Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Všechny pody, služby a uzly v clusteru Kubernetes neustále generují síťovou aktivitu: otevírání připojení, přeposílání nebo zahazování paketů, řešení či selhání DNS dotazů. Pochopení této aktivity je nezbytné pro ladění, plánování kapacity a udržování služeb v pořádku. Většina nastavení monitorování ale zkrachuje dvěma způsoby:
- Není dostatek viditelnosti. Agregace na úrovni uzlů říkají, že je něco špatně, ale ne kde. Bez podrobností na úrovni podů, které zahrnují zdrojový a cílový kontext, je izolace selhávající pracovní zátěže jen odhad.
- Příliš mnoho dat ve velkém měřítku. Cluster se stovkami mikroslužeb může vytvořit tisíce časových řad metrik na uzel. Shromažďování všech dat zvyšuje náklady na úložiště a zpomaluje řídicí panely.
Metriky sítě kontejnerů v Advanced Container Networking Services pro Azure Kubernetes Service (AKS) řeší obojí. Tato funkce shromažďuje síťové metriky na úrovni uzlu a úroveň podů napříč podporovanými rovinami dat Cilium a jiných než Cilium v Linuxu a Windows.
V clusterech Cilium můžete ještě rozšířit možnosti pomocí filtrování na úrovni zdroje, což vám umožní přesně vybrat jmenné prostory, pracovní zátěže a typy metrik, které budou shromážděny předtím, než data opustí uzel.
Filtrování metrik kontejnerů je kontrola před zpracováním dat o pozorovatelnosti. Místo shromažďování každé dostupné metriky a filtrování později v řídicích panelech nebo dotazech definujete, co se má shromažďovat ve zdroji. To udržuje metriky s vysokou přidanou hodnotou pro úlohy, které vás zajímají, a zabraňuje přijímání časových řad s nízkou hodnotou nebo šumem.
Výsledek: aktivovatelná pozorovatelnost sítě na jakékoli podporované datové rovině s volitelným nákladově efektivním filtrováním na Cilium.
Metriky sítě kontejnerů poskytují hlubokou viditelnost na úrovni úloh pro řešení potíží a plánování, zatímco filtrování na úrovni zdroje na Cilium pomáhá udržovat náklady na pozorovatelnost úměrné důležitým obchodním úlohám.
Přehledné shromažďování a filtrování
V této tabulce můžete rychle zjistit, kde je dostupná široká kolekce a kde je k dispozici jemně odstupňované filtrování:
| Schopnost | Klastry Cilium | Shluky bez Cilium |
|---|---|---|
| Kolekce metrik na úrovni uzlu | ✅ | ✅ |
| Kolekce metrik na úrovni podů | ✅ (Linux) | ✅ (Linux) |
| Filtrování na úrovni zdroje podle namespace, štítku podu a typu metriky | ✅ | ❌ |
| Řízení nákladů prostřednictvím filtrování před příjmem dat | ✅ | ❌ |
Important
Od 30. listopadu 2025 už Azure Kubernetes Service (AKS) nepodporuje ani neposkytuje aktualizace zabezpečení pro Azure Linux 2.0. Bitová kopie uzlu Azure Linux 2.0 je zmrazená na vydání 202512.06.0. Od 31. října 2026 se image uzlů odeberou a nebudete moct škálovat fondy uzlů. Přejděte na podporovanou verzi Azure Linuxu aktualizací poolů uzlů na podporovanou verzi Kubernetes nebo migrací na osSku AzureLinux3. Další informace najdete v tématu Problém s vyřazením z GitHubu a oznámení o vyřazení aktualizací Azure. Pokud chcete mít přehled o oznámeních a aktualizacích, postupujte podle poznámek k verzi AKS.
Klíčové výhody
Granularita na úrovni uzlu a podu Sledujte objem provozu, míru poklesu a stavy připojení na úrovni uzlu pro stav infrastruktury. Přejděte k podrobnostem jednotlivých podů se zdrojovými a cílovými popisky, abyste mohli určit přesnou úlohu, která způsobuje problém.
Rychlejší řešení potíží Když služba začne zahazovat pakety nebo dotazy DNS selžou, metriky na úrovni podů umožňují izolovat problém s konkrétním podem, oborem názvů nebo protokolem v sekundách, ne v hodinách.
Flexibilní vizualizace Metriky můžete ukládat do Azure Managed Prometheus a vizualizovat je v Azure Managed Grafana (plně spravované) nebo použít vlastní infrastrukturu Prometheus a Grafana.
Škálovatelné podle návrhu. Kanál zpracovává velké dynamické clustery se stovkami uzlů a tisíc podů, aniž byste museli vybírat mezi komplexním pokrytím a spravovatelnými objemy dat.
Cílená pozorovatelnost (shluky Cilium). V clusterech Cilium umožňuje filtrování na úrovni zdroje definovat obory názvů, popisky podů nebo typy metrik, o které vám záleží, a shromažďovat pouze ty. Nevyžaduje se žádné úprava po sběru.
Nižší náklady na zpracování metrik v clusterech Cilium. Vzhledem k tomu, že filtrování probíhá ve zdroji na každém uzlu, nechtěná časová řada metrik se nikdy nešrotuje, nepřenáší ani neingestuje do back-endu Prometheus. Platíte jenom za metriky, které skutečně potřebujete. Ve velkých clusterech, kde nefiltrovaná kolekce může vytvářet tisíce časových řad na uzel, může filtrování na úrovni zdroje výrazně snížit náklady na příjem dat a úložiště spravovaného nástroje Prometheus Azure.
Jak to funguje
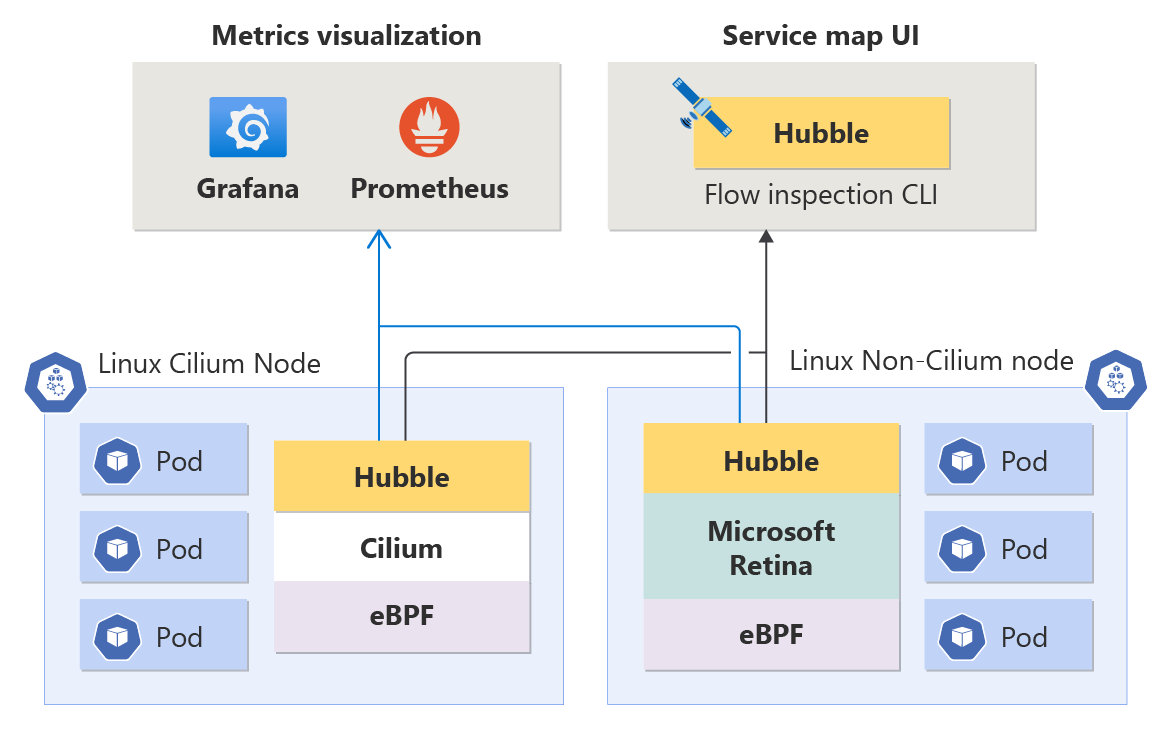
Zásobník agentů na každém uzlu závisí na datové vrstvě, jak je znázorněno v diagramu.
Uzly Linux Cilium používají vrstvený zásobník založený na eBPF: háky jádra eBPF zachycují nezpracovaná data o provozu, Cilium je zpracovává a Hubble ho zveřejňuje jako metriky formátu Prometheus. Vzhledem k tomu, že Hubble se nachází mezi uzlem a koncovým bodem výstřižku, spustí se filtrování na úrovni zdroje v této vrstvě – vyberete obory názvů, popisky podů a typy metrik, které se exportují, než data opustí uzel.
Linux non-Cilium nodes používají háky jádra eBPF, které poskytují data do Microsoft Retina, s vrstvou Hubble pro kontrolu toků. Microsoft Retina zpracovává shromažďování metrik a exportuje metriky na úrovni uzlů a podů ve formátu Prometheus.
Z každé cesty se metriky sbírají ve formátu Prometheus a jsou ingestovány do Azure Managed Prometheus nebo do vašeho vlastního backendu Prometheus, a poté se vizualizují v Azure Managed Grafana nebo ve vašem vlastním stacku Grafana.
Začněte tím, že nastavíte metriky sítě kontejnerů a nakonfigurujete filtrování metrik sítě kontejnerů pro clustery Cilium.
Kdy použít metriky sítě kontejneru
Metriky sítě kontejnerů jsou navržené pro týmy, které potřebují soustředit se na síťová data, a ne pro nezpracovaná telemetrická data. Mezi běžné scénáře patří:
- Ladění konkrétní pracovní zátěže Metriky na úrovni podů slouží k izolaci zahozených paketů, resetování protokolu TCP nebo selhání DNS pro konkrétní službu. V clusterech Cilium může filtrování omezit výběr na konkrétní jmenný prostor nebo popisek podu, čímž eliminuje šum v celém clusteru.
- Monitorování clusterů s více tenanty Sledujte stav sítě podle oboru názvů, aby každý tým získal přehled o vlastních vzorech provozu. V clusterech Cilium se oborové filtrování omezuje na obory názvů specifické pro tenanty.
- Plánování kapacity. Sledujte počty bajtů přesměrovaných a vyřazených na každý uzel a identifikujte saturované linky nebo nevyvážené rozložení zátěže.
- Monitorování stavu DNS Odhalte selhání dotazů DNS a pomalé časy řešení, abyste zachytili problémy dříve, než se přemění na chyby aplikace.
- Snížení nákladů na pozorovatelnost ve velkém měřítku Ve velkých clusterech může nefiltrovaná kolekce generovat tisíce časových řad na uzel. V clusterech Cilium filtrování na úrovni zdroje odstraní nežádoucí řady před příjmem, aby náklady zůstaly ve shodě s úlohami a typy metrik, které si zvolíte.
Jak zvolit, co se má shromažďovat (shluky Cilium)
K vyvážení viditelnosti a nákladů použijte tento model zavedení:
- Začněte se širokými sběry v neprodukčním namespace, abyste vytvořili základní úroveň.
- Zachovejte metriky zahozených paketů, DNS a TCP pro důležité obory názvů.
- Omezit metriky toku s vysokou kardinalitou pouze na kritické úlohy podniku
- Projděte si trendy příjmu dat v Prometheu a týdně vylepšujte filtry.
Tento přístup vám pomůže udržet metriky s vysokou hodnotou a zároveň řídit růst časových řad a náklady na příjem dat.
Než si prohlédnete tabulky metrik
Mějte na paměti tyto body:
- Metriky na úrovni uzlu jsou dostupné napříč podporovanými rovinami dat Cilium a ne-Cilium.
- Metriky na úrovni podů jsou k dispozici v Linuxu.
- Filtrování na úrovni zdroje je k dispozici pouze v clusterech Cilium.
- Na clusterech Cilium vyžadují DNS metriky závaznou síťovou zásadu FQDN Cilium.
Referenční informace k metrikám
Metriky na úrovni uzlů
Metriky na úrovni uzlu poskytují agregovanou statistiku provozu na uzel – přesměrované a zahozené pakety, počty bajtů a stavy připojení. Tyto metriky jsou uložené ve formátu Prometheus a lze je vizualizovat v Grafana.
Následující metriky se agregují na každý uzel. Všechny metriky zahrnují tyto popisky:
cluster-
instance(název uzlu)
Pro clustery roviny dat Cilium jsou metriky na úrovni uzlů k dispozici pouze v Linuxu. Cilium zveřejňuje následující metriky používané metrikami sítě kontejnerů:
| Název metriky | Description | Nadbytečné popisky | Linux | Windows |
|---|---|---|---|---|
| cilium_forward_count_total | Celkový počet přesměrovaných paketů | direction |
✅ | ❌ |
| cilium_forward_bytes_total | Celkový počet přeposlaných bajtů | direction |
✅ | ❌ |
| cilium_drop_count_total | Celkový počet zahozených paketů |
direction, reason |
✅ | ❌ |
| cilium_drop_bytes_total | Celkový počet vyřazených bajtů |
direction, reason |
✅ | ❌ |
Metriky na úrovni podů (metriky Hubble)
Metriky na úrovni podů zahrnují informace o zdrojovém a cílovém podu, takže můžete určit problémy se sítí na úrovni jednotlivých úloh. Tyto metriky pokrývají objem provozu, zahozené pakety, resetování protokolu TCP a toky vrstvy 4/vrstvy 7.
Metriky DNS (počty dotazů, kódy odpovědí a chyby) se ve výchozím nastavení shromažďují v rovinách dat mimo Cilium. Na datových rovinách Cilium vyžadují metriky DNS zásady sítě pro FQDN Cilium. DNS můžete řešit také v reálném čase pomocí rozhraní příkazového řádku Hubble.
Následující tabulka popisuje metriky agregované na pod (informace o uzlu se zachovají).
Všechny metriky zahrnují popisky:
clusterinstance(název uzlu)sourcenebodestinationU odchozího provozu
sourcepopisek označuje obor názvů a název zdrojového podu.U příchozího provozu
destinationpopisek označuje obor názvů cílového podu a jeho název.
| Název metriky | Description | Nadbytečné popisky | Linux | Windows |
|---|---|---|---|---|
| hubble_dns_queries_total | Celkový počet požadavků DNS podle dotazu |
sourcenebo destination, ( queryqtypestyp dotazu) |
✅ | ❌ |
| hubble_dns_responses_total | Celkový počet odpovědí DNS podle dotazu nebo odpovědi |
sourcenebo destination, ( queryqtypestyp dotazu), rcode (návratový kód), ips_returned (počet IP adres) |
✅ | ❌ |
| hubble_drop_total | Celkový počet zahozených paketů |
source nebo destination, protocol, reason |
✅ | ❌ |
| hubble_tcp_flags_total | Celkový počet paketů TCP podle příznaku |
source nebo destination, flag |
✅ | ❌ |
| hubble_flows_processed_total | Celkový počet zpracovaných síťových toků (provoz vrstvy 4/vrstvy 7) |
sourcenebo destination, , protocol, verdict, typesubtype |
✅ | ❌ |
Limitations
Platforma a datová rovina:
- Metriky na úrovni podů jsou dostupné jenom v Linuxu.
- Datová rovina Cilium je podporována od Kubernetes verze 1.29.
- Filtrování metrik na úrovni zdroje je k dispozici pouze v clusterech Cilium.
- Popisky metrik mají drobné rozdíly mezi klastrami Cilium a non-Cilium.
Metriky DNS:
- V clusterech Cilium metriky DNS vyžadují FQDN zásady sítě Cilium, nebo můžete použít rozhraní příkazového řádku Hubble k řešení potíží s DNS v reálném čase.
Známé problémy:
- Pokud dojde k výpadku agenta uzlu Hubble, může dojít k chybě Hubble relé, což může přerušit relace CLI Hubble.
Podpora FIPS (pouze pro ne-Cilium datová rozhraní):
- FIPS není k dispozici na uzlech Ubuntu 20.04 kvůli omezením jádra. Místo toho použijte fond uzlů Azure Linux nebo Ubuntu 22.04. Toto omezení neplatí pro datové roviny Cilium.
| Operační systém | Podpora FIPS |
|---|---|
| Azure Linux 3.0 | Yes |
| Azure Linux 2.0 | Yes |
| Ubuntu 20.04 | No |
| Ubuntu 22.04 | Yes |
Měřítko:
- Spravovaná služba pro Prometheus v Azure Monitor a Azure Managed Grafana ukládá specifická omezení škálování pro jednotlivé služby. Další informace najdete v tématu Sběr metrik Prometheus ve velkém rozsahu ve službě Azure Monitor.
Pricing
Important
Pokročilé služby kontejnerové sítě jsou placená nabídka.
Další informace o cenách naleznete v tématu Advanced Container Networking Services – Ceny.
Související obsah
- Nastavení metrik sítě kontejnerů
- Konfigurace filtrování metrik sítě kontejnerů
- Advanced Container Networking Services pro AKS
- Pozorovatelnost kontejnerové sítě v pokročilých síťových službách kontejnerů
- Zabezpečení sítě kontejnerů v pokročilých síťových službách kontejnerů