Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
VZTAHUJE SE NA: Azure Data Factory Azure Synapse Analytics
Tip
Data Factory v Microsoft Fabric je nová generace Azure Data Factory s jednodušší architekturou, integrovanou AI a novými funkcemi. Pokud s integrací dat začínáte, začněte Fabric Data Factory. Stávající úlohy ADF lze upgradovat na Fabric pro přístup k novým funkcím v oblastech datové vědy, analýz v reálném čase a vytváření sestav.
Tento článek popisuje, jak pomocí aktivity Kopírovat v kanálech Azure Data Factory nebo Synapse kopírovat data do a z Azure Synapse Analytics, a jak s použitím Tok dat transformovat data v Azure Data Lake Storage Gen2. Další informace o Azure Data Factory najdete v článku introductory.
Poznámka:
Tento konektor je také k dispozici ve službě Data Factory v Microsoft Fabric. Informace o konfiguraci a funkcích specifických pro Fabric najdete v dokumentaci ke konektoru Fabric Azure Synapse Analytics.
Podporované funkce
Tento konektor Azure Synapse Analytics je podporovaný pro následující funkce:
| Podporované funkce | IR | Spravovaný privátní koncový bod |
|---|---|---|
| aktivita Copy (zdroj/jímka) | (1) (2) | ✓ |
| Mapování toku dat (zdroj/jímka) | (1) | ✓ |
| Vyhledávací aktivita | (1) (2) | ✓ |
| Aktivita GetMetadata | (1) (2) | ✓ |
| Aktivita skriptu | (1) (2) | ✓ |
| Aktivita uložené procedury | (1) (2) | ✓ |
(1) Azure Integration Runtime (2) Lokálně hostované Integration Runtime
Pro aktivita Copy podporuje tento konektor Azure Synapse Analytics tyto funkce:
- Kopírování dat pomocí ověřování SQL a ověřování tokenu aplikace Microsoft Entra s objektovým služebním účtem nebo spravovanými identitami pro prostředky Azure.
- Jako zdroj načtěte data pomocí dotazu SQL nebo uložené procedury. Můžete také zvolit paralelní kopírování ze zdroje Azure Synapse Analytics, podrobnosti najdete v části Parallel copy from Azure Synapse Analytics.
- Jako jímku načtěte data pomocí příkazu COPY nebo PolyBase nebo hromadného vložení. Pro lepší výkon kopírování doporučujeme příkaz COPY nebo PolyBase. Konektor také podporuje automatické vytváření cílové tabulky pomocí funkce DISTRIBUTION = ROUND_ROBIN, pokud neexistuje na základě zdrojového schématu.
Důležité
Pokud kopírujete data pomocí Azure Integration Runtime, nakonfigurujte pravidlo brány firewall na úrovni serveru tak, aby Azure služby mohly přistupovat k logical SQL Server. Pokud kopírujete data pomocí místního prostředí Integration Runtime, nakonfigurujte bránu firewall tak, aby povolila odpovídající rozsah IP adres. Tento rozsah zahrnuje IP adresu počítače, která se používá pro připojení k Azure Synapse Analytics.
Začínáme
Tip
Pokud chcete dosáhnout nejlepšího výkonu, použijte příkaz PolyBase nebo COPY k načtení dat do Azure Synapse Analytics. Použití PolyBase k načtení dat do Azure Synapse Analytics a Použití příkazu COPY k načtení dat do Azure Synapse Analytics obsahují podrobnosti. Návod s případem použití najdete v tématu Načtení 1 TB do Azure Synapse Analytics do 15 minut s Azure Data Factory.
K provedení aktivity kopírování pomocí datového kanálu můžete použít jeden z následujících nástrojů nebo sad SDK:
- Nástroj pro kopírování dat
- portál Azure
- .NET SDK
- Python SDK
- Azure PowerShell
- REST API
- šablona Azure Resource Manager
Vytvoření propojené služby Azure Synapse Analytics pomocí uživatelského rozhraní
Pomocí následujícího postupu vytvořte v uživatelském rozhraní portálu Azure propojenou službu Azure Synapse Analytics.
Přejděte na kartu Spravovat v pracovním prostoru Azure Data Factory nebo Synapse a vyberte Propojené služby a potom klikněte na Nový:
Vyhledejte Synapse a vyberte konektor Azure Synapse Analytics.

Nakonfigurujte podrobnosti o službě, otestujte připojení a vytvořte novou propojenou službu.

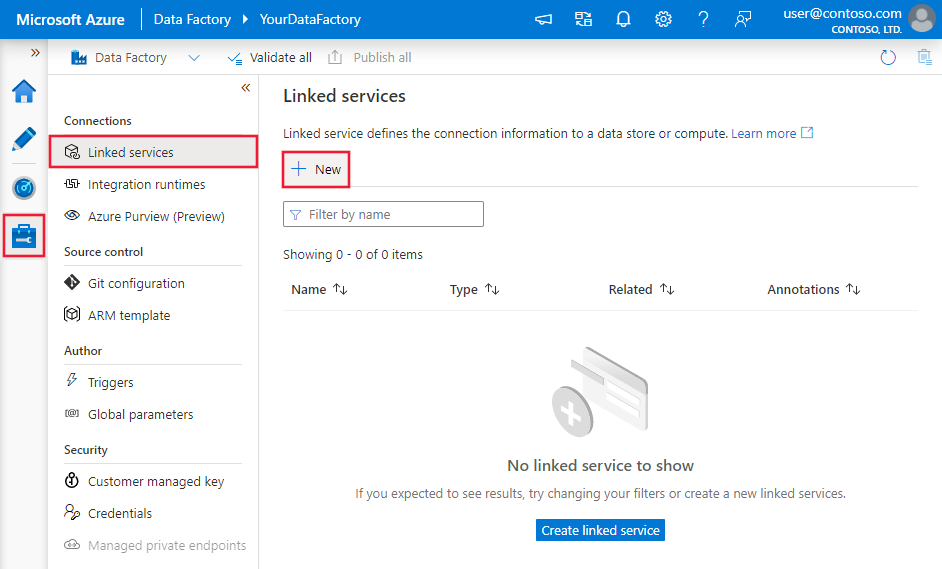
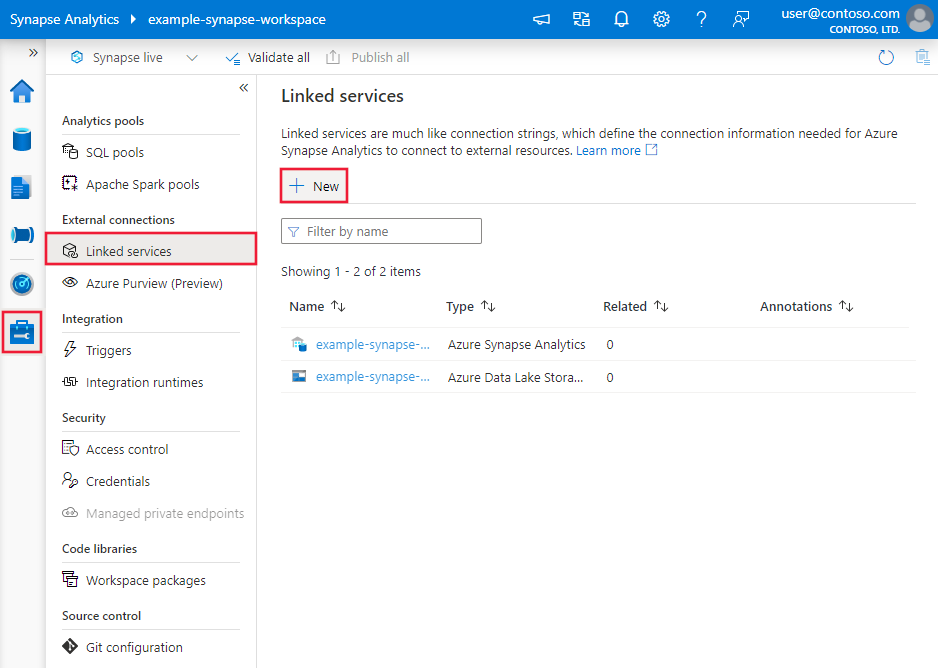
Podrobnosti konfigurace konektoru
Následující části obsahují podrobnosti o vlastnostech, které definují entity kanálu Data Factory a Synapse specifické pro konektor Azure Synapse Analytics.
Vlastnosti propojené služby
Konektor Azure Synapse Analytics Doporučená verze podporuje TLS 1.3. V tomto section upgradujte verzi konektoru Azure Synapse Analytics z Legacy. Podrobnosti vlastností najdete v odpovídajících sekcích.
Tip
Při vytváření propojené služby pro SQL pool serverless v Azure Synapse z portálu Azure:
- V případě metody výběru účtu zvolte Zadat ručně.
-
Vložte plně kvalifikovaný název domény bezserverového koncového bodu. Najdete ho na stránce Přehled portálu Azure pro váš pracovní prostor Synapse ve vlastnostech v části Serverless SQL endpoint. Například
myserver-ondemand.sql-azuresynapse.net. - Jako název databáze zadejte název databáze v bezserverovém fondu SQL.
Tip
Pokud narazíte na chybu s kódem chyby jako "UserErrorFailedToConnectToSqlServer" a zprávou typu "Limit relace pro databázi je XXX a byl dosažen", přidejte Pooling=false do řetězce připojení a zkuste to znovu.
Doporučená verze
Tyto obecné vlastnosti jsou podporovány pro propojenou službu Azure Synapse Analytics při použití verze Potvrzováno verze:
| Vlastnost | Popis | Povinné |
|---|---|---|
| typ | Vlastnost typu musí být nastavená na AzureSqlDW. | Ano |
| server | Název nebo síťová adresa instance SQL Serveru, ke které se chcete připojit. | Ano |
| databáze | Název databáze. | Ano |
| typ autentizace | Typ použitý k ověřování. Povolené hodnoty jsou SQL (výchozí), ServicePrincipal, SystemAssignedManagedIdentity, UserAssignedManagedIdentity. Přejděte do příslušné části ověřování týkající se konkrétních vlastností a požadavků. | Ano |
| šifrovat | Určete, jestli je vyžadováno šifrování TLS pro všechna data odesílaná mezi klientem a serverem. Možnosti: povinné (pro true, výchozí)/volitelné (pro false)/přísné. | Ne |
| důvěřovatServerovémuCertifikátu | Určete, jestli bude kanál při obejití řetězu certifikátů zašifrovaný, aby se ověřil vztah důvěryhodnosti. | Ne |
| hostNameInCertificate | Název hostitele, který se má použít při ověřování certifikátu serveru pro připojení. Pokud není zadaný, název serveru se použije k ověření certifikátu. | Ne |
| connectVia | Prostředí Integration Runtime, které má být použito k připojení k datovému úložišti. Můžete použít Azure Integration Runtime nebo lokálně hostované integrační prostředí (pokud je vaše úložiště dat umístěno v privátní síti). Pokud není zadaný, použije výchozí Azure Integration Runtime. | Ne |
Další vlastnosti připojení najdete v následující tabulce:
| Vlastnost | Popis | Povinné |
|---|---|---|
| účel aplikace | Typ úlohy aplikace při připojování k serveru. Povolené hodnoty jsou ReadOnly a ReadWrite. |
Ne |
| Připojovací časový limit (connectTimeout) | Doba (v sekundách) čekání na připojení k serveru před ukončením pokusu a vygenerováním chyby. | Ne |
| početPokusuOPřipojení | Počet pokusů o opětovné připojení po identifikaci selhání připojení při nečinnosti. Hodnota by měla být celé číslo mezi 0 a 255. | Ne |
| connectRetryInterval (interval opakování připojení) | Doba (v sekundách) mezi jednotlivými pokusy o opětovné připojení po identifikaci selhání nečinného připojení. Hodnota by měla být celé číslo mezi 1 a 60. | Ne |
| loadBalanceTimeout | Minimální doba (v sekundách), po kterou má připojení zůstat aktivní ve fondu připojení před jeho ukončením. | Ne |
| časový limit příkazu | Výchozí doba čekání (v sekundách) před ukončením pokusu o spuštění příkazu a vygenerováním chyby. | Ne |
| integrované zabezpečení | Povolené hodnoty jsou true nebo false. Při zadávání false uveďte, zda jsou v připojení zadány uživatelské jméno a heslo. Při zadávání true určuje, jestli se k ověřování používají aktuální přihlašovací údaje účtu Windows. |
Ne |
| failoverPartner | Název nebo adresa partnerského serveru, ke kterému se má připojit, pokud je primární server v výpadku. | Ne |
| maxPoolSize | Maximální počet připojení povolených ve fondu připojení pro konkrétní připojení. | Ne |
| minimálníVelikostPoolu | Minimální počet připojení povolených ve fondu připojení pro konkrétní připojení. | Ne |
| multipleActiveResultSets | Povolené hodnoty jsou true nebo false. Při zadávání truemůže aplikace udržovat více aktivních sad výsledků (MARS). Když zadáte false, aplikace musí zpracovat nebo zrušit všechny sady výsledků z jedné dávky, aby bylo možné v daném připojení spustit jakékoli jiné dávky. |
Ne |
| multiSubnetFailover | Povolené hodnoty jsou true nebo false. Pokud se vaše aplikace připojuje ke skupině dostupnosti AlwaysOn v různých podsítích, nastavením této vlastnosti true zajistíte rychlejší detekci a připojení k aktuálně aktivnímu serveru. |
Ne |
| velikost paketu | Velikost v bajtech síťových paketů používaných ke komunikaci s instancí serveru. | Ne |
| sdružování | Povolené hodnoty jsou true nebo false. Po zadání true bude připojení zařazeno do fondu. Když zadáte false, připojení se explicitně otevře při každém vyžádání připojení. |
Ne |
Ověřování SQL
Pokud chcete použít ověřování SQL, kromě obecných vlastností popsaných v předchozí části zadejte následující vlastnosti:
| Vlastnost | Popis | Povinné |
|---|---|---|
| userName | Uživatelské jméno použité pro připojení k serveru. | Ano |
| heslo | Heslo pro uživatelské jméno. Označte toto pole jako SecureString , abyste ho bezpečně uložili. Nebo můžete odložit tajný kód uložený v Azure Key Vault. | Ano |
Příklad: Použití ověřování SQL
{
    "name": "AzureSqlDWLinkedService",
    "properties": {
        "type": "AzureSqlDW",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "SQL",
            "userName": "<user name>",
            "password": {
                "type": "SecureString",
                "value": "<password>"
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
Example: heslo v Azure Key Vault
{
    "name": "AzureSqlDWLinkedService",
    "properties": {
        "type": "AzureSqlDW",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "SQL",
            "userName": "<user name>",
            "password": {
                "type": "AzureKeyVaultSecret",
                "store": {
                    "referenceName": "<Azure Key Vault linked service name>",
                    "type": "LinkedServiceReference"
                },
                "secretName": "<secretName>"
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
Ověřování service principal
Pokud chcete použít ověřování pomocí služebního principálu, zadejte kromě obecných vlastností popsaných v předchozí části následující vlastnosti:
| Vlastnost | Popis | Povinné |
|---|---|---|
| servicePrincipalId | Zadejte ID klienta aplikace. | Ano |
| servicePrincipalCredential | Přihlašovací údaje aplikačního vlastníka. Zadejte klíč aplikace. Toto pole označte jako SecureString pro bezpečné uložení nebo reference tajného kódu uloženého v Azure Key Vault. | Ano |
| klient | Zadejte informace o tenantovi (název domény nebo ID tenanta), pod kterým se vaše aplikace nachází. Můžete ho získat, když najedete myší do pravého horního rohu portálu Azure. | Ano |
| azureCloudType | Pro ověřování pomocí služebního účtu zadejte typ Azure cloudového prostředí, v němž je registrována vaše aplikace Microsoft Entra. Povolené hodnoty jsou AzurePublic, AzureChina, AzureUsGovernmenta AzureGermany. Ve výchozím nastavení se používá cloudové prostředí služby Data Factory nebo datového kanálu Synapse. |
Ne |
Musíte také postupovat podle následujících kroků:
Vytvoření aplikace Microsoft Entra z portálu Azure. Poznamenejte si název aplikace a následující hodnoty, které definují propojenou službu:
- ID aplikace
- Klíč aplikace
- ID nájemce
Poskytněte správce Microsoft Entra pro váš server na portálu Azure, pokud jste to ještě neudělali. Správcem Microsoft Entra může být Microsoft Entra uživatel nebo skupina Microsoft Entra. Pokud skupině udělíte roli správce spravované identity, přeskočte kroky 3 a 4. Správce bude mít úplný přístup k databázi.
Vytvořte uživatele omezeného na databázi pro služební principál. Připojte se k datovému skladu, ze kterého nebo do kterého chcete kopírovat data, pomocí nástrojů, jako je SSMS, s identitou služby Microsoft Entra, která má alespoň oprávnění ALTER ANY USER. Spusťte následující příkaz T-SQL:
CREATE USER [your_application_name] FROM EXTERNAL PROVIDER;Udělte služebnímu principálu potřebná oprávnění jako obvykle pro uživatele SQL nebo jiné. Spusťte následující kód nebo se tady podívejte na další možnosti. Pokud chcete k načtení dat použít PolyBase, přečtěte si požadované oprávnění k databázi.
EXEC sp_addrolemember db_owner, [your application name];Konfigurovat propojenou službu Azure Synapse Analytics v pracovním prostoru Azure Data Factory nebo Synapse.
Příklad propojené služby, který používá ověřování instančního objektu
{
    "name": "AzureSqlDWLinkedService",
    "properties": {
        "type": "AzureSqlDW",
        "typeProperties": {
            "connectionString": "Server=tcp:<servername>.database.windows.net,1433;Database=<databasename>;Connection Timeout=30",
            "servicePrincipalId": "<service principal id>",
            "servicePrincipalCredential": {
                "type": "SecureString",
                "value": "<application key>"
            },
            "tenant": "<tenant info, e.g. microsoft.onmicrosoft.com>"
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
Spravované identity přiřazené systémem pro ověřování Azure prostředků
Datová továrna nebo pracovní prostor Synapse může být přidružen k systémem přiřazené spravované identitě pro prostředky Azure, která představuje prostředek. Tuto spravovanou identitu můžete použít k ověřování Azure Synapse Analytics. Určený prostředek může přistupovat k vašemu datovému skladu a kopírovat data do něj nebo z něj pomocí této identity.
Pokud chcete použít ověřování spravované identity přiřazené systémem, zadejte obecné vlastnosti popsané v předchozí části a postupujte podle těchto kroků.
Nakonfigurujte správce Microsoft Entra pro váš server na portálu Azure, pokud jste to ještě neudělali. Správcem Microsoft Entra může být Microsoft Entra uživatel nebo skupina Microsoft Entra. Pokud skupině udělíte systémem přiřazenou spravovanou identitu jako administrátorskou roli, přeskočte kroky 3 a 4. Správce bude mít úplný přístup k databázi.
Vytvořte uživatele databáze s omezením pro spravovanou identitu přiřazenou systémem. Připojte se k datovému skladu, ze kterého nebo do kterého chcete kopírovat data, pomocí nástrojů, jako je SSMS, s identitou služby Microsoft Entra, která má alespoň oprávnění ALTER ANY USER. Spusťte následující příkaz T-SQL.
CREATE USER [your_resource_name] FROM EXTERNAL PROVIDER;Udělte spravované identitě přiřazené systémem potřebná oprávnění jako obvykle pro uživatele SQL a další uživatele. Spusťte následující kód nebo se tady podívejte na další možnosti. Pokud chcete k načtení dat použít PolyBase, přečtěte si požadované oprávnění k databázi.
EXEC sp_addrolemember db_owner, [your_resource_name];Konfigurovat propojenou službu Azure Synapse Analytics.
Příklad:
{
    "name": "AzureSqlDWLinkedService",
    "properties": {
        "type": "AzureSqlDW",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "SystemAssignedManagedIdentity"
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
Ověřování spravované identity přiřazené uživatelem
Pracovní prostor datové továrny nebo Synapse lze přidružit k uživatelsky přiřazeným spravovaným identitám, které představují prostředek. Tuto spravovanou identitu můžete použít k ověřování Azure Synapse Analytics. Určený prostředek může přistupovat k vašemu datovému skladu a kopírovat data do něj nebo z něj pomocí této identity.
Pokud chcete použít ověřování spravované identity přiřazené uživatelem, kromě obecných vlastností popsaných v předchozí části zadejte následující vlastnosti:
| Vlastnost | Popis | Povinné |
|---|---|---|
| přihlašovací údaje | Jako objekt přihlašovacích údajů zadejte spravovanou identitu přiřazenou uživatelem. | Ano |
Musíte také postupovat podle následujících kroků:
Nakonfigurujte správce Microsoft Entra pro váš server na portálu Azure, pokud jste to ještě neudělali. Správcem Microsoft Entra může být Microsoft Entra uživatel nebo skupina Microsoft Entra. Pokud skupině se spravovanou identitou přiřazenou uživatelem udělíte roli správce, přeskočte krok 3. Správce bude mít úplný přístup k databázi.
Vytvořte uživatele omezené databáze pro spravovanou identitu přiřazenou uživatelem. Připojte se k datovému skladu, ze kterého nebo do kterého chcete kopírovat data, pomocí nástrojů, jako je SSMS, s identitou služby Microsoft Entra, která má alespoň oprávnění ALTER ANY USER. Spusťte následující příkaz T-SQL.
CREATE USER [your_resource_name] FROM EXTERNAL PROVIDER;Vytvořte jednu nebo více spravovaných identit přiřazených uživatelem a udělte spravované identitě přiřazené uživatelem potřebná oprávnění jako obvykle pro uživatele SQL a další. Spusťte následující kód nebo se tady podívejte na další možnosti. Pokud chcete k načtení dat použít PolyBase, přečtěte si požadované oprávnění k databázi.
EXEC sp_addrolemember db_owner, [your_resource_name];Přiřaďte k datové továrně jednu nebo více spravovaných identit přiřazených uživatelem a vytvořte přihlašovací údaje pro každou spravovanou identitu přiřazenou uživatelem.
Konfigurovat propojenou službu Azure Synapse Analytics.
Příklad
{
    "name": "AzureSqlDWLinkedService",
    "properties": {
        "type": "AzureSqlDW",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "UserAssignedManagedIdentity",
            "credential": {
                "referenceName": "credential1",
                "type": "CredentialReference"
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
Starší verze
Tyto obecné vlastnosti jsou podporovány pro propojenou službu Azure Synapse Analytics při použití Legacy verze:
| Vlastnost | Popis | Povinné |
|---|---|---|
| typ | Vlastnost typu musí být nastavená na AzureSqlDW. | Ano |
| připojovací řetězec | Zadejte informace potřebné pro připojení k instanci Azure Synapse Analytics pro vlastnost connectionString. Označte toto pole jako SecureString, abyste ho bezpečně uložili. Můžete také vložit heslo nebo klíč pro službu do Azure Key Vault a pokud je použité ověřování SQL, vyjměte konfiguraci password z připojovacího řetězce. Podrobnosti najdete v článku Ukládání přihlašovacích údajů v Azure Key Vault. |
Ano |
| connectVia | Prostředí Integration Runtime, které má být použito k připojení k datovému úložišti. Můžete použít Azure Integration Runtime nebo lokálně hostované integrační prostředí (pokud je vaše úložiště dat umístěno v privátní síti). Pokud není zadaný, použije výchozí Azure Integration Runtime. | Ne |
Informace o různých typech ověřování najdete v následujících částech o konkrétních vlastnostech a požadavcích:
- Ověřování SQL pro starší verzi
- Ověřování servisní identity pro starší verzi
- Ověřování spravované identity přiřazené systémem pro starší verzi
- Ověřování spravované identity přiřazené uživatelem pro starší verzi
Ověřování SQL pro starší verzi
Pokud chcete použít ověřování SQL, zadejte obecné vlastnosti popsané v předchozí části.
Ověřování aplikační identity pro starší verzi
Pokud chcete použít ověřování pomocí služebního principálu, zadejte kromě obecných vlastností popsaných v předchozí části následující vlastnosti:
| Vlastnost | Popis | Povinné |
|---|---|---|
| servicePrincipalId | Zadejte ID klienta aplikace. | Ano |
| servicePrincipalKey | Zadejte klíč aplikace. Označte toto pole jako SecureString pro jeho bezpečné uložení, nebo odkazujte na tajemství uložené v Azure Key Vault. | Ano |
| klient | Zadejte informace o tenantovi, například název domény nebo ID tenanta, pod kterým se vaše aplikace nachází. Načtěte ho umístěním kurzoru myši v pravém horním rohu portálu Azure. | Ano |
| azureCloudType | Pro ověřování pomocí služebního účtu zadejte typ Azure cloudového prostředí, v němž je registrována vaše aplikace Microsoft Entra. Povolené hodnoty jsou AzurePublic, AzureChina, AzureUsGovernment a AzureGermany. Ve výchozím nastavení se používá cloudové prostředí služby Data Factory nebo datového kanálu Synapse. |
Ne |
Musíte také postupovat podle kroků v Ověřování pomocí definičního objektu služby, abyste udělili odpovídající oprávnění.
Ověřování spravované identity přiřazené systémem pro předchozí verzi
Pokud chcete použít ověřování spravované identity přiřazené systémem, postupujte podle stejného kroku pro doporučenou verzi ověřování spravované identity přiřazené systémem.
Ověřování spravované identity přiřazené uživatelem pro starší verzi
Pokud chcete použít ověřování spravované identity přiřazené uživatelem, postupujte podle stejného kroku pro doporučenou verzi ověřování spravované identity přiřazené uživatelem.
Vlastnosti datové sady
Úplný seznam oddílů a vlastností dostupných pro definování datových sad najdete v článku Datové sady .
Pro datovou sadu Azure Synapse Analytics se podporují následující vlastnosti:
| Vlastnost | Popis | Povinné |
|---|---|---|
| typ | Vlastnost typu datové sady musí být nastavená na AzureSqlDWTable. | Ano |
| schéma | Název schématu | Ne pro zdroj, Ano pro jímku |
| tabulka | Název tabulky nebo zobrazení | Ne pro zdroj, Ano pro jímku |
| tableName | Název tabulky nebo zobrazení se schématem Tato vlastnost je podporována pro zpětnou kompatibilitu. Pro nové úlohy použijte schema a table. |
Ne pro zdroj, Ano pro jímku |
Příklad vlastností datové sady
{
    "name": "AzureSQLDWDataset",
    "properties":
    {
        "type": "AzureSqlDWTable",
        "linkedServiceName": {
            "referenceName": "<Azure Synapse Analytics linked service name>",
            "type": "LinkedServiceReference"
        },
        "schema": [ < physical schema, optional, retrievable during authoring > ],
        "typeProperties": {
            "schema": "<schema_name>",
            "table": "<table_name>"
        }
    }
}
Vlastnosti aktivity kopírování
Úplný seznam oddílů a vlastností dostupných pro definování aktivit najdete v článku Pipelines . Tato část obsahuje seznam vlastností podporovaných zdrojem Azure Synapse Analytics a jímkou.
Azure Synapse Analytics jako zdroj
Tip
Pokud chcete efektivně načítat data z Azure Synapse Analytics pomocí dělení dat, přečtěte si další informace z Parallel copy z Azure Synapse Analytics.
Pokud chcete kopírovat data z Azure Synapse Analytics, nastavte vlastnost ve zdroji aktivity kopírování na SqlDWSource. V sekci zdroje aktivity kopírování jsou podporovány následující vlastnosti:
| Vlastnost | Popis | Povinné |
|---|---|---|
| typ | Vlastnost typu zdroje aktivity kopírování musí být nastavena na SqlDWSource. | Ano |
| sqlReaderQuery | Ke čtení dat použijte vlastní dotaz SQL. Příklad: select * from MyTable. |
Ne |
| sqlReaderStoredProcedureName | Název uložené procedury, která čte data ze zdrojové tabulky. Poslední příkaz SQL musí být příkaz SELECT v uložené proceduře. | Ne |
| parametry uložené procedury | Parametry pro uloženou proceduru. Povolené hodnoty jsou dvojice názvů nebo hodnot. Názvy a velikost písmen parametrů musí odpovídat názvům a velikostem písmen parametrů uložené procedury. |
Ne |
| úroveň izolace | Určuje chování uzamčení transakce pro zdroj SQL. Povolené hodnoty jsou: ReadCommitted, ReadUncommitted, RepeatableRead, Serializable, Snapshot. Pokud není zadáno, použije se výchozí úroveň izolace databáze. Další informace naleznete v tématu system.data.isolationlevel. | Ne |
| možnosti oddílu | Určuje možnosti dělení dat používané k načtení dat z Azure Synapse Analytics. Povolené hodnoty jsou: None (výchozí), PhysicalPartitionsOfTable a DynamicRange. Pokud je povolená možnost oddílu (tj. ne None), je stupeň paralelismu souběžného načítání dat z Azure Synapse Analytics řízen nastavením parallelCopies aktivity kopírování. |
Ne |
| nastavení oddílu | Zadejte skupinu nastavení pro dělení dat. Použít, pokud možnost oddílu není None. |
Ne |
V části partitionSettings: |
||
| název sloupce pro dělení (partitionColumnName) | Zadejte název zdrojového sloupce v typu celé číslo nebo date/datetime (int, smallint, bigint, date, smalldatetime, datetime, datetime2 nebo datetimeoffset), který bude použit dělením rozsahu pro paralelní kopírování. Pokud není zadán, index nebo primární klíč tabulky se automaticky zjistí a použije se jako partiční sloupec.Použít, pokud je možnost oddílu DynamicRange. Pokud k načtení zdrojových dat použijete dotaz, začněte s ?DfDynamicRangePartitionCondition v klauzuli WHERE. Příklad najdete v části Paralelní kopírování z databáze SQL. |
Ne |
| partitionUpperBound | Maximální hodnota sloupce oddílu pro rozdělení rozsahu oddílu. Tato hodnota se používá k určení kroku oddílu, nikoli k filtrování řádků v tabulce. Všechny řádky v tabulce nebo výsledku dotazu se rozdělí a zkopírují. Pokud není zadáno, aktivita kopírování automaticky rozpozná hodnotu. Použít, pokud je možnost oddílu DynamicRange. Příklad najdete v části Paralelní kopírování z databáze SQL. |
Ne |
| partitionLowerBound | Minimální hodnota sloupce oddílu pro rozdělení rozsahů. Tato hodnota se používá k určení kroku oddílu, nikoli k filtrování řádků v tabulce. Všechny řádky v tabulce nebo výsledku dotazu se rozdělí a zkopírují. Pokud není zadáno, aktivita kopírování automaticky rozpozná hodnotu. Použít, pokud je možnost oddílu DynamicRange. Příklad najdete v části Paralelní kopírování z databáze SQL. |
Ne |
Všimněte si následujícího bodu:
- Při použití uložené procedury ve zdroji k načtení dat si všimněte, že uložená procedura je navržena jako vrácení jiného schématu, pokud je předána jiná hodnota parametru, může dojít k selhání nebo může dojít k neočekávanému výsledku při importu schématu z uživatelského rozhraní nebo při kopírování dat do databáze SQL s automatickým vytvořením tabulky.
Příklad: Použití dotazu SQL
"activities":[
    {
        "name": "CopyFromAzureSQLDW",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<Azure Synapse Analytics input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SqlDWSource",
                "sqlReaderQuery": "SELECT * FROM MyTable"
            },
            "sink": {
                "type": "<sink type>"
            }
        }
    }
]
Příklad: použití uložené procedury
"activities":[
    {
        "name": "CopyFromAzureSQLDW",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<Azure Synapse Analytics input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SqlDWSource",
                "sqlReaderStoredProcedureName": "CopyTestSrcStoredProcedureWithParameters",
                "storedProcedureParameters": {
                    "stringData": { "value": "str3" },
                    "identifier": { "value": "$$Text.Format('{0:yyyy}', <datetime parameter>)", "type": "Int"}
                }
            },
            "sink": {
                "type": "<sink type>"
            }
        }
    }
]
Ukázková uložená procedura:
CREATE PROCEDURE CopyTestSrcStoredProcedureWithParameters
(
    @stringData varchar(20),
    @identifier int
)
AS
SET NOCOUNT ON;
BEGIN
    select *
    from dbo.UnitTestSrcTable
    where dbo.UnitTestSrcTable.stringData != stringData
    and dbo.UnitTestSrcTable.identifier != identifier
END
GO
Azure Synapse Analytics jako jímka
kanály Azure Data Factory a Synapse podporují tři způsoby načtení dat do Azure Synapse Analytics.
- Použití příkazu COPY
- Použití PolyBase
- Použijte hromadné vložení
Nejrychlejším a nejš škálovatelným způsobem načítání dat je příkaz COPY nebo PolyBase.
Pokud chcete kopírovat data do Azure Synapse Analytics, nastavte typ jímky v aktivitě kopírování na SqlDWSink. V části sink aktivity kopírování se podporují následující vlastnosti:
| Vlastnost | Popis | Povinné |
|---|---|---|
| typ | Vlastnost typu jímky aktivity kopírování musí být nastavena na SqlDWSink. | Ano |
| allowPolyBase | Určuje, zda se má použít PolyBase k načtení dat do Azure Synapse Analytics.
allowCopyCommand a allowPolyBase nemůže být pravdivý. Informace o omezeních a podrobnostech najdete v části Použití PolyBase k načtení dat do Azure Synapse Analytics. Povolené hodnoty jsou True a False (výchozí). |
Ne. Použít při použití PolyBase. |
| polyBaseSettings | Skupina vlastností, které lze zadat, když allowPolybase je vlastnost nastavena na hodnotu true. |
Ne. Použít při použití PolyBase. |
| allowCopyCommand | Určuje, jestli se má použít příkaz COPY k načtení dat do Azure Synapse Analytics.
allowCopyCommand a allowPolyBase nemůže být pravdivý. Informace o omezeních a podrobnostech najdete v části Použití příkazu COPY k načtení dat do oddílu Azure Synapse Analytics. Povolené hodnoty jsou True a False (výchozí). |
Ne. Aplikovat při použití příkazu COPY. |
| nastaveníPříkazuKopírování | Skupina vlastností, které lze zadat, když allowCopyCommand je vlastnost nastavena na HODNOTU TRUE. |
Ne. Aplikovat při použití příkazu COPY. |
| writeBatchSize | Počet řádků, které se mají vložit do tabulky SQL na jednu dávku Povolená hodnota je celé číslo (počet řádků). Ve výchozím nastavení služba dynamicky určuje odpovídající velikost dávky na základě velikosti řádku. |
Ne. Použít při použití hromadného vložení |
| writeBatchTimeout | Doba čekání na dokončení operace vložení, upsertu a uložené procedury před vypršením časového limitu. Povolené hodnoty jsou pro časový rozsah. Příkladem je 00:30:00 po dobu 30 minut. Pokud není zadána žádná hodnota, časový limit je výchozí hodnota 00:30:00. |
Ne. Použít při použití hromadného vložení |
| preCopyScript | Zadejte dotaz SQL pro aktivitu kopírování, který se má spustit před zápisem dat do Azure Synapse Analytics v každém spuštění. Tato vlastnost slouží k vyčištění předem načtených dat. | Ne |
| možnostTabulky | Určuje, zda se má automaticky vytvořit tabulka jímky, pokud neexistuje, na základě zdrojového schématu. Povolené hodnoty jsou: none (výchozí), autoCreate. |
Ne |
| disableMetricsCollection | Služba shromažďuje metriky, jako jsou Azure Synapse Analytics DWU pro optimalizaci výkonu kopírování a doporučení, která představují další hlavní přístup k databázi. Pokud máte obavy o toto chování, určete true , jestli chcete toto chování vypnout. |
Ne (výchozí hodnota je false) |
| maximální počet současných připojení | Horní limit souběžných připojení vytvořených k úložišti dat během spuštění aktivity. Zadejte hodnotu pouze v případech, kdy chcete omezit souběžná připojení. | Ne |
| WriteBehavior | Určete chování zápisu v rámci aktivity kopírování pro načtení dat do Azure Synapse Analytics. Povolená hodnota je Insert a Upsert. Ve výchozím nastavení služba používá k načtení dat operaci insert. |
Ne |
| upsertSettings | Zadejte skupinu nastavení pro chování zápisu. Použít, pokud je možnost Upsert WriteBehavior. |
Ne |
V části upsertSettings: |
||
| klíče | Zadejte názvy sloupců pro jedinečnou identifikaci řádků. Můžete použít jeden klíč nebo řadu klíčů. Pokud není zadaný, použije se primární klíč. | Ne |
| interimSchemaName | Zadejte dočasné schéma pro vytvoření dočasné tabulky. Poznámka: Uživatel musí mít oprávnění k vytváření a odstraňování tabulek. Ve výchozím nastavení bude dočasná tabulka sdílet stejné schéma jako tabulka jímky. | Ne |
Příklad 1: Azure Synapse Analytics jímka
"sink": {
    "type": "SqlDWSink",
    "allowPolyBase": true,
    "polyBaseSettings":
    {
        "rejectType": "percentage",
        "rejectValue": 10.0,
        "rejectSampleValue": 100,
        "useTypeDefault": true
    }
}
Příklad 2: Vložit nebo aktualizovat data
"sink": {
    "type": "SqlDWSink",
    "writeBehavior": "Upsert",
    "upsertSettings": {
        "keys": [
             "<column name>"
        ],
        "interimSchemaName": "<interim schema name>"
    },
}
Paralelní kopírování z Azure Synapse Analytics
Konektor Azure Synapse Analytics v aktivitě kopírování poskytuje integrované dělení dat pro paralelní kopírování dat. Možnosti dělení dat najdete na kartě Zdroj kopírovací aktivity.
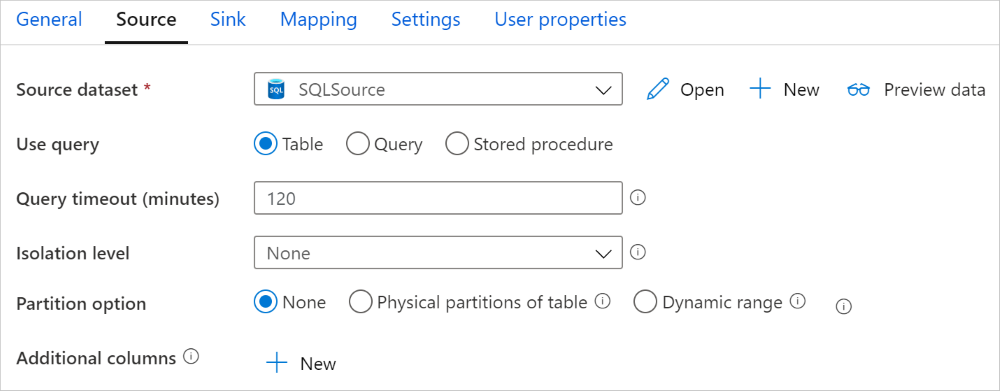
Když povolíte dělené kopírování, aktivita kopírování spouští paralelní dotazy na váš Azure Synapse Analytics zdroj pro načtení dat podle oddílů. Paralelní stupeň se řídí nastavením aktivity kopírování parallelCopies. Pokud například nastavíte parallelCopies na čtyři, služba současně generuje a spouští čtyři dotazy na základě zadané možnosti a nastavení oddílu a každý dotaz načte část dat z vašeho Azure Synapse Analytics.
Doporučujeme povolit paralelní kopírování s dělením dat, zejména pokud načítáte velké množství dat z Azure Synapse Analytics. Následující konfigurace jsou navržené pro různé scénáře. Při kopírování dat do souborového úložiště dat se doporučuje zapisovat do složky jako více souborů (zadat pouze název složky), v takovém případě je výkon lepší než zápis do jednoho souboru.
| Scénář | Navrhovaná nastavení |
|---|---|
| Načtení všech dat z velké tabulky s fyzickými partícemi |
Možnost oddílu: Fyzické oddíly tabulky. Během provádění služba automaticky rozpozná fyzické oddíly a kopíruje data podle oddílů. Pokud chcete zkontrolovat, jestli má vaše tabulka fyzický oddíl, můžete použít tento dotaz. |
| Úplné načtení z velké tabulky bez fyzického dělení, ale s využitím celočíselného nebo datetime sloupce pro dělení dat. |
Možnosti oddílu: Dynamický rozsah oddílu Sloupec pro oddílování (volitelné): Zadejte sloupec použitý pro oddílování dat. Pokud není zadáno, použije se sloupec indexu nebo primárního klíče. Horní mez oddílu a dolní mez oddílu (volitelné): Určete, jestli chcete určit krok oddílu. To není pro filtrování řádků v tabulce, všechny řádky v tabulce budou rozděleny a zkopírovány. Pokud není zadáno, aktivita kopírování automaticky rozpozná hodnoty. Pokud má například sloupec oddílu ID hodnoty od 1 do 100 a dolní mez nastavíte jako 20 a horní mez jako 80, přičemž paralelní kopírování je 4, služba načte data o 4 oddílech – ID v rozsahu <=20, [21, 50], [51, 80] a >=81. |
| Načtěte velké množství dat pomocí vlastního dotazu bez fyzického dělení, s použitím celočíselného sloupce nebo sloupce s datem či datem a časem pro rozdělení dat. |
Možnosti oddílu: Dynamický rozsah oddílu Dotaz: SELECT * FROM <TableName> WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>.Sloupec pro rozdělení: Zadejte sloupec použitý k rozdělení dat. Horní mez oddílu a dolní mez oddílu (volitelné): Určete, jestli chcete určit krok oddílu. To není pro filtrování řádků v tabulce, všechny řádky ve výsledku dotazu budou rozděleny a zkopírovány. Pokud není zadáno, aktivita kopírování automaticky rozpozná hodnotu. Pokud má například sloupec oddílu 'ID' hodnoty od 1 do 100 a dolní mez nastavíte jako 20 a horní mez 80, s paralelním kopírováním nastaveným na 4, služba načte data pomocí 4 oddílů s ID v rozsahu <=20, [21, 50], [51, 80] a >=81. Tady jsou další ukázkové dotazy pro různé scénáře: 1. Dotaz na celou tabulku: SELECT * FROM <TableName> WHERE ?DfDynamicRangePartitionCondition2. Dotaz z tabulky s výběrem sloupce a dalšími filtry klauzule where: SELECT <column_list> FROM <TableName> WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>3. Dotaz s poddotazy: SELECT <column_list> FROM (<your_sub_query>) AS T WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>4. Dotaz s partiční v poddotazu: SELECT <column_list> FROM (SELECT <your_sub_query_column_list> FROM <TableName> WHERE ?DfDynamicRangePartitionCondition) AS T |
Osvědčené postupy pro načtení dat s možností dělení:
- Zvolte výrazný sloupec jako sloupec oddílu (například primární klíč nebo jedinečný klíč), abyste se vyhnuli nerovnoměrné distribuci dat.
- Pokud má tabulka vestavěný oddíl, použijte možnost "Fyzické oddíly tabulky" ke zlepšení výkonu.
- Pokud ke kopírování dat používáte Azure Integration Runtime, můžete nastavit větší jednotky integrace dat Data Integration Units (DIU)" (>4) tak, aby využívaly více výpočetních prostředků. Zkontrolujte tam příslušné scénáře.
- "Stupeň paralelismu kopírování" určuje počet oddílů; pokud je tato hodnota nastavena příliš vysoko, může někdy snížit výkon. Doporučujeme nastavit tuto hodnotu na (DIU nebo počet uzlů místního prostředí IR) krát (2 až 4)."
- Všimněte si, že Azure Synapse Analytics může najednou spustit maximálně 32 dotazů, nastavení příliš velkého "stupně paralelismu kopírování" může způsobit problém s omezením prostředků Synapse.
Příklad: Úplné načtení z velké tabulky s fyzickými oddíly
"source": {
    "type": "SqlDWSource",
    "partitionOption": "PhysicalPartitionsOfTable"
}
Příklad: Dotaz s particí dynamického rozsahu
"source": {
    "type": "SqlDWSource",
    "query": "SELECT * FROM <TableName> WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>",
    "partitionOption": "DynamicRange",
    "partitionSettings": {
        "partitionColumnName": "<partition_column_name>",
        "partitionUpperBound": "<upper_value_of_partition_column (optional) to decide the partition stride, not as data filter>",
        "partitionLowerBound": "<lower_value_of_partition_column (optional) to decide the partition stride, not as data filter>"
    }
}
Ukázkový dotaz pro kontrolu fyzického oddílu
SELECT DISTINCT s.name AS SchemaName, t.name AS TableName, c.name AS ColumnName, CASE WHEN c.name IS NULL THEN 'no' ELSE 'yes' END AS HasPartition
FROM sys.tables AS t
LEFT JOIN sys.objects AS o ON t.object_id = o.object_id
LEFT JOIN sys.schemas AS s ON o.schema_id = s.schema_id
LEFT JOIN sys.indexes AS i ON t.object_id = i.object_id
LEFT JOIN sys.index_columns AS ic ON ic.partition_ordinal > 0 AND ic.index_id = i.index_id AND ic.object_id = t.object_id
LEFT JOIN sys.columns AS c ON c.object_id = ic.object_id AND c.column_id = ic.column_id
LEFT JOIN sys.types AS y ON c.system_type_id = y.system_type_id
WHERE s.name='[your schema]' AND t.name = '[your table name]'
Pokud tabulka obsahuje fyzický oddíl, zobrazí se hodnota HasPartition jako ano.
Použití příkazu COPY k načtení dat do Azure Synapse Analytics
Použití příkazu COPY je jednoduchý a flexibilní způsob načtení dat do Azure Synapse Analytics s vysokou propustností. Chcete-li zjistit více podrobností, podívejte se na hromadné načítání dat pomocí příkazu COPY.
- Pokud jsou vaše zdrojová data v Azure Blob Storage nebo Azure Data Lake Storage Gen2 a formát je kompatibilní s příkazem COPY, můžete pomocí aktivity kopírování přímo vyvolat příkaz COPY, aby Azure Synapse Analytics načetl data ze zdroje. Podrobnosti najdete v tématu Přímé kopírování pomocí příkazu COPY.
- Pokud vaše zdrojové úložiště dat a formát není původně podporováno příkazem COPY, použijte místo toho funkci fázované kopie pomocí funkce příkazu COPY. Funkce fázovaného kopírování také poskytuje lepší propustnost. Automaticky převede data do formátu kompatibilního s příkazem COPY, uloží data do Azure Blob Storage a potom zavolá příkaz COPY, který načte data do Azure Synapse Analytics.
Tip
Při použití příkazu COPY s Azure Integration Runtime jsou efektivní jednotky integrace dat (DIU) vždy 2. Ladění DIU nemá vliv na výkon, protože načítání dat z úložiště využívá modul Azure Synapse.
Přímé kopírování pomocí příkazu COPY
Azure Synapse Analytics příkaz COPY přímo podporuje Azure Blob a Azure Data Lake Storage Gen2. Pokud zdrojová data splňují kritéria popsaná v této části, zkopírujte příkaz COPY přímo ze zdrojového úložiště dat do Azure Synapse Analytics. V opačném případě použijte fázovanou kopii pomocí příkazu COPY. Služba zkontroluje nastavení a nezdaří spuštění aktivity kopírování, pokud kritéria nejsou splněna.
Zdrojová propojená služba a formát mají následující typy a metody ověřování:
Podporovaný typ zdrojového úložiště dat Podporovaný formát Podporovaný typ ověřování zdroje Azure Blob Text s oddělovači Ověřování pomocí klíče účtu, ověřování pomocí sdíleného přístupového podpisu, ověřování instančního objektu (pomocí ServicePrincipalKey), ověřování spravované identity přiřazené systémem Parquet Ověřování pomocí klíče účtu, ověřování pomocí sdíleného přístupového podpisu ORC Ověřování pomocí klíče účtu, ověřování pomocí sdíleného přístupového podpisu Azure Data Lake Storage Gen2 Text s oddělovači
Parquet
ORCOvěřování pomocí klíče účtu, ověřování instančního objektu (pomocí ServicePrincipalKey), ověřování pomocí sdíleného přístupového podpisu, ověřování spravované identity přiřazené systémem Důležité
- Při použití ověřování spravované identity pro propojenou službu úložiště se dozvíte potřebné konfigurace pro Azure Blob a Azure Data Lake Storage Gen2.
- Pokud je váš Azure Storage nakonfigurován s koncovým bodem služby virtuální sítě, musíte pro účet úložiště použít ověřování spravované identity s povolenou důvěryhodnou službou Microsoft, podívejte se na Dopady použití koncových bodů služby virtuální sítě s úložištěm Azure.
Nastavení formátu jsou následující:
- Pro Parquet:
compressionmůže být bez komprese, Snappy neboGZip. - Pro ORC:
compressionmůže být bez komprese,zlibnebo Snappy. -
Text s oddělovači:
-
rowDelimiterje explicitně nastaven jako jeden znak nebo \r\n, výchozí hodnota není podporována. -
nullValueje ponechán jako výchozí nebo je nastaven na prázdný řetězec (""). -
encodingNameje ve výchozím nastavení nebo nastaven na utf-8 nebo utf-16. -
escapeCharmusí být stejný jakoquoteChara není prázdný. -
skipLineCountje ponechán jako výchozí nebo je nastaven na hodnotu 0. -
compressionmůže být žádná komprese neboGZip.
-
- Pro Parquet:
Pokud je zdrojem složka,
recursivev aktivitě kopírování musí být nastavena na true awildcardFilenamemusí být*nebo*.*.wildcardFolderPath,wildcardFilename(jiné než*nebo*.*),modifiedDateTimeStart,modifiedDateTimeEnd,prefixenablePartitionDiscoveryaadditionalColumnsnejsou zadány.
V aktivitě kopírování jsou podporována následující nastavení příkazu Copy allowCopyCommand:
| Vlastnost | Popis | Povinné |
|---|---|---|
| defaultValues | Určuje výchozí hodnoty pro každý cílový sloupec v Azure Synapse Analytics. Výchozí hodnoty ve vlastnosti přepíší omezení DEFAULT nastavené v datovém skladu a sloupec identity nemůže mít výchozí hodnotu. | Ne |
| dalšíMožnosti | Další možnosti, které se předají příkazu Azure Synapse Analytics COPY přímo v klauzuli With v příkazu COPY. Podle potřeby uvozujte hodnotu tak, aby odpovídala požadavkům příkazu COPY. | Ne |
"activities":[
    {
        "name": "CopyFromAzureBlobToSQLDataWarehouseViaCOPY",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "ParquetDataset",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "AzureSQLDWDataset",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "ParquetSource",
                "storeSettings":{
                    "type": "AzureBlobStorageReadSettings",
                    "recursive": true
                }
            },
            "sink": {
                "type": "SqlDWSink",
                "allowCopyCommand": true,
                "copyCommandSettings": {
                    "defaultValues": [
                        {
                            "columnName": "col_string",
                            "defaultValue": "DefaultStringValue"
                        }
                    ],
                    "additionalOptions": {
                        "MAXERRORS": "10000",
                        "DATEFORMAT": "'ymd'"
                    }
                }
            },
            "enableSkipIncompatibleRow": true
        }
    }
]
Fázované kopírování pomocí příkazu COPY
Pokud zdrojová data nejsou nativně kompatibilní s příkazem COPY, povolte kopírování dat prostřednictvím meziprocesního úložiště Azure Blob Storage nebo Azure Data Lake Storage Gen2 (nelze použít Azure Premium Storage). V takovém případě služba automaticky převede data tak, aby splňovala požadavky na formát dat příkazu COPY. Potom vyvolá příkaz COPY, který načte data do Azure Synapse Analytics. Nakonec vyčistí dočasná data z úložiště. Podrobnosti o kopírování dat prostřednictvím přípravného procesu najdete v části Fázovaná kopie .
Pokud chcete tuto funkci použít, vytvořte propojenou službu Azure Blob Storage nebo Azure Data Lake Storage Gen2 s autentizací pomocí klíče účtu nebo identity spravované systémem, která odkazuje na účet úložiště Azure jako na dočasné úložiště.
Důležité
- Při použití ověřování spravované identity pro fázovou propojenou službu naučte se potřebné konfigurace pro Azure Blob a Azure Data Lake Storage Gen2. Musíte také udělit oprávnění spravované identitě pracovního prostoru Azure Synapse Analytics v přípravném Azure Blob Storage nebo Azure Data Lake Storage Gen2 účtu. Informace o udělení tohoto oprávnění najdete v tématu Udělení oprávnění pro spravovanou identitu pracovního prostoru.
- Pokud je přípravné úložiště Azure nakonfigurováno s koncovým bodem služby virtuální sítě (VNet), musíte pro účet úložiště použít ověřování spravované identity s povolením 'důvěryhodná služba Microsoft'. Přečtěte si Vliv používání koncových bodů služby VNet s Azure Storage.
Důležité
Pokud je přípravná Azure Storage nakonfigurovaná se spravovaným privátním koncovým bodem a má povolenou bránu firewall úložiště, musíte použít ověřování spravované identity a udělit službě Synapse SQL Server službě Synapse oprávnění čtenáře dat objektů blob služby Storage, aby se zajistilo, že bude mít přístup k fázovaným souborům během načítání příkazu COPY.
"activities":[
    {
        "name": "CopyFromSQLServerToSQLDataWarehouseViaCOPYstatement",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "SQLServerDataset",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "AzureSQLDWDataset",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SqlSource",
            },
            "sink": {
                "type": "SqlDWSink",
                "allowCopyCommand": true
            },
            "stagingSettings": {
                "linkedServiceName": {
                    "referenceName": "MyStagingStorage",
                    "type": "LinkedServiceReference"
                }
            }
        }
    }
]
Načtení dat do Azure Synapse Analytics pomocí PolyBase
Použití PolyBase představuje efektivní způsob načtení velkého množství dat do Azure Synapse Analytics s vysokou propustností. Místo výchozího mechanismu BULKINSERT uvidíte velké zvýšení propustnosti pomocí PolyBase.
- Pokud jsou zdrojová data v Azure objektu blob nebo Azure Data Lake Storage Gen2 a formát je kompatibilní s PolyBase, můžete pomocí aktivity kopírování přímo vyvolat PolyBase a umožnit Azure Synapse Analytics načíst data přímo ze zdroje. Podrobnosti najdete v tématu Přímé kopírování pomocí PolyBase.
- Pokud polyBase původně nepodporuje vaše zdrojové úložiště a formát dat, použijte místo toho fázovanou kopii pomocí funkce PolyBase . Funkce fázovaného kopírování také poskytuje lepší propustnost. Automaticky převede data do formátu kompatibilního s PolyBase, uloží data do Azure Blob Storage a pak zavolá PolyBase k načtení dat do Azure Synapse Analytics.
Tip
Přečtěte si další informace o osvědčených postupech pro používání PolyBase. Při použití PolyBase s Azure Integration Runtime je efektivní Data Integration Units (DIU) pro přímé nebo fázované přenosy mezi úložištěm a Synapse vždy 2. Ladění DIU nemá vliv na výkon, protože načítání dat z úložiště využívá modul Synapse.
V případě aktivity kopírování se podporují následující nastavení PolyBase: polyBaseSettings
| Vlastnost | Popis | Povinné |
|---|---|---|
| rejectValue | Určuje počet nebo procento řádků, které lze odmítnout před selháním dotazu. Další informace o možnostech zamítnutí PolyBase najdete v části Argumenty CREATE EXTERNAL TABLE (Transact-SQL). Povolené hodnoty jsou 0 (výchozí), 1, 2 atd. |
Ne |
| TypOdmítnutí | Určuje, zda volba rejectValue je literální hodnota nebo procento. Povolené hodnoty jsou Hodnota (výchozí) a Procento. |
Ne |
| rejectSampleValue | Určuje počet řádků, které se mají načíst, než PolyBase přepočítá procento odmítnutých řádků. Povolené hodnoty jsou 1, 2 atd. |
Ano, pokud je rejectTypeprocento. |
| useTypeDefault | Určuje, jak PolyBase zpracovává chybějící hodnoty v textových souborech s oddělovači při načítání dat z textového souboru. Další informace o této vlastnosti najdete v části Argumenty v FORMÁT EXTERNÍHO SOUBORU (Transact-SQL). Povolené hodnoty jsou True a False (výchozí). |
Ne |
Přímé kopírování pomocí PolyBase
Azure Synapse Analytics PolyBase přímo podporuje Azure Blob Storage a Azure Data Lake Storage Gen2. Pokud zdrojová data splňují kritéria popsaná v této části, použijte PolyBase k přímému kopírování z úložiště zdrojových dat do Azure Synapse Analytics. V opačném případě použijte fázovanou kopii pomocí PolyBase.
Tip
Pokud chcete data efektivně kopírovat do Azure Synapse Analytics, přečtěte si další informace o Azure Data Factory ještě více zjednodušuje odhalování poznatků z dat při použití Datové Jezero Store s Azure Synapse Analytics.
Pokud požadavky nejsou splněné, služba zkontroluje nastavení a automaticky se vrátí do mechanismu BULKINSERT pro přesun dat.
Zdrojová propojená služba má následující typy a metody ověřování:
Podporovaný typ zdrojového úložiště dat Podporovaný typ ověřování zdroje Azure Blob Ověřování pomocí klíče účtu, ověřování spravované identity přiřazené systémem Azure Data Lake Storage Gen2 Ověřování pomocí klíče účtu, ověřování spravované identity přiřazené systémem Důležité
- Při použití ověřování spravované identity pro propojenou službu úložiště se dozvíte potřebné konfigurace pro Azure Blob a Azure Data Lake Storage Gen2.
- Pokud je váš Azure Storage nakonfigurován s koncovým bodem služby virtuální sítě, musíte pro účet úložiště použít ověřování spravované identity s povolenou důvěryhodnou službou Microsoft, podívejte se na Dopady použití koncových bodů služby virtuální sítě s úložištěm Azure.
Formát zdrojových dat je Parquet, ORC nebo oddělený text s následujícími konfiguracemi:
- Cesta ke složce neobsahuje filtr zástupných znaků.
- Název souboru je prázdný nebo odkazuje na jeden soubor. Pokud v aktivitě kopírování zadáte název souboru se zástupným znakem, může být pouze
*nebo*.*. -
rowDelimiterje výchozí, \n, \r\n nebo \r. -
nullValueje ponechána jako výchozí nebo nastavena na prázdný řetězec (""), atreatEmptyAsNullje ponechána jako výchozí nebo nastavena na hodnotu true. -
encodingNameje ve výchozím nastavení nebo nastaven na utf-8. -
quoteChar,escapeCharaskipLineCountnejsou zadány. PolyBase podporuje přeskočení řádku záhlaví, který lze nakonfigurovat jakofirstRowAsHeader. -
compressionmůže být bez komprese,GZip, nebo Deflate.
Pokud je zdrojem složka,
recursivemusí být v aktivitě kopírování nastavena hodnota true.wildcardFolderPath,wildcardFilename,modifiedDateTimeStart,modifiedDateTimeEnd,prefix,enablePartitionDiscovery, aadditionalColumnsnejsou zadány.
Poznámka:
Pokud je zdrojem složka, všimněte si, že PolyBase načte soubory ze složky a všech jejích podsložek a nenačítá data ze souborů, pro které název souboru začíná podtržením (_) nebo tečkou (.), jak je uvedeno zde – argument LOCATION.
"activities":[
    {
        "name": "CopyFromAzureBlobToSQLDataWarehouseViaPolyBase",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "ParquetDataset",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "AzureSQLDWDataset",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "ParquetSource",
                "storeSettings":{
                    "type": "AzureBlobStorageReadSettings",
                    "recursive": true
                }
            },
            "sink": {
                "type": "SqlDWSink",
                "allowPolyBase": true
            }
        }
    }
]
Fázované kopírování pomocí PolyBase
Pokud zdrojová data nejsou nativně kompatibilní s PolyBase, aktivujte kopírování dat prostřednictvím dočasného úložiště Azure Blob nebo Azure Data Lake Storage Gen2 (není možné použít Azure Premium Storage). V tomto případě služba automaticky převede data tak, aby splňovala požadavky na formát dat PolyBase. Potom vyvolá PolyBase k načtení dat do Azure Synapse Analytics. Nakonec vyčistí dočasná data z úložiště. Podrobnosti o kopírování dat prostřednictvím přípravného procesu najdete v části Fázovaná kopie .
Pokud chcete tuto funkci použít, vytvořte propojenou službu Azure Blob Storage nebo propojenou službu Azure Data Lake Storage Gen2 s použitím klíče účtu nebo ověřování spravované identity, která odkazuje na účet úložiště Azure jako na dočasné úložiště.
Důležité
- Při použití ověřování spravované identity pro fázovou propojenou službu naučte se potřebné konfigurace pro Azure Blob a Azure Data Lake Storage Gen2. Musíte také udělit oprávnění spravované identitě pracovního prostoru Azure Synapse Analytics v přípravném Azure Blob Storage nebo Azure Data Lake Storage Gen2 účtu. Informace o udělení tohoto oprávnění najdete v tématu Udělení oprávnění pro spravovanou identitu pracovního prostoru.
- Pokud je přípravné úložiště Azure nakonfigurováno s koncovým bodem služby virtuální sítě (VNet), musíte pro účet úložiště použít ověřování spravované identity s povolením 'důvěryhodná služba Microsoft'. Přečtěte si Vliv používání koncových bodů služby VNet s Azure Storage.
Důležité
Pokud je přípravné úložiště Azure nakonfigurováno se spravovaným privátním koncovým bodem a má povolenou bránu firewall, musíte použít ověřování spravované identity a udělit SQL serveru Synapse oprávnění Storage Blob Data Reader, aby bylo zajištěno, že během načítání PolyBase má přístup k fázovaným souborům.
"activities":[
    {
        "name": "CopyFromSQLServerToSQLDataWarehouseViaPolyBase",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "SQLServerDataset",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "AzureSQLDWDataset",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SqlSource",
            },
            "sink": {
                "type": "SqlDWSink",
                "allowPolyBase": true
            },
            "enableStaging": true,
            "stagingSettings": {
                "linkedServiceName": {
                    "referenceName": "MyStagingStorage",
                    "type": "LinkedServiceReference"
                }
            }
        }
    }
]
Osvědčené postupy pro používání PolyBase
Následující části obsahují nejlepší postupy kromě těch, které jsou uvedeny v nejlepších postupech pro Azure Synapse Analytics.
Požadované oprávnění k databázi
Pokud chcete použít PolyBase, musí mít uživatel, který načítá data do Azure Synapse Analytics, oprávnění "CONTROL v cílové databázi. Jedním ze způsobů, jak toho dosáhnout, je přidat uživatele jako člena db_owner role. Zjistěte, jak to udělat v přehledu Azure Synapse Analytics.
Omezení velikosti řádků a datového typu
Načítání pomocí PolyBase je omezeno na řádky menší než 1 MB. Nedá se použít k načtení do VARCHR(MAX), NVARCHAR(MAX) nebo VARBINARY(MAX). Další informace najdete v tématu Azure Synapse Analytics limity kapacity služby.
Pokud zdrojová data mají řádky větší než 1 MB, můžete zdrojové tabulky svisle rozdělit na několik malých. Ujistěte se, že největší velikost každého řádku nepřekračuje limit. Menší tabulky je pak možné načíst pomocí PolyBase a sloučit je do Azure Synapse Analytics.
Alternativně, pro data s těmito širokými sloupci můžete data načíst jiným způsobem než pomocí PolyBase, a to vypnutím nastavení "povolit PolyBase".
Azure Synapse Analytics třída zdrojů
Pokud chcete dosáhnout co nejlepší propustnosti, přiřaďte uživateli větší třídu prostředků, která načítá data do Azure Synapse Analytics prostřednictvím PolyBase.
Řešení potíží s PolyBase
Načítání do desetinného sloupce
Pokud jsou zdrojová data v textovém formátu nebo jiných nekompatibilních úložištích PolyBase (pomocí fázované kopie a PolyBase) a obsahuje prázdnou hodnotu, která se má načíst do Azure Synapse Analytics desetinného sloupce, může se zobrazit následující chyba:
ErrorCode=FailedDbOperation, ......HadoopSqlException: Error converting data type VARCHAR to DECIMAL.....Detailed Message=Empty string can't be converted to DECIMAL.....
Řešením je zrušit výběr možnosti "Použít výchozí typ" (nastavit na false) v sinku aktivity kopírování, v nastavení PolyBase.> "USE_TYPE_DEFAULT" je nativní konfigurace PolyBase, která určuje, jak zpracovat chybějící hodnoty v textových souborech s oddělovači, když PolyBase načte data z textového souboru.
Kontrola vlastnosti tableName v Azure Synapse Analytics
Následující tabulka uvádí příklady, jak zadat vlastnost tableName v datové sadě JSON. Zobrazuje několik kombinací názvů schémat a tabulek.
| Schéma databáze | Název tabulky | tableName JSON – vlastnost |
|---|---|---|
| dbo | MyTable | Tabulka nebo dbo. MyTable nebo [dbo]. [Moje tabulka] |
| dbo1 | MyTable | dbo1. MyTable nebo [dbo1]. [Moje tabulka] |
| dbo | My.Table | [My.Table] nebo [dbo]. [My.Table] |
| dbo1 | My.Table | [dbo1]. [My.Table] |
Pokud se zobrazí následující chyba, může být problém hodnota, kterou jste zadali pro vlastnost tableName . Správný způsob zadání hodnot pro vlastnost tableName JSON najdete v předchozí tabulce.
Type=System.Data.SqlClient.SqlException,Message=Invalid object name 'stg.Account_test'.,Source=.Net SqlClient Data Provider
Sloupce s výchozími hodnotami
Funkce PolyBase v současné době přijímá pouze stejný počet sloupců jako v cílové tabulce. Příkladem je tabulka se čtyřmi sloupci, kde je jedna z nich definována s výchozí hodnotou. Vstupní data musí mít stále čtyři sloupce. Vstupní datová sada se třemi sloupci přináší chybu podobnou následující zprávě:
All columns of the table must be specified in the INSERT BULK statement.
Hodnota NULL je speciální forma výchozí hodnoty. Pokud má sloupec hodnotu null, můžou být vstupní data v objektu blob pro tento sloupec prázdná. Ve vstupní datové sadě ale nemůže chybět. PolyBase vloží hodnotu NULL pro chybějící hodnoty v Azure Synapse Analytics.
Přístup k externímu souboru se nezdařil.
Pokud se zobrazí následující chyba, ujistěte se, že používáte ověřování spravované identity a udělili čtenáři dat objektů blob služby Storage oprávnění ke spravované identitě pracovního prostoru Azure Synapse.
Job failed due to reason: at Sink '[SinkName]': shaded.msdataflow.com.microsoft.sqlserver.jdbc.SQLServerException: External file access failed due to internal error: 'Error occurred while accessing HDFS: Java exception raised on call to HdfsBridge_IsDirExist. Java exception message:\r\nHdfsBridge::isDirExist
Další informace najdete v tématu Udělení oprávnění spravované identitě po vytvoření pracovního prostoru.
Mapování vlastností toku dat
Při transformaci dat při mapování toku dat můžete číst a zapisovat do tabulek z Azure Synapse Analytics. Další informace najdete v tématu transformace zdroje a transformace jímky v mapování toků dat.
Transformace zdroje
Nastavení specifická pro Azure Synapse Analytics jsou k dispozici na kartě Zdrojové možnosti transformace zdroje.
Vstup Vyberte, jestli zdroj nasměrujete na tabulku (ekvivalent ) Select * from <table-name>nebo zadáte vlastní dotaz SQL.
Povolit fázi přípravy Důrazně doporučujeme tuto možnost použít v produkčních úlohách se systémy Azure Synapse Analytics. Když spustíte aktivitu toku dat se zdroji Azure Synapse Analytics z kanálu, zobrazí se výzva k zadání účtu úložiště pro přechodné umístění a ten bude použit pro načítání přechodných dat. Jedná se o nejrychlejší mechanismus načítání dat z Azure Synapse Analytics.
- Při použití ověřování spravované identity pro propojenou službu úložiště se dozvíte potřebné konfigurace pro Azure Blob a Azure Data Lake Storage Gen2.
- Pokud je váš Azure Storage nakonfigurován s koncovým bodem služby virtuální sítě, musíte pro účet úložiště použít ověřování spravované identity s povolenou důvěryhodnou službou Microsoft, podívejte se na Dopady použití koncových bodů služby virtuální sítě s úložištěm Azure.
- Pokud použijete jako zdroj Azure Synapse serverless fond SQL, povolení přípravného režimu se nepodporuje.
Dotaz: Pokud ve vstupním poli vyberete Dotaz, zadejte dotaz SQL pro zdroj. Toto nastavení přepíše všechny tabulky, které jste zvolili v datové sadě. Klauzule Order By se tady nepodporují, ale můžete nastavit úplný příkaz SELECT FROM. Můžete také použít uživatelem definované funkce tabulek. select * from udfGetData() je UDF v SQL, který vrací tabulku. Tento dotaz vytvoří zdrojovou tabulku, kterou můžete použít ve svém toku dat. Použití dotazů je také skvělý způsob, jak snížit počet řádků pro testování nebo pro vyhledávání.
Příklad SQL: Select * from MyTable where customerId > 1000 and customerId < 2000
Velikost dávky: Zvolte velikost dávky pro rozložení velkých dat do čtecích segmentů. V tocích dat se toto nastavení použije k nastavení sloupcového ukládání do mezipaměti Sparku. Toto je pole možnosti, které použije výchozí hodnoty Sparku, pokud zůstane prázdné.
Úroveň izolace: Výchozí hodnota pro zdroje SQL v mapování toku dat je nepotvrzená. Úroveň izolace můžete změnit tady na jednu z těchto hodnot:
- Přečteno potvrzeno
- Nepotvrzené čtení
- Opakovatelné čtení
- Serializovatelný
- Žádné (ignorovat úroveň izolace)

Transformace jímky
Nastavení specifická pro Azure Synapse Analytics jsou k dispozici na kartě Nastavení transformace jímky.
Metoda aktualizace: Určuje, jaké operace jsou povoleny v cíli databáze. Výchozí hodnota je povolit pouze vkládání. Pokud chcete aktualizovat, vložit nebo odstranit řádky, je pro tyto akce potřeba transformace alter-row. Pro aktualizace, upserty a odstranění je nutné nastavit klíčový sloupec nebo sloupce, aby bylo možné určit, který řádek se má změnit.
Akce tabulky: Určuje, zda se mají před zápisem znovu vytvořit nebo odebrat všechny řádky z cílové tabulky.
- Žádné: V tabulce nebude provedena žádná akce.
- Rekonstrukce: Tabulka bude zrušena a znovu vytvořena. Vyžaduje se při dynamickém vytváření nové tabulky.
- Truncate: Všechny řádky v cílové tabulce budou odstraněny.
Enable staging: To umožňuje načítání do Azure Synapse Analytics fondů SQL pomocí příkazu kopírování a doporučuje se pro většinu jímek Synapse. Přípravné úložiště je nakonfigurované v aktivitě Execute Tok dat.
- Při použití ověřování spravované identity pro propojenou službu úložiště se dozvíte potřebné konfigurace pro Azure Blob a Azure Data Lake Storage Gen2.
- Pokud je váš Azure Storage nakonfigurován s koncovým bodem služby virtuální sítě, musíte pro účet úložiště použít ověřování spravované identity s povolenou důvěryhodnou službou Microsoft, podívejte se na Dopady použití koncových bodů služby virtuální sítě s úložištěm Azure.
Velikost dávky: Určuje, kolik řádků se zapisuje v každém kontejneru. Větší velikosti dávek zlepšují kompresi a optimalizaci paměti, ale při ukládání dat do mezipaměti může dojít k chybám kvůli vyčerpání paměti.
Použít schéma jímky: Ve výchozím nastavení se ve schématu jímky vytvoří dočasná tabulka jako pracovní. Alternativně můžete zrušit zaškrtnutí možnosti Použít schéma cílového a místo toho v Vybrat uživatelské schéma DB zadat název schématu, pod kterým Služba Data Factory vytvoří pracovní tabulku pro načtení zdrojových dat a automaticky je po dokončení odstraní. Ujistěte se, že máte v databázi oprávnění k vytvoření tabulky, a upravte oprávnění ke schématu.

SQL skripty před a po: Zadejte víceřádkové SQL skripty, které se spustí před (předběžné zpracování) a po (následné zpracování) zapsání dat do vaší cílové databáze.

Tip
- Doporučujeme rozdělit jednotlivé skripty s více příkazy do několika samostatných dávek.
- Pouze příkazy DDL (Data Definition Language) a DML (Data Manipulation Language), které vracejí jednoduchý počet aktualizací, mohou být spuštěny jako součást dávky. Další informace o provádění dávkových operací
Zpracování chybového řádku
Při zápisu do Azure Synapse Analytics může dojít k selhání určitých řádků dat kvůli omezením nastaveným cílem. Mezi běžné chyby patří:
- Řetězcová nebo binární data by byla v tabulce zkrácena.
- Hodnotu NULL nelze vložit do sloupce.
- Převod se nezdařil při převodu hodnoty na datový typ
Ve výchozím nastavení se spuštění toku dat zastaví při první chybě, na kterou narazí. Můžete se rozhodnout pokračovat při chybě, což umožňuje dokončení datového toku, ačkoliv mají jednotlivé řádky chyby. Služba poskytuje různé možnosti, jak tyto řádky chyb zpracovat.
Potvrzení transakce: Zvolte, zda se vaše data zapisuje do jedné transakce nebo v dávkách. Jedna transakce zajistí lepší výkon a ostatní nebudou vidět žádná zapsaná data, dokud se transakce nedokončí. Dávkové transakce mají horší výkon, ale můžou fungovat pro velké datové sady.
Output odmítnutá data: Pokud je tato možnost povolena, můžete chybové řádky vypsat do souboru CSV ve vybraném účtu Azure Blob Storage nebo Azure Data Lake Storage Gen2. Tím se zapíšou řádky chyb se třemi dalšími sloupci: operace SQL, jako je INSERT nebo UPDATE, kód chyby toku dat a chybová zpráva na řádku.
Nahlášení úspěchu při chybě: Pokud je tok dat povolený, označí se jako úspěšný i v případě, že jsou nalezeny řádky chyb.

Vlastnosti aktivity vyhledávání
Zjistit podrobnosti o vlastnostech můžete v aktivitě Vyhledávání.
Vlastnosti aktivity GetMetadata
Podrobnosti o vlastnostech najdete v aktivitě GetMetadata.
Mapování datových typů pro Azure Synapse Analytics
Při kopírování dat z nebo do Azure Synapse Analytics se používají následující mapování z datových typů Azure Synapse Analytics na dočasné datové typy v Azure Data Factory. Tato mapování se také používají při kopírování dat z nebo do Azure Synapse Analytics pomocí pipelines Synapse, protože pipelines také implementují Azure Data Factory v rámci Azure Synapse. Podívejte se na mapování schématu a datového typu a zjistěte, jak aktivita kopírování mapuje zdrojové schéma a datový typ na jímku.
Tip
Pro více informací o podporovaných datových typech v Azure Synapse Analytics a řešeních pro nepodporované datové typy si přečtěte článek Table data types in Azure Synapse Analytics.
| datový typ Azure Synapse Analytics | Dočasný datový typ služby Data Factory |
|---|---|
| bigint | Int64 |
| binární | Bajt[] |
| bitové | logický |
| char | Řetězec, Znak[] |
| datum | Datum a čas |
| Datum a čas | Datum a čas |
| datetime2 | Datum a čas |
| Datetimeoffset | DateTimeOffset |
| Desetinné číslo | Desetinné číslo |
| Atribut FILESTREAM (varbinary(max)) | Bajt[] |
| Float | Hodnota s dvojitou přesností |
| bitová kopie | Bajt[] |
| int | Int32 |
| peníze | Desetinné číslo |
| nchar | Řetězec, Znak[] |
| numerické | Desetinné číslo |
| nvarchar | Řetězec, Znak[] |
| skutečný | Jednotlivý |
| rowversion | Bajt[] |
| smalldatetime | Datum a čas |
| smallint | Int16 |
| drobné peníze | Desetinné číslo |
| čas | TimeSpan |
| tinyint | Byte |
| jedinečný identifikátor | Guid |
| varbinary | Bajt[] |
| varchar | Řetězec, Znak[] |
Aktualizujte verzi Azure Synapse Analytics
Pokud chcete upgradovat verzi Azure Synapse Analytics, na stránce
Rozdíly mezi doporučenou a starší verzí
Následující tabulka ukazuje rozdíly mezi Azure Synapse Analytics používáním doporučené a starší verze.
| Doporučená verze | Starší verze |
|---|---|
Podpora protokolu TLS 1.3 prostřednictvím encrypt jako strict. |
Protokol TLS 1.3 se nepodporuje. |
Související obsah
Seznam úložišť dat podporovaných jako zdroje a jímky aktivitou kopírování najdete v podporovaných úložištích a formátech dat.