Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Tento článek obsahuje pokyny a strategie, jak nastavit nasazení do více oblastí pro pracovní postupy aplikace logiky ve službě Azure Logic Apps. Nasazení ve více oblastech pomáhá chránit data, rychle se zotavit z havárií a dalších rušivých událostí, obnovit prostředky vyžadované důležitými obchodními funkcemi a udržovat provozní kontinuitu.
Další informace o funkcích spolehlivosti ve službě Azure Logic Apps, včetně odolnosti v rámci oblasti prostřednictvím zón dostupnosti, najdete v tématu Spolehlivost ve službě Azure Logic Apps.
Důležité aspekty
Pracovní postupy aplikací logiky usnadňují integraci a orchestraci dat mezi aplikacemi, cloudovými službami a místními systémy snížením množství kódu, který je potřeba napsat. Při plánování redundance s více oblastmi se ujistěte, že zvažujete nejen aplikace logiky, ale také tyto prostředky Azure, které používáte se svými aplikacemi logiky:
Připojení , která vytvoříte z pracovních postupů aplikací logiky k jiným aplikacím, službám a systémům. Další informace najdete v tématu Připojení k prostředkům dále v tomto tématu.
Místní brány dat, které jsou prostředky Azure, které vytváříte a používáte ve svých aplikacích logiky pro přístup k datům v místních systémech. Každý prostředek brány představuje samostatnou instalaci datové brány na místním počítači. Další informace najdete v části Místní brány dat dále v tomto tématu.
Účty integrace, ve kterých definujete a ukládáte artefakty, které aplikace logiky používají pro scénáře podnikové integrace B2B (Business-to-Business). Můžete například nastavit obnovení po havárii mezi oblastmi pro integrační účty.
Další informace o spolehlivosti v Azure Logic Apps, včetně odolnosti uvnitř oblastí prostřednictvím zón dostupnosti a nasazení ve více oblastech, najdete v tématu Spolehlivost v Azure Logic Apps.
Primární a sekundární nasazení
Nasazení ve více oblastech se skládá z primární a sekundární aplikace logiky. Primární aplikace logiky je nakonfigurovaná tak, aby při selhání přešla na sekundární aplikaci logiky v jiné oblasti, kde je služba Azure Logic Apps také k dispozici. Díky tomu může v případě, že u primárního systému dojde ke ztrátě, narušení provozu nebo selhání, převzít jeho úlohu sekundární systém. Tato strategie nasazení vyžaduje, aby vaše sekundární aplikace logiky a závislé prostředky už byly nasazené a připravené v sekundární oblasti.
Poznámka:
Pokud vaše aplikace logiky také funguje s artefakty B2B, jako jsou obchodní partneři, smlouvy, schémata, mapy a certifikáty, které jsou uložené v účtu integrace, musí váš účet integrace i aplikace logiky používat stejné umístění.
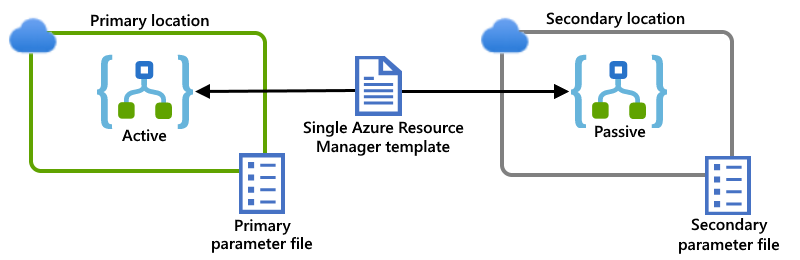
Pokud postupujete podle osvědčených postupů DevOps, už k definování a nasazení aplikací logiky a jejich závislých prostředků používáte šablony Bicep nebo Azure Resource Manageru. Šablony Bicep a Resource Manageru umožňují používat jednu definici nasazení a pak pomocí souborů parametrů poskytnout hodnoty konfigurace, které se mají použít pro každý cíl nasazení. Tato funkce znamená, že můžete nasadit stejnou aplikaci logiky do různých prostředí, například do vývoje, testování a produkce. Stejnou aplikaci logiky můžete také nasadit do různých oblastí Azure, které podporují nasazení ve více oblastech, jako jsou strategie zotavení po havárii.
Aby bylo převzetí služeb při selhání úspěšné, musí vaše aplikace Logic Apps a umístění splňovat tyto požadavky:
Sekundární instance aplikace logiky má přístup ke stejným aplikacím, službám a systémům jako primární instance aplikace logiky.
Obě instance aplikace logiky mají stejný typ hostitele. Obě instance se tedy nasazují do oblastí v globálních víceklientských azure Logic Apps nebo oblastech v Azure Logic Apps s jedním tenantem. Osvědčené postupy a další informace o používání více oblastí pro provozní kontinuitu a zotavení po havárii (BC/DR) najdete v tématu Replikace mezi oblastmi v Azure: Provozní kontinuita a zotavení po havárii.
Příklad: Azure s více tenanty
Tento příklad ukazuje primární a sekundární instance aplikace Azure Logic Apps, které jsou nasazeny do oddělených regionů v globálním víceklientském prostředí Azure. Jedna šablona Resource Manageru definuje instance aplikace logiky i závislé prostředky vyžadované těmito aplikacemi logiky. Samostatné soubory parametrů určují konfigurační hodnoty, které se mají použít pro každé umístění nasazení:
Připojení k prostředkům
Azure Logic Apps poskytuje operace pro více než 1 000 konektorů, které může pracovní postup vaší aplikace logiky používat k práci s dalšími aplikacemi, službami, systémy a dalšími prostředky, jako jsou účty Azure Storage, databáze SQL Serveru, pracovní nebo školní e-mailové účty atd. Pokud vaše aplikace logiky potřebuje přístup k těmto prostředkům, vytvoříte připojení, která ověřují přístup k těmto prostředkům. Každé připojení je samostatný prostředek Azure, který existuje v určitém umístění a není možné ho používat v jiných umístěních.
Pro strategii redundance ve více oblastech zvažte umístění, ve kterých existují závislé prostředky vzhledem k instancím aplikace logiky:
Vaše primární instance a závislé prostředky existují v různých umístěních. V takovém případě se vaše sekundární instance může připojit ke stejným závislým prostředkům nebo koncovým bodům. Měli byste ale vytvořit připojení speciálně pro vaši sekundární instanci. Pokud se tak vaše primární umístění stane nedostupným, nebudou připojení sekundárního serveru ovlivněna.
Předpokládejme například, že se vaše primární aplikace logiky připojuje k externí službě, jako je Salesforce. Dostupnost a umístění externí služby jsou obvykle nezávislé na dostupnosti vaší aplikace logiky. V takovém případě se vaše sekundární instance může připojit ke stejné službě, ale měla by mít v sekundární oblasti vlastní připojení.
Vaše primární instance i závislé prostředky jsou ve stejném umístění. V takovém případě by závislé prostředky měly mít zálohy nebo replikované verze v jiném umístění, aby sekundární instance měla k těmto prostředkům stále přístup.
Předpokládejme například, že se vaše primární aplikace logiky připojuje ke službě, která je ve stejném umístění nebo oblasti, například Azure SQL Database. Pokud se tato celá oblast stane nedostupnou, služba Azure SQL Database v této oblasti je pravděpodobně nedostupná. V takovém případě byste chtěli, aby sekundární instance používala replikovanou nebo záložní databázi v sekundární oblasti spolu s odděleným připojením k této databázi, která se nachází také v sekundární oblasti.
Místní brány dat
Pokud vaše aplikace logiky běží ve víceklientských Azure a potřebuje přístup k místním prostředkům, jako jsou databáze SQL Serveru, musíte místní bránu dat nainstalovat na místní počítač. Potom můžete na portálu Azure vytvořit prostředek brány dat, aby vaše aplikace logiky mohla bránu použít při vytváření připojení k tomuto prostředku.
Prostředek brány dat je přidružený k umístění nebo oblasti Azure, stejně jako prostředek aplikace logiky. Ve strategii redundance ve více oblastech se ujistěte, že brána dat zůstane dostupná pro vaši aplikaci logiky, která se má použít. Vysokou dostupnost brány můžete povolit, když máte více instalací brány.
Aktivní-aktivní vs. role aktivní-pasivní
Primární a sekundární umístění můžete nastavit tak, aby instance aplikace logiky v těchto umístěních mohly hrát tyto role:
| primárně-sekundární role | Popis |
|---|---|
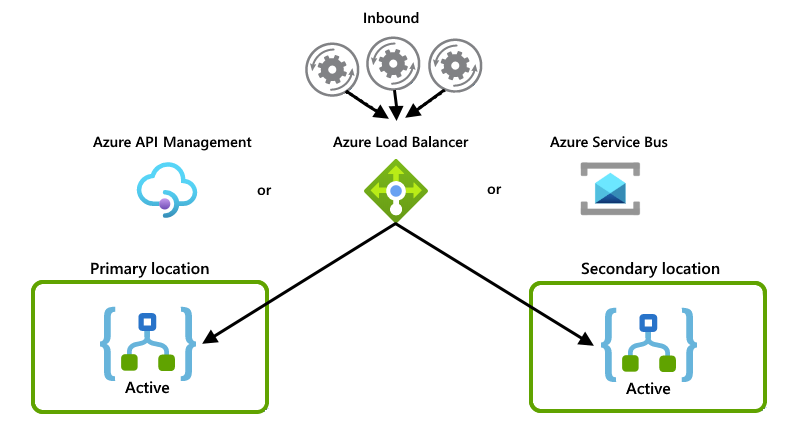
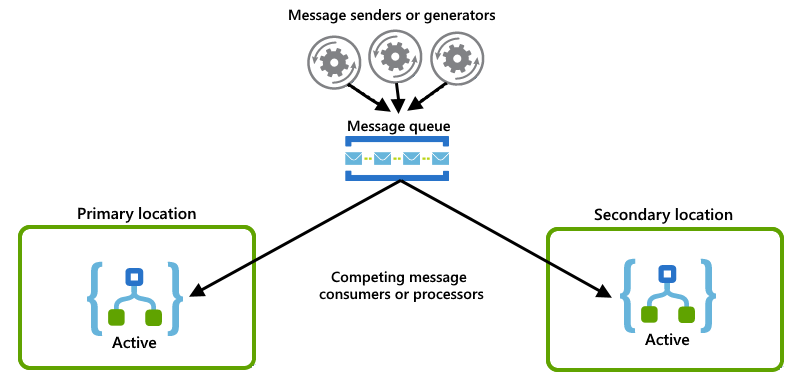
| aktivní – aktivní | Instance primární a sekundární aplikace logiky v obou umístěních aktivně zpracovávají požadavky pomocí některého z těchto vzorů: - Vyrovnávání zatížení: Obě instance můžou naslouchat koncovému bodu a vyrovnávat zatížení provozu každé instance podle potřeby. - Konkurenční konzumenti: Obě instance mohou fungovat jako konkurenční konzumenti, takže budou soupeřit o zprávy ve frontě. Pokud jedna instance selže, převezme druhá instance úlohu. |
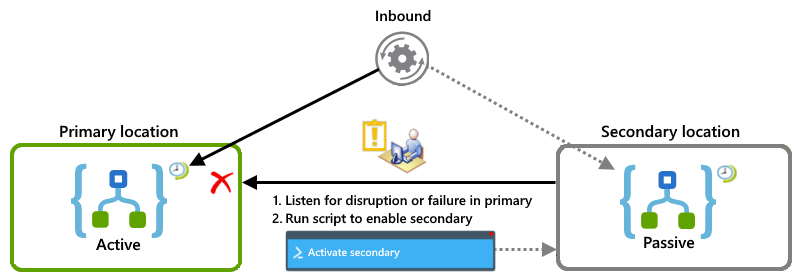
| Aktivní-pasivní | Instance primární aplikace logiky aktivně zpracovává celou úlohu, zatímco sekundární instance je pasivní (zakázaná nebo neaktivní). Sekundární instance čeká na signál, že primární instance není dostupná nebo nefunguje kvůli přerušení či selhání, a převezme pracovní zátěž jako aktivní instance. |
| Kombinace | Některé aplikace typu Logic Apps fungují v režimu aktivní-aktivní, zatímco jiné aplikace typu Logic Apps fungují v režimu aktivní-pasivní. |
Příklady active-active
Tyto příklady ukazují konfiguraci aktivní-aktivní, ve které obě instance aplikace Logic Apps aktivně zpracovávají požadavky nebo zprávy. Některé jiné systémy nebo služby distribuují požadavky nebo zprávy mezi instance, například jednu z těchto možností:
"Fyzický" nástroj pro vyrovnávání zatížení, například kus hardwaru, který směruje provoz
"Měkký" nástroj pro vyrovnávání zatížení, jako je Azure Load Balancer nebo Azure API Management. Pomocí služby API Management můžete zadat zásady, které určují, jak vyrovnávat zatížení příchozího provozu. Nebo můžete použít službu, která podporuje sledování stavu, například Azure Service Bus.
I když tento příklad primárně ukazuje Azure Load Balancer, můžete použít možnost, která nejlépe vyhovuje potřebám vašeho scénáře:
Každá instance aplikace logiky funguje jako příjemce a obě instance soutěží o zprávy z fronty:
Příklady aktivních a pasivních prvků
Tento příklad ukazuje nastavení aktivní-pasivní, kde je instance primární aplikace logiky aktivní v jednom umístění, zatímco sekundární instance zůstává neaktivní v jiném umístění. Pokud dojde k přerušení nebo selhání primárního serveru, můžete mít operátora, který spustí skript, který aktivuje sekundární, aby převzal úlohu.
Kombinace s aktivní-aktivní a aktivní-pasivní
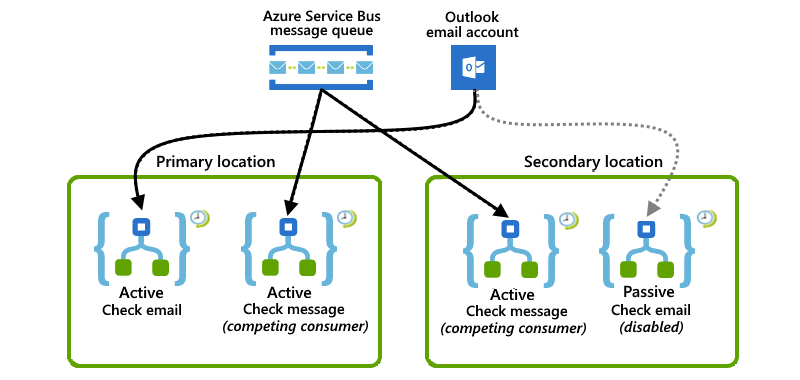
Tento příklad ukazuje kombinované nastavení, kde primární umístění má obě aktivní instance aplikace logiky, zatímco sekundární umístění má instance aplikace logiky typu aktivní-pasivní. Pokud dojde k přerušení nebo selhání primárního umístění, může aktivní aplikace logiky v sekundárním umístění, která už zpracovává částečnou úlohu, převzít celou úlohu.
V primárním umístění naslouchá aktivní aplikace logiky frontě služby Azure Service Bus pro zprávy, zatímco jiná aktivní aplikace logiky kontroluje e-maily pomocí triggeru dotazování v Office 365 Outlooku.
V sekundární lokalitě aktivní aplikace logiky spolupracuje s aplikací logiky v primární lokalitě tím, že naslouchá zprávám ze stejné fronty Service Bus a soutěží o ně. Pasivní neaktivní aplikace logiky mezitím zůstává v pohotovostním režimu, aby kontrolovala e-maily, když primární umístění nebude dostupné, ale je zakázána, aby se zabránilo opětovnému čtení e-mailů.
Stav a historie aplikace logiky
Když se aplikace logiky aktivuje a spustí se, stav aplikace se uloží do stejného umístění, kde se aplikace spustila a nedá se přenést do jiného umístění. Pokud dojde k selhání nebo narušení, veškeré rozpracované instance pracovních postupů budou opuštěny. Když máte nastavená primární a sekundární umístění, začnou v sekundárním umístění běžet nové instance pracovního postupu.
Snížit počet opuštěných rozpracovaných instancí
Pokud chcete minimalizovat počet opuštěných instancí rozpracovaných pracovních postupů, můžete zvolit z různých vzorů zasílání zpráv, které lze implementovat, například:
Pevná šablona směrovacího lístku
Tento podnikový vzor zpráv, který rozdělí obchodní proces do menších fází. Pro každou fázi nastavíte aplikaci logiky, která zpracovává úlohy pro danou fázi. Aplikace logiky používají k vzájemné komunikaci asynchronní protokol zasílání zpráv, jako jsou fronty nebo témata služby Azure Service Bus. Když proces rozdělíte do menších fází, snížíte počet obchodních procesů, které se můžou zaseknout na instanci aplikace logiky, která selhala. Obecné informace o tomto vzoru najdete v tématu Podnikové integrační vzory – Směrovací lístek.
Tento příklad ukazuje vzor směrovacího listu, ve kterém každá aplikace logiky představuje fázi a používá frontu Service Bus ke komunikaci s další aplikací logiky v procesu.
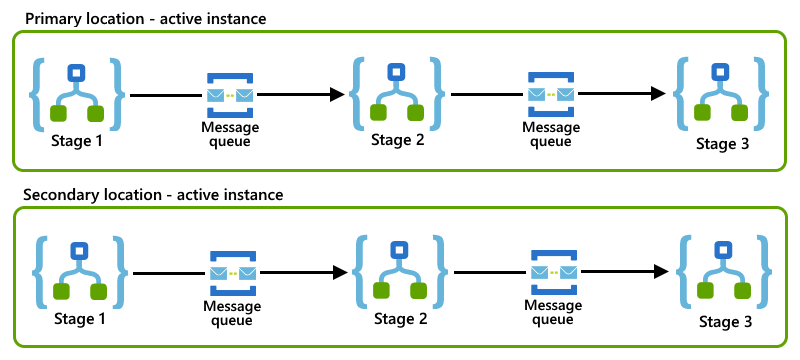
Pokud instance primární i sekundární služby Logic Apps ve svých umístěních používají stejný vzor Routing Slip, můžete pro tyto instance implementovat vzor konkurujících si příjemců nastavením aktivně-aktivních rolí.
Přístup k historii aktivačních událostí a běhů
Pokud chcete získat další informace o minulých spuštěních pracovního postupu aplikace logiky, můžete zkontrolovat historii triggerů a spuštění aplikace. Historie spouštění aplikace logiky je uložená ve stejném umístění nebo oblasti, ve které byla aplikace logiky spuštěná, což znamená, že tuto historii nemůžete migrovat do jiného umístění. Pokud se vaše primární instance při selhání přepne na sekundární instanci, ke aktivační události a historii spuštění každé instance můžete přistupovat pouze v příslušných umístěních, kde byly tyto instance spuštěny. Informace o historii aplikace logiky ale můžete získat tak, že nastavíte aplikace logiky tak, aby odesílaly diagnostické události do pracovního prostoru Služby Azure Log Analytics. Pak můžete zkontrolovat stav a historii napříč aplikacemi logiky, které běží na několika místech.
Pokyny k typu spouštěče
Typ triggeru, který použijete ve svých aplikacích logiky, určuje možnosti nastavení aplikací logiky napříč umístěními ve strategii zotavení po havárii. Tady jsou dostupné typy triggerů, které můžete použít v pracovních postupech aplikace logiky:
Aktivační událost opakování
Trigger Opakování je nezávislý na jakékoli konkrétní službě nebo koncovém bodu a spouští se výhradně podle zadaného plánu, a ne podle žádných jiných kritérií, například:
- Pevná frekvence a interval, například každých 10 minut
- Pokročilejší plán, například poslední pondělí každého měsíce v 17:00
Když se vaše aplikace logiky spouští triggerem Recurrence, musíte primární a sekundární instance aplikace logiky nakonfigurovat pro role aktivní-pasivní. Chcete-li zkrátit cíl doby obnovení (RTO), který odkazuje na cílovou dobu obnovení obchodního procesu po přerušení nebo havárii, můžete nastavit instance aplikace logiky pomocí kombinace rolí aktivní-pasivní a pasivní-aktivní role. V této konfiguraci rozdělíte harmonogram mezi jednotlivá umístění.
Předpokládejme například, že máte aplikaci logiky, která se musí spouštět každých 10 minut. Aplikace logiky a umístění můžete nastavit tak, aby v případě nedostupnosti primárního umístění mohly sekundární umístění převzít práci:
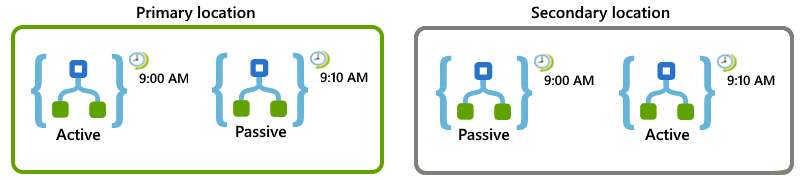
V primární lokalitě nastavte pro tyto aplikace logiky aktivně-pasivní role:
U aktivní povolené aplikace logiky nastavte trigger opakování tak, aby se spustil v horní části hodiny, a opakujte každých 20 minut, například 9:00, 9:20 atd.
Pro zakázanou aplikaci logiky passive nastavte trigger Recurrence na stejný plán spouštění, ale tak, aby začínal 10 minut po celé hodině a opakoval se každých 20 minut, například v 9:10, 9:30 a tak dále.
V sekundární lokalitě nakonfigurujte pasivní-aktivní u těchto aplikací logiky:
U pasivní zakázané aplikace logiky nastavte aktivační událost Recurrence na stejný plán jako u aktivní aplikace logiky v primárním umístění, tedy na začátek hodiny a s opakováním každých 20 minut, například v 9:00, 9:10 atd.
U aktivní povolené aplikace logiky nastavte trigger Opakování na stejný plán jako u pasivní aplikace logiky v primární lokalitě, tedy aby se spouštěl v 10. minutě po celé hodině a opakoval se každých 20 minut, například v 9:10, 9:20 atd.
Pokud v primárním umístění dojde k narušující události, aktivujte pasivní aplikaci logiky v alternativním umístění. Pokud nalezení selhání nějakou dobu trvá, omezí toto nastavení počet zmeškaných opakování během tohoto zpoždění.
Spouštěč dotazování
Chcete-li pravidelně kontrolovat, zda jsou k dispozici nová data ke zpracování z konkrétní služby nebo koncového bodu, může vaše aplikace logiky používat aktivační událost dotazování, která opakovaně volá službu nebo koncový bod podle pevně stanoveného plánu opakování. Data, která poskytuje služba nebo koncový bod, můžou mít jeden z těchto typů:
- Statická data, která popisují data, která jsou vždy k dispozici pro čtení
- Nestálá data, která popisují data, která už nejsou po přečtení k dispozici
Aby se zabránilo opakovanému čtení stejných dat, musí aplikace logiky pamatovat, která data byla dříve přečtená, a to udržováním stavu na straně klienta nebo na straně serveru, služby nebo systému.
Aplikace logiky, které pracují se stavem na straně klienta, používají triggery, které můžou udržovat stav.
Například trigger, který čte novou zprávu z e-mailové schránky, vyžaduje, aby si pamatoval naposledy přečtenou zprávu. Trigger tak spustí aplikaci logiky jenom v případě, že přijde další nepřečtená zpráva.
Aplikace logiky, které pracují se stavem serveru, služby nebo stavu na straně systému, používají hodnoty vlastností nebo nastavení, která jsou na straně serveru, služby nebo systému.
Například trigger založený na dotazu, který čte řádek z databáze, vyžaduje, aby řádek obsahuje
isReadsloupec, který je nastavený naFALSE. Pokaždé, když trigger přečte řádek, aplikace logiky aktualizuje tento řádek změnouisReadsloupce zFALSEnaTRUE.Tento přístup na straně serveru funguje podobně i pro fronty nebo témata služby Service Bus využívající frontovou sémantiku, u nichž může trigger zprávu přečíst a uzamknout, zatímco ji aplikace logiky zpracovává. Když aplikace logiky dokončí zpracování, trigger odstraní zprávu z fronty nebo tématu.
Z hlediska zotavení po havárii se při nastavování primárních a sekundárních instancí aplikace logiky ujistěte, že k těmto chováním přihlížete na základě toho, jestli aplikace logiky sleduje stav na straně klienta nebo na straně serveru:
U aplikace logiky, která funguje se stavem na straně klienta, se ujistěte, že aplikace logiky nečte stejnou zprávu vícekrát. Aktivní instanci aplikace logiky může mít kdykoliv jenom jedno umístění. Ujistěte se, že instance aplikace logiky v záložním umístění je neaktivní nebo zakázaná, dokud primární instance nepřevezme provoz při selhání do záložního umístění.
Například trigger Office 365 Outlooku udržuje stav na straně klienta a sleduje časové razítko pro naposledy přečtený e-mail, aby se zabránilo čtení duplicity.
Pro aplikaci logiky, která pracuje se stavem na straně serveru, můžete instance aplikace logiky nastavit tak, aby fungovaly buď v aktivním-aktivním režimu, kde pracují jako konkurenční příjemci, nebo v aktivním-pasivním režimu, kde alternativní instance čeká, dokud primární instance při selhání nepřejde do alternativního umístění.
Například čtení z fronty zpráv, jako je fronta služby Azure Service Bus, používá stav na straně serveru, protože služba fronty udržuje zámky u zpráv, aby ostatní klienti nemohli číst stejné zprávy.
Poznámka:
Pokud vaše aplikace logiky potřebuje číst zprávy v určitém pořadí, například z fronty Service Bus, můžete použít vzor konkurujících si příjemců, ale pouze v kombinaci s relacemi Service Bus, což se také označuje jako sekvenční konvojový vzor. Jinak musíte nastavit instance aplikace logiky s rolemi aktivní-pasivní.
Spouštěč požadavku
Aktivační událost Request umožňuje volat vaši aplikaci logiky z jiných aplikací, služeb a systémů a obvykle se používá k poskytování těchto možností:
Přímé rozhraní REST API pro vaši logickou aplikaci, které mohou volat ostatní
Například použijte aktivační událost Request ke spuštění své aplikace logiky, aby jiné aplikace logiky mohly tuto aktivační událost volat pomocí akce Call workflow - Logic Apps.
Webhook neboli mechanismus zpětného volání pro vaši aplikaci logiky
Způsob, jak ručně spouštět uživatelské operace nebo rutiny pro volání aplikace logiky, například pomocí skriptu PowerShellu, který provádí konkrétní úlohu
Z hlediska obnovení po havárii je trigger Request pasivním příjemcem, protože aplikace logiky nevykonává žádnou činnost a čeká, až některá jiná služba nebo systém tento trigger výslovně vyvolá. Jako pasivní koncový bod můžete nastavit primární a sekundární instance těmito způsoby:
Active-active: Obě instance aktivně zpracovávají požadavky nebo volání. Volající nebo směrovač vyrovnává nebo distribuuje provoz mezi těmito instancemi.
Aktivní-pasivní: Pouze primární instance je aktivní a zpracovává veškerou práci, zatímco sekundární instance čeká na přerušení nebo selhání primární instance. Volající nebo směrovač určuje, kdy se má volat sekundární instance.
Jako doporučenou architekturu můžete použít Azure API Management jako proxy pro aplikace logiky, které používají triggery požadavků. API Management poskytuje integrovanou odolnost mezi oblastmi a schopnost směrovat provoz napříč několika koncovými body.
Spouštěč webhooku
Aktivační událost webhooku poskytuje vaší aplikaci logiky možnost zaregistrovat se ke službě předáním adresy URL zpětného volání této službě. Aplikace logiky pak může naslouchat a čekat, až se v daném koncovém bodu služby stane konkrétní událost. Když dojde k události, služba pomocí URL adresy zpětného volání zavolá aktivační událost webhooku, která pak spustí logickou aplikaci. Je-li aktivační událost webhooku povolena, přihlásí se ke službě. Pokud je tato možnost zakázaná, trigger se ze služby odhlásí.
Z hlediska zotavení po havárii nastavte primární a sekundární instance, které používají triggery webhooku k přehrávání rolí aktivní-pasivní, protože z odebíraného koncového bodu by měly přijímat události nebo zprávy pouze jedna instance.
Posouzení stavu primární instance
Aby strategie převzetí služeb při selhání ve více oblastech fungovala, potřebuje vaše řešení způsoby, jak provádět tyto úlohy:
- Kontrola dostupnosti primární instance
- Monitorování stavu primární instance
- Aktivace sekundární instance
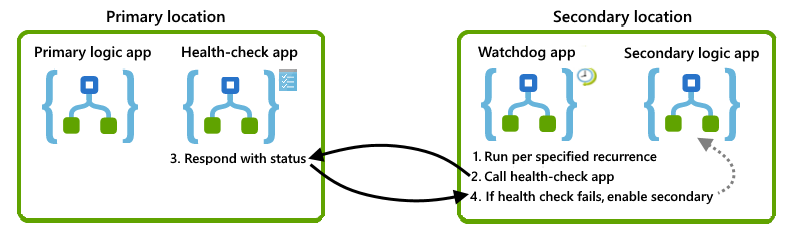
Tato část popisuje jedno řešení, které můžete použít přímo nebo jako základ pro vlastní návrh. Tady je přehled vizuálu vysoké úrovně pro toto řešení:
Kontrola dostupnosti primární instance
Pokud chcete zjistit, jestli je primární instance dostupná, spuštěná a schopná pracovat, můžete vytvořit aplikaci logiky kontroly stavu, která je ve stejném umístění jako primární instance. Tuto aplikaci pro kontrolu stavu pak můžete spustit z jiného umístění. Pokud aplikace pro kontrolu stavu úspěšně reaguje, je základní infrastruktura služby Azure Logic Apps v této oblasti dostupná a funkční. Pokud aplikace pro kontrolu stavu nereaguje, můžete předpokládat, že umístění už není v pořádku.
Pro tuto úlohu vytvořte základní aplikaci logiky kontroly stavu, která provádí tyto úlohy:
Přijímá volání z aplikace Watchdog pomocí triggeru Request.
Odpovězte stavem, který určuje, zda ověřovaná aplikace logiky stále funguje, pomocí akce Odpověď.
Důležité
Aplikace logiky kontroly stavu musí používat akci Odpovědi, aby aplikace reagovala synchronně, ne asynchronně.
Volitelně můžete při dalším určování, zda je primární umístění v dobrém stavu, zohlednit stav jakýchkoli dalších služeb, které v tomto umístění interagují s cílovou aplikací logiky. Stačí rozbalit aplikaci logiky kontroly stavu a posoudit také stav těchto dalších služeb.
Vytvoření aplikace logiky watchdogu
Chcete-li monitorovat stav primární instance a volat aplikaci logiky pro kontrolu stavu, vytvořte aplikaci logiky „watchdog“ v alternativní oblasti. Aplikaci logiky watchdogu můžete například nastavit tak, aby v případě, že volání logiky kontroly stavu selže, mohla odeslat upozornění vašemu provoznímu týmu, aby mohl prošetřit selhání a zjistit, proč primární instance neodpovídá.
Důležité
Ujistěte se, že je vaše aplikace logiky watchdogu v umístění, které se liší od primárního umístění. Pokud ve službě Azure Logic Apps v primární lokalitě dojde k problémům, pracovní postup monitorovací aplikace logiky se nemusí spustit.
Pro tuto úlohu v sekundárním umístění vytvořte aplikaci logiky sledovacího systému, která provádí tyto úlohy:
Spusťte na základě pevného nebo naplánovaného opakování pomocí aktivační události „Opakování“.
Opakování můžete nastavit na hodnotu, která je nižší než úroveň tolerance pro cíl doby obnovení (RTO).
Pomocí akce HTTP volejte pracovní postup aplikace logiky kontroly stavu v primárním umístění.
Můžete také vytvořit sofistikovanější aplikaci logiky pro monitorování, která po určitém počtu selhání zavolá jinou aplikaci logiky, jež automaticky zajistí přepnutí do sekundárního umístění, pokud primární umístění selže.
Aktivace sekundární instance
Pokud chcete sekundární instanci aktivovat automaticky, můžete vytvořit aplikaci logiky, která volá rozhraní API pro správu, například pomocí konektoru Azure Resource Manager, aby aktivovala příslušné aplikace logiky v sekundární lokalitě. Aplikaci watchdog můžete rozšířit tak, aby volala tuto aplikaci logiky aktivace, jakmile dojde k určitému počtu selhání.
Shromažďování diagnostických dat
Můžete nastavit protokolování pro běhy aplikace logiky a odesílat výsledná diagnostická data do služeb, jako jsou Azure Storage, Azure Event Hubs a Azure Log Analytics, k dalšímu zpracování a analýze.
Pokud chcete tato data používat se službou Azure Log Analytics, můžete tato data zpřístupnit pro primární i sekundární umístění nastavením nastavení diagnostiky aplikace logiky a odesláním dat do několika pracovních prostorů služby Log Analytics. Další informace najdete v tématu Nastavení protokolů služby Azure Monitor a shromažďování diagnostických dat pro Azure Logic Apps.
Pokud chcete data odeslat do služby Azure Storage nebo azure Event Hubs, můžete data zpřístupnit pro primární i sekundární umístění nastavením geografické redundance. Další informace naleznete v těchto článcích: