Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Tato příručka popisuje doporučení pro návrh strategie dělení dat pro databázi a technologii úložiště dat, kterou nasadíte. Tato strategie vám pomůže zlepšit spolehlivost vašich datových aktiv.
Terminologie
Než začnete navrhovat strategii dělení dat, seznamte se s těmito klíčovými pojmy.
| Term | definice |
|---|---|
| Ohraničený kontext | Jedinečná obchodní oblast nebo doména, která definuje jasné hranice pro data a funkce, často základ pro funkční rozhodování o dělení. |
| Operace napříč oddíly | Dotaz nebo transakce, které přistupují k datům napříč několika oddíly. Tyto operace mají obvykle vyšší latenci a složitost než jednooddílové operace. |
| Konečná konzistence | Model konzistence, ve kterém se aktualizace dat šíří napříč oddíly v průběhu času. Systém zaručuje, že všechny repliky se nakonec sjednocují do stejného stavu. |
| Funkční dělení | Strategie, která agreguje a ukládá data podle toho, jak je každý ohraničený kontext nebo obchodní doména používá. |
| Horizontální dělení | Strategie, která rozděluje data do několika úložišť, která mají identická schémata. Každý oddíl, označovaný také jako fragment, obsahuje podmnožinu řádků podle hodnot klíče oddílu. |
| Horký oddíl | Oddíl, u kterého dochází k nepřiměřeně vysoké míře přístupu nebo zatížení v porovnání s jinými oddíly. Může způsobit kritické body výkonu a problémy s dostupností. |
| particionování | Proces fyzického rozdělení dat do samostatných úložišť dat. V tomto kontextu se liší od dělení tabulek SQL Serveru. |
| Vyvážení | Proces redistribuce dat napříč oddíly za účelem zachování rovnoměrné distribuce zatížení, optimalizace výkonu a zabránění horkým oddílům. |
| Replika | Kopie oddílu, která je uchovávána v samostatném umístění nebo na serveru. Poskytuje redundanci pro dostupnost a může zlepšit výkon čtení prostřednictvím distribuce zatížení. |
| Shard | Horizontální oddíl, který obsahuje podmnožinu datových řádků z větší datové sady. Každý fragment má stejné schéma, ale různá data. |
| Klíč pro rozdělení na shardy | Datový atribut nebo kombinace atributů, která určuje, který shard obsahuje konkrétní datovou položku. Kritické pro dosažení rovnoměrné distribuce dat. Označuje se také jako klíč oddílu. |
| Vertikální dělení | Strategie, která rozděluje data podle sloupců nebo polí místo řádků. Různé podmnožiny polí jsou uloženy v samostatných oddílech na základě přístupových vzorů. |
Výhody dělení dat
V mnoha rozsáhlých řešeních se oddíly používají k dělení dat tak, aby se k datům mohly spravovat a přistupovat samostatně. Dělení dat zlepšuje škálovatelnost, snižuje kolize a optimalizuje výkon. Implementujte dělení dat tak, aby se data dělily podle způsobu použití. Můžete například archivovat starší data v levném úložišti dat. Strategii dělení pečlivě zvolte, abyste maximalizovali výhody a minimalizovali nežádoucí účinky.
Data můžete rozdělit na:
Zlepšení škálovatelnosti. Při vertikálním navýšení kapacity jednoúčelového databázového systému databáze nakonec dosáhne limitu fyzického hardwaru. Pokud rozdělíte data mezi více oddílů, přičemž každý oddíl je hostovaný na samostatném serveru, můžete systém škálovat téměř na neomezenou dobu.
Zvýšení výkonu. V každém oddílu se operace přístupu k datům provádějí nad menším objemem dat v porovnání s daty, která nejsou rozdělena na oddíly. Rozdělte data tak, aby byl systém efektivnější. Operace, které ovlivňují více než jeden oddíl, se můžou spouštět paralelně.
Zlepšení zabezpečení. V některých případech můžete rozdělit citlivá a necitlivá data do různých oddílů a použít různé bezpečnostní kontroly na data citlivá.
Zajištění provozní flexibility Data můžete rozdělit na oddíly a optimalizovat operace, maximalizovat efektivitu správy a minimalizovat náklady. Můžete například definovat strategie správy, monitorování, zálohování a obnovení a dalších úloh správy na základě důležitosti dat v jednotlivých oddílech.
Porovná úložiště dat se vzorem použití. Každý oddíl můžete nasadit do jiného typu úložiště dat na základě nákladů a integrovaných funkcí, které úložiště dat nabízí. Můžete například ukládat velká binární data do úložiště objektů blob a ukládat strukturovaná data do databáze dokumentů. Další informace najdete v tématu Pochopení modelů úložiště dat.
Zlepšení dostupnosti. Abyste se vyhnuli jedinému bodu selhání, můžete data oddělit mezi více servery. Pokud jedna instance selže, nebudou k dispozici pouze data v tomto oddílu. Operace pokračují v jiných diskových oddílech. Tento faktor je méně relevantní pro úložiště dat PaaS (Managed Platform as a Service), protože mají integrovanou redundanci.
Výběr správné strategie dělení
Existují tři typické strategie dělení dat:
Horizontální dělení (často označované jako horizontální dělení) V této strategii je každý oddíl samostatným úložištěm dat, ale všechny oddíly mají stejné schéma. Každý oddíl se označuje jako shard a obsahuje podmnožinu dat, jako je například soubor objednávek zákazníků.
Vertikální dělení. V této strategii každý oddíl obsahuje podmnožinu polí pro položky v úložišti dat. Pole jsou rozdělena podle jejich způsobu použití. Často přístupná pole se můžou například umístit do jednoho sloupce a méně často přístupná pole do druhého.
Funkční dělení V této strategii se data agregují podle toho, jak jednotlivé ohraničené kontexty v systému data používají. Například systém elektronického obchodování může ukládat data faktury do jednoho oddílu a data inventáře produktů v jiném oddílu.
Při návrhu schématu dělení zvažte kombinování těchto strategií. Můžete například rozdělit data do horizontálních oddílů a pak pomocí vertikálního dělení dále rozdělit data v jednotlivých horizontálních oddílech.
Horizontální dělení (sharding)
Následující obrázek ukazuje příklad horizontálního dělení nebo sharding. Tento příklad rozdělí data inventáře produktů na horizontální oddíly založené na kódu Product Key. Každý shard obsahuje data pro souvislou oblast klíčů (A-G a H-Z), uspořádaných abecedně. Při provádění horizontálního dělení se zatížení rozdělí na více počítačů, což snižuje kolize a zlepšuje výkon.
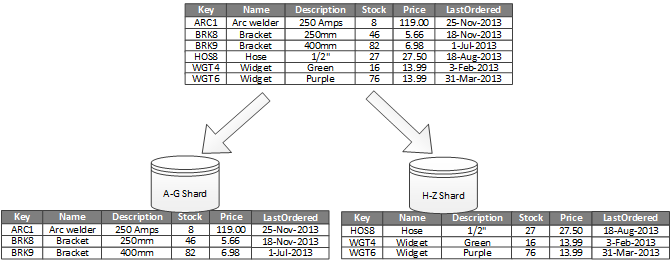
Nejdůležitějším faktorem je klíč horizontálního dělení, který zvolíte. Po spuštění systému může být obtížné změnit klíč. Klíč musí zajistit, aby se data rozdělila rovnoměrně a rozložila zátěž co nejvíce napříč shardy.
Datové fragmenty nemusí mít stejnou velikost. Je důležitější vyvážit počet požadavků. Některé shardy můžou být velké, ale každá položka v shardu má málo přístupových operací. Jiné shardy můžou být menší, ale ke každé položce ve shardu se přistupuje častěji. Je také důležité zajistit, aby jeden shard nepřekračoval limity škálování, co se týče kapacity a zpracovatelských zdrojů úložiště dat.
Vyhněte se vytváření horkých oddílů, které můžou ovlivnit výkon a dostupnost. Pokud například použijete první písmeno jména zákazníka, může vytvořit nevyváženou distribuci, protože některá písmena jsou častější než jiná. Místo toho použijte hodnotu hash identifikátoru zákazníka k rovnoměrné distribuci dat napříč oddíly.
Zvolte klíč horizontálního dělení, který minimalizuje budoucí potřebu dělit velké oddíly, kombinovat malé na větší, nebo měnit schéma. Tyto operace jsou časově náročné a můžou vyžadovat odstavit jeden nebo více shardů.
Pokud jsou fragmenty replikovány, můžete některé repliky ponechat online, zatímco jiné rozdělovat, slučovat nebo konfigurovat znovu. Systém však může omezit operace, které je možné provést během rekonfigurace. Například data v replikách můžou být označená jako jen pro čtení, aby se zabránilo nekonzistenci dat.
Další informace najdete v tématu Vzor horizontálního dělení.
Vertikální dělení
Nejběžnějším využitím vertikálního dělení je snížení nákladů na vstupně-výstupní operace a výkon, které jsou spojené s načítáním často přístupných položek. Následující obrázek ukazuje příklad vertikálního dělení. V tomto příkladu jsou různé vlastnosti položky uloženy v různých oddílech. Jeden oddíl obsahuje data, ke kterým se přistupuje častěji, včetně názvu produktu, popisu a ceny. Další oddíl obsahuje data inventáře, včetně počtu zásob a data poslední objednávky.
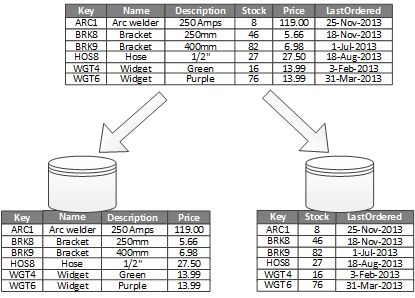
V tomto příkladu se aplikace pravidelně dotazuje na název produktu, popis a cenu, když zákazníkům zobrazí podrobnosti o produktu. Počet akcií a datum poslední objednávky jsou v samostatném oddílu, protože tyto dvě položky se běžně používají společně.
Podívejte se na následující výhody vertikálního dělení:
Relativně pomalá data (název produktu, popis a cena) můžete oddělit od dynamičtějších dat (úroveň zásob a datum poslední objednávky). Pomalé přesouvání dat je vhodným kandidátem pro aplikaci pro ukládání do mezipaměti v paměti.
Citlivá data můžete ukládat do samostatného oddílu s přidanými bezpečnostními prvky.
Vertikální dělení může snížit množství souběžného přístupu, který je potřeba.
Vertikální dělení funguje na úrovni entity v úložišti dat a částečně normalizuje entitu, aby ji rozdělila od široké položky do sady úzkých položek. Je ideální pro úložiště dat orientovaných na sloupce, jako jsou HBase a Cassandra. Pokud se data v kolekci sloupců pravděpodobně nezmění, zvažte použití úložišť sloupců na SQL Serveru.
Funkční dělení
Pokud je možné identifikovat ohraničený kontext pro každou samostatnou obchodní oblast v aplikaci, funkční dělení může zlepšit izolaci a výkon přístupu k datům. Dalším běžným použitím funkčního dělení je oddělení dat pro čtení a zápis od dat jen pro čtení. Následující obrázek ukazuje přehled funkčního dělení, které obsahuje data inventáře oddělená od zákaznických dat.
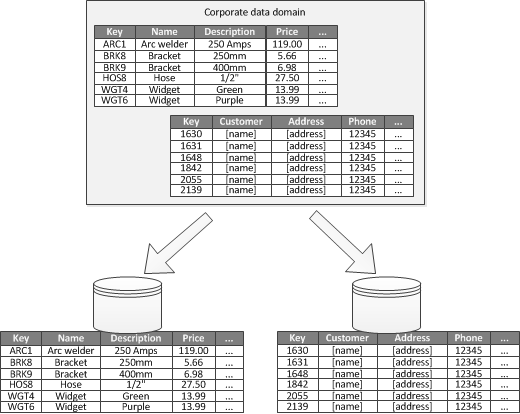
Tato strategie dělení může pomoct omezit kolize přístupu k datům v různých částech systému.
Návrh oddílů pro škálovatelnost
Je důležité zvážit velikost a zatížení pro každou partici. Vyvažte je tak, aby se data distribuovala za účelem dosažení maximální škálovatelnosti. Musíte však také rozdělit data tak, aby nepřekračovala limity škálování jednotlivého úložného oddílu.
Při návrhu oddílů pro zajištění škálovatelnosti postupujte takto:
Analyzujte aplikaci, abyste porozuměli vzorům přístupu k datům, jako je například velikost sady výsledků, kterou každý dotaz vrací, četnost přístupu, vlastní latenci a požadavky na zpracování výpočetních prostředků na straně serveru. V mnoha případech nejobvyklejší subjekty vyžadují většinu zpracovatelských zdrojů.
Pomocí této analýzy můžete určit aktuální a budoucí cíle škálovatelnosti, jako je velikost dat a úloha. Pak distribuujte data napříč oddíly, aby se splnil cíl škálovatelnosti. Pro zajištění rovnoměrného rozdělení při horizontální fragmentaci zvolte správný klíč fragmentu. Další informace najdete v tématu Vzor horizontálního dělení.
Ujistěte se, že každý oddíl má dostatek prostředků pro zpracování požadavků na škálovatelnost z hlediska velikosti a propustnosti dat. V závislosti na úložišti dat může být pro každý oddíl limit objemu úložného prostoru, výpočetního výkonu nebo šířky pásma sítě. Pokud požadavky pravděpodobně překročí tyto limity, možná budete muset upřesnit strategii dělení nebo dále rozdělit data. Možná budete muset zkombinovat dvě nebo více strategií.
Monitorujte systém a ověřte, že jsou data distribuována podle očekávání a že oddíly mohou zpracovat zatížení. Skutečné využití neodpovídá tomu, co analýza predikuje. Možná budete muset znovu vyvažovat partice nebo přepracovávat některé části systému, abyste dosáhli požadované rovnováhy.
Některá cloudová prostředí přidělují prostředky na základě hranic infrastruktury. Ujistěte se, že limity vybrané hranice poskytují dostatek místa pro očekávaný růst objemu dat, úložiště dat, výpočetního výkonu a šířky pásma.
Pokud například používáte Azure Table Storage, existuje omezení objemu požadavků, které může jeden oddíl zpracovat v určitém časovém období. Další informace najdete v tématu Škálovatelnost a výkonnostní cíle pro účty úložiště úrovně Standard. Zaneprázdněný shard může vyžadovat více prostředků, než zvládne jedna samostatná část. Možná bude potřeba znovu rozdělit shard, aby se zatížení lépe rozložilo. Pokud celková velikost nebo propustnost těchto tabulek překročí kapacitu účtu úložiště, budete možná muset vytvořit více účtů úložiště a rozložit tabulky mezi tyto účty.
Návrh partic pro výkon dotazů
Výkon dotazů můžete zvýšit pomocí malých datových sad a spouštění paralelních dotazů. Každý oddíl by měl obsahovat malou část celé datové sady. Toto snížení objemu může zlepšit výkon dotazů. Dělení ale není alternativou k vhodnému návrhu a konfiguraci databáze. Ujistěte se, že implementujete potřebné indexy.
Při návrhu oddílů pro výkon dotazů postupujte podle těchto kroků:
Prozkoumejte požadavky a výkon aplikace.
Pomocí obchodních požadavků můžete určit důležité dotazy, které musí vždy provádět rychle.
Monitorujte systém a identifikujte dotazy, které se provádějí pomalu.
Určete dotazy, které se vykonávají nejčastěji. I když má jeden dotaz minimální náklady, může být kumulativní spotřeba prostředků významná.
Rozdělte data, která způsobují nízký výkon.
Omezte velikost každého oddílu tak, aby doba odezvy dotazu byla v rámci cílového časového limitu.
Pokud používáte horizontální dělení, navrhejte klíč horizontálního oddílu tak, aby aplikace snadno vybrala příslušný oddíl. Tato nastavení brání dotazu ve skenování každého oddílu.
Zvažte umístění oddílu. Pokuste se uchovávat data v oddílech, které jsou geograficky blízko aplikacím a uživatelům, kteří k němu přistupují.
Pokud má entita požadavky na propustnost a výkon dotazů, použijte funkční dělení, které je založené na dané entitě. Pokud toto přidělení stále nesplňuje požadavky, můžete přidat horizontální dělení. Jedna strategie dělení je obvykle adekvátní, ale v některých případech je efektivnější kombinovat obě strategie.
Spouštění dotazů paralelně napříč oddíly za účelem zlepšení výkonu
Návrh částí pro dostupnost
Rozdělte data tak, aby se zlepšila dostupnost aplikací. Dělení zajišťuje, že celá datová sada nemá jediný bod selhání a můžete nezávisle spravovat jednotlivé podmnožina datové sady.
Vezměte v úvahu následující faktory, které ovlivňují dostupnost:
Určete důležitost dat. Identifikujte důležitá obchodní data, jako jsou transakce, a méně důležitá provozní data, jako jsou soubory protokolů.
Ukládejte kritická data do vysoce dostupných partíc a vytvořte adekvátní plán zálohování.
Vytvořte samostatné postupy správy a monitorování pro různé datové sady.
Umístěte data, která mají stejnou úroveň závažnosti ve stejném oddílu, aby je bylo možné zálohovat ve stejné frekvenci. Můžete například potřebovat zálohovat oddíly, které obsahují transakční data častěji než oddíly, které uchovávají informace protokolování nebo trasování.
Správa jednotlivých oddílů Navrhujte oddíly tak, aby podporovaly nezávislou správu a údržbu. Tento postup nabízí několik výhod, například:
Pokud dojde k selhání oddílu, je možné ho obnovit nezávisle bez aplikací, které přistupují k datům v jiných oddílech.
Rozdělení dat podle geografické oblasti umožňuje, aby úlohy plánované údržby probíhaly v době mimo špičku pro každé umístění. Ujistěte se, že oddíly nejsou příliš velké, aby znemožnily dokončení plánované údržby během tohoto období.
Replikace důležitých dat napříč oddíly Tato strategie zlepšuje dostupnost a výkon, ale může také zavádět problémy s konzistencí. Synchronizace změn s každou replikou nějakou dobu trvá. Během synchronizace obsahují různé oddíly různé datové hodnoty.
Optimalizace kódu aplikace pro použití oddílů
Dělení zvyšuje složitost návrhu a vývoje systému. Rozdělte data jako základní součást návrhu systému, i když systém zpočátku obsahuje jenom jeden oddíl. Pokud řešíte dělení na oddíly dodatečně, je to náročné, protože už máte živý systém, který je potřeba udržovat. Můžete:
Musíte upravit logiku přístupu k datům.
Abyste je mohli distribuovat mezi oddíly, musíte migrovat velké množství existujících dat.
Narazíte na výzvy, protože uživatelé očekávají, že budou systém během migrace dál používat.
V některých případech není dělení důležité, protože počáteční datová sada je malá a jeden server ji dokáže snadno zpracovat. Některé úlohy se obejdou bez oddílů, ale řada komerčních systémů s rostoucím počtem uživatelů vyžaduje rozšíření.
Některé malé úložiště dat také využívají dělení. Například stovky souběžných klientů můžou přistupovat k malému úložišti dat. Pokud data v této situaci rozdělíte, může vám pomoct snížit kolize a zlepšit propustnost.
Při návrhu schématu dělení dat zvažte následující body:
Minimalizujte operace přístupu k datům napříč oddíly. Pokuste se zachovat data pro nejběžnější databázové operace v oddílu, abyste minimalizovali operace přístupu k datům napříč oddíly. Dotazování napříč oddíly může být časově náročnější než dotazování v rámci jednoho oddílu. Optimalizace oddílů pro jednu sadu dotazů může nepříznivě ovlivnit jiné sady dotazů. Pokud se musíte dotazovat napříč oddíly, minimalizujte čas dotazu spuštěním paralelních dotazů a agregací výsledků v aplikaci. V některých případech tento přístup nemůžete použít, například pokud se v dalším dotazu použije výsledek z jednoho dotazu.
Replikace statických referenčních dat Pokud dotazy používají relativně statická referenční data, jako jsou tabulky PSČ nebo seznamy produktů, zvažte replikaci těchto dat ve všech oddílech, aby se snížily samostatné vyhledávací operace v různých oddílech. Tento přístup může také snížit pravděpodobnost, že se referenční data stanou horkou datovou sadou s velkým provozem z celého systému. Při synchronizaci změn referenčních dat jsou spojené další náklady.
Minimalizujte spojení mezi různými oddíly. Pokud je to možné, minimalizujte požadavky na referenční integritu napříč vertikálními a funkčními oddíly. V těchto schématech je aplikace zodpovědná za zachování referenční integrity napříč oddíly. Dotazy, které spojují data napříč několika oddíly, jsou neefektivní, protože aplikace obvykle provádí po sobě jdoucí dotazy založené na klíči a potom cizí klíč. Místo toho zvažte replikaci nebo zrušení normalizace relevantních dat. Pokud je potřeba spojení mezi oddíly, spusťte paralelní dotazy přes oddíly a připojte data v aplikaci.
Přijměte konečnou konzistenci. Vyhodnoťte, jestli je požadavkem silná konzistence. Běžným přístupem v distribuovaných systémech je implementace konečné konzistence. Data v každém oddílu se aktualizují samostatně a logika aplikace zajišťuje úspěšné dokončení aktualizací. Logika aplikace také zpracovává nekonzistence, které vznikají z dotazování dat, zatímco se nakonec spustí konzistentní operace.
Zvažte, jak dotazy vyhledají správný oddíl. Pokud dotaz musí prohledat všechny oddíly a vyhledat požadovaná data, výrazně ovlivňuje výkon, i když se spustí více paralelních dotazů. Při vertikálním a funkčním partitioningu mohou dotazy specifikovat partici. Horizontální dělení může naopak znesnadnit umístění položky, protože každý horizontální oddíl má stejné schéma. Typickým řešením je udržovat mapu, která se používá k vyhledání umístění shardů položek. Implementujte tuto mapu v logice horizontálního dělení aplikace. Může být také spravováno úložištěm dat, pokud úložiště dat podporuje transparentní rozřezání.
Pravidelně vyrovnávej fragmenty. Při horizontálním dělení vám může vyrovnávání horizontálních oddílů pomoct rovnoměrně distribuovat data podle velikosti a úloh. Přebalancování shardů k minimalizaci hotspotů, maximalizaci výkonu dotazů a obcházení omezení fyzického úložiště Tento úkol je složitý a často vyžaduje vlastní nástroj nebo proces.
Replikujte partitiony. Replikujte každý diskový oddíl, abyste zajistili zvýšenou ochranu před selháním. Pokud selže jedna replika, dotazy se směrují na funkční kopii.
Rozšiřte škálovatelnost na jinou úroveň. Pokud dosáhnete fyzických limitů strategie dělení, možná budete muset rozšířit škálovatelnost na jinou úroveň. Pokud je například dělení na úrovni databáze, možná budete muset vyhledat nebo replikovat oddíly ve více databázích. Pokud už dělení probíhá na úrovni databáze a existují fyzická omezení, možná budete muset vyhledat nebo replikovat oddíly v několika hostitelských účtech.
Vyhněte se transakcím, které přistupují k datům v několika oddílech. Některá úložiště dat implementují transakční konzistenci a integritu operací, které upravují data, ale pouze v případě, že jsou data umístěná v jednom oddílu. Pokud potřebujete transakční podporu napříč několika oddíly, implementujte ji jako součást logiky aplikace, protože většina systémů dělení neposkytuje nativní podporu.
Všechna úložiště dat vyžadují určitou provozní správu a monitorování aktivit. Mezi tyto úlohy patří načítání dat, zálohování a obnovení dat, změna uspořádání dat a zajištění správného a efektivního fungování systému.
Vezměte v úvahu následující faktory, které ovlivňují provozní správu:
Při dělení dat implementujte vhodné úlohy správy a provozu. Mezi tyto úlohy patří zálohování a obnovení, archivace dat, monitorování systému a další úlohy správy. Může být například náročné udržovat logickou konzistenci během operací zálohování a obnovení.
Načtěte data do několika particí a přidejte nová data pocházející z jiných zdrojů. Některé nástroje a pomůcky nemusí podporovat operace s rozdělenými daty, například načítání dat do správné partice.
Pravidelně archivujte a odstraňujte data. Aby bylo zamezeno nadměrnému růstu oddílů, každý měsíc archivujte a odstraňujte data. Možná budete muset transformovat data tak, aby odpovídala jinému schématu archivu.
Vyhledejte problémy s integritou dat. Zvažte spuštění pravidelného procesu pro vyhledání problémů s integritou dat, jako jsou data v jednom oddílu, který odkazuje na chybějící informace v jiném oddílu. Proces se může buď pokusit tyto problémy automaticky opravit, nebo vygenerovat sestavu pro ruční kontrolu.
Přerozdělení partícií
S tím, jak systém dospívá, možná budete muset upravit schéma dělení. Například jednotlivé oddíly můžou začít přijímat nepřiměřený objem provozu a stát se horkými, což vede k nadměrnému konfliktu. Nebo jste možná podcenili objem dat v některých oddílech, což způsobuje, že oddíly se blíží k limitům kapacity.
Některá úložiště dat, jako je azure Cosmos DB, můžou automaticky vyrovnát oddíly. V jiných případech můžete znovu vyrovnát oddíly ve dvou fázích:
Určete novou strategii dělení.
Které oddíly je potřeba rozdělit nebo zkombinovat?
Jaký je nový klíč oddílu?
Migrujte data ze starého partičního schématu na novou sadu oddílů.
Možná bude nutné, aby oddíly byly nedostupné během přemístění dat, což se označuje jako offline migrace. V závislosti na úložišti dat můžete migrovat data mezi oddíly, zatímco se používají. Tato technika se nazývá online migrace.
Offline migrace
Offline migrace snižuje pravděpodobnost konfliktní situace. Provedení offline migrace:
Označte oddíl jako offline. Oddíl můžete označit jako jen pro čtení, aby aplikace při přesouvání stále mohly číst data.
Rozdělte, sloučte a přesuňte data do nových oddílů.
Ověřte data.
Přeneste nové oddíly do online režimu.
Odeberte starý oddíl.
Online migrace
Online migrace je složitější, ale méně rušivá v porovnání s offline migrací. Tento proces je podobný offline migraci, ale původní oddíl se neoznačí jako offline. V závislosti na granularitě procesu migrace, například položku po položce versus oddíl po oddílu, může být nutné, aby kód pro přístup k datům v klientských aplikacích četl a zapisoval data, která jsou ve dvou umístěních, původním oddílu a novém oddílu.
Usnadnění na platformě Azure
Následující části popisují doporučení pro dělení dat uložených ve službách Azure.
V Azure Cosmos DB se globální sekundární indexy synchronizují ze zdrojových kontejnerů do kontejnerů jen pro čtení, které používají vlastní klíče oddílů. Využijte je ke zlepšení latence a efektivity RU u vzorců dotazů, které neodpovídají transakčnímu kontejneru, ale zohledněte přitom dodatečné nároky na propustnost a dopady na návrh.
Dělení ve službě Azure SQL Database
Jedna databáze SQL má omezení objemu dat, která může obsahovat. Propustnost je omezená faktory architektury a počtem souběžných připojení, která podporuje.
elastické fondy podporují horizontální škálování pro databázi SQL. Pomocí elastických fondů rozdělte data do shardů, které jsou rozložené do více databází SQL. Můžete také přidávat nebo odebírat shardy s rostoucím a klesajícím objemem dat. Elastické fondy také můžou pomoct snížit kolize tím, že zatížení distribuují mezi databáze.
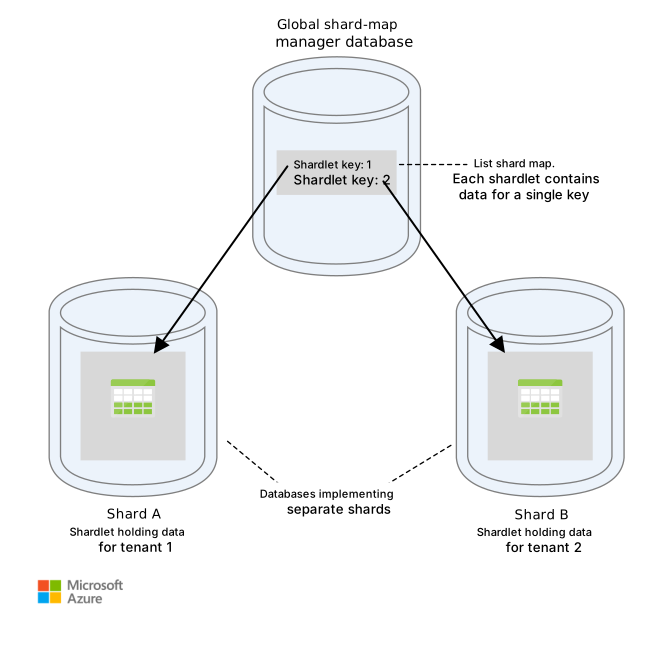
Každý shard je implementován jako databáze SQL. Shard může obsahovat více než jednu datovou sadu. Každá datová sada se nazývá shardlet. Každá databáze má metadata, která popisují shardlety, které obsahuje. Shardlet může být jedna datová položka nebo skupina položek, které sdílejí stejný klíč shardletu. Například ve víceklientské aplikaci může být klíč shardletu ID tenanta a všechna data pro tenanta můžou být ve stejném shardletu.
Aplikace zodpovídají za přidružení datové sady k klíči shardletu. Oddělená databáze SQL funguje jako globální správce mapování shardu. Tato databáze obsahuje seznam všech shardů a shardletů v systému. Aplikace se připojí k databázi správce rozdělování a získá kopii mapy rozdělování. Ukládá mapování fragmentů místně do mezipaměti a pomocí této mapy směruje žádosti o data do příslušného fragmentu. Tato funkce je skrytá za řadou rozhraní API obsažených v klientské knihovně funkce Elastic Database služby SQL Database, která je k dispozici pro Javu a .NET.
Další informace o elastických poolech naleznete v části Rozšíření s databází SQL.
Pokud chcete snížit latenci a zlepšit dostupnost, můžete replikovat databázi globálního správce shard map. S cenovými úrovněmi Premium můžete nakonfigurovat aktivní geografickou replikaci, která bude průběžně kopírovat data do databází v různých oblastech.
Případně můžete použít SQL Synchronizace dat pro SQL Database nebo Azure Data Factory k replikaci databáze správce mapování shardů v různých oblastech. Tato forma replikace se spouští pravidelně a je vhodnější, pokud se mapa horizontálních oddílů mění zřídka a nevyžaduje prémiovou úroveň.
Elastic Database poskytuje dvě schémata pro mapování dat na shardlety a jejich ukládání do šárů:
Mapa fragmentů seznamu přiřazuje jeden klíč k fragmentu. Například ve víceklientské soustavě můžou být data pro každého tenanta přidružená k jedinečnému klíči a uložená ve vlastním shardletu. Aby bylo možné zaručit izolaci, může být každý shardlet uložen ve svém vlastním shardu.
Mapa rozdílů klíčového rozhraní přidružuje sadu souvislých hodnot klíče ke shardletu. Můžete například seskupit data pro sadu tenantů, z nichž každý má vlastní klíč, v rámci stejného shardletu. Tento systém je levnější než mapování fragmentů seznamu, protože nájemci sdílejí úložiště dat, ale nabízí méně izolace.
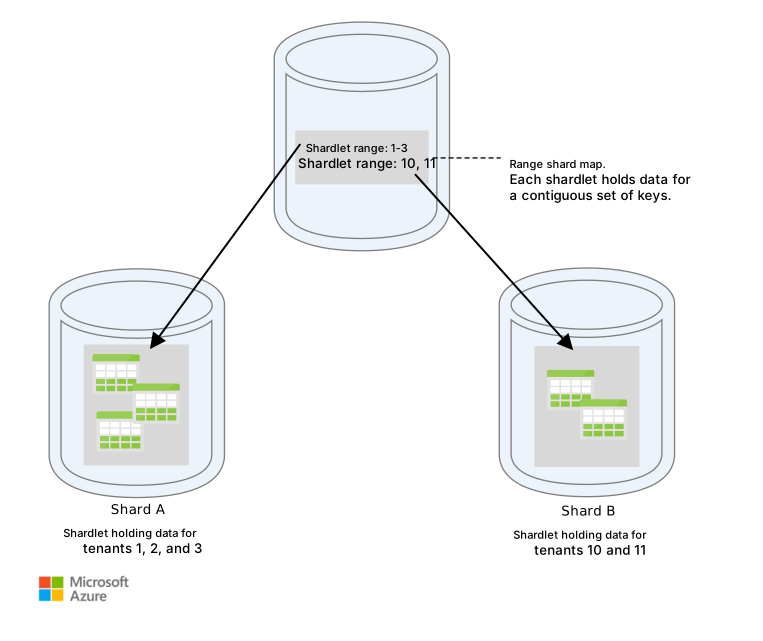
Stažení souboru Visia tohoto diagramu
Jeden shard může obsahovat data pro několik shardletů. Pomocí shardlistů můžete například ukládat data pro různé nesouvisící tenanty ve stejném oddílu. Můžete také kombinovat range shardlety a list shardlety ve stejném shardu, ale pak jsou adresovány prostřednictvím různých map. Následující diagram znázorňuje tento přístup:
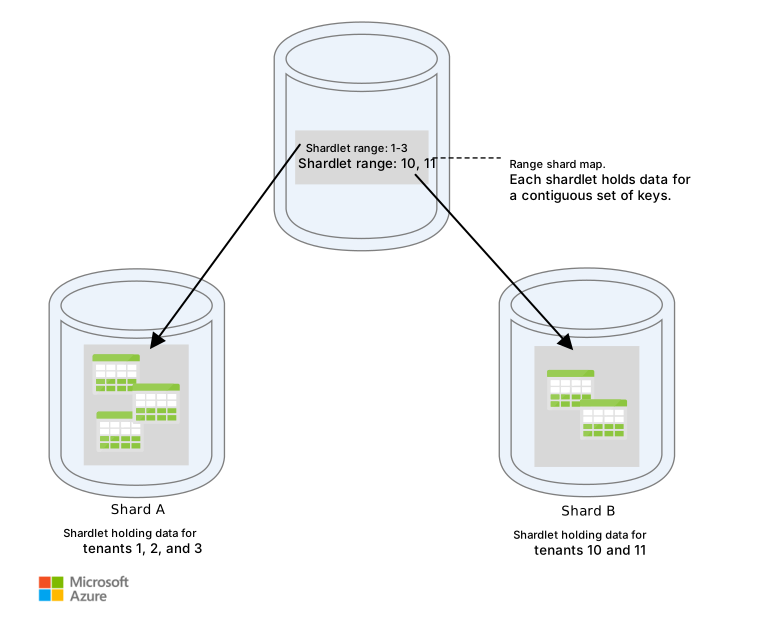
Stáhněte si soubor tohoto diagramu ve formátu Visio.
S elastickými fondy můžete přidávat a odebírat horizontální oddíly při růstu a zmenšení objemu dat. Klientské aplikace můžou dynamicky a transparentně vytvářet a odstraňovat horizontální oddíly a transparentně aktualizovat správce mapování horizontálních oddílů. Odebrání části je však destruktivní operace, která také vyžaduje odstranění všech dat v dané části.
Pokud aplikace potřebuje rozdělit fragment na dva samostatné fragmenty nebo kombinovat fragmenty, použijte nástroj sloučení a rozdělení. Tento nástroj běží jako webová služba Azure a bezpečně migruje data mezi shardy.
Schéma dělení může výrazně ovlivnit výkon systému. Může také ovlivnit rychlost, s jakou musí být shardy přidány nebo odebrány, nebo že data musejí být přerozdělena napříč shardy. Vezměte v úvahu následující body:
Seskupte data, která se používají společně ve stejném horizontálním oddílu, a vyhněte se operacím, které přistupují k datům z více horizontálních oddílů. Shard je databáze SQL sama o sobě a propojování mezi databázemi se musí provádět u klienta, když operace přistupují k více shardům.
I když SQL Database nepodporuje připojení mezi databázemi, můžete k provádění dotazů s více horizontálními oddíly použít nástroje Elastic Database. Dotaz s více fragmenty odesílá jednotlivé dotazy do každé databáze a sloučí výsledky.
Navrhňte systém, který nemá závislosti mezi shardami. Omezení referenční integrity, triggery a uložené procedury v jedné databázi nemůžou odkazovat na objekty v jiné.
Zvažte replikaci dat napříč shardy, pokud máte referenční data, která jsou často používána dotazy. Tento přístup může eliminovat potřebu spojení dat mezi databázemi. V ideálním případě by taková data měla být statická nebo pomalá, aby se minimalizovala úsilí replikace a snížila pravděpodobnost, že budou zastaralá.
Pro segmenty, které patří do stejné mapy fragmentů, použijte stejné schéma. Tyto pokyny SQL databáze nevynucují, ale správa a dotazování na data jsou složité, pokud má každý shardlet jiné schéma. Místo toho vytvořte pro každé schéma samostatné mapy shardů. Data, která patří do různých shardletů, můžete ukládat do stejného shardu.
Data můžete ukládat do stejného shardu nebo implementovat konečnou konzistenci, pokud vaše obchodní logika potřebuje provádět transakce. Transakční operace jsou podporovány pouze pro data, která jsou v shardu, a ne napříč shardy. Transakce můžou zahrnovat shardlety, pokud jsou součástí stejného shardu.
Umístěte shardy blízko k uživatelům, kteří přistupují k datům v těchto shardách. Tato strategie pomáhá snížit latenci.
Vyhněte se kombinaci vysoce aktivních a relativně neaktivních shardů. Pokuste se rovnoměrně rozložit zátěž napříč shardy. Možná budete muset zahashovat klíče pro sharding. Pokud určujete geografické umístění shardů, ujistěte se, že se hashované klíče mapují na shardlety uložené v shardech, které jsou blízko uživatelů, kteří k těmto datům přistupují.
Dělení ve službě Azure Blob Storage
Se službou Blob Storage můžete ukládat velké binární objekty. Používejte blokové objekty blob ve scénářích vyžadujících rychlé nahrávání nebo stahování velkých objemů dat. Objekty blob stránky používejte pro aplikace, které vyžadují náhodný přístup místo sériového přístupu k částem dat.
Každý blokový blob nebo stránkový blob je umístěn v kontejneru v úložném účtu Azure. Pomocí containers lze seskupit objekty blob, které mají stejné požadavky zabezpečení. Toto seskupení je logické místo fyzické. V kontejneru má každý blob jedinečný název.
Klíčem oddílu pro objekt blob je název účtu, název kontejneru a název objektu blob. Klíč pro oddílení se používá k rozdělení dat do rozsahů. Tyto rozsahy jsou v systému vyváženy zatížení. Objekty blob je možné distribuovat napříč mnoha servery, aby se k nim mohl škálovat přístup. Jeden objekt blob může obsluhovat jenom jeden server.
Pokud schéma pojmenování používá časová razítka nebo číselné identifikátory, může to vést k nadměrnému provozu směřujícímu k jednomu oddílu. Brání tomu, aby systém efektivně vyrovnává zatížení. Pokud máte například denní operace, které používají objekt blob s časovým razítkem, například yyyy-mm-dd, veškerý provoz pro tuto operaci přejde na jeden server pro oddíly. Místo toho zadejte před název třímístnou hodnotu hash. Další informace najdete v tématu Zásady vytváření názvů oddílů.
Akce zápisu jednoho bloku nebo stránky jsou atomické, ale operace, které zahrnují bloky, stránky nebo objekty blob, nejsou. Pokud potřebujete zajistit konzistenci při provádění operací zápisu napříč bloky, stránkami a objekty blob, pomocí zapůjčení objektu blob vynechejte zámek zápisu.
Úvahy
Dělení dat představuje některé výzvy a složitosti, které je potřeba vzít v úvahu.
Synchronizace dat mezi oddíly se může stát výzvou. Zajistěte, aby se aktualizace nebo změny v jednom oddílu včas a konzistentně rozšířily do ostatních oddílů.
Procesy převzetí služeb při selhání a zotavení po havárii se stávají složitými, když potřebujete koordinovat zálohování a obnovení více oddílů. K problémům s integritou dat může dojít v případě, že jsou některé oddíly nebo jejich zálohy poškozené nebo nedostupné.
Dělení dat může mít vliv na výkon a spolehlivost v případě, že potřebujete dotazovat napříč oddíly, a když znovu vyrovnáte oddíly, pokud data rostou nerovnoměrně.
Související odkazy
- Vytváření škálovatelných cloudových databází
- Data Factory
- Vzor tabulky indexu
- Model materializovaného zobrazení
- Přesun dat mezi cloudovými databázemi s horizontálním škálováním
- Dotazování s více shardy pomocí elastických databázových nástrojů
- Pojmenování oddílů
- Kontrola možností dat
- Škálovatelnost a výkonnostní cíle pro účty úložiště úrovně Standard
- Horizontální navýšení kapacity s využitím SLUŽBY SQL Database
- Model horizontálního dělení
- Pochopte modely úložiště dat
- Použití elastických fondů ke správě a škálování více databází ve službě SQL Database
- Co je Synchronizace dat SQL pro Azure?