Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
platí pro: SQL Server
Během přepnutí role závisí doba, po kterou bude zrcadlení databáze mimo provoz, na typu přepnutí rolí a na příčině přepnutí role.
Při automatickém převzetí služeb při selhání přispívají k době přerušení služby dva faktory: doba potřebná k tomu, aby zrcadlový server rozpoznal, že instance hlavního serveru selhala, tj. doba detekce chyby, a doba potřebná k převzetí databáze při selhání, tj. doba převzetí služeb při selhání.
U operace vynucené služby, i když došlo k selhání, zjišťování a reakce na selhání závisí na odezvě člověka. Odhad potenciálního přerušení služby je však omezen na odhad času, kdy zrcadlový server přepne role po vydání příkazu vynucené služby.
Note
Pokud chcete zkrátit dobu potřebnou ke zjištění konkrétních podmínek, jako jsou některé typy chyb, můžete pro tyto podmínky definovat výstrahy.
Při ručním přepnutí při selhání je vyžadován pouze čas potřebný k přepnutí databáze po zadání příkazu k přepnutí při selhání.
Detekce chyb
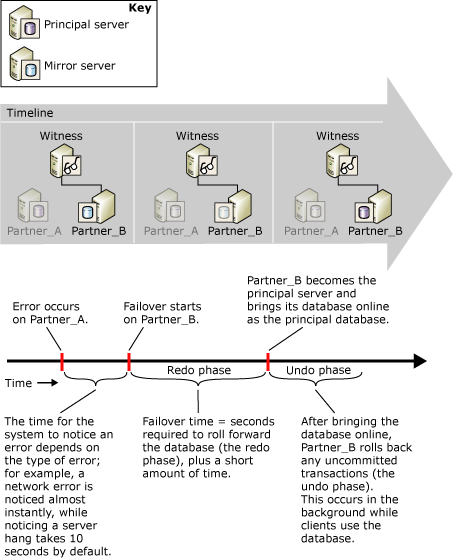
Doba, za kterou systém zaznamená chybu, závisí na typu chyby; například síťovou chybu zaznamená téměř okamžitě, zatímco zaznamenání serveru, který neodpovídá, trvá 10 sekund (při výchozím časovém limitu).
Informace o chybách, které mohou způsobit selhání během relace zrcadlení databáze, a o detekci časového limitu v režimu vysokého zabezpečení s automatickým převzetím služeb při selhání naleznete v tématu Possible Failures During Database Mirroring).
Čas převzetí služeb při selhání
Doba převzetí služeb při selhání se skládá hlavně z doby, kterou bývalý zrcadlový server potřebuje k přehrání veškerého protokolu zbývajícího v jeho frontě opakování, plus krátké dodatečné doby (další informace o tom, jak zrcadlový server zpracovává záznamy protokolu, viz Zrcadlení databáze (SQL Server)). Informace o odhadu doby převzetí služeb při selhání najdete v části Odhad míry opětovného převzetí služeb při selhání, dále v tomto tématu.
Important
Pokud dojde k převzetí služeb při selhání během transakce, ve které se vytvoří index nebo tabulka, a pak se změní, převzetí služeb při selhání může trvat déle než obvykle. Například pokud dojde k přepnutí při selhání během následující posloupnosti operací, může se prodloužit doba přepnutí při selhání: BEGIN TRANSACTION, CREATE INDEX nad tabulkou a SELECT INTO tabulky. Možnost prodloužení doby převzetí služeb při selhání během takové transakce přetrvává, dokud není transakce dokončena příkazem COMMIT TRANSACTION nebo ROLLBACK TRANSACTION.
Fronta opakování
Posun databáze dopředu spočívá v aplikaci všech záznamů protokolu, které jsou aktuálně ve frontě opakovaného zpracování na zrcadlovém serveru. Fronta opakování se skládá ze záznamů protokolu, které byly zapsány na disk na zrcadlovém serveru, ale dosud nebyly aplikovány na zrcadlené databázi.
Doba převzetí služeb při selhání databáze závisí na tom, jak rychle může zrcadlový server zpracovat protokol ve frontě opakování, což je zase určeno především hardwarem systému a aktuálním zatížením systému. Instanční databáze se může stát tak zaneprázdněná, že hlavní server dodává protokol na zrcadlový server mnohem rychleji, než může přeposílat protokoly. V této situaci může failover trvat značnou dobu, zatímco zrcadlový server zpracovává protokol transakcí ve frontě redo. Pokud chcete zjistit aktuální velikost fronty opakování, použijte čítač Redo Queue v objektu výkonu pro zrcadlení databáze. Další informace najdete v tématu SQL Server, objekt zrcadlení databáze.
Odhad rychlosti opětovného převzetí služeb při selhání
Pomocí testovací kopie produkční databáze můžete změřit dobu potřebnou k dopředné aplikaci záznamů protokolu – redo rate.
Metoda odhadu průběhu převzetí služeb při selhání závisí na počtu vláken, které zrcadlový server používá během fáze opakování. Počet vláken závisí na následujícím:
V edici Standard systému SQL Server zrcadlový server vždy používá jedno vlákno k dopřednému přehrání databáze.
V edici SQL Server Enterprise používají zrcadlové servery na počítačích s méně než pěti procesory pouze jedno vlákno. Při pěti nebo více procesorech zrcadlový server během převzetí služeb při selhání rozděluje své operace obnovení do více vláken (označuje se to jako paralelní obnova). Paralelní redo je optimalizováno tak, aby používalo jedno vlákno na každé čtyři CPU.
Odhad rychlosti jednovláknového reda
Při jednovláknovém opětovném provedení trvá dopředné obnovení zrcadlené databáze během převzetí služeb při selhání přibližně stejně dlouho jako obnovení zálohy protokolu transakcí potřebné k dopřednému obnovení stejného množství záznamů protokolu. Chcete-li odhadnout dobu převzetí služeb při selhání, vytvořte testovací databázi v prostředí, ve kterém hodláte zrcadlení provozovat. Pak proveďte zálohu protokolu z produkční databáze. Chcete-li změřit rychlost opětovného zpracování pro tuto zálohu protokolu, změřte, jak dlouho trvá obnovení zálohy protokolu s možností WITH NORECOVERY do testovací databáze.
Jakmile znáte rychlost opětovného provádění na zrcadlovém serveru, můžete odhadnout dobu převzetí služeb při selhání databáze v daném okamžiku tak, že objem aktuálního logu, který má být na zrcadlovém serveru znovu proveden (měřeno čítačem výkonu Redo Queue), vydělíte rychlostí opětovného provádění. Za normálních podmínek, pokud zrcadlový server stačí zatížení z hlavního serveru, je fronta opakování malá nebo téměř nulová a přepnutí při selhání trvá jen několik sekund.
Odhad rychlosti paralelního opakování
V edici SQL Server Enterprise je paralelní opakování optimalizované tak, aby používalo jedno vlákno pro každé čtyři procesory. Pro odhad doby roll-forward při paralelním redo je přesnější vycházet z běžícího testovacího systému než z testovací databáze. Při monitorování fronty opakovaného provádění na zrcadlovém serveru zvyšte zatížení hlavního serveru. V normálním provozu se fronta opakování blíží nule. Zvyšte zatížení primárního serveru, dokud fronta Redo nezačne nepřetržitě narůstat; systém je pak na své maximální rychlosti redo a čítač výkonu Redo Bytes/sec v tomto bodě představuje maximální rychlost redo. Další informace najdete v tématu SQL Server, objekt zrcadlení databáze.
Odhad přerušení služby během automatického převzetí služeb při selhání
Následující obrázek znázorňuje, jak detekce chyb a doba převzetí služeb při selhání přispívají k celkovému času potřebnému k automatickému převzetí služeb při selhání na Partner_B. Převzetí služeb při selhání vyžaduje čas na dopředné obnovení databáze (fáze opětovného provedení) a navíc krátkou dobu potřebnou k uvedení databáze do online režimu. Fáze vrácení, která zahrnuje vrácení všech nepotvrzených transakcí, nastává poté, co je nová primární databáze online, a pokračuje i po převzetí služeb při selhání. Databáze je k dispozici během fáze vrácení změn.