Bemærk
Adgang til denne side kræver godkendelse. Du kan prøve at logge på eller ændre mapper.
Adgang til denne side kræver godkendelse. Du kan prøve at ændre mapper.
Konfiguration af automatiske aggregationer inkluderer aktivering af træning for en understøttet DirectQuery-semantisk model og konfiguration af en eller flere planlagte opdateringer. Efter flere iterationer af trænings- og opdateringsoperationerne er kørt, kan du vende tilbage til de semantiske modelindstillinger for at finjustere procentdelen af rapportforespørgsler, der bruger cachen i hukommelsen for aggregationer. Før du gennemfører disse trin, skal du sikre dig, at du fuldt ud forstår funktionaliteten og begrænsningerne beskrevet i automatiske aggregationer.
Aktivér
Du skal have ejerrettigheder for semantiske modeller for at aktivere automatiske aggregeringer. Workspace-administratorer kan overtage modelejerens rettigheder.
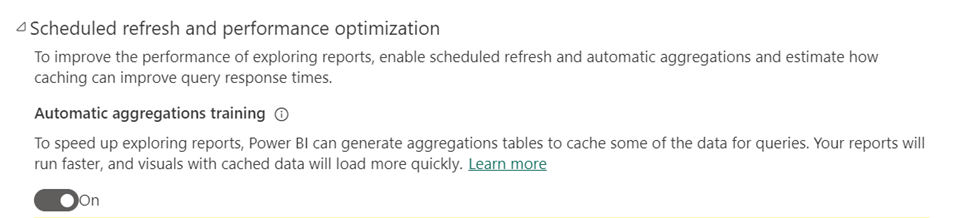
I Semantic Model Settings, udvid Planlagt opdatering og ydeevneoptimering.
Skift automatisk aggregationstræning til Tændt. Hvis switchen er gråtonet, skal du sikre, at datakilde-legitimationer er konfigureret, og at du er logget ind.
I opdateringsskema skal du angive en opdateringsfrekvens og tidszone. Hvis opdateringsplanlægningskontrollerne er deaktiveret, skal du verificere konfigurationen af datakilden, inklusive gateway-forbindelse (hvis nødvendigt) og datakilde-legitimationsoplysninger.
Vælg Tilføj en anden tid, og angiv derefter en eller flere opdateringer.
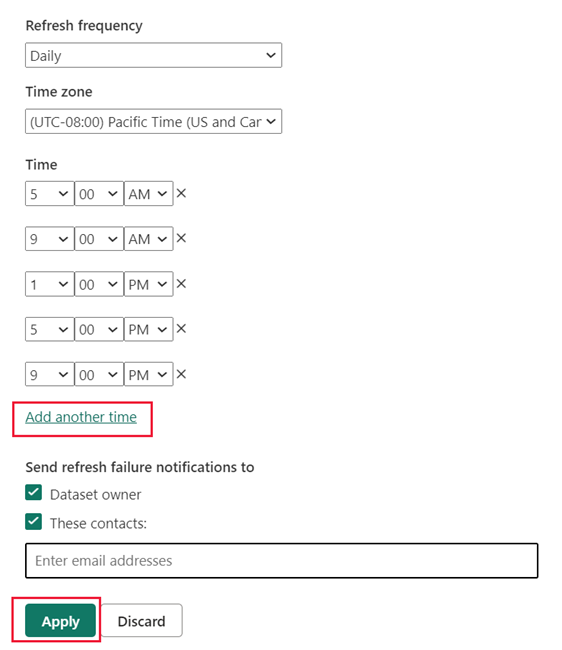
Du skal planlægge mindst én opdatering. Den første opdatering for den frekvens, du vælger, vil inkludere både en træningsoperation og en opdatering, der indlæser nye og opdaterede aggregationer i cachen i hukommelsen. Planlæg flere opdateringer for at sikre, at rapportforespørgsler, der rammer aggregationscachen, giver resultater, der er mest synkroniserede med backend-datakilden. For mere information, se Opfrisk drift.
Vælg Anvend.
On-demand tog- og opdateringsprogram
Den første planlagte opdateringsoperation for din valgte frekvens inkluderer en træningsoperation. Hvis denne træningsoperation ikke fuldføres inden for 60-minutters tidsgrænsen, vil den efterfølgende opdateringsoperation ikke indlæse eller opdatere aggregationer i cachen. Den næste træningsoperation kører først ved den første opdatering af din valgte frekvens.
I sådanne tilfælde kan du manuelt køre en eller flere on-demand trænings- og opdateringsoperationer for fuldt ud at gennemføre træningen og indlæse eller opdatere aggregationer i cachen. For eksempel, når du tjekker opdateringshistorikken, hvis den første planlagte trænings- og opdateringsoperation for dagen (frekvens) ikke bliver færdig inden for tidsgrænsen, og du ikke ønsker at vente på næste dags planlagte opdatering, som inkluderer en træningsoperation, kan du køre en eller flere on-demand tog- og opdateringsoperationer for fuldt ud at behandle dataforespørgselsloggen (train) og load-aggregationerne til cachen (refresh).
For at køre et on-demand tog og opfriske operation, vælg Train and Refresh Now. Sørg for at holde øje med opdateringshistorikken for at sikre, at on-demand træningsoperationen gennemføres med succes. Hvis ikke, kør en ny tog- og opdateringsoperation, indtil træningen er færdig, og aggregationer indlæses eller opdateres i cachen.
At køre Train and Refresh Now kan være nyttigt til at finjustere procentdelen af rapportforespørgsler, der vil bruge aggregationer fra cachen i hukommelsen. Ved at køre en on-demand tog- og opdateringsoperation, kan du hurtigere afgøre, om din nye procentindstilling tillader træningsoperationen at blive færdig inden for tidsgrænsen.
Husk, at trænings- og opdateringsdrift, uanset om de er planlagte eller on-demand, er proces- og ressourcekrævende både for datakilden og Power BI. Vælg et tidspunkt, hvor ressourcerne er mindst påvirket.
Finjustering
Både brugerdefinerede og systemgenererede aggregationstabeller er en del af modellen, bidrager til modelstørrelsen og er underlagt eksisterende Power BI-modelstørrelsesbegrænsninger. Aggregationsbehandling bruger også ressourcer og påvirker modellens opdateringsvarighed. En optimal konfiguration balancerer mellem at levere forudaggregerede resultater fra hukommelsescachen for de mest anvendte rapportforespørgsler, samtidig med at man accepterer langsommere resultater for outlier- og ad hoc-forespørgsler til gengæld for hurtigere træning og opdateringstider samt en reduceret belastning på systemets ressourcer.
Juster procentdelen
Som standard er indstillingen for aggregations-cache, der bestemmer procentdelen af rapportforespørgsler, der vil bruge aggregationer fra hukommelsescachen, 75%. At øge procentdelen betyder, at et større antal rapportforespørgsler rangeres højere, og derfor inkluderes aggregeringer for dem i hukommelsescachen. Selvom en højere procentdel kan betyde, at flere forespørgsler besvares fra cachen i hukommelsen, kan det også betyde længere trænings- og opdateringstider. At justere til en lavere procentdel kan derimod betyde kortere trænings- og opdateringstider samt mindre ressourceforbrug, men rapporteringsvisualiseringspræstationen kan falde, fordi færre rapportforespørgsler besvares af cachen i hukommelsen, da disse forespørgsler i stedet skal rundrejse til datakilden.
Før systemet kan bestemme de optimale aggregationer til cachen, skal det først kende de rapportforespørgselsmønstre, der bruges oftest. Sørg for at lade flere iterationer af trænings-/opdateringsoperationerne blive gennemført, før du justerer procentdelen af forespørgsler, der bruger aggregationscachen. Dette giver træningsalgoritmen tid til at analysere rapportforespørgsler over en bredere periode og selv justere sig derefter. For eksempel, hvis du har planlagt opdateringer til daglig frekvens, kan det være en god idé at vente en hel uge. Mønstrene for brugerrapportering på nogle dage i ugen kan være anderledes end andre.
For at justere procentdelen
I Semantic Model Settings, udvid Planlagt opdatering og ydeevneoptimering.
I Forespørgselsdækning bruger du Juster procentdelen af forespørgsler, der vil bruge den aggregerede cache-skyder , til at øge eller sænke procentdelen til den ønskede værdi. Når du justerer procentdelen, viser diagrammet Query Performance Impact Lift, estimerede svartider for forespørgsler.
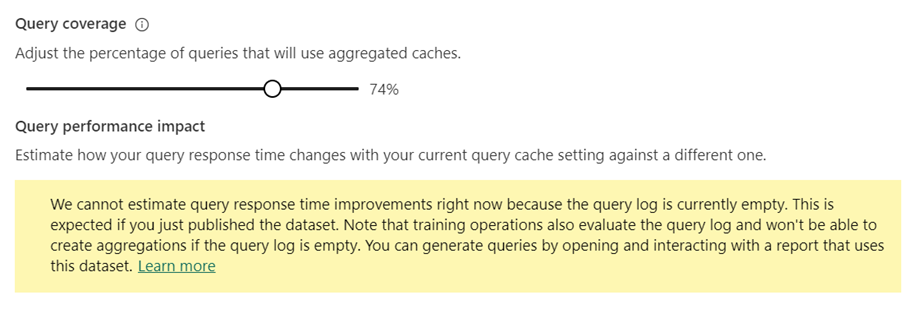
Vælg Train and Refresh Now eller Apply.
Estimering af forespørgselspræstationens indvirkning
Forespørgselspræstationens impact lift-diagram giver estimerede forespørgselskørselstider som funktion af procentdelen af forespørgsler, der vil bruge cachede aggregeringer. Diagrammet vil i starten vise 0,0 for alle målinger, indtil mindst én trænings-/opdateringsoperation er udført. Efter en indledende trænings-/opdateringsoperation kan diagrammet hjælpe dig med at afgøre, om justering af procentdelen af forespørgsler, der bruger cachen i hukommelsen, potentielt kan forbedre svaret på forespørgsler yderligere.
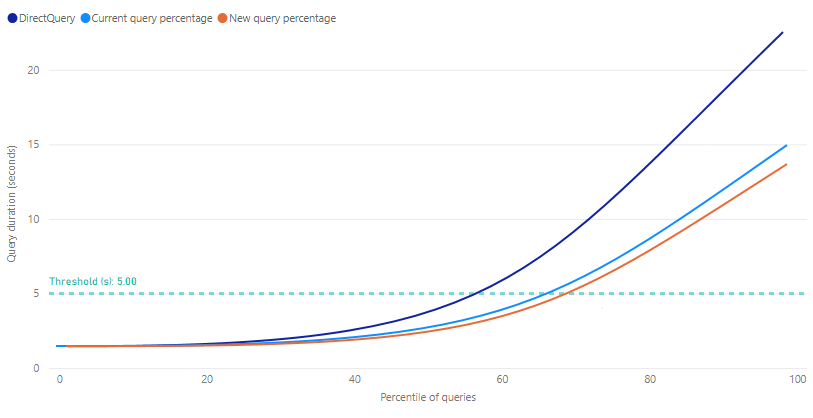
Threshold vises som en markørlinje på liftdiagrammet og angiver den ønskede svartid for forespørgsler for dine rapporter. Du kan derefter finjustere procentdelen af forespørgsler, der skal bruge aggregationscachen, for at bestemme en ny forespørgselsprocent, der opfylder den ønskede tærskel.
Målepunkter
DirectQuery - En estimeret varighed i sekunder for en rapportforespørgsel, der sendes til og returneres fra datakilden ved brug af DirectQuery. Forespørgsler, der ikke kan besvares af cachen i hukommelsen, vil typisk være inden for dette estimat.
Nuværende forespørgselsprocent - En estimeret varighed i sekunder for rapportforespørgsler besvaret fra hukommelsescachen, baseret på procentindstillingen for den seneste trænings-/opdateringsoperation.
Ny forespørgselsprocent - En estimeret varighed i sekunder for rapportforespørgsler besvaret fra hukommelsesaggregationscachen for den nyvalgte procentdel. Når procentdelen ændres, afspejler denne måling den potentielle ændring.
Deaktiver
Du skal have modelejer-tilladelser for at deaktivere automatiske aggregeringer. Workspace-administratorer kan overtage modelejerens rettigheder.
For at deaktivere skal du skifte automatisk aggregationstræning til Slukket.
Når du deaktiverer træning, bliver du bedt om en mulighed for at slette automatiske aggregeringstabeller.
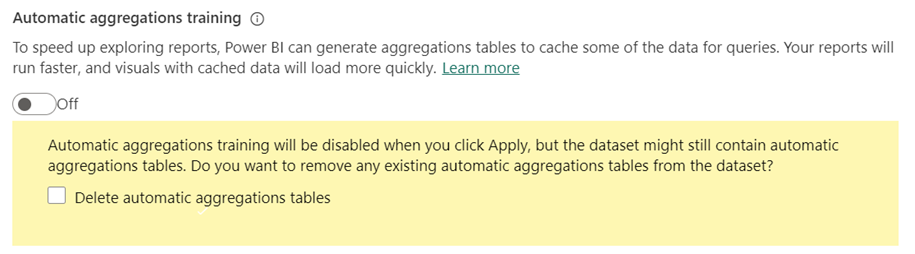
Hvis du vælger ikke at slette eksisterende automatiske aggregeringstabeller, vil tabellerne forblive i modellen og fortsætte med at blive opdateret. Men fordi træningen er deaktiveret, vil der ikke blive tilføjet nye aggregeringer til dem. Power BI vil fortsat bruge de eksisterende tabeller til at få aggregerede forespørgselsresultater, når det er muligt.
Hvis du vælger at slette tabellerne, bliver modellen gendannet til sin oprindelige tilstand uden automatiske aggregeringer.
Vælg Anvend.