Bemærk
Adgang til denne side kræver godkendelse. Du kan prøve at logge på eller ændre mapper.
Adgang til denne side kræver godkendelse. Du kan prøve at ændre mapper.
Forespørgsler, der sendes til en semantisk Direct Lake-model, håndteres typisk fra en cache i hukommelsen for de kolonner, der stammer fra Delta-tabeller. Det underliggende lager for en Delta-tabel er en eller flere Parquet-filer i OneLake. Parketfiler organiserer data efter kolonne i stedet for efter række. Semantiske modeller indlæser hele kolonner fra Delta-tabeller i hukommelsen, da forespørgsler kræver det.
Direct Lake på OneLake er ikke koblet sammen med SQL-analyse-endpointet. Denne arkitektur tilbyder tættere integration med OneLake-funktioner som OneLake-sikkerhed og mere effektive DAX-forespørgselsplaner, fordi for eksempel det ikke er nødvendigt at tjekke SQL-baseret sikkerhed. DirectQuery-fallback understøttes ikke af Direct Lake på OneLake.
Med Direct Lake på SQL-analyseendepunkter kan en DAX-forespørgsel bruge DirectQuery-fallback, som indebærer problemfrit skift til DirectQuery-tilstand. DirectQuery-fallback henter data direkte fra SQL Analytics-slutpunktet for lakehouse'et eller lageret. For eksempel opstår fallback, når SQL-baseret sikkerhed opdages i SQL-analyseendepunkterne. I dette tilfælde sender en DirectQuery-handling en forespørgsel til SQL-analyseslutpunktet. Fallback-handlinger kan resultere i langsommere forespørgselsydeevne.
I følgende afsnit beskrives Begreber og funktioner i Direct Lake, herunder indlæsning af kolonner, indramning, automatiske opdateringer og DirectQuery-fallback.
Kolonneindlæsning (omkodning)
Direct Lake semantiske modeller indlæser data fra OneLake kun, når en forespørgsel anmoder om en kolonne for første gang. Denne on-demand dataindlæsningsproces kaldes transkodning.
Når den semantiske model modtager en DAX-forespørgsel (eller Flerdimensionelle udtryk – MDX), bestemmer den først, hvilke kolonner der skal bruges til at oprette et forespørgselsresultat. Alle kolonner, der bruges direkte af forespørgslen, er nødvendige og også kolonner, der kræves af relationer og målinger. Det antal kolonner, der skal bruges til at oprette et forespørgselsresultat, er typisk betydeligt mindre end det antal kolonner, der er defineret i den semantiske model.
Når den forstår, hvilke kolonner der er behov for, bestemmer den semantiske model, hvilke kolonner der allerede findes i hukommelsen. Hvis de kolonner, der er nødvendige for forespørgslen, ikke er i hukommelsen, indlæser den semantiske model alle data for disse kolonner fra OneLake. Indlæsning af kolonnedata er typisk en hurtig handling, men det kan afhænge af faktorer som kardinaliteten af data, der er gemt i kolonnerne.
Kolonner, der indlæses i hukommelsen , er derefter hjemmehørende i hukommelsen. Fremtidige forespørgsler, der kun involverer residente kolonner, behøver ikke at indlæse flere kolonner i hukommelsen.
En kolonne forbliver hjemmehørende, indtil der er grund til, at den fjernes (fjernes) fra hukommelsen. Årsager til, at kolonner kan blive fjernet, omfatter:
- Modellen eller tabellen blev opdateret efter en deltatabelopdatering ved kilden (se Framing i næste afsnit).
- Kolonnen blev ikke brugt i nogen tid.
- Andre årsager til hukommelsesstyring, herunder hukommelsesforbrug i kapaciteten på grund af andre samtidige handlinger.
Dit valg af Fabric SKU bestemmer den maksimale tilgængelige hukommelse for hver semantiske Direct Lake-model i kapaciteten. For mere information om ressource-sikkerhedsforanstaltninger og maksimale hukommelsesgrænser, se Fabric kapacitetskrav.
Indramning
Framing giver modelejere punkt-i-tid kontrol over, hvilke data der indlæses i den semantiske model. Framing er en Direct Lake-operation, som en opdatering af en semantisk model udløser. I de fleste tilfælde tager det kun få sekunder at gennemføre. Det skyldes, at det er en lavomkostningsoperation, hvor den semantiske model analyserer metadata fra den nyeste version af Delta Lake-tabellerne og opdaterer for at referere til de nyeste Parquet-filer i OneLake.
Når der sker indramning, kan processen fjerne kolonnesegmenter og ordbøger fra den residente tabel fra hukommelsen, hvis de underliggende data ændrede sig. Tidspunktet for opdateringen bliver den nye baseline for alle fremtidige transkodningsbegivenheder. Fra dette tidspunkt overvejer Direct Lake-forespørgsler kun data i Delta-tabellerne fra tidspunktet for den seneste indramning. Af den grund forespørges Direct Lake-tabeller om at returnere data baseret på tilstanden af Delta-tabellen på tidspunktet for den seneste vellykkede indramningshandling. Dette tidspunkt er ikke nødvendigvis den seneste tilstand for Delta-tabellerne.
Den semantiske model analyserer Delta-loggen for hver Delta-tabel under indramningen for kun at slippe de berørte kolonnesegmenter og genindlæse nyligt tilføjede data under omkodning. En vigtig optimering er, at ordbøger normalt ikke droppes, når inkrementel indramning træder i kraft, og nye værdier tilføjes til de eksisterende ordbøger. Denne inkrementelle framing-tilgang hjælper med at reducere genindlæsningsbyrden og gavner forespørgselspræstationen. I det ideelle tilfælde, når en Delta-tabel ikke modtager opdateringer, er der ikke behov for genindlæsning for kolonner, der allerede er beboende i hukommelsen. Forespørgsler viser langt mindre ydelsespåvirkning efter indramning, fordi inkrementel indramning i praksis gør det muligt for den semantiske model at opdatere betydelige dele af de eksisterende data i hukommelsen.
Bemærkning
Rammekonstruktion kan fejle, hvis et Delta-bord overstiger Fabric-kapacitetens rækkevidde, for eksempel når et Delta-bord har mere end 10.000 parketfiler. For mere information om ressourcegelændere, se Fabric kapacitetskrav.
I følgende diagram kan du se, hvordan Direct Lake-indramning fungerer.
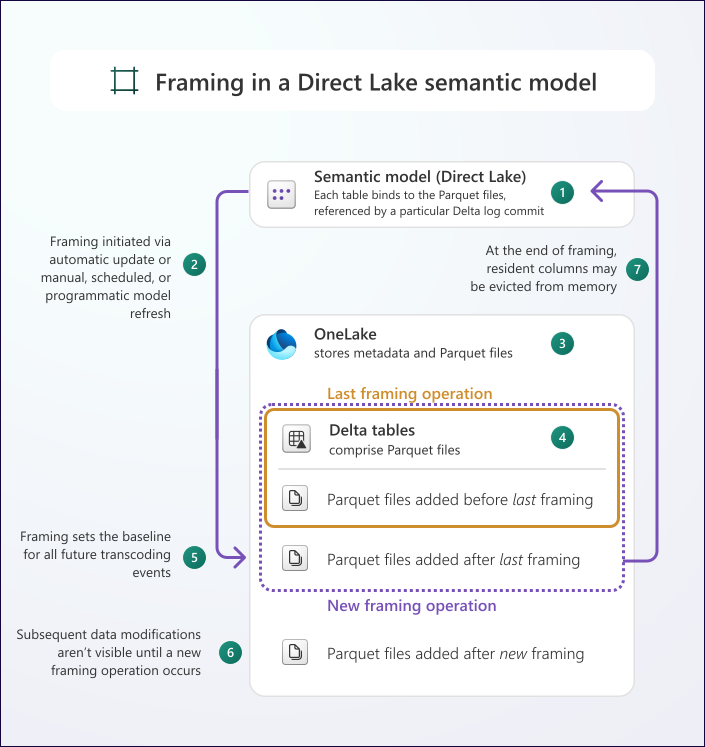
Diagrammet viser følgende processer og funktioner.
| Artikel | Beskrivelse |
|---|---|

|
Der findes en semantisk model i et Fabric-arbejdsområde. |

|
Indramningshandlinger finder sted med jævne mellemrum, og de angiver den oprindelige plan for alle fremtidige omkodningshændelser . Indramning af handlinger kan ske automatisk, manuelt, efter tidsplan eller programmatisk. |

|
OneLake gemmer metadata og Parquet-filer, der repræsenteres som Delta-tabeller. |

|
Den sidste indramningshandling omfatter Parquet-filer, der er relateret til Delta-tabellerne, og især de Parquet-filer, der blev tilføjet før den sidste indramning. |

|
En senere indramningshandling omfatter Parquet-filer, der er tilføjet efter den sidste indramningshandling. |

|
Residente kolonner i den semantiske Direct Lake-model kan blive fjernet fra hukommelsen, og tidspunktet for opdateringen bliver den nye grundlinje for alle fremtidige transkodningshændelser. |

|
Efterfølgende dataændringer, der repræsenteres af nye Parquet-filer, er ikke synlige, før den næste indramningshandling finder sted. |
Det er ikke altid ønskeligt at have data, der repræsenterer den seneste tilstand af en Delta-tabel, når der udføres en omkodningshandling. Overvej, at indramning kan hjælpe dig med at levere ensartede forespørgselsresultater i miljøer, hvor data i Delta-tabeller er midlertidige. Data kan være midlertidige af flere årsager, f.eks. når der forekommer langvarige ekstrakt-, transformerings- og indlæsningsprocesser (ETL).
Du kan opdatere en Direct Lake-semantisk model manuelt, automatisk eller programmatisk.
Automatiske opdateringer
Direct Lake-semantiske modeller har en model-niveau indstilling kaldet Keep your Direct Lake-data up-to-date, som udfører automatiske opdateringer af Direct Lake-tabeller. Den er aktiveret som standard. Det sikrer, at dataændringer i OneLake automatisk afspejles i den semantiske Direct Lake-model. Du kan finde indstillingen i Fabric-portalen, i Refresh-sektionen af de semantiske modelindstillinger.
Når indstillingen er aktiveret, udfører den semantiske model en indramningsoperation , hver gang dataændringer i de underliggende Delta-tabeller opdages. Framing-operationen er begrænset til kun de tabeller, hvor dataændringer opdages.
Vi anbefaler, at du lader indstillingen være tændt, især når du har en lille eller mellemstor semantisk model. Det er især nyttigt, når du har lav-latenstid-rapporteringskrav, og Delta-tabeller ændres regelmæssigt.
I nogle situationer kan du ønske at deaktivere automatiske opdateringer. For eksempel kan du være nødt til at tillade færdiggørelse af dataforberedelsesjobs eller en extract, transform, and load (ETL)-proces, før nye data eksponeres for forbrugere af den semantiske model. Når den er deaktiveret, kan du manuelt udløse en opdatering i Fabric-portalen, på en opdateringsplan eller programmatisk ved at bruge Power BI REST API eller Tabular Object Model (TOM).
Vigtigt!
Power BI suspenderer automatiske opdateringer, når der opstår en ikke-genoprettelig fejl under en opdatering. En ikke-genoprettelig fejl kan for eksempel opstå, når en opdatering fejler efter flere forsøg. Hvis dine automatiske opdateringer stopper, skal du bekræfte, at den semantiske model kan opdateres korrekt. Power BI genoptager automatisk automatiske opdateringer, når en efterfølgende on-demand opdatering er fuldført uden fejl.
Tips
Du kan konfigurere automatisk sideopdatering i dine Power BI-rapporter. Denne funktion opdaterer automatisk en specifik rapportside, forudsat at rapporten forbinder til en Direct Lake semantisk model (eller andre typer semantiske modeller).
DirectQuery-fallback
Når du bruger Direct Lake på SQL-analyseendepunkter, kan en forespørgsel sendt til en Direct Lake-semantisk model falde tilbage til DirectQuery-tilstand. I denne tilstand fungerer tabellen ikke længere i Direct Lake-tilstand. Den henter data direkte fra SQL Analytics-slutpunktet for lakehouse eller warehouse. Sådanne forespørgsler returnerer altid de nyeste data, fordi de ikke er begrænset til tidspunktet for den sidste indramningshandling. Dog kan fallback-operationer resultere i langsommere forespørgselsydelse.
Vigtigt!
Hvis muligt, så design altid din løsning eller dimensioner din kapacitet for at undgå DirectQuery-fallback. Det skyldes, at det kan resultere i langsommere forespørgselsydeevne.
Direct Lake på OneLake kører udelukkende i DirectLakeOnly-tilstand og understøtter ikke DirectQuery fallback. For nye semantiske modeller er det den anbefalede Direct Lake-mulighed.
Når Direct Lake-tilstand anvendes
Forespørgsler forbliver i Direct Lake-tilstand (undgår DirectQuery-faldback) kun når alle følgende betingelser er opfyldt:
- Den semantiske model refererer ikke til nogen tabeller, der har SQL row-level security (RLS) defineret ved SQL-analyse-endpointet.
- Den semantiske model refererer ikke til nogen tabeller, der har SQL dynamic data masking (DDM) defineret ved SQL-analyse-endpointet.
- Den semantiske model refererer ikke til nogen tabeller, der har SQL object-level security (OLS) defineret ved SQL-analyse-endpointet.
- Den semantiske model refererer ikke til nogen tabeller baseret på umaterialiserede SQL-visninger.
- Ingen enkelt tabel i den semantiske model overskrider rækkergrænsen som defineret i Fabric-kapacitetskravene:
- Antallet af Parquet-filer er inden for grænsen.
- Antallet af rækkegrupper er inden for grænsen.
- Antallet af rækker er inden for grænsen.
- Du opdaterede (indrammede) den semantiske model, efter du oprettede eller ændrede de underliggende Delta-tabeller.
En enkelt tabel, der overstiger enhver sikkerhedsgrænse, forhindrer Direct Lake-tilstand for hele modellen.
Kontrol-fallback med DirectLakeBehavior
Når Direct Lake-betingelserne ikke er opfyldt, afhænger adfærden af dine semantiske modeller af DirectLakeBehavior-indstillingen . Denne indstilling gælder kun for Direct Lake på SQL-analyseendepunkter.
Sæt DirectLakeBehavior-egenskaben til en af følgende tre værdier:
| Værdi | Beskrivelse |
|---|---|
| Automatisk | (Standard) Hvis betingelserne ikke er opfyldt, falder forespørgslen lydløst tilbage til DirectQuery-tilstand. Rapporterne fortsætter med at virke, men ydeevnen kan være langsommere. Brug denne tilstand i produktion for at bevare funktionaliteten for dine brugere. |
| DirectLakeOnly | Hvis betingelserne ikke er opfyldt, fejler forespørgslen med en fejl. Brug denne tilstand under udviklingen til at identificere og løse fejl. |
| DirectQueryOnly | Forespørgslen bruger altid DirectQuery-tilstand. Brug denne tilstand under udviklingen til at måle fallback-ydeevne. |
Sæt DirectLakeBehavior
I modelvisningen åbner du Egenskaber-panelet for den semantiske model og ændrer indstillingen for Direct Lake-adfærd .
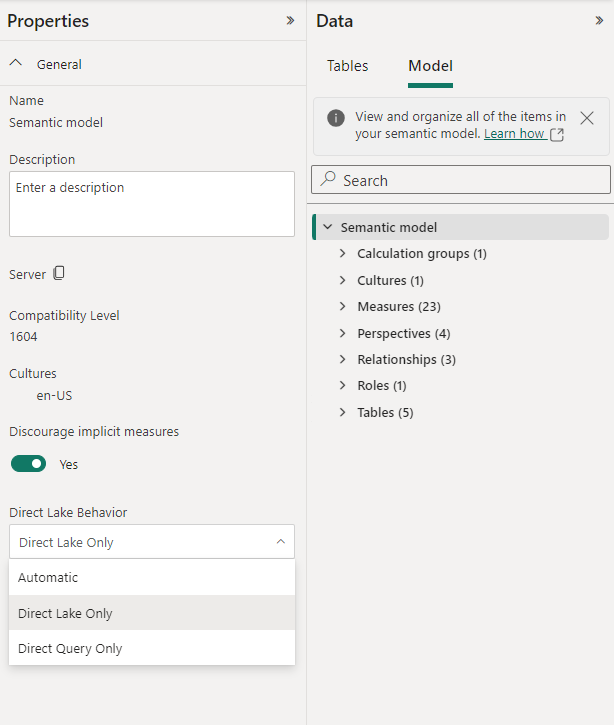
Sæt DirectLakeBehavior programmatisk
Du kan også konfigurere DirectLakeBehavior-egenskaben ved at bruge Tabular Object Model (TOM) eller Tabular Model Scripting Language (TMSL).
Følgende eksempel angiver, at alle forespørgsler kun bruger Direct Lake-tilstand:
// Disable fallback to DirectQuery mode.
database.Model.DirectLakeBehavior = DirectLakeBehavior.DirectLakeOnly;
database.Model.SaveChanges();
For mere information, se Model.DirectLakeBehavior Property.
Diagnosticér fallback
For at identificere hvilke tabeller der falder tilbage og hvorfor, kør følgende DAX-forespørgsel:
EVALUATE TABLETRAITS()
Kolonnen [DirectLakeFallbackInfo] viser årsagen til fallback-metoden for hver tabel. En værdi af None betyder, at tabellen bruger Direct Lake-tilstand.
Ret almindelige fallback-årsager
Brug denne tabel til at identificere løsningen for hvert fallback-scenarie:
| Fallback-sag | Afhjælpning |
|---|---|
| Bordet er ikke indrammet | Opdater den semantiske model for at ramme tabellerne. Efter at have tilføjet tabeller programmatisk via TOM eller TMSL, skal du altid opdatere før forespørgslen. |
| Tabellen er baseret på en SQL-visning | Materialiser visningen som en delta-tabel, eller accepter DirectQuery-ydelse for den tabel. |
| Tabellen findes ikke | Tjek at delta-tabellen findes i søhuset eller lageret. Tjek for skema-drift eller slettede tabeller. |
| Midlertidig fejl | Prøv forespørgslen igen. Hvis den er vedvarende, tjek kapacitetens sundhed og opdater den semantiske model. |
| OLS defineret ved SQL analytics-endpointet | Flyt objektniveau-sikkerhed til den semantiske model, eller accepter DirectQuery-fallback. |
| RLS eller DDM defineret ved SQL analytics-endpointet | Flyt række-niveau sikkerhed til den semantiske model, eller accepter DirectQuery-fallback. |
| Delta-tabellen overstiger autoværnet | Kør OPTIMIZE og VACUUM på delta-tabellen for at reducere parquet-filer og rækkegrupper. Hvis bordet stadig overskrider grænserne, opgrader til en højere Fabric SKU. |
| Kapacitet under hukommelsespres | Reducer samtidige arbejdsbelastninger, optimer andre modeller eller opgrader kapacitets-SKU'en. |
For detaljeret forespørgselsniveauanalyse med Effektivitetsanalyse eller SQL Server Profiler, se Analyze query processing for Direct Lake semantiske modeller.