Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Zurzeit wird folgendes angezeigt: Neue Version des Foundry-Portals - Wechseln zur Version für das klassische Foundry-Portal
Spillover gleicht Datenverkehrsschwankungen bei bereitgestellten Bereitstellungen aus, indem es Anforderungen, die das Kontingent überschreiten, automatisch an eine entsprechende Standardbereitstellung weiterleitet. Wenn Ihre bereitgestellte Bereitstellung vollständig ausgelastet ist und Nicht-200-Antworten zurückgibt (z. B. 429, wenn die PTUs erschöpft sind), leitet Spillover diese Anforderungen an die Standardbereitstellung weiter und trägt so dazu bei, Unterbrechungen bei Datenverkehrsspitzen zu verringern. Diese optionale Funktion kann für alle Anfragen in einer Bereitstellung konfiguriert oder pro Anfrage verwaltet werden.
Voraussetzungen
- Ein Azure-Abonnement. Erstellen Sie eine kostenlos.
- Eine bereitgestellte verwaltete Bereitstellung und eine Standardbereitstellung in derselben Foundry-Ressource.
- Azure CLI für REST-API-Beispiele oder Zugriff auf das Foundry-Portal installiert.
- Die
AZURE_OPENAI_ENDPOINT-Umgebungsvariable, die auf die Endpoint-URL Ihres Azure OpenAI-Diensts festgelegt ist. - Mitwirkender für Cognitive Services-Rolle oder höher in der Foundry-Ressource zum Erstellen oder Ändern von Bereitstellungen.
Aktivieren des Überlaufs für alle Anforderungen in einer bereitgestellten Bereitstellung
-
Melden Sie sich bei Microsoft Foundry an. Stellen Sie sicher, dass die Umschaltfläche "Neue Gießerei " aktiviert ist. Diese Schritte beziehen sich auf Foundry (neu).
Wählen Sie das Abonnement und die Ressource in der Region aus, in der Sie ein Kontingent haben.
Wählen Sie " Entdecken" in der oberen rechten Navigation und dann " Modelle " im linken Bereich aus.
Wählen Sie den Filter Sammlungen aus und filtern Sie nach Direkt von Azure, um Modelle anzuzeigen, die direkt von Azure verkauft werden. Einige dieser Modelle unterstützen die Bereitstellungsoption für bereitgestellten Durchsatz.
Wählen Sie das Modell aus, das Sie bereitstellen möchten, um die Modellkarte zu öffnen.
Wählen Sie Bereitstellen>Benutzerdefinierte Einstellungen aus, um Ihre Bereitstellung zu konfigurieren. Das Dropdownmenü " Bereitstellungstyp" listet bereitgestellte Bereitstellungstypen auf, die für das ausgewählte Modell verfügbar sind.
Hinweis
Um den Überlauf zu aktivieren, muss Ihr Konto über mindestens eine aktive Pay-as-you-go-Bereitstellung verfügen, die mit dem Modell und der Version Ihrer aktuellen bereitgestellten Bereitstellung übereinstimmt.
Legen Sie den Bereitstellungstyp auf eine der bereitgestellten Optionen fest, z. B. global bereitgestellter Durchsatz.
Wählen Sie Verkehrsüberlauf aus, um den Überlauf für Ihren bereitgestellten Einsatz zu aktivieren.
Aktivieren des Überlaufs für ausgewählte Ableitungsanforderungen
Um den Überlauf auf Anforderungsbasis selektiv zu aktivieren, legen Sie den Rückschlussanforderungsheader x-ms-spillover-deployment auf das Standardbereitstellungsziel für Überlaufanforderungen fest. Wenn der x-ms-spillover-deployment Header nicht für eine bestimmte Anforderung festgelegt ist, wird der Überlauf im Falle einer Nicht-200-Antwort nicht initiiert. Die Verwendung oder Auslassung dieses Headers bietet die Flexibilität, zu steuern, wann ein Überlauf für eine bestimmte Workload oder ein bestimmtes Szenario initiiert werden soll oder nicht.
curl $AZURE_OPENAI_ENDPOINT/openai/deployments/spillover-ptu-deployment/chat/completions?api-version=2024-10-21 \
  -H "Content-Type: application/json" \
  -H "x-ms-spillover-deployment: spillover-standard-deployment" \
  -H 'Authorization: Bearer YOUR_AUTH_TOKEN' \
  -d '{"messages":[{"role": "system", "content": "You are a helpful assistant."},{"role": "user", "content": "Does Azure OpenAI support customer managed keys?"},{"role": "assistant", "content": "Yes, customer managed keys are supported by Azure OpenAI."},{"role": "user", "content": "Do other Azure services support this too?"}]}'
Eine erfolgreiche Anforderung gibt den HTTP-Status 200 mit der Chatabschlussantwort zurück. Wenn ein Überlauf erfolgt, enthält die Antwort den x-ms-spillover-from-deployment Header.
Reference:Chat-Vervollständigung erstellen
Hinweis
Wenn die Überlauffunktion für die Bereitstellung mithilfe der spilloverDeploymentName-Eigenschaft aktiviert und zudem auf Anforderungsebene mithilfe des x-ms-spillover-deployment-Headers aktiviert wird, verwendet das System standardmäßig die Einstellung der Bereitstellungseigenschaft. Wenn Sie sicherstellen möchten, dass der Überlauf nur pro Anforderung aktiviert ist, legen Sie die spilloverDeploymentName Eigenschaft nicht für die bereitgestellte Bereitstellung fest, und verlassen Sie sich nur auf die x-ms-spillover-deployment Kopfzeile pro Anforderung.
Identifizieren von Überlaufanforderungen
Die folgenden HTTP-Antwortheader geben an, dass eine bestimmte Anforderung übergelaufen ist:
-
x-ms-spillover-from-deployment: Enthält den PTU-Bereitstellungsnamen. Das Vorhandensein dieses Headers gibt an, dass es sich bei der Anforderung um eine Überlaufanforderung handelt. -
x-ms-deployment-name: Enthält den Namen der Bereitstellung, die der Anforderung dient. Wenn die Anforderung überläuft, ist der Bereitstellungsname der Name der Standardbereitstellung. -
x-ms-spillover-errorwird für jede Anforderung zurückgegeben, die überläuft und den Antwortcode der bereitgestellten Bereitstellung enthält, die den Überlauf ausgelöst hat (z. B. 429, 500 oder 503). Es ist vorhanden, unabhängig davon, ob der Spillover-Versuch letztendlich gelingt oder nicht.
Wenn eine Anfrage überläuft und auch von der Standardbereitstellung nicht verarbeitet werden kann, wird die Antwort der Standardbereitstellung (einschließlich Statuscode und Antworttext) an den Aufrufer zurückgegeben. Die x-ms-spillover-from-deployment- und x-ms-spillover-error-Header sind weiterhin vorhanden, sodass der Aufrufer einen Spillover-Fehler von einem direkten Standardbereitstellungsfehler unterscheiden kann.
Überwachung der Überschussnutzung
Spillover basiert auf einer Kombination aus provisionierten und Standardbereitstellungen, um zusätzliches Verkehrsaufkommen zu verwalten, sodass die Überwachung für jede Bereitstellung auf Bereitstellungsebene erfolgen kann. Um zu sehen, wie viele Anforderungen vom primär bereitgestellten Deployment im Vergleich zum Standarddeployment im Spillover-Modus verarbeitet wurden, verwenden Sie die Aufteilungsfunktion in Azure Monitor Metriken, um die Anforderungen anzuzeigen, die von jedem Deployment verarbeitet werden, sowie deren jeweiligen Statuscodes. Verwenden Sie auf ähnliche Weise die Aufteilungsfunktion, um zu sehen, wie viele Tokens in der primär bereitgestellten Bereitstellung gegenüber der Standard-Überlaufbereitstellung in einem bestimmten Zeitraum verarbeitet wurden.
Folgendes Azure Monitor-Metrikdiagramm stellt ein Beispiel für die Aufteilung von Anforderungen zwischen der primären bereitgestellten Bereitstellung und der Überlaufstandardbereitstellung beim Initiieren des Überlaufs bereit. Navigieren Sie zum Erstellen eines Diagramms im portal Azure zu Ihrer Ressource.
Wählen Sie ">" im linken Navigationsmenü aus.
Fügen Sie die Metrik
Azure OpenAI Requestshinzu.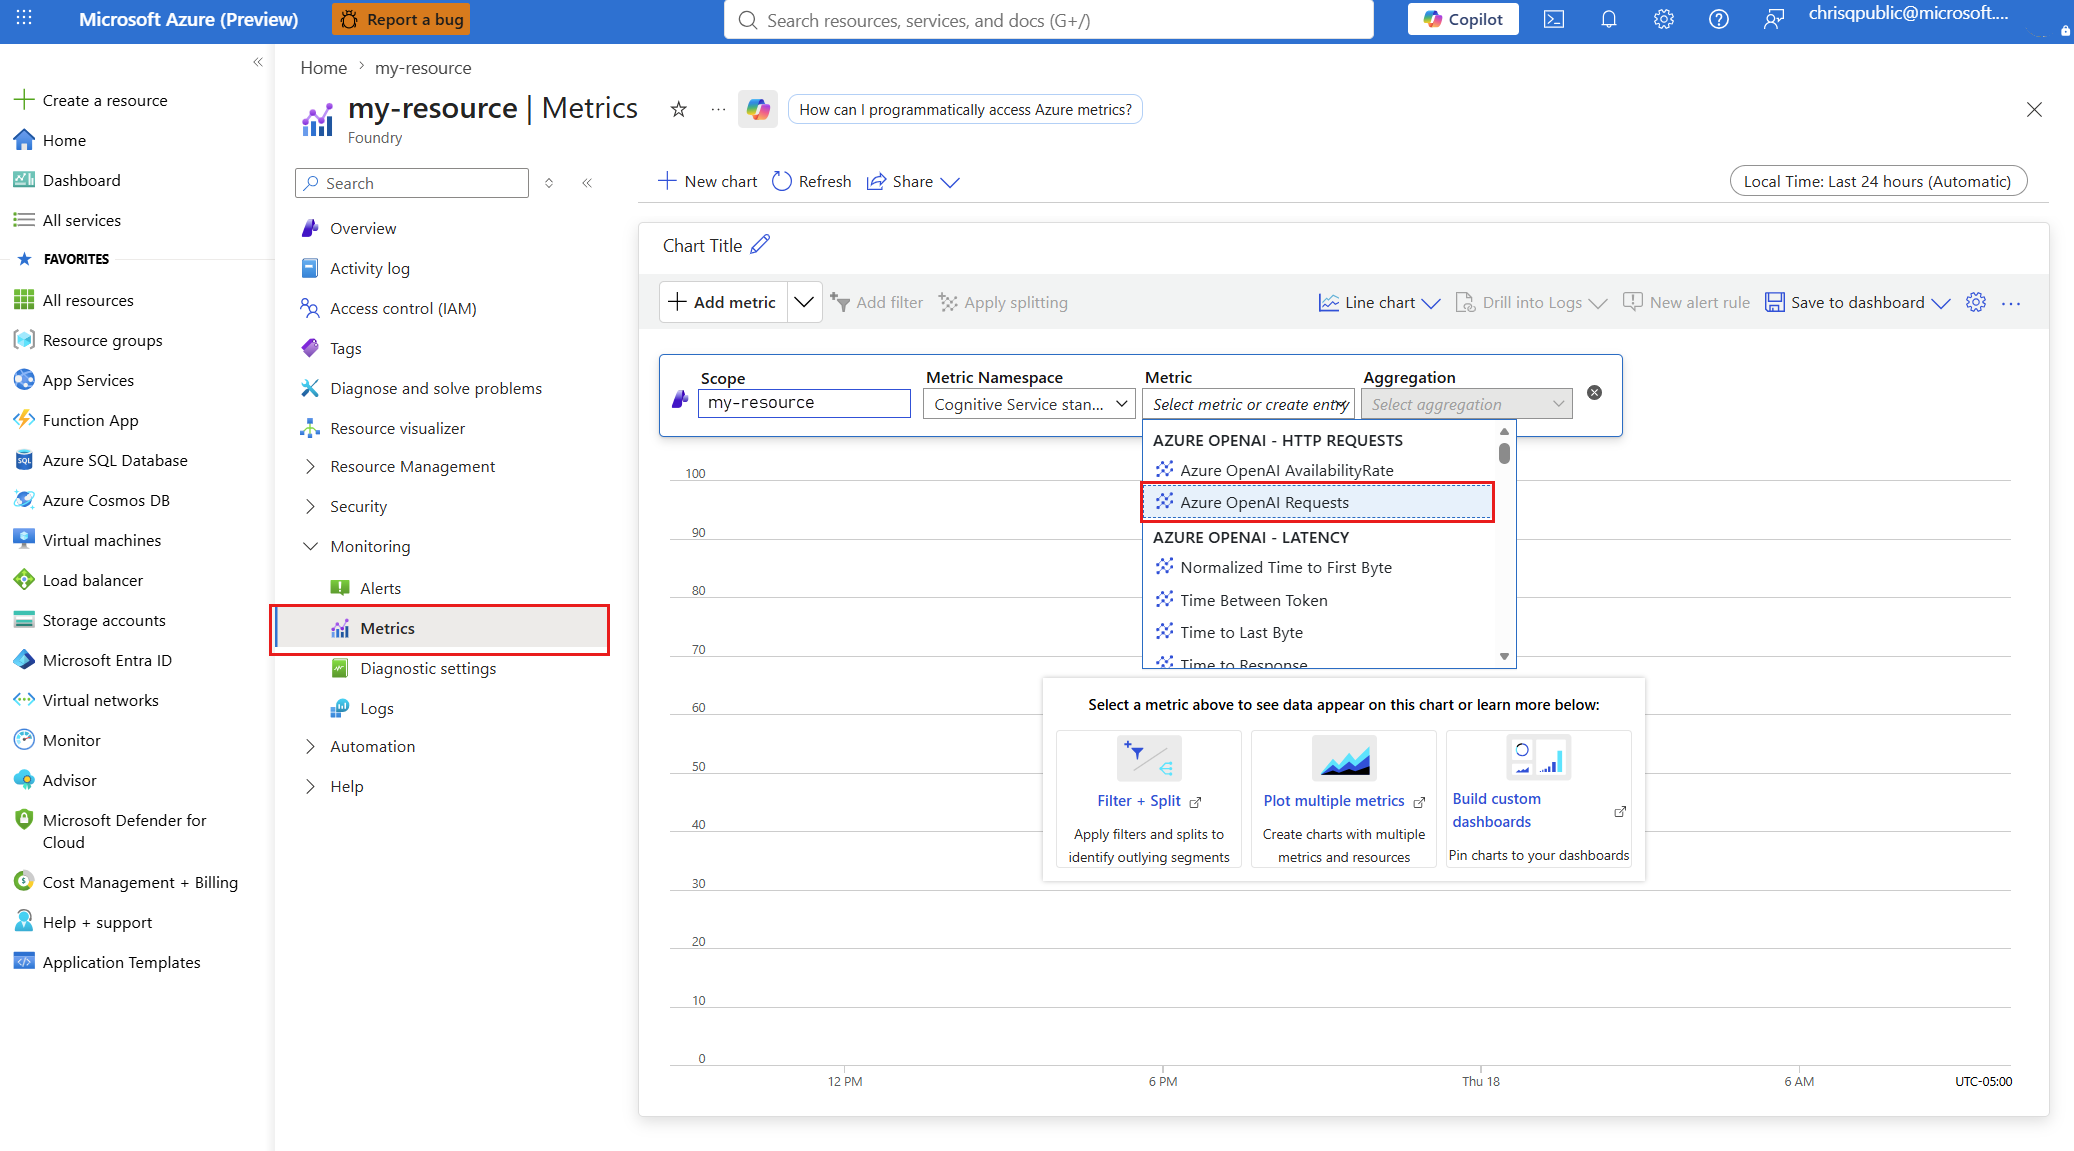
Wählen Sie Anwendung der Teilung aus, und wenden Sie die
ModelDeploymentNameTeilung und dieStatusCodeTeilungen auf dieAzure OpenAI RequestsMetrik an. Hier wird ein Diagramm mit dem200(Erfolg) und dem400(Fehlercode) angezeigt, die für Ihre Ressource generiert wurden. Die Anzahl für den Fehlercode ist derzeit null im Diagramm.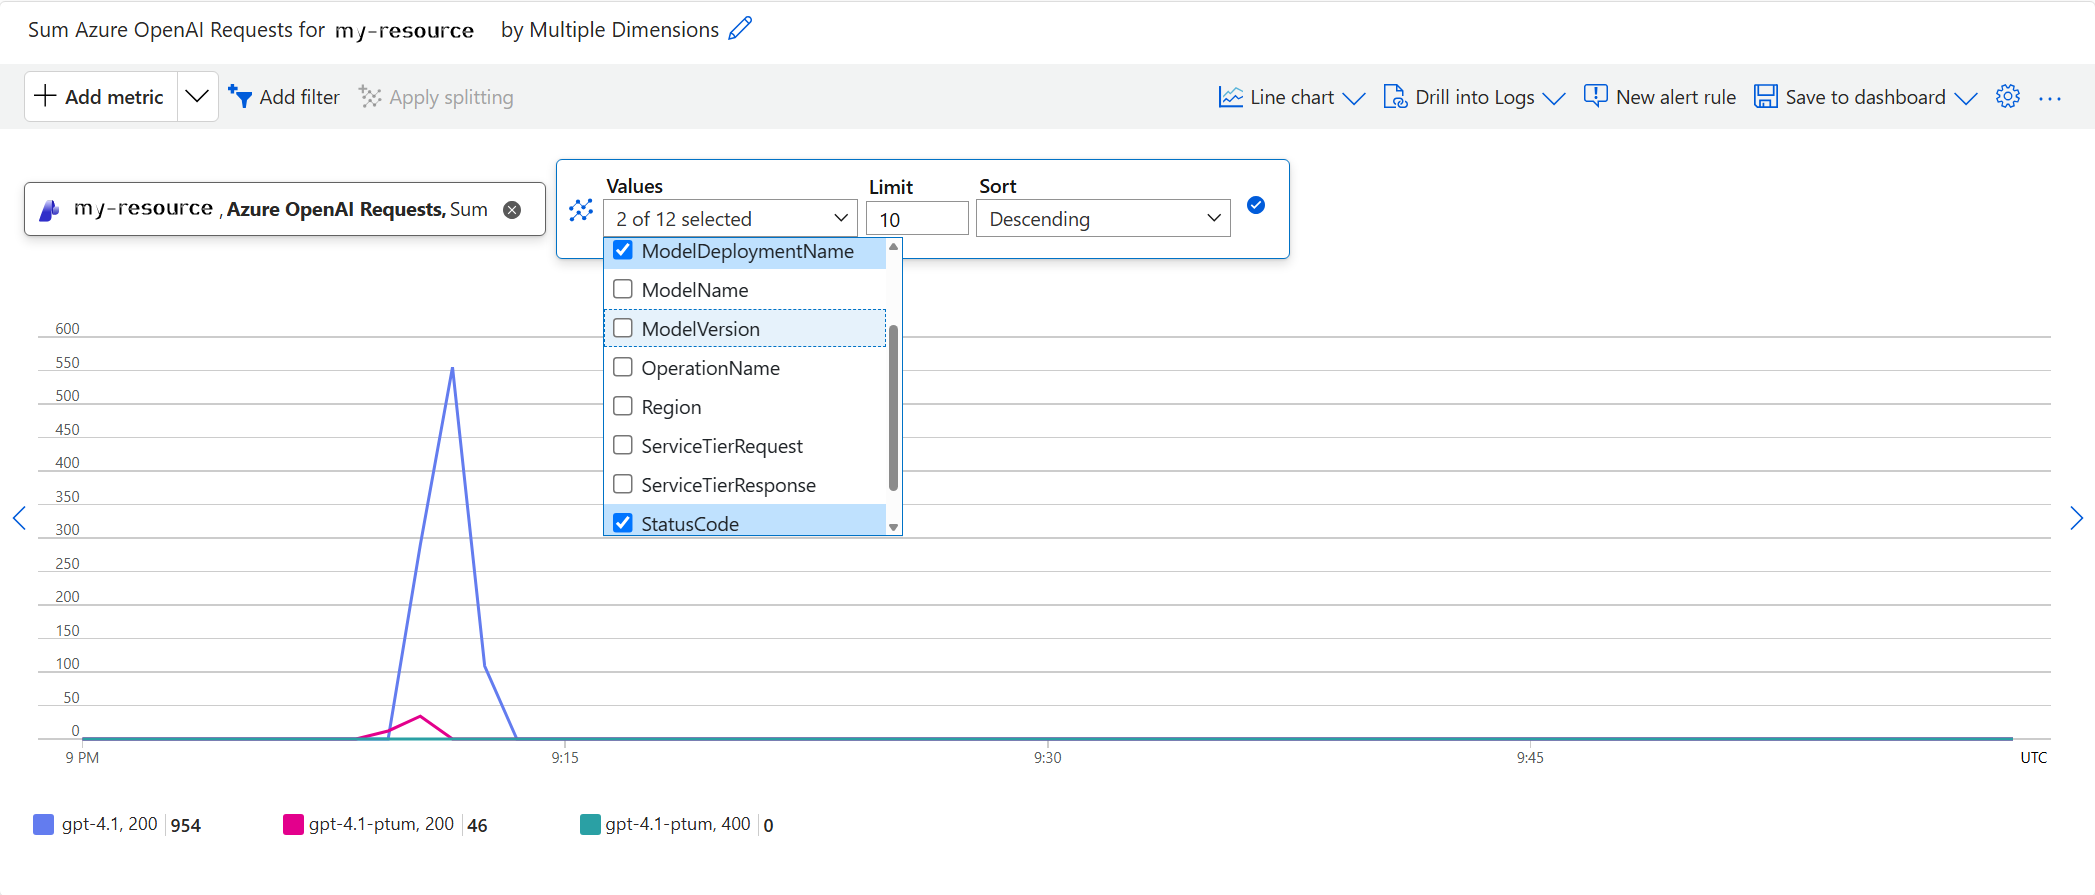
Wählen Sie "Filter hinzufügen" aus. Legen Sie im Filterfeld die Eigenschaft auf
ModelDeploymentNameund legen Sie die Werte auf die Modellbereitstellungen fest, die Sie anzeigen möchten.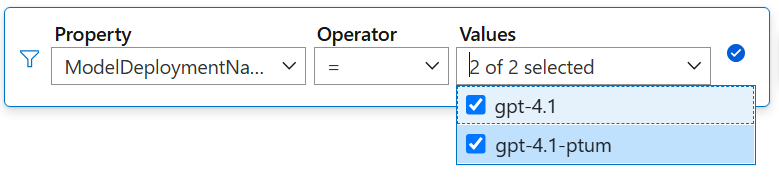
Jede Anfrage, die von der bereitgestellten Bereitstellung nicht bedient werden kann (d. h.
429,500oder503zurückgibt), wird sofort an die Pay-as-you-go-Bereitstellung umgeleitet, die für den Überlauf verwendet wird; dort wird sie verarbeitet und als200-Antwort gezählt (gpt-4.1, 200 = 954). Die Zeile der bereitgestellten Bereitstellung (gpt-4.1-ptum, 200 = 46) spiegelt nur die Anfragen wider, die von ihr direkt verarbeitet wurden, da übergelaufene Anfragen nicht als429s in der bereitgestellten Bereitstellung gezählt werden. Um den Spillover-Datenverkehr vom direkten Datenverkehr in der Standardbereitstellung zu unterscheiden, wenden Sie dieIsSpillover-Aufteilung an, wie im nächsten Abschnitt gezeigt.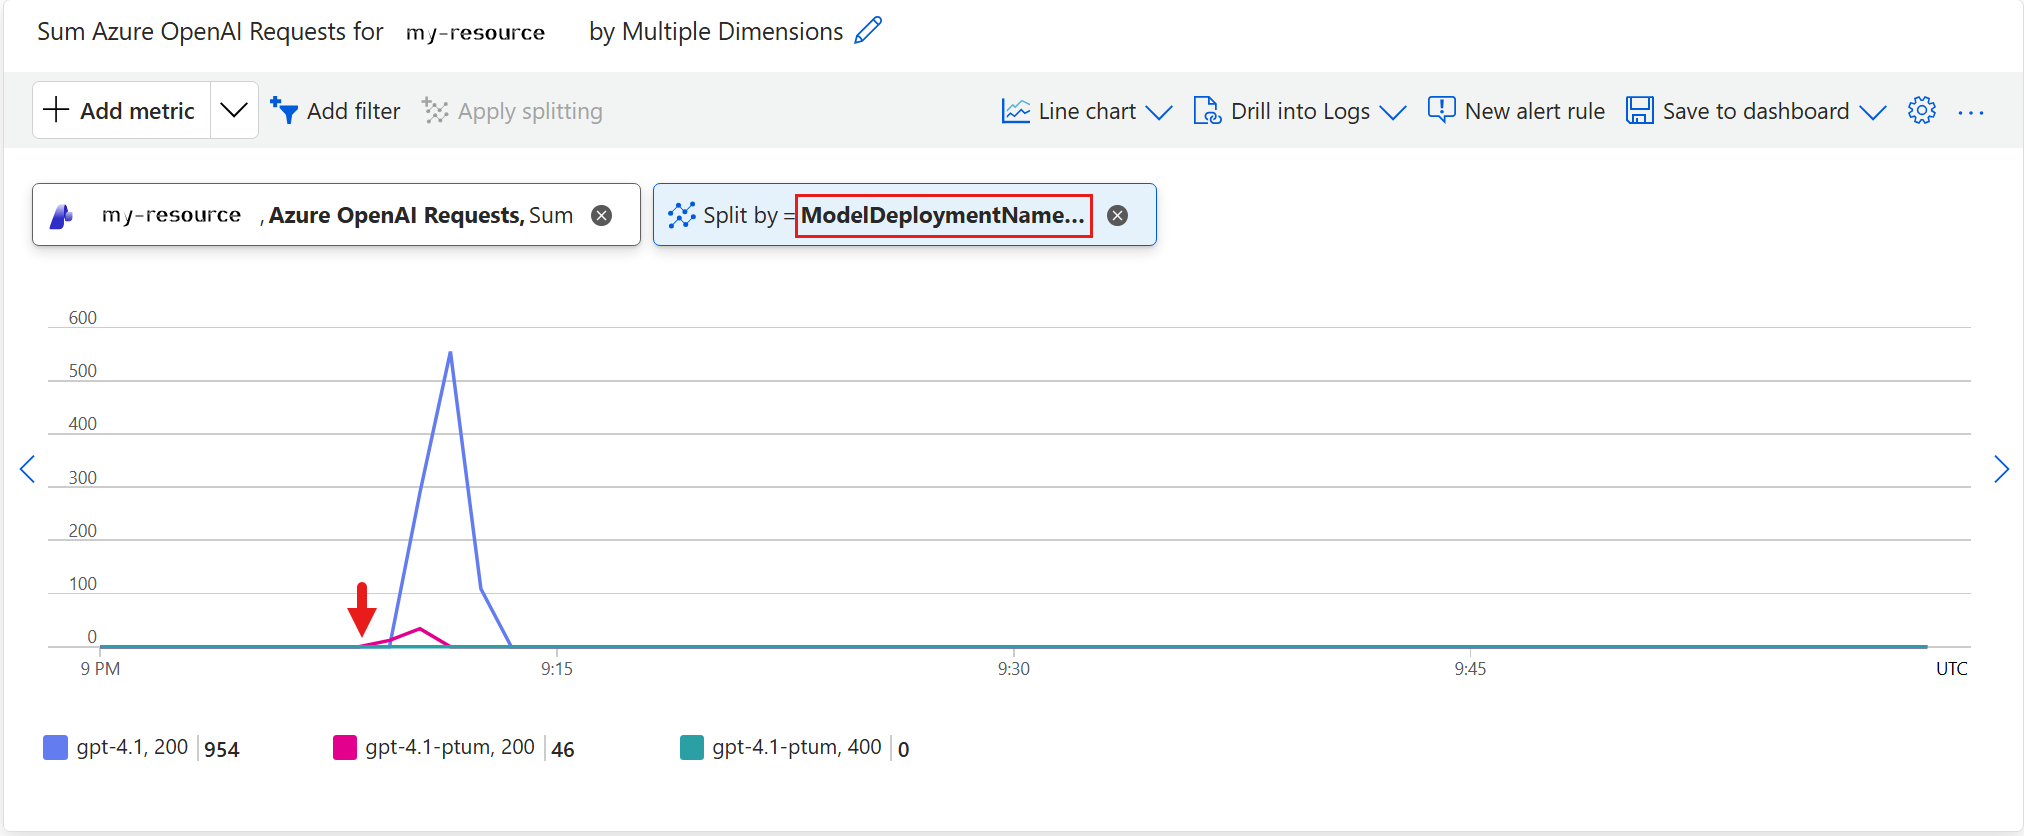
Überlaufmetriken anzeigen
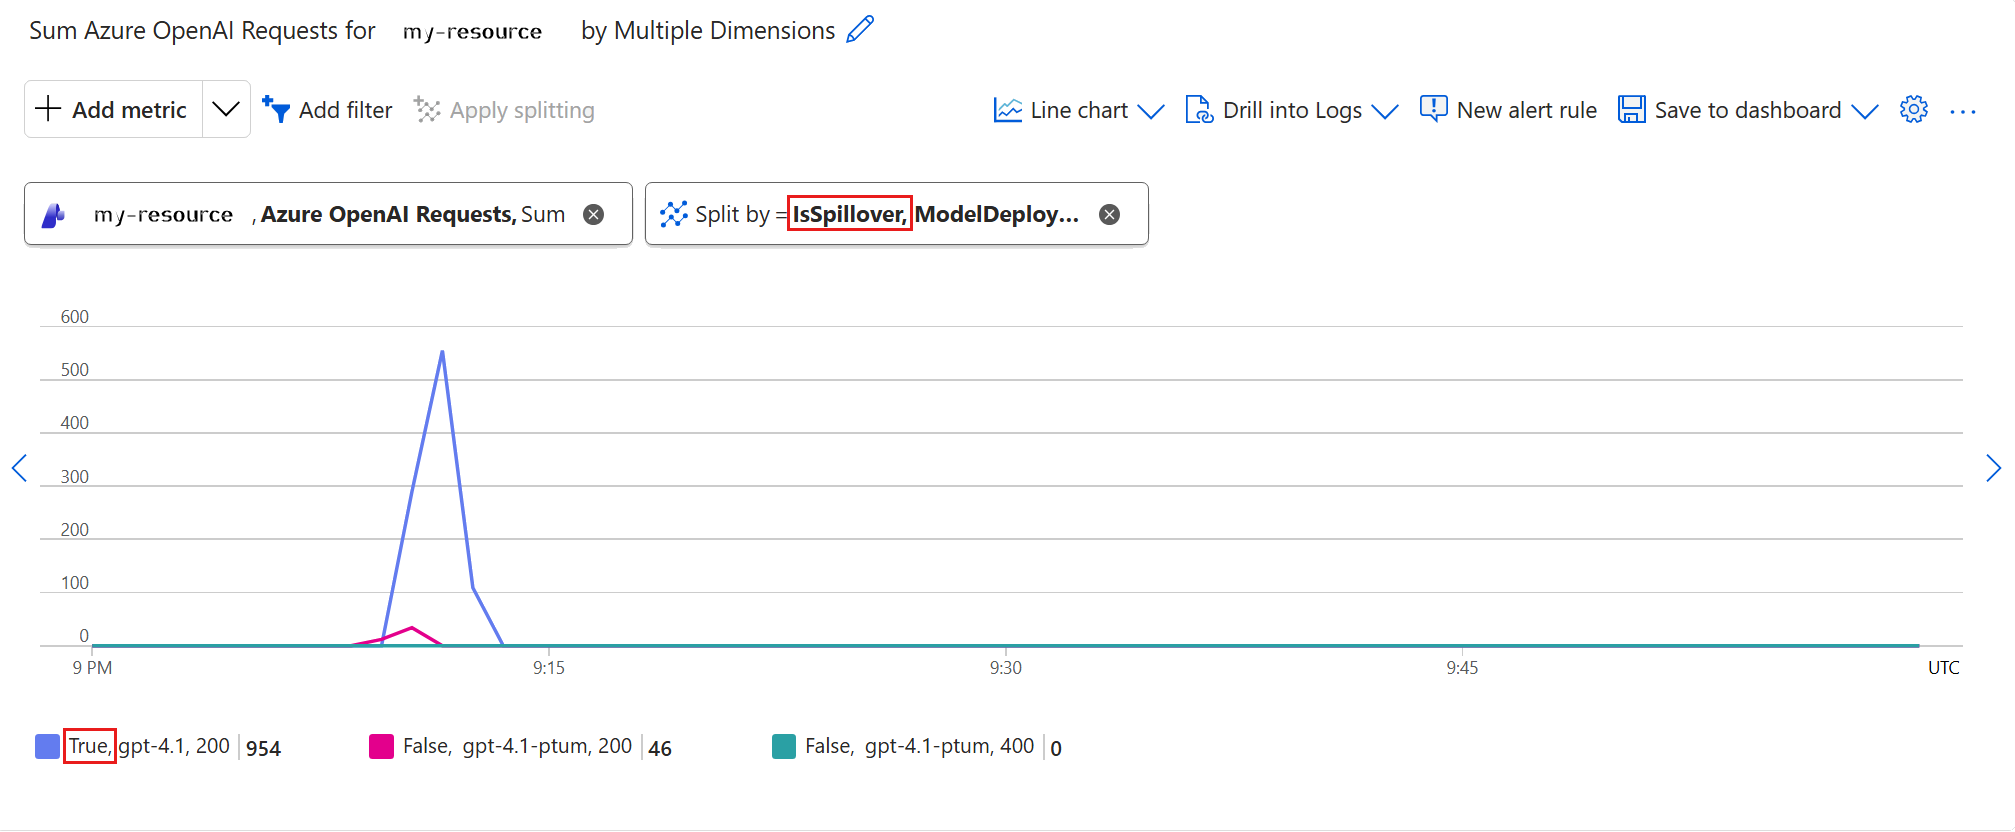
Wenn Sie die IsSpillover-Aufteilung anwenden, können Sie anzeigen, welche Anforderungen für Ihre Standardbereitstellung über einen Überlauf von einer bereitgestellten Bereitstellung eingetroffen sind. Übergelaufene Anfragen erscheinen in der Standardbereitstellung als Datensätze mit IsSpillover = True und ihrem endgültigen Statuscode (in der Regel 200). Sie werden bei der bereitgestellten Bereitstellung nicht doppelt als 429 gezählt.
Im folgenden Diagramm wird die übergelaufene Anforderung als IsSpillover=True, gpt-4.1, 200 = 954 nur für die Standardbereitstellung angezeigt. Die bereitgestellte Bereitstellung hat keinen IsSpillover=True-Datensatz.
Wann soll Überlauf aktiviert werden?
Um die Auslastung Ihrer bereitgestellten Bereitstellung zu maximieren, sollten Sie Spillover für alle globalen und für Datenzonen bereitgestellten Bereitstellungen aktivieren. Mit Überlauf können Spitzen oder Schwankungen des Datenverkehrs automatisch vom Dienst verwaltet werden. Diese Funktion reduziert das Risiko, dass Unterbrechungen auftreten, wenn eine bereitgestellte Bereitstellung vollständig genutzt wird. Alternativ kann der Überlauf pro Anforderung konfiguriert werden, um Flexibilität in verschiedenen Szenarien und Workloads bereitzustellen. Spillover funktioniert auch mit dem Foundry Agent Service.
Wenn der Überlauf in Kraft tritt
Wenn Sie einen Überlauf für eine Bereitstellung aktivieren oder für eine bestimmte Inference-Anforderung konfigurieren, wird der Überlauf ausgelöst, wenn ein bestimmter Nicht-200-Antwortcode als Ergebnis eines dieser Szenarien empfangen wird.
Bereitgestellte Durchsatzeinheiten (PTU) werden vollständig verwendet, was zu einem
429Antwortcode führt.Sie senden eine lange Kontexttokenanforderung, was zu einem
400Fehlercode führt. Wenn Sie beispielsweise Serienmodelle verwendengpt 4.1, unterstützt PTU nur Kontextlängen unter 128K und gibt HTTP 400 zurück.Serverfehler treten beim Verarbeiten Ihrer Anforderung auf, was zu Fehlercode
500oder503.
Wenn eine Anforderung zu einem dieser Nicht-200 Antwortcodes führt, sendet Azure OpenAI die Anforderung automatisch von Ihrer bereitgestellten Bereitstellung an die zu verarbeitende Standardbereitstellung.
Hinweis
Selbst wenn eine Teilmenge von Anforderungen an die Standardbereitstellung weitergeleitet wird, priorisiert der Dienst das Senden von Anforderungen an die bereitgestellte Bereitstellung, bevor überlastete Anforderungen an die Standardbereitstellung gesendet werden. Diese Priorisierung kann zu einer zusätzlichen Latenz führen.
Spillover-Kosten
Da Spillover eine Kombination aus bereitgestellten und Standardbereitstellungen verwendet, um Schwankungen im Datenverkehr zu bewältigen, umfasst die Abrechnung für Spillover zwei Komponenten:
Für alle Anforderungen, die von Ihrer bereitgestellten Bereitstellung verarbeitet werden, gelten nur die Kosten für die stündlich bereitgestellten Bereitstellungen. Für diese Anfragen entstehen keine zusätzlichen Kosten.
Für alle Anforderungen, die an Ihre Standardbereitstellung weitergeleitet werden, wird die Anforderung zu den jeweiligen Raten für Eingabetoken, zwischengespeicherte Token und Ausgabetoken für die angegebene Modellversion und den Bereitstellungstyp abgerechnet.