Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Agenten-Observabilität und -Qualität basieren auf einer sich wiederholenden Schleife: Finde ein Problem in deinem Agenten, misse es systematisch, behebe es, bestätige die Behebung und überwache, damit es nicht wiederholt wird. Jedes Konzept auf dieser Seite ist ein Teil dieser Schleife.
Diese Seite erklärt jedes Element und wie es zusammenhängt.
Die Qualitätsschleife
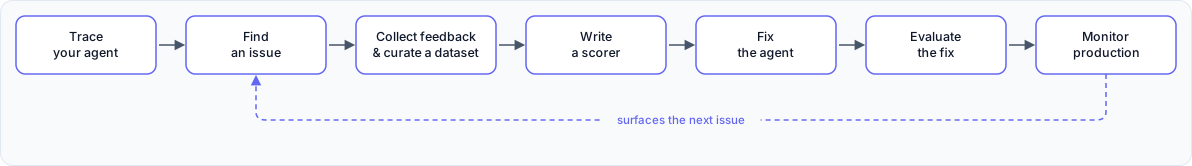
Jeder Abschnitt unten entspricht einer Stufe in dieser Schleife.
Ablaufverfolgungen und Spannen
Ein Trace ist ein strukturierter Nachweis einer vollständigen Ausführung Ihres Agenten – die obersten Eingaben und Ausgaben, jeden Zwischenschritt (LLM-Aufrufe, Retriever-Lookups, Werkzeugaufrufe), Latenz und etwaige Fehler. Spuren sind das Rohmaterial, das jede andere Stufe im Kreislauf versorgt.
Ein Trace ist intern ein Baum aus Spans. Jede Spanne repräsentiert eine Operation: Sie erfasst, was eingegangen ist, was herauskam, wie lange es gedauert hat und alle Metadaten. Der Root-Span steht für die gesamte Anfrage des Agenten; untergeordnete Spans stehen für Teiloperationen, die während dieser Anfrage aufgetreten sind.
Traces werden im Unity-Katalog als Delta-Tabellen gespeichert (empfohlen). Das gibt dir kontrollierten Zugriff, SQL-Abfragemöglichkeiten und keine Speicherobergrenze pro Experiment – das gleiche Governance-Modell wie jede andere UC-Tabelle. Sobald sie gespeichert sind, können Sie Traces in der Benutzeroberfläche erforschen, sie mit SQL abfragen oder Fragen in natürlicher Sprache mit Genie Code stellen.
Verwandt:Instrumentieren Sie Ihren Agenten · Verfolgen Sie Traces in der Benutzeroberfläche · Such- und Abfragetraces
Sitzungen
Eine Sitzung ist ein Tag, das zusammengehörige Ablaufverfolgungen aus einer mehrteiligen Unterhaltungen gruppiert: Setzen Sie mlflow.trace.session für jede Ablaufverfolgung. Die Sitzungsgruppierung ermöglicht es Ihnen, die Gesprächsqualität durchgängig zu bewerten, nicht nur Gesprächszug für Gesprächszug.
Bewertungen: Feedback und Erwartungen
Eine Bewertung ist eine Qualitätsmessung, die an eine Spur angehängt ist. Es gibt zwei Arten:
| Typ | Wer es hinzufügt | Was er erfasst |
|---|---|---|
| Feedback | Scorer, Endnutzer, Fachexperten | Eine Qualitätsbewertung: bestanden/nicht bestanden, numerische Bewertung oder Freitextkommentar. Beispiele: Ein Safety Bewertungsprüfer, der eine Antwort als unsicher markiert; ein Daumen nach unten vom Endnutzer. |
| Erwartungshaltung | Domänenexperten | Die korrekte Ausgabe für eine gegebene Eingabe – Ground Truth. Beispiele: die erwartete Antwort auf eine Frage; die erforderlichen Fakten, die eine Antwort enthalten muss. |
Feedback ist das wichtigste Signal bei routinemäßiger Qualitätsarbeit; man braucht keine Erwartungen, um aus MLflow einen Mehrwert zu ziehen. Erwartungen sind optional, ermöglichen aber die präziseste Bewertung: Richter vergleichen zum Beispiel Correctness die Antwort des Agenten mit einer bekannten guten Antwort.
Verwandt:Entwickleranmerkungen · Expertenfeedback · Nutzerfeedback sammeln
Schützen
Ein Scorer ist eine Funktion, die eine Ablaufverfolgung bewertet und eine Feedback-Bewertung zurückgibt. Jeder Scorer folgt demselben Vertrag: erhält eine Spur → extrahiert relevante Felder → bewertet → Rückgabe von Feedback. Der gleiche Scorer arbeitet in der Offline-Bewertung und bei der Live-Produktionsüberwachung – man schreibt einmal Qualitätslogik und sie gilt überall.
Arten von Punktesammlern
| Typ | Wie die Bewertung erfolgt | Verwenden Sie, wenn |
|---|---|---|
|
Integrierte LLM-Judges ( mlflow.genai.scorers.*) |
Vorgefertigte, LLM-gestützte Bewertungsmodule für gängige Bewertungsdimensionen: Korrektheit, Relevanz, Sicherheit, Faktentreue, Richtlinieneinhaltung und mehr. | Sie wollen sofortige hochwertige Abdeckung, ohne individuellen Code schreiben zu müssen. |
| Benutzerdefinierte LLM-Bewerter | Ein LLM-Richter mit einem individuellen Bewertungsprompt und einer Bewertungsrubrik, die du definierst. | Eingebaute Juroren decken deine domänenspezifischen Kriterien nicht ab, oder du brauchst fein granulare Bewertungen (numerische Noten, benutzerdefinierte Kategorien). |
| Codebasierte Scorer | Eine deterministische Python-Funktion – exakte Abgleichung, Formatvalidierung, Latenzprüfungen, Geschäftsregeln. | Man braucht präzise, reproduzierbare Logik, die kein Sprachmodell benötigt. |
Juroren gegen Scorer
Juroren (zum Beispiel) mlflow.genai.judges.is_correctbewerten Text anhand spezifischer Kriterien – aber sie wissen nicht, wie man eine Spur liest.
Scorer sind die Adapter: Sie extrahieren die relevanten Felder aus einem Trace (Anfrage, Antwort, abgerufener Kontext usw.) und leiten sie an einen Richter oder an benutzerdefinierte Logik weiter. Wenn Sie einen integrierten Judge in scorers=[Correctness()] direkt verwenden, packt MLflow ihn automatisch in einen Scorer.
Verwandt:Überblick über die Punkterichter · Eingebaute Wertungsrichter · Benutzerdefinierte LLM-Richter · Codebasierte Punkterichter
Evaluationsdatensätze und Läufe
Evaluierungsdatensätze
Ein Evaluationsdatensatz ist eine versionierte, kuratierte Sammlung von Testfällen. Jeder Datensatz enthält:
-
inputs: Was soll ich dem Agenten schicken -
expectations(optional): die korrekte Ausgabe, die von Scorern verwendet wird, die Ground Truth benötigen
Man baut Datensätze auf, indem man repräsentative Spuren aus Produktion oder Entwicklung auswählt, Fälle von Grund auf schreibt oder aus externen Quellen importiert. Datensätze sind versionierungsfähig, sodass Sie verfolgen können, wie Ihre Testsuite im Laufe der Zeit wächst.
Verwandt:Erstellen Sie einen Evaluierungsdatensatz
Auswertungsausführungen
Ein Evaluationslauf ist das Ergebnis des Aufrufs von mlflow.genai.evaluate(). Geben Sie ihm einen Datensatz und eine Liste der Scorer; es:
- Er führt Ihren Agenten auf jeder Eingabe im Datensatz aus und erfasst Traces.
- Wendet jeden Scorer auf jeden Trace an und erzeugt Feedback-Bewertungen.
- Speichert aggregierte Erfolgsquoten und Kennzahlen zusammen mit den einzelnen Ablaufverfolgungen.
Verwende Evaluationsläufe, um folgende Fragen zu beantworten: Hat diese Änderung die Qualität verbessert? und hat sie an anderer Stelle zu Regressionen geführt? Vergleiche die Ausführungen Seite an Seite, um den Fortschritt über Iterationen hinweg zu verfolgen. Evaluationsläufe sind eine spezielle Art von MLflow Run und können programmatisch abfragbar sein.
Verwandt:Führen Sie eine Bewertung durch · Wie die Bewertung funktioniert
Produktionsüberwachung
Produktionsüberwachung plant Scorer so ein, dass sie automatisch für den Live-Agentenverkehr ausgeführt werden. Fügen Sie Ihrem eingesetzten Agenten einen Scorer zu, und der Überwachungsdienst bewertet eingehende Spuren fortlaufend und schreibt Feedback-Bewertungen auf dieselbe Spur zurück.
Das Feedback-Format ist identisch mit der Offline-Bewertung, sodass Qualitätstrends zwischen Entwicklung und Produktion direkt vergleichbar sind. Produktionsmonitoring schließt den Kreislauf: Neue Fehler im Live-Verkehr werden entdeckt, die Sie dann in Ihren Bewertungsdatensatz einbauen, um sie in der nächsten Iteration zu beheben.
Verwandt:Produktionsüberwachungsübersicht · Monitoring starten und konfigurieren
Wie alles zusammenpasst
Jedes Konzept dient einer bestimmten Stufe der Qualitätsschleife:
| Stage | Schlüsselkonzepte |
|---|---|
| Verfolgen Sie Ihren Agent | Ablaufverfolgungen, Spans |
| Finde ein Problem | Traces, Sitzungen, UI- und SQL-Abfragen, natürlichsprachliche Analyse mit Genie Code |
| Sammeln Sie Feedback und kuratieren Sie einen Datensatz | Bewertungen (Rückmeldung + Erwartungen), Bewertungsdatensätze |
| Schreiben Sie einen Scorer, korrigieren Sie den Agenten und bewerten Sie die Korrektur | Punktesammler, Bewertungsläufe |
| Produktion überwachen | Produktionsüberwachung, geplante Scorer |
Die Schleife verbindet alles: Die Produktionsüberwachung erkennt neue Fehlerfälle → Sie kuratieren diese zu einem Datensatz → Sie erstellen oder optimieren einen Scorer → Sie führen eine Evaluierung durch, um die Fehlerbehebung zu bestätigen → der verbesserte Agent geht in Produktion → die Überwachung achtet auf das nächste Problem.
Nächste Schritte
- Instrumentiere deinen Makler – füge deinem Makler in wenigen Zeilen eine Nachverfolgung hinzu
- Beobachten und finden Sie Probleme – erforschen und analysieren Sie erfasste Spuren
- Erstellen Sie einen Evaluationsdatensatz – kuratieren Sie Traces zu strukturierten Testfällen
- Führen Sie eine Bewertung durch – bewerten Sie Ihren Makler anhand eines Datensatzes
- Produktionsüberwachung einrichten – Qualitätsregressionen im Live-Verkehr erkennen