Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
MLflow bietet Agentenauswertung und LLM-Auswertung, die Ihnen dabei hilft, die Qualität Ihrer KI-Anwendungen zu messen, zu verbessern und aufrechtzuerhalten. MLflow unterstützt den gesamten Entwicklungslebenszyklus vom Testen über die Produktionsüberwachung für LLMs, Agents, RAG-Systeme oder andere GenAI-Anwendungen.
Die Auswertung von Agents und LLMs ist komplexer als herkömmliche ML-Modellauswertung. Diese Anwendungen umfassen mehrere Komponenten, mehrstufige Unterhaltungen und nuancierte Qualitätskriterien. Sowohl qualitative als auch quantitative Metriken erfordern spezielle Auswertungsansätze, um die Leistung genau zu bewerten.
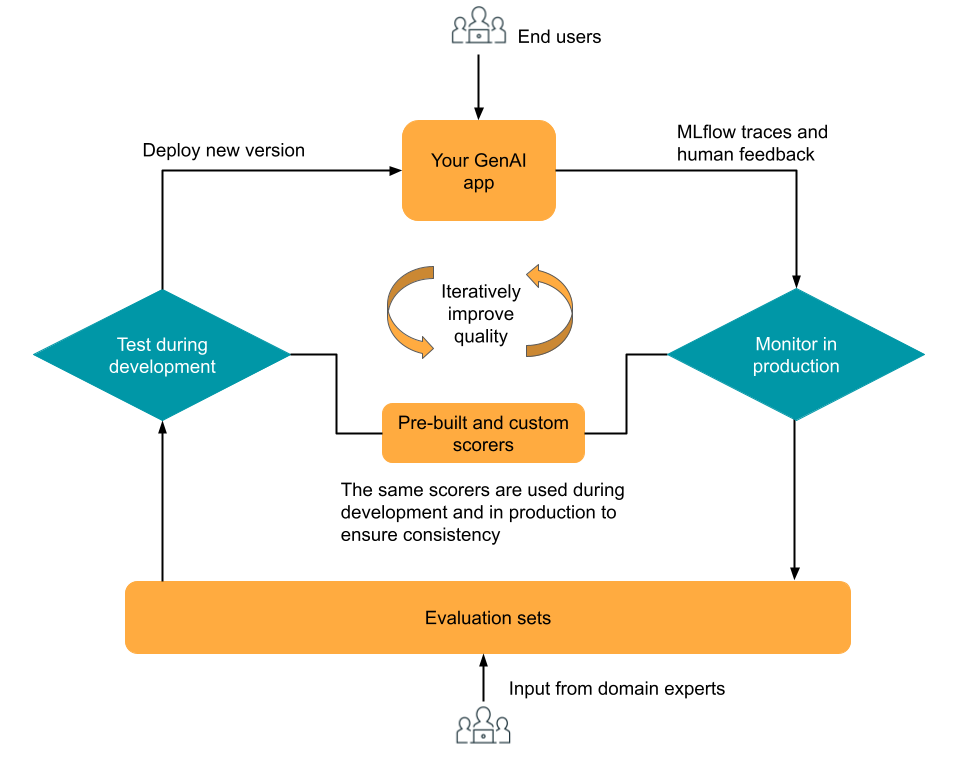
Die Auswertungs- und Überwachungskomponente von MLflow 3 soll Ihnen dabei helfen, die Qualität Ihrer GenAI-App iterativ zu optimieren. Auswertung und Überwachung bauen auf der MLflow-Ablaufverfolgung auf, die echtzeitbasierte Ablaufverfolgungsprotokollierung in den Entwicklungs-, Test- und Produktionsphasen bereitstellt. Ablaufverfolgungen können während der Entwicklung mit integrierten oder benutzerdefinierten LLM-Judges und -Scorern ausgewertet werden, und die Produktionsüberwachung kann dieselben Judges und Scorer wiederverwenden, um eine konsistente Bewertung während des gesamten Anwendungslebenszyklus sicherzustellen. Domänenexperten können Feedback mithilfe einer integrierten Prüf-App zum Sammeln von menschlichem Feedback bereitstellen und Auswertungsdaten zur weiteren Iteration erstellen.
Das Diagramm zeigt diesen iterativen Workflow auf hoher Ebene.
| Merkmal | Description |
|---|---|
| 10-minütige Demo: Bewerten einer KI-App | Führen Sie ein schnelles Demonotizbuch aus, in dem die MLflow-Auswertung mithilfe einer einfachen GenAI-Anwendung eingeführt wird. |
| Lernprogramm: Bewerten und Verbessern einer GenAI-Anwendung | Durchlaufen Sie ein Lernprogramm des vollständigen Auswertungsworkflows mithilfe einer simulierten RAG-Anwendung. Verwenden Sie Auswertungsdatensätze und LLM-Richter, um Qualität zu bewerten, Probleme zu identifizieren und Ihre App iterativ zu verbessern. |
| Scorer und LLM-Judges | Definieren Sie Qualitätsmetriken für Ihre App mit integrierten LLM-Richtern, benutzerdefinierten LLM-Richtern und benutzerdefinierten Scorern. Verwenden Sie die gleichen Metriken sowohl für die Entwicklung als auch für die Produktion. |
| Bewerten während der Entwicklung | Testen Sie Ihre GenAI-Anwendung mit Evaluierungsdatensätzen, Scorern und LLM-Beurteilern. Vergleichen Sie App-Versionen, verfolgen Sie Verbesserungen und teilen Sie Ergebnisse. |
| Gespräche auswerten | Bewerten Sie die Qualität von mehrteiligen Unterhaltungen mit spezialisierten Scorern auf Vollständigkeit der Unterhaltungen, Benutzerfrustration und Dialogkohärenz. |
| Gesprächssimulation | Generieren Sie synthetische mehrstufige Dialoge, um Dialogsysteme anhand vielfältiger Szenarien und Nutzerverhaltensweisen zu testen. |
| Überwachen von Apps in der Produktion (Beta) | Führen Sie Scorer und LLM-Judges automatisch für Ihre GenAI-Produktionsanwendungsüberwachung aus, um die Qualität kontinuierlich zu überwachen. |
| Sammeln von menschlichem Feedback | Verwenden Sie die Rezensions-App, um Expertenfeedback zu sammeln und Auswertungsdatensätze zu erstellen. |
| Genie-Code für die Überwachbarkeit und Bewertung von Agenten | Verwenden Sie natürliche Sprache, um Bewertungsergebnisse zu überprüfen, Bewertungsdatensätze zu analysieren, geplante Scorer zu prüfen und Hilfe beim Einrichten von mlflow.genai.evaluate() mit den richtigen Scorern zu erhalten. |
Hinweis
Die Agentenbewertung ist in das verwaltete MLflow 3 integriert. Die Agent Evaluation SDK-Methoden sind jetzt mit dem mlflow[databricks]>=3.1 SDK verfügbar. Informieren Sie sich unter Migrieren von der Agent Evaluation zu MLflow 3, um Ihren MLflow 2 Agent Evaluation-Code auf MLflow 3 zu aktualisieren.