Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
La búsqueda de vectores es una manera de buscar información almacenada en una base de datos en la forma de vectores. Los vectores son grupos de números que representan funciones o características de medios, como texto o imágenes. Capturan relaciones semánticas dentro de la información, lo que permite la búsqueda de similitud más allá de la coincidencia exacta de palabras clave.
Azure proporciona varias maneras de almacenar y buscar datos vectorizados. Este artículo le ayuda a elegir el servicio de búsqueda vectorial Azure adecuado para las aplicaciones.
En este artículo se comparan los siguientes servicios en función de sus funcionalidades de vector de búsqueda:
- Búsqueda de Azure AI
- Azure Cosmos DB para NoSQL
- Azure DocumentDB
- Azure Database para PostgreSQL
- Azure Managed Redis
- Azure SQL Database
Para comparar los requisitos del sistema para cada servicio, consulte Elegir un servicio candidato y unamatriz de funcionalidades.
Elección de un servicio candidato
Esta sección le ayuda a seleccionar el mejor servicio o servicios para sus necesidades. Para restringir las opciones, empiece por considerar los requisitos del sistema.
Requisitos principales
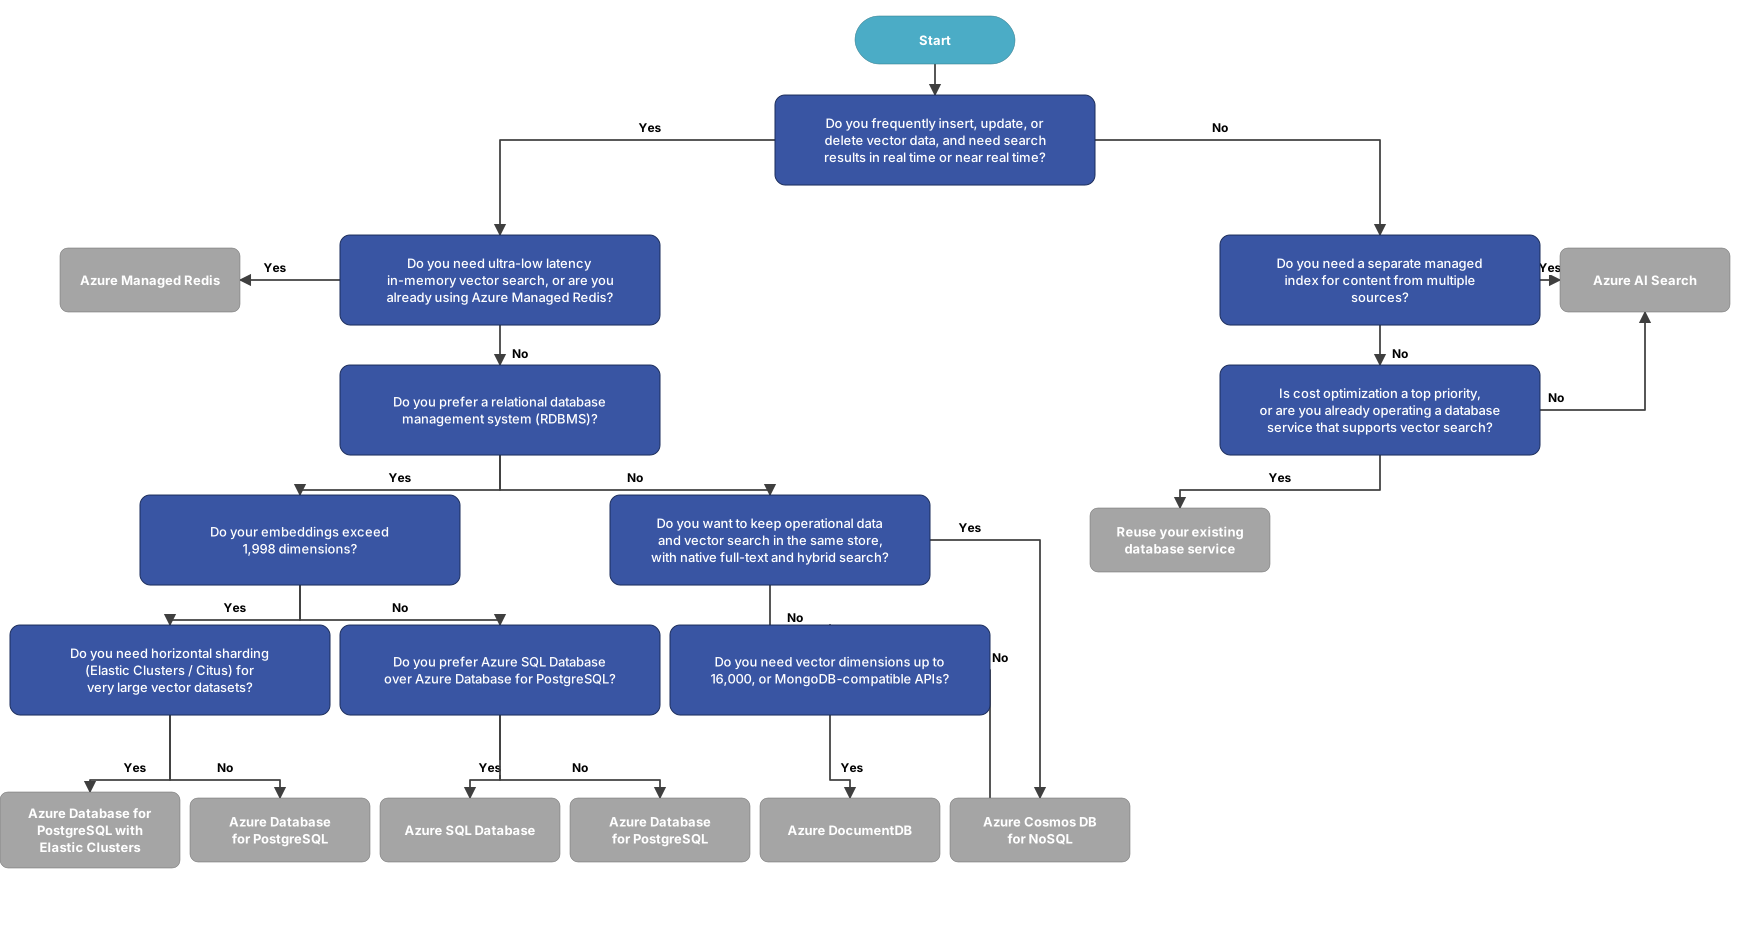
Para decidir si utilizar una solución de base de datos tradicional o AI Search, tenga en cuenta sus requisitos y si puede realizar búsquedas vectoriales en vivo o en tiempo real sobre sus datos. Si cambia con frecuencia valores en campos vectorizados y si esos cambios deben ser buscables en tiempo real o casi en tiempo real, una base de datos relacional o NoSQL tradicional es la mejor opción para su escenario. Del mismo modo, la base de datos existente podría ser la mejor manera de cumplir el objetivo de rendimiento. Sin embargo, si su carga de trabajo no requiere la posibilidad de realizar búsquedas vectoriales en tiempo real o casi en tiempo real, y puede gestionar un índice de vectores, puede usar AI Search.
Si elige una solución de base de datos tradicional, elija un servicio de base de datos basado en el conjunto de aptitudes del equipo y las bases de datos existentes. Si ya usa un servicio de base de datos, como Azure Cosmos DB para NoSQL, ese servicio podría ser la solución más sencilla para su escenario.
Azure Cosmos DB para NoSQL es una buena opción si desea mantener los datos operativos y la búsqueda de vectores en el mismo sistema y si necesita puntuación de texto completo, búsqueda híbrida o reeranking integrado. Su reclasificador semántico se encuentra en versión preliminar. Cuando la aplicación escribe un registro y su inserción juntos, no es necesario sincronizar un índice de búsqueda independiente antes de consultar el elemento actualizado.
AI Search es una buena opción cuando necesita un índice administrado por separado para contenido procedente de múltiples orígenes, con vectorización integrada y funcionalidades específicas de búsqueda, como navegación por facetas y autocompletado.
Azure Database for PostgreSQL admite el escalado horizontal mediante clústeres elásticos, una oferta administrada de la extensión Citus de código abierto que admite particionamiento horizontal. Esta funcionalidad distribuye los datos vectoriales entre varios nodos, lo que puede ser útil para conjuntos de datos vectoriales de gran tamaño.
Considere Azure Managed Redis cuando necesite una búsqueda vectorial en memoria con latencia ultrabaja o cuando Redis ya se use para el almacenamiento en caché o la administración de sesiones.
Cada servicio de base de datos tiene funcionalidades y limitaciones únicas para la búsqueda de vectores. Compruebe que el tipo de base de datos tiene la funcionalidad necesaria.
Los nuevos servicios y las instancias de base de datos adicionales pueden aumentar el costo y la complejidad. Para reducir la sobrecarga, puede seguir usando el diseño existente. La búsqueda de vectores en las bases de datos actuales podría ser más rentable que un servicio de búsqueda vectorial dedicado.
La compatibilidad con características avanzadas de recuperación varía según el servicio. Azure Cosmos DB para NoSQL y Azure DocumentDB proporcionan una búsqueda híbrida nativa que combina la búsqueda de texto completo y vector mediante la fusión de rango recíproca (RRF). Azure Cosmos DB para NoSQL también proporciona un reordenador semántico en vista previa. AI Search proporciona búsqueda híbrida y clasificación semántica como características de búsqueda administradas. En el caso de los servicios que no proporcionan estas funcionalidades, implemente la lógica de clasificación necesaria en el código de la aplicación o la base de datos.
Matriz de funcionalidades
Las tablas de esta sección resumen las funcionalidades del servicio de búsqueda vectorial de Azure. Compare los servicios disponibles con sus requisitos. Algunos servicios son una mejor opción para escenarios específicos, por lo que tenga en cuenta las ventajas que se muestran en cada tabla.
Si está trabajando en Microsoft Fabric, puede utilizar Real-Time Intelligence para la búsqueda de similitud vectorial (VSS) utilizando un eventhouse como base de datos vectorial. Para obtener más información, consulte la documentación de Fabric.
Características básicas
La compatibilidad nativa con los tipos de datos vectoriales, los índices de vectores vecinos más cercanos (ANN), los límites de dimensiones vectoriales, varios campos vectoriales y varios índices vectoriales varían en todos los servicios. La carga de trabajo puede requerir una o varias de estas características.
En la tabla siguiente se muestran las funcionalidades vectoriales de cada servicio Azure.
| Capacidad | Azure Cosmos DB para NoSQL | Azure DocumentDB | Base de Datos de Azure para PostgreSQL | Azure Managed Redis | Búsqueda IA | SQL Database |
|---|---|---|---|---|---|---|
| Vector de búsqueda integrado | Sí | Sí1 | Sí2 | Sí3 | Sí4 | Sí |
| Tipo de datos vectoriales | Sí | Sí | Sí | Sí | Sí | Sí5 |
| Límites de dimensión6 | 40967 o 505 con un índice plano | 16 0008, 4000 o 2000, según la configuración | 16 0009 o 2000 | 32,768 | 409610 | 1998 11 |
| Varios campos vectoriales | Sí | Sí12 | Sí | Sí | Sí | Sí |
| Varios índices vectoriales | Sí | Sí13 | Sí | Sí | Sí | Sí |
- Azure DocumentDB admite la búsqueda de vectores en incrustaciones.
-
pgvector, una extensión de PostgreSQL, admite la búsqueda vectorial. Lapg_diskannextensión ofrece la indexación de vectores basada en DiskANN para una búsqueda ANN eficaz a escala. - El módulo RediSearch de Azure Managed Redis proporciona búsqueda vectorial.
- AI Search admite vectores.
- SQL Database admite un tipo de datos vectorial.
- Los modelos de incrustación de OpenAI incluyen 1536 dimensiones para text-embedding-ada-002 y text-embedding-3-small, y 3072 dimensiones para text-embedding-3-large. Los modelos de incrustación multimodal de Azure Vision tienen 1.024 dimensiones tanto para imágenes como para texto.
- Los vectores indexados mediante el tipo de índice plano pueden tener hasta 505 dimensiones. Los vectores indexados mediante el tipo de índice quantizedFlat o DiskANN pueden tener hasta 4096 dimensiones.
- Puede indexar vectores hasta 16 000 dimensiones mediante DiskANN y cuantificación de productos. El pequeño mundo navegable jerárquico (HNSW) o IVFFlat con media precisión admiten índices vectoriales de hasta 4.000 dimensiones. Sin compresión, la dimensión de vector máxima predeterminada para la indexación es de 2000. Para obtener más información, consulte las dimensiones vectoriales de Azure DocumentDB.
- Los vectores pueden tener hasta 16 000 dimensiones. Sin embargo, la indexación mediante algoritmos SIGHTFlat y HNSW admite vectores con hasta 2000 dimensiones.
- AI Search admite el truncamiento de dimensiones basado en el aprendizaje de representaciones Matryoshka. Los modelos de inserción de texto-3 pueden reducir las dimensiones vectoriales. Por ejemplo, puede usar 256 o 512 dimensiones.
- SQL Database admite un tipo de datos vectorial nativo con hasta 1998 dimensiones.
- Cada índice vectorial de Azure DocumentDB se dirige a una ruta de vector. Cree un índice de vector independiente para cada campo vectorial que necesite consultar.
- Puede crear varios índices en una colección de Azure DocumentDB, pero solo un índice vectorial puede tener como destino una ruta de acceso de vector específica.
Métodos de búsqueda
Las cargas de trabajo suelen necesitar combinar la búsqueda vectorial con búsqueda de texto completo o búsqueda híbrida. La búsqueda híbrida es una búsqueda de texto completo o una búsqueda semántica combinada con una búsqueda vectorial. Cuando se combinan, la búsqueda híbrida y la reordenación ofrecen una alta precisión para las cargas de trabajo. Puede implementar manualmente la búsqueda híbrida y el reordenamiento mediante su propio código, o bien puede considerar cómo su almacén vectorial satisface esta necesidad de carga de trabajo.
| Método de búsqueda | Azure Cosmos DB para NoSQL | Azure DocumentDB | Base de Datos de Azure para PostgreSQL | Azure Managed Redis | Búsqueda IA | SQL Database |
|---|---|---|---|---|---|---|
| Búsqueda de texto completo | Sí12 | Sí2 | Sí3 | Sí4 | Sí | Sí5 |
| Búsqueda híbrida | Sí6 | Sí7 | Sí8 | Sí9 | Sí10 | Sí11 |
| Reclasificación integrada | Sí (versión preliminar)13 | No | No | No | Sí1 | No |
- La reclasificación semántica reordena los resultados de las búsquedas de texto completo y vectoriales.
- Azure DocumentDB admite búsquedas y consultas mediante índices de texto.
- PostgreSQL admite la búsqueda de texto completo.
- Azure Managed Redis admite la búsqueda de texto completo mediante el módulo RediSearch, incluida la tokenización de texto, la lematización y la clasificación.
- SQL Server admite la búsqueda de texto completo.
- Azure Cosmos DB para NoSQL admite búsquedas híbridas que combinan la puntuación de texto completo BM25 y la búsqueda vectorial mediante RRF. Puede asignar pesos a las clasificaciones de componentes.
- Azure DocumentDB admite de forma nativa la búsqueda híbrida que combina texto completo y búsqueda vectorial con fusión de clasificación recíproca.
- La búsqueda híbrida no está integrada, pero hay código de ejemplo disponible.
- Azure Managed Redis admite la búsqueda híbrida mediante VSS combinado con el filtrado de atributos en campos de texto, numéricos, de etiquetas y geográficos.
- La búsqueda híbrida, que combina la búsqueda de texto completo, la búsqueda vectorial y la clasificación semántica, es una característica de búsqueda de IA.
- Hay disponible un ejemplo de búsqueda híbrida de SQL Database y SQL Server.
- Azure Cosmos DB para NoSQL admite la búsqueda de texto completo y la puntuación de texto completo.
- El reranker semántico para Azure Cosmos DB para NoSQL está en versión preliminar. Puede reordenar los resultados de consultas vectoriales, de texto completo o híbridas mediante los SDK compatibles de Azure Cosmos DB.
Algoritmos de indexación de datos vectoriales
La indexación de datos vectoriales es la capacidad de almacenar y recuperar vectores de forma eficaz. La indexación influye en la velocidad y precisión de las búsquedas de similitud y las consultas vecinas más cercanas en los orígenes de datos.
Los índices suelen usar un algoritmo k-vecino más cercano (Ek-NN) exhaustivo o un algoritmo ANN. Ek-NN realiza una búsqueda exhaustiva entre todos los puntos de datos y devuelve los k vecinos más cercanos exactos. Al buscar una pequeña cantidad de datos, Ek-NN funciona en milisegundos. En el caso de conjuntos de datos más grandes, es posible que experimente latencia.
DiskANN, HNSW y OBJECTFlat son índices de algoritmo ANN. La selección de la estrategia de indexación adecuada requiere una consideración cuidadosa de varios factores, como la naturaleza del conjunto de datos, los requisitos específicos de las consultas y los recursos disponibles. DiskANN puede adaptarse a los cambios en el conjunto de datos y ahorrar recursos informáticos. HNSW destaca en sistemas que requieren respuestas de consulta rápidas y pueden adaptarse a los cambios en el conjunto de datos. IVFFlat es eficaz en entornos en los que los recursos de hardware son limitados o los volúmenes de consulta no son altos.
En la tabla siguiente se muestran los tipos de indexación de datos vectoriales disponibles.
| Enfoque de indexación | Azure Cosmos DB para NoSQL | Azure DocumentDB | Base de Datos de Azure para PostgreSQL | Azure Managed Redis | Búsqueda IA | SQL Database |
|---|---|---|---|---|---|---|
| DiskANN | Sí | Sí1 | Sí2 | No | No | Sí3 |
| Ek-NN | Sí | Sí | Sí | Sí4 | Sí | Sí |
| HNSW | No | Sí1 | Sí | Sí5 | Sí | No |
| IVFFlat | No | Sí | Sí | No | No | No |
| Otros | Plano, quantizedFlat6 | Un campo vectorial y un índice por ruta78 | - | - | Cuantificación escalar, cuantificación binaria9 | - |
- Para obtener más información, consulte Almacén de vectores integrado en Azure DocumentDB.
- Para obtener más información, consulte DiskANN para Azure Database for PostgreSQL.
- La indexación de vectores de DiskANN nativa está en versión preliminar. Para obtener más información, consulte Búsqueda vectorial e índices vectoriales en el Motor de base de datos SQL.
- Azure Managed Redis admite la búsqueda Ek-NN mediante índices de tipo FLAT para realizar búsquedas por fuerza bruta.
- Azure Managed Redis admite HNSW para la búsqueda de ANN. Para más información, consulte VSS.
- Para obtener más información, consulte Directivas de indexación de vectores.
- La indexación solo se aplica a un vector por ruta de acceso.
- Solo puede crear un índice por ruta de acceso del vector.
- AI Search admite la cuantificación escalar y binaria para reducir el tamaño del vector en un índice de búsqueda.
Funcionalidades de cálculo de similitud y distancia
La búsqueda vectorial admite los métodos de cálculo de similitud coseno, producto escalar y distancia euclidiana. Use estos métodos para calcular la similitud o la distancia entre dos vectores.
El análisis de datos preliminar usa métricas y distancias euclidianas para poder extraer una variedad de conclusiones de la estructura de datos. La clasificación de texto generalmente funciona mejor en distancias euclidianas. La recuperación de los textos más similares a un texto determinado normalmente funciona mejor con similitud coseno.
Las incrustraciones de Azure OpenAI se basan en la similitud coseno para calcular la similitud entre documentos y una consulta.
| Cálculo de comparación de vectores integrado | Azure Cosmos DB para NoSQL | Azure DocumentDB | Base de Datos de Azure para PostgreSQL | Azure Managed Redis | Búsqueda IA | SQL Database |
|---|---|---|---|---|---|---|
| Similitud coseno | Sí1 | Sí | Sí | Sí2 | Sí | Sí3 |
| Distancia euclidiana | Sí1 | Sí | Sí | Sí2 | Sí | Sí3 |
| Producto escalar | Sí1 | Sí | Sí | Sí2 | Sí | Sí3 |
- Para obtener más información, consulte el cálculo de distancia vectorial para Azure Cosmos DB para NoSQL.
- Azure Managed Redis admite métricas de similitud coseno, distancia euclidiana y distancia de producto escalar. Para más información, consulte VSS.
- Para obtener más información, consulte los ejemplos de cálculo de distancia para SQL Database y SQL Server.
Integración con Azure OpenAI y otros componentes
Puede vincular la búsqueda de vectores a otros componentes de Microsoft. Por ejemplo, Azure OpenAI le ayuda a crear vectores para los datos y las consultas de entrada para VSS.
| Capacidad | Azure Cosmos DB para NoSQL | Azure DocumentDB | Base de Datos de Azure para PostgreSQL | Azure Managed Redis | Búsqueda IA | SQL Database |
|---|---|---|---|---|---|---|
| Integración de Foundry IQ | No | No | No | No | Sí | No |
| Integración del servicio Foundry Agent | Sí1 | No | Sí2 | Sí2 | Sí3 | Sí2 |
| Generación integrada de incrustaciones de Azure OpenAI | No | No | Sí4 | No | Sí5 | Sí6 |
| Integración con Kernel semántico | Sí7 | Sí8 | Sí9 | Sí10 | Sí11 | Sí12 |
- La integración con Foundry Agent Service se proporciona a través del almacenamiento del estado del agente.
- La integración del servicio Foundry Agent se proporciona a través de datos, búsqueda de vectores o acceso a herramientas.
- La integración del servicio Foundry Agent se proporciona a través de la recuperación de conocimiento y la búsqueda de vectores.
- La extensión de Azure AI está disponible.
- Ai Search incluye una aptitud que vectoriza fragmentos de texto.
- Puede crear un procedimiento almacenado para el despliegue de su modelo de incrustación.
- Este servicio se admite como un conector de memoria y un conector de base de datos vectorial. Para obtener más información, consulte la documentación de C# y la documentación de Python.
- Este servicio se admite como un conector de base de datos vectorial. Para obtener más información, consulte la documentación de C# y la documentación de Python.
- Este servicio se admite como un conector de memoria y un conector de base de datos vectorial. Para obtener más información, consulte la documentación de C#.
- Este servicio se admite como un conector de base de datos vectorial. Para más información, consulte Uso del conector de Redis.
- Este servicio se admite como un conector de memoria y un conector de base de datos vectorial. Para obtener más información, consulte la documentación de C# y la documentación de Python.
- Este servicio se admite como conector de memoria.
Consideraciones operativas
La matriz de funcionalidades identifica los servicios que cumplen sus requisitos funcionales. Cuando más de un servicio cumpla los requisitos, compare cómo afecta cada opción a la ubicación de los datos, su actualidad, el filtrado, la capacidad y el mantenimiento de los embeddings.
Ubicación y actualización de datos
Azure Cosmos DB para NoSQL, Azure DocumentDB, Azure Database for PostgreSQL y Azure SQL Database pueden almacenar incrustaciones con los registros operativos de la carga de trabajo. Si la aplicación genera un vector de incrustación y lo escribe junto con el registro, ambos valores se actualizan a través de la ruta de escritura de la base de datos. Este diseño evita un proceso de sincronización de índices de búsqueda independiente.
AI Search mantiene un índice de búsqueda independiente del sistema de origen. Puede insertar documentos en el índice o usar un indexador para extraer datos de un origen de datos compatible. Un índice independiente permite combinar y dar forma al contenido de varios sistemas y escalar la recuperación independientemente de las cargas de trabajo transaccionales. También crea otra copia de los datos que se pueden buscar. Tenga en cuenta el tiempo entre una actualización de origen y la actualización de índice correspondiente.
Elija un diseño con ubicación compartida cuando los registros operativos cambien con frecuencia y las consultas deban usar los valores actualizados. Elija un índice de búsqueda independiente cuando el corpus abarque varios sistemas o requiera extracción, enriquecimiento y vectorización de contenido administrados.
Filtrado y creación de particiones
La mayoría de las consultas vectoriales de producción usan filtros para aplicar límites de inquilino, seguridad, conjunto de documentos o aplicaciones. Evalúe los filtros con la búsqueda de vectores porque pueden afectar tanto a la recuperación como a la latencia.
- En Azure Cosmos DB para NoSQL, agregue predicados admitidos a la cláusula
WHEREde una consulta que useVectorDistance. Un filtro de clave de partición limita la búsqueda a la partición lógica coincidente. - En Azure DocumentDB, agregue filtros admitidos al operador
cosmosSearch. - En AI Search, cree campos no vectoriales filtrables y use modos de filtro vectorial para controlar si el servicio aplica un filtro antes o después de la recuperación de vectores.
Capacidad y diseño regional
Los servicios usan diferentes unidades de escalado y facturación, por lo que las comparaciones de precios de lista no muestran el costo de una carga de trabajo específica. Tamaño del índice del modelo, dimensiones vectoriales, velocidad de consulta, velocidad de actualización, réplicas, particiones y rendimiento de la base de datos. Incluya el costo de la base de datos de origen al evaluar un índice de búsqueda independiente.
El diseño regional también difiere:
- Azure Cosmos DB proporciona distribución integrada de datos en las regiones de Azure y admite múltiples regiones de escritura.
- AI Search es un servicio regional. Un diseño de búsqueda de IA multiregión usa un servicio de búsqueda en cada región y requiere un proceso que mantenga los índices alineados.
Mantén los embeddings actualizados
Las incrustaciones son datos derivados. Vuelva a generarlos cuando cambie el contenido de origen o cuando adopte un modelo de inserción diferente.
Los indizadores de AI Search pueden orquestar la fragmentación y la vectorización integrada para fuentes compatibles. Para un diseño centrado en la base de datos, la aplicación o la canalización de datos realiza esos pasos y escribe los vectores resultantes. Una fuente de cambios o un evento de origen puede iniciar ese proceso, pero el nuevo contenido no se puede buscar semánticamente hasta que se almacene el embedding actualizado.
Colaboradores
Microsoft mantiene este artículo. Los colaboradores siguientes escribieron este artículo.
Autores principales
- Yu Saito | Ingeniero de soluciones
- Miho Yamamoto | Ingeniero sénior de soluciones
Otros colaboradores:
- Keita Onabuta | Ingeniero sénior de soluciones
- Manish Sharma | Administrador de programas principal
Para ver los perfiles no públicos de LinkedIn, inicie sesión en LinkedIn.
Pasos siguientes
- Aplicaciones inteligentes e inteligencia artificial
- VSS mediante Azure SQL y Azure OpenAI
- Compatibilidad con vectores nativos en Azure SQL y SQL Server
- Base de datos vectorial en Azure Cosmos DB
- VSS en Azure Managed Redis
- Búsqueda vectorial en Búsqueda de Azure AI
- Búsqueda de vectores en Azure Cosmos DB para NoSQL