Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
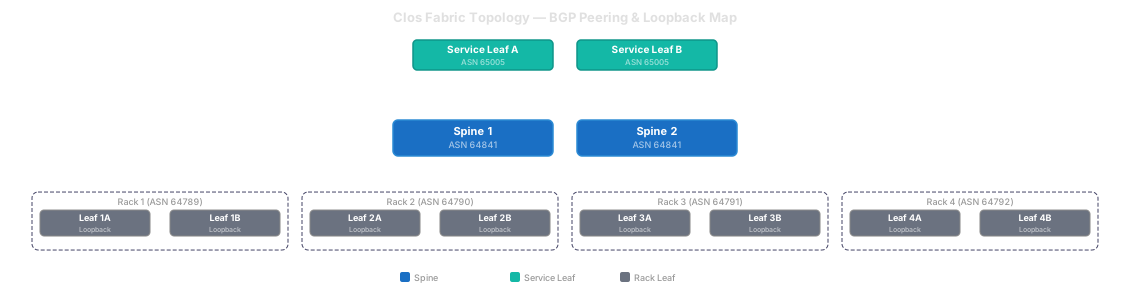
En este artículo se proporciona información general sobre los patrones de referencia de red para implementaciones desagregadas de Azure Local. Utiliza esta guía para comprender la arquitectura de estructura leaf-spine, cómo fluye el tráfico entre los racks y cómo se administra la conectividad externa a través de los conmutadores leaf de servicio.
¿Qué es una implementación desagregada?
En una implementación desagregada, el proceso y el almacenamiento se separan. El almacenamiento lo proporciona una red de área de almacenamiento externa (SAN), como canal de fibra (FC) o iSCSI, en lugar de discos locales dentro de cada nodo de servidor. Esta separación permite escalar de forma independiente la capacidad de procesamiento, el almacenamiento y la red: añada bastidores con sus propios pares de switches leaf para obtener más capacidad de procesamiento, amplíe la SAN para disponer de más almacenamiento o añada switches spine para aumentar el ancho de banda entre bastidores.
Una implementación desagregada consta de sistemas de nodo único o multinodo (hasta 64 nodos por clúster) con las siguientes características:
Note
No todas las implementaciones desagregadas se extienden a varios racks. Si el clúster desagregado sigue siendo de un solo rack y no requiere SDN a gran escala, puede utilizar la topología más sencilla de un solo rack con un par de conmutadores HSRP.
- Al menos dos conmutadores de red service leaf para la conectividad externa.
- Al menos dos conmutadores de red spine para el tránsito entre racks.
- Al menos dos conmutadores de red leaf (Top of Rack) por rack.
- Al menos cuatro puertos de adaptador de red por servidor: dos puertos para la intención de administración y proceso, y dos puertos para las redes de clúster. En las implementaciones desagregadas, las redes de clúster usan puertos independientes sin una intención de Network ATC y se configuran automáticamente durante la implementación.
- En las configuraciones SAN de Fibre Channel (FC), el tráfico de almacenamiento se transmite completamente en la estructura FC, independiente de la red Ethernet.
- En las configuraciones de SAN iSCSI, el tráfico de almacenamiento se ejecuta a través de adaptadores Ethernet dedicados y un tejido de almacenamiento iSCSI dedicado.
Patrones de referencia de red desagregados admitidos
Los siguientes patrones de referencia de red están disponibles para implementaciones desagregadas:
| Conectividad de almacenamiento | Red de copia de seguridad | Patrón de referencia |
|---|---|---|
| SAN de Fibre Channel | Ninguna red de copia de seguridad dedicada | Patrón desagregado de canal de fibra sin red de copia de seguridad |
| SAN de Fibre Channel | Red de copia de seguridad dedicada | Patrón desagregado de canal de fibra con red de copia de seguridad |
| SAN iSCSI | Red de respaldo opcional dentro del invitado (añadida tras la implementación) | Patrón desagregado de iSCSI 6-NIC |
¿Por qué usar una topología de columna de hoja (Clos)?
Un diseño tradicional de dos conmutadores (un par de conmutadores Top of Rack) funciona para clústeres pequeños, pero no se escala bien. En 64 nodos en varios bastidores:
- Límites de puerto: un único conmutador Top of Rack (TOR) tiene aproximadamente 48 puertos y no puede conectar 64 o más nodos.
- Impacto en el error : si se produce un error en un conmutador, la mitad del clúster pierde la conectividad.
- Cuello de botella de ancho de banda: todo el tráfico entre racks se canaliza a través de un único par de enlaces ascendentes.
Una topología leaf-spine (Clos) resuelve estos problemas añadiendo una capa spine dedicada que interconecta todos los racks. Cada rack dispone de su propio par de conmutadores leaf. Todos los conmutadores leaf se conectan a los conmutadores spine compartidos. El tráfico entre racks sigue la ruta: Leaf → Spine → Leaf — nunca más de tres saltos.
Piense en ello como un sistema de autopistas:
| Concepto de red | Analogía de autopistas |
|---|---|
| Conmutadores leaf (Top of Rack) | Carreteras locales que conectan directamente con tu casa (servidores). |
| Conmutadores spine | Intersecciones de autopistas que conectan todas las carreteras locales. |
| Nodes | Casas donde viven las personas (cargas de trabajo). |
| Enrutamiento virtual y reenvío (VRF) | Separe los sistemas de autopistas que no comparten salidas (aislamiento de tráfico). |
| Red LAN virtual extensible (VXLAN) | Túneles que permiten que las carreteras locales se extiendan a través de los sistemas de carreteras. |
| Hoja de servicio | El punto de control de borde en el que el tráfico entra o sale del sistema de autopistas. |
Suscripción excesiva
La capa de hoja a columna está diseñada para una relación mínima de sobresuscripción de 2:1 (ancho de banda de conexión descendente de hoja a ancho de banda de conexión ascendente de hoja a columna) en operaciones normales.
Sugerencia
¿Qué es sobresuscripción? Una relación de 2:1 significa que el ancho de banda total orientado al servidor en cada hoja es el doble del ancho de banda de los vínculos superiores a las columnas vertebrales. Por ejemplo, si un conmutador leaf tiene 48 puertos de host de 25 GbE (1200 Gbps en total) y 4 enlaces ascendentes spine de 100 GbE (400 Gbps), la relación es de 3:1. En condiciones normales, no todos los servidores transmiten a la velocidad completa simultáneamente, por lo que es aceptable una sobresuscripción moderada.
Durante un fallo del conmutador de columna o una ventana de mantenimiento, la sobresuscripción efectiva puede aumentar hasta 4:1. Durante este periodo, las cargas de trabajo con un tráfico intenso en dirección este-oeste (entre racks) podrían experimentar una reducción del rendimiento hasta que se restablezca la capacidad total de la columna vertebral.
Para reducir el riesgo de congestión y mejorar la resistencia, escale horizontalmente la capa de columna vertebral a medida que crece el entorno. La incorporación de conmutadores spine aumenta el ancho de banda agregado de leaf a spine y añade más rutas de múltiplo de caminos de igual coste (ECMP), lo que mejora tanto el rendimiento como la tolerancia a fallos.
Funcionamiento del tejido
La estructura leaf-spine se basa en tres capas: la subcapa (underlay) para el enrutamiento entre conmutadores, la supercapa (overlay) para extender las VLAN a través de los racks y la segmentación mediante enrutamiento y reenvío virtuales (VRF) para aislar los tipos de tráfico.
Infraestructura subyacente: enrutamiento eBGP entre conmutadores
La subcapa es la red enrutada de capa 3 que conecta todos los conmutadores leaf y spine. Utiliza el Protocolo de puerta de enlace fronteriza externo (eBGP) con interfaces sin numerar (RFC 5549), lo que significa que cada enlace entre conmutadores utiliza direcciones IPv6 de enlace local para el emparejamiento BGP, en lugar de subredes /30 o /31 asignadas manualmente. Cada rack obtiene un número de sistema autónomo BGP único (ASN). Equal-Cost Multipath (ECMP) distribuye el tráfico en todas las rutas de columna vertebral disponibles.
Note
BGP sin numerar es la opción recomendada, pero también se admite el uso de subredes de punto a punto /31. Elija cualquiera de los métodos en función de sus preferencias operativas.
La red subyacente se ejecuta en la instancia predeterminada de enrutamiento y reenvío virtual (VRF) (la tabla de enrutamiento global), pero se trata como si fuera exclusivamente de infraestructura: solo transporta direcciones de bucle invertido y rutas de pares BGP. No se inyecta ninguna ruta predeterminada (0.0.0.0/0) en la red subyacente, y no se filtran en ella prefijos de cargas de trabajo. Todo el tráfico de las cargas de trabajo queda aislado en VRF de superposición dedicadas, cada una de ellas asignada a su propio identificador de red VXLAN (VNI). La red subyacente nunca ve las direcciones IP de los inquilinos ni de los clústeres, ya que estas se encapsulan dentro de túneles VXLAN antes de entrar en la estructura.
Esta separación es el límite de seguridad crítico. Si se produce una configuración errónea o un anuncio de ruta no autorizado en un VRF de superposición, esto no puede afectar a la red subyacente ni a otros VRF, ya que están separados de forma fundamental mediante la encapsulación VXLAN.
Superposición: VXLAN EVPN para ampliar las VLAN entre racks
Azure Local requiere que determinadas VLAN, como las de administración y cómputo, estén disponibles en todos los racks. Dado que las VLAN son segmentos de capa 2 que, tradicionalmente, no pueden traspasar los límites de enrutamiento, la red LAN virtual extensible (VXLAN) resuelve este problema encapsulando las tramas de capa 2 dentro de paquetes de capa 3. Cada VLAN se asigna a un identificador de red VXLAN (VNI) único, y esta asignación es coherente en todos los racks.
Ethernet Virtual Private Network (EVPN) es el plano de control basado en BGP que indica a cada conmutador dónde reside cada MAC y dirección IP, sin inundar la red.
Segmentación: VRF para el aislamiento del tráfico
Las instancias de enrutamiento y reenvío virtual (VRF) crean dominios de enrutamiento aislados en cada conmutador, como tener varios conmutadores invisibles que comparten el mismo hardware. Los diferentes tipos de tráfico —administración, cómputo/clúster y cargas de trabajo de los tenants— se colocan en VRF separadas para que un error de enrutamiento en uno de los dominios no afecte a los demás.

Note
Cada clúster se puede colocar en su propio VRF, en función de sus requisitos de aislamiento. Esto permite la multitenencia sin hardware adicional.
Hoja de cálculo frente a hoja de servicio
No todos los conmutadores hoja tienen el mismo rol. La estructura cuenta con dos tipos de conmutadores leaf con responsabilidades distintas:
| Function | Leaf de cómputo | Hoja de servicio |
|---|---|---|
| Terminación de LAN extensible virtual (VXLAN) para servidores locales | Sí | Sí |
| Gateway anycast para VLAN de carga de trabajo | Sí | Sí |
| Enlaces ascendentes de spine | Sí | Sí |
| Emparejamiento del núcleo del centro de datos (BGP externo) | No | Sí |
| Fuga de rutas entre VRF | No | Sí |
| Conexión de firewall o equilibrador de carga | No | Sí |
Conmutadores leaf de cómputo
Los conmutadores leaf de cómputo constituyen el borde del host. Terminan la red LAN virtual extensible (VXLAN) para los servidores conectados localmente, proporcionan puertas de enlace anycast para las instancias de enrutamiento y reenvío virtual (VRF) de la carga de trabajo del clúster y participan en la subcapa de la estructura. No se conectan al núcleo del centro de datos y no realizan fugas de rutas a redes externas.
Conmutadores leaf de servicio
El par de conmutadores leaf de servicio constituye el límite dedicado entre la estructura del clúster y la red central del centro de datos. Dado que el par de conmutadores leaf de servicio participa en múltiples instancias de enrutamiento y reenvío virtual (VRF), es el punto de integración natural para:
- Fuga de rutas: importación controlada de rutas entre VRF para el tráfico norte-sur.
- Cortafuegos y equilibradores de carga: conectados directamente a los puertos leaf de servicio como dispositivos de servicio.
- Terminación VXLAN: encapsulación y desencapsulación del tráfico superpuesto para la conectividad externa.
Importante
La red principal del centro de datos (enrutadores ascendentes, firewalls, Internet) no se conecta directamente a los conmutadores de columna vertebral. Toda la conectividad externa se centraliza en el par leaf de servicio. Esto mantiene la capa de columna vertebral como tránsito puro sin dependencias externas.
La centralización de la conectividad externa en la hoja de servicio proporciona las siguientes ventajas:
- Estabilidad de la columna vertebral : el mantenimiento de red principal (actualizaciones de firewall, reemplazos de enrutadores) no afecta al tejido de la columna vertebral.
- Cambios simples : puede agregar o quitar la conectividad externa sin modificar la configuración de la columna vertebral.
- Radio de impacto reducido: una configuración incorrecta del enrutamiento o de las directivas en el nodo leaf de servicio solo afecta a la conectividad externa, no a la estructura interna.

Consideraciones de SDN para implementaciones desagregadas
La compatibilidad con redes definidas por software (SDN) varía en función de la arquitectura local de Azure y el tipo de implementación. En implementaciones desagregadas, las redes lógicas SDN (LNET) son compatibles a través de una infraestructura SDN externa, en lugar de la pila SDN de Microsoft.
En la tabla siguiente se resume la compatibilidad con SDN en arquitecturas locales de Azure a partir de la versión 2604:
| Arquitectura local de Azure | Versión local de Azure | Número de nodos | Configuración compatible con SDN |
|---|---|---|---|
| Hyperconverged | 2604 | De 1 a 16 | LNETs y NSGs de Microsoft SDN |
| Híbrido hiperconvergido (S2D + conexión SAN) | 2604 | De 1 a 16 | LNETs y NSGs de Microsoft SDN |
| Desagregado | 2604 | De 1 a 64 | Se admiten LNET de SDN externos. |
Note
Para las implementaciones desagregadas, las redes lógicas de SDN deben configurarse en el tejido de red externo (conmutadores de columna hoja) en lugar de a través de la controladora de red SDN de Microsoft. Asegúrese de que el diseño de VXLAN EVPN de superposición esté adecuadamente planificado para admitir las redes lógicas necesarias.
Enrutamiento de red lógica de AKS y diseño de VRF
Al crear redes lógicas (LNET) para Azure Kubernetes Service (AKS) en Azure Local, la LNET de AKS debe tener capacidad de acceso de nivel 3 (línea de visión) a los nodos del clúster que se ejecutan en la LNET de administración. AKS usa esta ruta de acceso para comunicarse con el servidor de API de Kubernetes y otros servicios de infraestructura hospedados en la red de administración. Si la LNET de AKS no puede acceder a la LNET de administración, se producirá un error en la implementación y las operaciones de AKS. Este requisito es específico de AKS: los LNET de máquina virtual (VM) no requieren capacidad de acceso a la red de administración.
Opción 1: VRF único
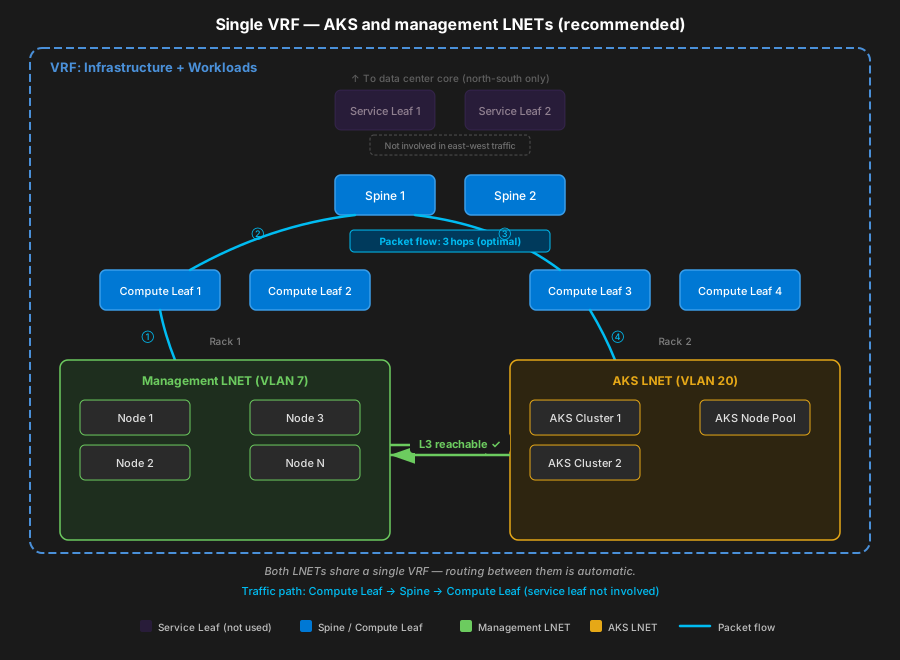
Para Azure Local, versión 2604, un enfoque consiste en colocar tanto las LNET de infraestructura (administración, proceso) como las LNET de AKS en un único VRF en la estructura leaf-spine. Una única VRF garantiza que todos los LNET compartan la misma tabla de enrutamiento, por lo que la accesibilidad entre la administración y las redes de AKS es automática; no se necesita ninguna configuración adicional.
Con IRB simétrico VXLAN EVPN, el tráfico entre subredes entre AKS y las LNET de administración en el mismo VRF se enruta localmente a nivel del leaf de proceso (VTEP). Los paquetes atraviesan nodo leaf de proceso → nodo spine → nodo leaf de proceso (3 saltos). Los conmutadores leaf de servicio no intervienen en este tráfico este-oeste, lo que se traduce en una latencia óptima y evita la creación de un cuello de botella en el nivel de los conmutadores leaf de servicio.
Opción 2: VRF separados con filtración de rutas
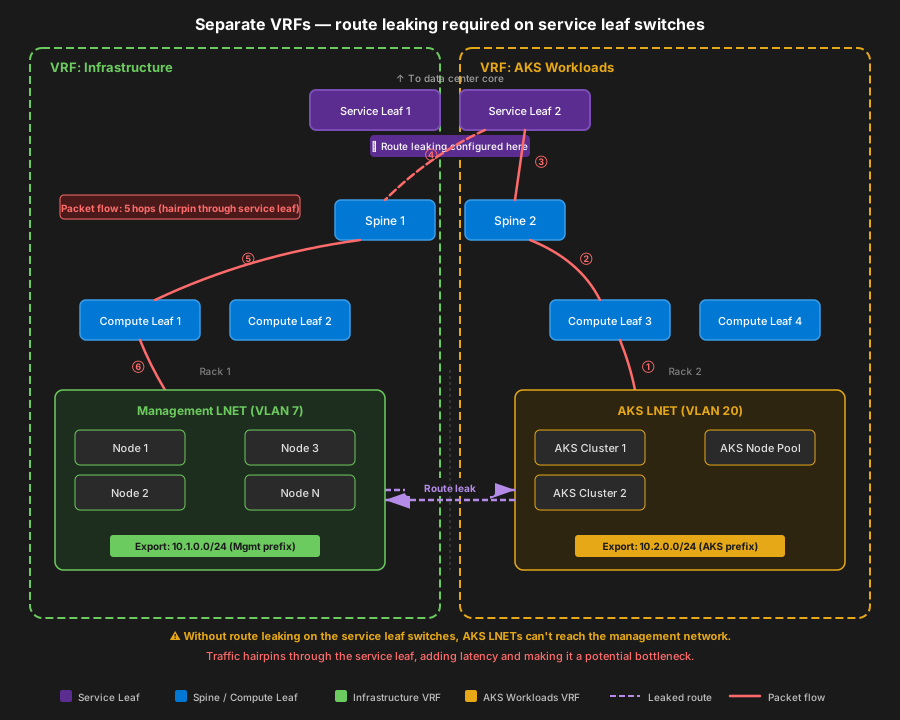
Si tu entorno requiere VRF independientes para diferentes cargas de trabajo o inquilinos —por ejemplo, para cumplir con los requisitos normativos de aislamiento—, debes configurar la filtración de rutas en los conmutadores leaf de servicio para permitir el tráfico necesario entre VRF. Como mínimo, el VRF que hospeda la LNET de AKS debe importar los prefijos LNET de administración, y el VRF de administración debe importar los prefijos LNET de AKS. Sin estas rutas filtradas, la comunicación entre diferentes VRFs falla y AKS no puede acceder a los servicios de infraestructura.
Dado que la filtración de rutas se configura en los conmutadores leaf de servicio, el tráfico entre VRF debe realizar un recorrido en forma de horquilla a través del nivel leaf de servicio. La ruta del paquete pasa a ser hoja de cómputo → columna vertebral → hoja de servicio → columna vertebral → hoja de cómputo (5 saltos), en lugar de la ruta de 3 saltos que se da en un único VRF. Este recorrido adicional añade latencia y convierte a los conmutadores hoja de servicio en un posible cuello de botella de rendimiento para todas las comunicaciones entre AKS y la administración.
Importante
La filtración de rutas introduce una accesibilidad compartida entre VRF que, de otro modo, estarían aislados. Filtra únicamente los prefijos específicos necesarios para la comunicación entre AKS y la administración. Evita filtrar rutas predeterminadas o resúmenes amplios, ya que esta acción socava las ventajas de aislamiento que ofrecen los VRF separados.
Optimización del tráfico en el mismo rack
Los recuentos de saltos descritos en la Opción 1 (3 saltos) y la Opción 2 (5 saltos) representan el peor escenario posible entre racks: cuando la carga de trabajo de AKS y el nodo de administración al que debe llegar se encuentran en conmutadores leaf de cómputo diferentes (racks diferentes).
Cuando tanto la carga de trabajo de AKS como su nodo de administración de destino se encuentran en el mismo rack (conectados al mismo par de conmutadores leaf de proceso), el conmutador leaf de proceso realiza el enrutamiento local mediante el protocolo IRB (Integrated Routing and Bridging). El tráfico no atraviesa el conmutador spine y se completa en un solo salto. Esta es una propiedad del IRB simétrico de VXLAN EVPN: cada conmutador leaf es un VTEP totalmente funcional que puede enrutar entre cualquier subred dentro de sus VRF instanciadas localmente.
En la tabla siguiente se resume el recuento de saltos efectivo para cada escenario:
| Escenario | Ruta de enrutamiento | Recuento de saltos |
|---|---|---|
| Mismo bastidor, mismo VRF | IRB local en el conmutador leaf de cálculo | Un salto |
| Entre racks, mismo VRF (Opción 1) | Conmutador leaf de cálculo → Spine → Conmutador leaf de cálculo | Tres saltos |
| Entre racks, VRF distintos (Opción 2) | Conmutador de hoja de cómputo → Spine → Conmutador de hoja de servicio → Spine → Conmutador de hoja de cómputo | Cinco saltos |
Sugerencia
Si la mayoría de sus cargas de trabajo de AKS se comunican principalmente con servicios de administración en el mismo rack, la latencia efectiva es menor que en el peor de los casos entre racks. Considere la ubicación de la carga de trabajo y la afinidad de bastidor al evaluar el impacto en el rendimiento de su diseño VRF.
Requisitos de la estructura leaf y spine
En esta sección se describen las funcionalidades adicionales del conmutador necesarias para implementaciones medianas (17-32 nodos) y grandes (33-64 nodos) que usan una arquitectura Clos de hoja-espina con superposición de red privada virtual extensible (VXLAN) y red privada virtual de Ethernet (EVPN), aislamiento de enrutamiento y reenvío virtual con multitenencia (VRF) e integración de servicios a través de dispositivos de firewall o balanceadores de carga. Estos requisitos son aditivos: se siguen aplicando todos los requisitos de conmutadores locales de Azure base.
| Categoría | Requisitos |
|---|---|
| Subcapa | Protocolo de puerta de enlace fronteriza externa (eBGP) sin numerar (RFC 5549) que utiliza transporte IPv6 de enlace local para la información de accesibilidad de la capa de red IPv4 (NLRI) |
| Emparejamiento basado en loopback (un loopback por conmutador) | |
| Número de sistema autónomo (ASN) único por rack | |
| Equal-Cost Multipath (ECMP): mínimo de 16 vías, recomendado de 64 vías | |
| Detección de reenvío bidireccional (BFD) para la conmutación por error del Protocolo de puerta de enlace fronteriza (BGP) en menos de un segundo | |
| Superposición | Virtual Extensible LAN (VXLAN) (RFC 7348) con BGP multiprotocolo (MP-BGP) Red privada virtual Ethernet (EVPN) (RFC 8365) |
| Compatibilidad con los tipos de ruta EVPN 2 y 5 | |
| Puerta de enlace anycast por VLAN | |
| Supresión del Protocolo de resolución de direcciones/Detección de vecinos (ARP/ND) | |
| Asignación coherente de VLAN a VNI | |
| Enrutamiento integrado simétrico y puente (IRB) para el enrutamiento entre VLAN dentro de una instancia de enrutamiento y reenvío virtual (VRF) | |
| Segmentación | Compatibilidad de VRF con el identificador de red VXLAN de capa 3 (L3VNI) |
| Importación/exportación de destinos de ruta para la filtración controlada de rutas | |
| Enrutamiento predeterminado compatible con VRF | |
| Escalabilidad para admitir simultáneamente VRF de proceso/clúster, administración y múltiples inquilinos | |
| Integración del servicio (hoja de servicio) | Par dedicado de hojas de servicio para el núcleo del centro de datos y los dispositivos de servicio |
| Peering BGP externo con el núcleo del centro de datos a través de hojas de servicio (no de espinas) | |
| Fuga de rutas VRF hacia/desde el VRF de servicio | |
| Compatibilidad con el encadenamiento de servicios o la dirección del tráfico a través del firewall o el equilibrador de carga | |
| Calidad de servicio (QoS) | Mínimo cuatro colas de hardware por puerto |
| Clasificación/marcado de Clase de Servicio (CoS) 802.1p | |
| Reserva de ancho de banda mediante Selección de Transmisión Mejorada (ETS) (802.1Qaz) a través del algoritmo Round-Robin ponderado (WRR) | |
| Anuncio de tipo-longitud-valor (TLV) de Data Center Bridging Capability Exchange (DCBX) a través del Protocolo de descubrimiento de la capa de enlace (LLDP) | |
| Funcionalidad de Control de flujo de prioridad (PFC) opcional (no necesaria para iSCSI) | |
| Almacenamiento iSCSI | Compatibilidad con VLAN de iSCSI (etiquetada 802.1Q) y funcionalidad de enrutamiento estático para el aislamiento del tráfico de almacenamiento |
| Compatible con E/S multirruta (MPIO) (no se requiere el protocolo de control de agregación de enlaces (LACP) en enlaces iSCSI) | |
| Alta disponibilidad | Agregación de enlaces multichasis (MLAG) / Canal de puerto virtual (vPC) para hosts con doble conexión |
| Reinicio progresivo del Protocolo de puerta de enlace fronteriza (BGP) / enrutamiento ininterrumpido | |
| Se recomienda la actualización de software en servicio (ISSU) | |
| Scale | Tabla MAC ≥16 000 |
| ARP/ND ≥8 000 | |
| Escala VNI ≥1.000 | |
| Escala de VRF ≥16 | |
| Rutas IPv4 + EVPN combinadas ≥10 000 | |
| Capacidad de memoria ternaria direccionable por contenido (TCAM) / lista de control de acceso (ACL) suficiente para la clasificación de calidad de servicio (QoS) y las ACL de seguridad |
Requisitos del firewall
Azure Local necesita tener una conectividad periódica a Azure. Si el firewall saliente de su organización está restringido, necesitaría incluir los requisitos del firewall en puntos de conexión de salida, así como reglas internas y puertos. Existen puntos de conexión obligatorios y recomendados para los componentes principales de Azure Local, que incluyen creación de sistemas, registro y facturación, Microsoft Update y testigo en la nube.
Consulte los requisitos de firewall para ver toda la lista de puntos de conexión. Asegúrese de incluir estas URL obligatorias en la lista de elementos permitidos. Los puertos de red adecuados se deben abrir entre todas las máquinas dentro de un sitio o entre varios sitios (para clústeres extendidos).
El proceso de validación de la conectividad de Azure Local de la herramienta Comprobador del entorno, verifica el requisito de la conectividad saliente predeterminada durante la implementación. Además, puede ejecutar sola la herramienta Comprobador del entorno ante, durante o después de la implementación para evaluar la conectividad saliente del entorno.
Lo más recomendable es tener todos los puntos de conexión que correspondan en un archivo de datos al que pueda acceder la herramienta de comprobación del entorno. Este mismo archivo se puede compartir con el administrador del firewall para que abra los puertos y URL necesarios.
Para obtener más información, consulte Requisitos de firewall.
Pasos siguientes
- Elija un patrón de red desagregado para revisarlo.