Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Recupera un pipeline de Lakeflow cuando un punto de control de streaming deja de ser válido o se corrompe, mediante una actualización completa, una copia de seguridad y un relleno, o un restablecimiento selectivo del punto de control.
¿Qué es un punto de control de streaming?
En Apache Spark Structured Streaming, un punto de control es un mecanismo que se usa para conservar el estado de una consulta de streaming. Este estado incluye:
- Información de progreso: Qué desplazamientos de la fuente han sido procesados.
-
Estado intermedio: Datos que deben mantenerse entre microlotes para operaciones con estado (por ejemplo, agregaciones,
mapGroupsWithState). - Metadatos: Información sobre la ejecución de la consulta de streaming.
Los puntos de control son esenciales para garantizar la tolerancia a errores y la coherencia de los datos en las aplicaciones de streaming:
- Tolerancia a fallos: Si una aplicación de streaming falla (por ejemplo, debido a un fallo de nodo o fallo de la aplicación), el punto de control permite que la aplicación se reinicie desde el último estado exitoso del punto de control en lugar de reprocesar todos los datos desde el principio. Esto evita la pérdida de datos y garantiza el procesamiento incremental.
- Procesamiento exactamente una vez: Para muchas fuentes de streaming, los puntos de control, junto con los sumideros idempotentes, permiten un procesamiento que garantiza que cada registro se procese exactamente una vez, incluso ante fallos, evitando duplicados u omisiones.
- Gestión de estados: Para transformaciones con estado, los puntos de control mantienen el estado interno de estas operaciones, permitiendo que la consulta en streaming continúe procesando correctamente nuevos datos basándose en el estado histórico acumulado.
Puntos de control de canalización
Las canalizaciones se basan en Structured Streaming y abstraen gran parte de la gestión subyacente de los puntos de control, ofreciendo un enfoque declarativo. Al definir una tabla de streaming en la canalización, hay un estado de punto de comprobación para cada escritura de flujo en la tabla de streaming. Estas ubicaciones de punto de control son internas de la canalización y no son accesibles para los usuarios.
Normalmente no necesitas gestionar ni entender los puntos de control subyacentes para las tablas de streaming. Cuando lo hagas, la herramienta adecuada depende de tu situación:
- Si quieres recuperar la canalización a una versión anterior debido a una mala transformación, cambio de esquema, entrada mal formada o un despliegue de código defectuoso: Rebobina la canalización. Rewind restaura de forma conjunta los datos de la tabla, los desplazamientos de origen y el estado del operador a un momento anterior, y vuelve a procesar únicamente los datos afectados, preservando el estado del operador. Esta es la forma recomendada de reprocesar desde un punto en el tiempo, aunque pueden aplicarse limitaciones en la Beta.
-
El punto de control está corrupto, o un cambio de código incompatible con el punto de control bloquea la canalización: Rewind no recupera estos casos porque no relaja las reglas de compatibilidad de Structured Streaming. Utiliza uno de los métodos de recuperación por puntos de control en las opciones de recuperación:
- Actualización completa de la tabla: Reinicia la tabla y borra los datos existentes.
- Actualización completa de la tabla con copia de seguridad y relleno: Haz una copia de seguridad de la tabla antes de una actualización completa y luego rellena los datos antiguos. Esto es caro y debería ser el último recurso.
- Reinicia el punto de control y continúa de forma incremental: Conserva los datos existentes y reinicia el punto de control para los flujos de streaming afectados.
Ejemplo: Error de canalización debido al cambio de código
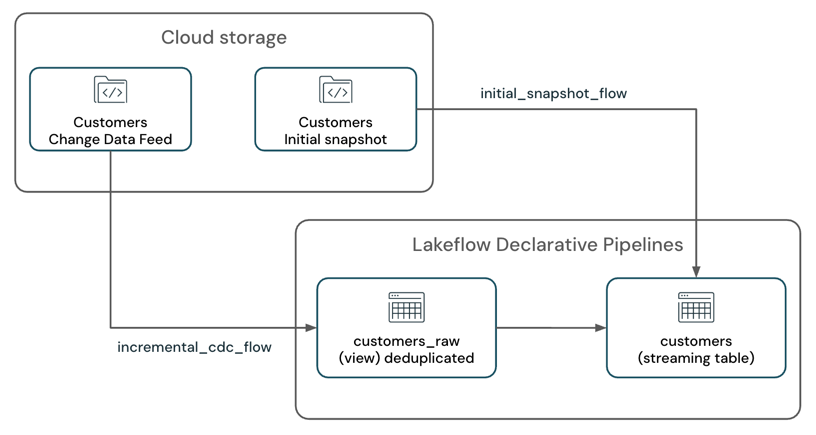
Considere un escenario en el que tiene una canalización que procesa un flujo de datos de cambios junto con la instantánea de la tabla inicial de un sistema de almacenamiento en la nube, como Amazon S3, y escribe en una tabla de streaming SCD-1.
La canalización tiene dos flujos de streaming:
-
customers_incremental_flow: Lee incrementalmente lacustomerfuente de alimentación CDC, filtra los registros duplicados y los introduce en la tabla objetivo. -
customers_snapshot_flow: Lee una sola vez la instantánea inicial de lacustomerstabla fuente y inserta o actualiza los registros en la tabla objetivo.
@dp.temporary_view(name="customers_incremental_view")
def query():
    return (
    spark.readStream.format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.includeExistingFiles", "true")
        .load(customers_incremental_path)
        .dropDuplicates(["customer_id"])
    )

@dp.temporary_view(name="customers_snapshot_view")
def full_orders_snapshot():
    return (
        spark.readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.includeExistingFiles", "true")
        .option("cloudFiles.inferColumnTypes", "true")
        .load(customers_snapshot_path)
        .select("*")
    )

dp.create_streaming_table("customers")

dp.create_auto_cdc_flow(
    name = "customers_incremental_flow",
    target = "customers",
    source = "customers_incremental_view",
    keys = ["customer_id"],
    sequence_by = col("sequenceNum"),
    apply_as_deletes = expr("operation = 'DELETE'"),
    apply_as_truncates = expr("operation = 'TRUNCATE'"),
    except_column_list = ["operation", "sequenceNum"],
    stored_as_scd_type = 1
)
dp.create_auto_cdc_flow(
    name = "customers_snapshot_flow",
    target = "customers",
    source = "customers_snapshot_view",
    keys = ["customer_id"],
    sequence_by = lit(0),
    stored_as_scd_type = 1,
    once = True
)
Después de implementar esta canalización, se ejecuta correctamente y comienza a procesar el flujo de datos de cambio y la instantánea inicial.
Más tarde, se da cuenta de que la lógica de desduplicación de la consulta customers_incremental_view resulta redundante y provoca un cuello de botella en el rendimiento. Para mejorar el rendimiento, quite el dropDuplicates().
@dp.temporary_view(name="customers_raw_view")
def query():
    return (
    spark.readStream.format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.includeExistingFiles", "true")
        .load()
        # .dropDuplicates()
    )
Después de quitar la dropDuplicates() API y volver a implementar la canalización, la actualización produce el siguiente error:
Streaming stateful operator name does not match with the operator in state metadata.
This is likely to happen when a user adds/removes/changes stateful operators of existing streaming query.
Stateful operators in the metadata: [(OperatorId: 0 -> OperatorName: dedupe)];
Stateful operators in current batch: []. SQLSTATE: 42K03 SQLSTATE: XXKST
Este error indica que no se permite el cambio debido a una falta de coincidencia entre el estado del punto de control y la definición de consulta actual, lo que impide que la canalización avance aún más.
Los errores relacionados con los puntos de comprobación pueden producirse por varios motivos más allá de simplemente quitar la dropDuplicates API. Entre los escenarios habituales se incluyen los siguientes:
- Agregar o quitar operadores con estado (por ejemplo, introducir o quitar
dropDuplicates()o agregar agregaciones) en una consulta de streaming existente. - Agregar, quitar o combinar orígenes de streaming en una consulta previamente guardada (por ejemplo, uniendo una consulta de streaming existente con una nueva, o añadiendo o quitando orígenes de una operación de unión existente).
- Modificar el esquema de estado de las operaciones de streaming con estado (por ejemplo, cambiar las columnas usadas para la desduplicación o la agregación).
Para obtener una lista completa de los cambios admitidos y no admitidos, consulte la Guía de streaming estructurado de Spark y Tipos de cambios en las consultas de Structured Streaming.
Opciones de recuperación
La siguiente tabla compara tus opciones. Rewind vuelve a procesar una canalización en buen estado desde un momento anterior; las otras tres recuperan una canalización bloqueada por un punto de control no válido o dañado. Difieren en complejidad, coste y requisitos de durabilidad de los datos:
| Methods | Complejidad | Cost | Posible pérdida de datos | Posible duplicación de datos | Requiere instantánea inicial | Restablecimiento de tabla completa |
|---|---|---|---|---|---|---|
| Rebobinar | Low | Bajo (reprocesa solo la ventana afectada) | No | No | No | No |
| Actualización completa de la tabla | Low | Media | Sí (si no hay ninguna instantánea inicial disponible o si los archivos sin procesar se han eliminado en el origen). | No (para aplicar cambios en la tabla de destino). | Sí | Sí |
| Actualización completa de la tabla con copia de seguridad y rellenado retrospectivo | Media | High | No | No (para receptores idempotentes; por ejemplo, CDC automático). | No | No |
| Restablecer punto de control de la tabla | Medio-Alto (medio para fuentes de solo adición que proporcionan desplazamientos inmutables). | Low | No (requiere una consideración cuidadosa). | No (para escritores idempotentes; por ejemplo, CDC automático solo en la tabla de destino). | No | No |
La complejidad media-alta depende del tipo de fuente de streaming y de la complejidad de la consulta.
Rewind requiere una canalización en el canal Preview con el indicador de configuración pipelines.rewind.betaEnabled establecido, así como fuentes y sumideros compatibles. Reprocesa una tubería desde un punto anterior; no recupera un punto de control inválido o corrupto ni un cambio de código incompatible con el punto de control. Para eso, usa uno de los otros tres métodos. Consulte Rebobinar y reproducir un canal.
Recommendations
- Usa Rewind cuando la tubería esté en buen estado pero haya producido datos incorrectos de un momento conocido, y quieras preservar el estado del operador mientras reprocesas solo la ventana afectada. Es la opción más sencilla cuando se aplica, pero requiere el canal de Vista previa y las fuentes y sumideros compatibles, y no puede recuperar un punto de control corrupto o un cambio incompatible con el punto de control.
- Use una actualización de tabla completa si no quiere tratar con la complejidad de un restablecimiento de punto de control y puede volver a calcular toda la tabla. Una actualización completa también ofrece una opción para realizar cambios en el código.
- Utilice la actualización completa de la tabla con copia de seguridad y rellenado si no desea tratar la complejidad del reinicio del punto de control y está de acuerdo con el costo adicional de realizar una copia de seguridad y el rellenado de datos históricos.
- Use el punto de control de restablecimiento de la tabla si debe conservar los datos existentes en la tabla y continuar procesando los nuevos datos de forma incremental. Sin embargo, este enfoque requiere un control cuidadoso del restablecimiento del punto de control para comprobar que los datos existentes de la tabla no se pierden y que la canalización puede continuar procesando nuevos datos.
Restablecer el punto de control y continuar incrementalmente
Para restablecer el punto de control y continuar procesando incrementalmente, siga estos pasos:
Detener la canalización: asegúrese de que la canalización no tenga actualizaciones activas en ejecución.
Determine la posición inicial del nuevo punto de control: identifique el último desplazamiento exitoso o la última marca de tiempo desde el que desea continuar con el procesamiento. Por lo general, este es el desplazamiento más reciente procesado correctamente antes de que se produzca el error.
Dado que está leyendo los archivos JSON mediante Auto Loader en el ejemplo anterior, puede usar la
modifiedAfteropción para establecer una marca de tiempo para cuando Auto Loader comienza a procesar archivos nuevos.En el caso de los orígenes de Kafka, se puede usar la opción
startingOffsetspara especificar los desplazamientos desde donde la consulta de streaming debe empezar a procesar nuevos datos.Para fuentes de Delta Lake, puede usar la opción
startingVersionpara especificar la versión desde la cual la consulta de streaming debería comenzar a procesar nuevos datos.Realizar cambios en el código: puede modificar la consulta de streaming para quitar la
dropDuplicates()API o realizar otros cambios. Compruebe también que ha agregado lamodifiedAfteropción a la ruta de lectura del cargador automático.@dp.temporary_view(name="customers_incremental_view") def query(): return ( spark.readStream.format("cloudFiles") .option("cloudFiles.format", "json") .option("cloudFiles.inferColumnTypes", "true") .option("cloudFiles.includeExistingFiles", "true") .option("modifiedAfter", "2025-04-09T06:15:00") .load(customers_incremental_path) # .dropDuplicates(["customer_id"]) )Nota:
Proporcionar una marca de tiempo incorrecta
modifiedAfterpuede provocar la pérdida de datos o la duplicación. Compruebe que la marca de tiempo está configurada correctamente para evitar volver a procesar los datos antiguos o que falten nuevos datos.Si la consulta tiene una combinación de transmisión-transmisión o una unión de transmisión-transmisión, debe aplicar la estrategia anterior para todos los orígenes de streaming participantes. Por ejemplo:
cdc_1 = spark.readStream.format("cloudFiles")...
cdc_2 = spark.readStream.format("cloudFiles")...
cdc_source = cdc_1.union(cdc_2)
Identifique los nombres de flujo asociados a la tabla de streaming para la que desea restablecer el punto de control. Debe pasar cada nombre de flujo en un formato
catalog.schema.flow_namecompleto. En el ejemplo, el nombre completo del flujo esmy_catalog.my_schema.customers_incremental_flow. El flujo utiliza un parámetro explícitonamedecustomers_incremental_flow. Si no establece un nombre de flujo explícito, el nombre de flujo predeterminado es el nombre completo de la tabla de destino con el formatocatalog.schema.table(por ejemplo,my_catalog.my_schema.customers). Puede encontrar nombres de flujo en el código de canalización, la interfaz de usuario de canalización o los registros de eventos de canalización.Reinicia el punto de control y comienza una actualización: crea un cuaderno de Python y conéctalo a un clúster de Azure Databricks.
Necesitará la siguiente información para poder restablecer el punto de control:
- Dirección URL del área de trabajo de Azure Databricks
- Id. de canalización
- Nombres de flujo para los que está restableciendo el punto de control
import requests
import json

# Define your Databricks instance and pipeline ID
databricks_instance = "<DATABRICKS_URL>"
token = dbutils.notebook.entry_point.getDbutils().notebook().getContext().apiToken().get()
pipeline_id = "<YOUR_PIPELINE_ID>"
flows_to_reset = ["<YOUR_FLOW_NAME>"]
# Set up the API endpoint
endpoint = f"{databricks_instance}/api/2.0/pipelines/{pipeline_id}/updates"


# Set up the request headers
headers = {
    "Authorization": f"Bearer {token}",
    "Content-Type": "application/json"
}

# Define the payload
payload = {
    "reset_checkpoint_selection": flows_to_reset
}

# Make the POST request
response = requests.post(endpoint, headers=headers, data=json.dumps(payload))

# Check the response
if response.status_code == 200:
    print("Pipeline update started successfully.")
else:
    print(f"Error: {response.status_code}, {response.text}")
En la interfaz del pipeline, comprueba que la actualización está en curso. Los flujos de restablecimiento procesan nuevos datos desde la posición inicial especificada con un punto de control nuevo, y se conservan los datos existentes de la tabla.
procedimientos recomendados
- Evite el uso de características de versión preliminar privada en producción.
- Pruebe los cambios antes de realizar cambios en el entorno de producción.
- Cree una canalización de prueba, idealmente en un entorno inferior. Si esto no es posible, intente usar un catálogo y un esquema diferentes para la prueba.
- Reproduzca el error.
- Aplique los cambios.
- Valide los resultados y decida sobre aprobar/rechazar.
- Implemente los cambios en las canalizaciones de producción.