Important
Les traductions non anglaises sont fournies uniquement pour des raisons pratiques. Consultez la EN-US version de ce document pour obtenir la version définitive.
Cet article fournit des détails sur la façon dont les données que vous fournissez sont traitées, utilisées et stockées par Azure Speech dans Foundry Tools en synthèse vocale. En guise de rappel important, vous êtes responsable de votre utilisation et de l’implémentation de cette technologie et vous devez obtenir toutes les autorisations nécessaires, y compris, le cas échéant, à partir du talent vocal et d’avatar (et, le cas échéant, les utilisateurs de vos intégrations vocales personnelles) pour le traitement de leur voix, de leur image, de leur like et/ou d’autres données pour développer des voix synthétiques et/ou des avatars.
Vous êtes également responsable de l’obtention de licences, d’autorisations ou d’autres droits nécessaires pour le contenu que vous entrez dans le service de synthèse vocale pour générer l’audio, l’image et/ou la sortie vidéo. Certaines juridictions peuvent imposer des exigences légales particulières pour la collecte, le traitement et le stockage de certaines catégories de données, telles que les données biométriques, et imposer la divulgation de l’utilisation de voix synthétiques, d’images et/ou de vidéos aux utilisateurs. Avant d’utiliser du texte pour traiter et stocker des données de n’importe quel type et, le cas échéant, pour créer des modèles de voix neuronales personnalisées, de voix personnelle ou d’avatar personnalisés, vous devez vous assurer que vous êtes en conformité avec toutes les exigences légales qui peuvent s’appliquer à vous.
Important
Si vous utilisez des produits ou services Microsoft pour traiter les données biométriques, vous êtes responsable de : (i) fournir un avis aux personnes concernées, y compris en ce qui concerne les périodes de rétention et la destruction ; (ii) obtenir le consentement des personnes concernées ; et (iii), en supprimant les données biométriques, toutes les conditions appropriées et requises en vertu des exigences applicables en matière de protection des données. Les « données biométriques » auront la signification définie dans l’article 4 du RGPD et, le cas échéant, des termes équivalents dans d’autres exigences de protection des données.
Quelles sont les données traitées par les services de synthèse vocale ?
-
Entrée de texte pour la synthèse vocale. Il s’agit du texte que vous sélectionnez et envoyez au service de synthèse vocale pour générer une sortie audio à l’aide d’un ensemble de voix neuronales prédéfinies ou pour générer un avatar prédéfini qui énoncé l’audio généré à partir de voix neuronales prédéfinies ou personnalisées.
Fichier de reconnaissance des talents vocaux enregistrés. Les clients sont tenus de charger une déclaration enregistrée spécifique parlée par le talent vocal dans lequel ils reconnaissent que vous utiliserez leur voix pour créer des voix synthétiques.
Note
Lors de la préparation de votre script d’enregistrement, veuillez inclure la déclaration de reconnaissance requise pour que l'artiste vocal puisse l’enregistrer. Vous trouverez l’instruction dans plusieurs langues here. La langue de la déclaration de reconnaissance doit être la même que celle des données d'apprentissage pour les enregistrements audio.
Données d’apprentissage (y compris les fichiers audio et les transcriptions de texte associées). Cela inclut les enregistrements audio du talent vocal qui ont accepté d’utiliser leur voix pour la formation de modèle et les transcriptions de texte associées. Dans un projet de pro de voix neuronale personnalisée, vous pouvez fournir vos propres transcriptions de texte audio ou utiliser la fonctionnalité de transcription de reconnaissance vocale automatisée disponible dans Speech Studio pour générer une transcription de texte de l’audio. Les enregistrements audio et les fichiers de transcription de texte seront utilisés comme données d’entraînement de modèle vocal. Dans un projet de voix neuronale lite personnalisée, vous êtes invité à enregistrer la voix lisant le script défini par Microsoft dans *Speech Studio*. Les transcriptions de texte ne sont pas requises pour les fonctionnalités vocales personnelles.
Texte en tant que script de test. Vous pouvez charger vos propres scripts textuels pour évaluer et tester la qualité du modèle vocal neuronal personnalisé en générant des exemples audio de synthèse vocale. Cela ne s’applique pas aux fonctionnalités vocales personnelles.
Entrée de texte pour la synthèse vocale. Il s’agit du texte que vous sélectionnez et envoyez au service de synthèse vocale pour générer une sortie audio à l’aide de votre voix neuronale personnalisée.
Fichier sauvegardé contenant l’instruction de reconnaissance du talent de l’avatar. Les clients sont tenus de charger une déclaration spécifique enregistrée en vidéo par le talent d’avatar dans laquelle ils reconnaissent que vous utiliserez leur voix et leur image pour créer des modèles d’avatars.
Note
Lorsque vous élaborez votre plan d'enregistrement vidéo, assurez-vous d'inclure la déclaration de reconnaissance requise pour l'enregistrement par le talent de l'avatar. Vous trouverez l’instruction dans plusieurs langues here. La langue de la déclaration de reconnaissance doit être la même que la langue des données d'entraînement de l’enregistrement vidéo.
La vidéo de déclaration d’accusé de réception n’est pas tenue d’être réalisée dans les mêmes conditions (comme l’environnement d’enregistrement ou les vêtements du talent de l’avatar) que les données d’entraînement vidéo, mais le visage de l’acteur doit être entièrement visible et sans aucune occlusion.
Données d’apprentissage (y compris les fichiers audio et les fichiers image/vidéo). Cela inclut des enregistrements vidéo et audio du talent d’avatar qui ont accepté d’utiliser leur image et leur voix pour l’entraînement du modèle. Nous n’avons pas besoin d’une transcription textuelle de l’audio dans la vidéo.
Texte en tant que script de test. Vous pouvez charger vos propres scripts textuels pour évaluer et tester la qualité du modèle d’avatar personnalisé en générant des exemples vidéo d’avatar synthétiques.
Entrée de texte pour la synthèse vocale. Il s’agit du texte que vous sélectionnez et envoyez au service de synthèse vocale pour générer une sortie audio et vidéo à l’aide de votre avatar personnalisé.
Comment les services de synthèse vocale traitent-ils les données ?
Voix neuronale prédéfinie
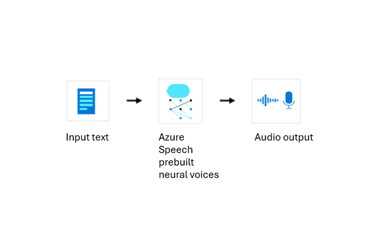
Le diagramme suivant illustre la façon dont vos données sont traitées pour la synthèse avec la voix neuronale prédéfinie. L’entrée est du texte et la sortie est audio. Ni le texte d’entrée ni le contenu audio de sortie ne sont stockés dans les journaux de Microsoft.
Voix neuronale personnalisée
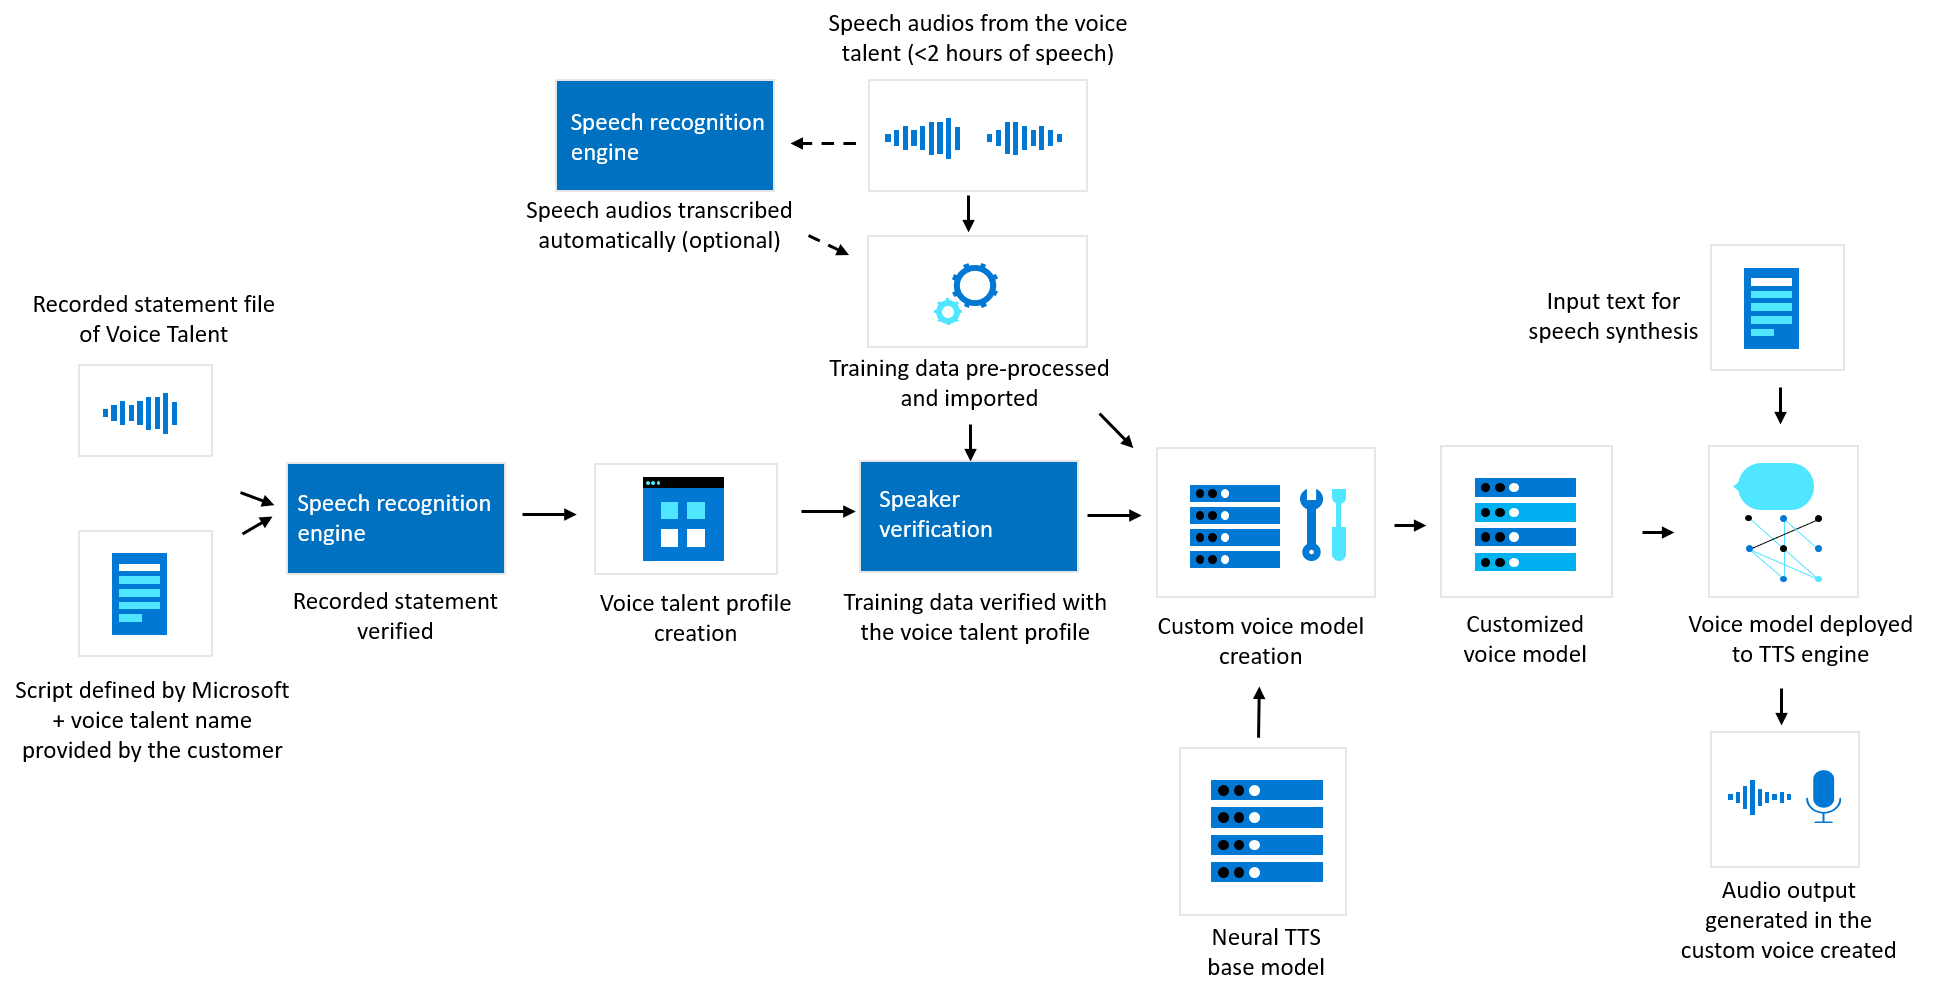
Le diagramme suivant illustre la façon dont vos données sont traitées pour la voix neuronale personnalisée. Ce diagramme couvre trois types de traitement différents : comment Microsoft vérifie les fichiers d'accusé de réception enregistrés des talents vocaux avant l’entraînement du modèle neuronal vocal personnalisé, comment Microsoft crée un modèle vocal neuronal personnalisé avec vos données de formation et comment la synthèse vocale traite votre entrée textuelle pour générer du contenu audio.
Avatar de synthèse vocale
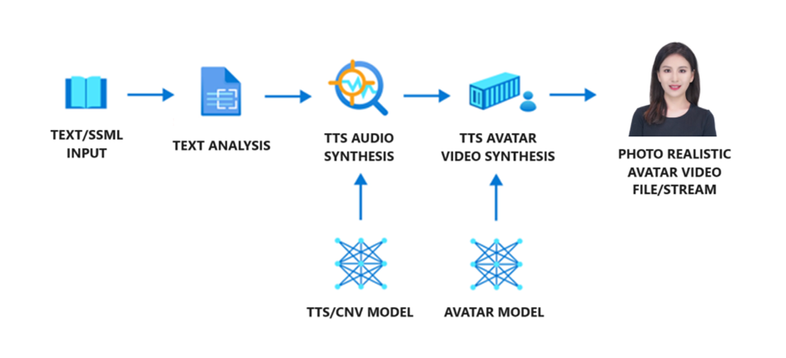
Le diagramme suivant illustre la façon dont vos données sont traitées pour la synthèse avec un avatar de synthèse vocale prédéfini. Il existe trois composants dans un flux de travail de génération de contenu d’avatar : analyseur de texte, synthétiseur audio TTS et synthétiseur vidéo d’avatar TTS. Pour générer une vidéo d’avatar, le texte est d’abord entré dans l’analyseur de texte, qui fournit la sortie sous la forme d’une séquence phonème. Ensuite, le synthétiseur audio TTS prédit les caractéristiques acoustiques du texte d’entrée et synthétise la voix. Ces deux parties sont fournies par des modèles vocaux de synthèse vocale. Ensuite, le modèle Avatar de synthèse vocale neuronale prédit l'image de synchronisation labiale avec les paramètres acoustiques, afin que la vidéo synthétique soit générée.
Traduction vidéo
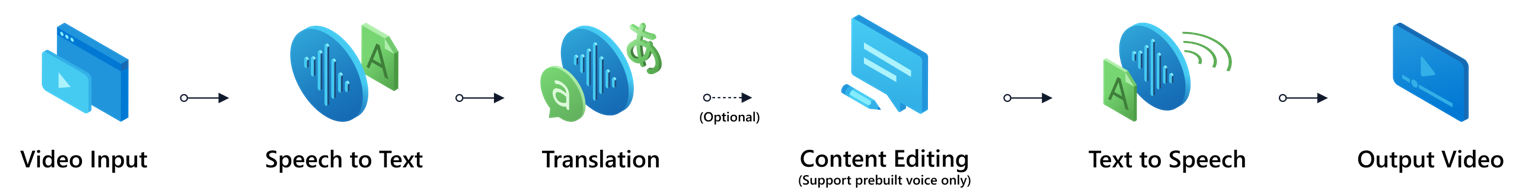
Le diagramme ci-dessous illustre la façon dont vos données sont traitées avec la traduction vidéo. Le client télécharge une vidéo comme entrée pour la traduction vidéo; l'audio du dialogue est extrait, et un système de reconnaissance vocale transcrira l'audio en contenu texte. Ensuite, le contenu texte sera traduit dans le contenu de la langue cible et, à l’aide de la fonctionnalité de synthèse vocale, l’audio traduit sera fusionné avec le contenu vidéo d’origine comme sortie vidéo.
Il n’existe aucune section supplémentaire pour la voix ou l’avatar prédéfini.
Vérification de l’instruction enregistrée
Microsoft exige que les clients chargent un fichier audio dans Speech Studio avec une déclaration enregistrée du talent vocal reconnaissant que le client utilisera sa voix pour créer une voix synthétique. Microsoft peut utiliser la technologie de reconnaissance vocale et de conversion de la parole en texte de Microsoft pour transcrire cette déclaration d’accusé de réception enregistrée en texte et vérifier que le contenu de l’enregistrement correspond au script prédéfini fourni par Microsoft. Cette déclaration de reconnaissance, ainsi que les informations relatives au talent vocal fournies avec l’audio, sont utilisées pour créer un profil de talent vocal. Vous devez associer des données d’entraînement au profil de talent vocal approprié lors du lancement d’une formation vocale neuronale personnalisée.
Microsoft peut également traiter les signatures vocales biométriques issues du fichier enregistré de déclaration d'accusé de réception du talent vocal, ainsi que de l’audio aléatoire provenant des jeux de données d’entraînement, afin de confirmer avec une confiance raisonnable que la signature vocale dans l’enregistrement de la déclaration d'accusé de réception et les enregistrements des données d’entraînement correspondent, en utilisant Azure AI Speaker Verification. Une signature vocale peut également être appelée « modèle vocal » ou « empreinte vocale » et est un vecteur numérique qui représente les caractéristiques vocales d’une personne extraites des enregistrements audio d’une personne parlante. Cette protection technique vise à empêcher l’utilisation abusive de la voix neuronale personnalisée, par exemple en empêchant les clients d’entraîner des modèles vocaux avec des enregistrements audio et d’utiliser les modèles pour usurper la voix d’une personne sans leur connaissance ni leur consentement.
Les signatures vocales sont utilisées par Microsoft uniquement à des fins de vérification de l’orateur ou, dans le cas contraire, pour examiner l’utilisation abusive des services.
L'avenant sur la protection des données des produits et services de Microsoft (« DPA ») définit les obligations des clients et de Microsoft en ce qui concerne le traitement et la sécurité des données client et des données personnelles en lien avec Azure et est incorporé par référence dans le contrat d’entreprise des clients pour les services Azure. Le traitement des données de Microsoft dans cette section est régi sous la section Opérations commerciales d'intérêt légitime de l'Addenda sur la protection des données.
Formation d’un modèle vocal neuronal personnalisé
Les données d’entraînement (audio vocal) que les clients soumettent à Speech Studio sont prétraitées à l’aide d’outils automatisés pour la vérification de la qualité, notamment la vérification du format des données, l’évaluation de la prononciation, la détection du bruit, le mappage de script, etc. Les données d'entraînement sont ensuite importées dans le composant de formation du modèle de la plateforme vocale personnalisée. Au cours du processus d’apprentissage, les données d’entraînement (à la fois les transcriptions audio et textuelles) sont décomposées en mappages affinés d’acoustiques vocales et de texte, comme une séquence de phonèmes. Grâce à une modélisation plus complexe de l'apprentissage automatique, le service crée un modèle vocal, qui peut ensuite être utilisé pour générer de l’audio ressemblant à celle de l'artiste vocal et peut même être produite dans différentes langues à partir de l’enregistrement de données d’entraînement. Le modèle vocal est un modèle d’ordinateur de synthèse vocale qui peut imiter des caractéristiques vocales uniques d’un haut-parleur particulier. Il représente un ensemble de paramètres au format binaire qui n’est pas lisible par l’homme et ne contient pas d’enregistrements audio.
Les données d'apprentissage d'un client sont utilisées uniquement pour développer les modèles vocaux personnalisés du client et ne sont pas utilisées par Microsoft pour entraîner ou améliorer les modèles vocaux de Microsoft.
Synthèse vocale/génération de contenu audio
Une fois le modèle vocal créé, vous pouvez l’utiliser pour créer du contenu audio via le service de synthèse vocale avec deux options différentes.
Pour la synthèse vocale en temps réel, vous envoyez le texte d’entrée au service de synthèse vocale via le Kit de développement logiciel (SDK) TTS ou l’API RESTful. La synthèse vocale traite le texte d’entrée et retourne les fichiers de contenu audio de sortie en temps réel à l’application qui a effectué la requête.
Pour la synthèse asynchrone de l’audio long (synthèse par lots), vous envoyez les fichiers texte d’entrée au service de traitement par lots de synthèse vocale via l’API Audio Long pour créer de manière asynchrone des audios de plus de 10 minutes (par exemple des livres audio ou des conférences). Contrairement à la synthèse effectuée à l’aide de l’API de synthèse vocale, les réponses ne sont pas retournées en temps réel avec l’API Audio Long. Les fichiers audio sont créés de manière asynchrone et vous pouvez accéder aux fichiers audio synthétisés lorsqu’ils sont mis à disposition à partir du service de synthèse par lots.
Vous pouvez également utiliser votre modèle vocal personnalisé pour générer du contenu audio via un outil de création de contenu sans code Audio Content Creation et choisir d’enregistrer votre contenu audio d’entrée de texte ou de sortie avec l’outil dans Azure stockage.
Traitement des données pour la voix neuronale personnalisée lite (préversion)
Custom neural voice lite est un type de projet en préversion qui vous permet d’enregistrer des exemples vocaux 20-50 sur Speech Studio et de créer un modèle de voix neuronal personnalisé léger à des fins de démonstration et d’évaluation. Le script d’enregistrement et le script de test sont prédéfinis par Microsoft. Un modèle vocal synthétique que vous créez à l’aide de la voix neuronale personnalisée lite peut être déployé et utilisé plus largement uniquement si vous appliquez et recevez un accès complet à la voix neuronale personnalisée (sous réserve de conditions applicables).
La voix synthétique et l’enregistrement audio associé que vous envoyez via Speech Studio sont automatiquement supprimés dans les 90 jours, sauf si vous bénéficiez d’un accès complet à la voix neuronale personnalisée et que vous choisissez de déployer la voix synthétique, auquel cas vous contrôlerez la durée de sa rétention. Si le talent vocal souhaite que la voix synthétique et les enregistrements audio associés soient supprimés avant 90 jours, ils peuvent les supprimer directement sur le portail ou contacter leur entreprise pour le faire.
En outre, avant de pouvoir déployer n’importe quel modèle vocal synthétique créé à l’aide d’un projet de voix neuronale personnalisée, le talent vocal doit fournir un enregistrement supplémentaire dans lequel il reconnaît que la voix synthétique sera utilisée à des fins supplémentaires au-delà de la démonstration et de l’évaluation.
Traitement des données pour l’API vocale personnelle (préversion)
La voix personnelle permet aux clients de créer une voix synthétique à l’aide d’un échantillon de voix humaine court. Le fichier de déclaration de confirmation verbale décrit ci-dessus est requis de chaque utilisateur qui utilise l’intégration dans votre application. Microsoft peut traiter des signatures vocales biométriques à partir du fichier d’enregistrement de l’instruction de chaque utilisateur et de son échantillon de formation enregistré (également appelé « requête ») afin de confirmer, avec un niveau de confiance raisonnable, que la signature vocale de l’instruction correspond à celle des données de formation, au moyen de la vérification de l’orateur Azure AI.
L’exemple d’apprentissage sera utilisé pour créer le modèle vocal. Le modèle vocal peut ensuite être utilisé pour générer la reconnaissance vocale avec une entrée de texte fournie au service via l’API, sans déploiement supplémentaire requis.
Vérification de la déclaration de confirmation vidéo
Microsoft exige que les clients fournissent un fichier vidéo contenant une déclaration enregistrée d’accusé de réception de leur talent avatar, confirmant que le client utilisera l’image et la voix du talent pour créer un avatar personnalisé. Microsoft vérifiera que le contenu de l’enregistrement de la déclaration de reconnaissance correspondra au script prédéfini fourni par Microsoft.
Microsoft peut comparer le visage et la voix du talent de l’avatar présents dans le fichier vidéo de l’instruction de reconnaissance avec des vidéos sélectionnées de manière aléatoire issues des ensembles de données de formation pertinents, afin de confirmer que la personne figurant dans les enregistrements vidéo des données de formation correspond à celle apparaissant dans le fichier vidéo de l’instruction de reconnaissance.
Ce n’est qu’après la fourniture du fichier vidéo de l’instruction de reconnaissance et des données de formation vidéo, et leur validation réussie lors des vérifications des acteurs, que Microsoft commencera l’entraînement du modèle d’avatar personnalisé.
Formation d’un modèle d’avatar de synthèse vocale personnalisé
Les clients envoient leurs données d’apprentissage à Speech Studio via le portail d’avatar personnalisé. Les données sont prétraitées à l’aide d’outils automatisés pour vérifier la qualité, notamment le format des données, la taille de fichier et le volume total. Les données d’entraînement sont ensuite importées dans le composant d’entraînement du modèle du portail d’avatar personnalisé. Pendant le processus d’entraînement, les données d’entraînement (image vidéo et audio vocale dans le fichier vidéo) sont décomposées en mappages affinés des mouvements de lèvres et de l’acoustique vocale. Grâce à une modélisation plus complexe basée sur l'apprentissage automatique, le service construit un modèle d’avatar, qui peut ensuite être utilisé pour générer une vidéo ressemblant au talent représenté par l’avatar, et peut même être modifiée pour correspondre à la voix dans différentes langues à partir des données enregistrées pour l'entraînement.
Les données d'apprentissage d'un client sont utilisées uniquement pour développer les modèles d'avatar personnalisés du client et n'est pas utilisée par Microsoft pour entraîner ou améliorer les Microsoft modèles d'avatar de synthèse vocale.
Stockage et rétention des données
Text input for speech synthesis : Microsoft ne conserve pas ou stocke le texte que vous fournissez avec l'API de synthèse vocale en temps réel. Les scripts fournis via l'API Long Audio pour la synthèse vocale ou via l'API batch pour la synthèse vocale avatar sont stockés dans le stockage Azure pour traiter la demande de synthèse par lots. Le texte d’entrée peut être supprimé via l’API de suppression à tout moment.
Contenu audio et vidéo généré : Microsoft ne stocke pas le contenu audio ou vidéo généré avec l'API de synthèse en temps réel. Si vous utilisez la traduction vidéo ou l'API Long Audio pour l'API batch d'avatars de synthèse vocale, le contenu audio ou vidéo de sortie est stocké dans Azure stockage. Ces audios ou vidéos peuvent être supprimés à tout moment via l’opération de suppression .
Déclaration d’accusé de réception enregistrée et données de vérification de l’orateur : les signatures vocales sont utilisées par Microsoft uniquement à des fins de vérification de l’orateur ou, si nécessaire, pour examiner l’utilisation abusive des services. Les signatures vocales ne seront conservées que pour le temps nécessaire à l’exécution de la vérification de l’orateur, ce qui peut se produire de temps à autre. Microsoft peut nécessiter cette vérification avant de vous permettre d’entraîner ou de réentraîner des modèles vocaux neuronaux personnalisés dans Speech Studio, ou si nécessaire. Microsoft conservera le fichier de l’instruction de reconnaissance enregistrée ainsi que les données du profil du talent vocal pendant la durée nécessaire au maintien de la sécurité et de l’intégrité d’Azure Speech.
Modèles vocaux neuronaux personnalisés : pendant que vous conservez les droits d'utilisation exclusifs pour votre modèle vocal neuronal personnalisé, Microsoft peut conserver indépendamment une copie de modèles vocaux neuronaux personnalisés aussi longtemps que nécessaire. Microsoft pouvez utiliser votre modèle vocal neuronal personnalisé dans le seul but de protéger la sécurité et l’intégrité des outils Foundry.
Microsoft protégera et stockera des copies de l’instruction de reconnaissance enregistrée de chaque talent vocal et des modèles vocaux neuronaux personnalisés en appliquant le même niveau élevé de sécurité que celui utilisé pour ses autres services Azure. En savoir plus sur Microsoft Centre de gestion de la confidentialité.
Données de formation : Vous envoyez des données d’apprentissage vocale des talents vocaux pour générer des modèles vocaux via Speech Studio, qui seront conservées et stockées par défaut dans Azure storage (voir stockage Azure chiffrement des données au niveau de REST pour plus d’informations). Vous pouvez accéder à l’une des données d’apprentissage utilisées pour créer des modèles vocaux via Speech Studio et les supprimer.
Vous pouvez gérer le stockage de vos données d’apprentissage via BYOS (Bring Your Own Storage). Avec cette méthode de stockage, les données d’apprentissage sont accessibles uniquement à des fins d’entraînement de modèle vocal et seront stockées par le biais de BYOS.
Note
La voix personnelle n’offre pas la prise en charge de BYOS. Vos données seront stockées dans Azure stockage géré par Microsoft. Vous pouvez accéder et supprimer l’ensemble des données d’entraînement (audio d’invitation) utilisées pour créer des modèles vocaux via l’API. Microsoft peut conserver indépendamment une copie des modèles vocaux personnels tant que nécessaire. Microsoft pouvez utiliser votre modèle vocal personnel dans le seul but de protéger la sécurité et l’intégrité des outils Foundry.
Text input for speech synthesis : Microsoft ne conserve pas ou stocke le texte que vous fournissez avec l'API de synthèse vocale en temps réel. Les scripts fournis via l'API Long Audio pour la synthèse vocale ou via l'API batch pour la synthèse vocale avatar sont stockés dans le stockage Azure pour traiter la demande de synthèse par lots. Le texte d’entrée peut être supprimé via l’API de suppression à tout moment.
Contenu audio et vidéo généré : Microsoft ne stocke pas le contenu audio ou vidéo généré avec l'API de synthèse en temps réel. Si vous utilisez la traduction vidéo ou l'API Long Audio pour l'API batch d'avatars de synthèse vocale, le contenu audio ou vidéo de sortie est stocké dans Azure stockage. Ces audios ou vidéos peuvent être supprimés à tout moment via l’opération de suppression .
Données de déclaration de reconnaissance enregistrées : Microsoft peut comparer la vidéo de la déclaration de reconnaissance et les données d'entraînement avant de vous autoriser à entraîner ou réentraîner des modèles d’avatar personnalisés. Microsoft conservera le fichier d’enregistrement de l’instruction de reconnaissance et les données du profil du talent de l’avatar pendant la durée nécessaire au maintien de la sécurité et de l’intégrité de Foundry Tools.
Modèles d'avatar personnalisés pour la synthèse vocale : Bien que vous conserviez les droits d'utilisation exclusifs de votre modèle d'avatar personnalisé, Microsoft peut conserver indépendamment une copie des modèles d'avatar personnalisés aussi longtemps que ce sera nécessaire. Microsoft pouvez utiliser votre modèle d’avatar personnalisé dans le seul but de protéger la sécurité et l’intégrité des outils Foundry.
Microsoft sécurisera et stockera une copie de la déclaration de reconnaissance enregistrée de la personnalité d’avatar et des modèles personnalisés d’avatar avec la même sécurité de haut niveau qu'elle utilise pour ses autres services Azure. En savoir plus sur Microsoft Centre de gestion de la confidentialité.
Training data : Les données d’apprentissage envoyées via Speech Studio sont conservées et stockées dans Azure storage par défaut (voir stockage Azure chiffrement des données à REST pour plus d’informations). Vous pouvez accéder à vos données d’apprentissage et les supprimer pour créer des modèles d’avatar via Speech Studio.
Prévention des abus et de la génération de contenu nuisible (aperçu)
Pour réduire le risque d’utilisation nuisible des services de synthèse vocale avatar Azure, l'avatar de synthèse vocale Azure comprend des fonctionnalités de protection du contenu. La sécurité du contenu se produit de façon synchrone au fur et à mesure que le service traite du texte pour générer de l’audio. Aucun texte ou résultat généré n’est stocké dans les modèles de classifieur de contenu, et le texte et les résultats ne sont pas utilisés pour entraîner, réentraîner ou améliorer les modèles classifieur. Pour en savoir plus sur les catégories de préjudices des fonctionnalités de sécurité du contenu, consultez catégories de préjudices.
Voir aussi