Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megvizsgálhatja az egyéni beszédmodellek felismerési minőségét. Lejátszhatja a feltöltött hangokat, és megállapíthatja, hogy a megadott felismerés eredménye helyes-e. A teszt sikeres létrehozása után láthatja, hogy egy modell hogyan írta át a hangadatkészletet, vagy összehasonlíthatja két modell eredményeit egymás mellett.
Az egymás melletti modelltesztelés hasznos annak ellenőrzéséhez, hogy melyik beszédfelismerési modell a legjobb egy alkalmazáshoz. A pontosság objektív méréséhez, amelyhez átírási adatkészletek bemenete szükséges, tekintse meg a modell mennyiségi tesztelését.
Fontos
A tesztelés során a rendszer átírást végez. Ezt fontos szem előtt tartani, mivel a díjszabás szolgáltatásajánlatonként és előfizetési szintenként eltérő. A legfrissebb részletekért mindig tekintse meg a Foundry Tools hivatalos díjszabását.
Teszt létrehozása
Miután feltöltötte a betanítási és tesztelési adathalmazokat, létrehozhat egy tesztet.
Az új Microsoft Foundry portálon nem hoz létre külön minőségi tesztet. Az érvényesítés automatikusan fut a Modell finomhangolása varázsló Érvényesítési adatpanelén megadott adatkészleten. Az eredmények vizsgálatához lásd: Teszteredmények lekérése.
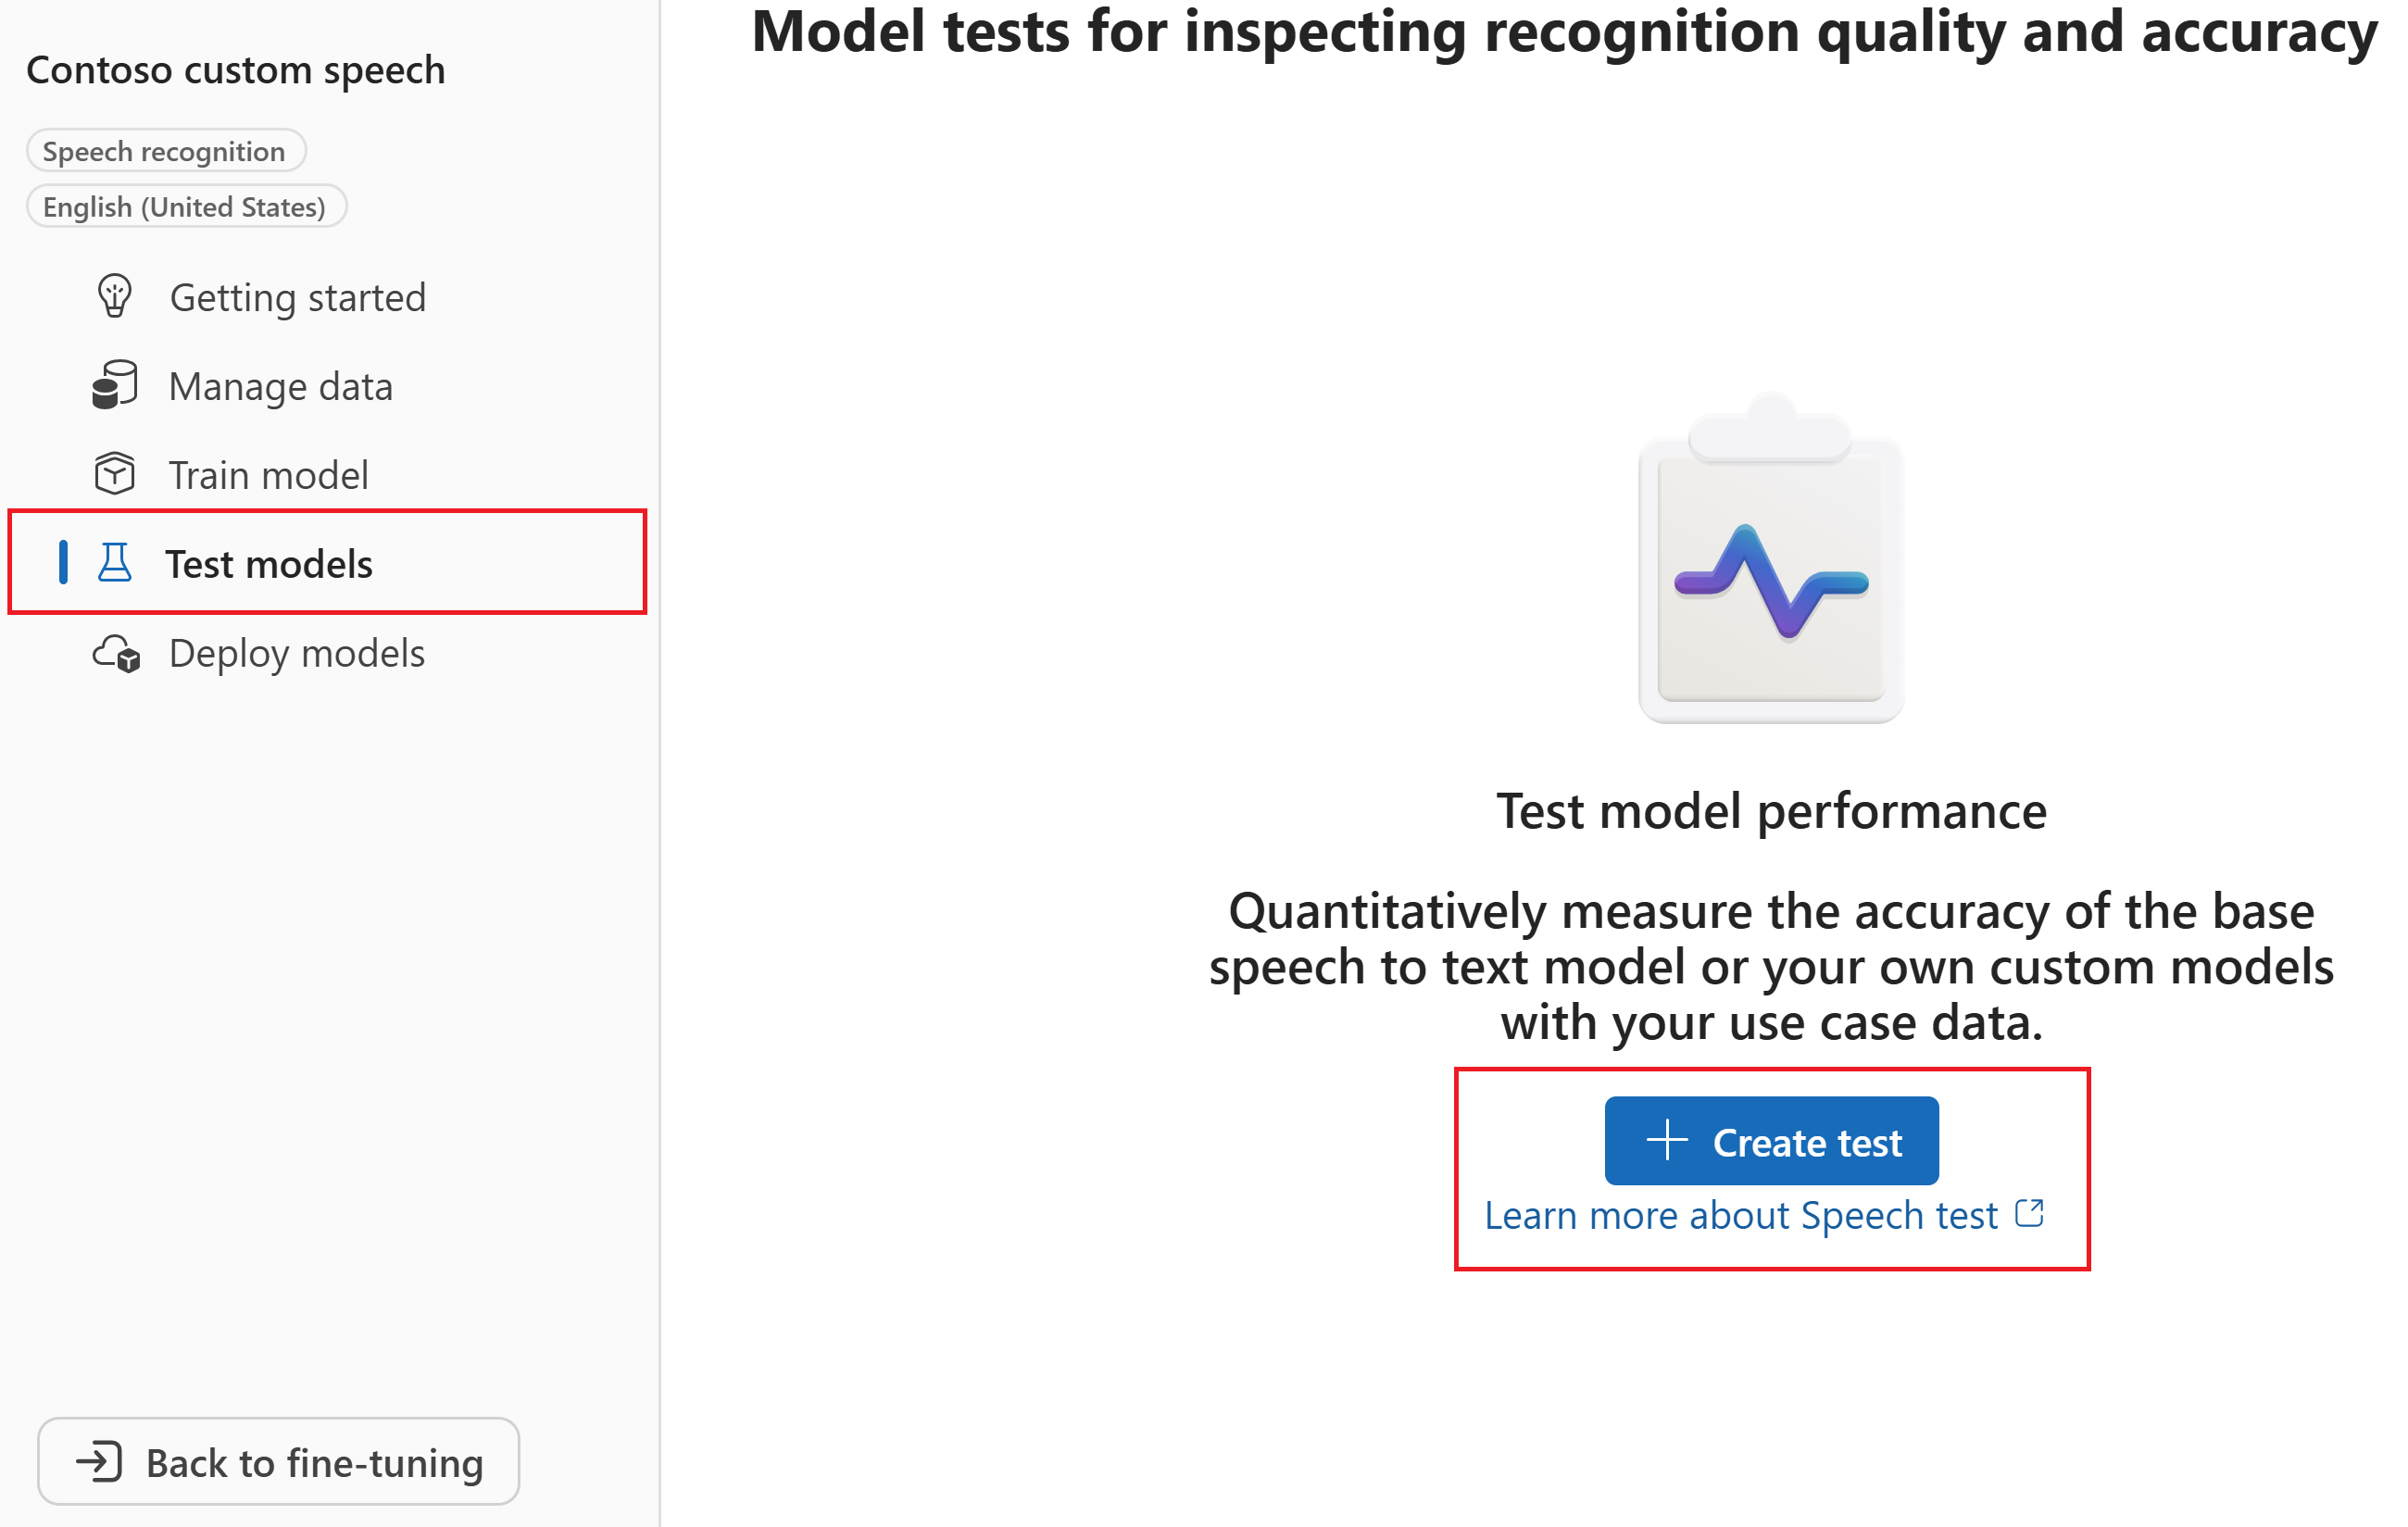
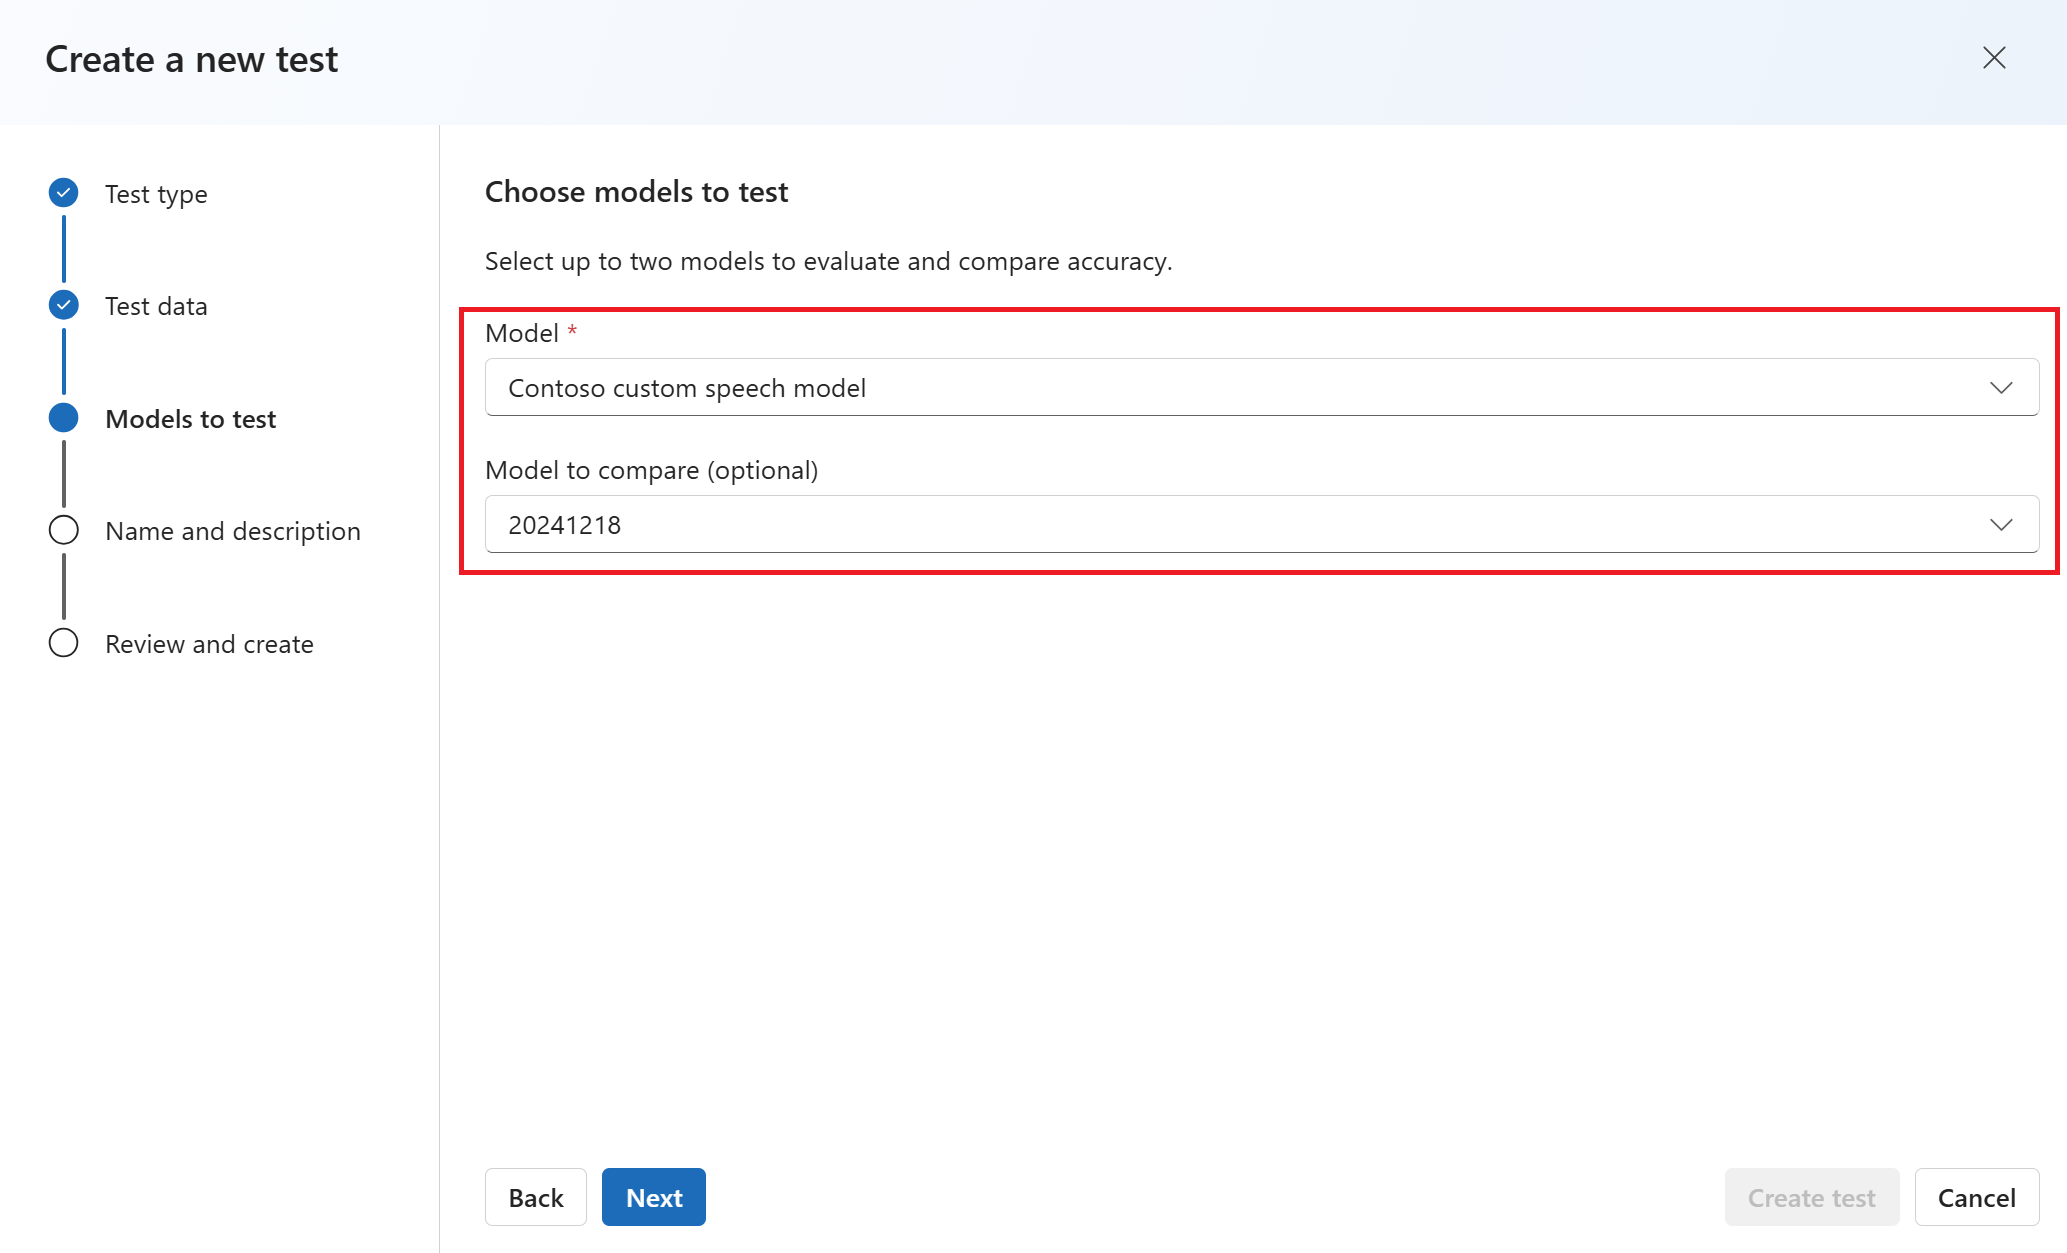
Teszt létrehozásához kövesse az alábbi utasításokat:
Jelentkezzen be a Speech Studio-ba.
Lépjen a Speech Studio>Custom Speechre , és válassza ki a projekt nevét a listából.
Válassza a Tesztmodellek>Új teszt létrehozása lehetőséget.
Válassza a Minőség vizsgálata (csak hangadatok)>Tovább lehetőséget.
Válasszon ki egy hangadatkészletet, amelyet tesztelni szeretne, majd válassza a Tovább gombot. Ha nincs elérhető adathalmaz, szakítsa meg a beállítást, majd lépjen a Speech adathalmazok menübe az adathalmazok feltöltéséhez.
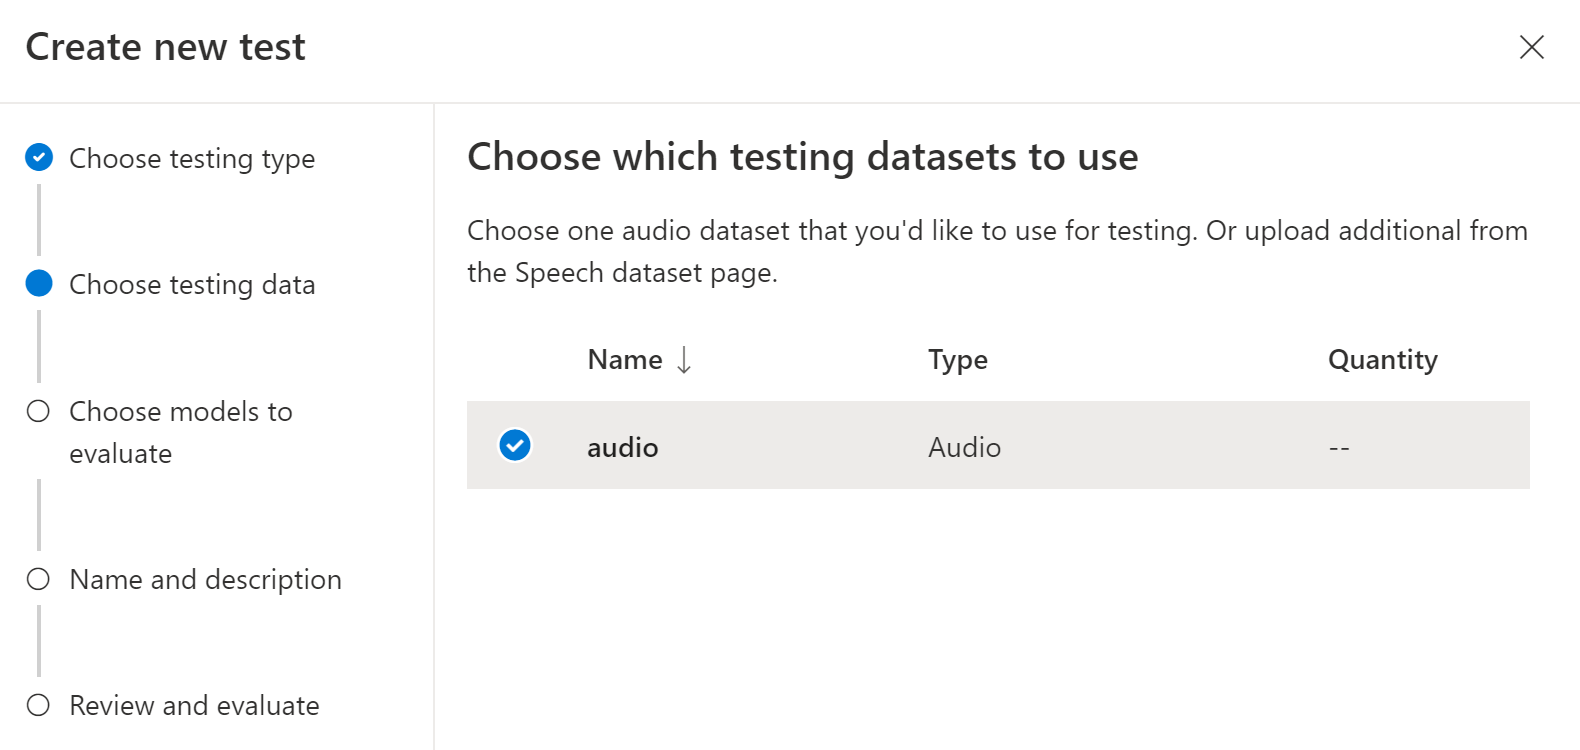
Válasszon ki egy vagy két modellt a pontosság kiértékeléséhez és összehasonlításához.
Adja meg a teszt nevét és leírását, majd kattintson a Tovább gombra.
Tekintse át a beállításokat, majd válassza a Mentés és bezárás lehetőséget.
A folytatás előtt győződjön meg arról, hogy telepítette és konfigurálta a Speech CLI-t .
Teszt létrehozásához használja a spx csr evaluation create parancsot. A kérelemparamétereket az alábbi utasítások szerint hozhatja létre:
- Állítsa a
projecttulajdonságot egy meglévő projekt azonosítójára. Aprojecttulajdonság azért ajánlott, hogy az egyéni beszéd finomhangolását a Microsoft Foundry portálon is felügyelhesse. A projektazonosító lekéréséhez tekintse meg a REST API dokumentációjának projektazonosítóját . - Állítsa be a szükséges
model1tulajdonságot a tesztelni kívánt modell azonosítójára. - Állítsa be a szükséges
model2tulajdonságot egy másik tesztelni kívánt modell azonosítójára. Ha nem szeretne két modellt összehasonlítani, használja ugyanazt a modellt mindkettőhözmodel1ésmodel2. - Állítsa a szükséges
datasettulajdonságot a teszthez használni kívánt adathalmaz azonosítójára. - Állítsa be a
languagetulajdonságot, ellenkező esetben a Speech CLI alapértelmezés szerint a "en-US" beállítást állítja be. Ennek a paraméternek kell lennie az adathalmaz tartalmának területi beállításának. A területi beállítás később nem módosítható. A Speech CLIlanguagetulajdonság megfelel alocaleJSON-kérés és -válasz tulajdonságának. - Állítsa be a szükséges
nametulajdonságot. Ez a paraméter a Microsoft Foundry portálon megjelenő név. A Speech CLInametulajdonság megfelel adisplayNameJSON-kérés és -válasz tulajdonságának.
Íme egy példa a Speech CLI-parancsra, amely létrehoz egy tesztet:
spx csr evaluation create --api-version v3.2 --project aaaabbbb-0000-cccc-1111-dddd2222eeee --dataset bbbbcccc-1111-dddd-2222-eeee3333ffff --model1 ccccdddd-2222-eeee-3333-ffff4444aaaa --model2 ccccdddd-2222-eeee-3333-ffff4444aaaa --name "My Inspection" --description "My Inspection Description"
Fontos
Be kell állítania a kívánt értéket --api-version v3.2. A Speech CLI a REST API-t használja, de később még nem támogatja a verziókat v3.2.
A válasz törzsének a következő formátumban kell érkeznie:
{
  "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/ddddeeee-3333-ffff-4444-aaaa5555bbbb",
  "model1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ccccdddd-2222-eeee-3333-ffff4444aaaa"
  },
  "model2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ccccdddd-2222-eeee-3333-ffff4444aaaa"
  },
  "dataset": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/datasets/bbbbcccc-1111-dddd-2222-eeee3333ffff"
  },
  "transcription2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/eeeeffff-4444-aaaa-5555-bbbb6666cccc"
  },
  "transcription1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/eeeeffff-4444-aaaa-5555-bbbb6666cccc"
  },
  "project": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/projects/aaaabbbb-0000-cccc-1111-dddd2222eeee"
  },
  "links": {
    "files": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/9c06d5b1-213f-4a16-9069-bc86efacdaac/files"
  },
  "properties": {
    "wordErrorRate1": -1.0,
    "sentenceErrorRate1": -1.0,
    "sentenceCount1": -1,
    "wordCount1": -1,
    "correctWordCount1": -1,
    "wordSubstitutionCount1": -1,
    "wordDeletionCount1": -1,
    "wordInsertionCount1": -1,
    "wordErrorRate2": -1.0,
    "sentenceErrorRate2": -1.0,
    "sentenceCount2": -1,
    "wordCount2": -1,
    "correctWordCount2": -1,
    "wordSubstitutionCount2": -1,
    "wordDeletionCount2": -1,
    "wordInsertionCount2": -1
  },
  "lastActionDateTime": "2024-07-14T21:21:39Z",
  "status": "NotStarted",
  "createdDateTime": "2024-07-14T21:21:39Z",
  "locale": "en-US",
  "displayName": "My Inspection",
  "description": "My Inspection Description"
}
A válasz törzsének legfelső szintű self tulajdonsága az értékelés URI-ja. Ezzel az URI-val részletes információkat kaphat a projektről és a tesztelési eredményekről. Ezzel az URI-val is frissítheti vagy törölheti az értékelést.
A Speech CLI kiértékelésekkel kapcsolatos súgójához futtassa a következő parancsot:
spx help csr evaluation
Teszt létrehozásához használja a Speech to text REST API Evaluations_Create műveletét. A kérelem törzsének összeállítása az alábbi utasítások szerint:
- Állítsa a
projecttulajdonságot egy meglévő projekt azonosítójára. Aprojecttulajdonság azért ajánlott, hogy az egyéni beszéd finomhangolását a Microsoft Foundry portálon is felügyelhesse. A projektazonosító lekéréséhez tekintse meg a REST API dokumentációjának projektazonosítóját . - Állítsa a szükséges
model1tulajdonságot a tesztelni kívánt modell URI-jára. - Állítsa be a szükséges
model2tulajdonságot egy másik tesztelni kívánt modell URI-jára. Ha nem szeretne két modellt összehasonlítani, használja ugyanazt a modellt mindkettőhözmodel1ésmodel2. - Állítsa be a szükséges
datasettulajdonságot a teszthez használni kívánt adathalmaz URI-jára. - Állítsa be a szükséges
localetulajdonságot. Ennek a tulajdonságnak kell lennie az adathalmaz tartalmának területi beállításának. A területi beállítás később nem módosítható. - Állítsa be a szükséges
displayNametulajdonságot. A tulajdonság neve, amely megjelenik a Microsoft Foundry portálon.
Http POST-kérés létrehozása az URI használatával az alábbi példában látható módon. Cserélje le a(z) YourSpeechResoureKey elemet a Speech-erőforráskulcsra, cserélje le a(z) YourResourceName elemet a Speech-erőforrás nevére, és állítsa be a kérelem törzsének tulajdonságait a korábban leírtak szerint.
curl -v -X POST -H "Ocp-Apim-Subscription-Key: YourSpeechResoureKey" -H "Content-Type: application/json" -d '{
  "model1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/ccccdddd-2222-eeee-3333-ffff4444aaaa"
  },
  "model2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ccccdddd-2222-eeee-3333-ffff4444aaaa"
  },
  "dataset": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/datasets/bbbbcccc-1111-dddd-2222-eeee3333ffff"
  },
  "project": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/projects/aaaabbbb-0000-cccc-1111-dddd2222eeee"
  },
  "displayName": "My Inspection",
  "description": "My Inspection Description",
  "locale": "en-US"
}'  "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations"
A válasz törzsének a következő formátumban kell érkeznie:
{
  "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/ddddeeee-3333-ffff-4444-aaaa5555bbbb",
  "model1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ccccdddd-2222-eeee-3333-ffff4444aaaa"
  },
  "model2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ccccdddd-2222-eeee-3333-ffff4444aaaa"
  },
  "dataset": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/datasets/bbbbcccc-1111-dddd-2222-eeee3333ffff"
  },
  "transcription2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/eeeeffff-4444-aaaa-5555-bbbb6666cccc"
  },
  "transcription1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/eeeeffff-4444-aaaa-5555-bbbb6666cccc"
  },
  "project": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/projects/aaaabbbb-0000-cccc-1111-dddd2222eeee"
  },
  "links": {
    "files": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/9c06d5b1-213f-4a16-9069-bc86efacdaac/files"
  },
  "properties": {
    "wordErrorRate1": -1.0,
    "sentenceErrorRate1": -1.0,
    "sentenceCount1": -1,
    "wordCount1": -1,
    "correctWordCount1": -1,
    "wordSubstitutionCount1": -1,
    "wordDeletionCount1": -1,
    "wordInsertionCount1": -1,
    "wordErrorRate2": -1.0,
    "sentenceErrorRate2": -1.0,
    "sentenceCount2": -1,
    "wordCount2": -1,
    "correctWordCount2": -1,
    "wordSubstitutionCount2": -1,
    "wordDeletionCount2": -1,
    "wordInsertionCount2": -1
  },
  "lastActionDateTime": "2024-07-14T21:21:39Z",
  "status": "NotStarted",
  "createdDateTime": "2024-07-14T21:21:39Z",
  "locale": "en-US",
  "displayName": "My Inspection",
  "description": "My Inspection Description"
}
A válasz törzsének legfelső szintű self tulajdonsága az értékelés URI-ja. Ezzel az URI-val részletes információkat kaphat az értékelés projektjéről és a tesztelés eredményeiről. Ezzel az URI-val is frissítheti vagy törölheti az értékelést.
Teszteredmények lekérése
Le kell szereznie a teszteredményeket, és meg kell vizsgálnia a hangadatkészleteket az egyes modellek átirati eredményeihez képest.
A betanítás befejezése után válassza ki az egyéni modellt a részletek lapjának megnyitásához, majd válassza az Érvényesítések lapot. A Részletek allapon lejátszhatja a hangot, és egymás mellett összehasonlíthatja a felismert és az emberi címkével ellátott átiratokat.
A teszteredmények lekéréséhez kövesse az alábbi lépéseket:
- Jelentkezzen be a Speech Studio-ba.
- Válassza a(z) Egyéni beszéd> projekt nevét >Tesztmodellek lehetőséget.
- Válassza ki a hivatkozást tesztnév alapján.
- Miután a teszt befejeződött, amit az jelez, hogy az állapot értéke Sikeres, látnia kell az eredményeket, amelyek az egyes tesztelt modellekhez tartozó WER-értéket is tartalmazzák.
Ez a lap felsorolja az adathalmaz összes kimondott szövegét és a felismerési eredményeket, valamint a beküldött adathalmaz átiratát. Különböző hibatípusokat kapcsolhat be, beleértve a beszúrást, a törlést és a helyettesítést. A hang meghallgatásával és az egyes oszlopokban a felismerési eredmények összehasonlításával eldöntheti, hogy melyik modell felel meg az igényeinek, és meghatározhatja, hogy hol van szükség további betanításra és fejlesztésre.
A folytatás előtt győződjön meg arról, hogy telepítette és konfigurálta a Speech CLI-t .
A teszteredmények lekéréséhez használja a spx csr evaluation status parancsot. A kérelemparamétereket az alábbi utasítások szerint hozhatja létre:
- Állítsa be a szükséges
evaluationtulajdonságot annak a kiértékelésnek az azonosítójára, amelyről szeretné megkapni a teszteredményeket.
Íme egy példa a Speech CLI-parancsra, amely lekéri a teszteredményeket:
spx csr evaluation status --api-version v3.2 --evaluation ddddeeee-3333-ffff-4444-aaaa5555bbbb
Fontos
Be kell állítania a kívánt értéket --api-version v3.2. A Speech CLI a REST API-t használja, de később még nem támogatja a verziókat v3.2.
A modellek, hangadatkészletek, átiratok és további részletek a válasz törzsében jelennek meg.
A válasz törzsének a következő formátumban kell érkeznie:
{
  "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/ddddeeee-3333-ffff-4444-aaaa5555bbbb",
  "model1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ccccdddd-2222-eeee-3333-ffff4444aaaa"
  },
  "model2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ccccdddd-2222-eeee-3333-ffff4444aaaa"
  },
  "dataset": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/datasets/bbbbcccc-1111-dddd-2222-eeee3333ffff"
  },
  "transcription2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/eeeeffff-4444-aaaa-5555-bbbb6666cccc"
  },
  "transcription1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/eeeeffff-4444-aaaa-5555-bbbb6666cccc"
  },
  "project": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/projects/aaaabbbb-0000-cccc-1111-dddd2222eeee"
  },
  "links": {
    "files": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/9c06d5b1-213f-4a16-9069-bc86efacdaac/files"
  },
  "properties": {
    "wordErrorRate1": 0.028900000000000002,
    "sentenceErrorRate1": 0.667,
    "tokenErrorRate1": 0.12119999999999999,
    "sentenceCount1": 3,
    "wordCount1": 173,
    "correctWordCount1": 170,
    "wordSubstitutionCount1": 2,
    "wordDeletionCount1": 1,
    "wordInsertionCount1": 2,
    "tokenCount1": 165,
    "correctTokenCount1": 145,
    "tokenSubstitutionCount1": 10,
    "tokenDeletionCount1": 1,
    "tokenInsertionCount1": 9,
    "tokenErrors1": {
      "punctuation": {
        "numberOfEdits": 4,
        "percentageOfAllEdits": 20.0
      },
      "capitalization": {
        "numberOfEdits": 2,
        "percentageOfAllEdits": 10.0
      },
      "inverseTextNormalization": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      },
      "lexical": {
        "numberOfEdits": 12,
        "percentageOfAllEdits": 12.0
      },
      "others": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      }
    },
    "wordErrorRate2": 0.028900000000000002,
    "sentenceErrorRate2": 0.667,
    "tokenErrorRate2": 0.12119999999999999,
    "sentenceCount2": 3,
    "wordCount2": 173,
    "correctWordCount2": 170,
    "wordSubstitutionCount2": 2,
    "wordDeletionCount2": 1,
    "wordInsertionCount2": 2,
    "tokenCount2": 165,
    "correctTokenCount2": 145,
    "tokenSubstitutionCount2": 10,
    "tokenDeletionCount2": 1,
    "tokenInsertionCount2": 9,
    "tokenErrors2": {
      "punctuation": {
        "numberOfEdits": 4,
        "percentageOfAllEdits": 20.0
      },
      "capitalization": {
        "numberOfEdits": 2,
        "percentageOfAllEdits": 10.0
      },
      "inverseTextNormalization": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      },
      "lexical": {
        "numberOfEdits": 12,
        "percentageOfAllEdits": 12.0
      },
      "others": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      }
    }
  },
  "lastActionDateTime": "2024-07-14T21:22:45Z",
  "status": "Succeeded",
  "createdDateTime": "2024-07-14T21:21:39Z",
  "locale": "en-US",
  "displayName": "My Inspection",
  "description": "My Inspection Description"
}
A Speech CLI kiértékelésekkel kapcsolatos súgójához futtassa a következő parancsot:
spx help csr evaluation
A teszteredmények lekéréséhez először használja a Speech to text REST API Evaluations_Get műveletét.
Http GET-kérés létrehozása az URI használatával az alábbi példában látható módon. Cserélje le a(z) YourEvaluationId elemet a kiértékelési azonosítóra, a(z) YourSpeechResoureKey elemet a Speech-erőforráskulcsra, és a(z) YourResourceName elemet a Speech-erőforrás nevére.
curl -v -X GET "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/YourEvaluationId" -H "Ocp-Apim-Subscription-Key: YourSpeechResoureKey"
A modellek, hangadatkészletek, átiratok és további részletek a válasz törzsében jelennek meg.
A válasz törzsének a következő formátumban kell érkeznie:
{
  "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/ddddeeee-3333-ffff-4444-aaaa5555bbbb",
  "model1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ccccdddd-2222-eeee-3333-ffff4444aaaa"
  },
  "model2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ccccdddd-2222-eeee-3333-ffff4444aaaa"
  },
  "dataset": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/datasets/bbbbcccc-1111-dddd-2222-eeee3333ffff"
  },
  "transcription2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/eeeeffff-4444-aaaa-5555-bbbb6666cccc"
  },
  "transcription1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/eeeeffff-4444-aaaa-5555-bbbb6666cccc"
  },
  "project": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/projects/aaaabbbb-0000-cccc-1111-dddd2222eeee"
  },
  "links": {
    "files": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/9c06d5b1-213f-4a16-9069-bc86efacdaac/files"
  },
  "properties": {
    "wordErrorRate1": 0.028900000000000002,
    "sentenceErrorRate1": 0.667,
    "tokenErrorRate1": 0.12119999999999999,
    "sentenceCount1": 3,
    "wordCount1": 173,
    "correctWordCount1": 170,
    "wordSubstitutionCount1": 2,
    "wordDeletionCount1": 1,
    "wordInsertionCount1": 2,
    "tokenCount1": 165,
    "correctTokenCount1": 145,
    "tokenSubstitutionCount1": 10,
    "tokenDeletionCount1": 1,
    "tokenInsertionCount1": 9,
    "tokenErrors1": {
      "punctuation": {
        "numberOfEdits": 4,
        "percentageOfAllEdits": 20.0
      },
      "capitalization": {
        "numberOfEdits": 2,
        "percentageOfAllEdits": 10.0
      },
      "inverseTextNormalization": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      },
      "lexical": {
        "numberOfEdits": 12,
        "percentageOfAllEdits": 12.0
      },
      "others": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      }
    },
    "wordErrorRate2": 0.028900000000000002,
    "sentenceErrorRate2": 0.667,
    "tokenErrorRate2": 0.12119999999999999,
    "sentenceCount2": 3,
    "wordCount2": 173,
    "correctWordCount2": 170,
    "wordSubstitutionCount2": 2,
    "wordDeletionCount2": 1,
    "wordInsertionCount2": 2,
    "tokenCount2": 165,
    "correctTokenCount2": 145,
    "tokenSubstitutionCount2": 10,
    "tokenDeletionCount2": 1,
    "tokenInsertionCount2": 9,
    "tokenErrors2": {
      "punctuation": {
        "numberOfEdits": 4,
        "percentageOfAllEdits": 20.0
      },
      "capitalization": {
        "numberOfEdits": 2,
        "percentageOfAllEdits": 10.0
      },
      "inverseTextNormalization": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      },
      "lexical": {
        "numberOfEdits": 12,
        "percentageOfAllEdits": 12.0
      },
      "others": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      }
    }
  },
  "lastActionDateTime": "2024-07-14T21:22:45Z",
  "status": "Succeeded",
  "createdDateTime": "2024-07-14T21:21:39Z",
  "locale": "en-US",
  "displayName": "My Inspection",
  "description": "My Inspection Description"
}
Az átirat és a hang összehasonlítása
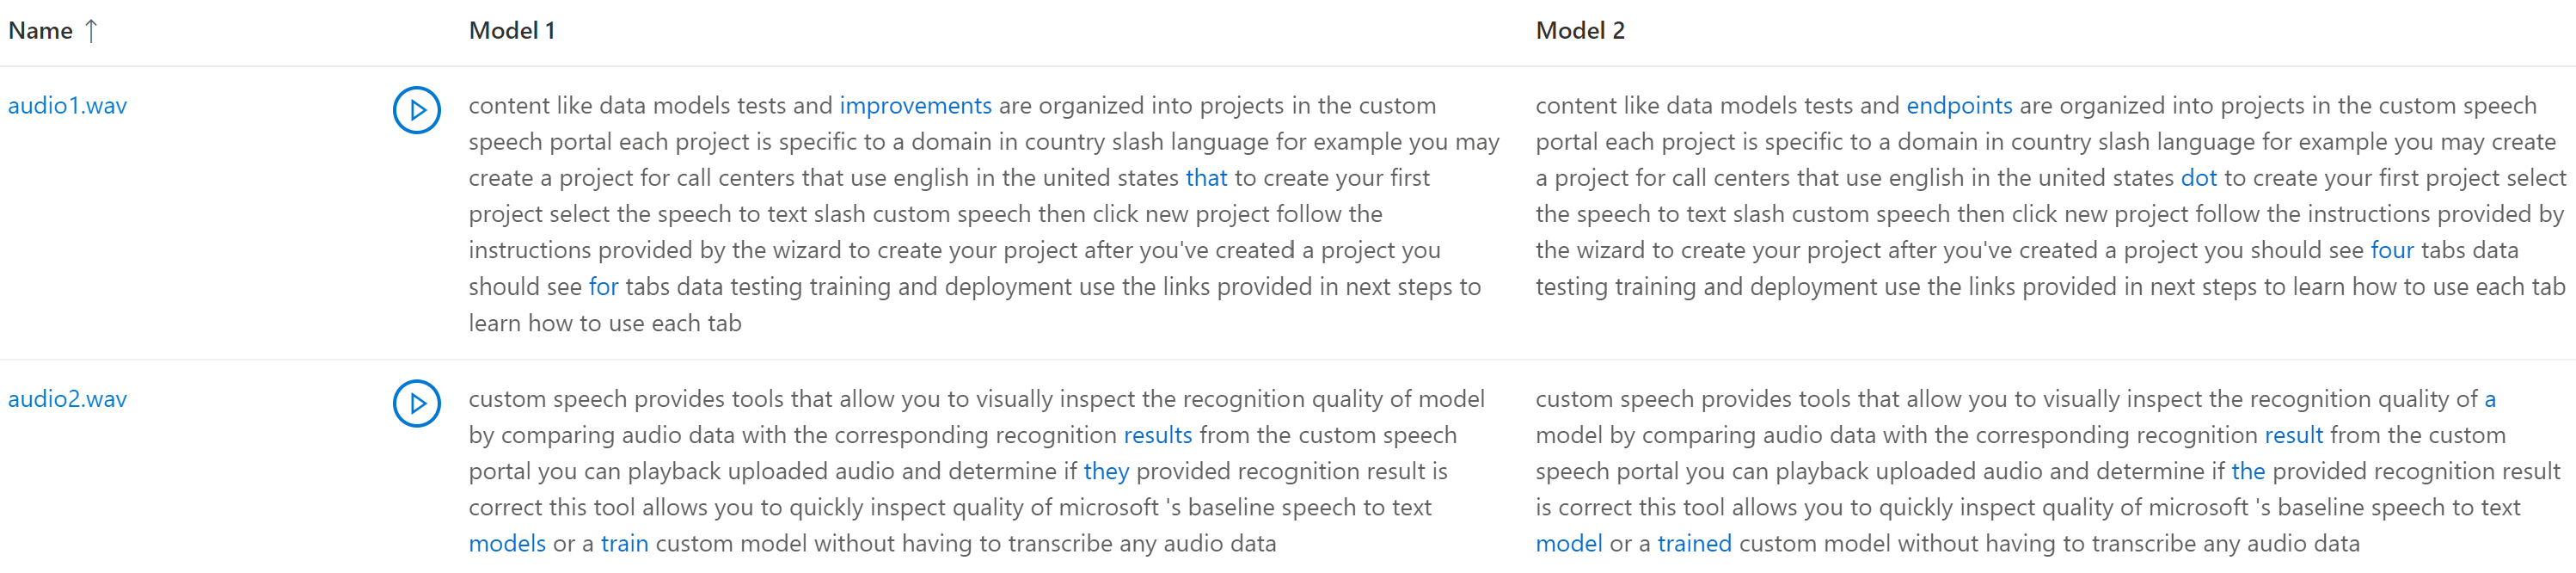
Megvizsgálhatja az egyes tesztelt modellek átírási eredményét a hangbemeneti adatkészlethez viszonyítva. Ha két modellt bevont a tesztbe, egymás mellett hasonlíthatja össze a transzkripciós minőségüket.
Az átiratok minőségének áttekintése:
- Jelentkezzen be a Speech Studio-ba.
- Válassza a(z) Egyéni beszéd> projekt nevét >Tesztmodellek lehetőséget.
- Válassza ki a hivatkozást tesztnév alapján.
- Hangfájl lejátszása a megfelelő átirat modell általi olvasása közben.
Ha a tesztadatkészlet több hangfájlt tartalmazott, akkor több sor jelenik meg a táblában. Ha két modellt vett fel a tesztbe, az átiratok egymás melletti oszlopokban jelennek meg. A modellek közötti átírási különbségek kék szöveg betűtípusban jelennek meg.
A folytatás előtt győződjön meg arról, hogy telepítette és konfigurálta a Speech CLI-t .
A hangtesztelési adatkészlet, az átiratok és a tesztelt modellek a teszteredményekben kerülnek visszaadásra. Ha csak egy modellt teszteltek, a model1 érték megegyezik a model2 értékkel, és a transcription1 érték megegyezik a transcription2 értékkel.
Az átiratok minőségének áttekintése:
- Töltse le a hangteszt adatkészletet, hacsak nincs másolata.
- Töltse le a kimeneti átiratokat.
- Hangfájl lejátszása a megfelelő átirat modell általi olvasása közben.
Ha két modell minőségét hasonlítja össze, különös figyelmet kell fordítani az egyes modellek átiratai közötti különbségekre.