Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Konten ini berlaku untuk:🟩v4.0 (GA) | Versi sebelumnya:🟦v3.1 (GA)🟥v3.0 (pensiun)🟥v2.1 (pensiun)
Konten ini berlaku untuk:🟥v3.0 (pensiun) | Versi terbaru:🟪v4.0 (GA)🟪v3.1 (GA) | Versi sebelumnya:🟥v2.1 (pensiun)
Konten ini berlaku untuk:🟥v2.1 | Versi terbaru:🟪v4.0 (GA)
Model faktur Kecerdasan Dokumen menggunakan kemampuan Pengenalan Karakter Optik (OCR) yang kuat untuk menganalisis dan mengekstrak bidang kunci dan item baris dari faktur penjualan, tagihan utilitas, dan pesanan pembelian. Faktur dapat memiliki berbagai format dan kualitas termasuk gambar yang diambil telepon, dokumen yang dipindai, dan PDF digital. API menganalisis teks faktur; mengekstrak informasi utama seperti nama pelanggan, alamat penagihan, tanggal jatuh tempo, dan jumlah jatuh tempo; dan mengembalikan representasi data JSON terstruktur. Model saat ini mendukung faktur dalam 27 bahasa.
Jenis dokumen yang didukung:
- Faktur
- Tagihan utilitas
- Pesanan penjualan
- Pesanan pembelian
Pemrosesan faktur otomatis
Pemrosesan faktur otomatis adalah proses mengekstrak bidang kunci accounts payable dari dokumen akun penagihan. Data yang diekstrak mencakup item dari faktur yang terintegrasi dengan alur kerja akun utang (AP) Anda untuk tinjauan dan pembayaran. Berdasarkan sejarah, proses hutang piutang dilakukan secara manual dan, karenanya, sangat memakan waktu. Ekstraksi data kunci yang akurat dari faktur biasanya merupakan langkah pertama dan salah satu langkah paling penting dalam proses otomatisasi faktur.
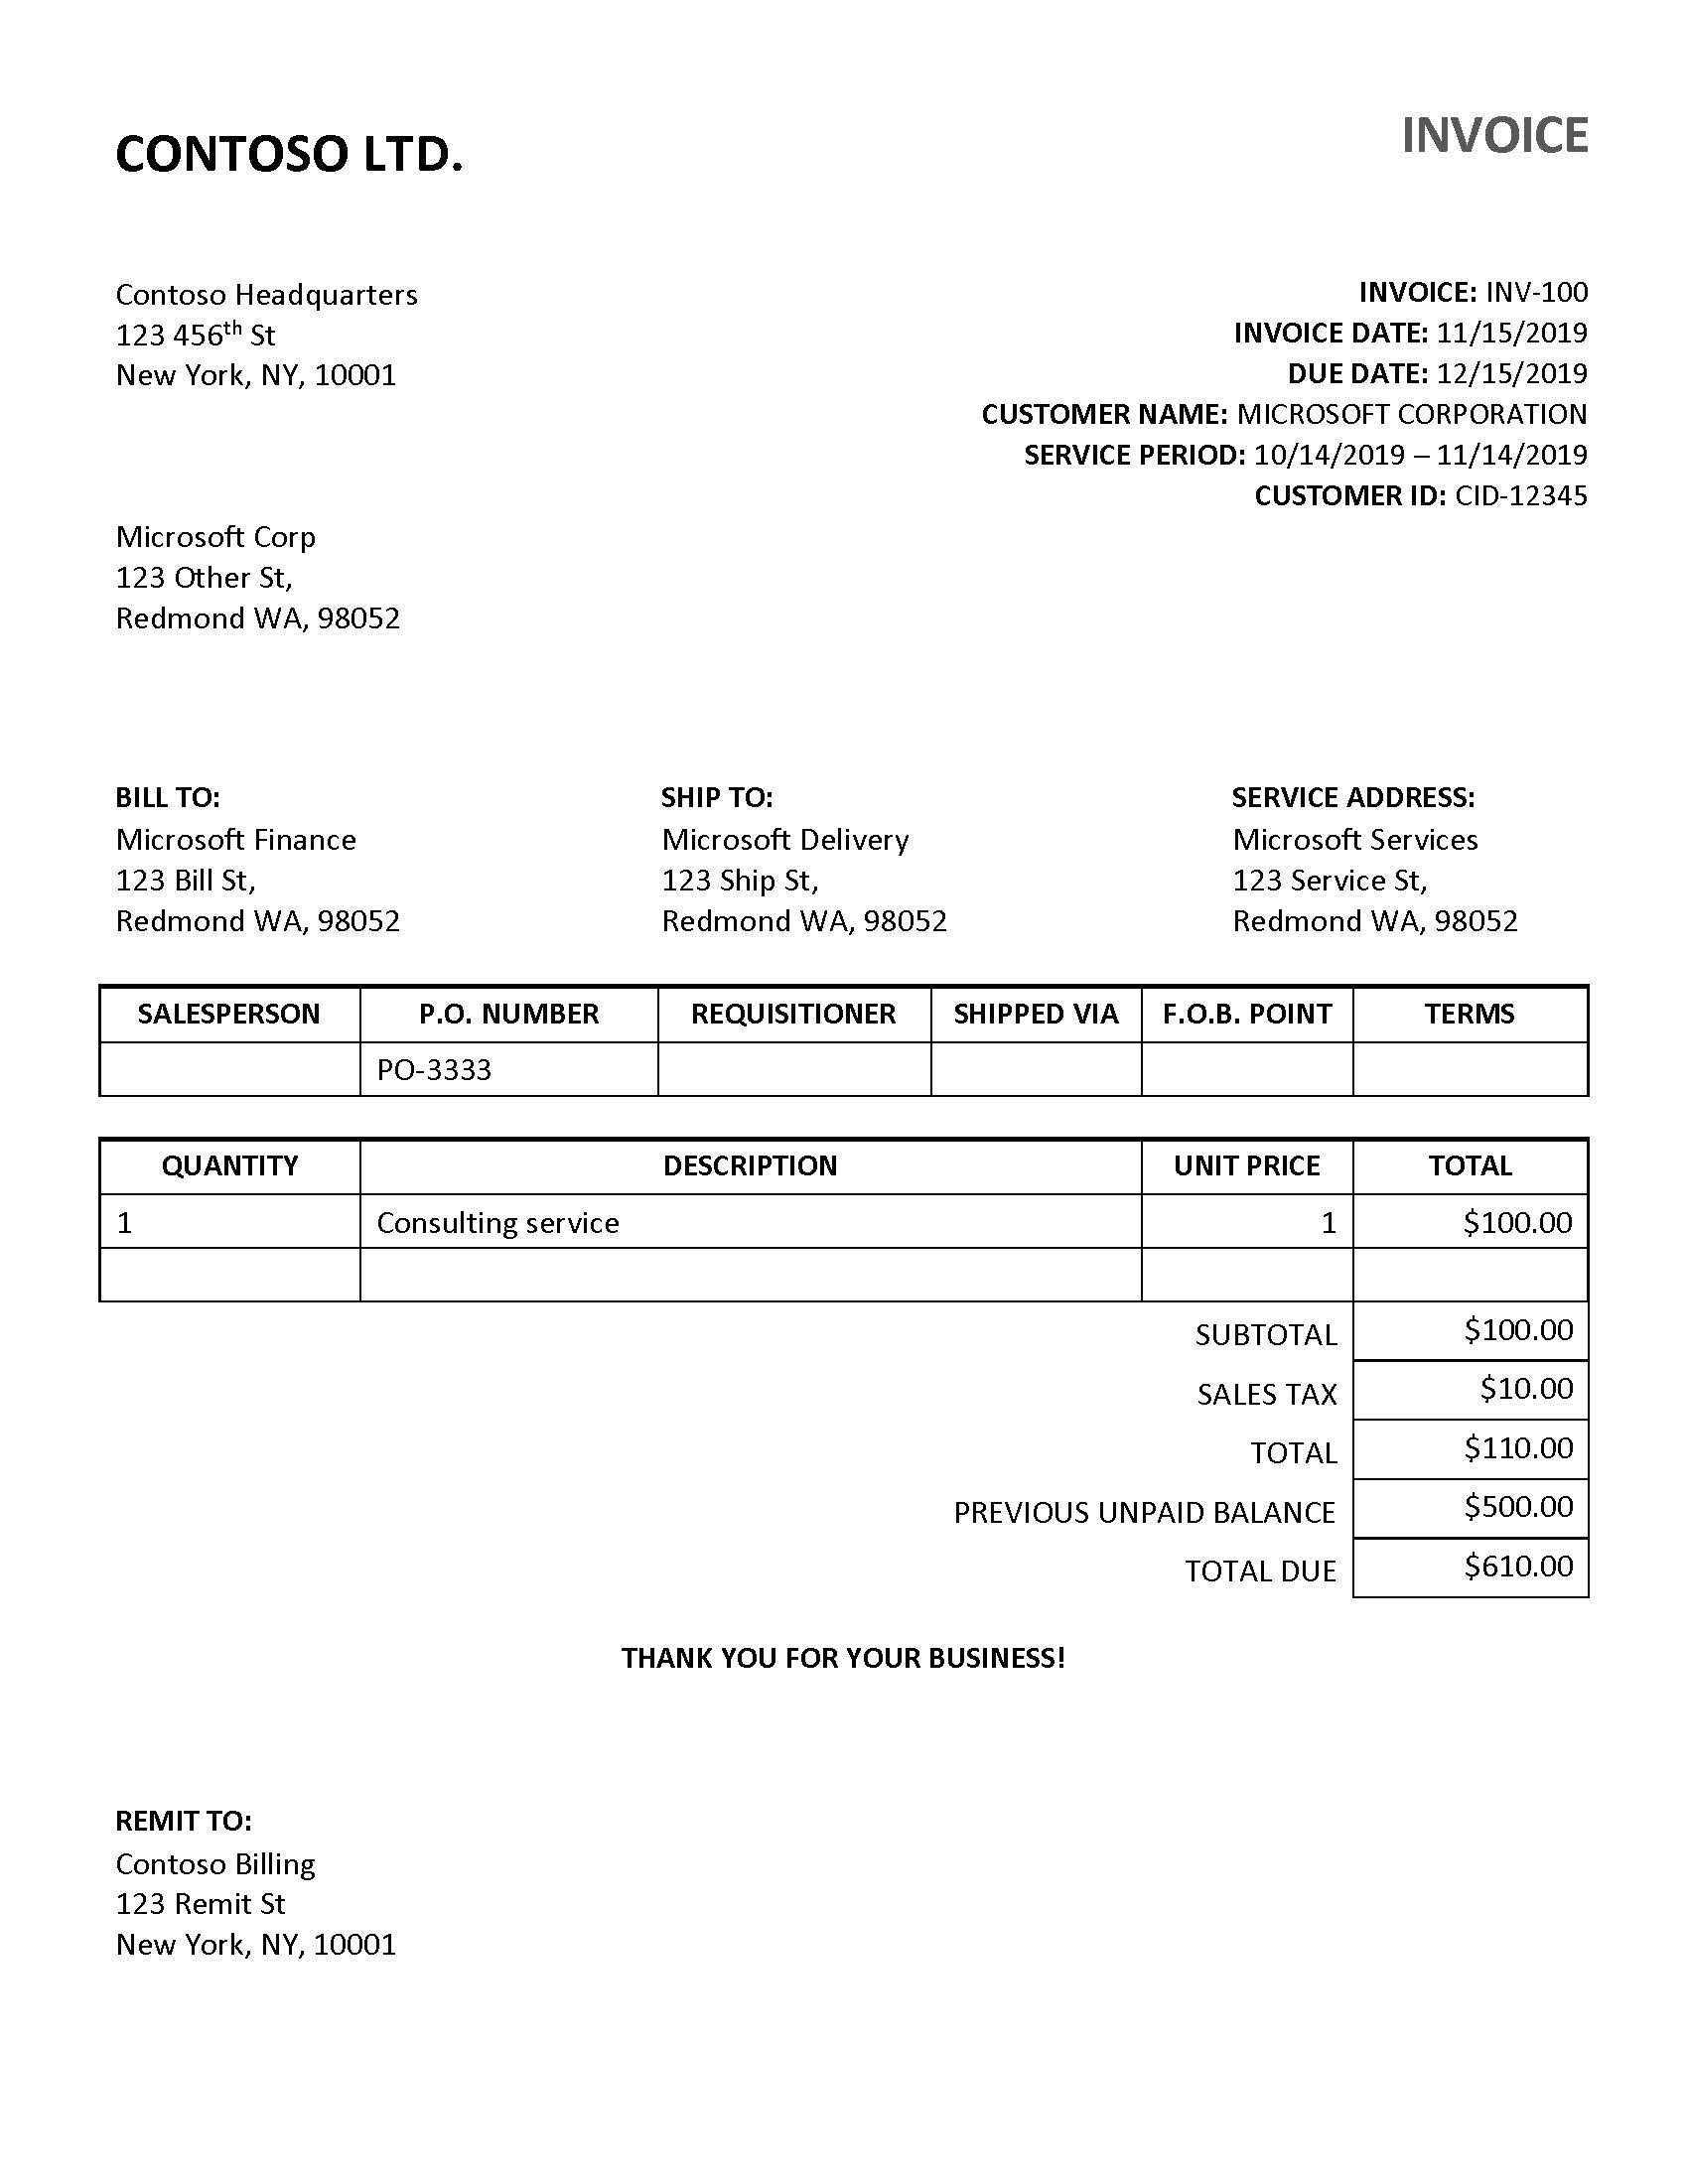
Contoh faktur yang diproses dengan Document Intelligence Studio:

Contoh faktur yang diproses dengan alat Pelabelan Sampel Kecerdasan Dokumen:

Opsi pengembangan
Kecerdasan Dokumen v4.0: 2024-11-30 (GA) mendukung alat, aplikasi, dan pustaka berikut:
| Fitur | Sumber daya | Identifikasi Model |
|---|---|---|
| Model faktur | • Document Intelligence Studio • REST API • C# SDK • Python SDK • Java SDK • JavaScript SDK |
faktur bawaan |
Kecerdasan Dokumen v3.1 mendukung alat, aplikasi, dan pustaka berikut:
| Fitur | Sumber daya | Identifikasi Model |
|---|---|---|
| Model faktur | • Document Intelligence Studio • REST API • C# SDK • Python SDK • Java SDK • JavaScript SDK |
faktur bawaan |
Kecerdasan Dokumen v3.0 mendukung alat, aplikasi, dan pustaka berikut:
| Fitur | Sumber daya | Identifikasi Model |
|---|---|---|
| Model faktur | • Document Intelligence Studio • REST API • C# SDK • Python SDK • Java SDK • JavaScript SDK |
faktur bawaan |
Kecerdasan Dokumen v2.1 mendukung alat, aplikasi, dan pustaka berikut:
| Fitur | Sumber daya |
|---|---|
| Model faktur | • Alat pelabelan Kecerdasan Dokumen • REST API • SDK pustaka klien • Kontainer Docker Kecerdasan Dokumen |
Persyaratan input
Format file berikut didukung.
| Model | Gambar: JPEG/JPG, PNG, BMP, TIFF, HEIF |
Office: Word (DOCX), Excel (XLSX), PowerPoint (PPTX), HTML |
|
|---|---|---|---|
| Baca | ✔ | ✔ | ✔ |
| Tata letak | ✔ | ✔ | ✔ |
| Dokumen umum | ✔ | ✔ | |
| Prabangun | ✔ | ✔ | |
| Ekstraksi kustom | ✔ | ✔ | |
| Klasifikasi kustom | ✔ | ✔ | ✔ |
- Foto dan pemindaian: Untuk hasil terbaik, berikan satu foto yang jelas atau pemindaian berkualitas tinggi per dokumen.
- PDF dan TIFF: Untuk PDF dan TIFF, hingga 2.000 halaman dapat diproses. (Dengan langganan tingkat gratis, hanya dua halaman pertama yang diproses.)
- Ukuran file: Ukuran file untuk menganalisis dokumen adalah 500 MB untuk tingkat berbayar (S0) dan 4 MB untuk tingkat gratis (F0).
- Dimensi gambar: Dimensi harus antara 50 piksel x 50 piksel dan 10.000 piksel x 10.000 piksel.
- Kunci sandi: Jika PDF Anda dikunci dengan sandi, Anda harus membukanya dulu sebelum pengiriman.
- Tinggi teks: Tinggi minimum teks yang akan diekstrak adalah 12 piksel untuk gambar 1024 x 768 piksel. Dimensi ini sesuai dengan teks berukuran sekitar 8 poin pada 150 titik per inci.
- Pelatihan model kustom: Jumlah maksimum halaman untuk data pelatihan adalah 500 untuk model templat kustom dan 50.000 untuk model neural kustom.
- Pelatihan model ekstraksi kustom: Ukuran total data pelatihan adalah 50 MB untuk model templat dan 1 GB untuk model neural.
- Pelatihan model klasifikasi kustom: Ukuran total data pelatihan adalah 1 GB dengan maksimum 10.000 halaman. Untuk 2024-11-30 (GA), ukuran total data pelatihan adalah 2 GB dengan maksimum 10.000 halaman.
- Jenis file Office (DOCX, XLSX, PPTX): Batas panjang string maksimum adalah 8 juta karakter.
- Format file yang didukung: JPEG, PNG, PDF, dan TIFF.
- PDF dan TIFF yang didukung, hingga 2.000 halaman diproses. Untuk pelanggan tingkat gratis, hanya dua halaman pertama yang diproses.
- Ukuran file yang didukung harus kurang dari 50 MB dan dimensi minimal 50 x 50 piksel dan paling banyak 10.000 x 10.000 piksel.
Ekstraksi data model faktur
Lihat bagaimana data, termasuk informasi pelanggan, detail vendor, dan item baris, diekstrak dari faktur. Anda memerlukan sumber daya berikut:
Langganan Azure—Anda dapat buat langganan secara gratis.
Instans Document Intelligence di portal Azure. Anda dapat menggunakan tingkat harga gratis (
F0) untuk mencoba layanan. Setelah sumber daya Anda disebarkan, pilih Akses sumber daya untuk mendapatkan kunci dan titik akhir Anda.

Pada beranda Studio Kecerdasan Dokumen, pilih Faktur.
Anda dapat menganalisis faktur sampel atau mengunggah file Anda sendiri.
Pilih tombol Jalankan analisis dan, jika perlu, konfigurasikan opsi Analisis :

Alat Pelabelan Sampel untuk Kecerdasan Dokumen
Navigasikan ke Alat Sampel Kecerdasan Dokumen.
Pada beranda alat sampel, pilih gunakan model bawaan untuk mendapatkan petak data.

Pilih Jenis Formulir untuk dianalisis dari menu dropdown.
Pilih URL untuk file yang ingin Anda analisis dari opsi di bawah ini:
Di bidang Sumber , pilih URL dari menu dropdown, tempelkan URL yang dipilih, dan pilih tombol Ambil .

Di bidang titik akhir layanan Kecerdasan Dokumen, tempelkan titik akhir yang Anda peroleh dengan langganan Kecerdasan Dokumen Anda.
Di bidang kunci , tempelkan kunci yang Anda peroleh dari sumber daya Kecerdasan Dokumen Anda.

Pilih Jalankan analisis. Alat Pelabelan Sampel Kecerdasan Dokumen memanggil API Analisis Bawaan dan menganalisis dokumen.
Lihat hasilnya - lihat pasangan kunci-nilai yang diekstrak, item baris, teks yang disorot diekstrak, dan tabel terdeteksi.

Catatan
Alat Pelabelan Sampel tidak mendukung format file BMP. Ini adalah batasan alat, bukan Document Intelligence Service.
Bahasa dan lokal yang didukung
Untuk daftar lengkap bahasa yang didukung, lihat halaman dukungan bahasa model bawaan kami.
Ekstraksi bidang
Untuk bidang ekstraksi dokumen yang didukung, lihat halaman skema model faktur di repositori sampel GitHub kami.
Pasangan kunci-nilai dan item baris faktur yang diekstrak terdapat di bagian
documentResultsdari output JSON.
Pasangan kunci-nilai
Model faktur bawaan mendukung pengembalian opsional pasangan kunci-nilai. Secara default, pengembalian pasangan kunci-nilai dinonaktifkan. Pasangan kunci-nilai adalah rentang khusus dalam faktur yang mengidentifikasi label atau kunci dan respons atau nilai terkait. Dalam faktur, pasangan ini bisa berupa label dan nilai yang diinput pengguna untuk bidang tertentu, misalnya nomor telepon. Model AI dilatih untuk mengekstrak kunci dan nilai yang dapat diidentifikasi berdasarkan berbagai jenis, format, dan struktur dokumen.
Kunci juga dapat ada dalam isolasi ketika model mendeteksi bahwa kunci ada, tanpa nilai terkait atau saat memproses bidang opsional. Misalnya, kolom nama tengah dapat dibiarkan kosong di formulir dalam beberapa kasus. Pasangan kunci-nilai selalu merupakan teks yang terdapat dalam dokumen. Untuk dokumen di mana nilai yang sama dijelaskan dengan cara yang berbeda, misalnya, pelanggan/pengguna, kunci terkait adalah pelanggan atau pengguna (berdasarkan konteks).
Output JSON
Output JSON memiliki tiga bagian:
-
"readResults"node berisi semua teks yang dikenali dan tanda pilihan. Teks diatur melalui halaman, lalu menurut baris, lalu dengan kata-kata individual. -
"pageResults"node berisi tabel dan sel yang diekstraksi dengan kotak pembatas, tingkat kepercayaan, dan referensi ke baris serta kata di dalam readResults. - Node
"documentResults"berisi nilai yang spesifik untuk faktur dan item baris yang ditemukan oleh model. Di sinilah Anda dapat menemukan semua bidang dari faktur seperti ID faktur, dikirim ke, ditagih ke, pelanggan, total, item baris, dan masih banyak lagi.
Panduan migrasi
- Ikuti panduan migrasi Kecerdasan Dokumen v3.1 kami untuk mempelajari cara menggunakan versi v3.0 di aplikasi dan alur kerja Anda.
::: akhir-moniker
Langkah berikutnya
Coba pemrosesan formulir dan dokumen Anda sendiri dengan Studio Kecerdasan Dokumen.
Selesaikan Panduan Mulai Cepat Kecerdasan Dokumen dan mulai membuat aplikasi pemrosesan dokumen dalam bahasa pemrograman pilihan Anda.
Cobalah memproses formulir dan dokumen Anda sendiri dengan Alat Pelabelan Sampel Kecerdasan Dokumen.
Selesaikan Panduan Mulai Cepat Kecerdasan Dokumen dan mulai membuat aplikasi pemrosesan dokumen dalam bahasa pemrograman pilihan Anda.