Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Spillover mengelola fluktuasi lalu lintas pada deployment yang diprovisikan dengan secara otomatis mengarahkan permintaan yang melebihi kapasitas ke deployment standar yang sesuai. Ketika penyebaran yang disediakan sepenuhnya digunakan dan mengembalikan respons non-200 (seperti 429 ketika PTUs habis), spillover mengalihkan permintaan tersebut ke penyebaran standar, membantu Anda mengurangi gangguan selama ledakan lalu lintas. Kemampuan opsional ini dapat dikonfigurasi untuk semua permintaan dalam sebuah deployment atau dikelola per permintaan.
Prasyarat
- Langganan Azure. Buat satu secara gratis.
- Penyebaran terkelola yang disediakan dan penyebaran standar di sumber daya Foundry yang sama.
- Azure CLI diinstal untuk contoh REST API, atau akses ke portal Foundry.
- Variabel lingkungan
AZURE_OPENAI_ENDPOINTdiatur ke URL titik akhir OpenAI Azure Anda. - Peran Kontributor Cognitive Services atau yang lebih tinggi pada sumber daya Foundry untuk membuat atau memodifikasi penyebaran.
Mengaktifkan spillover untuk semua permintaan pada deployment yang sudah disediakan
Pertama, buat penyebaran throughput yang disediakan. Lihat Menggunakan portal Foundry untuk penyebaran.
Setelah Anda memiliki deployment yang telah diprovisikan, perbarui deployment tersebut untuk mengaktifkan spillover lalu lintas sebagai berikut:
-
Masuk ke Microsoft Foundry. Pastikan tombol New Foundry nonaktif. Langkah-langkah ini mengacu pada Foundry (klasik).
Pilih langganan dan sumber daya Foundry di wilayah tempat Anda menyebarkan model Anda.
Dalam portal Foundry, pada menu navigasi kiri, pilih Model + endpoint>Penyebaran model.
Pilih penyebaran.
Pilih Edit di halaman deployment.
Perbarui deployment untuk mengaktifkan Traffic spillover.
Catatan
Untuk mengaktifkan spillover, akun Anda harus memiliki setidaknya satu penyebaran aktif dengan sistem bayar sesuai penggunaan yang cocok dengan model dan versi penyebaran yang disediakan saat ini.
Kirim perubahan.
Mengaktifkan spillover untuk permintaan inferensi tertentu
Untuk mengaktifkan spillover secara selektif berdasarkan permintaan individual, atur header permintaan inferensi x-ms-spillover-deployment ke target penyebaran standar untuk permintaan spillover. Jika header x-ms-spillover-deployment tidak disetel pada permintaan tertentu, spillover tidak akan dimulai jika terjadi respons non-200. Penggunaan atau penghilangan header ini memungkinkan fleksibilitas untuk mengontrol kapan spillover dapat atau dilarang dimulai untuk beban kerja atau skenario tertentu.
curl $AZURE_OPENAI_ENDPOINT/openai/deployments/spillover-ptu-deployment/chat/completions?api-version=2024-10-21 \
  -H "Content-Type: application/json" \
  -H "x-ms-spillover-deployment: spillover-standard-deployment" \
  -H 'Authorization: Bearer YOUR_AUTH_TOKEN' \
  -d '{"messages":[{"role": "system", "content": "You are a helpful assistant."},{"role": "user", "content": "Does Azure OpenAI support customer managed keys?"},{"role": "assistant", "content": "Yes, customer managed keys are supported by Azure OpenAI."},{"role": "user", "content": "Do other Azure services support this too?"}]}'
Permintaan yang berhasil memberikan status HTTP 200 beserta respons penyelesaian obrolan. Jika terjadi transmisi berlebih, respons menyertakan header x-ms-spillover-from-deployment.
Referensi:Membuat penyelesaian obrolan
Catatan
Jika kemampuan spillover diaktifkan untuk penyebaran menggunakan spilloverDeploymentName properti dan juga diaktifkan pada tingkat permintaan melalui header x-ms-spillover-deployment, sistem secara default akan mengikuti pengaturan properti penyebaran. Jika Anda ingin memastikan bahwa spillover hanya diaktifkan untuk setiap permintaan, jangan tetapkan properti spilloverDeploymentName pada deployment yang diprovisikan dan hanya andalkan header x-ms-spillover-deployment untuk setiap permintaan.
Mengidentifikasi permintaan berlebih
Header respons HTTP berikut menunjukkan bahwa permintaan tertentu melampaui batas:
-
x-ms-spillover-from-deployment: Berisi nama penyebaran PTU. Kehadiran header ini menunjukkan bahwa permintaan adalah permintaan spillover. -
x-ms-deployment-name: Berisi nama deployment yang menangani permintaan. Jika permintaan meluap, nama penyebaran adalah nama penyebaran standar. -
x-ms-spillover-errordikembalikan untuk setiap permintaan yang mengalami spillover, dan berisi kode respons dari deployment yang diprovisikan yang memicu spillover tersebut (misalnya 429, 500, atau 503). Hal ini tetap terjadi, terlepas dari apakah upaya spillover pada akhirnya berhasil atau tidak.
Untuk permintaan yang meluap, jika penyebaran standar juga gagal melayaninya, respons penyebaran standar (termasuk kode status dan isi) dikembalikan ke pemanggil. Header x-ms-spillover-from-deployment dan x-ms-spillover-error masih ada, sehingga pemanggil dapat membedakan kegagalan spillover dari kegagalan penyebaran standar langsung.
Memantau penggunaan kelebihan alokasi
Spillover bergantung pada kombinasi penyebaran yang disediakan dan standar untuk mengelola kelebihan lalu lintas, sehingga pemantauan dapat dilakukan pada tingkat penyebaran untuk setiap penyebaran. Untuk melihat berapa banyak permintaan yang diproses pada penyebaran utama yang disediakan versus penyebaran standar spillover, terapkan fitur pemisahan dalam metrik Azure Monitor untuk melihat permintaan yang diproses oleh setiap penyebaran dan kode status masing-masing. Demikian pula, gunakan fitur pemisahan untuk melihat berapa banyak token yang diproses pada penyebaran utama yang disediakan versus penyebaran standar spillover untuk periode waktu tertentu.
Bagan metrik Azure Monitor berikut memberikan contoh pemisahan permintaan antara penyebaran utama yang disediakan dan penyebaran standar spillover saat spillover dimulai. Untuk membuat bagan, navigasikan ke sumber daya Anda di portal Azure.
PilihMetrik> dari menu navigasi kiri.
Tambahkan metrik
Azure OpenAI Requests.Tangkapan layar menampilkan metrik untuk contoh spillover dasar di portal Azure.
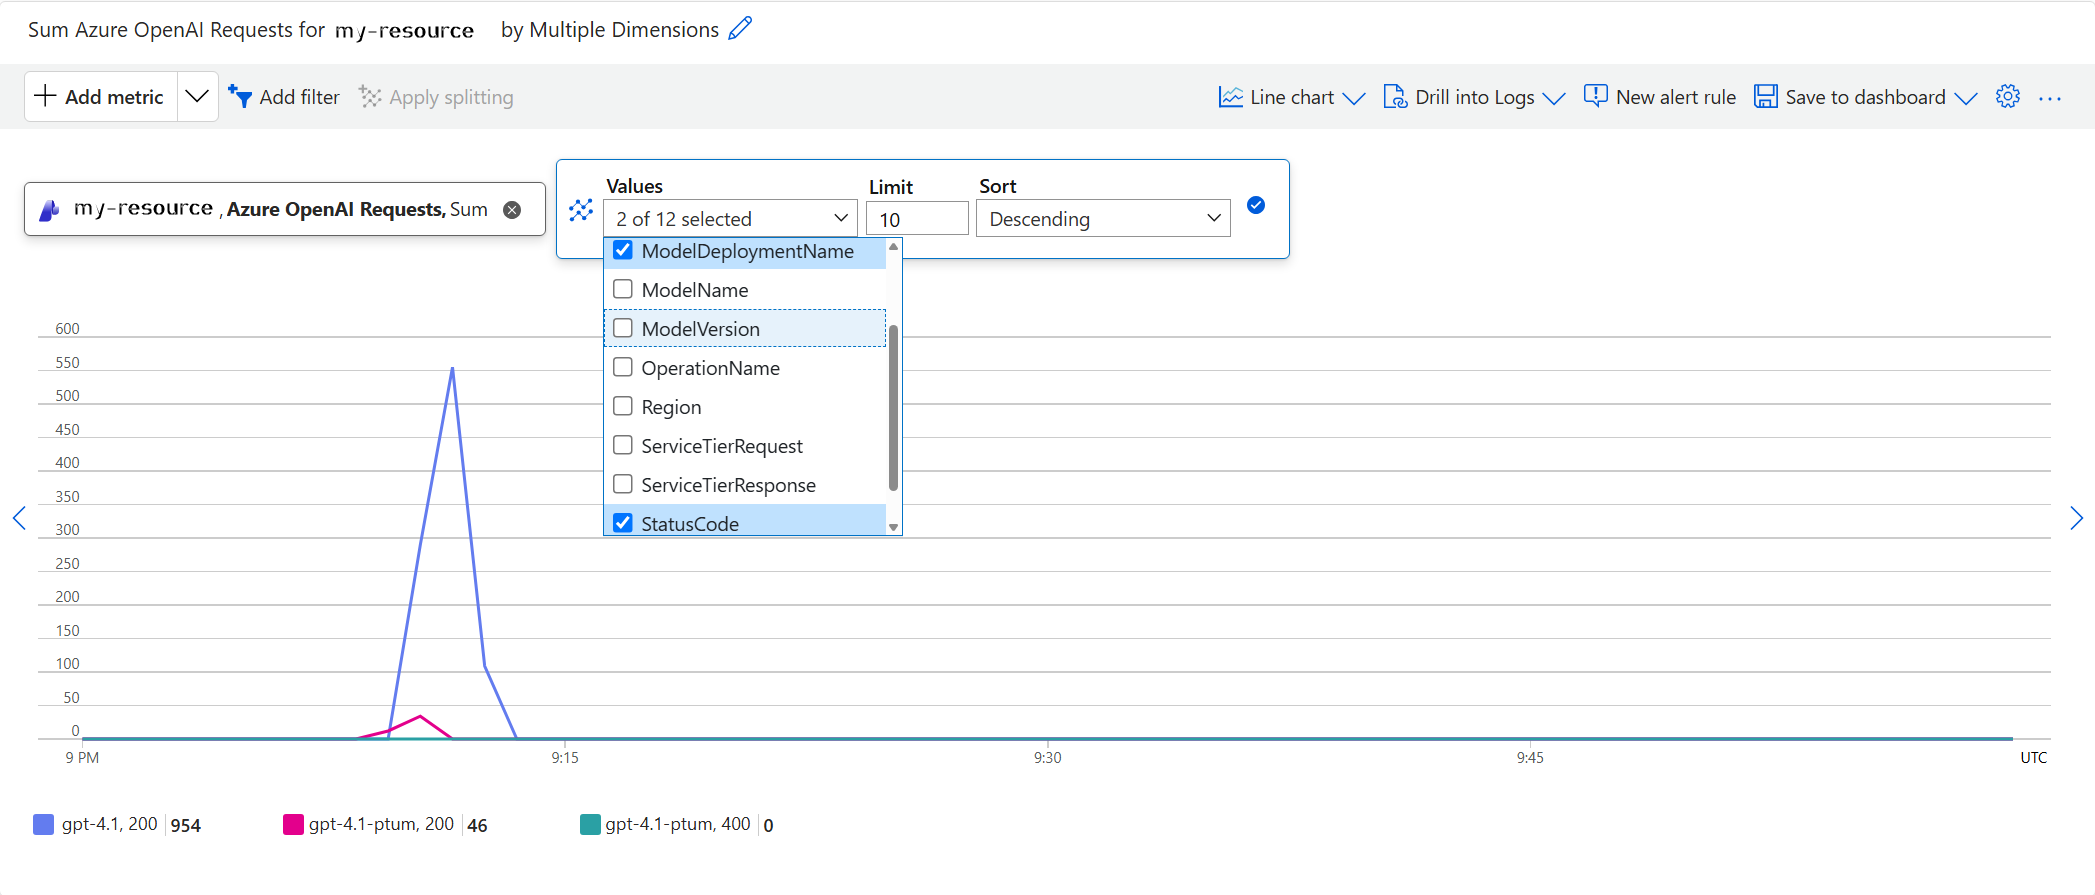
Pilih Terapkan pemisahan dan terapkan pemisahan
ModelDeploymentNamedanStatusCodeke metrikAzure OpenAI Requests. Ini memperlihatkan bagan dengan200(berhasil) dan400(kode kesalahan) yang dihasilkan untuk sumber daya Anda. Jumlah untuk kode kesalahan saat ini nol dalam bagan.cuplikan layar
Pilih Tambahkan filter. Dalam kotak filter, atur Properti ke
ModelDeploymentNamedan atur Nilai ke penyebaran model yang ingin Anda lihat.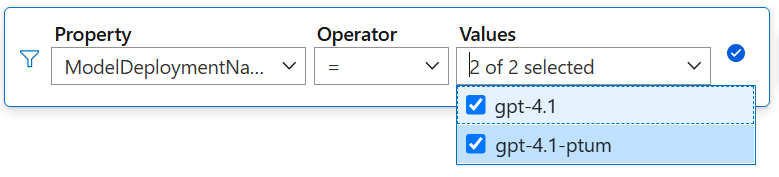
Setiap permintaan yang tidak dapat dilayani oleh deployment yang diprovisikan (mengembalikan
429,500, atau503) akan segera dialihkan ke deployment bayar sesuai pemakaian yang digunakan untuk menangani spillover, tempat permintaan tersebut diproses dan dihitung sebagai respons200(gpt-4.1, 200 = 954). Baris penyebaran yang disediakan (gpt-4.1-ptum, 200 = 46) hanya mencerminkan permintaan yang dilayani secara langsung, karena permintaan yang ditumpahkan tidak dihitung sebagai429pada penyebaran yang disediakan. Untuk membedakan trafik spillover dari trafik langsung pada deployment standar, terapkan pemisahanIsSpillover, seperti yang ditunjukkan di bagian berikutnya.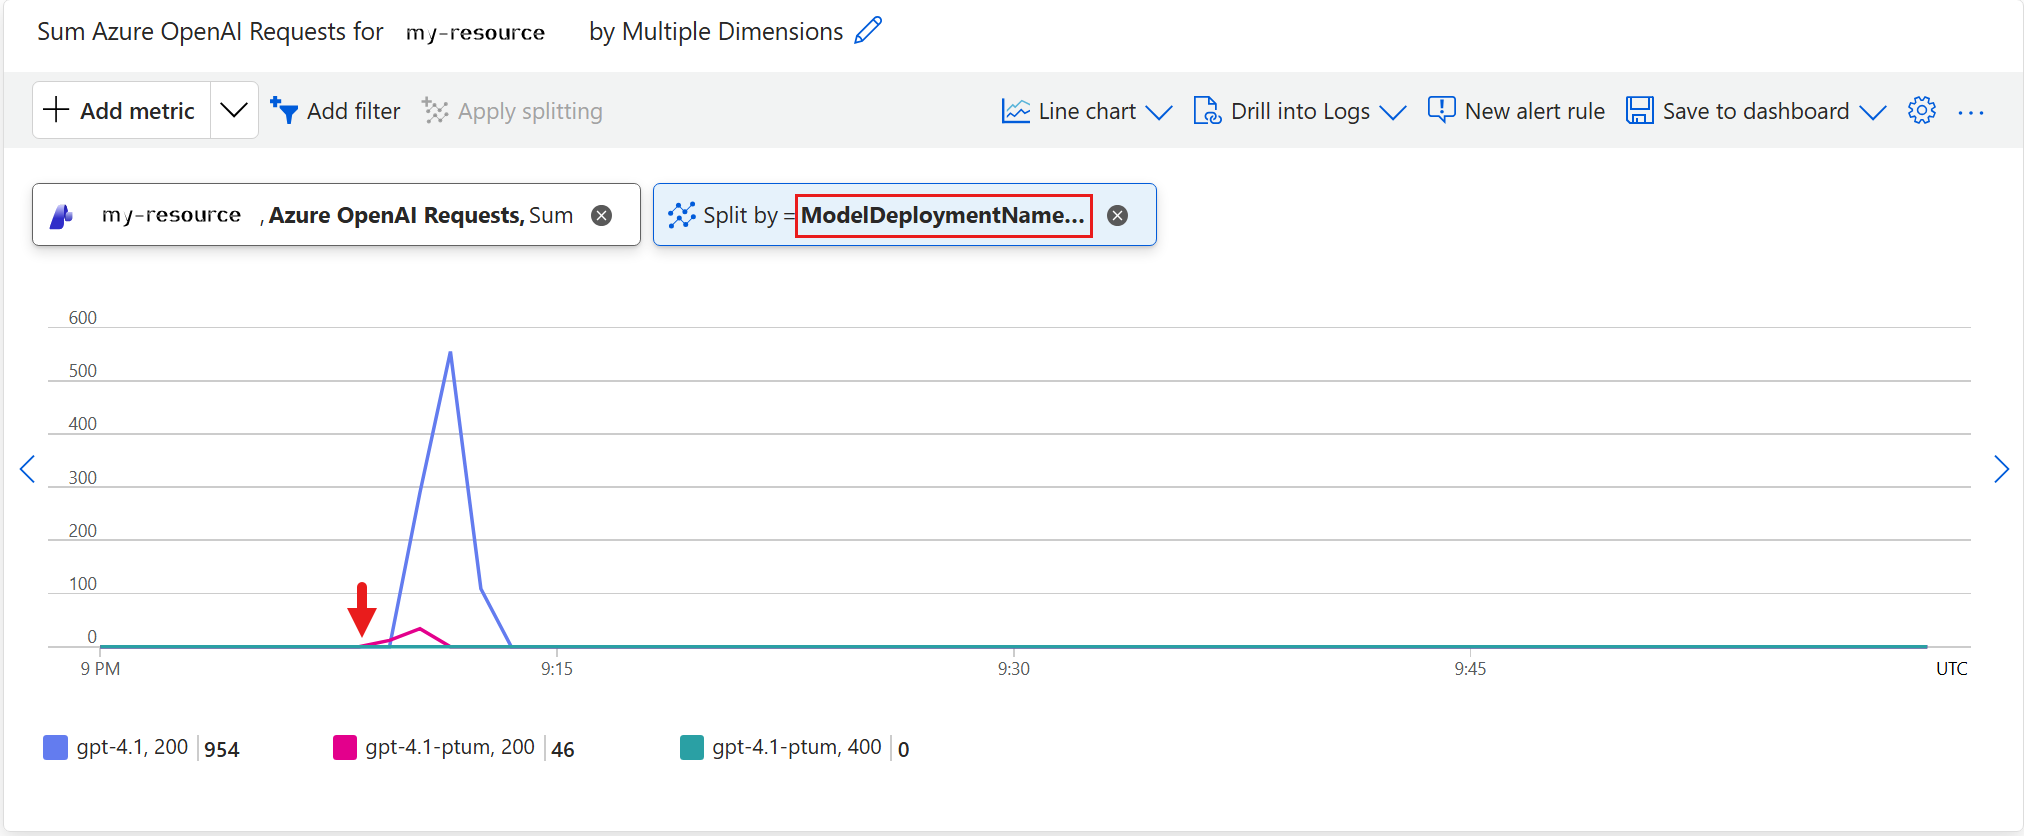
Lihat metrik spillover
Menerapkan pemisahan IsSpillover memungkinkan Anda melihat permintaan mana pada penyebaran standar Anda yang tiba melalui spillover dari penyebaran yang disediakan. Permintaan yang dialihkan muncul sebagai catatan pada deployment standar dengan IsSpillover = True dan kode status finalnya (biasanya 200). Mereka tidak dihitung ganda sebagai 429pada penyebaran yang disediakan.
Dalam grafik berikut, permintaan yang dialihkan muncul sebagai IsSpillover=True, gpt-4.1, 200 = 954 hanya pada deployment standar. Deployment yang telah diprovisikan tidak memiliki rekaman IsSpillover=True.
Tangkapan layar yang memperlihatkan pembagian spillover di portal Azure.
Kapan mengaktifkan spillover
Untuk memaksimalkan penggunaan penyebaran yang disediakan, aktifkan spillover untuk semua penyebaran global dan zona data yang disediakan. Berkat spillover, ledakan atau fluktuasi lalu lintas dapat dikelola dengan otomatis oleh layanan. Kemampuan ini mengurangi risiko mengalami gangguan ketika penyebaran yang disediakan digunakan sepenuhnya. Atau, spillover dapat dikonfigurasi per permintaan untuk memberikan fleksibilitas di berbagai skenario dan beban kerja. Spillover juga berfungsi dengan Foundry Agent Service.
Ketika penyebaran mulai berlaku
Saat Anda mengaktifkan spillover untuk penyebaran atau mengonfigurasinya untuk permintaan inferensi tertentu, spillover dimulai ketika kode respons non-200 tertentu diterima sebagai akibat dari salah satu skenario ini:
Unit throughput yang sudah dialokasikan (PTU) telah digunakan sepenuhnya, yang menghasilkan
429kode respons.Anda mengirim permintaan token konteks panjang, yang menghasilkan
400kode kesalahan. Misalnya, saat Anda menggunakangpt 4.1model seri, PTU hanya mendukung panjang konteks kurang dari 128K dan mengembalikan HTTP 400.Kesalahan server terjadi saat memproses permintaan Anda, yang menghasilkan kode
500kesalahan atau503.
Ketika permintaan menghasilkan salah satu kode respons non-200 ini, Azure OpenAI secara otomatis mengirim permintaan dari penyebaran yang disediakan ke penyebaran standar Anda untuk diproses.
Catatan
Bahkan jika subset permintaan dirutekan ke penyebaran standar, layanan memprioritaskan pengiriman permintaan ke penyebaran yang telah disediakan sebelum mengirimkan permintaan yang berlebih ke penyebaran standar. Prioritas ini mungkin menimbulkan latensi tambahan.
Biaya tumpahan
Karena spillover menggunakan kombinasi penyebaran terprovisi dan standar untuk mengelola fluktuasi lalu lintas, penagihan untuk spillover melibatkan dua komponen:
Untuk permintaan apa pun yang diproses oleh penyebaran yang Anda sediakan, hanya biaya penyebaran yang disediakan per jam yang berlaku. Tidak ada biaya tambahan yang dikeluarkan untuk permintaan ini.
Untuk setiap permintaan yang dirutekan ke penyebaran standar Anda, permintaan tersebut dikenakan biaya berdasarkan tarif token input, token yang disimpan dalam cache, dan token output sesuai dengan versi model dan tipe penyebaran yang telah ditentukan.