Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Aktivitas Azure HDInsight di Fabric Data Factory memungkinkan Anda mengorkestrasi tipe pekerjaan Azure HDInsight berikut:
- Menjalankan kueri Apache Hive
- Memanggil program MapReduce
- Menjalankan kueri Pig
- Menjalankan program Spark
- Menjalankan program Hadoop Stream
Artikel ini menyediakan panduan langkah demi langkah yang menjelaskan cara membuat aktivitas Azure HDInsight menggunakan antarmuka Data Factory.
Prasyarat
Untuk memulai, Anda harus menyelesaikan prasyarat berikut:
- Anda harus memiliki akses ke tenan Microsoft Fabric dengan kapasitas yang disediakan. Anda dapat mencoba Fabric dengan uji coba gratis.
- Ruang kerja Fabric yang ditetapkan ke kapasitas tersebut.
Tambahkan aktivitas Azure HDInsight (HDI) ke alur menggunakan UI.
Buat alur baru di ruang kerja Anda.
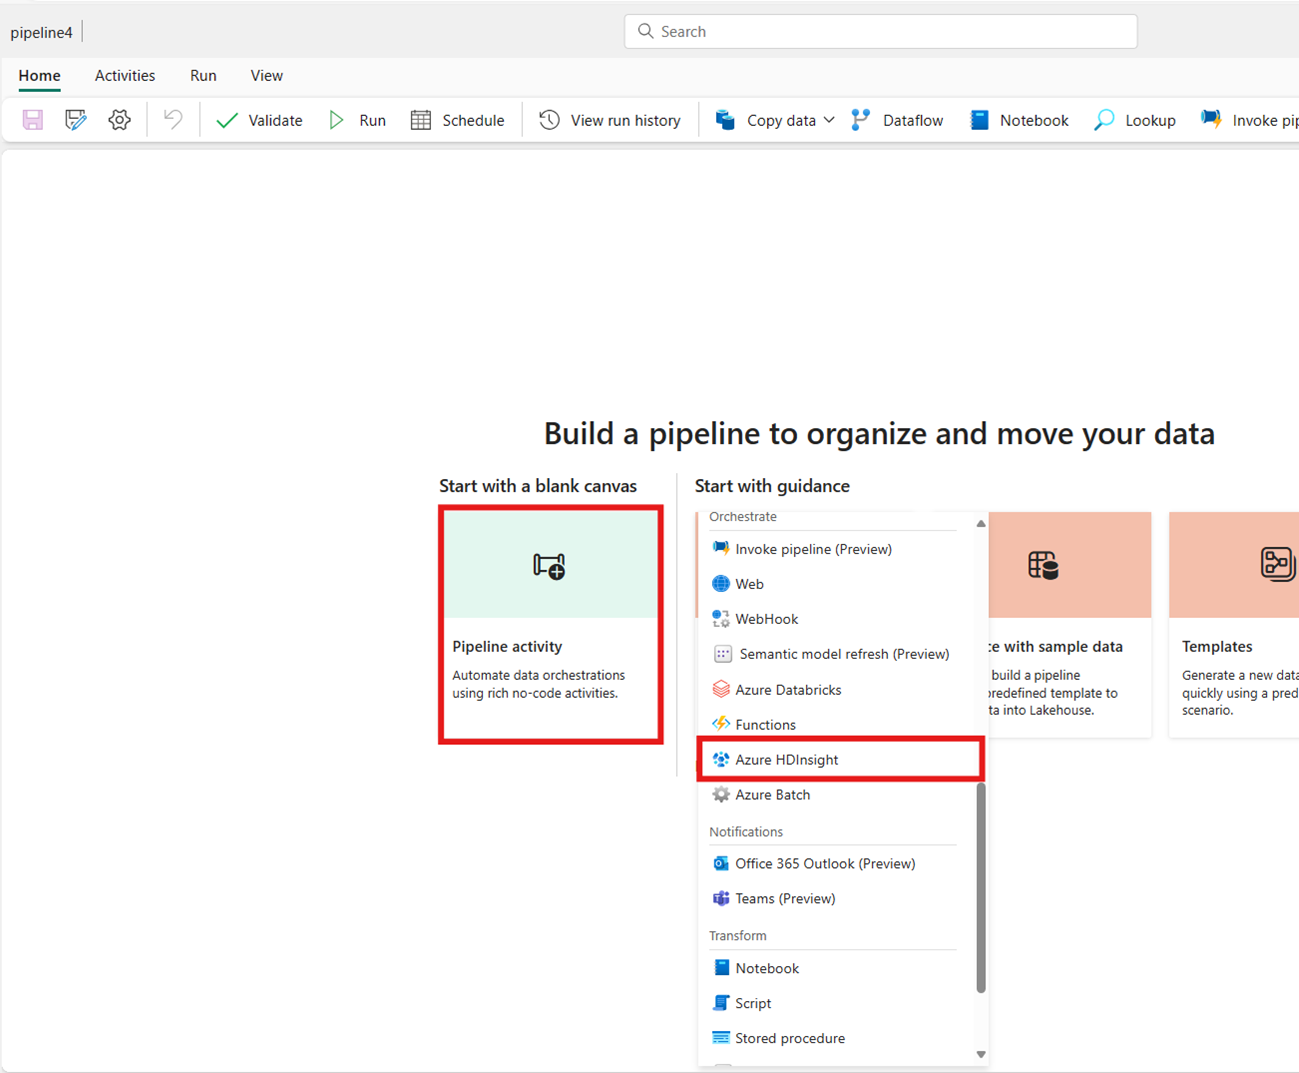
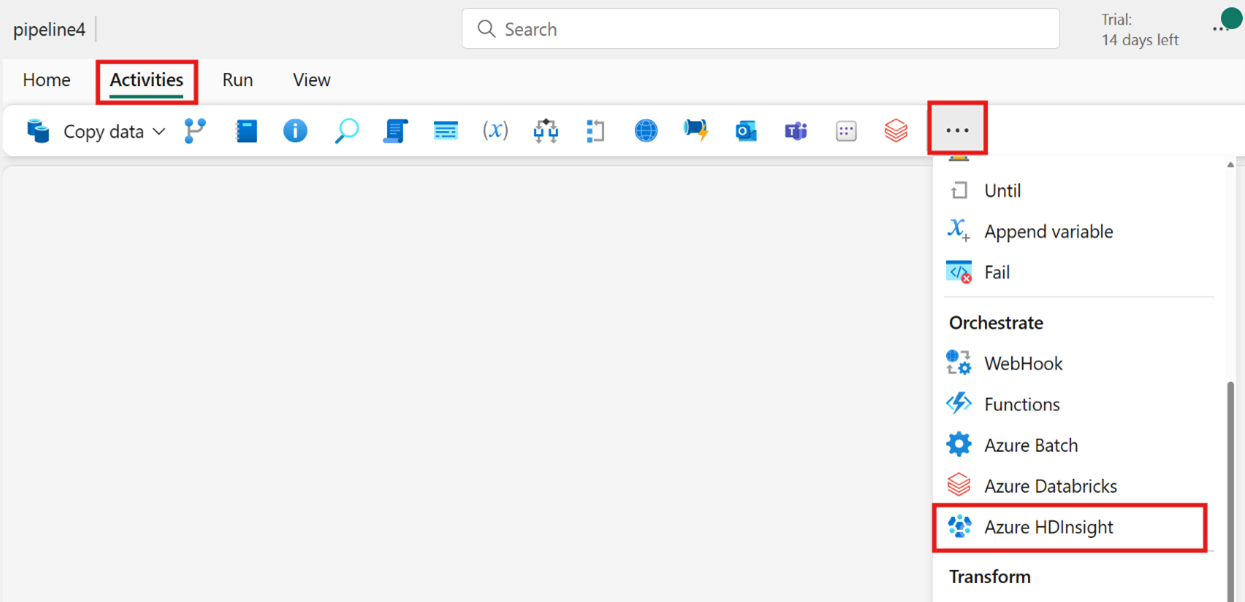
Pilih kartu Aktivitas Pipeline, atau pilih tab Aktivitas, dan pilih Azure HDInsight.
Membuat aktivitas dari kartu layar beranda:
Membuat aktivitas dari bilah Aktivitas:
Pastikan aktivitas Azure HDInsight baru sudah dipilih di kanvas editor alur kerja. Jika belum, silakan pilih.

Lihat panduan Pengaturan umum untuk mengonfigurasi opsi yang ditemukan di tab Pengaturan umum.
Mengonfigurasi kluster HDI
Pilih tab Kluster HDI. Kemudian Anda dapat memilih koneksi HDInsight yang sudah ada, atau membuat koneksi baru.
Untuk Koneksi sumber daya, pilih Azure Blob Storage yang mereferensikan kluster Azure HDInsight Anda. Anda dapat memilih penyimpanan Blob yang sudah ada atau membuat yang baru.
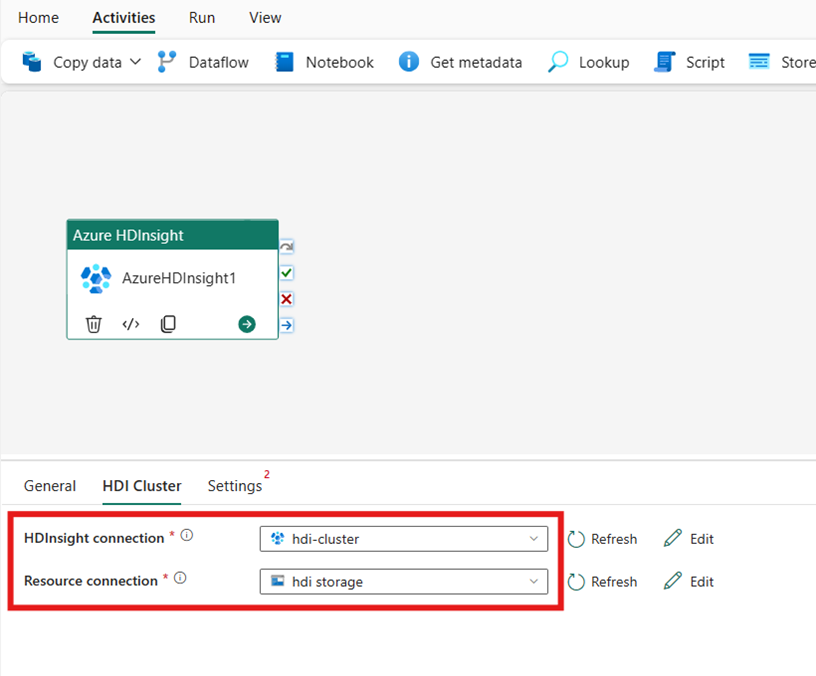
Konfigurasikan pengaturan
Pilih tab Pengaturan untuk melihat pengaturan tingkat lanjut untuk aktivitas tersebut.
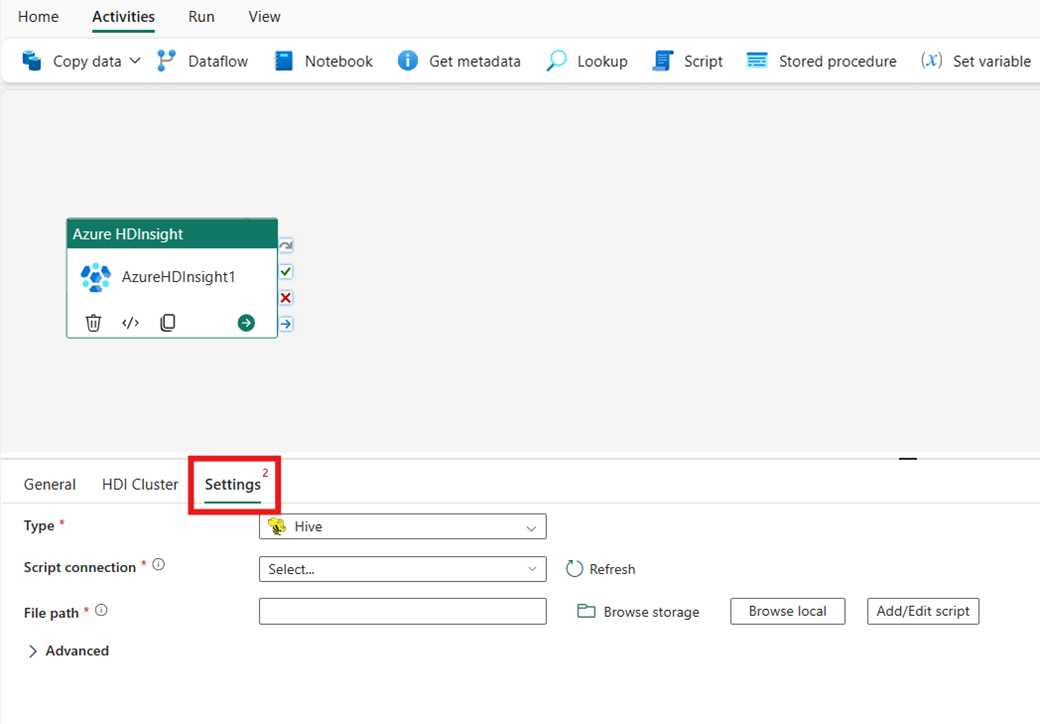
Semua properti klaster lanjutan dan ekspresi dinamis yang didukung dalam layanan terkait Azure Data Factory dan Synapse Analytics HDInsight kini juga didukung dalam aktivitas Azure HDInsight untuk Data Factory, di bawah bagian Lanjutan di UI. Semua properti ini mendukung ekspresi parameter kustom yang mudah digunakan dengan konten dinamis.
Jenis kluster
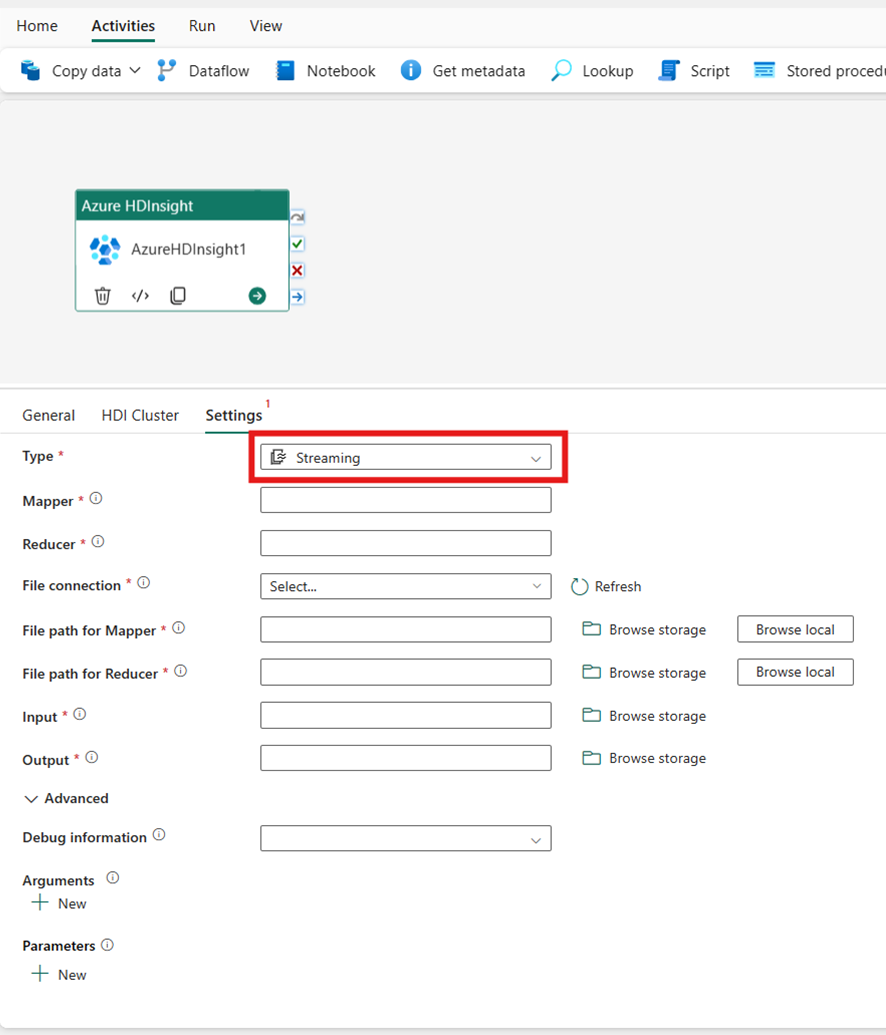
Untuk mengonfigurasi pengaturan untuk kluster HDInsight Anda, pertama-tama pilih Jenisnya dari opsi yang tersedia, termasuk Apache Hive, Map Reduce, Pig, Spark, dan Streaming.
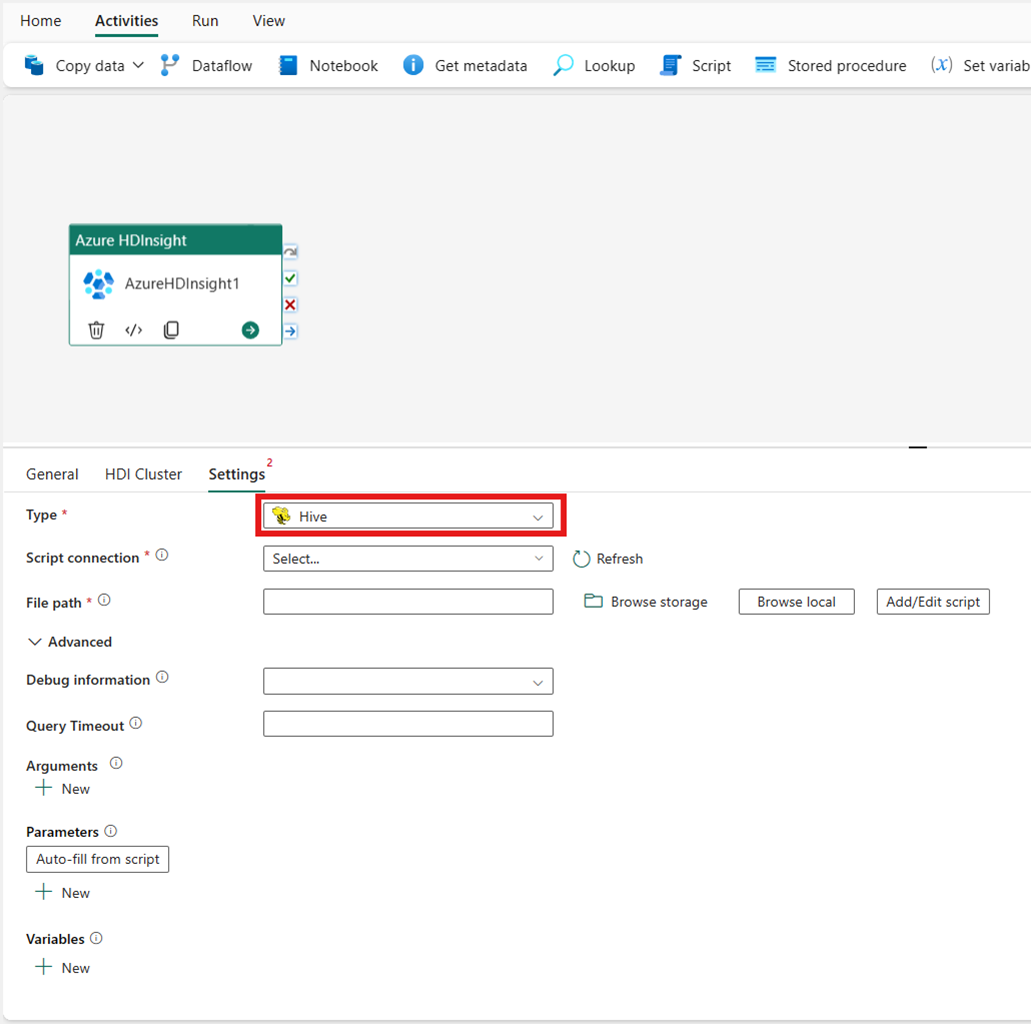
Sarang
Jika Anda memilih Apache Hive untuk Jenis, aktivitas akan menjalankan kueri Apache Hive. Anda dapat secara opsional menentukan Koneksi Skrip yang mereferensikan akun penyimpanan yang menyimpan jenis Hive. Secara default, koneksi penyimpanan yang Anda tentukan di tab Kluster HDI digunakan. Anda perlu menentukan jalur berkas untuk dijalankan di Azure HDInsight. Secara opsional, Anda dapat menentukan lebih banyak konfigurasi di bagian Tingkat Lanjut , Informasi debug, Batas waktu kueri, Argumen, Parameter, dan Variabel.
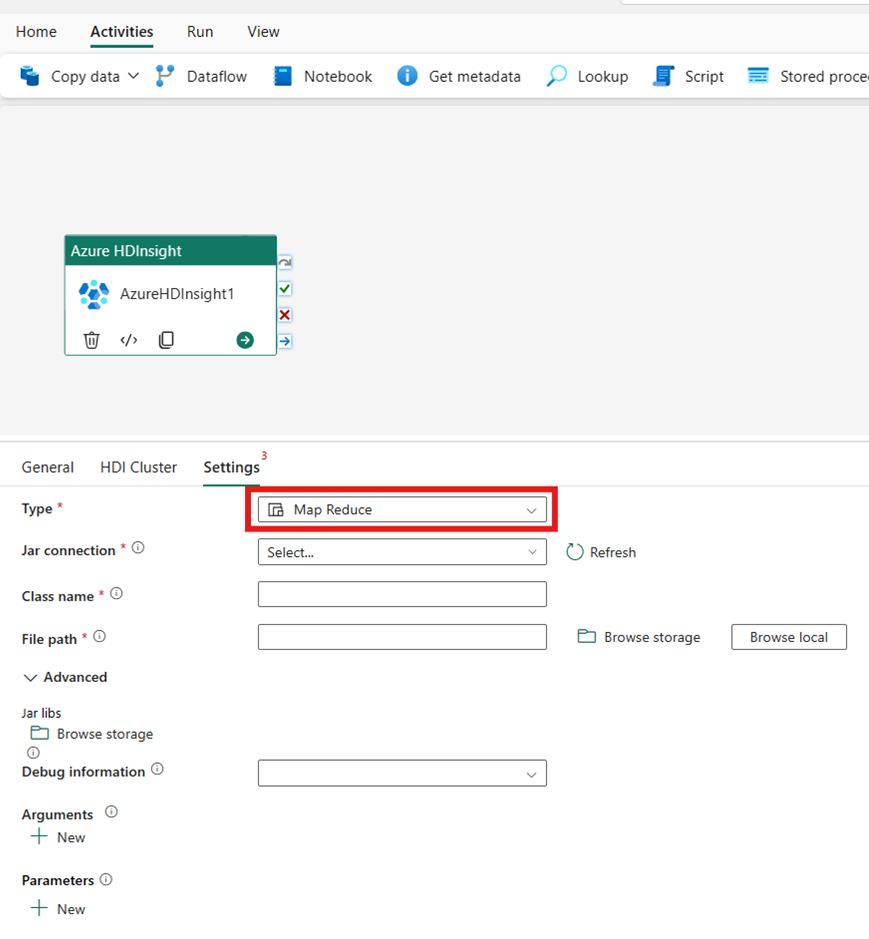
Map Reduce
Jika Anda memilih Kurangi Peta untuk Jenis, aktivitas memanggil program Pengurangan Peta. Anda dapat menentukan secara opsional dalam koneksi Jar yang merujuk akun penyimpanan yang menyimpan tipe Map Reduce. Secara default, koneksi penyimpanan yang Anda tentukan di tab Kluster HDI digunakan. Anda perlu menentukan Nama kelas dan jalur File yang akan dijalankan di Azure HDInsight. Secara opsional Anda dapat menentukan detail konfigurasi lainnya, seperti mengimpor pustaka Jar, informasi debug, argumen, dan parameter di bawah bagian Tingkat Lanjut .
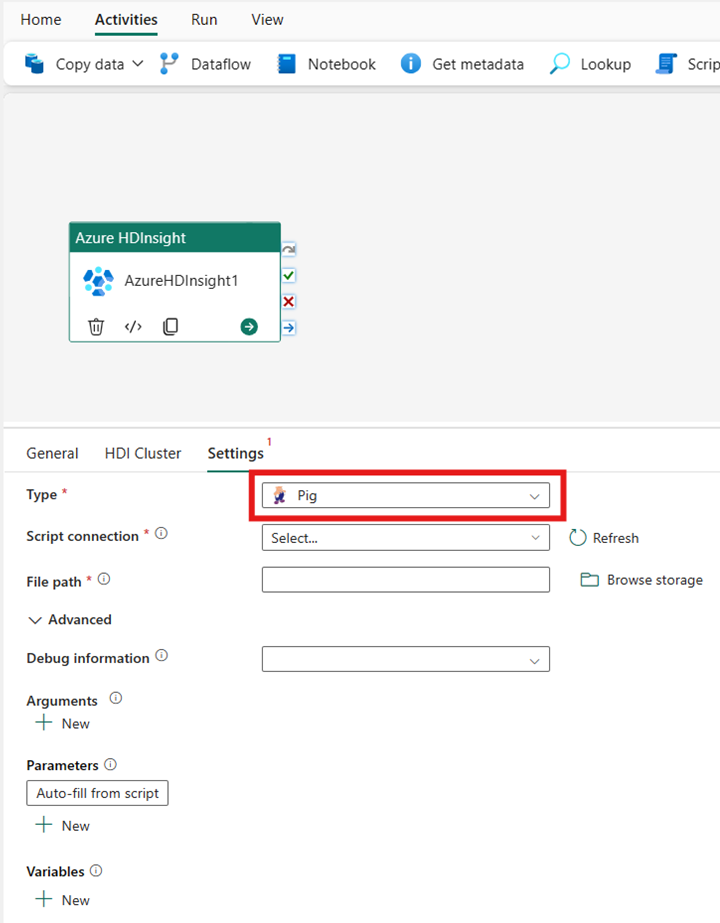
Babi
Jika Anda memilih Pig untuk Tipe, aktivitas akan memanggil kueri Pig. Anda dapat secara opsional menentukan Script connection yang mereferensikan akun penyimpanan yang menyimpan jenis Pig. Secara default, koneksi penyimpanan yang Anda tentukan di tab Kluster HDI digunakan. Anda perlu menentukan jalur berkas untuk dijalankan di Azure HDInsight. Secara opsional Anda dapat menentukan lebih banyak konfigurasi, seperti informasi debug, argumen, parameter, dan variabel di bawah bagian Tingkat Lanjut .
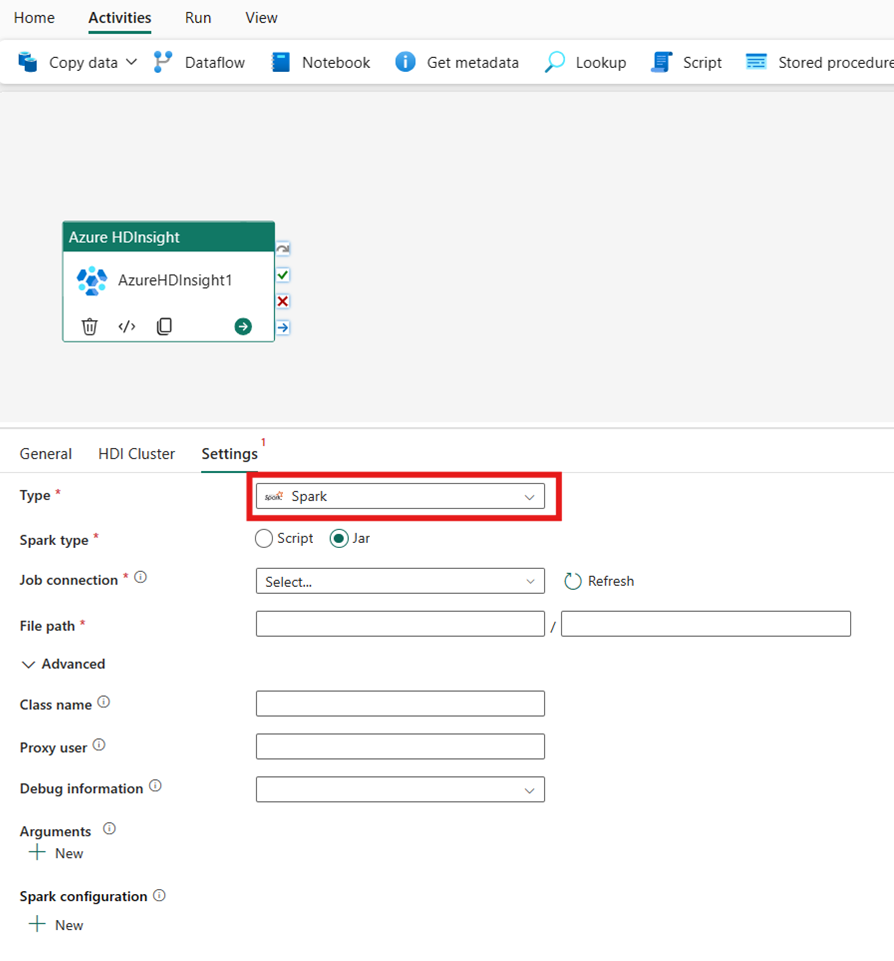
Spark
Jika Anda memilih Spark untuk Jenis, aktivitas akan memanggil program Spark. Pilih Skrip atau Jar untuk jenis Spark. Secara opsional, Anda dapat menentukan koneksi Job yang mereferensikan akun penyimpanan yang menyimpan jenis Spark. Secara default, koneksi penyimpanan yang Anda tentukan di tab Kluster HDI digunakan. Anda perlu menentukan jalur berkas untuk dijalankan di Azure HDInsight. Secara opsional Anda dapat menentukan lebih banyak konfigurasi, seperti nama kelas, pengguna proksi, informasi debug, argumen, dan konfigurasi spark di bawah bagian Tingkat Lanjut.
Siaran Langsung
Jika Anda memilih Streaming untuk Jenis, aktivitas akan memanggil program Streaming. Tentukan nama Mapper dan Reducer, dan Anda dapat secara opsional menentukan Koneksi File yang mereferensikan akun penyimpanan yang menyimpan tipe Streaming. Secara default, koneksi penyimpanan yang Anda tentukan di tab Kluster HDI digunakan. Anda perlu menentukan jalur File untuk Mapper dan jalur File untuk Reducer yang akan dijalankan di Azure HDInsight. Sertakan juga opsi Input dan Output untuk jalur WASB. Secara opsional Anda dapat menentukan lebih banyak konfigurasi, seperti informasi debug, argumen, dan parameter di bawah bagian Tingkat Lanjut.
Referensi properti
| Properti | Deskripsi | Wajib |
|---|---|---|
| jenis | Untuk Aktivitas Streaming Hadoop, jenis aktivitasnya adalah HDInsightStreaming | Ya |
| pemeta | Menentukan nama mapper yang dapat dieksekusi | Ya |
| pengurangan | Menentukan nama dari reducer yang dapat dieksekusi | Ya |
| Penggabung | Menentukan nama combiner yang dapat dieksekusi | Tidak. |
| koneksi berkas | Referensi ke Layanan Tertaut Azure Storage yang digunakan untuk menyimpan program Mapper, Combiner, dan Reducer untuk dieksekusi. | Tidak. |
| Hanya koneksi Azure Blob Storage dan ADLS Gen2 yang didukung di sini. Jika Anda tidak menentukan koneksi ini, koneksi penyimpanan yang ditentukan dalam koneksi HDInsight digunakan. | ||
| filePath | Berikan array jalur ke program Mapper, Combiner, dan Reducer yang disimpan di Azure Storage yang dirujuk oleh koneksi file. | Ya |
| Masukan | Menentukan jalur WASB ke file input untuk Mapper. | Ya |
| keluaran | Menentukan jalur WASB ke file output untuk Reducer. | Ya |
| getDebugInfo | Menentukan waktu saat file log disalin ke Azure Storage yang digunakan oleh kluster Azure HDInsight (atau) ditentukan oleh scriptLinkedService. | Tidak. |
| Nilai yang diizinkan: None, Always, atau Failure. Nilai default: None. | ||
| argumen | Menentukan rangkaian argumen untuk pekerjaan Hadoop. Argumen diteruskan sebagai argumen baris perintah untuk tiap tugas. | Tidak. |
| Mendefinisikan | Menentukan parameter sebagai pasangan kunci/nilai untuk referensi dalam skrip Apache Hive. | Tidak. |
Simpan dan jalankan atau jadwalkan pipeline
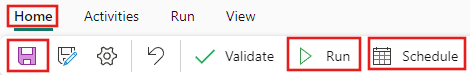
Beralih ke tab Beranda di bagian atas editor alur dan pilih tombol simpan untuk menyimpan alur Anda. Pilih Jalankan untuk menjalankannya secara langsung atau Jadwalkan untuk menjadwalkan eksekusi pada waktu atau interval tertentu. Untuk informasi selengkapnya tentang proses alur, lihat: menjadwalkan proses alur.
Setelah berjalan, Anda dapat memantau eksekusi alur dan melihat riwayat eksekusi dari tab Output di bawah kanvas.