Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Anda dapat membuat salinan logis data database KQL di eventhouse dengan mengaktifkan ketersediaan OneLake. Saat mengaktifkan ketersediaan OneLake, Anda dapat mengkueri data dalam database KQL Anda dalam format Delta Lake melalui mesin Fabric lainnya seperti mode Direct Lake di Power BI, Gudang, Lakehouse, Notebooks, dan banyak lagi. Delta Lake adalah format tabel data lake terpadu yang memungkinkan akses data tanpa hambatan di semua mesin komputasi dalam Fabric.
Dalam artikel ini, Anda mempelajari cara mengaktifkan ketersediaan data database KQL di OneLake.
Ketika ketersediaan OneLake dan sinkronisasi skema diaktifkan, Anda juga dapat menggunakan Analyze data with>SQL analytics endpoint di tingkat basis data untuk melakukan query representasi Delta Lake hampir secara real-time melalui mesin berbasis SQL.
Cara kerja ketersediaan OneLake untuk database KQL
Anda dapat mengaktifkan ketersediaan OneLake pada tingkat database atau tabel. Saat diaktifkan di tingkat database, semua tabel baru dan datanya tersedia di OneLake. Saat mengaktifkan fitur, Anda juga dapat memilih untuk menerapkan opsi ini ke tabel yang sudah ada dengan memilih opsi Terapkan ke tabel yang ada, untuk menyertakan isi ulang historis. Mengaktifkan fitur pada tingkat tabel hanya membuat tabel tersebut dan datanya dapat diakses di OneLake. Kebijakan penyimpanan data database KQL Anda juga diterapkan ke data di OneLake. Data yang dihapus dari database KQL Anda di akhir periode retensi juga dihapus dari OneLake. Jika Anda menonaktifkan ketersediaan OneLake, data akan dihapus secara sementara dari OneLake.
Sinkronisasi skema di backend menjaga representasi Delta Lake tetap selaras dengan database KQL, sehingga memungkinkan kueri nyaris real-time melalui endpoint analitik SQL dan notebook. Untuk latensi dan perilaku batch yang diharapkan, lihat Perilaku adaptif.
Saat ketersediaan OneLake diaktifkan, Anda tidak dapat melakukan tugas berikut:
- Ganti nama tabel.
- Mengubah jenis kolom. Menambahkan atau menghapus kolom didukung.
- Terapkan keamanan tingkat baris ke tabel.
- Hapus, potong, atau hapus menyeluruh data.
Jika Anda perlu melakukan salah satu tugas ini, gunakan langkah-langkah berikut:
- Nonaktifkan ketersediaan OneLake.
- Lakukan tugas.
- Aktifkan ketersediaan OneLake.
Penting
Menonaktifkan ketersediaan OneLake menghapus data Anda dari OneLake. Saat Anda mengaktifkan kembali ketersediaan, semua data akan tersedia di OneLake, termasuk pengisian balik historis.
Catatan
Untuk informasi tentang waktu yang diperlukan agar data muncul di OneLake, lihat Perilaku adaptif. Tidak ada biaya penyimpanan tambahan untuk mengaktifkan ketersediaan OneLake. Untuk informasi selengkapnya, lihat konsumsi sumber daya.
Prasyarat
- Ruang kerja dengan kapasitas yang mendukung Fabric.
- Database KQL dengan izin pengeditan dan data.
Mengaktifkan ketersediaan OneLake untuk database atau tabel KQL
Anda dapat mengaktifkan ketersediaan OneLake untuk database atau tabel KQL.
Pilih database atau tabel.
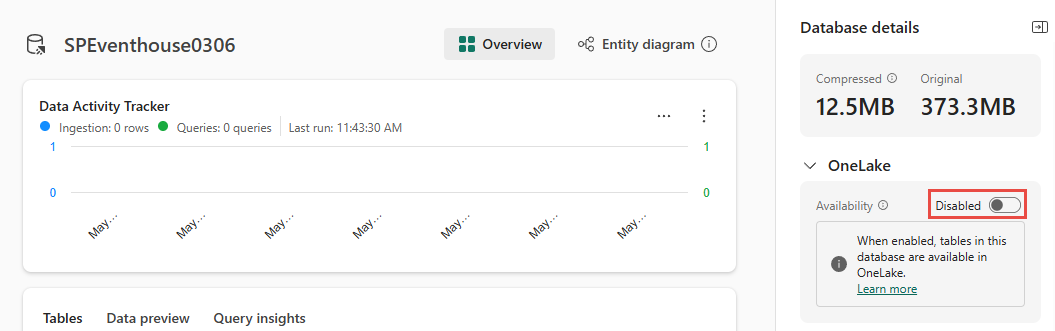
Di panel detail bagian OneLake , atur Ketersediaan ke Diaktifkan.
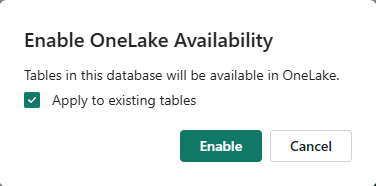
Di jendela Aktifkan ketersediaan OneLake , pilih Aktifkan.
Detail database atau tabel diperbarui secara otomatis.
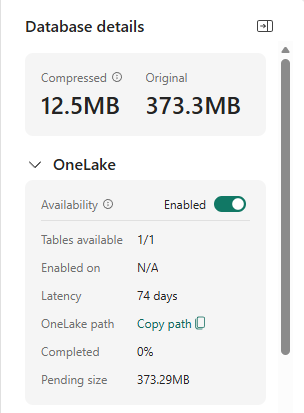
Saat mengaktifkan ketersediaan OneLake di database atau tabel KQL, Anda dapat mengakses semua data di jalur OneLake yang diberikan dalam format Delta Lake. Anda juga dapat membuat pintasan OneLake dari lakehouse atau gudang, atau mengkueri data langsung melalui mode Power BI Direct Lake. Dengan ketersediaan OneLake di database atau tabel KQL Anda diaktifkan, Anda sekarang dapat mengakses semua data di jalur OneLake yang diberikan dalam format Delta Lake. Anda juga dapat membuat pintasan OneLake dari Lakehouse, Gudang Data, atau mengkueri data secara langsung melalui mode Power BI Direct Lake.
Gunakan dengan Analisis data dengan opsi
Saat ketersediaan OneLake diaktifkan, item database Eventhouse dan KQL mengekspos Analisis data dengan opsi di tingkat database:
- Endpoint SQL analytics: Tersedia ketika ketersediaan OneLake dan sinkronisasi skema diaktifkan.
- Notebook: Membuka analisis berbasis buku catatan untuk database yang dipilih.
Jika Anda mematikan ketersediaan OneLake, opsi endpoint SQL analytics akan dihapus dari menu ini sampai Anda mengaktifkannya kembali.
Perilaku adaptif untuk pemrosesan batch file Parquet
Eventhouse secara cerdas mengelompokkan aliran data yang masuk ke dalam satu atau beberapa file Parquet yang terstruktur untuk analisis. Melakukan batch pada aliran data penting saat menangani data yang masuk sedikit demi sedikit, karena menulis banyak file Parquet berukuran kecil ke data lake dapat menjadi tidak efisien. Inefisiensi ini menghasilkan biaya yang lebih tinggi dan performa kueri yang buruk.
Mekanisme adaptif eventhouse dapat menunda operasi penulisan ke OneLake jika tidak ada cukup data untuk membuat file Parquet yang optimal. Perilaku ini memastikan bahwa file Parquet berukuran optimal dan mematuhi praktik terbaik Delta Lake. Ini menyeimbangkan kebutuhan akan ketersediaan data yang diminta dengan pertimbangan biaya dan performa.
Latensi penulisan default dan yang dapat dikonfigurasi untuk ketersediaan OneLake:
| Setting | Nilai standar | Rentang yang diizinkan |
|---|---|---|
Penundaan operasi tulis (TargetLatencyInMinutes) |
Hingga 3 jam, atau hingga file dengan ukuran yang memadai (biasanya 200-256 MB) dibuat | 5 menit hingga 3 jam |
Misalnya, gunakan perintah Kusto berikut untuk mengatur penundaan tulis menjadi 5 menit untuk satu tabel:
.alter-merge table <TableName> policy mirroring dataformat=parquet with (IsEnabled=true, TargetLatencyInMinutes=5);
Perhatian
Menyesuaikan penundaan ke periode yang lebih singkat dapat mengakibatkan tabel delta suboptimal dengan sejumlah besar file kecil, yang dapat menyebabkan performa kueri yang tidak efisien. Tabel yang dihasilkan di OneLake bersifat baca-saja dan tidak dapat dioptimalkan setelah pembuatan.
Anda dapat memantau sudah berapa lama sejak data baru ditambahkan di data lake dengan memeriksa latensi data Anda menggunakan perintah .show table mirroring operations.
Hasil diukur dari terakhir kali data ditambahkan. Saat Latensi mengembalikan 00:00:00, semua data dalam database KQL tersedia di OneLake.
Menampilkan file Delta Lake di OneLake
Saat Anda mengaktifkan ketersediaan OneLake pada tabel, proses membuat folder log delta bersama dengan file JSON dan Parquet yang sesuai. Anda dapat melihat file yang tersedia di OneLake dan properti file tersebut tanpa meninggalkan Real-Time Intelligence.
Untuk menampilkan file, arahkan mouse ke atas tabel di panel Explorer lalu pilih menu Lainnya [...]>Lihat file.
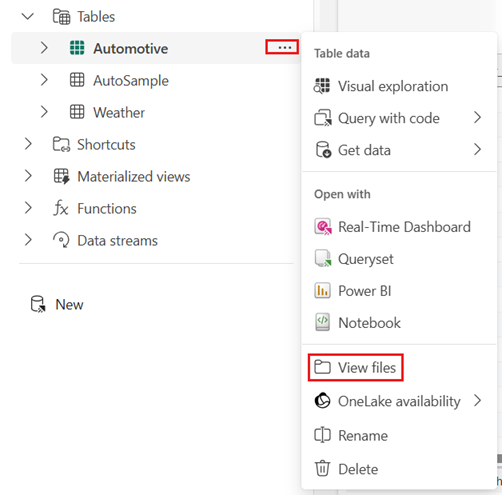
Untuk melihat properti folder log delta atau file individual, arahkan mouse ke folder atau file lalu pilih menu Lainnya [...]>Properti.
Untuk melihat file di folder log delta:
- Pilih folder _delta_log.
- Pilih file untuk melihat metadata dan skema tabel. Editor yang terbuka dalam format baca-saja.
Mengakses kebijakan pencerminan OneLake
Secara default, saat Anda mengaktifkan ketersediaan OneLake untuk database atau tabel KQL, sistem mengaktifkan kebijakan pencerminan. Anda dapat menggunakan kebijakan pencerminan untuk memantau latensi data atau mengubahnya menjadi tabel delta partisi.
Catatan
Jika Anda menonaktifkan ketersediaan OneLake, properti kebijakan IsEnabled pencerminan diatur ke false (IsEnabled=false).
Tabel delta partisi di OneLake
Anda dapat mempartisi tabel delta Anda untuk meningkatkan kecepatan kueri. Untuk informasi tentang kapan harus mempartisi file OneLake Anda, lihat Kapan harus mempartisi tabel. Setiap partisi direpresentasikan sebagai kolom terpisah menggunakan PartitionName yang tercantum dalam daftar Partitions. Representasi ini berarti salinan OneLake Anda memiliki lebih banyak kolom daripada tabel sumber Anda.
Untuk mempartisi tabel delta Anda, gunakan .alter-merge table policy mirroring perintah .
Kueri tabel Delta dari buku catatan Fabric
Anda dapat menggunakan Fabric Notebook untuk membaca data OneLake menggunakan cuplikan kode berikut.
Tip
Anda dapat meluncurkan buku catatan Fabric baru atau yang sudah ada langsung dari Menganalisis data dengan>Notebook di database Eventhouse atau KQL. Buku catatan secara otomatis dilampirkan ke konteks database yang dipilih. Gunakan sampel kode berikut saat Anda menginginkan akses berbasis jalur manual.
Dalam cuplikan kode, ganti
<workspaceGuid>,<workspaceGuid>, dan<tableName>dengan nilai Anda sendiri.
delta_table_path = 'abfss://<workspaceGuid>@onelake.dfs.fabric.microsoft.com/<eventhouseGuid>/Tables/<tableName>'

df = spark.read.format("delta").load(delta_table_path)

df.show()
Catatan
Untuk database Azure Data Explorer, gunakan kode ini:
delta_table_path = 'abfss://<workspaceName>@onelake.dfs.fabric.microsoft.com/<itemName>.KustoDatabase/Tables/<tableName>'