Fireworks AI との統合により、Microsoft Foundry のお客様は次のことができます。
最新のオープンソース モデルを試用することができます しばしば、Azureから直接利用可能になる前に。 - カスタム モデルの重み (独自のモデルを持ち込むまたは BYOM) をインポートして、Fireworks のオンデマンド GPU ベースのインフラストラクチャにデプロイします。 詳細については、「Microsoft Foundry with Fireworks でのカスタムモデルのインポート」を参照してください。
- スケールアップするためにプロビジョニング済みスループットを使用します。
これらの機能はすべて Foundry プロジェクト内で直接使用でき、Azureガバナンス、アクセス制御、プロジェクト管理が組み込まれています。
前提 条件
Azure サブスクリプション。 お持ちでない場合は、 無料アカウントを作成してください。
機能を有効にするサブスクリプション所有者ロールまたはサブスクリプション共同作成者ロールを持つAzure ID。
モデルをデプロイするには、Foundry プロジェクトでの Foundry Owner ロールが必要です。 詳細については、「Azure組み込みロールを参照してください。
重要
Foundry RBAC ロールの名前が最近変更されました。 Foundry User, Foundry Owner, Foundry Account Owner、および Foundry Project Manager は、以前は、AZURE AI ユーザー、Azure AI 所有者、Azure AI アカウント所有者、および AZURE AI Project Manager という名前でした。 名前の変更がロールアウトされている間、以前の名前が表示される場合があります。ロール ID とコア アクセス許可は、名前の変更によって変更されません。
リージョンの可用性
Foundry 上の Fireworks による Data Zone Standard および Data Zone Provisioned でのモデルのデプロイは、次のAzure リージョンで利用できます。
- 米国東部 (eastus)
- 米国東部 2 (eastus2)
- 米国中部 (centralus)
- 米国中北部 (北中部)
- 米国西部 (westus)
- 米国西部 3 (westus3)
基本モデルとカスタム モデルのグローバル プロビジョニング スループット デプロイは、Azure Governmentクラウド環境を除くすべてのグローバル Azure リージョンで利用できます。 グローバル プロビジョニングスループットをサポートするすべてのカタログ モデルでは、Data Zone Provisioned スループットもサポートされます。
鋳造で花火を有効にする
重要
Foundry の花火は現在、EU データ境界コミットメントから除外されています。
FedRAMP は、Foundry の花火では達成されません。 組織で FedRAMP が必要な場合は、使用前に承認担当者に問い合わせて、Foundry での花火の使用が許可されているかどうかを確認してください。
Payment Card Industry (PCI) Data Security Standard (DSS) は、Foundry の花火には適用されません。 Foundry の花火を使用して、支払いデータとカード所有者データを格納、処理、または送信しないでください。
Foundry の花火は一般提供されていますが、管理者は、Azure サブスクリプション内でサービスを有効にする必要があります。 Azure プレビュー機能ポータルを使用すると、お客様は次の手順を使用してサービスを有効にすることができます。
Azure ポータルにサインインします。
検索ボックスに「サブスクリプション」と入力し、 [サブスクリプション] を選択します。
サブスクリプションの名前のリンクを選択します。
左側のメニューの [設定] で、[ プレビュー機能] を選択します。
Fireworks.EnableDeploy プレビュー機能を検索して選択します。
このドキュメントの 説明 と データプライバシー に関するセクションに記載されている用語を確認します。
条件に同意しない場合は、[ 閉じる ] を選択して続行しないでください。 それ以外の場合は、[ 登録] を選択します。
[OK] を選択. プレビュー機能画面が更新され、プレビュー機能の状態が表示されます。 この機能がサブスクリプションに対して有効になるまでに最大 30 分かかる場合があります。
ヒント
登録を確認するには、[Preview features]\(プレビュー機能\) ページを更新し、[State] 列に Foundry の花火機能に登録済みと表示されていることを確認します。
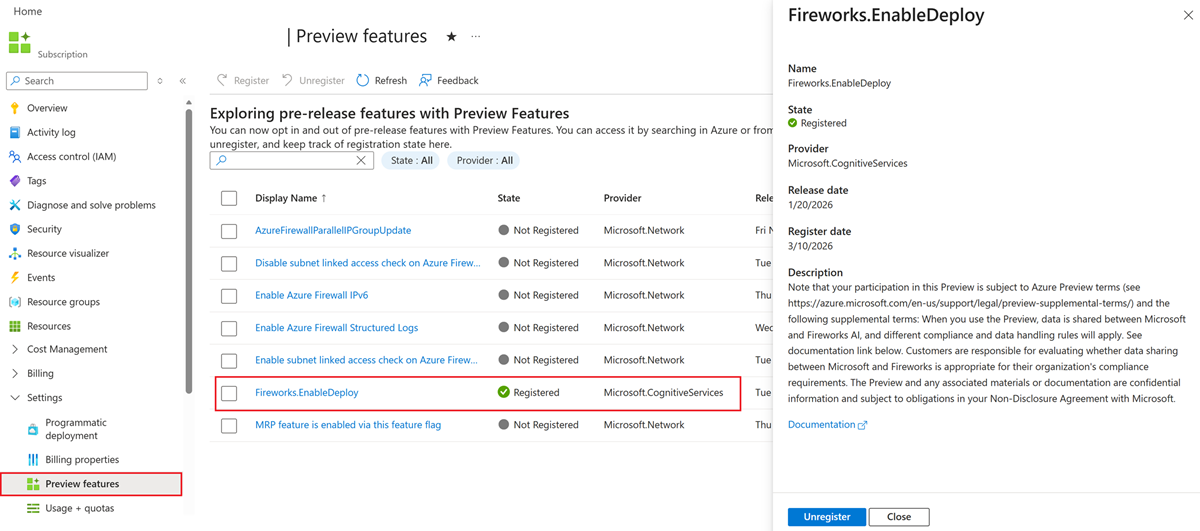
Foundry ポータルから花火 モデルをデプロイする
この機能を有効にすると、Foundry モデル カタログから花火 モデルをデプロイできます。 チャットの完了のためのライブ エンドポイントを取得するには、次の手順を実行します。 [使用可能なカタログ モデル] セクションで 使用可能なモデル を参照するか、 独自のカスタム モデルをインポートします。
ポータルのホームページで、右上のナビゲーションで [ 検出 ] を選択します。
左側のウィンドウで、[ モデル ] を選択してモデル カタログを開きます。
目的の花火 モデルを選択して、モデル ページでその詳細を表示します。
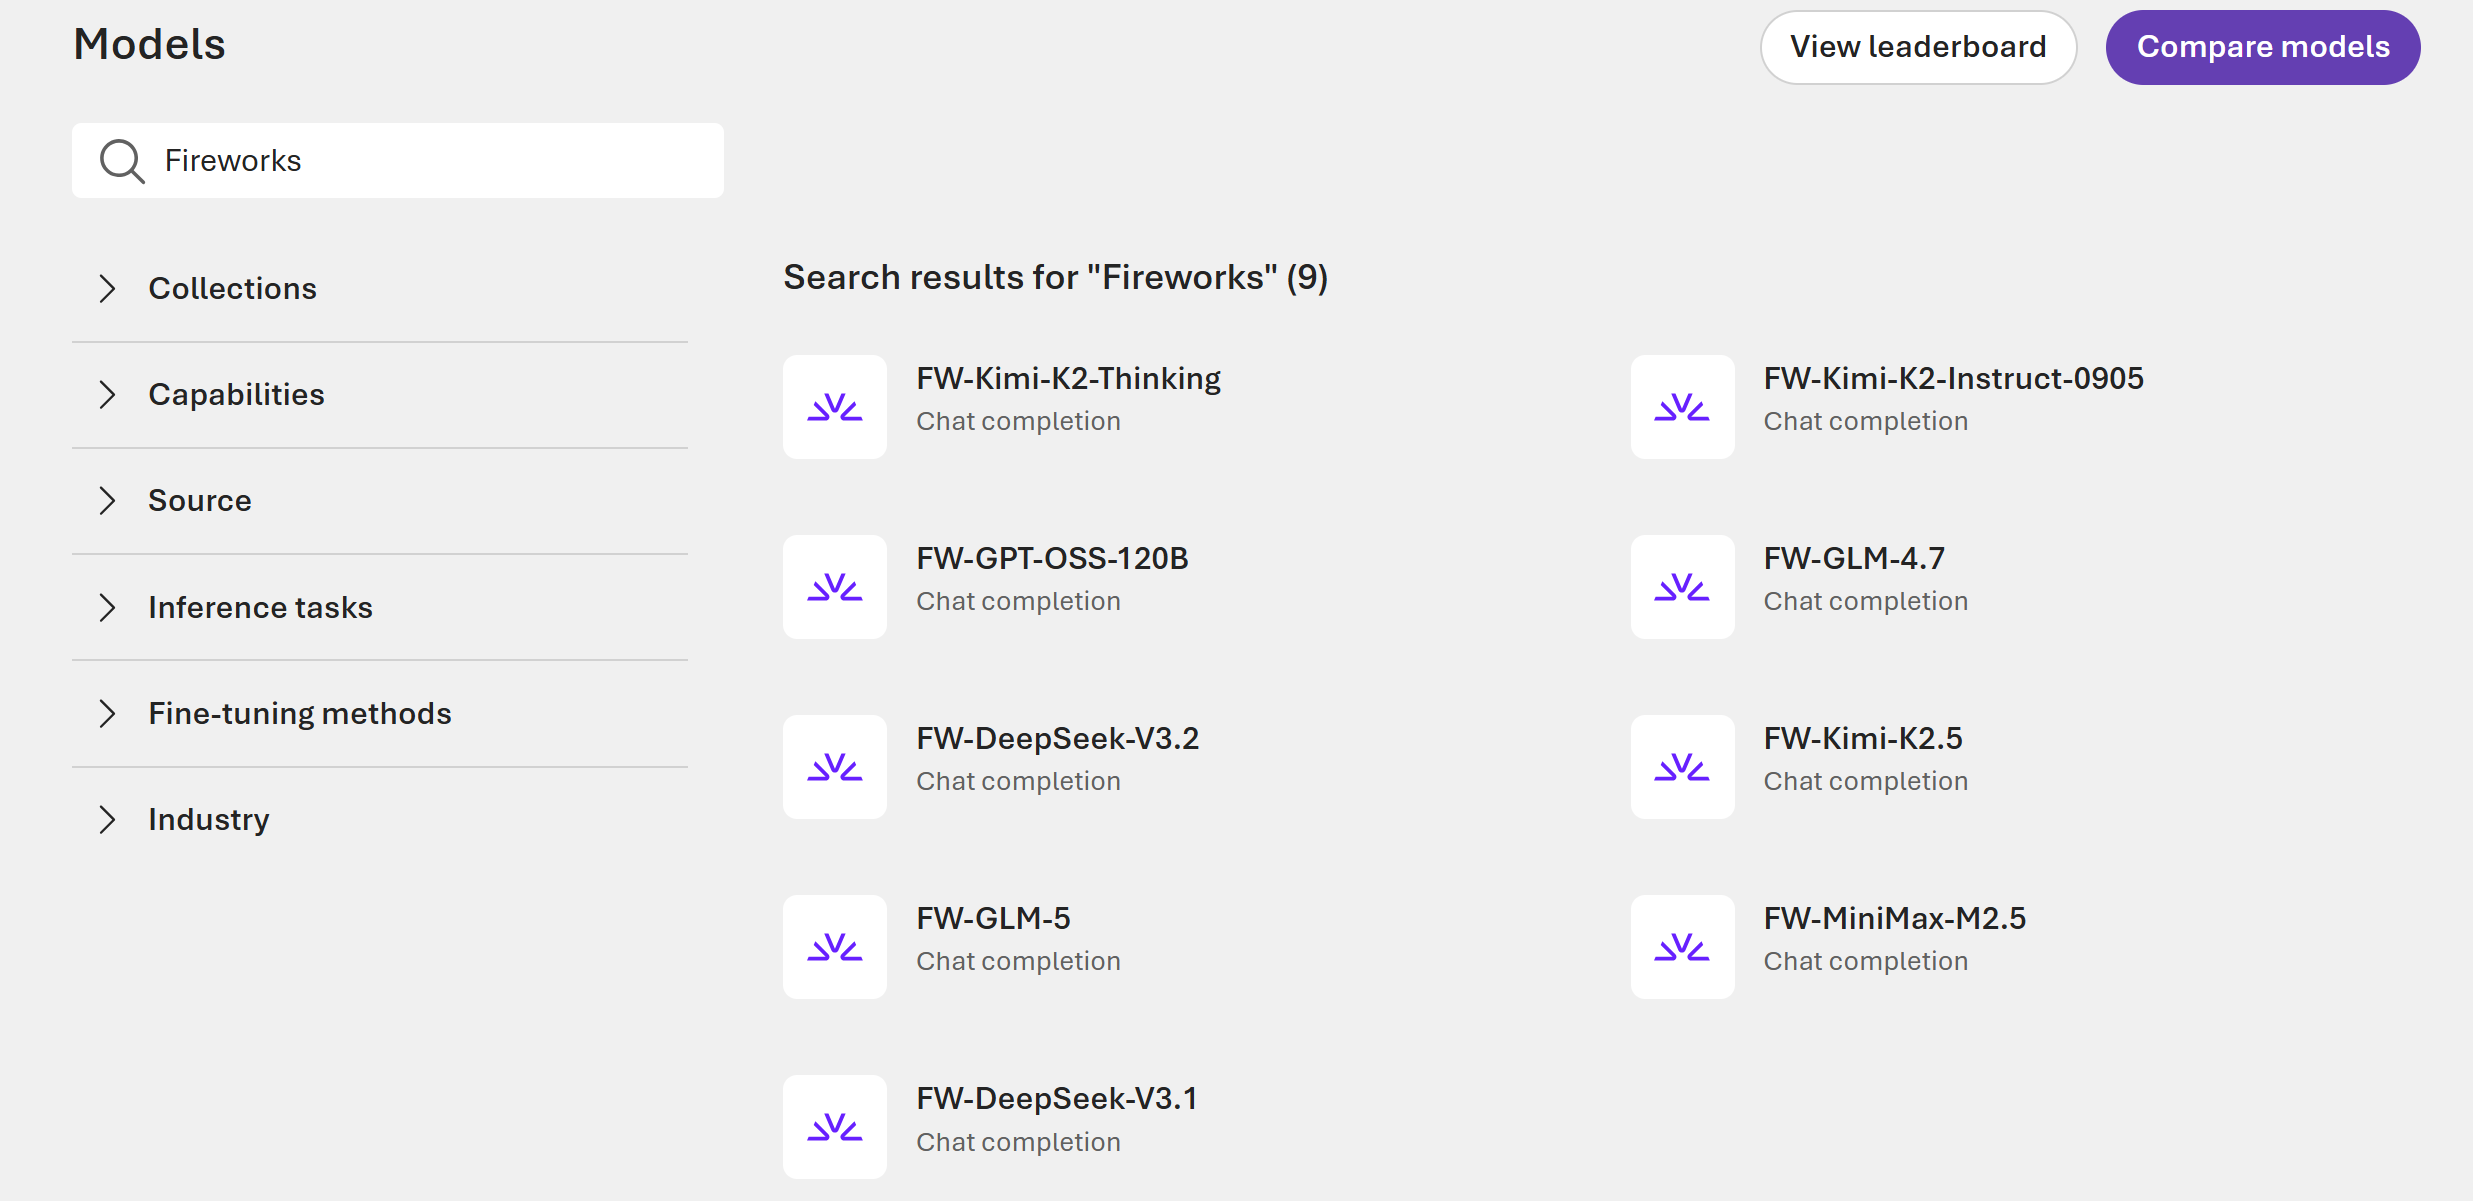
モデル ページで、[デプロイ] を選択 します。 デプロイ オプションの詳細については、「 ポータルでの Foundry モデルのデプロイ」を参照してください。
展開ウィンドウで、次の設定を構成します。
- デプロイ名: 既定の名前をそのまま使用するか、カスタム名を入力してデプロイを識別します。
- トークン プラン: モデルに応じて、 トークンごとの支払い -> Datazone Standard または Global Standard を選択するか、 プロビジョニングされたスループット -> Datazone またはグローバルを選択します。 詳細については、「展開の 種類」を参照してください。
- モデル バージョンの設定: デプロイのモデル バージョンを選択します。
- 1 分あたりのトークンレート制限: コストを管理し、使用状況を制御するために、1 分あたりのカスタム トークン数の制限を設定します。 トークンごとの支払いデプロイについては、「 クォータとレート制限」を参照してください。
- ガードレール: DefaultV2 または 既定の ガードレール構成を選択します。 モデルは、別のガードレールが指定されていない場合、Microsoft.DefaultV2 のガードレールを使用します。 詳細については、「 ガードレールを使用してモデル出力に境界を設定する」を参照してください。
[ デプロイ] を選択します。 デプロイ プロセスには最大 30 分かかることがあります。
デプロイが完了したら、指定されたエンドポイントとキーを使用して推論要求をモデルに送信します。 デプロイをすばやくテストするには、Foundry プロジェクトで Playground を使用します。
ヒント
デプロイを確認するには、プロジェクトの [デプロイ] ページに移動し、デプロイの 状態 に [成功] と表示されていることを確認します。
クォータとレート制限
トークンごとの支払いデプロイの場合、Global Standard と Data Zone Standard には個別のクォータ プールがあります。 エンタープライズのお客様の既定のクォータは、リージョンあたり、サブスクリプションあたり、各プールの 1 分あたり 1000 万トークン (TPM) です。 各プールはすべての花火 モデルで共有され、個々のモデルデプロイにクォータを割り当てることができます。
Fireworks は、クォータ内でアダプティブ レート制限を直接適用します。 有効な制限は完全なクォータを下回り、使用量の増加に合わせて自動的に調整されます。
トラフィックを徐々に増やし、HTTP 429 (要求が多すぎます) 応答を再試行するときに指数バックオフを使用します。 詳細については、「 花火の適応レート制限」を参照してください。
すべての顧客は、 クォータの引き上げ要求 を送信して、より多くのクォータを得ることができます。
プロンプトのキャッシュヒット率を向上させる
プロンプト キャッシュでは、同じプロンプト プレフィックスを共有する要求の処理が再利用されます。 プロンプト キャッシュヒット率を向上させるには、各ユーザーまたはセッションに安定した識別子を設定し、関連する要求に同じ値を再利用します。 次のいずれかのオプションを使います。
-
x-session-affinityHTTP ヘッダーを設定します。 -
user要求パラメーターを設定します。 -
prompt_cache_key要求パラメーターを設定します。 両方が存在する場合、このパラメーターはuserよりも優先されます。
詳細については、Fireworks AI ドキュメントの プロンプト キャッシュ を参照してください。
使用可能なカタログ モデル
Foundry モデル カタログでは、次の花火 モデルを使用できます。 [サポートされているプラン] 列の PTU には、グローバル プロビジョニング スループットとデータ ゾーン プロビジョニング スループットの両方が含まれます。
| モデル プロバイダー | モデル名 | モデル ID | タイプ | サポートされているオファー | 説明 |
|---|---|---|---|---|---|
| DeepSeek | DeepSeek V3.1 | FW-DeepSeek-V3.1 |
チャットの完了 | PTU | チャットおよびツール使用ワークロードを呼び出す 163K コンテキストと関数を備えた MoE 言語モデル。 |
| DeepSeek | DeepSeek V3.2 | FW-DeepSeek-V3.2 |
チャットの完了 | PTU | 効率的な推論とエージェントのパフォーマンスに重点を置いた MoE モデル。 |
| DeepSeek | DeepSeek V4 Flash | FW-DeepSeek-V4-Flash |
チャットの完了 | PTU | 1M トークン コンテキストスケールでの高速でコスト効率の高い推論とコーディングのために最適化された合理化された MoE モデル。 |
| DeepSeek | DeepSeek V4 Flash 0731 | FW-DeepSeek-V4-Flash-0731 |
チャットの完了 | トークンごとの支払いおよび PTU | 強化されたエージェント機能、投機的デコード、1M コンテキストを使用して DeepSeek V4 Flash モデルを更新しました。 |
| DeepSeek | DeepSeek V4 Pro | FW-DeepSeek-V4-Pro |
チャットの完了 | トークンごとの支払いおよび PTU | 最先端の推論、コーディング、長文コンテキストのエージェント型ワークロード向けの、1.6TパラメータのフラッグシップMoEモデル。 |
| DeepSeek | DeepSeek V4.1 Flash | FW-DeepSeek-V4.1-Flash |
チャットの完了 | トークンごとの支払い (グローバル標準) | 552B パラメーター、画像入力、1M コンテキストを備えたマルチモーダル MoE モデル。 |
| グーグル | Gemma 4 26B A4B IT | FW-Gemma-4-26B-A4B-IT |
チャットの完了 | PTU | 画像入力、関数呼び出し、256K コンテキストを使用したマルチモーダル MoE 命令チューニング モデル。 |
| グーグル | Gemma 4 31B IT | FW-Gemma-4-31B-IT |
チャットの完了 | PTU | 画像入力、関数呼び出し、256K コンテキストを使用したマルチモーダル密命令チューニング モデル。 |
| メタ | ラマ 3.1 8B 指示 | FW-Llama-v3.1-8B-Instruct |
チャットの完了 | PTU | ダイアログ ワークロード用に最適化された多言語の命令調整モデル。 |
| ミニマックス | MiniMax-M2.5 | FW-MiniMax-M2.5 |
チャットの完了 | PTU | コーディング、エージェント ツールの使用、検索、およびオフィスワークワークフロー用の MoE モデル。 |
| ミニマックス | MiniMax-M3 | FW-MiniMax-M3 |
チャットの完了 | トークンごとの支払いおよび PTU | コーディングと長期エージェント タスクのための 512K コンテキストを持つマルチモーダル MoE モデル。 |
| Mistral AI | Ministral 3 3B Instruct 2512 | FW-Ministral-3-3B-Instruct-2512 |
チャットの完了 | PTU | ビジョン入力と256Kコンテキストを備えたコンパクトな3B高密度命令チューニングモデル。 |
| Moonshot AI | キミK2指示0905 | FW-Kimi-K2-Instruct-0905 |
チャットの完了 | PTU | 262K コンテキストでの 1T パラメーター MoE 命令モデル、改善されたコーディング、およびツールの使用。 |
| Moonshot AI | キミ K2 シンキング | FW-Kimi-K2-Thinking |
チャットの完了 | PTU | 262Kコンテキスト対応の段階的なツール利用エージェント向けMoE推論モデル。 |
| Moonshot AI | キミ K2.5 | FW-Kimi-K2.5 |
チャットの完了 | PTU | 推論コントロール、ツールの使用、262K コンテキストを備えたマルチモーダル MoE エージェント モデル。 |
| Moonshot AI | キミ K2.6 | FW-Kimi-K2.6 |
チャットの完了 | トークンごとの支払い (2026 年 9 月 25 日に廃止) と PTU | 長期コーディングとタスク オーケストレーションのためのオープンソースのマルチモーダル エージェント モデル。 |
| Moonshot AI | キミ K2.7 コード | FW-Kimi-K2.7-Code |
チャットの完了 | トークンごとの支払い (2026 年 9 月 25 日に廃止) と PTU | 長期ソフトウェア エンジニアリング ワークフロー用のコーディングに重点を置いたマルチモーダル エージェント モデル。 |
| Moonshot AI | キミ K3 | FW-Kimi-K3 |
チャットの完了 | トークンごとの支払い (グローバル標準) | ネイティブの視覚理解と 1M コンテキストを備えたマルチモーダル 2.8T パラメーター MoE モデル。 |
| NVIDIA | NVIDIA Nemotron 3 Super 120B A12B BF16 | FW-Nemotron-3-Super-120B-A12B-BF16 |
チャットの完了 | PTU | エージェント型ワークフロー、長いコンテキスト推論、およびツールの使用のための 120B 合計パラメーターを持つ Hybrid LatentMoE モデル。 |
| NVIDIA | NVIDIA Nemotron 3 Ultra NVFP4 | FW-Nemotron-3-Ultra-NVFP4 |
チャットの完了 | トークンごとの支払いおよび PTU | エージェント型およびロングコンテキストのワークロード向けに、262Kのコンテキスト長を備えたNemotron推論モデル。 |
| NVIDIA | NVIDIA Nemotron Lightning 3.5 30B A3B | FW-Nemotron-Lightning-3.5-30B-A3B |
チャットの完了 | トークンごとの支払いおよび PTU | 構成可能な推論と 262K コンテキストを備えたハイブリッド Mamba-Transformer MoE モデル。 |
| OpenAI | OpenAI gpt-oss-120b | FW-GPT-OSS-120B |
チャットの完了 | PTU | 推論、エージェント タスク、開発者のユース ケースのためのオープンウェイト MoE モデル。 |
| OpenAI | OpenAI gpt-oss-20b | FW-GPT-OSS-20B |
チャットの完了 | PTU | 131K コンテキストでの推論と開発者ワークロードのオープンウェイト モデル。 |
| PaddlePaddle | PaddleOCR VL 1.6 | FW-PaddleOCR-VL-1.6 |
チャットの完了 | PTU | OCR、テーブル、数式、グラフなど、ドキュメント解析用のコンパクトなビジョン言語モデル。 |
| Qwen | Qwen3 14B | FW-Qwen3-14B |
チャットの完了 | PTU | 関数呼び出しと 40.9K コンテキストを持つ高密度 Qwen モデル。 |
| Qwen | Qwen3 32B | FW-Qwen3-32B |
チャットの完了 | PTU | 推論、コーディング、および対話タスクのための高密度 32B Qwen モデル。 |
| Qwen | Qwen3.5 4B | FW-Qwen3.5-4B |
チャットの完了 | PTU | 262K コンテキストを備えたコンパクトな Qwen モデル。 |
| Qwen | Qwen3.5 9B | FW-Qwen3.5-9B |
チャットの完了 | PTU | 262K コンテキストを備えたコンパクトな高密度 Qwen モデル。 |
| Qwen | Qwen3.5 27B | FW-Qwen3.5-27B |
チャットの完了 | PTU | 262K コンテキストを持つ高密度 27B Qwen モデル。 |
| Qwen | Qwen3.5 35B A3B | FW-Qwen3.5-35B-A3B |
チャットの完了 | PTU | 35B パラメーターの MoE Qwen モデル (コンテキスト長 262K)。 |
| Qwen | Qwen3.5 122B A10B | FW-Qwen3.5-122B-A10B |
チャットの完了 | PTU | 画像入力と 262K コンテキストを持つ 122B パラメーター MoE Qwen モデル。 |
| Qwen | Qwen3.5 397B A17B | FW-Qwen3.5-397B-A17B |
チャットの完了 | PTU | 画像入力と262Kコンテキストに対応した3960億パラメータのMoE Qwenモデル |
| Qwen | Qwen3.6 27B | FW-Qwen3.6-27B |
チャットの完了 | PTU | 画像入力、関数呼び出し、262Kコンテキストに対応した270億パラメータのデンスQwenモデル。 |
| Qwen | Qwen3.6 35B A3B | FW-Qwen3.6-35B-A3B |
チャットの完了 | PTU | 35B パラメーターの MoE Qwen モデル (コンテキスト長 262K)。 |
| シンキング マシン ラボ | Inkling | FW-Inkling |
チャットの完了 | トークンごとの支払い (2026 年 9 月 25 日に廃止) と PTU | テキスト、画像、およびオーディオ入力と 1M コンテキストを持つマルチモーダル 975B パラメーター MoE モデル。 |
| Z.ai | GLM-4.7 | FW-GLM-4.7 |
チャットの完了 | PTU | コーディング、推論、およびエージェント ワークフロー用の 352B パラメーター MoE モデル。 |
| Z.ai | GLM-5 | FW-GLM-5 |
チャットの完了 | PTU | 複雑なシステム エンジニアリングと長期的なエージェント タスクのための MoE モデル。 |
| Z.ai | GLM-5.1 | FW-GLM-5.1 |
チャットの完了 | PTU | エージェント エンジニアリング、コーディング、および長期タスク用の MoE モデル。 |
| Z.ai | GLM-5.2 | FW-GLM-5.2 |
チャットの完了 | トークンごとの支払いおよび PTU | 長期タスク用の 1M トークン コンテキストとマルチエフォート コーディング機能を備えた MoE モデル。 |
| Z.ai | GLM-5.2 Fast | FW-GLM-5.2-Fast |
チャットの完了 | トークンごとの支払いおよび PTU | 待機時間に依存するコーディングとエージェントのワークロード用に最適化された高スループット GLM-5.2 バリアント。 |
| Z.ai | GLM-5.3 | FW-GLM-5.3 |
チャットの完了 | トークンあたりの支払い | GLM-5.2 の後継で、複雑なコーディングと長期タスクのパフォーマンスが向上しました。 |
| Z.ai | GLM-5.3 Flash | FW-GLM-5.3-Flash |
チャットの完了 | トークンごとの支払い (グローバル標準) | 合計パラメーターが 320B、アクティブなパラメーターが 18B、コンテキストが 1M のマルチモーダル MoE モデル。 |
すべてのカタログモデルは、Chat Completions API 用の OpenAI/v1 API と、Responses API にアクセスするための Foundry SDK とエンドポイントをサポートしています。
重要
スタンダード (トークン単位) の推論プランにおける Fireworks モデルは、モデルの提供終了に先立ち、15日 間の事前通知期間が設けられています。 それに応じてデプロイを計画し、今後の提供終了日に関する通知を監視します。
トークンごとの支払いプランは、 FW-GPT-OSS-120B、 FW-DeepSeek-V3.2、 FW-Kimi-K2.5、 FW-GLM-5、 FW-GLM-5.1、 FW-MiniMax-M2.5では非推奨です。 プロビジョニング済みスループット (PTU) は、6 つのモデルすべてで引き続き使用できます。
FW-Kimi-K2.6、FW-Kimi-K2.7-Code、およびFW-Inklingのトークンごとの支払い (従量課金制) オファリングは、2026 年 9 月 25 日に廃止されます。 プロビジョニング済みスループット (PTU) は、これら 3 つのモデルで引き続き使用できます。
カスタム モデル (独自のモデルを持ち込む)
カタログモデルに加えて、Foundry の Fireworks は、カスタムモデルの重みのインポートおよび展開をサポートしています。 この BYOM 機能を使用すると、最適化された花火 クラウドによって提供される推論を使用して、Foundry エコシステム内で独自または微調整されたオープンウェイト モデルを実行できます。
サポートされているモデル アーキテクチャ
カスタム モデルは、次のサポートされているアーキテクチャのいずれかに基づいている必要があります。
- キミ (K2、K2.5、K2.6)
- GLM (4.7、4.8)
- OpenAI (gpt-oss-120b)
- Qwen (qwen3.5-9B, qwen3.5-35B-A3B, qwen3.5-112B-A10B, qwen3.5-397B)
制限
-
CLI 優先ワークフロー。 インポート プロセスでは、Azure Developer CLI (
azd) を使用します。 Foundry ポータルでは、アップロード後のモデルの登録、表示、デプロイがサポートされます。 - 現在、花火 エージェントとエージェント ビルダーのワークフロー はサポートされていません。
詳細な手順については、「 カスタム モデルを Foundry にインポートする」を参照してください。
データのプライバシー
Foundry で花火を使用する場合、データは Microsoft と Fireworks AI の間で共有され、さまざまなコンプライアンスとデータ処理ルールが適用されます。 詳細については、以下を参照してください。 お客様は、Microsoftと花火の間のデータ共有が組織のコンプライアンス要件に適しているかどうかを評価する責任があります。
Foundry の花火は現在、EU データ境界コミットメントから除外されています。
FedRAMP は、Foundry の花火では達成されません。 組織で FedRAMP が必要な場合は、使用前に承認担当者に問い合わせて、Foundry での花火の使用が許可されているかどうかを確認してください。
Payment Card Industry (PCI) Data Security Standard (DSS) は、Foundry の花火には適用されません。 Foundry の花火を使用して、支払いデータとカード所有者データを格納、処理、または送信しないでください。
透明度に関するメモ
Foundryプラットフォームサービスの「Fireworks on Foundry」により、お客様はサードパーティおよびオープンソースのAIモデルをデプロイして運用できます。
- Microsoftは、FoundryからFireworksを通じてデプロイされたモデルの安全性、セキュリティ、責任あるAI特性を開発、トレーニング、微調整、または評価しません。
- Microsoftでは、これらのモデルの動作、パフォーマンス、またはリスク プロファイルに関する表現はありません。
- お客様は、運用環境または顧客向けアプリケーションにモデルをデプロイする前に、必要な安全性、コンプライアンス、責任ある AI 評価の実行を含め、目的に合ったモデルの適合性を評価する責任を負います。
Foundry には、モデルの 独自のリスクと安全性評価 を実行するためのツールとベスト プラクティスが用意されています。
よく寄せられる質問
Fireworks on Foundryはアメリカ政府向けのAzureで利用可能ですか?
現時点では、Azure Government クラウドユーザーは Fireworks on Foundry サービスを利用することができません。
花火モデル展開のためのクォータを取得するにはどうすればいいですか?
クォータ要求 フォーム を使用して、Foundry の花火の追加クォータを要求します。
私はFireworks AIアカウントを持っています。 既存の Fireworks デプロイメントを使用できますか?
いいえ。Foundry で新しいデプロイを作成する必要があります。 消費をAzureに移行したい場合は、Fireworksのアカウントチームにお問い合わせください。
LoRA またはアダプター ベースのモデルをデプロイできますか?
LoRA のサポートはパブリック プレビュー段階です。 詳細については、カスタム Fireworks モデルのインポートを参照してください。 Foundry でトレーニングされた互換性のあるアダプターについては、Foundry で Fireworks を使用して微調整モデルをデプロイする(プレビュー)を参照してください。他の場所でトレーニングされたアダプターについては、インポート ガイドを使用してください。
カスタム モデルをインポートしてデプロイする方法
カスタム モデルのインポートでは、Azure Developer CLI を使用する CLI 優先ワークフローが使用されます。 詳細な手順については、「 カスタム モデルを Foundry にインポートする」を参照してください。
「Fireworks on Foundry」はどのように請求されますか?
Foundry を通じてデプロイされた花火 モデルでは、 トークンごとの支払い プランと プロビジョニング済みスループット オファーの両方がサポートされます。
Foundry プロジェクトで花火を無効にする方法
花火は、Azure サブスクリプション レベルで無効にすることができます。 手順に従って、Azure サブスクリプションの プレビュー機能の登録を解除 します。
Responses API を使用する方法
Responses API は、Foundry Projects API と SDK を介してサポートされています。 クライアントをプロジェクトの API エンドポイントにポイントするか、 Foundry SDK を使用してください。
Foundry で Fireworks のトラブルシューティングを行う
次のガイダンスを使用して、Foundry の花火に関する一般的な問題を解決します。
| 問題 | 解決方法 |
|---|---|
| プレビュー登録は "登録中" 状態のまま | 登録には最大 30 分かかる場合があります。 [プレビュー機能] ページを更新して、現在の状態を確認します。 30 分経っても状態が変わらない場合は、機能の登録を解除して再登録してみてください。 |
| 花火 モデルがモデル カタログに表示されない | プレビュー機能の状態にサブスクリプションの 登録済み と表示されていることを確認します。 サポートされているリージョンで作業していることを確認します。 |
| クォータ エラーでデプロイが失敗する | クォータ要求フォームを使用して、Foundry の花火の追加容量を要求します。 |
| デプロイ中に "禁止" またはアクセスが拒否されました | ID に Foundry プロジェクトの Azure AI Developer 以上のロールがあることを確認します。 サブスクリプション レベルのロールだけでは、デプロイには十分ではありません。 |
| モデル エンドポイントがデプロイ後にエラーを返す | プロジェクトの [デプロイ] ページで、デプロイの状態が [成功] と表示されていることを確認します。 デプロイの詳細から正しい ターゲット URI と キー を使用していることを確認します。 |
その他のクエリについては、 よく寄せられる質問のセクションを 参照してください。