Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
In dit artikel leest u hoe u kwantitatief kunt meten en de nauwkeurigheid van de basisspraak naar tekstmodel of uw eigen aangepaste modellen kunt verbeteren. Als u de nauwkeurigheid wilt testen, hebt u audio- en mensgelabelde transcriptgegevens nodig. Geef 30 minuten tot 5 uur representatieve audio op.
Belangrijk
Bij het testen voert het systeem een transcriptie uit. Dit is belangrijk om rekening mee te houden, omdat de prijzen per serviceaanbod en abonnementsniveau variëren. Raadpleeg altijd de officiële prijzen van Foundry Tools voor de meest recente details.
Een test maken
Aanbeveling
Breng uw aangepaste spraakmodellen van Speech Studio naar de Microsoft Foundry-portal. In de Microsoft Foundry-portal kunt u verder gaan waar u was gebleven door verbinding te maken met uw bestaande Spraak-resource. Zie Verbinding maken met een bestaande Spraak-resource voor meer informatie over het maken van verbinding met een bestaande Spraak-resource.
U kunt de nauwkeurigheid van uw aangepaste model testen door een test te maken. Een test vereist een verzameling audiobestanden en de bijbehorende transcripties. U kunt de nauwkeurigheid van een aangepast model vergelijken met een spraak-naar-tekstbasismodel of een ander aangepast model. Nadat u de testresultaten hebt opgehaald , evalueert u de foutfrequentie van het woord (WER) in vergelijking met spraakherkenningsresultaten.
Nadat u gegevenssets voor training en testen hebt geüpload, kunt u een test maken.
In de nieuwe Microsoft Foundry-portal maakt u geen afzonderlijke nauwkeurigheidstest. De nauwkeurigheidsevaluatie wordt automatisch uitgevoerd op basis van de validatiegegevensset die u hebt opgegeven in het deelvenster Validatiegegevens van de wizard Een model verfijnen . Zie Testresultaten ophalen om de nauwkeurigheidsscores weer te geven.
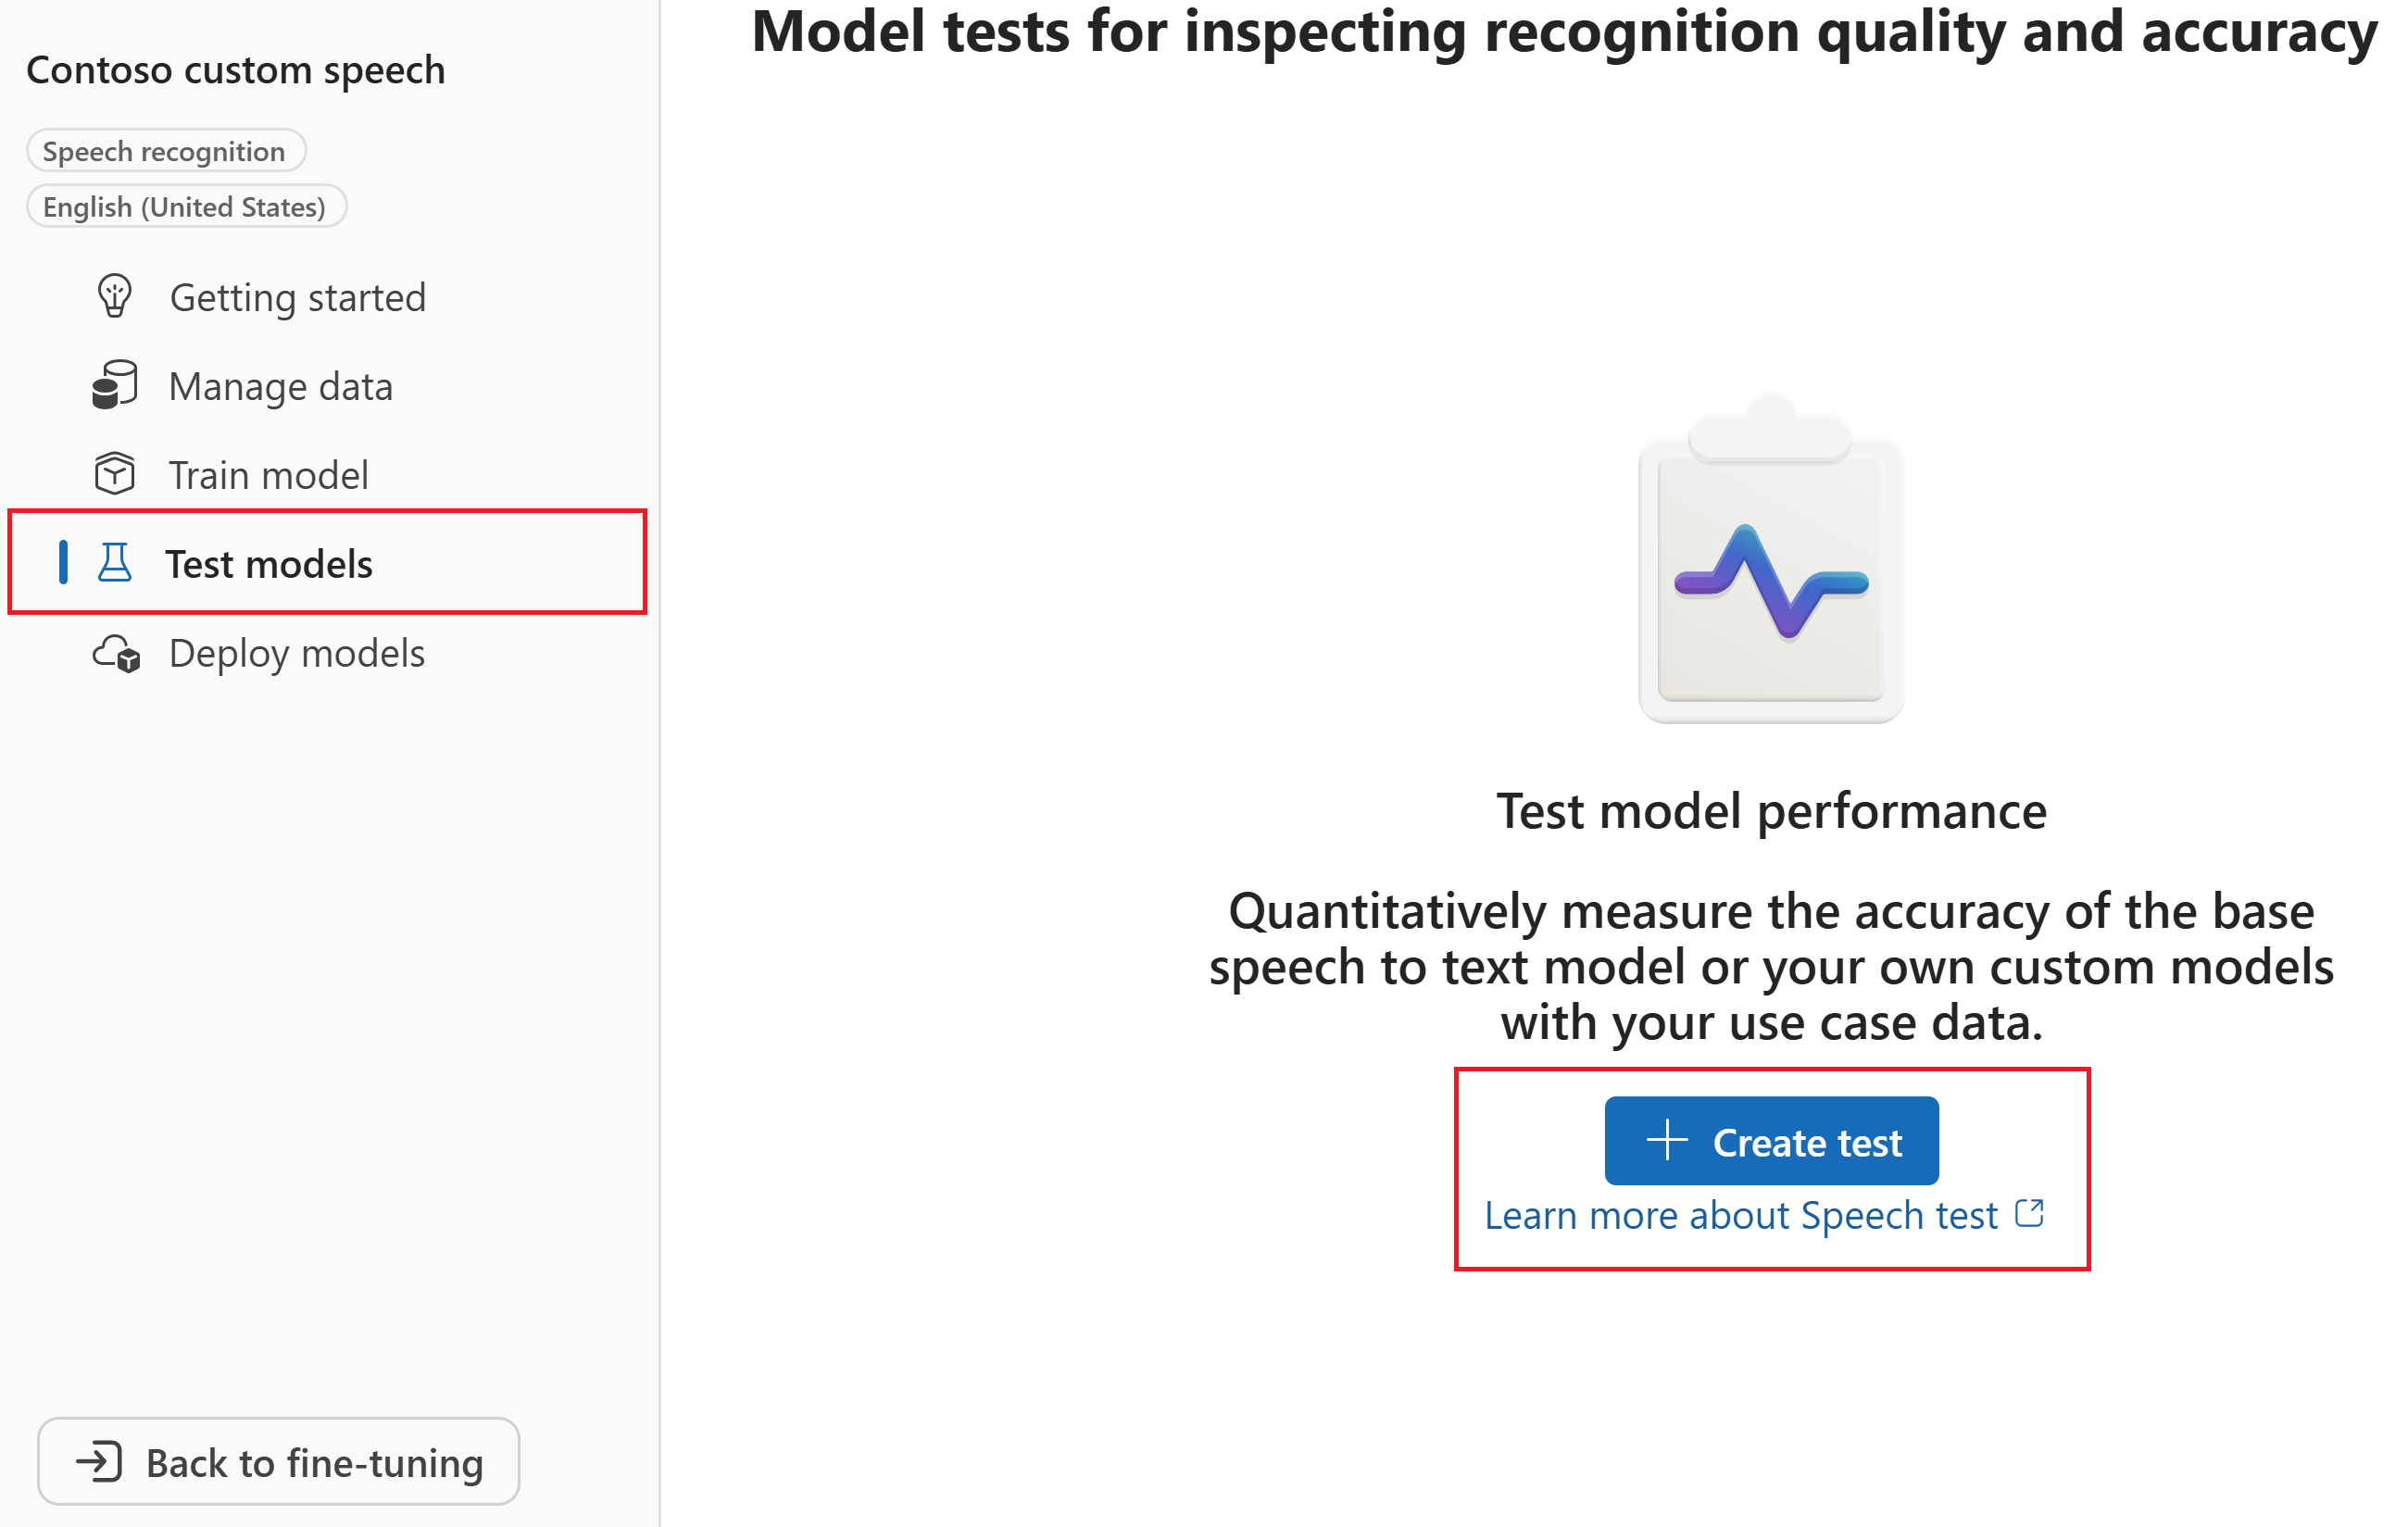
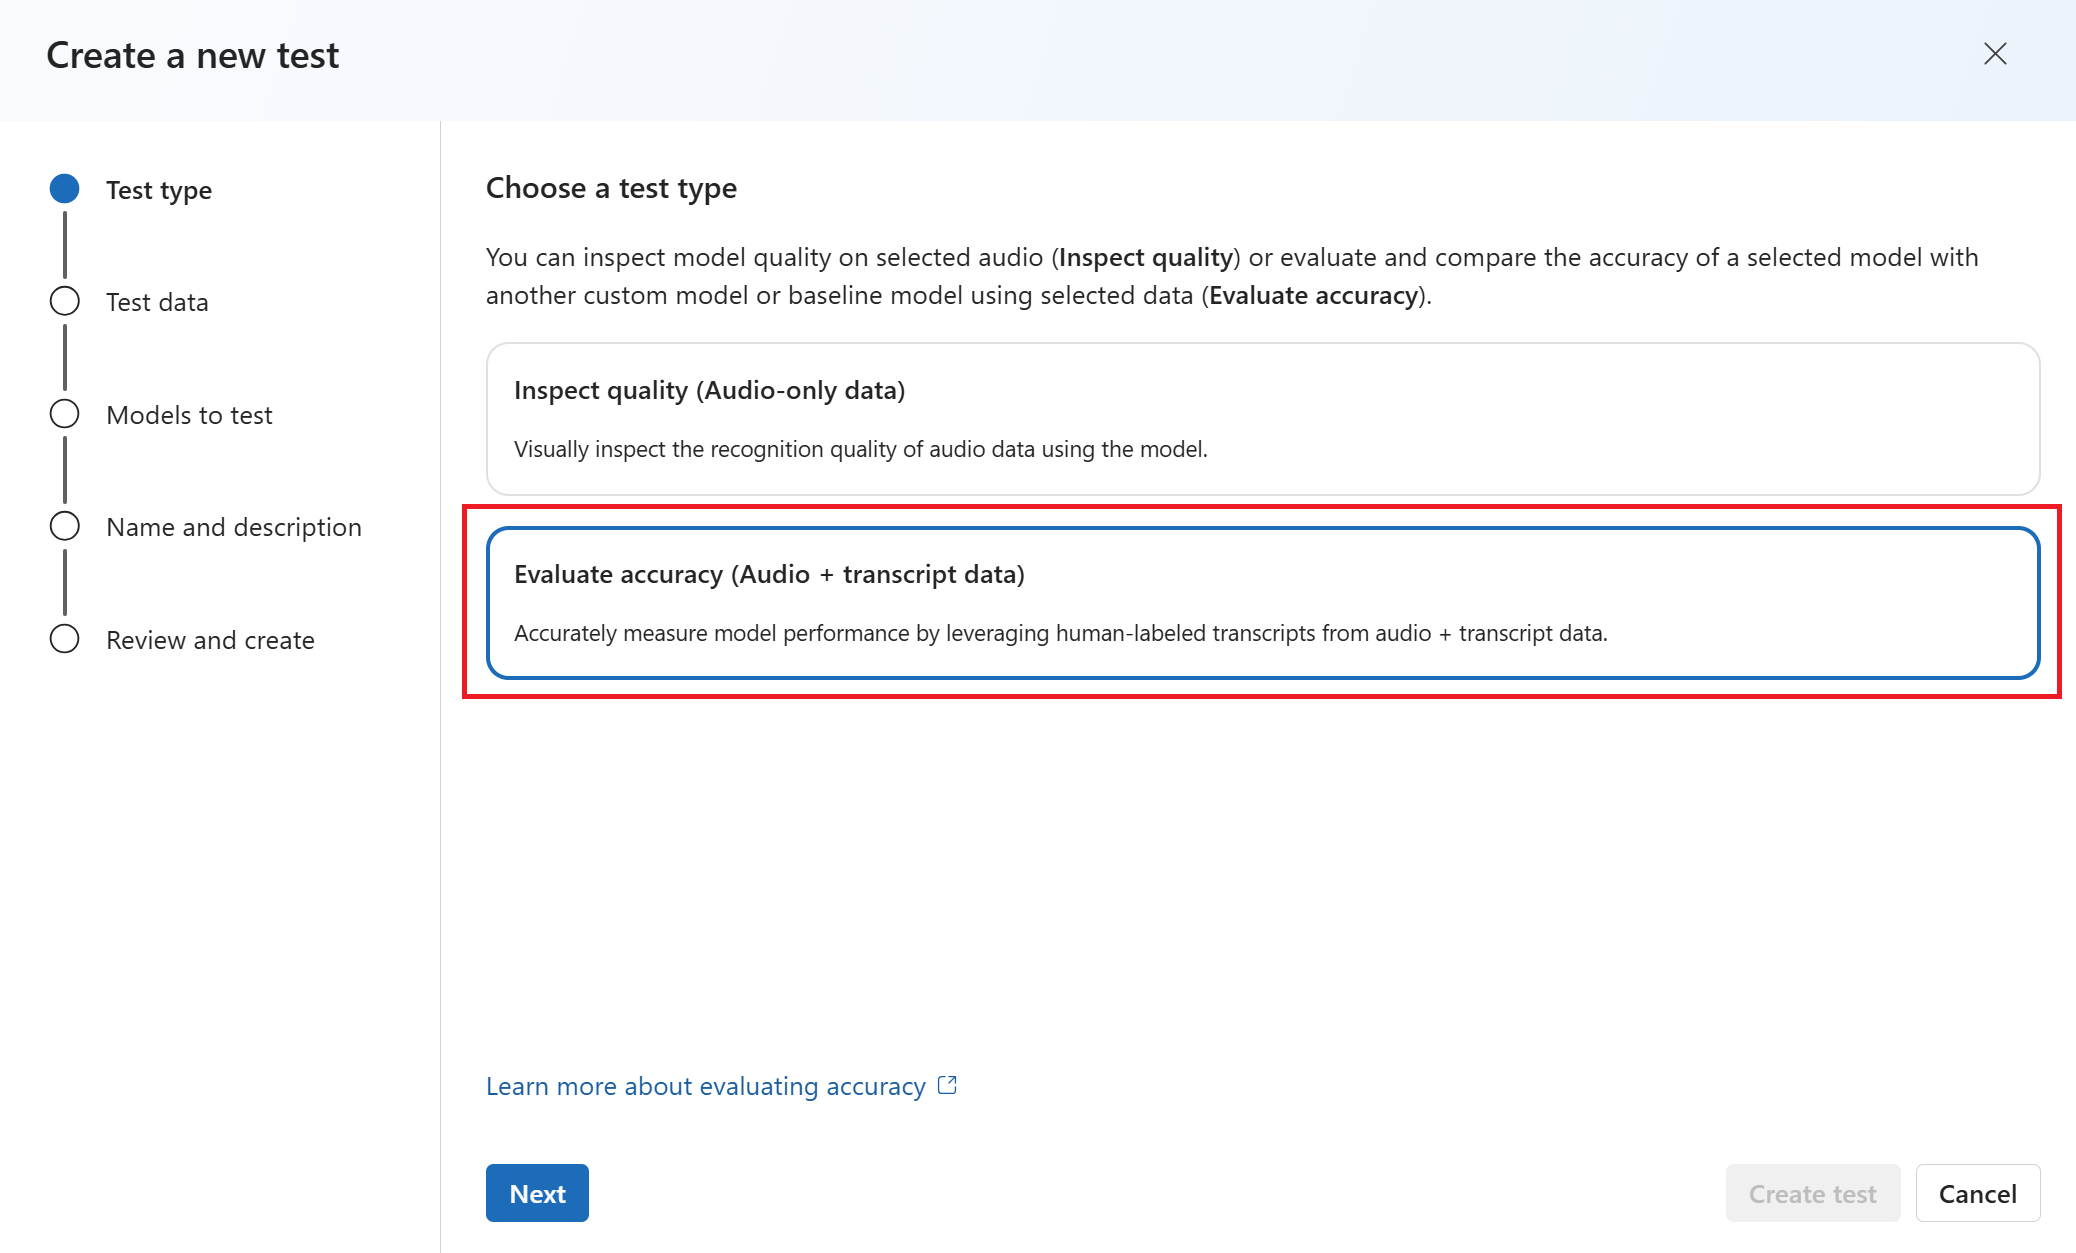
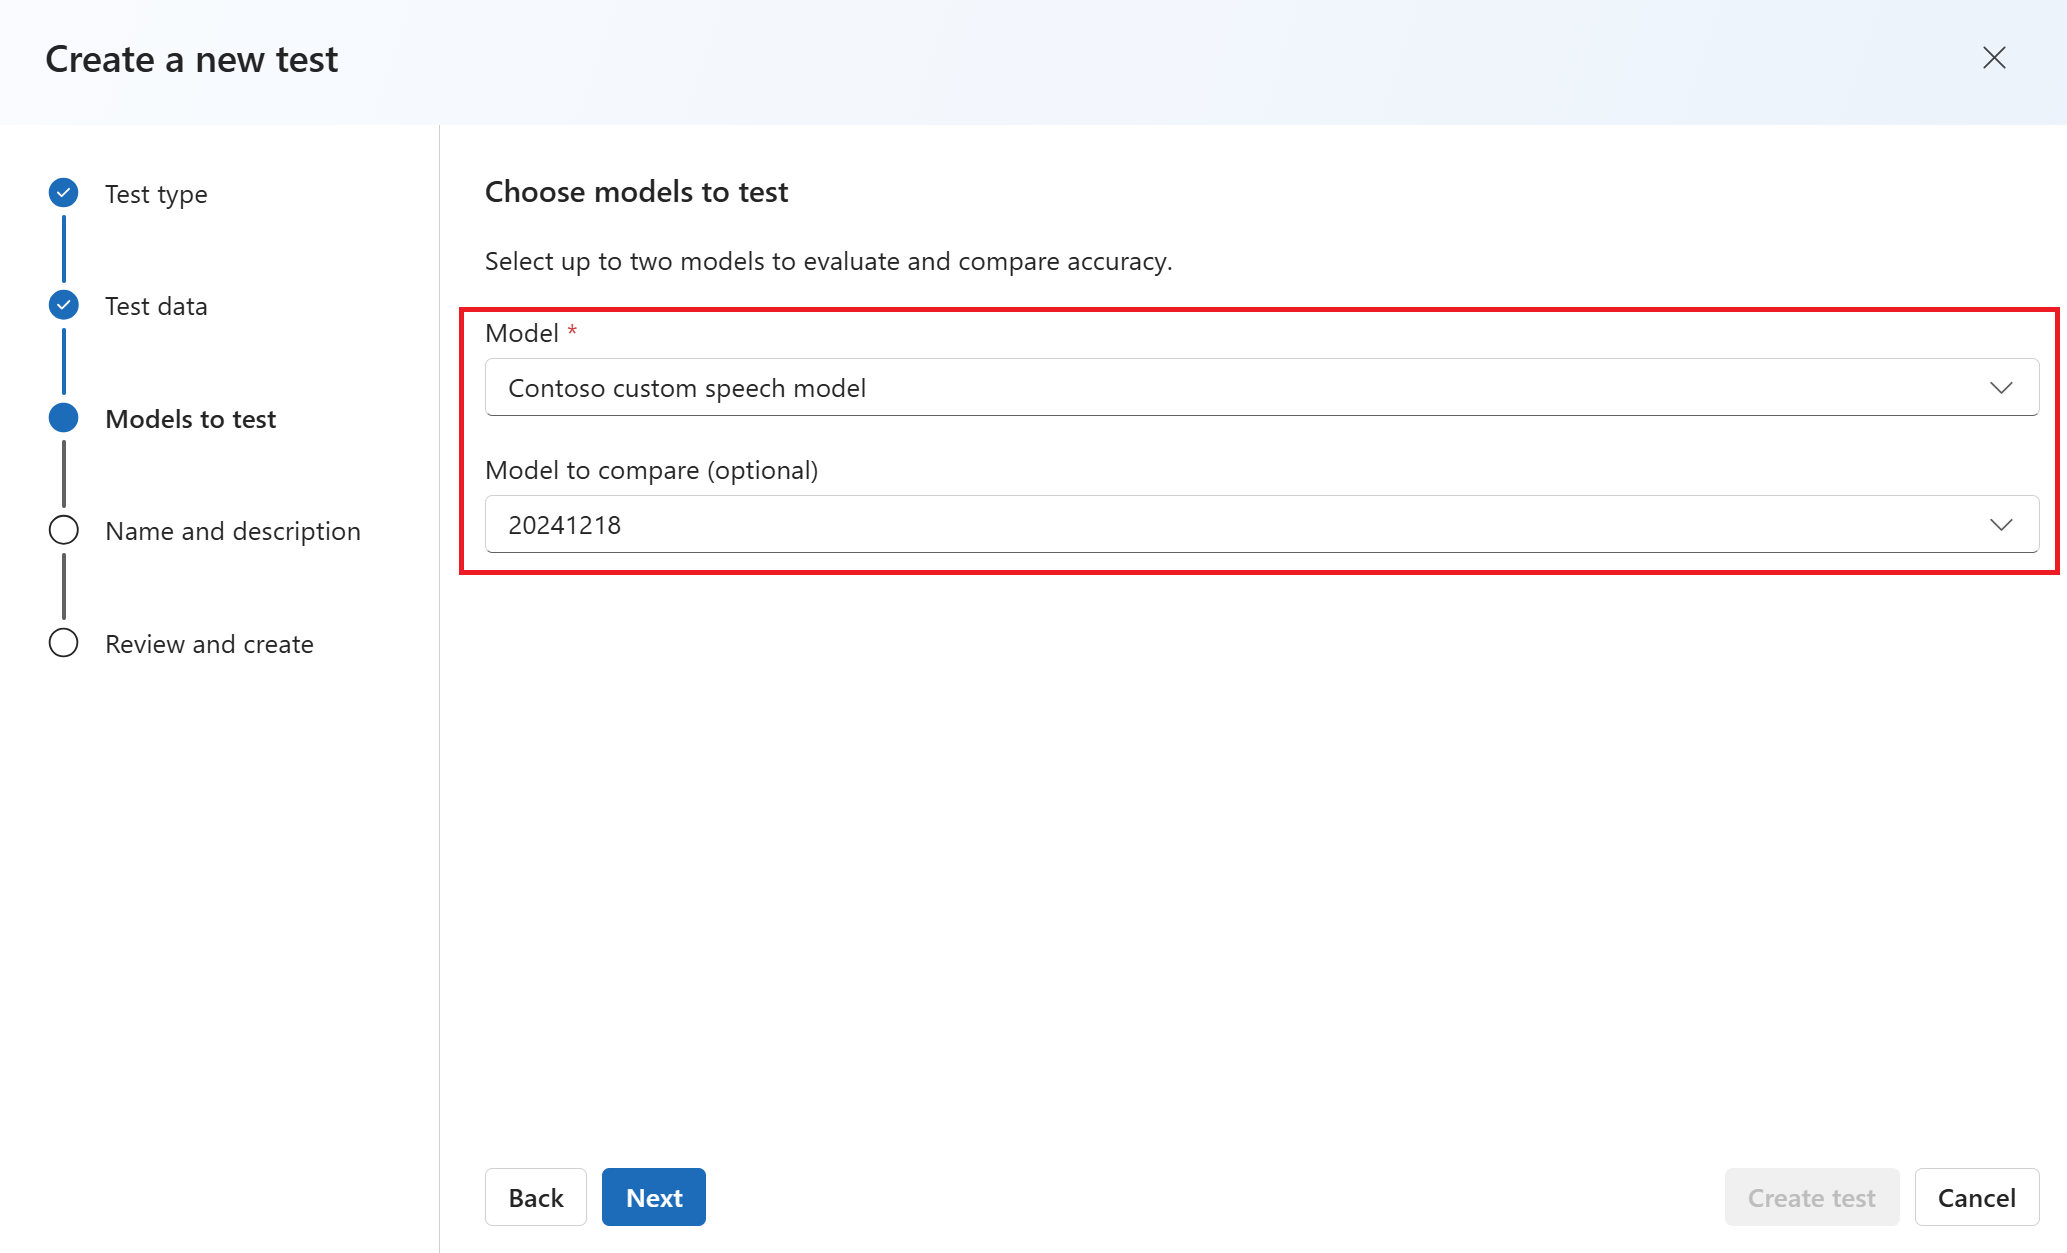
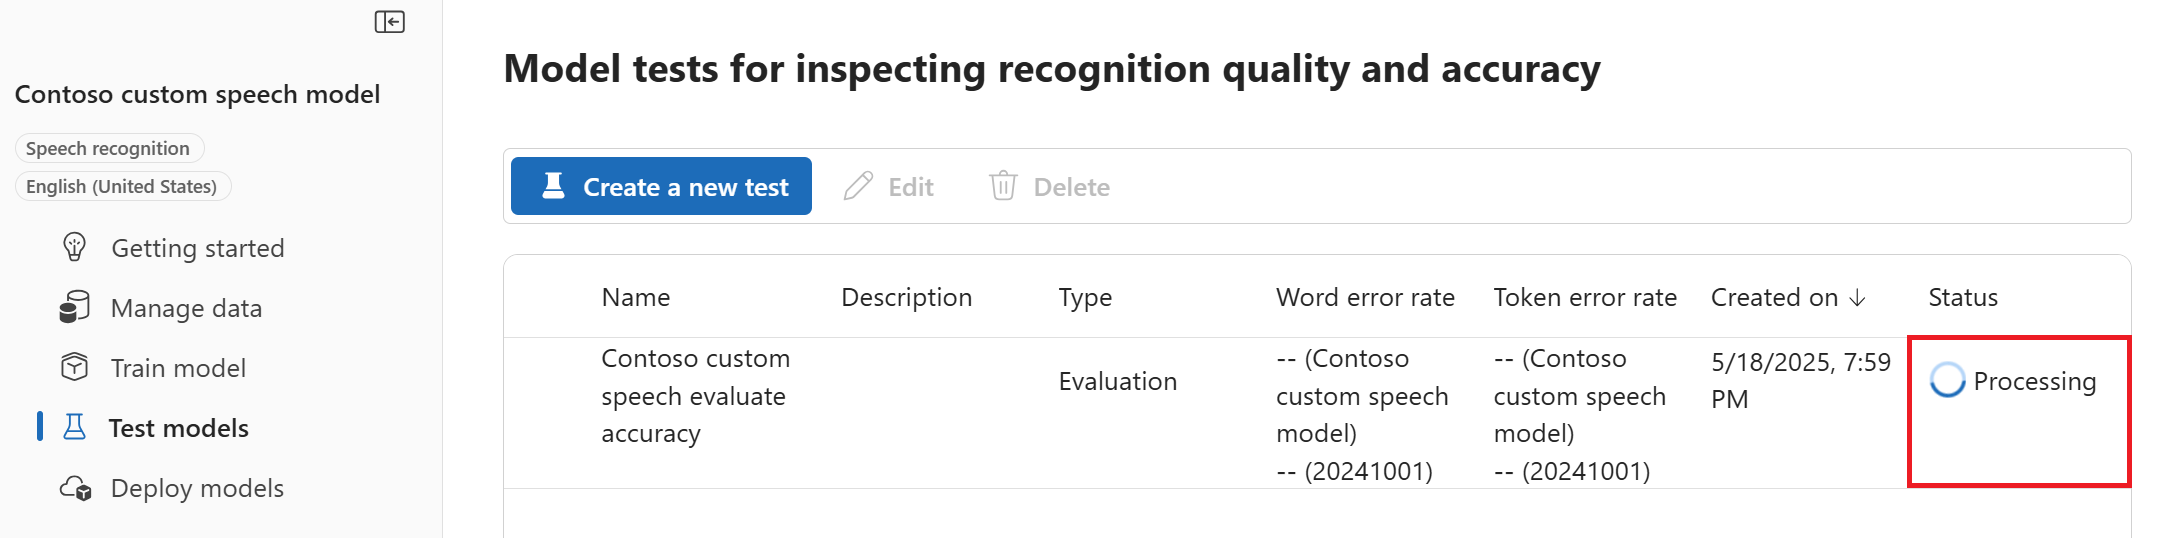
Volg deze stappen om een nauwkeurigheidstest te maken:
Meld u aan bij Speech Studio.
Selecteer Aangepaste spraak> de naam van uw project >Testmodellen.
Selecteer Nieuwe test maken.
Selecteer Nauwkeurigheid evalueren>Volgende.
Selecteer één audio- en gegevensset met door mensen gelabelde transcripties en selecteer vervolgens Volgende. Als er geen gegevenssets beschikbaar zijn, annuleert u de installatie en gaat u naar het menu Spraakgegevenssets om gegevenssets te uploaden.
Notitie
Het is belangrijk dat u een akoestische gegevensset selecteert die verschilt van de gegevensset die u met uw model hebt gebruikt. Deze benadering kan een realistischer beeld bieden van de prestaties van het model.
Selecteer maximaal twee modellen die u wilt evalueren en selecteer vervolgens Volgende.
Voer de testnaam en beschrijving in en selecteer Vervolgens.
Controleer de testdetails en selecteer Opslaan en sluiten.
Voordat u doorgaat, moet u ervoor zorgen dat de Speech CLI is geïnstalleerd en geconfigureerd.
Gebruik de spx csr evaluation create opdracht om een test te maken. Bouw de aanvraagparameters volgens de volgende instructies:
- Stel de
projecteigenschap in op de id van een bestaand project. Deprojecteigenschap wordt aanbevolen, zodat u ook het afstemmen van aangepaste spraak in de Microsoft Foundry-portal kunt beheren. Zie de documentatie 'De project-id ophalen voor de REST API' voor instructies om de project-id op te halen. - Stel de vereiste eigenschap
model1in met de id van een model dat u wilt testen. - Stel de vereiste
model2eigenschap in op de id van een ander model dat u wilt testen. Als u geen twee modellen wilt vergelijken, gebruikt u hetzelfde model voor beidemodel1enmodel2. - Stel de vereiste
dataseteigenschap in op de id van een gegevensset die u voor de test wilt gebruiken. - Stel de
languageeigenschap in, anders stelt de Speech CLI standaard 'en-US' in. Deze parameter moet de locale van de inhoud van de dataset zijn. De taal- en regio-instelling kan later niet meer worden gewijzigd. De speech CLI-eigenschaplanguagekomt overeen met delocaleeigenschap in de JSON-aanvraag en het antwoord. - Stel de vereiste
nameeigenschap in. Deze parameter is de naam die wordt weergegeven in de Microsoft Foundry-portal. De speech CLI-eigenschapnamekomt overeen met dedisplayNameeigenschap in de JSON-aanvraag en het antwoord.
Hier volgt een voorbeeld van een Speech CLI-opdracht waarmee een test wordt gemaakt:
spx csr evaluation create --api-version v3.2 --project aaaabbbb-0000-cccc-1111-dddd2222eeee --dataset bbbbcccc-1111-dddd-2222-eeee3333ffff --model1 ccccdddd-2222-eeee-3333-ffff4444aaaa --model2 ddddeeee-3333-ffff-4444-aaaa5555bbbb --name "My Evaluation" --description "My Evaluation Description"
Belangrijk
Je moet --api-version v3.2 instellen. De Speech CLI maakt gebruik van de REST API, maar biedt nog geen ondersteuning voor versies later dan v3.2.
U ontvangt een antwoordtekst in de volgende indeling:
{
  "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/eeeeffff-4444-aaaa-5555-bbbb6666cccc",
  "model1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ddddeeee-3333-ffff-4444-aaaa5555bbbb"
  },
  "model2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ddddeeee-3333-ffff-4444-aaaa5555bbbb"
  },
  "dataset": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/datasets/bbbbcccc-1111-dddd-2222-eeee3333ffff"
  },
  "transcription2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/ffffaaaa-5555-bbbb-6666-cccc7777dddd"
  },
  "transcription1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/ffffaaaa-5555-bbbb-6666-cccc7777dddd"
  },
  "project": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/projects/aaaabbbb-0000-cccc-1111-dddd2222eeee"
  },
  "links": {
    "files": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/dda6e880-6ccd-49dc-b277-137565cbaa38/files"
  },
  "properties": {
    "wordErrorRate1": -1.0,
    "sentenceErrorRate1": -1.0,
    "sentenceCount1": -1,
    "wordCount1": -1,
    "correctWordCount1": -1,
    "wordSubstitutionCount1": -1,
    "wordDeletionCount1": -1,
    "wordInsertionCount1": -1,
    "wordErrorRate2": -1.0,
    "sentenceErrorRate2": -1.0,
    "sentenceCount2": -1,
    "wordCount2": -1,
    "correctWordCount2": -1,
    "wordSubstitutionCount2": -1,
    "wordDeletionCount2": -1,
    "wordInsertionCount2": -1
  },
  "lastActionDateTime": "2024-07-14T21:31:14Z",
  "status": "NotStarted",
  "createdDateTime": "2024-07-14T21:31:14Z",
  "locale": "en-US",
  "displayName": "My Evaluation",
  "description": "My Evaluation Description",
  "customProperties": {
    "testingKind": "Evaluation"
  }
}
De eigenschap self op het hoogste niveau in de hoofdtekst van het antwoord is de URI van de evaluatie. Gebruik deze URI voor meer informatie over het project en de testresultaten. U gebruikt deze URI ook om de evaluatie bij te werken of te verwijderen.
Voer de volgende opdracht uit voor Speech CLI-hulp bij evaluaties:
spx help csr evaluation
Als u een test wilt maken, gebruikt u de Evaluations_Create bewerking van de REST API voor spraak-naar-tekst. Stel de hoofdtekst van de aanvraag op volgens de volgende instructies:
- Stel de
projecteigenschap in op de id van een bestaand project. Deprojecteigenschap wordt aanbevolen, zodat u ook het afstemmen van aangepaste spraak in de Microsoft Foundry-portal kunt beheren. Zie de documentatie 'De project-id ophalen voor de REST API' voor instructies om de project-id op te halen. - Stel de
testingKindeigenschap in opEvaluationbinnencustomProperties. Als u dit niet opgeeftEvaluation, wordt de test behandeld als een kwaliteitsinspectietest. Of detestingKindeigenschap is ingesteld opEvaluation,Inspectionof niet is ingesteld, u hebt toegang tot de nauwkeurigheidsscores via de API, maar niet in de Microsoft Foundry-portal. - Stel de vereiste
model1eigenschap in op de URI van een model dat u wilt testen. - Stel de vereiste
model2eigenschap in op de URI van een ander model dat u wilt testen. Als u geen twee modellen wilt vergelijken, gebruikt u hetzelfde model voor beidemodel1enmodel2. - Stel de vereiste
dataseteigenschap in op de URI van een gegevensset die u voor de test wilt gebruiken. - Stel de vereiste
localeeigenschap in. Deze eigenschap moet de locale van de inhoud van de dataset zijn. De taal- en regio-instelling kan later niet meer worden gewijzigd. - Stel de vereiste
displayNameeigenschap in. Deze eigenschap is de naam die wordt weergegeven in de Microsoft Foundry-portal.
Maak een HTTP POST-aanvraag met behulp van de URI, zoals wordt weergegeven in het volgende voorbeeld. Vervang door YourSpeechResoureKey uw Spraak-resourcesleutel, vervang deze door YourResourceName de naam van de Spraak-resource en stel de eigenschappen van de aanvraagbody in zoals eerder beschreven.
curl -v -X POST -H "Ocp-Apim-Subscription-Key: YourSpeechResoureKey" -H "Content-Type: application/json" -d '{
  "model1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/ddddeeee-3333-ffff-4444-aaaa5555bbbb"
  },
  "model2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ddddeeee-3333-ffff-4444-aaaa5555bbbb"
  },
  "dataset": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/datasets/bbbbcccc-1111-dddd-2222-eeee3333ffff"
  },
  "project": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/projects/aaaabbbb-0000-cccc-1111-dddd2222eeee"
  },
  "displayName": "My Evaluation",
  "description": "My Evaluation Description",
  "customProperties": {
    "testingKind": "Evaluation"
  },
  "locale": "en-US"
}'  "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations"
U ontvangt een antwoordtekst in de volgende indeling:
{
  "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/eeeeffff-4444-aaaa-5555-bbbb6666cccc",
  "model1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ddddeeee-3333-ffff-4444-aaaa5555bbbb"
  },
  "model2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ddddeeee-3333-ffff-4444-aaaa5555bbbb"
  },
  "dataset": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/datasets/bbbbcccc-1111-dddd-2222-eeee3333ffff"
  },
  "transcription2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/ffffaaaa-5555-bbbb-6666-cccc7777dddd"
  },
  "transcription1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/ffffaaaa-5555-bbbb-6666-cccc7777dddd"
  },
  "project": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/projects/aaaabbbb-0000-cccc-1111-dddd2222eeee"
  },
  "links": {
    "files": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/dda6e880-6ccd-49dc-b277-137565cbaa38/files"
  },
  "properties": {
    "wordErrorRate1": -1.0,
    "sentenceErrorRate1": -1.0,
    "sentenceCount1": -1,
    "wordCount1": -1,
    "correctWordCount1": -1,
    "wordSubstitutionCount1": -1,
    "wordDeletionCount1": -1,
    "wordInsertionCount1": -1,
    "wordErrorRate2": -1.0,
    "sentenceErrorRate2": -1.0,
    "sentenceCount2": -1,
    "wordCount2": -1,
    "correctWordCount2": -1,
    "wordSubstitutionCount2": -1,
    "wordDeletionCount2": -1,
    "wordInsertionCount2": -1
  },
  "lastActionDateTime": "2024-07-14T21:31:14Z",
  "status": "NotStarted",
  "createdDateTime": "2024-07-14T21:31:14Z",
  "locale": "en-US",
  "displayName": "My Evaluation",
  "description": "My Evaluation Description",
  "customProperties": {
    "testingKind": "Evaluation"
  }
}
De eigenschap self op het hoogste niveau in de hoofdtekst van het antwoord is de URI van de evaluatie. Gebruik deze URI om details op te halen over het project van de evaluatie en de testresultaten. U gebruikt deze URI ook om de evaluatie bij te werken of te verwijderen.
Testresultaten ophalen
Haal de testresultaten op en evalueer het woordfoutpercentage (WER) in vergelijking met spraakherkenningsresultaten.
Nadat de training is voltooid, selecteert u het aangepaste model om de detailpagina te openen en selecteert u vervolgens het tabblad Validaties om de nauwkeurigheidsscores weer te geven.
Volg deze stappen om testresultaten op te halen:
- Meld u aan bij Speech Studio.
- Selecteer Aangepaste spraak> de naam van uw project >Testmodellen.
- Selecteer de link op basis van de testnaam.
- Nadat de test is voltooid, zoals aangegeven door de status die is ingesteld op Geslaagd, ziet u resultaten met het WER-nummer voor elk getest model.
Op deze pagina worden alle uitingen in uw gegevensset en de herkenningsresultaten weergegeven, samen met de transcriptie van de ingediende gegevensset. U kunt verschillende fouttypen in- of uitschakelen, waaronder invoegen, verwijderen en vervangen. Door naar de audio te luisteren en de herkenningsresultaten in elke kolom te vergelijken, kunt u bepalen welk model aan uw behoeften voldoet en bepalen waar meer training en verbeteringen nodig zijn.
Voordat u doorgaat, moet u ervoor zorgen dat de Speech CLI is geïnstalleerd en geconfigureerd.
Gebruik de spx csr evaluation status opdracht om testresultaten op te halen. Bouw de aanvraagparameters volgens de volgende instructies:
- Stel de vereiste eigenschap in
evaluationop de ID van de evaluatie waarvoor u testresultaten wilt ophalen.
Hier volgt een voorbeeld van een Speech CLI-opdracht waarmee testresultaten worden opgehaald:
spx csr evaluation status --api-version v3.2 --evaluation aaaabbbb-6666-cccc-7777-dddd8888eeee
Belangrijk
Je moet --api-version v3.2 instellen. De Speech CLI maakt gebruik van de REST API, maar biedt nog geen ondersteuning voor versies later dan v3.2.
De woordfoutpercentages en meer details worden geretourneerd in de hoofdtekst van de respons.
U ontvangt een antwoordtekst in de volgende indeling:
{
  "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/eeeeffff-4444-aaaa-5555-bbbb6666cccc",
  "model1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ddddeeee-3333-ffff-4444-aaaa5555bbbb"
  },
  "model2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ddddeeee-3333-ffff-4444-aaaa5555bbbb"
  },
  "dataset": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/datasets/bbbbcccc-1111-dddd-2222-eeee3333ffff"
  },
  "transcription2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/ffffaaaa-5555-bbbb-6666-cccc7777dddd"
  },
  "transcription1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/ffffaaaa-5555-bbbb-6666-cccc7777dddd"
  },
  "project": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/projects/aaaabbbb-0000-cccc-1111-dddd2222eeee"
  },
  "links": {
    "files": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/dda6e880-6ccd-49dc-b277-137565cbaa38/files"
  },
  "properties": {
    "wordErrorRate1": 0.028900000000000002,
    "sentenceErrorRate1": 0.667,
    "tokenErrorRate1": 0.12119999999999999,
    "sentenceCount1": 3,
    "wordCount1": 173,
    "correctWordCount1": 170,
    "wordSubstitutionCount1": 2,
    "wordDeletionCount1": 1,
    "wordInsertionCount1": 2,
    "tokenCount1": 165,
    "correctTokenCount1": 145,
    "tokenSubstitutionCount1": 10,
    "tokenDeletionCount1": 1,
    "tokenInsertionCount1": 9,
    "tokenErrors1": {
      "punctuation": {
        "numberOfEdits": 4,
        "percentageOfAllEdits": 20.0
      },
      "capitalization": {
        "numberOfEdits": 2,
        "percentageOfAllEdits": 10.0
      },
      "inverseTextNormalization": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      },
      "lexical": {
        "numberOfEdits": 12,
        "percentageOfAllEdits": 12.0
      },
      "others": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      }
    },
    "wordErrorRate2": 0.028900000000000002,
    "sentenceErrorRate2": 0.667,
    "tokenErrorRate2": 0.12119999999999999,
    "sentenceCount2": 3,
    "wordCount2": 173,
    "correctWordCount2": 170,
    "wordSubstitutionCount2": 2,
    "wordDeletionCount2": 1,
    "wordInsertionCount2": 2,
    "tokenCount2": 165,
    "correctTokenCount2": 145,
    "tokenSubstitutionCount2": 10,
    "tokenDeletionCount2": 1,
    "tokenInsertionCount2": 9,
    "tokenErrors2": {
      "punctuation": {
        "numberOfEdits": 4,
        "percentageOfAllEdits": 20.0
      },
      "capitalization": {
        "numberOfEdits": 2,
        "percentageOfAllEdits": 10.0
      },
      "inverseTextNormalization": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      },
      "lexical": {
        "numberOfEdits": 12,
        "percentageOfAllEdits": 12.0
      },
      "others": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      }
    }
  },
  "lastActionDateTime": "2024-07-14T21:31:22Z",
  "status": "Succeeded",
  "createdDateTime": "2024-07-14T21:31:14Z",
  "locale": "en-US",
  "displayName": "My Evaluation",
  "description": "My Evaluation Description",
  "customProperties": {
    "testingKind": "Evaluation"
  }
}
Voer de volgende opdracht uit voor Speech CLI-hulp bij evaluaties:
spx help csr evaluation
Als u testresultaten wilt ophalen, begint u met de Evaluations_Get bewerking van de REST API voor spraak-naar-tekst.
Maak een HTTP GET-aanvraag met behulp van de URI, zoals wordt weergegeven in het volgende voorbeeld. Vervang YourEvaluationId door uw evaluatie-id, vervang YourSpeechResoureKey door uw Speech-resourcesleutel en vervang YourResourceName door uw Speech-resourcenaam.
curl -v -X GET "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/YourEvaluationId" -H "Ocp-Apim-Subscription-Key: YourSpeechResoureKey"
De woordfoutpercentages en meer details worden geretourneerd in de hoofdtekst van de respons.
U ontvangt een antwoordtekst in de volgende indeling:
{
  "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/eeeeffff-4444-aaaa-5555-bbbb6666cccc",
  "model1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ddddeeee-3333-ffff-4444-aaaa5555bbbb"
  },
  "model2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/models/base/ddddeeee-3333-ffff-4444-aaaa5555bbbb"
  },
  "dataset": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/datasets/bbbbcccc-1111-dddd-2222-eeee3333ffff"
  },
  "transcription2": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/ffffaaaa-5555-bbbb-6666-cccc7777dddd"
  },
  "transcription1": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/transcriptions/ffffaaaa-5555-bbbb-6666-cccc7777dddd"
  },
  "project": {
    "self": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/projects/aaaabbbb-0000-cccc-1111-dddd2222eeee"
  },
  "links": {
    "files": "https://YourResourceName.cognitiveservices.azure.com/speechtotext/v3.2/evaluations/dda6e880-6ccd-49dc-b277-137565cbaa38/files"
  },
  "properties": {
    "wordErrorRate1": 0.028900000000000002,
    "sentenceErrorRate1": 0.667,
    "tokenErrorRate1": 0.12119999999999999,
    "sentenceCount1": 3,
    "wordCount1": 173,
    "correctWordCount1": 170,
    "wordSubstitutionCount1": 2,
    "wordDeletionCount1": 1,
    "wordInsertionCount1": 2,
    "tokenCount1": 165,
    "correctTokenCount1": 145,
    "tokenSubstitutionCount1": 10,
    "tokenDeletionCount1": 1,
    "tokenInsertionCount1": 9,
    "tokenErrors1": {
      "punctuation": {
        "numberOfEdits": 4,
        "percentageOfAllEdits": 20.0
      },
      "capitalization": {
        "numberOfEdits": 2,
        "percentageOfAllEdits": 10.0
      },
      "inverseTextNormalization": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      },
      "lexical": {
        "numberOfEdits": 12,
        "percentageOfAllEdits": 12.0
      },
      "others": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      }
    },
    "wordErrorRate2": 0.028900000000000002,
    "sentenceErrorRate2": 0.667,
    "tokenErrorRate2": 0.12119999999999999,
    "sentenceCount2": 3,
    "wordCount2": 173,
    "correctWordCount2": 170,
    "wordSubstitutionCount2": 2,
    "wordDeletionCount2": 1,
    "wordInsertionCount2": 2,
    "tokenCount2": 165,
    "correctTokenCount2": 145,
    "tokenSubstitutionCount2": 10,
    "tokenDeletionCount2": 1,
    "tokenInsertionCount2": 9,
    "tokenErrors2": {
      "punctuation": {
        "numberOfEdits": 4,
        "percentageOfAllEdits": 20.0
      },
      "capitalization": {
        "numberOfEdits": 2,
        "percentageOfAllEdits": 10.0
      },
      "inverseTextNormalization": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      },
      "lexical": {
        "numberOfEdits": 12,
        "percentageOfAllEdits": 12.0
      },
      "others": {
        "numberOfEdits": 1,
        "percentageOfAllEdits": 5.0
      }
    }
  },
  "lastActionDateTime": "2024-07-14T21:31:22Z",
  "status": "Succeeded",
  "createdDateTime": "2024-07-14T21:31:14Z",
  "locale": "en-US",
  "displayName": "My Evaluation",
  "description": "My Evaluation Description",
  "customProperties": {
    "testingKind": "Evaluation"
  }
}
Foutpercentage van woorden evalueren (WER)
De industriestandaard voor het meten van modelnauwkeurigheid is woordfoutpercentage (WER). WER telt het aantal onjuiste woorden dat tijdens de herkenning is geïdentificeerd en deelt de som door het totale aantal woorden dat is opgegeven in het door mensen gelabelde transcriptie (N).
Onjuist geïdentificeerde woorden vallen in drie categorieën:
- Invoeging (I): Woorden die onjuist zijn toegevoegd aan de hypothesetranscriptie
- Verwijdering (D): woorden die niet zijn gedetecteerd in de hypothesetranscriptie
- Vervanging (S): Woorden die werden vervangen tussen referentie en hypothese
In de Microsoft Foundry-portal en Speech Studio wordt het quotiënt vermenigvuldigd met 100 en weergegeven als een percentage. De resultaten van de Speech CLI en REST API worden niet vermenigvuldigd met 100.
$$ WER = {{I+D+S}\over N} \times 100 $$
Hier volgt een voorbeeld waarin onjuist geïdentificeerde woorden worden weergegeven, in vergelijking met het door mensen gelabelde transcript:
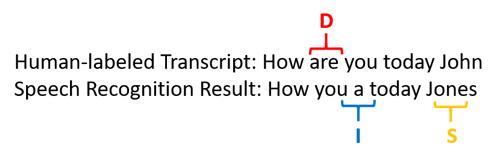
Het resultaat van spraakherkenning is als volgt mislukt:
- Invoeging (I): Het woord 'a' toegevoegd
- Verwijdering (D): Het woord 'are' verwijderd
- Vervanging (S): Vervangt het woord 'Jones' voor 'John'
Het woordfoutpercentage uit het vorige voorbeeld is 60%.
Als u WER-metingen lokaal wilt repliceren, kunt u het sclite-hulpprogramma van de NIST Scoring Toolkit (SCTK) gebruiken.
Fouten oplossen en WER verbeteren
U kunt de WER-berekening van de resultaten van machineherkenning gebruiken om de kwaliteit te evalueren van het model dat u gebruikt met uw app, hulpprogramma of product. Een WER van 5-10% wordt beschouwd als goede kwaliteit en is klaar voor gebruik. Een WER van 20% is acceptabel, maar misschien wilt u meer training overwegen. Een WER van 30% of meer duidt op slechte kwaliteit en vereist maatwerk en training.
Hoe de fouten worden gedistribueerd, is belangrijk. Wanneer er veel verwijderingsfouten optreden, komt dit meestal door zwakke geluidssignaalsterkte. U kunt dit probleem oplossen door audiogegevens dichter bij de bron te verzamelen. Invoegfouten betekenen dat de audio is opgenomen in een lawaaierige omgeving en crosstalk mogelijk aanwezig is, wat herkenningsproblemen veroorzaakt. Vervangingsfouten treden vaak op wanneer een onvoldoende voorbeeld van domeinspecifieke termen wordt verstrekt als transcripties met menselijk label of gerelateerde tekst.
Door afzonderlijke bestanden te analyseren, kunt u bepalen welk type fouten er bestaan en welke fouten uniek zijn voor een specifiek bestand. Inzicht in problemen op bestandsniveau helpt u bij het doel van verbeteringen.
Foutpercentage van token evalueren (TER)
Naast woordfoutpercentage kunt u ook de uitgebreide meting van Token Error Rate (TER) gebruiken om de kwaliteit van de uiteindelijke end-to-endweergave te evalueren. Naast de lexicale notatie (That will cost $900. in plaats van that will cost nine hundred dollars), houdt TER rekening met de aspecten van de weergave-indeling, zoals interpunctie, hoofdlettergebruik en ITN. Zie Uitvoeropmaak weergeven met spraak-naar-tekst voor meer informatie.
TER telt het aantal onjuiste tokens dat tijdens de herkenning is geïdentificeerd en deelt de som door het totale aantal tokens dat is opgegeven in de transcriptie met menselijk label (N).
$$ TER = {{I+D+S}\over N} \times 100 $$
De formule voor TER-berekening is ook vergelijkbaar met WER. Het enige verschil is dat TER wordt berekend op basis van het tokenniveau in plaats van woordniveau.
- Invoeging (I): Tokens die onjuist zijn toegevoegd aan de hypothesetranscriptie
- Verwijdering (D): Tokens die niet zijn gedetecteerd in de hypothesetranscriptie
- Vervanging (S): Tokens die zijn vervangen tussen referentie en hypothese
In een praktijk kunt u zowel WER- als TER-resultaten analyseren om de gewenste verbeteringen te verkrijgen.
Notitie
Als u TER wilt meten, moet u ervoor zorgen dat de audio - en transcriptietestgegevens transcripties bevatten met weergaveopmaak, zoals interpunctie, hoofdlettergebruik en ITN.
Voorbeeldscenarioresultaten
Spraakherkenningsscenario's variëren per audiokwaliteit en taal (vocabulaire en spreekstijl). In de volgende tabel worden vier veelvoorkomende scenario's onderzocht:
| Scenariobeschrijving | Audiokwaliteit | Woordenschat | Spreekstijl |
|---|---|---|---|
| Callcenter | Laag, 8 kHz, kan twee sprekers op één audiokanaal bevatten, kan gecomprimeerd zijn | Smal, uniek voor domein en producten | Conversationeel, losjes gestructureerd |
| Spraakassistent, zoals Cortana of een doorrijdend venster | Hoog, 16 kHz | Rijk aan entiteiten (nummertitels, producten, locaties) | Duidelijk aangegeven woorden en woordgroepen |
| Dicteren (chatbericht, notities, zoeken) | Hoog, 16 kHz | Menigvoudig | Notities maken |
| Ondertiteling van video | Gevarieerd, inclusief gevarieerd microfoongebruik, toegevoegde muziek | Gevarieerd, van vergaderingen, voorgedragen spraak, songteksten | Lezen, voorbereid of losjes gestructureerd |
Verschillende scenario's produceren verschillende kwaliteitsresultaten. In de volgende tabel wordt onderzocht hoe inhoud uit deze vier scenario’s scoort in de WER. In de tabel ziet u welke fouttypen het meest voorkomt in elk scenario. Met de foutpercentages voor invoeging, vervanging en verwijdering kunt u bepalen welk soort gegevens u wilt toevoegen om het model te verbeteren.
| Scenariobeschrijving | Kwaliteit van spraakherkenning | Invoegfouten | Verwijderingsfouten | Vervangingsfouten |
|---|---|---|---|---|
| Callcenter | Gemiddeld (< 30% WER) |
Laag, behalve wanneer andere mensen op de achtergrond praten | Kan hoog zijn. Callcenters kunnen luidruchtig zijn en overlappende sprekers kunnen het model verwarren | Gemiddeld. De namen van producten en personen kunnen deze fouten veroorzaken |
| Spraakassistent | Hoog (kan < 10% WER zijn) |
Laag | Laag | Gemiddeld, vanwege nummertitels, productnamen of locaties |
| Dicteren | Hoog (kan < 10% WER zijn) |
Laag | Laag | Hoog |
| Ondertiteling van video | Hangt af van het type video (kan < 50% WER zijn) | Laag | Kan hoog zijn vanwege muziek, geluiden, microfoonkwaliteit | Jargon kan deze fouten veroorzaken |