Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Dit artikel is de vierde in een reeks over herstel na noodgevallen (DR) voor een Azure-gegevensplatform. Het biedt aanbevelingen en lessen die zijn geleerd voor het implementeren van een DR-strategie, waaronder richtlijnen voor het definiëren van hersteldoelstellingen, testprocedures voor herstel na noodgevallen en het aanpakken van operationele overwegingen.
Geleerde lessen
Zorg ervoor dat alle betrokken partijen het verschil tussen hoge beschikbaarheid (HA) en DR begrijpen. Verwarrende deze concepten kunnen leiden tot niet-overeenkomende oplossingen.
Werk samen met zakelijke belanghebbenden om beoogde herstelpunten (RPO's) en beoogde hersteltijd (RPO's) te definiëren op basis van de volgende factoren:
De hoeveelheid downtime die ze kunnen tolereren. Sneller herstel kost meestal meer.
De typen incidenten die belanghebbenden moeten beschermen tegen en hoe waarschijnlijk deze zich voordoen. Een serverfout is bijvoorbeeld waarschijnlijker dan een natuurramp die van invloed is op alle datacenters in een regio.
De gevolgen van de onbeschikbaarheid van het systeem voor hun bedrijf.
Het budget voor operationele uitgaven (OPEX) voor de langetermijnoplossing.
Overweeg welke gedegradeerde serviceopties uw gebruikers kunnen accepteren, zoals:
Toegang tot visualisatiedashboards, zelfs als de gegevens niet up-to-date zijn. In dit scenario kunnen gebruikers hun gegevens bekijken, zelfs als opnamepijplijnen mislukken.
Leestoegang zonder schrijfmogelijkheden.
Uw doel-RTO en RPO bepalen welke DR-strategie moet worden gebruikt. Veelvoorkomende strategieën zijn actief-actief, actief-passief en opnieuw implementeren bij noodgevallen. Houd ook rekening met uw samengestelde serviceniveaudoelstelling (SLO) om rekening te houden met alle drempelwaarden voor toegestane downtime.
Zorg ervoor dat u alle onderdelen begrijpt die van invloed kunnen zijn op de beschikbaarheid van uw systemen:
Identiteitsbeheer
Netwerktopologie
Geheimbeheer en sleutelbeheer
Gegevensbronnen
Automatisering en taakplanning
Bronopslagplaats en implementatiepijplijnen zoals GitHub en Azure DevOps
Vroege detectie van storingen kan RTO- en RPO-waarden verlagen. Pas de volgende procedures toe:
Definieer wat een storing is en hoe deze wordt toegewezen aan de definitie van een storing volgens Microsoft.
Implementeer een bewakings- en waarschuwingssysteem met duidelijk eigendom, zodat uw team onmiddellijk metrische gegevens en waarschuwingen beoordeelt.
Voor abonnementsontwerp kan extra infrastructuur voor herstel na noodgevallen zich in het oorspronkelijke abonnement bevinden. PaaS-aanbiedingen (Platform as a Service), zoals Azure Data Lake Storage, bevatten doorgaans systeemeigen failoverfuncties. Deze mogelijkheden ondersteunen secundaire exemplaren in andere regio's terwijl ze binnen het oorspronkelijke abonnement blijven. Om de kosten te optimaliseren, kunt u een afzonderlijke resourcegroep reserveren die uitsluitend is bedoeld voor DR-gerelateerde resources.
Abonnementslimieten kunnen beperkingen in deze benadering introduceren.
Deze aanpak voegt ook ontwerpcomplexiteit toe en vereist governancebesturingselementen om te voorkomen dat teams dr-resourcegroepen gebruiken voor routinewerkstromen.
Ontwerp de DR-werkstroom op basis van de kritieke waarde en afhankelijkheden van een oplossing. Probeer bijvoorbeeld geen Azure Analysis Services-exemplaar opnieuw op te bouwen voordat uw datawarehouse operationeel is, omdat er een fout optreedt. Laat ontwikkellabs later in het proces staan en herstel eerst de belangrijkste bedrijfsoplossingen.
Voer hersteltaken parallel uit in alle oplossingen om het totale aantal RTO's te verminderen.
Als uw oplossing Fabric-pijplijnen gebruikt, neemt u on-premises gegevensgateways op binnen de scope. Gebruik Azure Site Recovery voor deze machines.
Automatiseer waar mogelijk herstelbewerkingen om menselijke fouten te verminderen, met name voor situaties met hoge druk.
Gebruik resource-inrichting via Bicep-, Azure Resource Manager-sjablonen (ARM-sjablonen), Terraform- of PowerShell-scripts.
Versiebeheer van broncode en resourceconfiguratie aannemen.
Gebruik pijplijnen voor continue integratie en continue levering (CI/CD) in plaats van handmatige stappen uit te voeren.
Stel een plan op voor failback en failover. Documenteer de procedures voor het retourneren van bewerkingen naar de primaire exemplaren nadat ze zijn hersteld.
Definieer duidelijke indicatoren en metrische gegevens om te controleren of failover slaagt en of uw oplossingen operationeel zijn. Controleer of de prestaties weer normaal zijn, ook bekend als primair functioneel.
Bepaal of uw SLA's (Service Level Agreements) na een failover ongewijzigd moeten blijven of dat een tijdelijke vermindering van de servicekwaliteit acceptabel is. Het antwoord hangt af van hoe kritisch de workload is. Een ruimteboekingssysteem heeft bijvoorbeeld een andere downtimetolerantie dan een kern financieel of operationeel systeem.
Definieer RTO's en RPO's op gebruikersscenarioniveau in plaats van op infrastructuurniveau. Op scenario's gebaseerde doelen maken het gemakkelijker om te bepalen welke processen en onderdelen tijdens het herstel prioriteit moeten krijgen.
Voer capaciteitscontroles uit in de doelregio voordat u doorgaat met een failover. In een grote ramp zullen veel klanten tegelijkertijd proberen over te schakelen naar dezelfde gekoppelde regio. Dit scenario kan leiden tot vertragingen of conflicten bij de toewijzing van resources. Als deze risico's onaanvaardbaar zijn, kunt u een actief-actief- of actief-passief DR-strategie overwegen.
Maak en onderhoud een DR-plan om het herstelproces en de verantwoordelijken voor de acties te documenteren. Wijs voor elke rol een plaatsvervangend contactpersoon aan om rekening te houden met afwezige teamleden.
Voer regelmatig dr-oefeningen uit om de werkstroom voor noodherstelplannen te valideren, zorg ervoor dat deze voldoet aan de vereiste RTO- en RPO-vereisten en train de verantwoordelijke teams. Test regelmatig back-ups van gegevens en configuratie om te bevestigen dat ze herstel kunnen ondersteunen wanneer dat nodig is.
Werk vroeg samen met netwerk-, identiteits- en resourceinrichtingsteams om akkoord te gaan met:
Verkeersomleiding naar de secundaire site. Overweeg hulpprogramma's zoals DNS-omleiding (Domain Name System) of Azure Traffic Manager.
Hoe u snel en veilig toegang verleent tot de secundaire site.
Tijdens een noodgeval communiceert u duidelijk met alle betrokken partijen om het plan efficiënt uit te voeren. Informeer de volgende groepen tijdens het herstel:
- Besluitvormers
- Teams voor reactie op incidenten
- Beïnvloede interne gebruikers en teams
- Externe teams
Coördineer het herstellen van resources in de juiste volgorde om de efficiëntie te maximaliseren.
Antipatronen
Kopieer en plak deze reeks artikelen
Deze reeks artikelen bevat richtlijnen voor klanten die meer inzicht willen in een Azure specifiek dr-proces. Het maakt gebruik van algemene Microsoft intellectuele eigendoms- en referentiearchitecturen in plaats van één klantspecifieke Azure implementatie.
Deze inhoud biedt een sterk basiskennis. Maar u moet uw aanpak aanpassen door rekening te houden met uw unieke context, implementatie en vereisten om een fit-for-purpose DR-strategie en -proces te ontwikkelen.
Dr behandelen als een proces met alleen technologie
Dr-planning richt zich meestal op technische taken, maar het herstellen van systemen zonder aan bedrijfsvereisten te voldoen, mislukt nog steeds. Zakelijke belanghebbenden definiëren dr-vereisten en valideren dat serviceherstel voldoet aan de bedrijfsbehoeften.
Betrek zakelijke belanghebbenden in alle DR-activiteiten om een proces te produceren dat werkt wanneer dat nodig is en echte bedrijfswaarde levert.
Statische DR-plannen maken
Azure evolueert voortdurend, en dat geldt ook voor de manieren waarop klanten de diensten gebruiken. Uw DR-proces moet gelijke tred houden met die veranderingen.
Evalueert uw DR-plan regelmatig als onderdeel van de levenscyclus van uw softwareontwikkeling of door middel van periodieke beoordelingen om het op de hoogte te houden van eventuele wijzigingen in uw onderdelen, services of oplossingen.
Op papier gebaseerde evaluaties
Organisaties beoordelen vaak de DR-gereedheid aan de hand van documentatiebeoordelingen of tabletop-oefeningen zonder echte hersteltests uit te voeren. Deze benadering kan een onwaar gevoel van beveiliging geven, omdat echte fouten zelden overeenkomen met theoretische scenario's.
Een volledige end-to-end simulatie is moeilijk in een modern gegevensecosysteem, maar probeer zoveel mogelijk van de getroffen omgeving te testen. Regelmatige oefeningen vergroten het vertrouwen van uw team in en de vertrouwdheid met het DR-plan.
Vertrouw op Microsoft om alles te doen
Azure services definiëren een duidelijk model voor gedeelde verantwoordelijkheid voor betrouwbaarheid op basis van de cloudservicelaag.
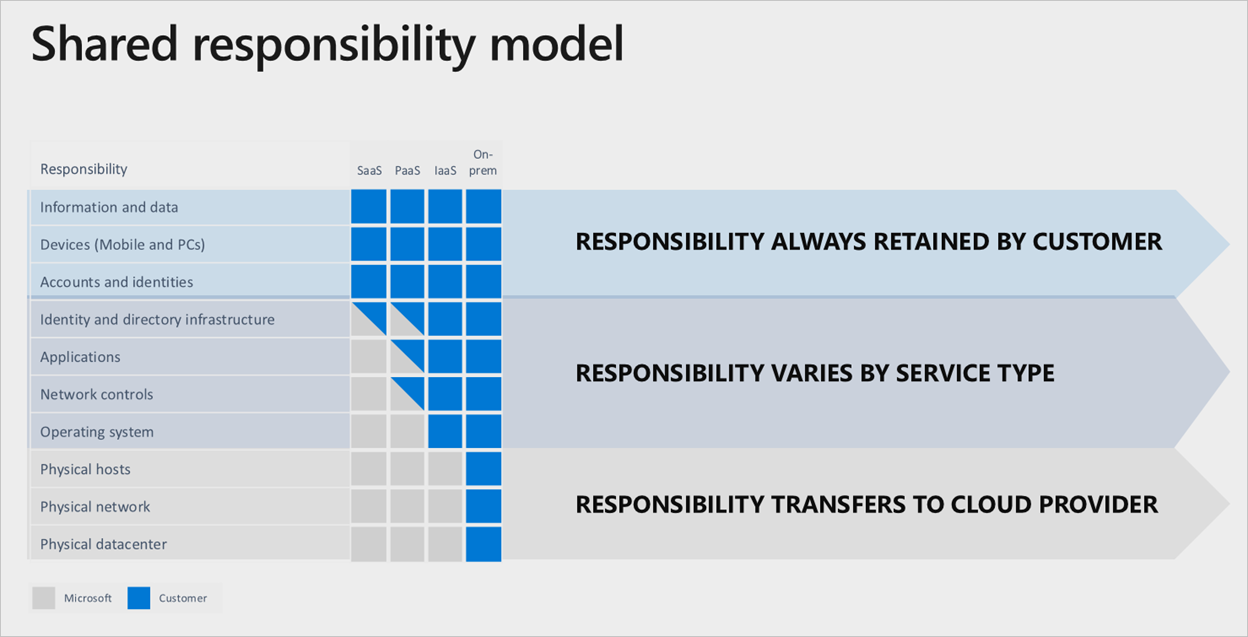
Zelfs met een volledige SaaS-stack blijft u verantwoordelijk voor uw accounts, identiteiten en gegevens en de apparaten die gebruikers gebruiken voor toegang tot Azure services.
Gebeurtenisbereik en -strategie
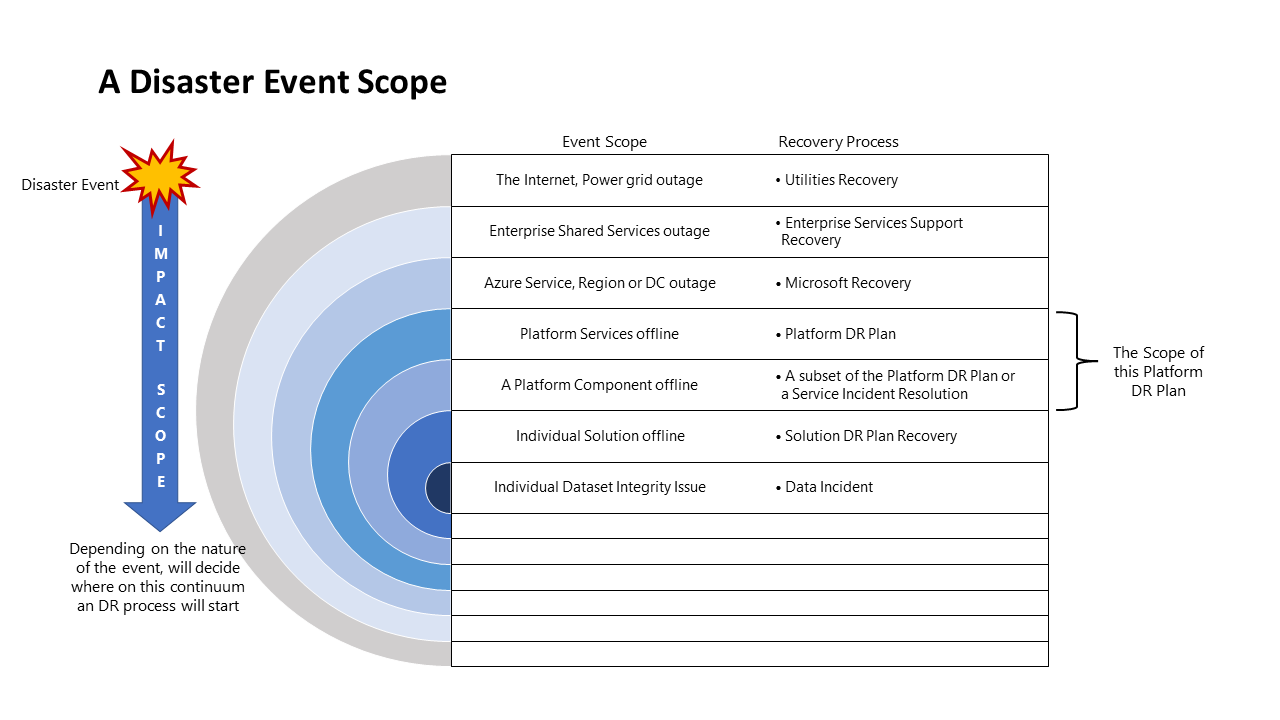
Bereik van rampgebeurtenis
Verschillende gebeurtenissen hebben verschillende impactbereiken waarvoor verschillende reacties nodig zijn. In het volgende diagram ziet u het bereik van de impact en reactie op een noodgeval.
DR-strategieopties
Kies uit vier strategieën voor herstel na noodgevallen op hoog niveau:
Wacht op Microsoft: de oplossing blijft offline totdat Microsoft services in de betrokken regio herstelt. Vervolgens valideert u de oplossing en werkt u deze bij voordat u deze weer in gebruik neemt.
Opnieuw implementeren bij noodgeval: U implementeert de oplossing na een noodgeval handmatig opnieuw in een beschikbare regio.
Warme reserve (actief-passief): U implementeert een secundaire oplossing in een andere regio met minimale capaciteit, maar ontvangt geen productieverkeer. De secundaire services worden uitgevoerd met verminderde prestaties of blijven uitgeschakeld totdat er een DR-gebeurtenis plaatsvindt.
Hot spare (actief-actief): De oplossing draait in een actief-actiefconfiguratie over meerdere regio's. Elk exemplaar ontvangt, verwerkt en dient gegevens als onderdeel van het algehele systeem.
Effecten van DR-strategie
Kosten zijn vaak de beslissingsfactor wanneer u een DR-strategie kiest, maar RTO, herstelcomplexiteit en impact op de klant is ook belangrijk.
Opmerking
Kostenoptimalisatie is een van de vijf pijlers van architectonische uitmuntendheid binnen het Azure Well-Architected Framework. Het doel is om onnodige uitgaven te verminderen en operationele efficiëntie te verbeteren.
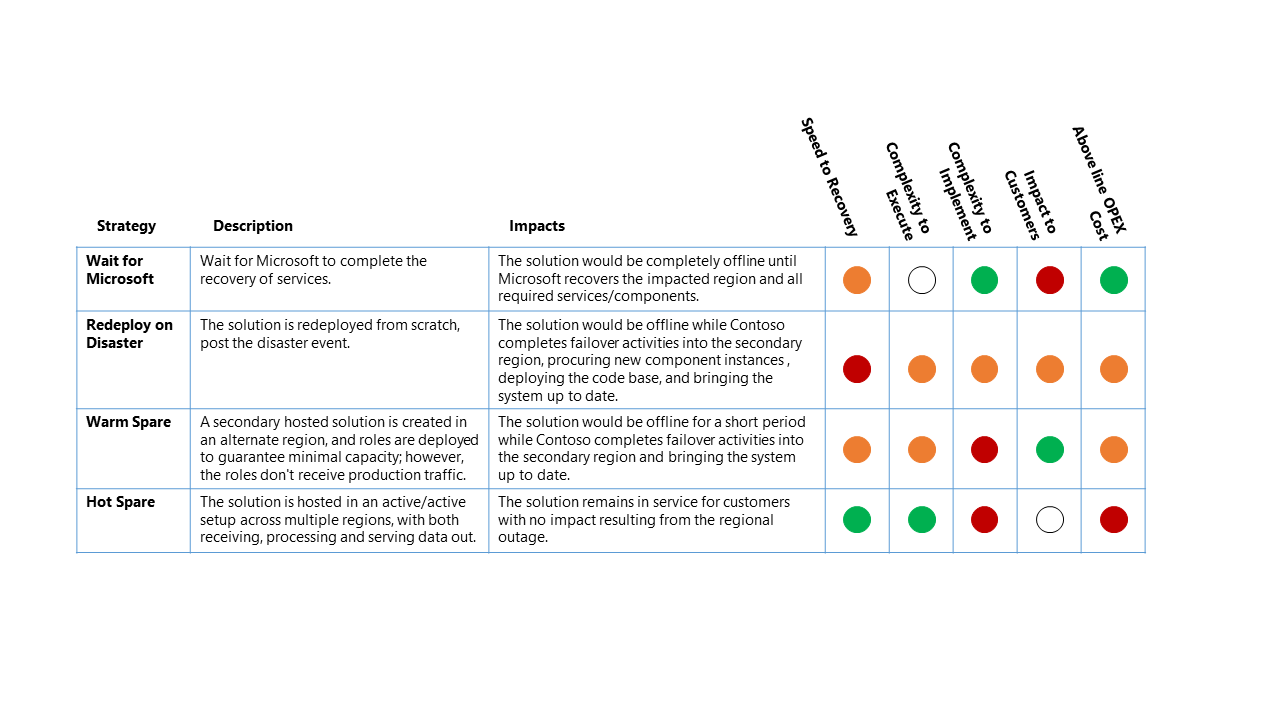
De volgende tabel vergelijkt de vier opties voor een volledige Azure regionale storing in de primaire regio die als host fungeert voor het Contoso-gegevensplatform. Groen geeft een gunstig resultaat voor die factor aan. Oranje geeft een gemiddeld resultaat aan. Rood geeft een ongunstige uitkomst aan.
Classificatiesleutel
Voor dit storingsscenario bepalen de volgende factoren de relatieve impact van elke DR-strategie:
RTO: De verwachte verstreken tijd van de noodgebeurtenis naar het platformserviceherstel
Uitvoeringscomplexiteit: De complexiteit voor de organisatie bij het uitvoeren van de herstelactiviteiten
Complexiteit om te implementeren: De complexiteit voor de organisatie om de DR-strategie te implementeren
Impact van de klant: De directe impact op klanten van de dataplatformservice van de DR-strategie
Boven-the-line OPEX-kosten: De extra kosten die worden verwacht bij het implementeren van deze strategie, zoals een verhoogde maandelijkse facturering voor Azure voor extra onderdelen en extra resources die nodig zijn
Volgende stappen
- Bedrijfskritieke workload
- Well-Architected Framework-aanbevelingen voor het ontwerpen van een DR-strategie