Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Microsoft Fabric
Azure-blobopslag
Microsoft Entra ID
Power BI
In dit artikel wordt beschreven hoe u gegevens overdraagt van een on-premises datawarehouse naar een cloudomgeving en vervolgens een BI-model (Business Intelligence) gebruikt om de gegevens te verwerken. U kunt deze benadering gebruiken als een einddoel of als eerste stap voor volledige modernisering met cloudonderdelen.
Deze richtlijnen zijn gebaseerd op het end-to-end-scenario van Microsoft Fabric. Er zijn meerdere opties voor het extraheren van gegevens uit een on-premises SQL-server, zoals Fabric Data Factory-pijplijnen, spiegelen, kopieertaak, en Fabric Real-time eventstreams voor het vastleggen van gegevens wijzigen (CDC) voor SQL. Na extractie worden de gegevens getransformeerd voor analyse.
Architecture

Een Visio-bestand van deze architectuur downloaden.
Werkproces
De volgende werkstroom komt overeen met het vorige diagram.
Gegevensbron
- Een SQL Server-database in Azure bevat de brongegevens. Als u de on-premises omgeving wilt simuleren, configureert u implementatiescripts voor dit scenario een Azure SQL-database. De AdventureWorks-voorbeelddatabase wordt gebruikt als het brongegevensschema en voorbeeldgegevens. Zie Gegevens kopiëren en transformeren van en naar SQL Servervoor meer informatie.
Opname en gegevensopslag
Fabric OneLake is één, geïntegreerde, logische data lake voor uw hele organisatie. Deze SaaS biedt verschillende opties voor gegevensopslag, zoals Fabric Lakehouse voor data engineering lakehouse-workloads, Fabric Warehouse voor datawarehouse-workloads en Fabric Eventhouse voor grote volumes tijdreeksen en logboekgegevenssets.
Met Fabric Data Factory-pijplijnen kunt u complexe ETL-werkstromen (extract, transform, load) en data factory bouwen die veel verschillende taken op schaal kunnen uitvoeren. Mogelijkheden voor controlestromen zijn ingebouwd in gegevenspijplijnen waarmee u werkstroomlogica kunt bouwen, die lussen en voorwaarden biedt. In deze architectuur maken metagegevensgestuurde frameworks incrementele opname van meerdere tabellen op schaal mogelijk.
Met Fabric Data Factory-spiegeling kunt u complexe ETL-processen voorkomen en uw bestaande SQL Server-estate integreren met de rest van uw gegevens in Fabric. U kunt uw bestaande SQL Server-databases continu rechtstreeks repliceren naar Fabric OneLake. Met de kopieertaak Fabric Data Factory kunt u eenvoudig gegevens van uw bron naar uw bestemming verplaatsen zonder dat u pijplijnen nodig hebt. Gegevensoverdrachten kunnen worden geconfigureerd via ingebouwde patronen voor batch- en incrementele kopie, met ondersteuning voor schaalbare prestaties.
Fabric-gebeurtenisstromen bieden een hoge doorvoer, realtime data-inname van een SQL Server-database die wordt gehost op een virtuele machine (VM) door CDC-extractie te gebruiken. Dit patroon is geschikt voor use cases waarvoor realtime dashboards en waarschuwingen nodig zijn.
Analyse en rapporteren
- De benadering voor gegevensmodellering in dit scenario combineert het enterprise-model en het semantische BI-model. Fabric-SKU's bieden de rekenkracht voor semantische Power BI-modellen. Power BI heeft toegang tot de gegevens via de connectiviteit van Import, DirectQuery of Direct Lake.
Components
Azure SQL Database- is een Door Azure gehoste PaaS SQL-server. In deze architectuur biedt SQL Database de brongegevens en demonstreert de gegevensstroom voor het migratiescenario.
OneLake is een geïntegreerde, cloudgebaseerde data lake voor het opslaan van gestructureerde en ongestructureerde gegevens in de hele organisatie. In deze architectuur fungeert OneLake als de centrale opslaglaag. Het maakt gebruik van artefacten zoals Fabric Lakehouse, Fabric Warehouse, Fabric Eventhouse en gespiegelde databases om verschillende soorten gegevens te behouden en te organiseren voor analyse en rapportage.
Fabric Data Warehouse is een SaaS-aanbieding die als host fungeert voor datawarehouseworkloads voor grote gegevenssets. In deze architectuur fungeert Fabric Data Warehouse als het uiteindelijke archief voor dimensionale gegevenssets en biedt ondersteuning voor analyses en rapportage.
Power BI is een business intelligence-hulpprogramma dat wordt gehost op Fabric-rekenkracht. In dit scenario worden gegevens gepresenteerd en gevisualiseerd, zodat zakelijke gebruikers kunnen communiceren met dashboards en rapporten op basis van gegevens uit Fabric Data Warehouse en andere bronnen.
Microsoft Entra ID is een suite voor identiteits- en netwerkoplossingen met meerdere clouds die ondersteuning biedt voor de verificatie- en autorisatiestroom. In deze architectuur biedt Microsoft Entra ID beveiligde toegang voor gebruikers die verbinding maken met Power BI- en Fabric-resources.
Scenario-details
In dit scenario heeft een organisatie een SQL-database die een groot on-premises datawarehouse bevat. De organisatie wil Fabric gebruiken voor het opnemen en analyseren van de gegevens en het leveren van analytische inzichten aan gebruikers via Power BI.
Wanneer u deze architectuur gebruikt
U kunt verschillende methoden gebruiken om te voldoen aan bedrijfsvereisten voor bedrijfsinformatie. Verschillende aspecten definiëren bedrijfsvereisten, zoals huidige technologische investeringen, menselijke vaardigheden, de tijdlijn voor modernisering, toekomstige doelstellingen en of u liever PaaS (Platform as a Service) of Software as a Service (SaaS) wilt.
Houd rekening met de volgende ontwerpmethoden:
Fabric en Azure Databricks voor klanten die al geïnvesteerd hebben in Azure Databricks en Power BI en die willen moderniseren met Fabric
Enterprise BI voor kleine en middelgrote bedrijven die gebruikmaken van een Azure SQL-ecosysteem en Fabric-
End-to-end datawarehousing in Fabric voor klanten die de voorkeur geven aan een SaaS-oplossing
In de architectuur in dit artikel wordt ervan uitgegaan dat u een Fabric Lakehouse- of Fabric-magazijn gebruikt als de permanente laag van het semantische bedrijfsmodel en dat u Power BI gebruikt voor business intelligence. Deze SaaS-benadering heeft de flexibiliteit om tegemoet te komen aan verschillende zakelijke vereisten en voorkeuren.
Authenticatie
Microsoft Entra ID verifieert gebruikers die verbinding maken met Power BI-dashboards en -apps. Eenmalige aanmelding (SSO) verbindt gebruikers met de gegevens in het Fabric-magazijn en het semantische Power BI-model. Autorisatie vindt plaats bij de bron.
Incrementeel laden
Wanneer u een geautomatiseerd ETL- of ELT-proces uitvoert, moet u alleen de gegevens laden die zijn gewijzigd sinds de vorige uitvoering. Dit proces wordt een incrementele belasting genoemd. Bij een volledige belasting worden daarentegen alle gegevens geladen. Als u een incrementele belasting wilt uitvoeren, bepaalt u hoe u de gewijzigde gegevens identificeert. U kunt een hoogwatermerk waardeaanpak gebruiken, waarmee de meest recente waarde van een datum-tijdkolom of een unieke geheel getalkolom in de brontabel wordt bijgehouden.
U kunt tijdelijke tabellen in SQL Server gebruiken. Tijdelijke tabellen zijn systeemtabellen die de geschiedenis van gegevenswijziging opslaan. De database-engine registreert automatisch de geschiedenis van elke wijziging in een afzonderlijke geschiedenistabel. Als u een query wilt uitvoeren op de historische gegevens, voegt u een FOR SYSTEM_TIME component toe aan een query. Intern voert de database-engine een query uit op de geschiedenistabel, maar deze is transparant voor de toepassing.
Tijdelijke tabellen ondersteunen dimensiegegevens, die na verloop van tijd kunnen worden gewijzigd. Feitentabellen vertegenwoordigen meestal onveranderbare transacties, zoals een verkoop, waarbij het bewaren van de systeemversiegeschiedenis niet zinvol is. In plaats daarvan hebben transacties meestal een kolom die de transactiedatum vertegenwoordigt. De kolom kan worden gebruikt als de watermerkwaarde. In het DataWarehouse AdventureWorks hebben de SalesLT.* tabellen bijvoorbeeld een LastModified veld.
In de volgende stappen wordt de algemene stroom van de ELT-pijplijn beschreven:
Houd voor elke tabel in de brondatabase de tijd bij waarop de laatste ELT-taak is uitgevoerd. Sla deze informatie op in het datawarehouse. Bij de eerste installatie worden alle tijden ingesteld op
1-1-1900.Tijdens de gegevensexportstap wordt de cutoff-tijd doorgegeven als een parameter aan een set opgeslagen procedures in de brondatabase. Met deze opgeslagen procedures worden records opgevraagd die na het cutoff-tijdstip zijn gewijzigd of gemaakt. Voor alle tabellen in het voorbeeld kunt u de
ModifiedDatekolom gebruiken.Wanneer de gegevensmigratie is voltooid, werkt u de tabel bij waarin de afsluittijden worden opgeslagen.
Gegevenspijplijn
In dit scenario wordt de AdventureWorks-voorbeelddatabase gebruikt als gegevensbron. Het patroon voor incrementele gegevensinvoer zorgt ervoor dat alleen de bijgewerkte of toegevoegde gegevens worden geladen na de meest recente pipeline-uitvoering.
Framework voor opname op basis van metagegevens
Het metagegevensgestuurde opnameframework in Fabric Data Factory-pijplijnen laadt incrementeel alle tabellen die zich in de relationele database bevinden. Het artikel verwijst naar een datawarehouse als bron, maar kan worden vervangen door een Azure SQL-database als bron.
Selecteer een watermerkkolom. Kies één kolom in de brontabel waarmee u nieuwe of gewijzigde records kunt bijhouden. Deze kolom bevat doorgaans waarden die toenemen wanneer rijen worden toegevoegd of bijgewerkt (zoals een tijdstempel of id). Gebruik de hoogste waarde in deze kolom als watermerk om te weten waar u was gebleven.
Stel een tabel in om de laatste grenswaarde op te slaan.
Bouw een pijplijn met de volgende activiteiten:
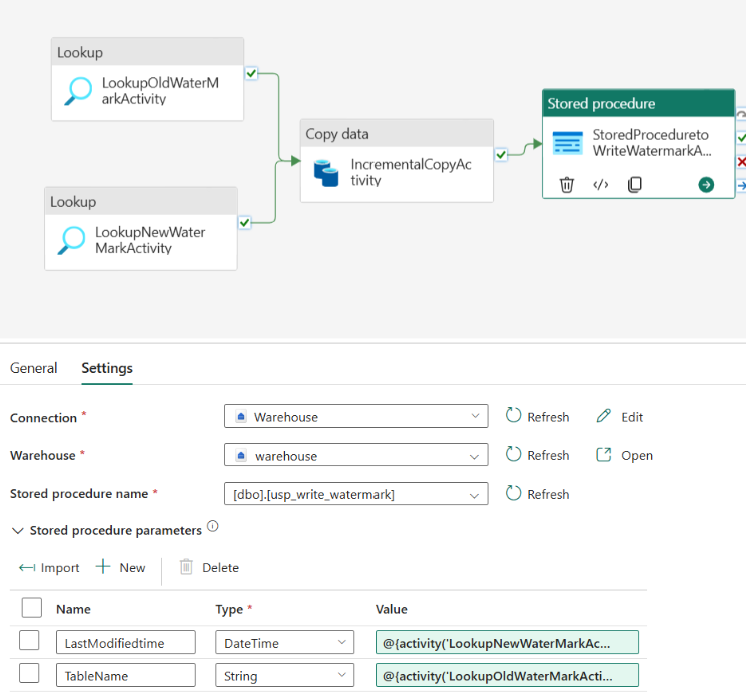
Twee opzoekactiviteiten. De eerste activiteit krijgt de laatste grenswaarde (waar we de laatste keer zijn gestopt). De tweede activiteit haalt de nieuwe grenswaarde op (waar we deze keer stoppen). Beide waarden worden doorgegeven aan de kopieeractiviteit.
Een kopieeractiviteit waarmee rijen worden gevonden waar de waarde van de watermerkkolom zich bevindt tussen de oude en nieuwe watermerken. Vervolgens worden deze gegevens van uw datawarehouse naar uw Lakehouse gekopieerd als een nieuw bestand.
Een opgeslagen procedureactiviteit waarmee de nieuwe grenswaarde wordt opgeslagen om het beginpunt voor de volgende pijplijnuitvoering te bepalen.

In de volgende afbeelding ziet u een voltooide pijplijn. Zie Incrementele opname voor meer informatie.
Gegevens laden in een Fabric-datawarehouse
Met de kopieeractiviteit worden gegevens uit de SQL-database gekopieerd naar het datawarehouse Fabric. De SQL-database van dit voorbeeld bevindt zich in Azure, dus maakt gebruik van een verbinding die is ingesteld in de Fabric-portal onder Verbindingen en gateways beheren.
Fabric Data Factory-pijplijnen gebruiken
Pijplijnen in Fabric Data Factory definiëren een geordende set activiteiten om een incrementeel belastingspatroon te voltooien. Handmatige of automatische triggers starten de pijplijn.
De gegevens transformeren
Als transformatie nodig is, gebruikt u Fabric-gegevensstromen om met AI ondersteunde ETL-transformaties te ontwerpen die de gegevens hervormen. Fabric-gegevensstromen zijn afhankelijk van de Power Query-engine om deze transformaties toe te passen en de resultaten naar Fabric Data Warehouse te schrijven.
In een productieomgeving gebruikt u Fabric-notebooks om ETL-transformaties te implementeren die goed werken voor grote gegevenssets via een gedistribueerd computingframework dat wordt aangestuurd door Apache Spark.
Opmerking
Gebruik de systeemeigen uitvoeringsengine om data engineering- of ETL-workloads uit te voeren.
Power BI gebruiken met Fabric-capaciteiten om gegevens te openen, te modelleren en te visualiseren
Infrastructuurcapaciteiten in Power BI ondersteunen meerdere opslagmodi voor het maken van verbinding met Azure-gegevensbronnen:
Importeren: Laadt gegevens in het semantische Power BI-model voor query's in het geheugen.
DirectQuery: Voert query's rechtstreeks uit op relationele opslag zonder gegevens in het geheugen te laden.
Samengesteld model: Hiermee wordt de importmodus voor sommige tabellen gecombineerd met DirectQuery voor anderen in dezelfde gegevensset.
Direct Lake: Query's uitvoeren op deltatabellen die zijn opgeslagen in OneLake vanuit een semantisch fabric-werkruimtemodel. Het is geoptimaliseerd voor interactieve analyse van grote tabellen door gegevens op aanvraag in het geheugen te laden.
In dit scenario wordt het DirectQuery-dashboard gebruikt omdat het een kleine hoeveelheid gegevens en een lage modelcomplexiteit heeft. DirectQuery delegeert de query naar de onderliggende berekeningsengine en maakt gebruik van beveiligingsmogelijkheden op de bron. DirectQuery zorgt ervoor dat de resultaten altijd consistent zijn met de meest recente brongegevens.
De importmodus kan de laagste querylatentie bieden. Overweeg de importmodus als de volgende factoren waar zijn:
- Het model past volledig in het geheugen van Power BI.
- De gegevenslatentie tussen vernieuwingen is acceptabel.
- U hebt complexe transformaties tussen het bronsysteem en het uiteindelijke model nodig.
In dit geval willen de gebruikers volledige toegang tot de meest recente gegevens zonder vertragingen bij het vernieuwen van Power BI en willen ze alle historische gegevens, die de capaciteit van de Power BI-gegevensset overschrijden. Een Power BI-gegevensset kan 25 gigabyte (GB) tot 400 GB verwerken, afhankelijk van de capaciteitsgrootte. Het gegevensmodel in de toegewezen SQL-pool bevindt zich al in een stervormig schema en vereist geen transformatie, dus DirectQuery is een geschikte keuze.

Gebruik Power BI om grote modellen, gepagineerde rapporten en implementatiepijplijnen te beheren. Profiteer van het ingebouwde Azure Analysis Services-eindpunt. U kunt ook toegewezen capaciteit hebben met een unieke waardepropositie.
Wanneer het BI-model groeit of de complexiteit van het dashboard toeneemt, kunt u overschakelen naar samengestelde modellen en delen van opzoektabellen importeren via hybride tabellenen vooraf samengevoegde gegevens importeren. U kunt querycache inschakelen in Power BI voor geïmporteerde gegevenssets en dubbele tabellen gebruiken voor de eigenschap opslagmodus.
Binnen het samengestelde model fungeren gegevenssets als een virtuele passthrough-laag. Wanneer gebruikers interactie hebben met visualisaties, genereert Power BI SQL-query's naar Fabric Data Warehouse. Power BI bepaalt of in-memory of DirectQuery-opslag moet worden gebruikt op basis van efficiëntie. De engine bepaalt wanneer moet worden overgeschakeld van in-memory naar DirectQuery en de logica naar het Fabric-datawarehouse pusht. Afhankelijk van de context van de querytabellen kunnen ze fungeren als in de cache opgeslagen (geïmporteerd) of niet-in de cache geplaatste samengestelde modellen. U kunt kiezen welke tabel u in het geheugen wilt opslaan, gegevens uit een of meer DirectQuery-bronnen wilt combineren of DirectQuery-brongegevens en geïmporteerde gegevens wilt combineren.
Wanneer u DirectQuery gebruikt met een Fabric-datawarehouse of Lakehouse, voert u de volgende acties uit:
Gebruik Fabric Z-Order en V-Order om de queryprestaties te verbeteren door de opslag van onderliggende tabelgegevens in delta-indelingsbestanden te optimaliseren.
Gebruik Fabric Lakehouse gerealiseerde weergaven om gegevens zoals een tabel vooraf te compileren, op te slaan en te onderhouden. Query's die gebruikmaken van alle gegevens of een subset van de gegevens in gerealiseerde weergaven, kunnen sneller presteren zonder rechtstreeks naar de gedefinieerde gerealiseerde weergave te hoeven verwijzen om deze te gebruiken.
Overwegingen
Met deze overwegingen worden de pijlers van het Azure Well-Architected Framework geïmplementeerd. Dit is een set richtlijnen die u kunt gebruiken om de kwaliteit van een workload te verbeteren. Zie Well-Architected Framework voor meer informatie.
Reliability
Betrouwbaarheid zorgt ervoor dat uw toepassing kan voldoen aan de toezeggingen die u aan uw klanten hebt gedaan. Zie de controlelijst ontwerpbeoordeling voor betrouwbaarheid voor meer informatie.
In het artikel Betrouwbaarheid wordt uitgelegd hoe Fabric ondersteuning biedt voor betrouwbaarheid, inclusief regionale tolerantie via beschikbaarheidszones, samen met herstel tussen regio's en bedrijfscontinuïteit. Fabric biedt een schakeloptie voor herstel na noodgevallen op de pagina capaciteitsinstellingen. Het is beschikbaar waar regionale paren van Azure overeenkomen met de beschikbaarheid van de Fabric-service. Wanneer de instelling voor noodherstelcapaciteit is ingeschakeld, wordt replicatie tussen regio's ingeschakeld als noodherstelmogelijkheid voor OneLake-gegevens.
Security
Beveiliging biedt garanties tegen opzettelijke aanvallen en misbruik van uw waardevolle gegevens en systemen. Zie de controlelijst ontwerpbeoordeling voor beveiliging voor meer informatie.
Cloudmodernisatie introduceert beveiligingsproblemen, zoals gegevensschendingen, malware-infecties en schadelijke code-injectie. U hebt een cloudprovider of serviceoplossing nodig die uw zorgen kan oplossen omdat ontoereikende beveiligingsmaatregelen grote problemen kunnen veroorzaken.
In dit scenario worden de meest veeleisende beveiligingsproblemen aangepakt met behulp van een combinatie van gelaagde beveiligingscontroles, waaronder netwerk-, identiteits-, privacy- en autorisatiecontroles. In een Fabric-datawarehouse worden de meeste gegevens opgeslagen. Power BI heeft toegang tot de gegevens via DirectQuery met Single Sign-On. Gebruik Microsoft Entra-id voor verificatie. Er zijn ook uitgebreide beveiligingscontroles voor gegevensautorisatie binnen de ingerichte pools.
Houd rekening met de volgende veelvoorkomende beveiligingsproblemen:
Definieer wie welke gegevens kunnen zien.
Zorg ervoor dat uw gegevens voldoen aan de federale, lokale en bedrijfsrichtlijnen om risico's voor gegevenslekken te beperken. Fabric biedt uitgebreide mogelijkheden voor gegevensbescherming ter ondersteuning van beveiliging en bevordering van naleving.
OneLake-beveiliging beheert alle toegang tot de OneLake-gegevens met verschillende machtigingen die zijn overgenomen van het bovenliggende item of van de werkruimterechten.
Een werkruimte is een samenwerkingsomgeving voor het maken en beheren van items. Werkruimterollen kunnen op dit niveau worden beheerd.
Een item is een set mogelijkheden die zijn gebundeld in één onderdeel. Een gegevensitem is een subtype van het item waarmee gegevens erin kunnen worden opgeslagen met OneLake. Items nemen machtigingen over van de werkruimterollen, maar kunnen ook extra machtigingen hebben. Mappen binnen een item worden gebruikt voor het opslaan en beheren van gegevens, zoals
Tables/ofFiles/.
Bepaal hoe u de identiteit van een gebruiker controleert.
- Gebruik Fabric om te bepalen wie toegang heeft tot welke gegevens via toegangsbeheer en verificatie.
Kies een netwerkbeveiligingstechnologie om de integriteit, vertrouwelijkheid en toegang tot uw netwerken en gegevens te beschermen.
- Help Fabric beveiligen met behulp van netwerkbeveiligingsopties .
Kies hulpprogramma's om bedreigingen te detecteren en op de hoogte te stellen.
- Fabric heeft geen ingebouwde detectie van bedreigingen. U wordt aangeraden een combinatie van Microsoft Purview Compliancebeheer te gebruiken om waarschuwingen in te stellen en auditlogboeken te controleren om gebruikersactiviteiten bij te houden.
Bepaal hoe u gegevens in Fabric OneLake beveiligt.
- Bescherm gegevens in Fabric met behulp van vertrouwelijkheidslabels van Microsoft Purview Informatiebeveiliging. Labels zoals Algemeen, Vertrouwelijk en Zeer vertrouwelijk worden veel gebruikt in Microsoft Office-apps zoals Word, PowerPoint en Excel om gevoelige informatie te beveiligen. Ze volgen de gegevens automatisch van item naar item terwijl het door Fabric loopt, helemaal van gegevensbron naar zakelijke gebruiker.
Kostenoptimalisatie
Kostenoptimalisatie richt zich op manieren om onnodige uitgaven te verminderen en operationele efficiëntie te verbeteren. Zie de controlelijst ontwerpbeoordeling voor Kostenoptimalisatie voor meer informatie.
In deze sectie vindt u een overzicht van de prijsgegevens voor de verschillende services die in de oplossing worden gebruikt en worden de beslissingen voor dit scenario uitgelegd met behulp van een voorbeeldgegevensset. Gebruik de beginconfiguratie in deze Azure prijsraming en pas deze aan zodat deze past bij uw scenario. Zie het overzicht van fabric-prijzen voor meer informatie over Fabric-SKU's. Zie de fabric-capaciteitsschatter voor meer informatie over het genereren van een schatting van het totale fabric-verbruik.
Opmerking
De schatting bevat geen Power BI Pro- of Premium-licenties per gebruiker. Dit zijn kosten per gebruiker die buiten het bereik van deze infrastructuurraming vallen, maar rekening moeten worden gehouden.
Schaalbare architectuur met fabric
Fabric is een serverloze architectuur voor de meeste workloads die u kunt gebruiken om uw reken- en opslagniveaus onafhankelijk te schalen. Rekenmiddelen brengen kosten met zich mee op basis van het gebruik. U kunt deze resources op aanvraag schalen of onderbreken. Voor opslagbronnen worden kosten per GB in rekening gebracht, zodat uw kosten toenemen wanneer u gegevens opneemt.
Fabric Factory-pijplijnen
Drie hoofdonderdelen beïnvloeden de prijs van een pijplijn:
Orkestratie-activiteiten voor gegevenspijplijnen: Verminder de totale orkestratietijd door parallelle stromen te implementeren om de kosten te verlagen.
Gegevensstroom Gen2 voor berekening: Om kosten te optimaliseren, vereenvoudigt u ETL-pijplijnen door onnodige gegevens te filteren en incrementele extractie te verwerken.
Gegevensverplaatsing voor kopieertaak of kopieeractiviteit: Als u de kosten wilt optimaliseren, configureert u de kopieertaak met incrementele extractie en past u de doorvoer voor de kopieeractiviteit aan.
Zie het tabblad Data Factory-prijsmeters op de prijzen van Data Factory voor meer informatie.
De prijs varieert afhankelijk van componenten of activiteiten, frequentie en de totale rekenkracht die is gekoppeld aan orkestratie. Voor elke gegevensverplaatsing die het gevolg is van pijplijnactiviteiten of een kopieertaak, worden kosten in rekening gebracht. Rekenkracht die is gekoppeld aan gegevensverplaatsing via Fabric-spiegeling is echter gratis en de opslagkosten van gespiegelde gegevens zijn vrij tot de capaciteitsgrootte. Als u bijvoorbeeld een F64-capaciteit aanschaft, ontvangt u 64 gratis terabytes (TB) aan opslagruimte die exclusief wordt gebruikt voor spiegeling. OneLake-opslag wordt gefactureerd als de opslaglimiet voor gratis spiegeling wordt overschreden of wanneer de capaciteit wordt onderbroken.
Handleiding voor beslissingen over fabricworkloads
Gebruik deze handleiding voor beslissingen om een gegevensarchief te selecteren voor uw Fabric-workloads. Alle opties zijn beschikbaar in geïntegreerde opslag in OneLake.
Het SQL-eindpunt voor Fabric Lakehouse of Fabric Warehouse biedt de mogelijkheid om ad-hocquery's uit te voeren voor analyse. Daarnaast kunnen semantische Power BI-modellen de gegevens importeren of er rechtstreeks query's op uitvoeren. De kosten die zijn gekoppeld aan een lakehouse of warehouse zijn gelijk aan het verbruik van CU's voor SQL-query's op het SQL-eindpunt. Implementeer Z-Ordering en V-Ordering in Fabric Lakehouse om de queryprestaties te verbeteren om de kosten te optimaliseren. Voor Data Warehouse optimaliseert u query's om kleinere batches te lezen.
OneLake-opslag
OneLake-opslag wordt gefactureerd tegen een pay-as-you-go-tarief per GB aan gebruikte gegevens en verbruikt geen Fabric-capaciteitseenheden (CUs). Fabric-items zoals lakehouses en magazijnen verbruiken OneLake-opslag. Zie Fabric-prijzen voor meer informatie.
Als u de kosten van OneLake wilt optimaliseren, richt u zich op het beheren van het opslagvolume door ongebruikte gegevens regelmatig te verwijderen, inclusief gegevens in opslag voor voorlopig verwijderen en het optimaliseren van lees-/schrijfbewerkingen. OneLake-opslag wordt afzonderlijk gefactureerd van compute, dus het is belangrijk om het gebruik te bewaken met de app Fabric-capaciteitsmetrieken. Als u de opslagkosten wilt verlagen, die worden berekend op basis van gemiddeld dagelijks gebruik gedurende de maand, kunt u overwegen de hoeveelheid opgeslagen gegevens te minimaliseren.
Power BI
In dit scenario worden Power BI-werkruimten met ingebouwde prestatieverbeteringen gebruikt om tegemoet te komen aan veeleisende analytische behoeften. Implementeer incrementeel vernieuwen van gegevens voor Importmodus-extractie om de kosten te optimaliseren. Implementeer de Direct Lake-modus voor rapportage over grotere gegevenssets indien mogelijk om de totale belasting van fabric-capaciteiten te verminderen.
Zie Prijzen voor Power BIvoor meer informatie.
Operationele uitmuntendheid
Operational Excellence behandelt de operationele processen die een toepassing implementeren en deze in productie houden. Zie de controlelijst ontwerpbeoordeling voor Operational Excellence voor meer informatie.
Gebruik een Azure DevOps-releasepijplijn en GitHub Actions om de implementatie van een Fabric-werkruimte-artefact in meerdere omgevingen te automatiseren. Zie Continue integratie en continue levering voor een Fabric-werkruimte voor meer informatie.
Plaats elke workload in een afzonderlijke implementatiesjabloon en sla de resources op in broncodebeheersystemen. U kunt de sjablonen samen of afzonderlijk implementeren als onderdeel van een CI/CD-proces (continue integratie en continue levering). Deze aanpak vereenvoudigt het automatiseringsproces. Deze architectuur heeft vier hoofdworkloads:
- Het datawarehouse en gerelateerde resources
- Data Factory-pijplijnen
- Power BI-assets, waaronder dashboards, apps en gegevenssets
- Een gesimuleerde scenario van on-premises naar cloud
Overweeg om uw workloads te faseren, waar mogelijk praktisch. Implementeer uw workload in verschillende fasen. Voer validatiecontroles uit in elke fase voordat u naar de volgende fase gaat. Deze aanpak pusht updates naar uw productieomgevingen op een gecontroleerde manier en minimaliseert onverwachte implementatieproblemen. Gebruik blauwgroene implementatie en canary release strategieën om live productieomgevingen bij te werken.
Gebruik een strategie voor terugdraaien om mislukte implementaties af te handelen. U kunt bijvoorbeeld automatisch een eerdere, geslaagde implementatie opnieuw implementeren vanuit uw implementatiegeschiedenis. Gebruik de vlag
--rollback-on-errorin de Azure CLI.Gebruik de Fabric-capaciteitsmetriek-app voor uitgebreide bewaking van het capaciteitgebruik van Fabric. Werkruimtebewaking gebruiken voor gedetailleerde bewaking van telemetrielogboeken voor fabric-werkruimten.
Gebruik de Fabric capaciteitsschatting om uw Fabric capaciteitsbehoeften in te schatten.
Prestatie-efficiëntie
Prestatie-efficiëntie verwijst naar de mogelijkheid van uw workload om efficiënt te voldoen aan de behoeften van de gebruiker. Zie de controlelijst ontwerpbeoordeling voor prestatie-efficiëntie voor meer informatie.
In dit artikel wordt de Fabric F64-capaciteit gebruikt om BI-mogelijkheden te demonstreren. Toegewezen Power BI-capaciteiten in Fabric variëren van F64 tot de maximale SKU-grootte. Zie Fabric-prijzen voor meer informatie.
Voer de volgende acties uit om te bepalen hoeveel capaciteit u nodig hebt:
Evalueer de belasting op uw capaciteit.
Installeer de Fabric capaciteitsmetriekapp voor doorlopende bewaking.
Overweeg het gebruik van werkbelastinggerelateerde technieken voor capaciteitsoptimalisatie.
Bijdragers
Microsoft onderhoudt dit artikel. De volgende inzenders hebben dit artikel geschreven.
Hoofdauteur:
- Bibhu Acharya | Principal Cloud Solution Architect
Andere Inzenders:
- Jim McLeod | Cloud Solution Architect
- Miguel Myers | Senior Program Manager
- Galina Polyakova | Senior Cloud Solution Architect
- George Stevens | Solutions Engineer
Als u niet-openbare LinkedIn-profielen wilt zien, meldt u zich aan bij LinkedIn.
Volgende stappen
- Wat is Power BI Premium?
- Wat is Microsoft Entra ID?
- Wat is stof?
- Wat is Data Factory in Fabric?
- Wat is Azure SQL?