Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Een grondig onderzoek is de werkstroom voor probleemoplossing die door de Azure Copilot Waarneembaarheidsagent wordt uitgevoerd wanneer er al iets mis is en u moet weten wat er is gebeurd en wat u vervolgens moet doen. De agent verzamelt signalen van de verschillende lagen van de toepassing, infrastructuur en Azure platform, correleert deze automatisch en produceert een rapport met bevindingen en aanbevolen volgende stappen. Grondige onderzoeken vervangen het handmatige werk van het draaien van dashboards, logboeken en implementatiegeschiedenis om samen te voegen wat er is gewijzigd. Diepgaande onderzoeken werken voor Azure-resourcetypen, waaronder Azure Kubernetes Service (AKS), virtuele machines en Application Insights.
In dit artikel wordt uitgelegd wanneer u een grondig onderzoek moet gebruiken, waar u een begint, hoe de agent deze uitvoert en wat het rapport bevat. Zie Chat met uw waarneembaarheidsgegevens voor ad-hocvragen die niet zijn gekoppeld aan een actief incident.
Diepgaand onderzoek versus verkenning via chat
Gebruik een grondig onderzoek wanneer:
- Er gaat een Azure Monitor-waarschuwing af en u weet nog niet wat de oorzaak is.
- U ziet pieken in latentie of fouten in meerdere resources en wilt een laagoverstijgend overzicht.
- Een incident omvat uw toepassingscode, de hostinfrastructuur en Azure platformvoorwaarden.
Gebruik in plaats daarvan chat met uw waarneembaarheidsgegevens wanneer:
- U hebt een ad-hocvraag over één resource ('Wat waren de belangrijkste uitzonderingen gisteren?').
- U onderzoekt telemetrie zonder een actief incident.
- U wilt een Kusto-query ontwerpen of een patroon in uw logboeken begrijpen.
Zie Chatten met uw waarneembaarheidsgegevens voor chatwerkstromen. Een enkele deep investigation-bewerking is gemaximeerd op 300 Azure Agent Credits (AAC's). Zie Facturering en kostenbeheer voor Waarneembaarheidsagent in Azure Monitor voor meer informatie over kosten.
Ondersteunde incidentscenario’s
Diepgaande onderzoeken richten zich op de volgende incidentcategorieën. Zie Voorbeelden van diepgaand onderzoek in de Azure Copilot Observability-agent voor stapsgewijze uitleg bij verschillende scenario's.
-
Toepassingsproblemen
- Uitrolregressies
- Aanvraag- en afhankelijkheidsfouten
- Prestatieverminderingen
- Uitputting van middelen
- Identiteits- of configuratiefouten
-
Infrastructuurproblemen
- Verzadiging van rekenkracht
- Schijf-I/O beperken
- Onjuist geconfigureerde afhankelijkheden
- Netwerkverbindingsfouten
-
Platformproblemen
- Azure onderhoud of storingen
- Problemen met beheerde infrastructuur, zoals uitputting van SNAT-poorten en problemen met het blokkeren van upgrades
Waar u een diepgaand onderzoek start in de Azure-portal
Gebruikers met toegang tot Azure Copilot kunnen grondige onderzoeken uitvoeren. Als uw organisatie Azure Copilot toegang beperkt, kunt u de waarneembaarheidsagent niet gebruiken. Zie Toegang tot Azure Copilot beheren voor meer informatie.
U begint een diepgaand onderzoek vanaf verschillende plaatsen in de Azure-portal. Elk toegangspunt biedt de agent de resource- en tijdsbereikcontext voor het incident.
Azure Monitor waarschuwing (aanbevolen): open een geactiveerde waarschuwing in de portal en selecteer Onderzoeken. Deze ingang is primair omdat een waarschuwing al informatie bevat over de betrokken bron, het symptoom en het tijdstip waarop deze werd geactiveerd.
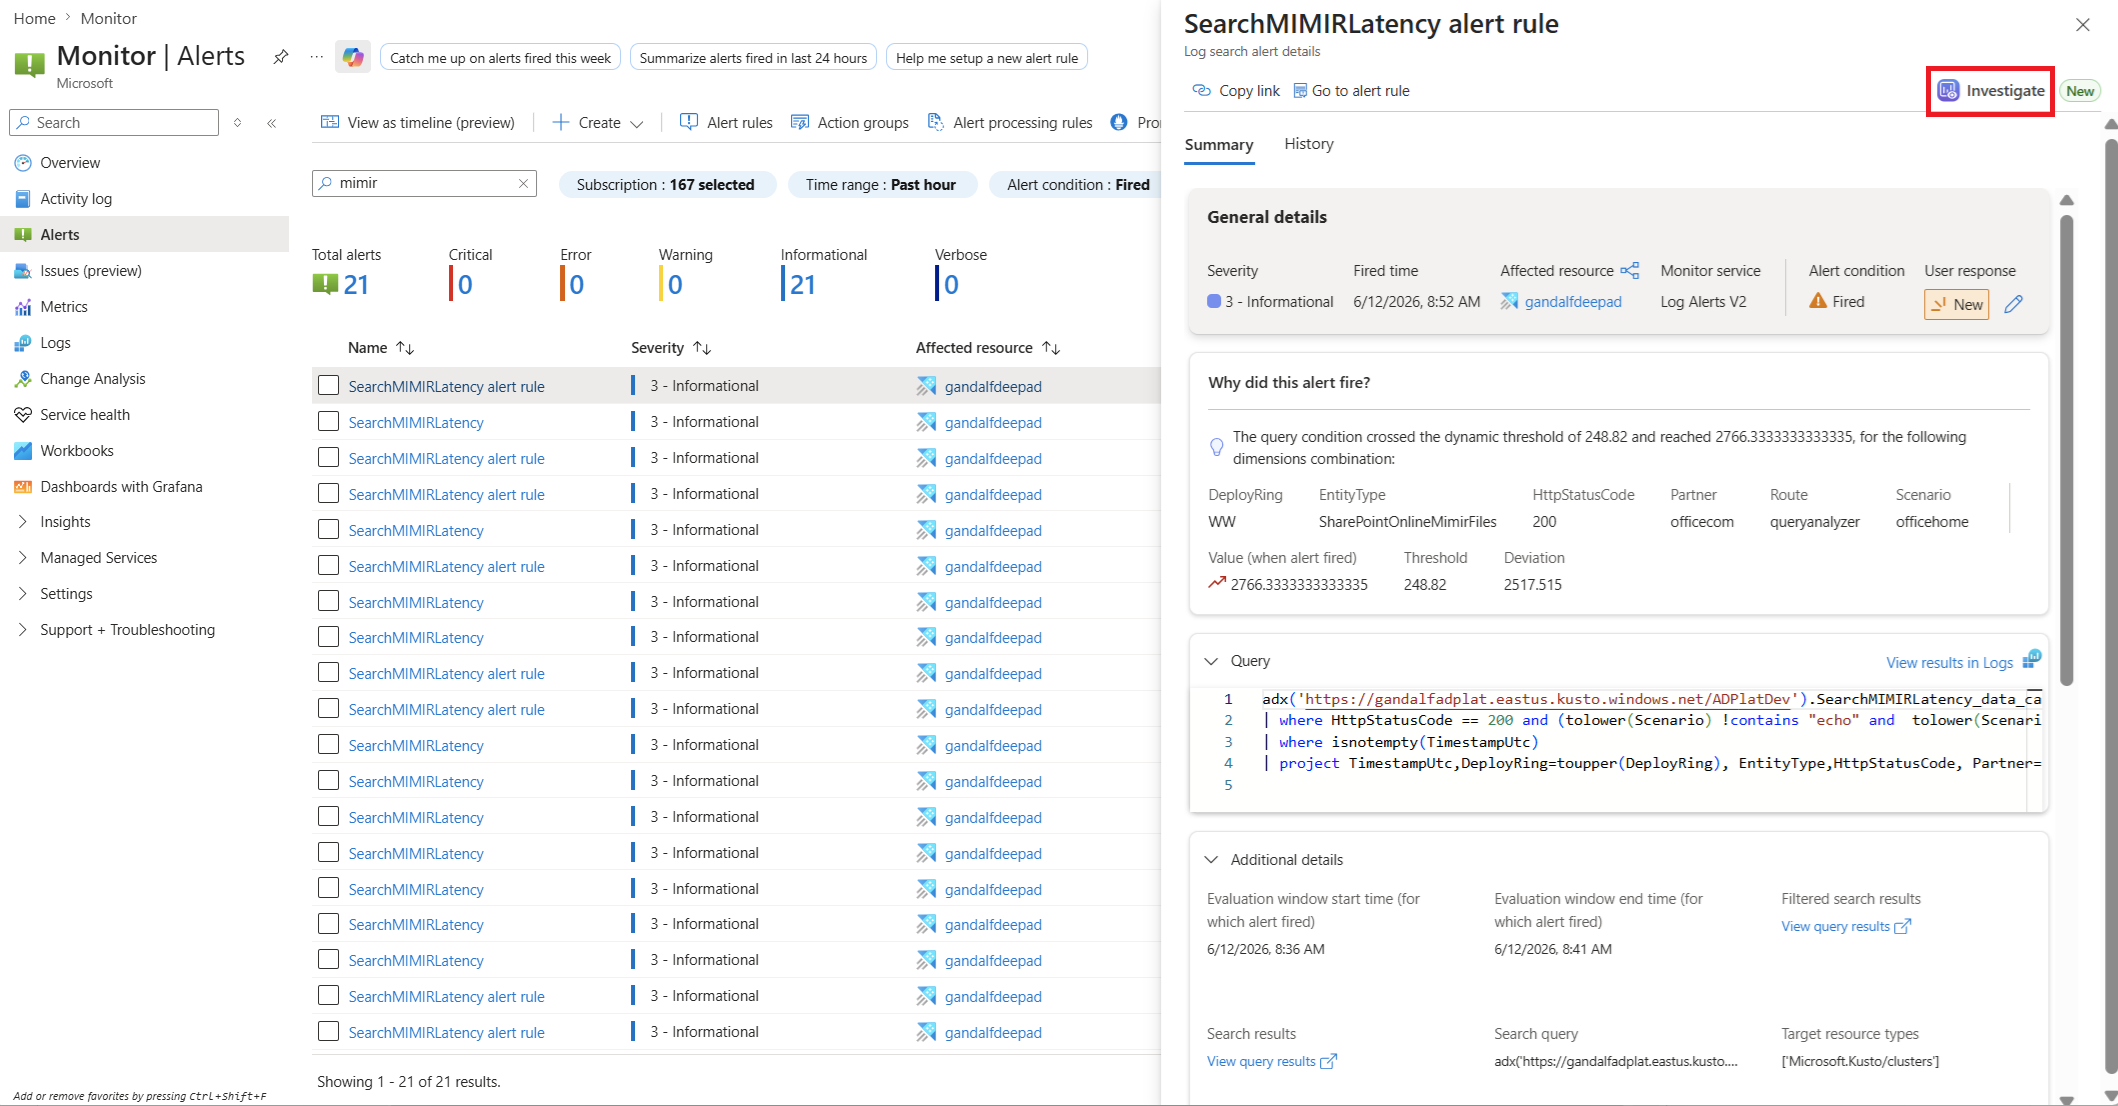
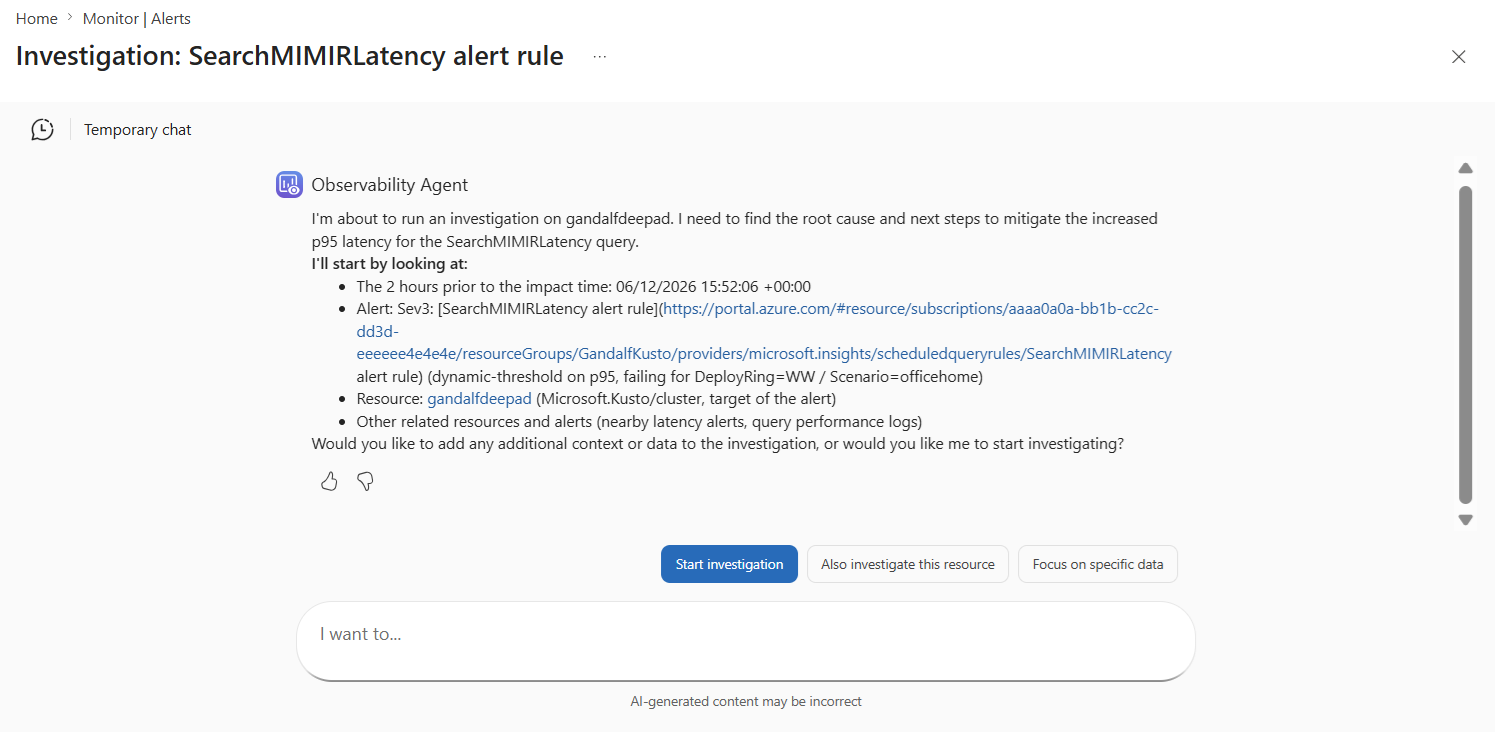
Nadat u Onderzoeken hebt geselecteerd, wordt de waarneembaarheidsagent geopend in een tijdelijke chat en wordt het onderzoek automatisch gericht op de oorspronkelijke waarschuwing. Er wordt een openingsbericht geplaatst met een overzicht van de geplande analyse, met inbegrip van het tijdvenster van de impact, de activerende waarschuwing, de doelresource en de gerelateerde signalen die het wil correleren. Deze signalen omvatten bewakingsregels, relevante metrische gegevens en recente waarschuwingen over aangrenzende resources.
De agent vraagt u vervolgens om aanvullende context op te geven voordat u doorgaat of om te bevestigen dat het onderzoek moet beginnen met behulp van het weergegeven bereik.
E-mailmelding voor waarschuwingen: open de koppeling Onderzoeken vanuit een Azure Monitor waarschuwings-e-mail om een onderzoek te starten zonder eerst de lijst met waarschuwingen te doorlopen.
Logs-blade — opent een chat binnen de context van een Log Analytics-werkruimte of query, waar u kunt opschalen naar een diepgaand onderzoek.
Activiteitenlogboek — start een onderzoek vanuit een Mislukking Resource Health-gebeurtenis in het activiteitenlogboek.
Application Insights — start rechtstreeks vanuit de blade Mislukkingen, waarbij de geselecteerde foutcontext aan de agent wordt doorgegeven, of open de chat vanuit de weergave Agents en schaal op naar een diepgaand onderzoek.
AKS — open de chat vanuit de blade Container Insights of de AKS-resourcepagina en start een diepgaand onderzoek.
Zie Chat met uw waarneembaarheidsgegevens voor meer informatie over chatinvoerpunten.
De pijplijn voor onderzoek in zes fasen
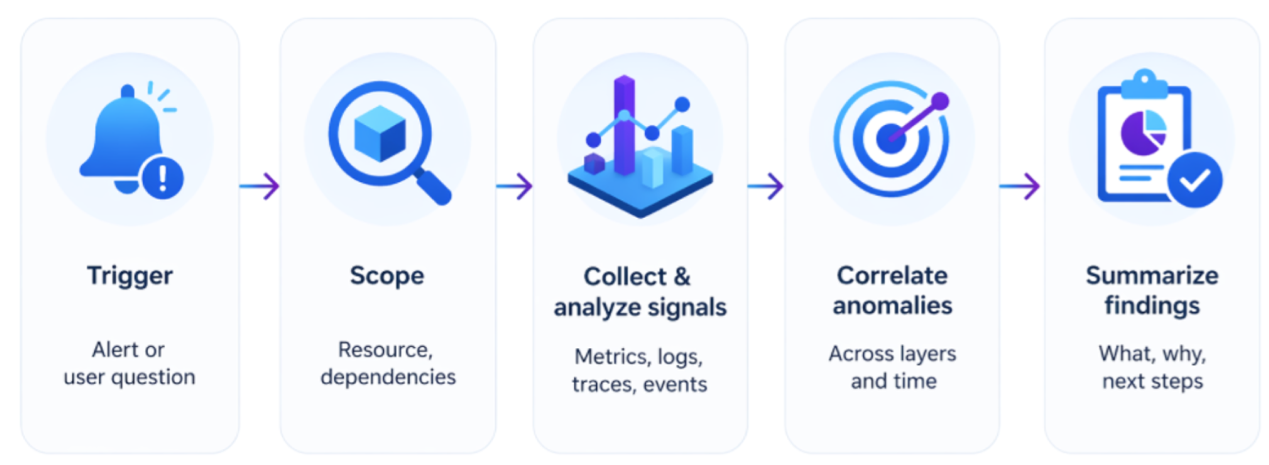
Wanneer u een grondig onderzoek start, voert de agent een vaste reeks fasen uit. Deze fasen worden uitgevoerd zonder uw invoer. De agent voert elke fase automatisch uit en toont tijdens het werken live de voortgang.
| Stage | Wat de agent doet |
|---|---|
| 1. Bereik van het probleem | Identificeert de meest waarschijnlijk getroffen resources en de bijbehorende afhankelijkheden, op basis van de context van het toegangspunt. |
| 2. Gegevens verzamelen | Haalt metrische gegevens, logboeken, traceringen, gebeurtenissen, vermeldingen in activiteitenlogboeken en wijzigingsgeschiedenis voor de resources binnen het bereik op. |
| 3. Afwijkingen detecteren | Hiermee past u geleerde basislijnen toe op metrische gegevens en analyseert u logboeken voor uitschieters en ongebruikelijke patronen. |
| 4. Correleren tussen resources | Brengt signalen uit de applicatie- en infrastructuurlagen met elkaar in lijn om aanwijzingen te vinden die samen bewegen. |
| 5. Voer uitgebreide diagnostische gegevens uit | Roept waar nodig resourcespecifieke hulpprogramma's aan (bijvoorbeeld diagnostische gegevens op AKS-knooppuntniveau of Application Insights-afhankelijkheidsanalyse). |
| 6. Bevindingen samenvatten | Produceert een rapport waarin wordt uitgelegd wat er is gebeurd, waarom en wat u vervolgens moet doen. |
De volgende afbeelding toont hoe de agent de acties samenvat die deze van plan is te ondernemen nadat het probleem is afgebakend.
In het volgende diagram ziet u het diepgaande onderzoek in één oogopslag. Het vak Collect & analyze signals omvat zowel gegevensverzameling als anomaliedetectie uit de gedetailleerde tabel, en diepgaande resourcespecifieke diagnostiek wordt uitgevoerd als onderdeel van Correlate anomalies.
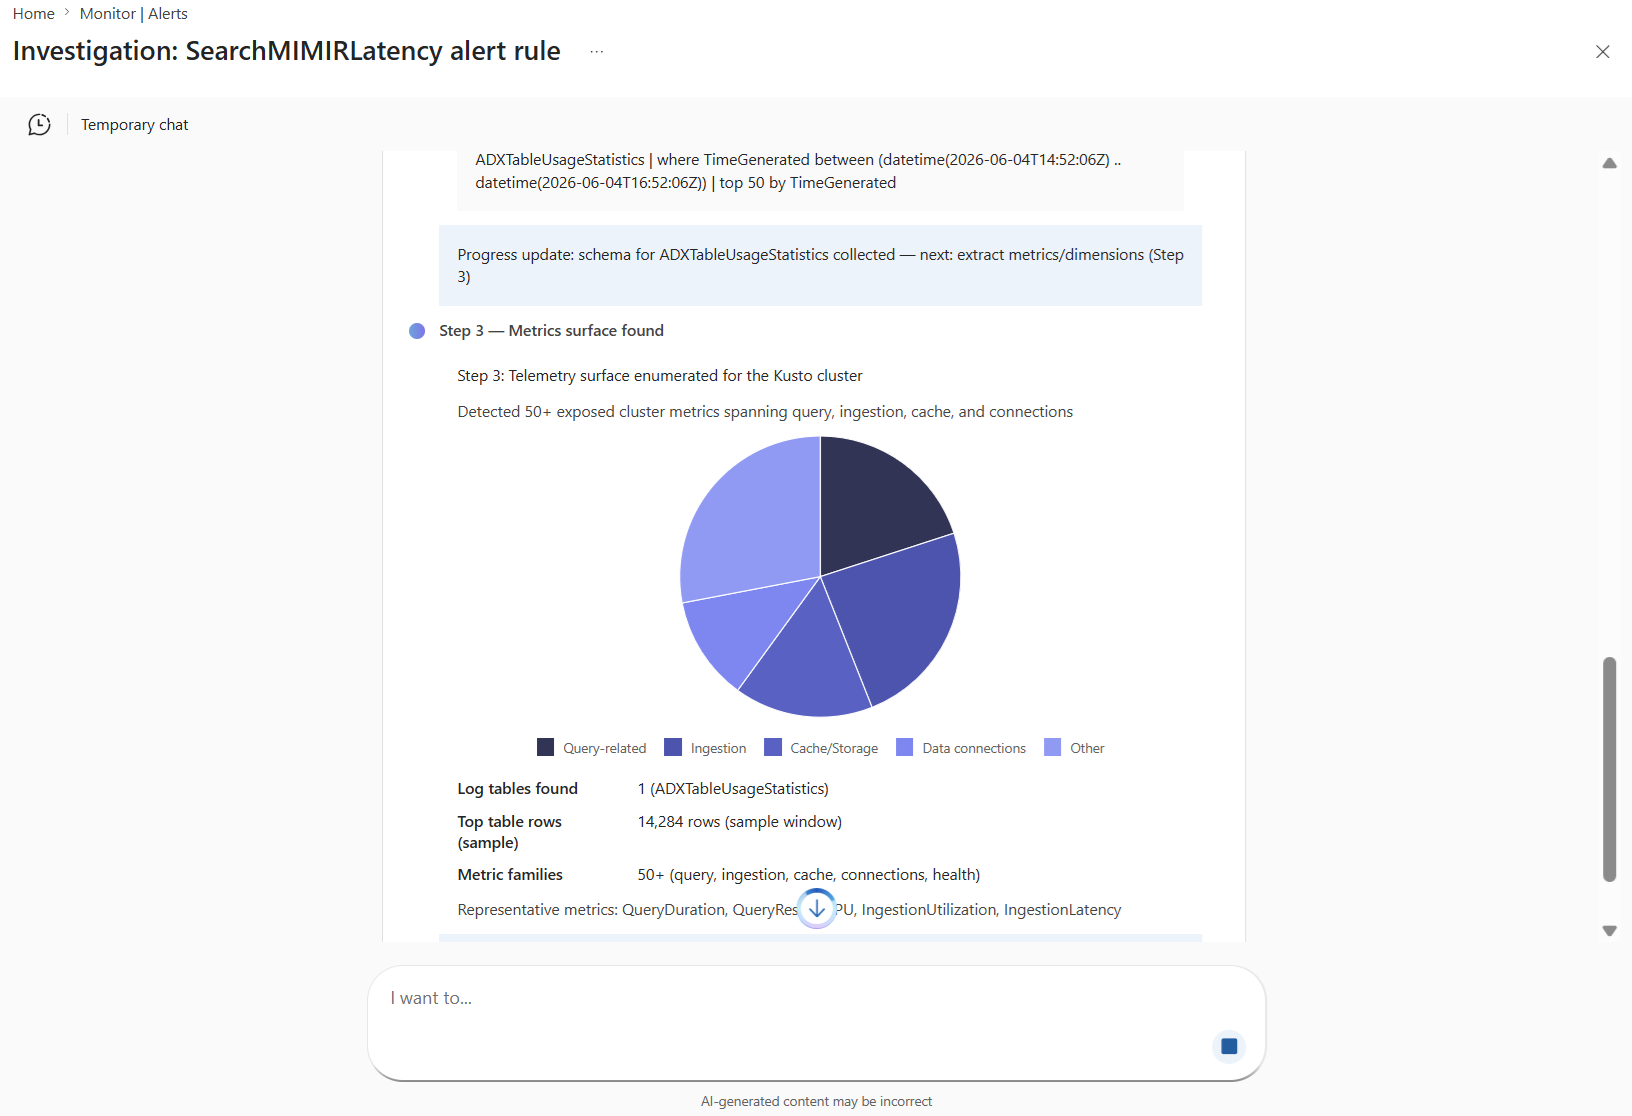
Naarmate het onderzoek vordert, streamt de agent de bevindingen in realtime.
Hoe de agent redeneert bij een incident
Diepgaande onderzoeken volgen een praktische controlelus die weerspiegelt hoe ervaren responders werken:
- Formuleer een hypothese op basis van de incidenttrigger en de reikwijdte.
- Verzamel en correleert bewijs over toepassings-, infrastructuur- en platformsignalen.
- Test alternatieve uitleg door te controleren of signalen worden uitgelijnd op tijd, bereik en type.
- Sluit zwakke hypothesen uit wanneer er bewijs ontbreekt of inconsistent is.
- Verfijn en vat de meest waarschijnlijke uitleg samen met aanbevolen volgende stappen.
Deze lus is waarom onderzoeksuitvoer zowel bevindingen als hypothesen bevat die zijn uitgesloten. Hiermee kunt u het redeneringspad controleren, niet alleen de uiteindelijke conclusie.
Hoe de agent signalen uitlijnt op tijd, bereik en type
De agent ordent het bewijsmateriaal langs drie assen, zodat het uiteindelijke rapport oorzaak en gevolg met elkaar in verband brengt in plaats van elke anomalie op te sommen die het heeft gedetecteerd.
- Tijd — is het signaal met het incident mee verplaatst? Een CPU-piek die 20 minuten voordat de waarschuwing afging begon en hetzelfde verloop heeft, wordt als gecorreleerd beschouwd. Een piek ten opzichte van de vorige dag is dat niet.
- Bereik — deelt het signaal een resource, afhankelijkheid, bewerking of regio met het incident? Latentie van een afhankelijkheid die door de betrokken app wordt aangeroepen, hangt samen. Voor de latentie van een andere, niet-verwante app in dezelfde regio geldt dat niet.
- Type : komt het signaal overeen met het symptoom? Een toename van het aantal uitzonderingen houdt verband met een waarschuwing voor een foutpercentage. Een trage schijf doet dat niet, tenzij die deel uitmaakt van het pad van de mislukkende aanvraag.
Met deze uitlijning van drie assen kan de agent niet-gerelateerde ruis uitsluiten en een korte lijst met causaal relevant bewijs presenteren.
Een diepgaand onderzoek correleert bewijs over meerdere lagen en resources, dus de hoofdoorzaakanalyse is niet beperkt tot één resource of signaaltype. De agent behandelt waarschuwingen als ondersteunend bewijs, niet als de hoofdoorzaak. De agent gebruikt waarschuwingen om het tijdvenster en de betrokken resources te verankeren en kijkt vervolgens achter de waarschuwing om te vinden wat er daadwerkelijk is gewijzigd.
Wat het onderzoeksrapport bevat
Het onderzoeksrapport beantwoordt de vragen die een on-call engineer tijdens een incident stelt:
- Afbakening van het incident — wat de aanleiding was voor het onderzoek, het tijdvenster en het impactgebied (welke bronnen worden getroffen).
- Betrokken onderdelen : toepassings-, infrastructuur- en platformbronnen die bewijs van het probleem tonen.
- Uitgesloten hypothesen — alternatieve oorzaken die de agent heeft overwogen en het bewijs waarmee die zijn uitgesloten. Dit bewijs maakt de conclusie verifieerbaar.
- Oplossingsstappen : aanbevolen acties om het systeem te stabiliseren.
- Ondersteunende gegevens : koppelingen terug naar de metrische gegevens, logboeken, query's en vermeldingen in het activiteitenlogboek die door de agent worden gebruikt.
- Livevoortgang : het rapport wordt gestreamd terwijl het onderzoek wordt uitgevoerd, zodat u resultaten kunt zien terwijl ze worden geproduceerd.
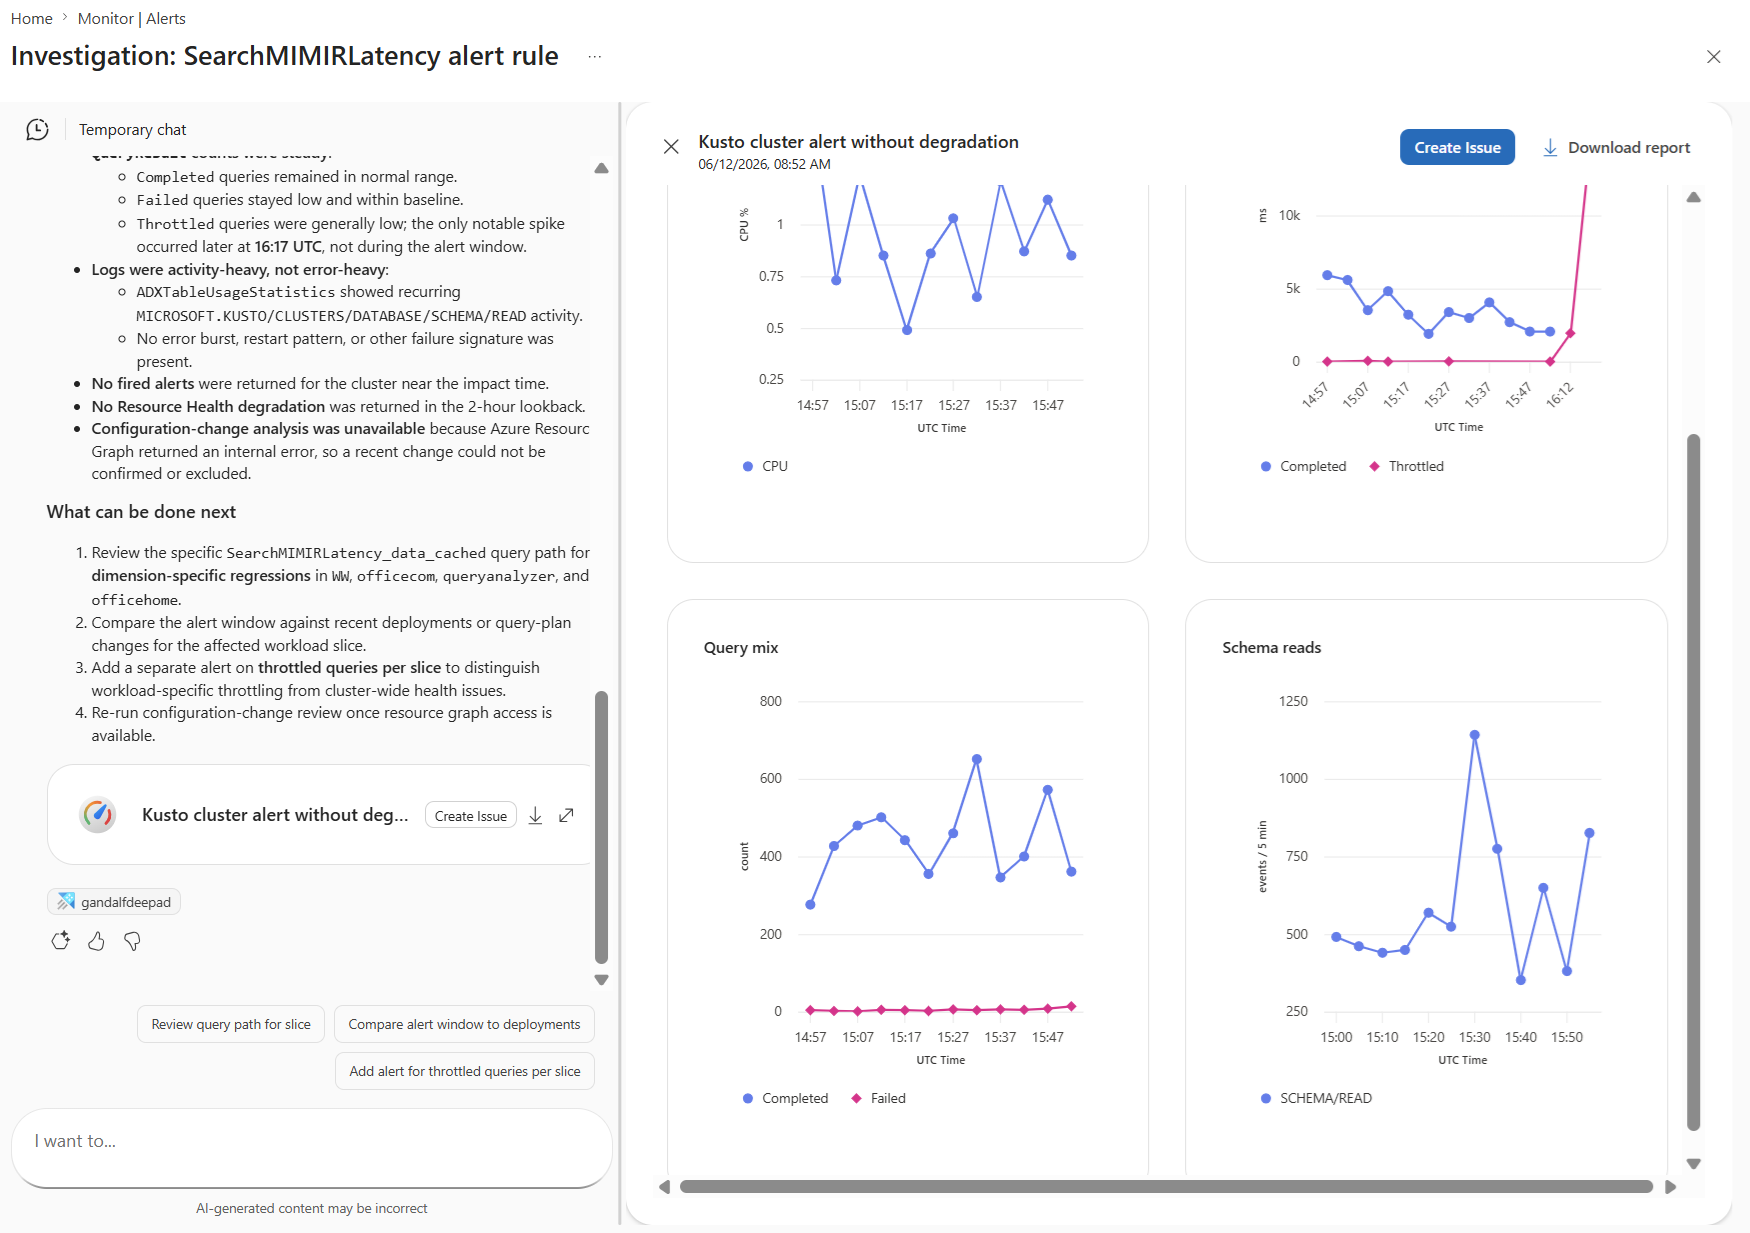
In de volgende afbeelding ziet u een onderzoeksrapport met de bevindingen van de agent en een lijst met aanbevolen volgende stappen.
Vervolgprompts die een onderzoek verfijnen
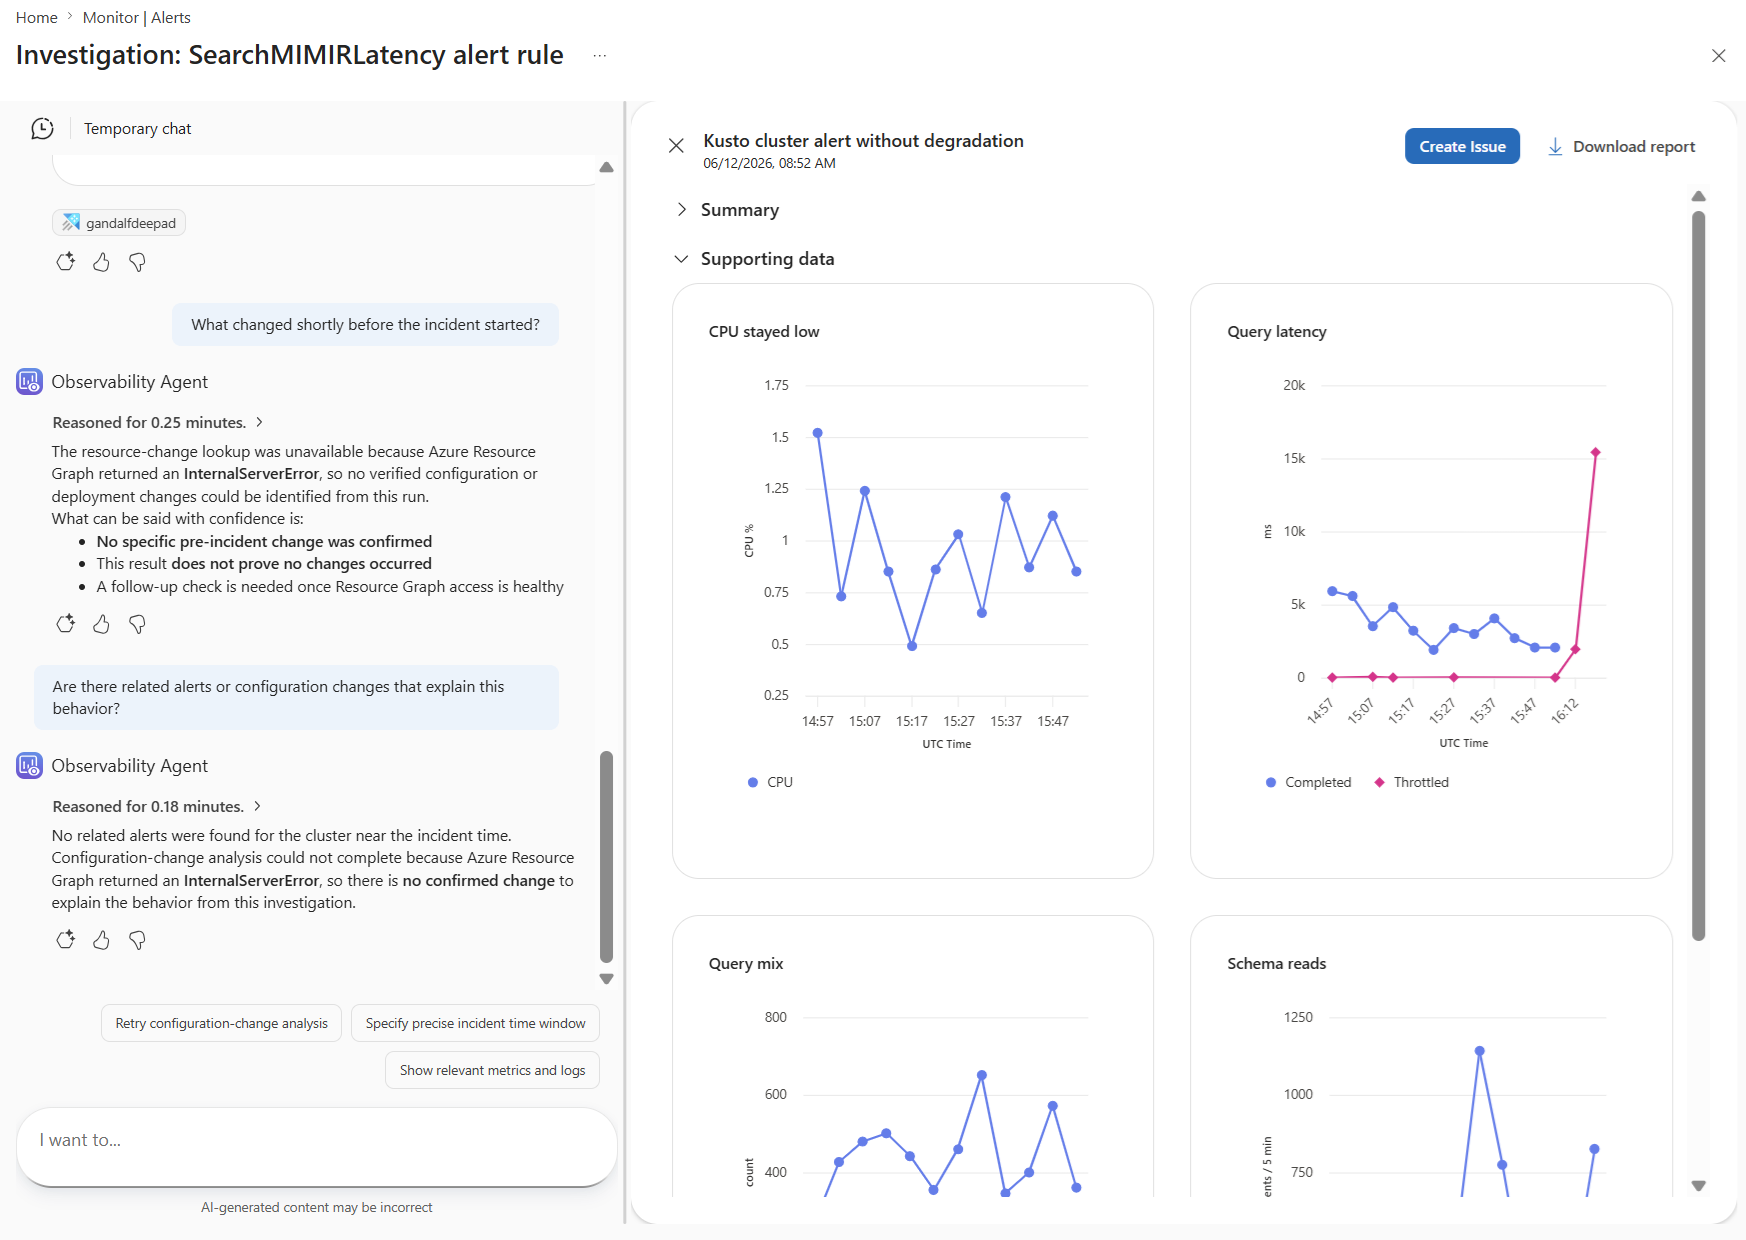
Nadat de agent een rapport heeft teruggestuurd, stel vervolgvragen om de reikwijdte te verfijnen, alternatieve hypothesen te testen of over te schakelen naar een verwante bron. Het gesprek houdt de context van het onderzoek bij, zodat u het incident niet opnieuw maakt.
Voorbeelden van nuttige vervolgprompts zijn:
- Wat veranderde er kort voordat het incident begon?
- 'Zijn er problemen in de VM
<vm-id>en zijn ze gerelateerd? Zo ja, voer dan een grondig onderzoek uit, inclusief deze VM.' - "Welke afhankelijkheden zijn het meest gecorreleerd met deze foutpiek?"
- 'Zijn er gerelateerde waarschuwingen of configuratiewijzigingen die dit gedrag uitleggen?'
Hier volgt een voorbeeld waarin een gebruiker vervolgvragen heeft gesteld.
Onderzoeksresultaten opslaan als een Azure Monitor probleem
Onderzoeksresultaten zijn tijdelijk. Sla het onderzoek op als een Azure Monitor probleem om de volledige context te behouden, waaronder het rapport, de redenering van de agent, de ondersteunende gegevens en het vervolggesprek. Vanuit het probleem kunt u het gesprek later hervatten, het delen met teamleden en de analyse voortzetten zonder context te verliezen.
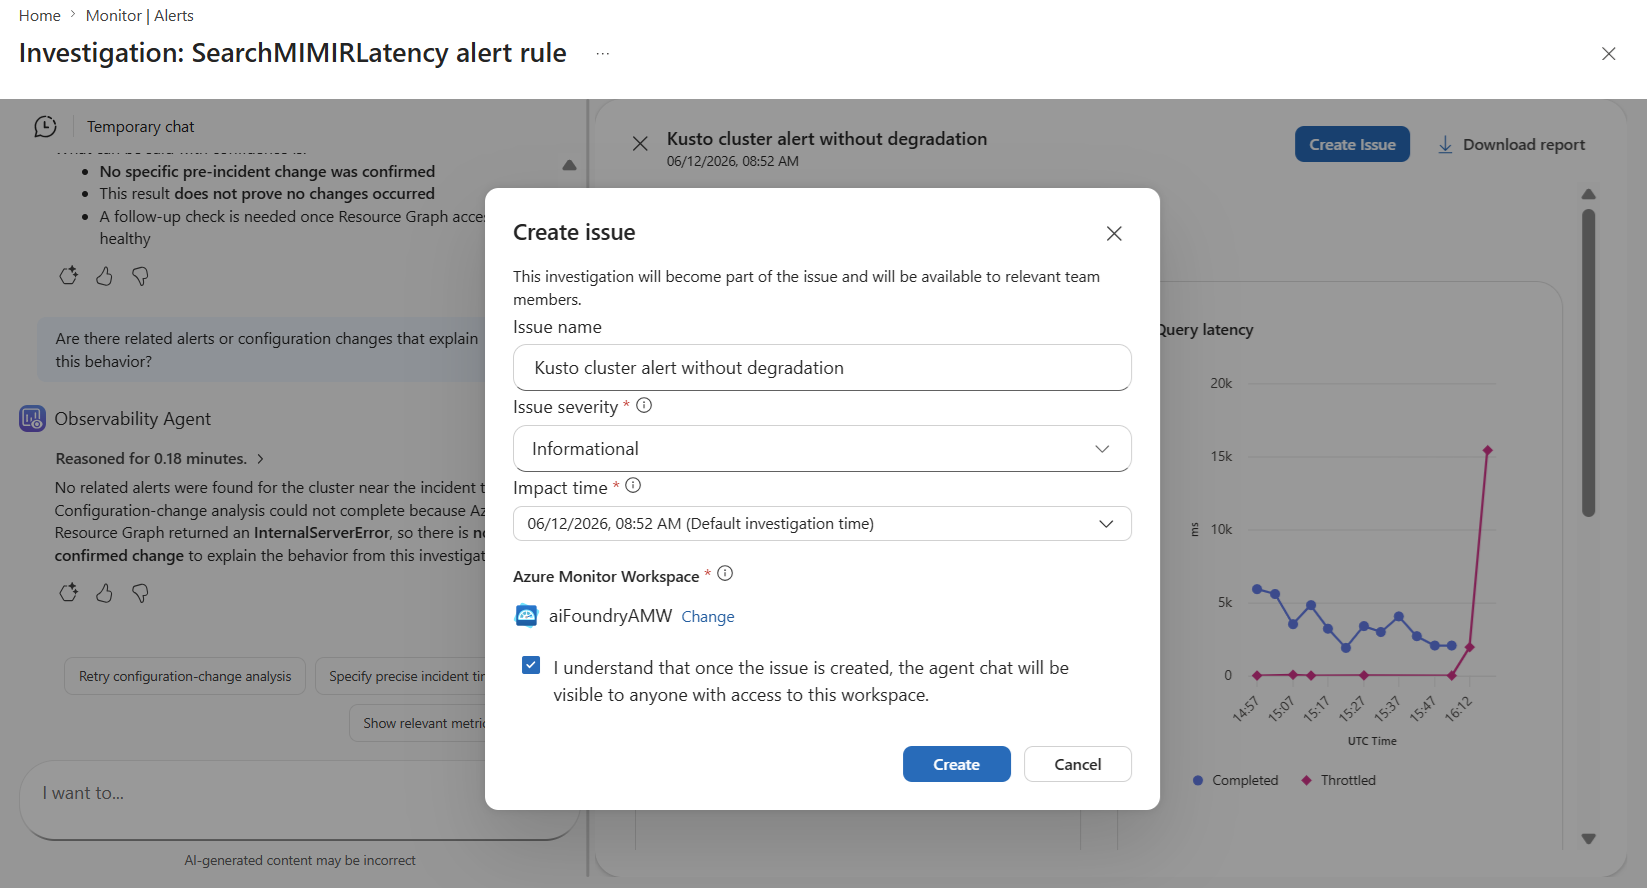
Zie Azure Monitor problemen en gebruik Azure Monitor voor meer informatie over problemen.
Escaleren van chat naar een grondig onderzoek
Wanneer chatverkenning op de pagina Logboeken een dieper probleem aan het licht brengt dan met ad-hocvragen kan worden opgelost, schakel dan over op een volledig diepgaand onderzoek zonder de chat te verlaten. De agent neemt de context van de chat mee als uitgangspunt voor het onderzoek.
Zie Chat met uw waarneembaarheidsgegevens voor meer informatie over de chatwerkstroom.
Hoe de agent de redenering verklaart
De waarneembaarheidsagent geeft de redenering weer zoals deze werkt: welke signalen worden overwogen, welke query's zijn uitgevoerd en welke Azure resources waartoe deze toegang heeft. Met deze transparantie kunt u de conclusies van de agent controleren, de patronen leren die deze gebruikt en gevallen ondervangen waarbij de beschikbare signalen de voorgestelde volgende stap niet ondersteunen.
Zie Transparantie in de Azure Copilot Waarneembaarheidsagent voor meer informatie over wat is geregistreerd, hoe redenering wordt gepresenteerd en hoe u agentacties controleert.
Gegevensretentie, privacy en verantwoordelijk gebruik
De service kan onderzoeksgegevens maximaal 30 dagen bewaren om onderzoeken en gebruikersinteracties te ondersteunen. Microsoft gebruikt geen prompts of reacties van agents om de onderliggende AI-modellen te trainen of te verbeteren.
Zie Veelgestelde vragen over transparantie voor Azure Copilot Observability Agent voor verwachtingen met betrekking tot transparantie en betrouwbaarheid. Zie de FAQ over gegevens, privacy en governance voor Azure Copilot Observability Agent voor informatie over governance, privacy en naleving.
Regio's en huidige beperkingen
Diepgaande onderzoeken zijn beschikbaar in dezelfde Azure regio's als de Waarneembaarheidsagent zelf. Zie Regio's in het overzicht voor de huidige regiolijst. Zie Problemen met de Azure Copilot Waarneembaarheidsagent oplossen voor bekende beperkingen en probleemoplossing.
Wat is de volgende stap: autonome bewerkingen
Naast de door de gebruiker geïnitieerde diepgaande onderzoeken die in dit artikel worden beschreven, kan de Waarneembaarheidsagent automatisch diepgaande onderzoeken uitvoeren op problemen die door de agent zijn gemaakt, zonder een gebruikersprompt. Autonome bewerkingen zijn in openbare preview bij de lancering, zijn standaard ingeschakeld met opt-out en de facturering voor autonome diepgaande onderzoeken is gestart op 1 juli 2026.
Zie Autonome bewerkingen in de Azure Copilot Waarneembaarheidsagent voor installatie, opt-out, aangepaste instructies, op rollen gebaseerd toegangsbeheer en de factureringsgegevens die specifiek zijn voor autonome bewerkingen.
Verwante inhoud
- Overzicht van Azure Copilot Waarneembaarheidsagent
- Chatten met uw waarneembaarheidsgegevens
- Voorbeelden van diepgaand onderzoek in de Azure Copilot Waarneembaarheidsagent
- Transparantie in de Azure Copilot Waarneembaarheidsagent
- Autonome bewerkingen in de Azure Copilot Waarneembaarheidsagent
- Overzicht van problemen met Azure Monitor
- Aanbevolen procedures voor de Azure Copilot Observability-agent
- Facturerings- en kostenbeheer voor waarneembaarheidsagent in Azure Monitor