Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Belangrijk
Items die in dit artikel zijn gemarkeerd (preview) zijn momenteel beschikbaar als openbare preview. Deze preview wordt aangeboden zonder een service level agreement en we raden deze niet aan voor productieworkloads. Bepaalde functies worden mogelijk niet ondersteund of hebben mogelijk beperkte mogelijkheden. Zie Aanvullende gebruiksvoorwaarden voor Microsoft Azure previews voor meer informatie.
Gebruik het dashboard Agentbewaking in Microsoft Foundry om operationele metrische gegevens en evaluatieresultaten voor uw agents bij te houden. Dit dashboard helpt u inzicht te krijgen in tokengebruik, latentie, slagingspercentages en evaluatieresultaten voor productieverkeer.
In dit artikel worden twee benaderingen behandeld: metrische gegevens weergeven in de Foundry-portal en programmatisch continue evaluatie instellen met de Python SDK.
Voorwaarden
- Een Foundry-project met ten minste één agent.
- Een Application Insights-resource die is verbonden met uw project.
- Toegang tot de Foundry portal.
- Python 3.9 of hoger (vereist voor Python SDK-stappen).
- Azure toegangsbeheer op basis van rollen (RBAC) tot de Application Insights-resource. Voor weergaven op basis van logboeken hebt u ook toegang nodig tot de bijbehorende Log Analytics werkruimte. Als u de toegang wilt controleren, opent u de Application Insights-resource in de Azure-portal, selecteert u Access-beheer (IAM) en controleert u of uw account een geschikte rol heeft. Wijs voor logboektoegang de rol Log Analytics Lezer toe. Als deze Log Analytics tabellen zijn beveiligd (beveiligingsniveau ingesteld op Beveiligd), wijst u ook de rol Privileged Monitoring Data Reader toe om die gegevens te lezen.
Verbinding maken met Application Insights
Het dashboard Voor agentbewaking leest telemetrie uit de Application Insights-resource die is verbonden met uw Foundry-project. Als u Application Insights nog niet hebt verbonden, volgt u de installatiestappen voor tracering en gaat u terug naar dit artikel.
Metrieken van de agent weergeven (preview)
Metrische gegevens voor een agent weergeven in de Foundry-portal:
-
Meld u aan bij Microsoft Foundry. Zorg ervoor dat de wisselknop New Foundry is ingeschakeld. Deze stappen verwijzen naar Foundry (nieuw).
Selecteer in de bovenste navigatie build en selecteer vervolgens de agent waarvoor u gegevens wilt weergeven.
Selecteer het tabblad Monitor om operationele, evaluatie- en red-teaminggegevens van uw agent weer te geven.
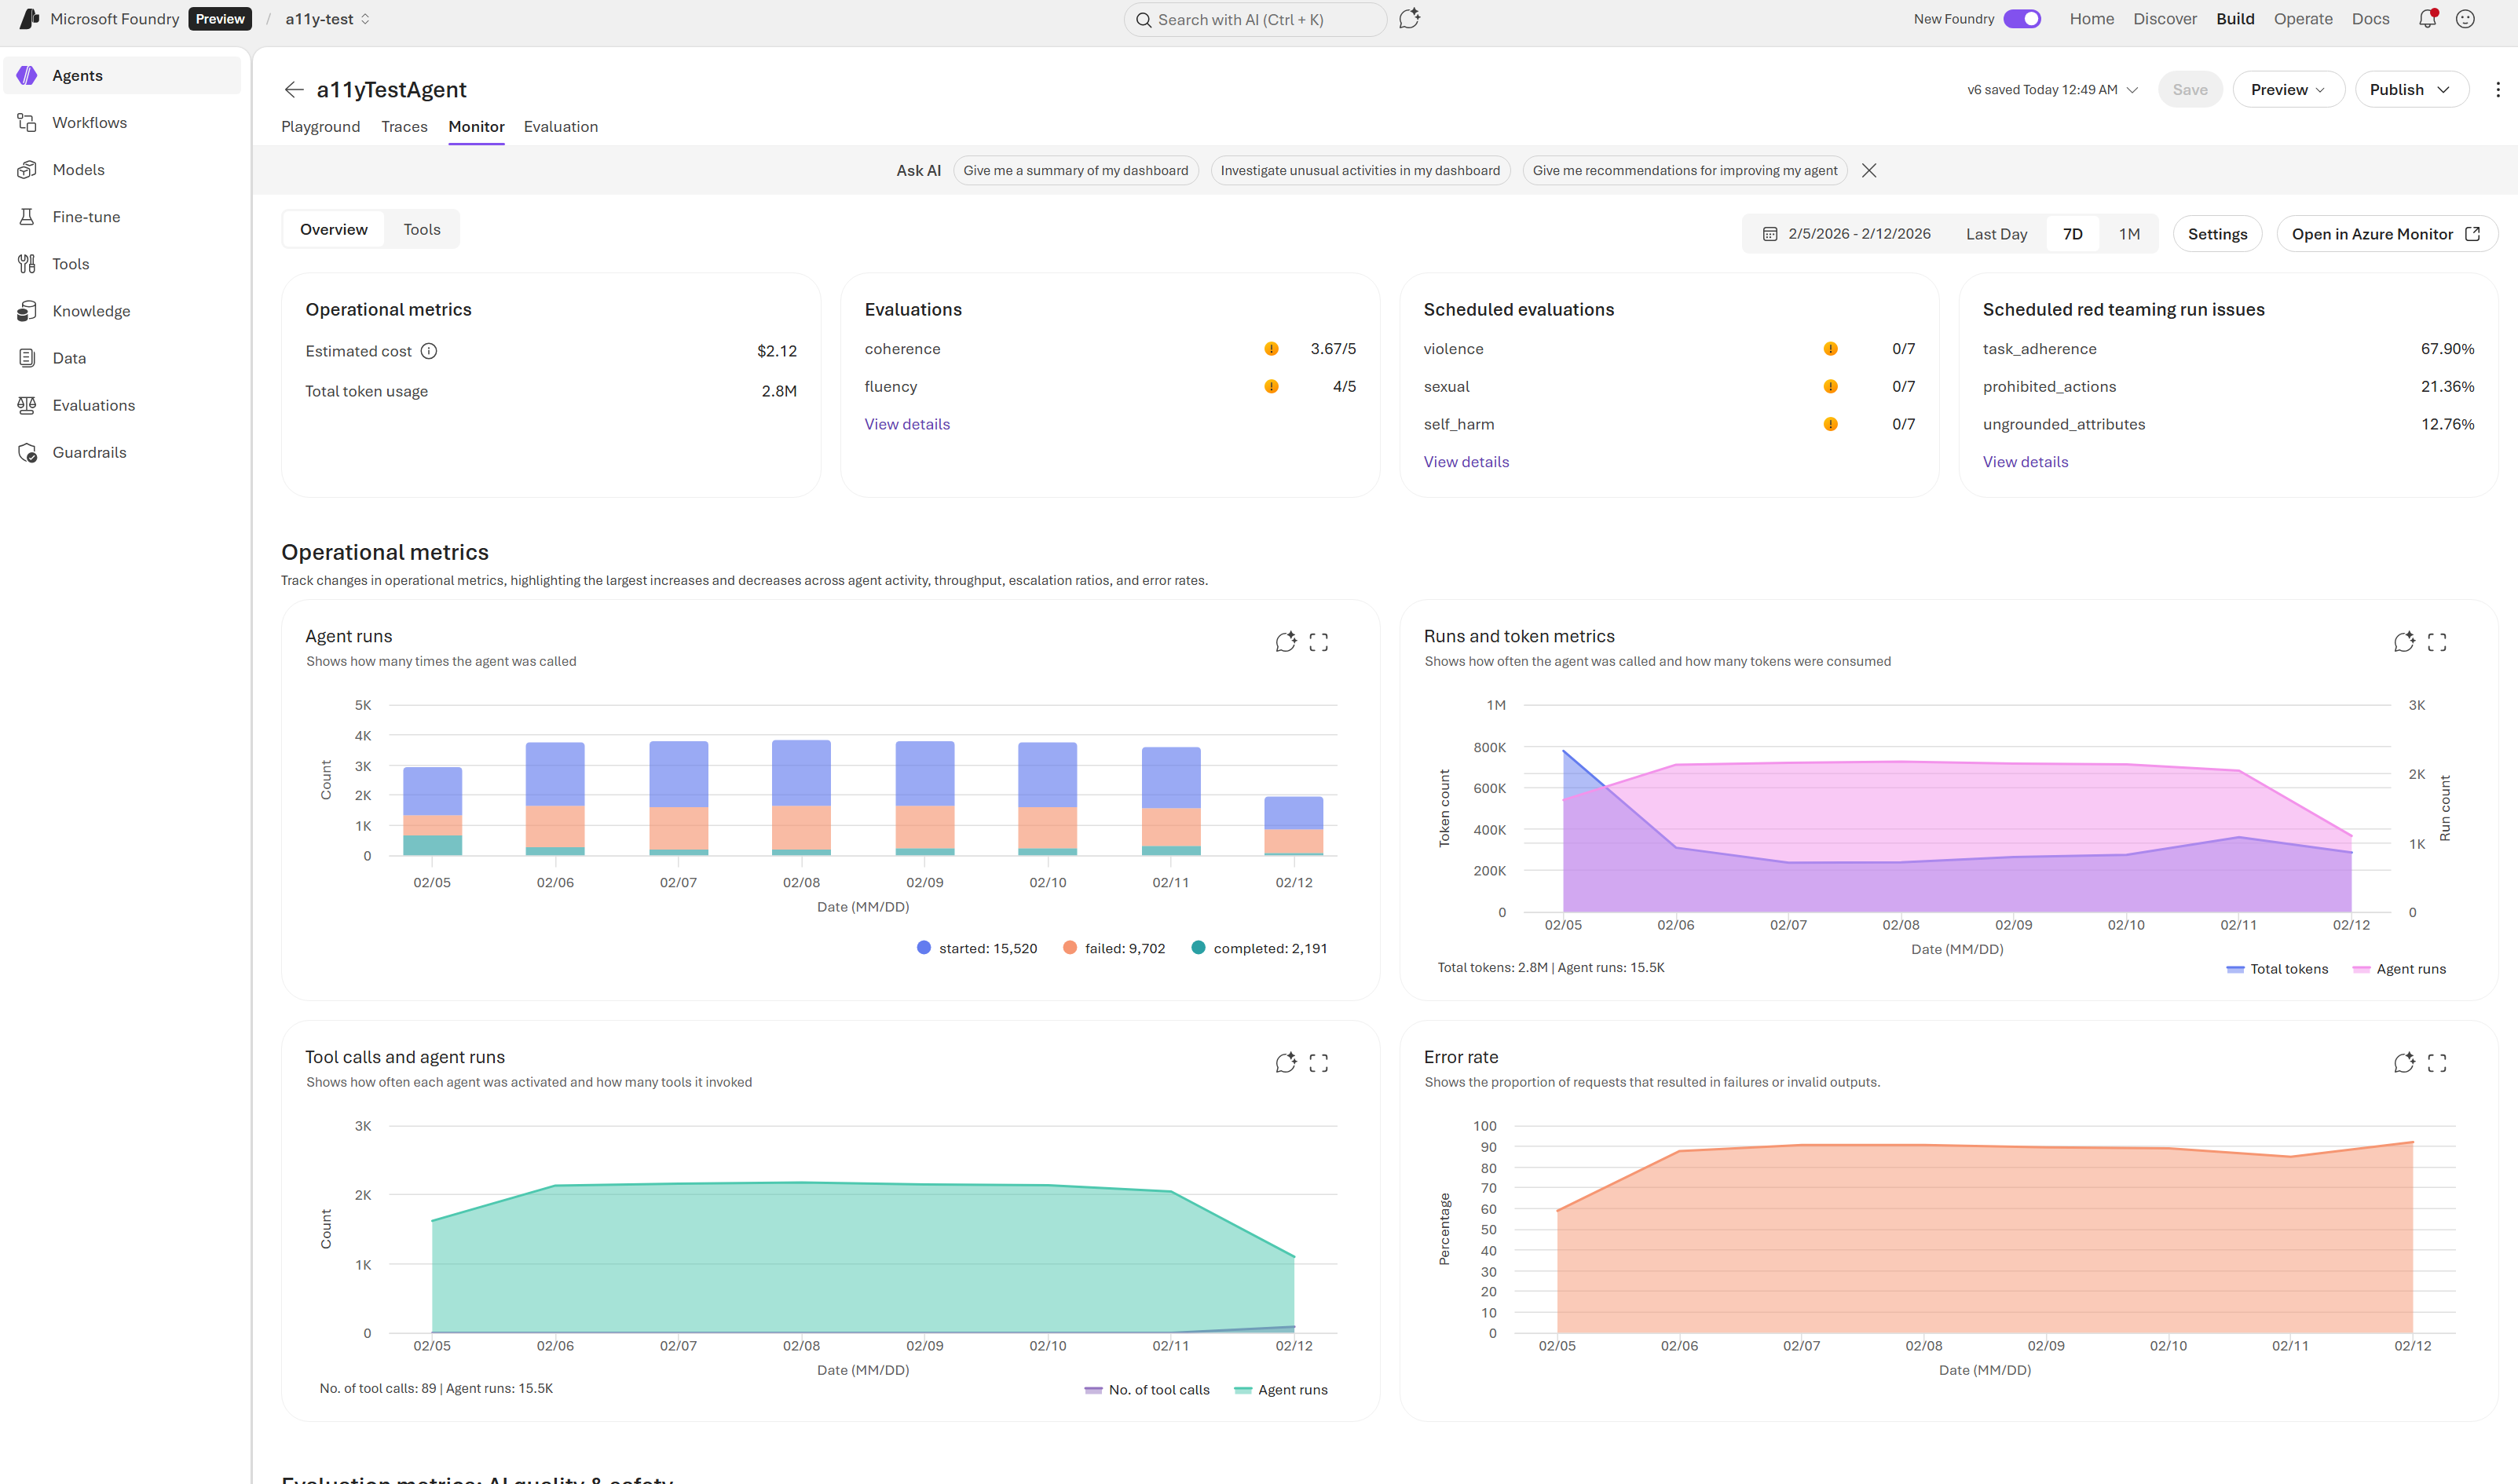
Het dashboard is ontworpen voor snelle inzichten en diepgaande analyse van de prestaties van uw agent. Het bestaat uit twee hoofdgebieden:
Overzichtskaarten bovenaan voor metrische gegevens op hoog niveau.
Grafieken en diagrammen hieronder voor gedetailleerde informatie. Deze visualisaties weerspiegelen gegevens voor het geselecteerde tijdsbereik.
Inzicht in de metrieke gegevens van het dashboard
Gebruik deze definities om het dashboard te interpreteren:
- Tokengebruik: Token telt voor agentverkeer in het geselecteerde tijdsbereik. Hoog tokengebruik kan duiden op overdreven gedetailleerde prompts of antwoorden die kunnen profiteren van optimalisatie.
- Latentie: reactietijd voor agentuitvoeringen. Latentie van meer dan 10 seconden kan duiden op modelbeperking, complexe hulpprogramma-aanroepen of netwerkproblemen.
- Run-succespercentage: het percentage uitvoeringen dat succesvol is afgerond. Een percentage onder de 95% rechtvaardigt onderzoek naar mislukte uitvoeringen.
- Metrische evaluatiegegevens: scores die worden geproduceerd door evaluators die worden uitgevoerd op uitvoer van een sample-agent. Scores variëren per evaluator; bekijk de documentatie voor individuele evaluator voor interpretatierichtlijnen.
- Resultaten van red teaming: resultaten van geplande red team-scans, indien ingeschakeld. Mislukte scans geven potentiële beveiligingsrisico's aan waarvoor herstel is vereist.
Opmerking
Bewakingsgegevens worden opgeslagen in de verbonden Application Insights-resource. Retentie en facturering volgen uw Application Insights-configuratie.
Instellingen configureren
Gebruik het deelvenster Instellingen bewaken om telemetrie, evaluaties en beveiligingscontroles voor uw agents te configureren. Met deze instellingen bepaalt u welke grafieken in het dashboard worden weergegeven en welke evaluaties worden uitgevoerd.
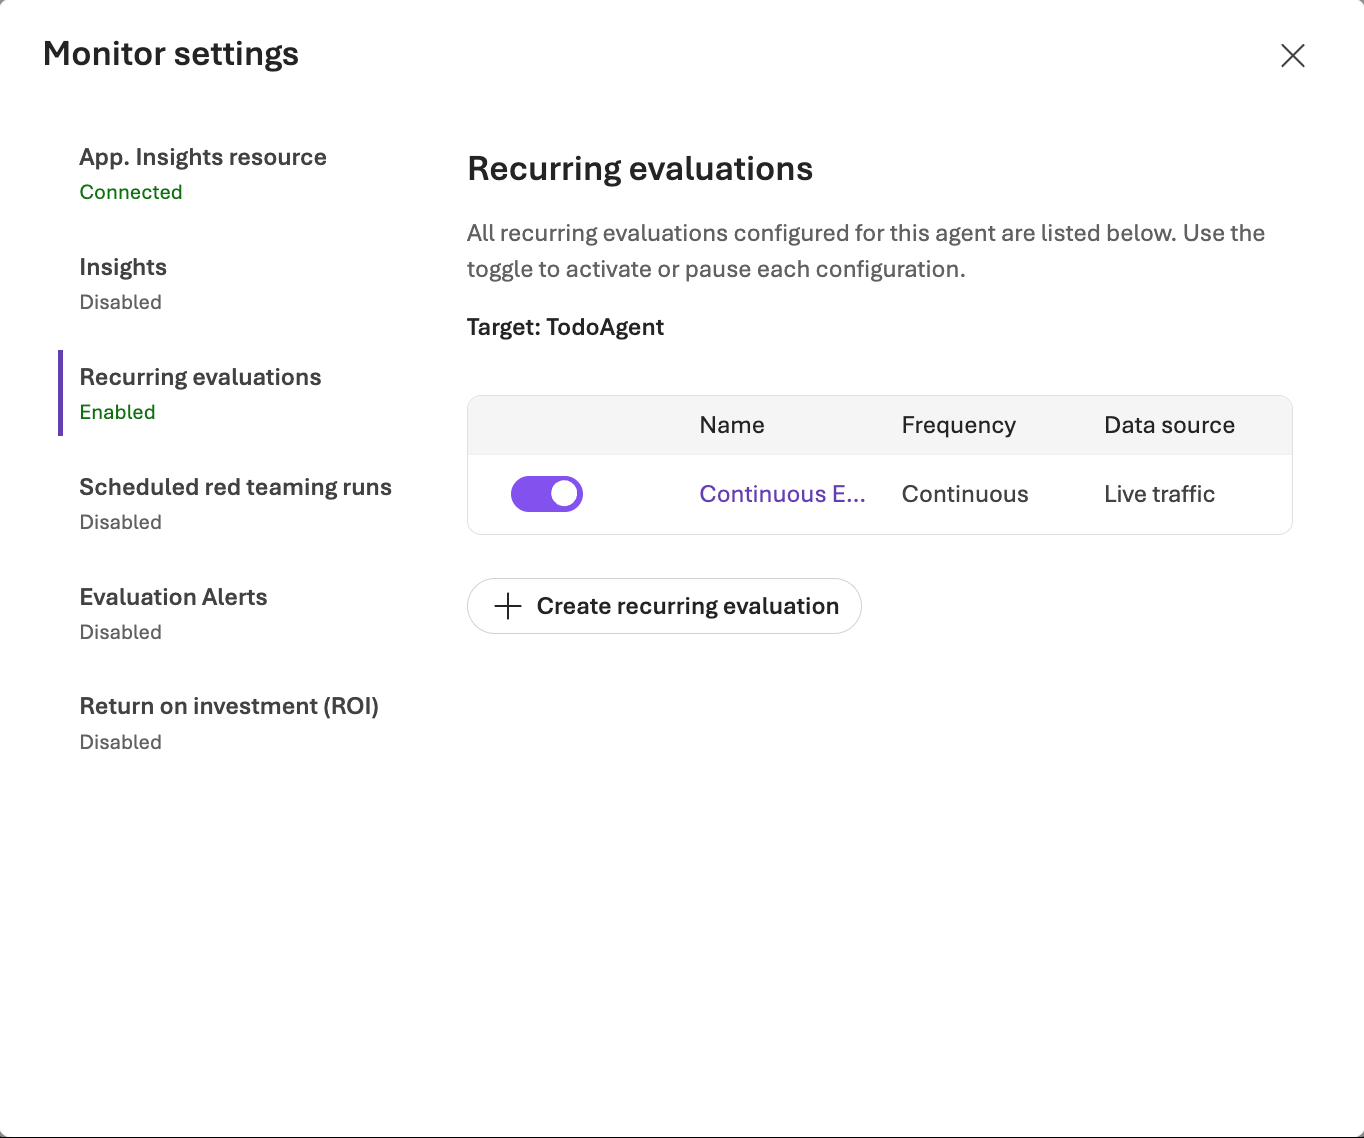
Als u de instellingen van Monitor wilt openen, selecteert u het tandwielpictogram op het tabblad Monitor . In de volgende tabel wordt elke bewakingsfunctie beschreven:
| Instelling | Purpose | Configuratieopties |
|---|---|---|
| Terugkerende evaluaties (preview-versie) | Voert evaluaties uit volgens een schema om de prestaties te valideren op basis van benchmarks. | Gebruik de wizard voor het maken van de evaluatie om een terugkerende evaluatie te maken en te plannen. |
| Red team scans (voorvertoning) | Voert adversarial tests uit om risico's te detecteren, zoals gegevenslekken of verboden acties. | In- of uitschakelen Een evaluatiesjabloon selecteren en uitvoeren Een planning instellen |
| Waarschuwingen (preview) | Detecteert prestatieafwijkingen, evaluatiefouten en beveiligingsrisico's. | Waarschuwingen configureren voor latentie, tokengebruik, evaluatiescores of rode teamresultaten |
Doorlopende evaluatie instellen
Gebruik de Foundry-portal, de Python SDK of de .NET SDK om terugkerende evaluaties in te stellen voor het bewaken van uw agents.
Voor deze sectie is Python 3.9 of hoger vereist.
pip install "azure-ai-projects>=2.0.0" python-dotenv
Stel deze omgevingsvariabelen in met uw eigen waarden:
-
AZURE_AI_PROJECT_ENDPOINT: Het Foundry-projecteindpunt, zoals te vinden is op de overzichtspagina van het project in de Foundry-portal. -
AZURE_AI_AGENT_NAME: De naam van de agent die moet worden gebruikt voor evaluatie. -
AZURE_AI_MODEL_DEPLOYMENT_NAME: De implementatienaam van het model.
Machtigingen toewijzen voor continue evaluatie
Als u regels voor continue evaluatie wilt inschakelen, wijst u de door het project beheerde identiteit toe aan de rol Foundry-gebruiker .
Belangrijk
De rollen Foundry RBAC zijn onlangs hernoemd. Foundry User, Foundry Owner, Foundry Account Owner en Foundry Project Manager zijn eerder benoemd Azure AI-gebruiker, Azure AI-eigenaar Azure AI-accounteigenaar en Azure AI Project Manager. Het kan zijn dat u op sommige plekken nog steeds de vorige namen ziet terwijl de naamswijziging wordt doorgevoerd. De rol-id's en basismachtigingen worden niet gewijzigd door de naamswijziging.
- Open in de Azure-portal de resource voor uw Foundry-project.
- Selecteer Toegangsbeheer (IAM) en selecteer vervolgens Toevoegen.
- Maak een roltoewijzing voor Foundry User.
- Selecteer voor het lid de beheerde identiteit van uw Foundry-project.
Een agent maken
import os
from dotenv import load_dotenv
from azure.identity import DefaultAzureCredential
from azure.ai.projects import AIProjectClient
from azure.ai.projects.models import (
    PromptAgentDefinition,
)

load_dotenv()

endpoint = os.environ["AZURE_AI_PROJECT_ENDPOINT"]

with (
    DefaultAzureCredential() as credential,
    AIProjectClient(endpoint=endpoint, credential=credential) as project_client,
    project_client.get_openai_client() as openai_client,
):
    agent = project_client.agents.create_version(
        agent_name=os.environ["AZURE_AI_AGENT_NAME"],
        definition=PromptAgentDefinition(
            model=os.environ["AZURE_AI_MODEL_DEPLOYMENT_NAME"],
            instructions="You are a helpful assistant that answers general questions",
        ),
    )
    print(f"Agent created (id: {agent.id}, name: {agent.name}, version: {agent.version})")
Verwijzingen: AIProjectClient, DefaultAzureCredential
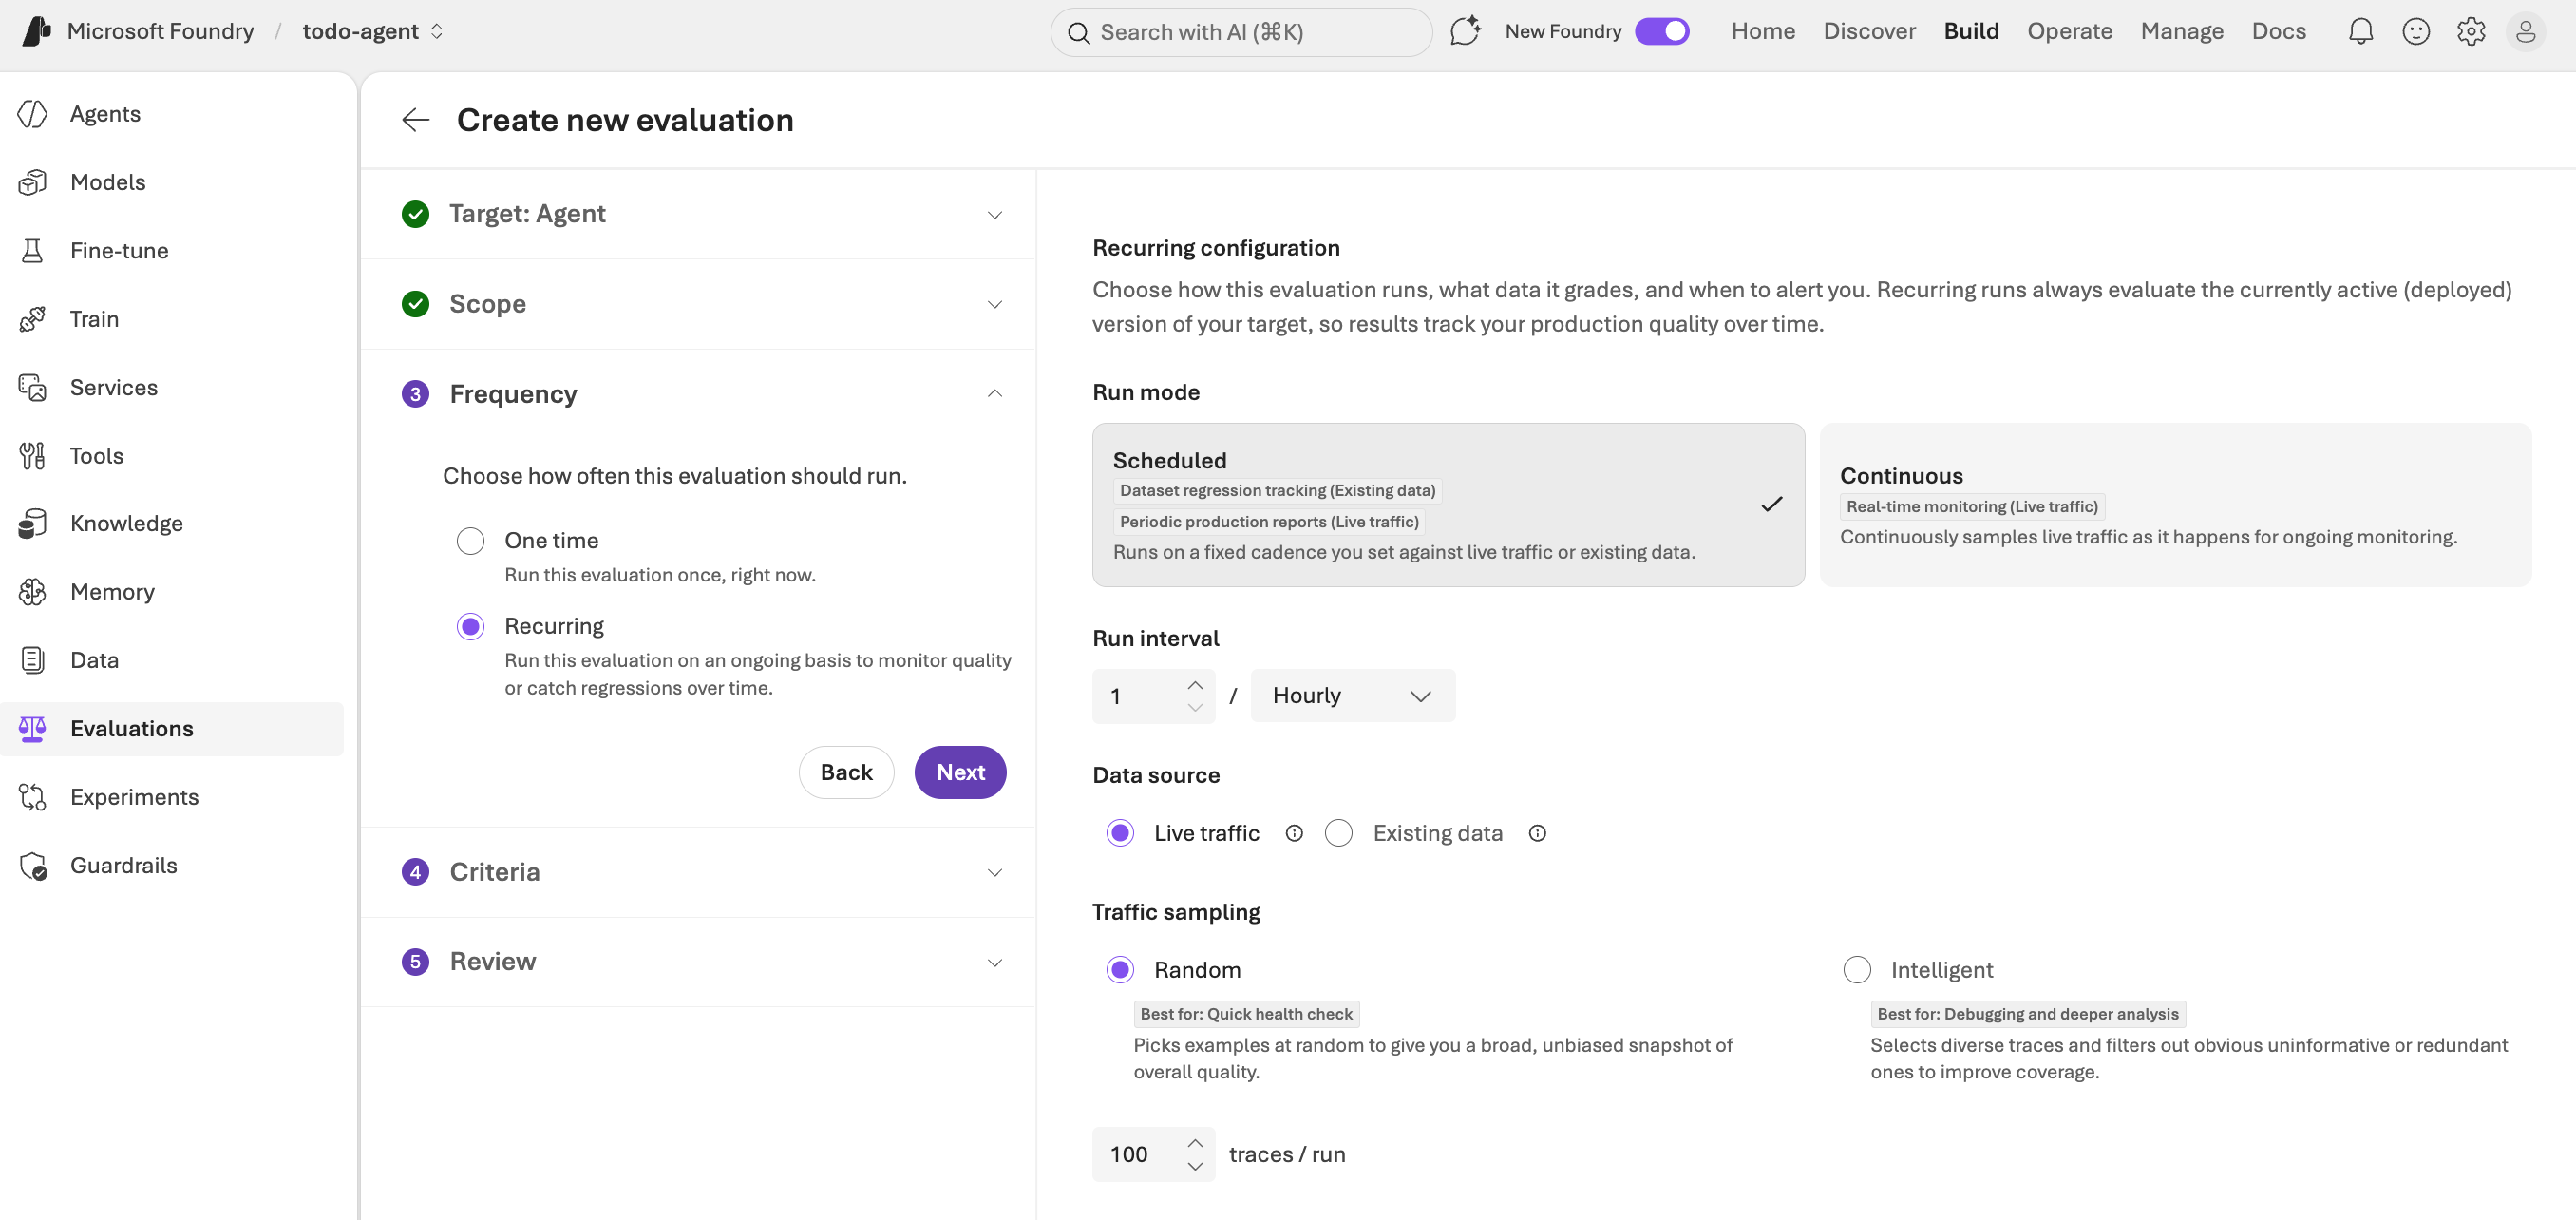
Een terugkerende evaluatie maken
Terugkerende evaluaties op twee manieren configureren:
- Geplande evaluatie wordt volgens een vast schema uitgevoerd.
- Doorlopende evaluatie neemt liveverkeer steekproefsgewijs terwijl het zich voordoet.
from azure.ai.projects.models import (
    EvaluationRule,
    ContinuousEvaluationRuleAction,
    EvaluationRuleFilter,
    EvaluationRuleEventType,
)

data_source_config = {"type": "azure_ai_source", "scenario": "responses"}
testing_criteria = [
    {"type": "azure_ai_evaluator", "name": "violence_detection", "evaluator_name": "builtin.violence"}
]
eval_object = openai_client.evals.create(
    name="Continuous Evaluation",
    data_source_config=data_source_config,  # type: ignore
    testing_criteria=testing_criteria,  # type: ignore
)
print(f"Evaluation created (id: {eval_object.id}, name: {eval_object.name})")

// Create scheduled recurring evaluation by creating the schedule.

trace_source: dict = {
    "type": "agent_filter",
    "agent_name": agent_name,
    "start_time": start_time,
    "end_time": end_time,
    "max_traces": args.max_traces
}

eval_run_object = {
    "eval_id": eval_object.id,
    "name": "trace_eval_with_smart_filter",
    "data_source": {
        "type": "azure_ai_trace_data_source_preview",
        "trace_source": trace_source,
    },
}

print("Creating Schedule for agent trace evaluation")

schedule = Schedule(
    display_name="Agent Trace Evaluation Eval Run Schedule",
    enabled=True,
    trigger=RecurrenceTrigger(interval=1, schedule=DailyRecurrenceSchedule(hours=[9])),  # Every day at 9 AM
    task=EvaluationScheduleTask(eval_id=eval_object.id, eval_run=eval_run_object),
)
schedule_response = project_client.beta.schedules.create_or_update(
    schedule_id="agent-trace-eval-run-schedule-9am", schedule=schedule
)

print(f"Schedule created for agent trace evaluation: {schedule_response.schedule_id}")

// Create continuous recurring evaluation by creating evaluation rule.

continuous_eval_rule = project_client.evaluation_rules.create_or_update(
    id="my-continuous-eval-rule",
    evaluation_rule=EvaluationRule(
        display_name="My Continuous Eval Rule",
        description="An eval rule that runs on agent response completions",
        action=ContinuousEvaluationRuleAction(eval_id=eval_object.id, max_hourly_runs=100),
        event_type=EvaluationRuleEventType.RESPONSE_COMPLETED,
        filter=EvaluationRuleFilter(agent_name=agent.name),
        enabled=True,
    ),
)
print(
    f"Continuous Evaluation Rule created (id: {continuous_eval_rule.id}, name: {continuous_eval_rule.display_name})"
)
Verwijzingen: Schedule, EvaluationRuleEventType, EvaluationRule
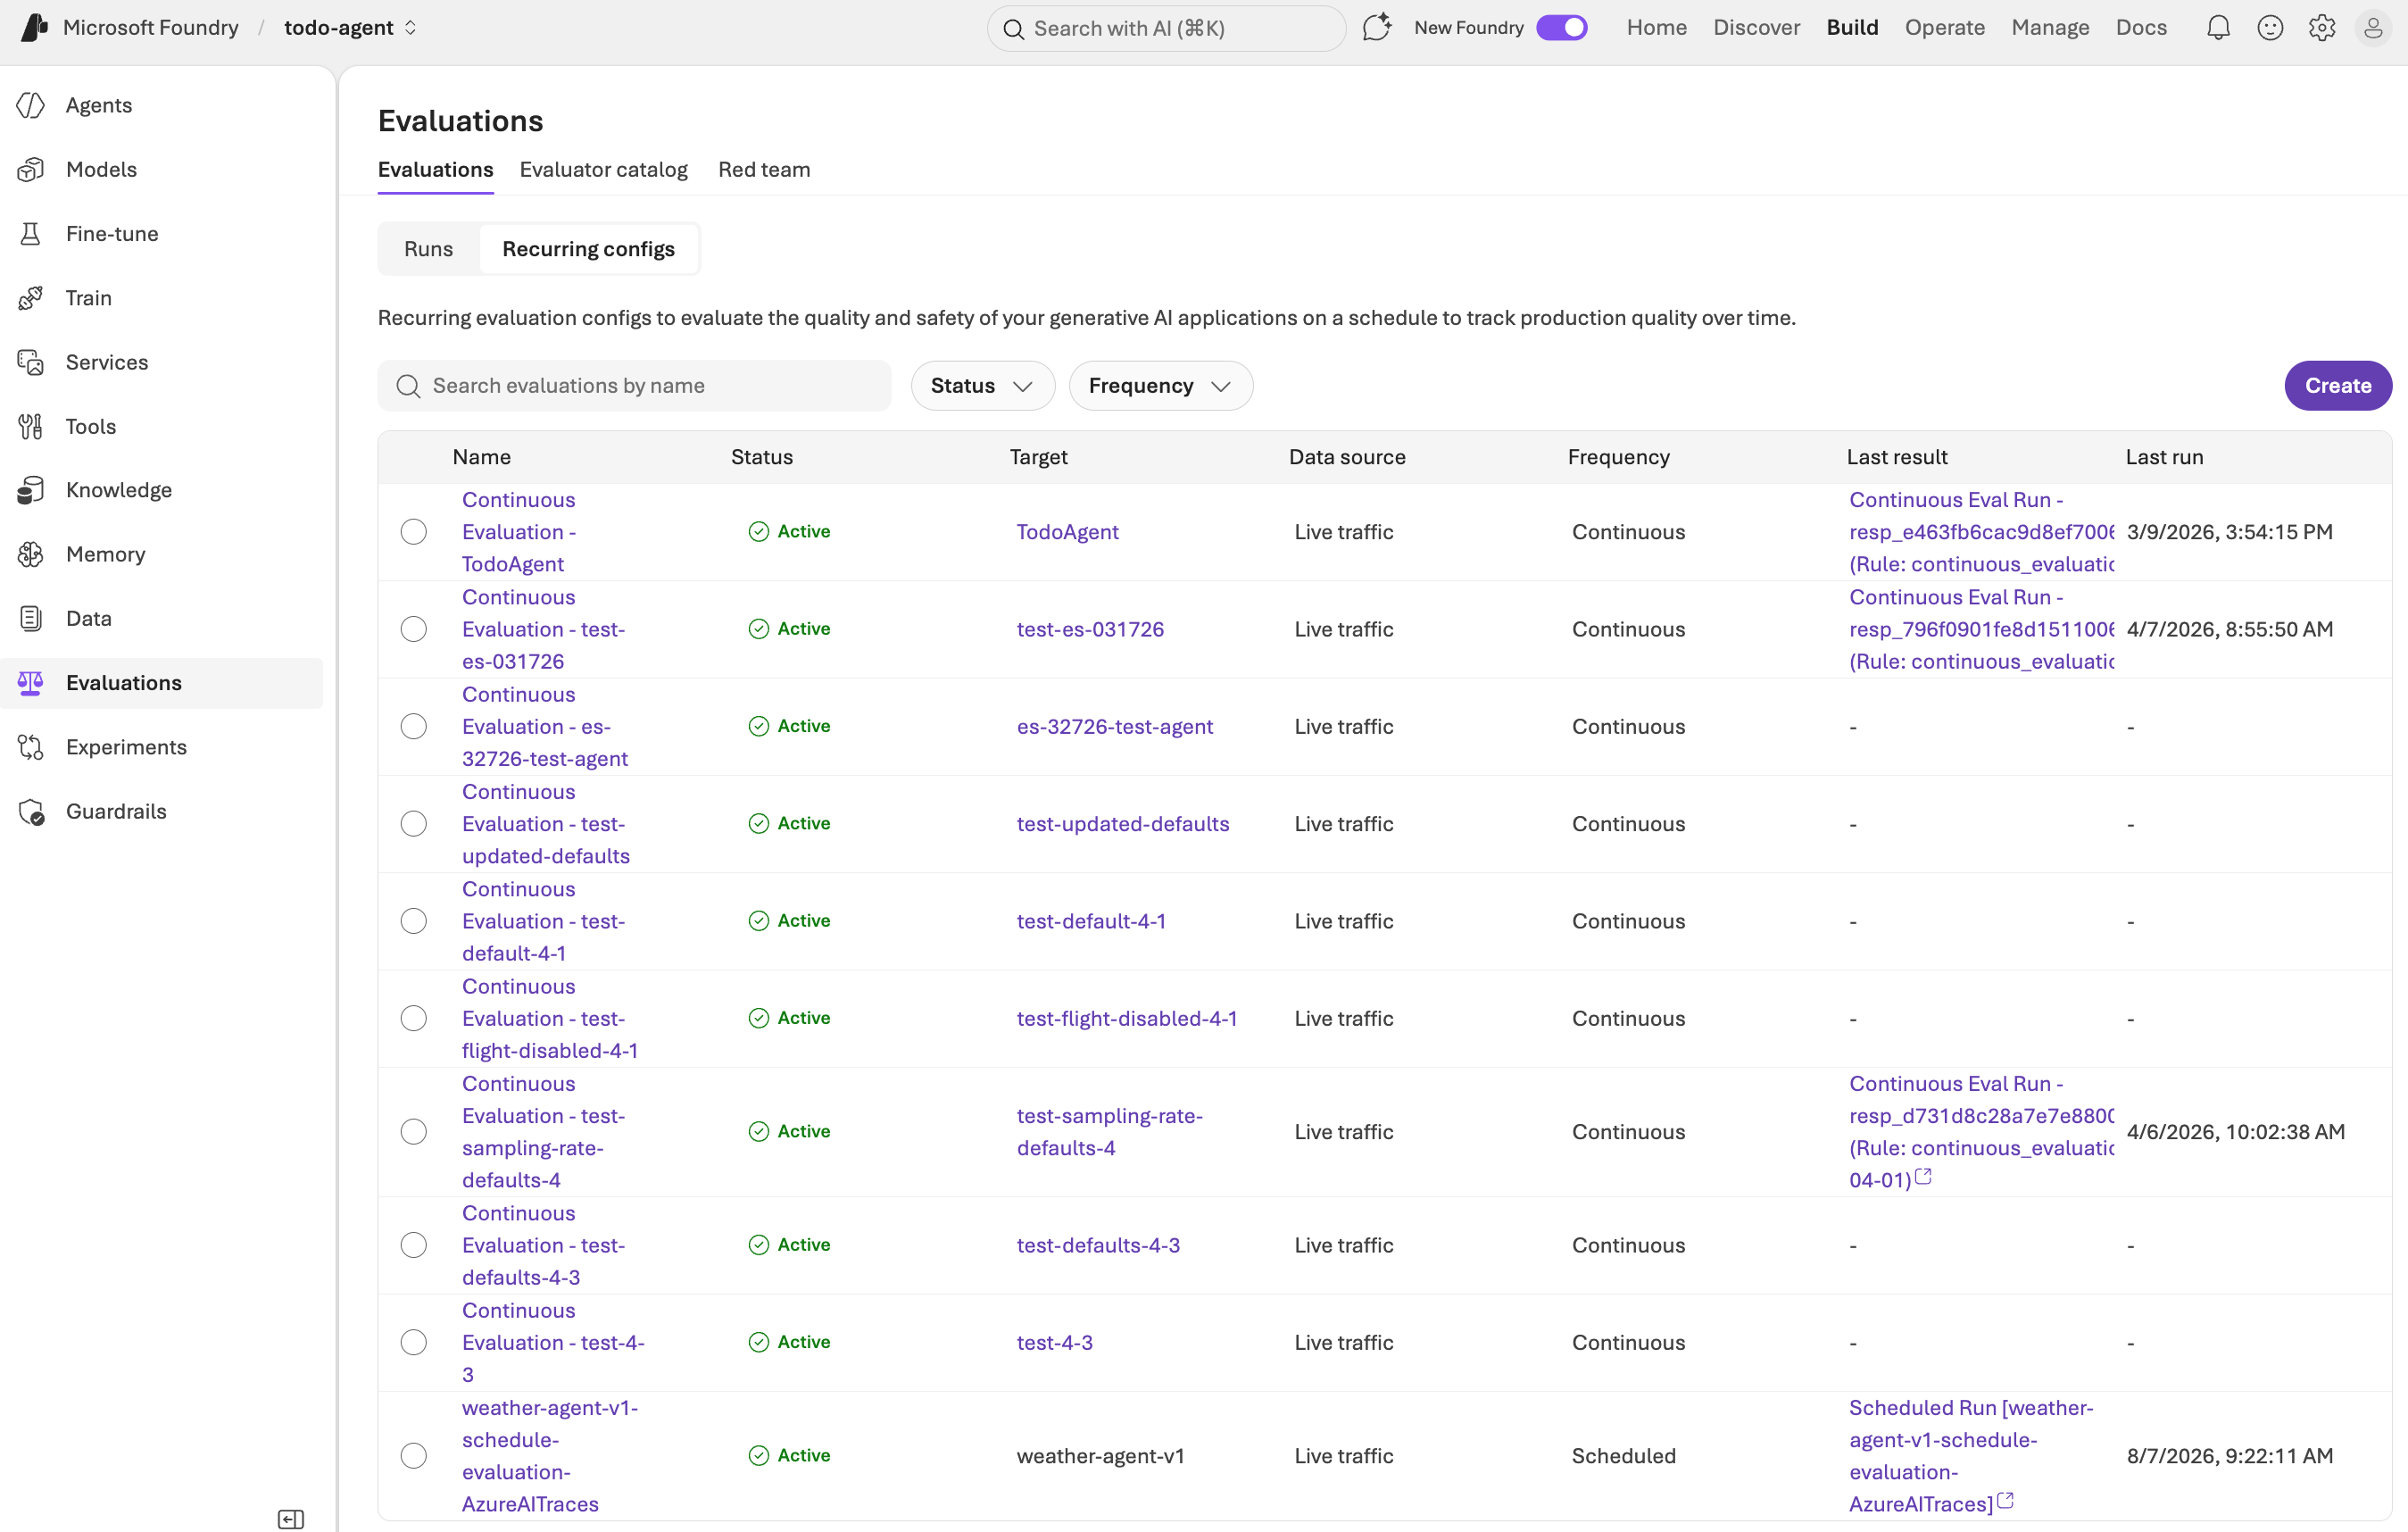
Doorlopende evaluatieresultaten controleren
- Agentverkeer genereren (bijvoorbeeld uw app uitvoeren of de agent testen in de portal).
- Open de agent in de Foundry-portal en selecteer Monitor.
- Bekijk evaluatiegrafieken voor het geselecteerde tijdsbereik.
Als de installatie is geslaagd, worden in de evaluatiegrafieken scores voor het geselecteerde tijdsbereik weergegeven en worden in de lijst met evaluatieuitvoeringen vermeldingen met de status Voltooid weergegeven.
U kunt ook recente evaluatieuitvoeringen weergeven en de rapport-URL openen:
eval_run_list = openai_client.evals.runs.list(
    eval_id=eval_object.id,
    order="desc",
    limit=10,
)

if len(eval_run_list.data) > 0 and eval_run_list.data[0].report_url:
    print(f"Report URL: {eval_run_list.data[0].report_url}")
Aangepaste evaluators gebruiken voor doorlopende evaluaties
Naast externe evaluators kunt u uw eigen evaluators meenemen voor doorlopende evaluaties. Volg de stappen in Aangepaste evaluators (preview) om aangepaste evaluators in te stellen.
Aangepaste evaluators toevoegen aan doorlopende evaluaties:
- Selecteer Instellingen op het tabblad Controleren.
- Selecteer het tabblad Continue evaluatie .
- Selecteer Evaluator(en) toevoegen.
- Kies de aangepaste evaluators die u wilt opnemen.
Volledige voorbeeldcode
Als u de volledige voorbeeldcode wilt bekijken, raadpleegt u:
- Voorbeeld van continue evaluatie (Python).
- Geplande evaluatie en AI-voorbeeld van red teaming-evaluatie plannen (Python).
Probleemoplossing
| Probleem | Oorzaak | Resolutie |
|---|---|---|
| Dashboarddiagrammen zijn leeg | Geen recent verkeer, tijdsbereik sluit gegevens of opnamevertraging uit | Genereer nieuw agentverkeer, verruim het tijdsbereik en vernieuw na enkele minuten. |
| U ziet autorisatiefouten | Ontbrekende RBAC-machtigingen voor Application Insights of Log Analytics | Bevestig de toegang in Toegangsbeheer (IAM) voor de verbonden resources. Wijs voor logboektoegang de rol Log Analytics Lezer toe. Als de tabellen zijn beveiligd, wijst u ook Privileged Monitoring Data Reader toe. |
| Resultaten van continue evaluatie worden niet weergegeven | Continue evaluatie is niet ingeschakeld of het maken van regels is mislukt | Controleer of uw regel is ingeschakeld en of het agentverkeer wordt doorgestuurd. Als u de Python SDK-installatie gebruikt, controleert u of de door het project beheerde identiteit de rol Foundry User heeft. |
| Evaluatieuitvoeringen worden overgeslagen | Limiet voor uitvoering per uur bereikt | Verhoog max_hourly_runs in de configuratie van de evaluatieregel of wacht tot het volgende uur. De standaardlimiet is 100 uitvoeringen per uur. |
Doorlopende evaluatie voor aangepaste agents bewaken en instellen
Foundry kan fungeren als een gecentraliseerde locatie voor het monitoren van uw agents, zelfs voor agents die niet op het platform draaien. In het besturingsvlak Foundry kunt u agents onboarden die elders worden uitgevoerd via AI Gateway. Vervolgens kunt u uw agent instrumenteren om traceringen te verzenden naar hetzelfde Application Insights-exemplaar als uw Foundry-project. Met deze configuratie kunt u continue evaluaties uitvoeren en metriek bijhouden, zoals het foutpercentage voor agents die niet draaien in Foundry.
Monitoring instellen voor uw aangepaste agents
- Zet uw aangepaste agent op Foundry volgens de instructies in Registreren en beheren van aangepaste agents.
- Instrumenteer uw agent om te voldoen aan de semantische conventies voor generatieve AI-oplossingen in de OpenTelemetry-standaard.
- Configureer uw agent voor het verzenden van telemetrie naar hetzelfde Application Insights-exemplaar als uw Foundry-project om functies voor continue evaluatie mogelijk te maken.
- Ga in Foundry Control Plane naar de pagina Asset en selecteer uw agent.
- Selecteer het tabblad Controleren om uw metrische gegevens en grafieken weer te geven.
- Stel continue evaluaties in met behulp van de methoden die worden beschreven in Instellingen configureren.