Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Wyszukiwanie wektorowe to sposób znajdowania informacji przechowywanych w bazie danych w kształcie wektorów. Wektory to grupy liczb reprezentujące cechy lub cechy multimediów, takie jak tekst lub obrazy. Przechwytują relacje semantyczne w informacjach, co umożliwia wyszukiwanie podobieństw poza dokładnym dopasowaniem słów kluczowych.
Platforma Azure oferuje wiele sposobów przechowywania i wyszukiwania wektoryzowanych danych. Ten artykuł pomaga wybrać odpowiednią usługę wyszukiwania wektorów Azure dla aplikacji.
W tym artykule porównaliśmy następujące usługi na podstawie ich możliwości wyszukiwania wektorowego:
- Wyszukiwanie AI w usłudze Azure
- Azure Cosmos DB dla baz danych NoSQL
- Azure DocumentDB
- Azure Database for PostgreSQL
- Usługa Redis zarządzana w platformie Azure
- Azure SQL Database
Aby porównać wymagania systemowe poszczególnych usług, zobacz Wybór usługi kandydującej i macierz możliwości.
Wybierz usługę kandydata
Ta sekcja pomaga wybrać najlepszą usługę lub usługi dla Twoich potrzeb. Aby zawęzić opcje, zacznij od rozważenia wymagań systemowych.
Podstawowe wymagania
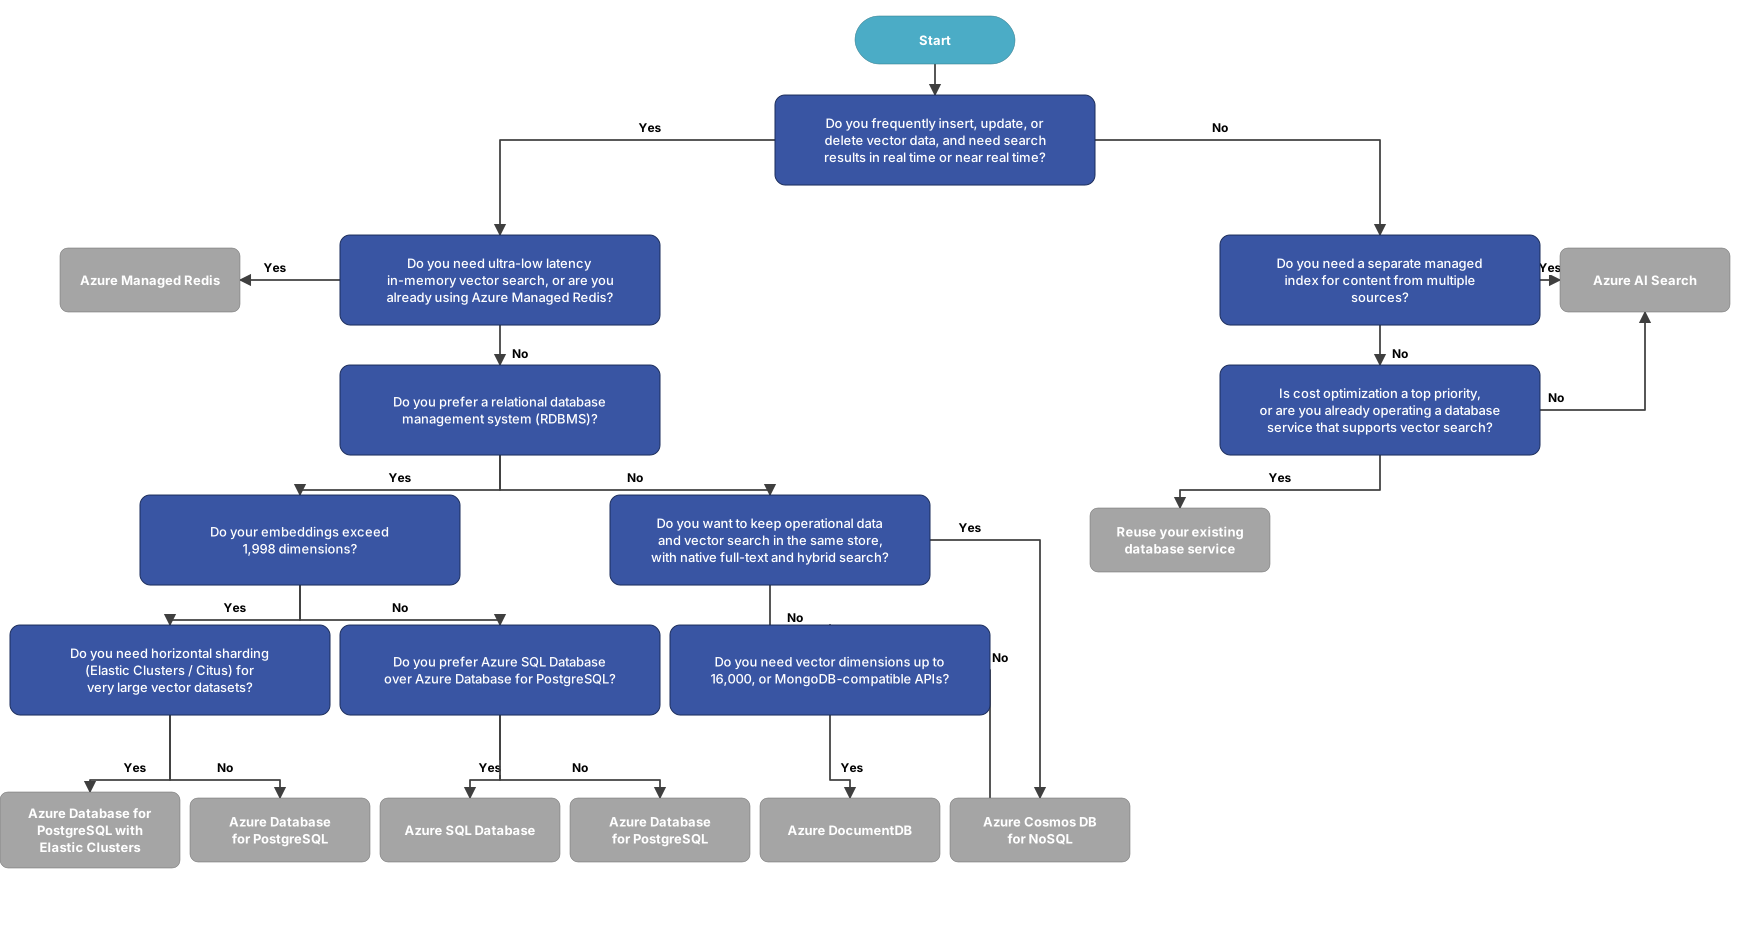
Aby zdecydować, czy używać tradycyjnego rozwiązania bazy danych, czy wyszukiwania sztucznej inteligencji, weź pod uwagę wymagania i czy można wykonywać wyszukiwania wektorów na żywo lub w czasie rzeczywistym na danych. Jeśli często zmieniasz wartości w polach wektoryzowanych i jeśli te zmiany muszą być przeszukiwalne w czasie rzeczywistym lub niemal w czasie rzeczywistym, tradycyjna relacyjna lub NoSQL baza danych jest najlepszym rozwiązaniem dla danego scenariusza. Podobnie istniejąca baza danych może być najlepszym sposobem spełnienia celu wydajności. Jeśli jednak obciążenie nie wymaga wyszukiwania wektorów w czasie rzeczywistym lub niemal w czasie rzeczywistym i możesz zarządzać indeksem wektorów, możesz użyć funkcji wyszukiwania sztucznej inteligencji.
Jeśli wybierzesz tradycyjne rozwiązanie bazy danych, wybierz usługę bazy danych na podstawie zestawu umiejętności twojego zespołu i istniejących baz danych. Jeśli używasz już usługi bazy danych, takiej jak Azure Cosmos DB na potrzeby NoSQL, usługa ta może być najprostszym rozwiązaniem dla danego scenariusza.
Azure Cosmos DB for NoSQL jest dobrym rozwiązaniem, jeśli chcesz przechowywać dane operacyjne i wykonywać wyszukiwanie wektorowe w tym samym systemie oraz jeśli potrzebujesz punktacji pełnotekstowej, wyszukiwania hybrydowego lub wbudowanego ponownego rankingowania.
Wyszukiwanie sztucznej inteligencji może być dobrym wyborem, jeśli obciążenie wymaga najwyższej klasy wyszukiwania hybrydowego i klasyfikacji semantycznej.
Azure Database for PostgreSQL obsługuje skalowanie w poziomie przy użyciu klastrów elastycznych — zarządzanej wersji rozszerzenia Citus typu open source, które obsługuje partycjonowanie horyzontalne. Ta funkcja dystrybuuje dane wektorowe między wieloma węzłami, co może być przydatne w przypadku dużych zestawów danych wektorowych.
Rozważ usługę Azure Managed Redis, gdy potrzebujesz ultraniskich opóźnień i wektorowego wyszukiwania w pamięci lub gdy Redis wdrożono już na potrzeby buforowania albo zarządzania sesjami.
Każda usługa bazy danych ma unikatowe możliwości i ograniczenia dotyczące wyszukiwania wektorów. Sprawdź, czy typ bazy danych ma wymagane funkcje.
Nowe usługi i dodatkowe wystąpienia bazy danych mogą zwiększyć koszty i złożoność. Aby zmniejszyć nakład pracy, możesz nadal używać istniejącego projektu. Wyszukiwanie wektorowe w bieżących bazach danych może być bardziej ekonomiczne niż dedykowana usługa wyszukiwania wektorów. Jednak niektóre funkcje wyszukiwania zaawansowanego nie są domyślnie dostępne w tradycyjnych bazach danych. Jeśli na przykład potrzebujesz ponownego rankingowania lub wyszukiwania hybrydowego, możesz zaimplementować te funkcje za pomocą kodu, takiego jak Transact-SQL (T-SQL).
Macierz możliwości
Tabele w tej sekcji podsumowują możliwości usługi Azure Vector Search. Porównaj dostępne usługi z wymaganiami. Niektóre usługi są lepiej dopasowane do konkretnych scenariuszy, dlatego należy wziąć pod uwagę kompromisy przedstawione w każdej tabeli.
Jeśli pracujesz w Microsoft Fabric, możesz użyć Real-Time Intelligence na potrzeby wyszukiwania podobieństwa wektorów (VSS) przy użyciu magazynu zdarzeń jako wektorowej bazy danych. Aby uzyskać więcej informacji, zobacz dokumentację Fabric.
Funkcje podstawowe
Natywna obsługa wektorowych typów danych, przybliżonych indeksów wektorowych najbliższych sąsiadów (ANN), limitów wymiarów wektorów, wielu pól wektorowych i wielu indeksów wektorowych różni się w zależności od usługi. Obciążenie może wymagać co najmniej jednej z tych funkcji.
W poniższej tabeli przedstawiono możliwości wektorów każdej usługi Azure.
| Zdolność | Azure Cosmos DB for NoSQL | Azure DocumentDB | Azure Database for PostgreSQL | Zarządzany Redis w Azure | Wyszukiwanie AI | Baza danych SQL |
|---|---|---|---|---|---|---|
| Wbudowane wyszukiwanie wektorów | Tak | Tak1 | Tak2 | Tak3 | Tak4 | Tak |
| Typ danych wektora | Tak | Tak | Tak | Tak | Tak | Tak5 |
| Limity wymiarów6 | 5057 lub 4096 | 16 0008, 4000 lub 2000 w zależności od konfiguracji | 16 0009 lub 2000 | 32,768 | 409610 | 1998 11 |
| Wiele pól wektorów | Tak | Nie. | Tak | Tak | Tak | Tak |
| Wiele indeksów wektorów | Tak | Nie. | Tak | Tak | Tak | Tak |
- Azure DocumentDB obsługuje wyszukiwanie wektorowe na embeddingach.
-
pgvector, rozszerzenie bazy danych PostgreSQL, obsługuje wyszukiwanie wektorów. Rozszerzeniepg_diskannumożliwia indeksowanie wektorowe oparte na technologii DiskANN na potrzeby wydajnego wyszukiwania ANN na dużą skalę. - Moduł RediSearch w usłudze Azure Managed Redis udostępnia wyszukiwanie wektorów.
- Wyszukiwanie sztucznej inteligencji obsługuje wektory.
- Usługa SQL Database obsługuje typ danych wektorowych.
- Modele embeddingów OpenAI mają 1 536 wymiarów dla text-embedding-ada-002 i text-embedding-3-small oraz 3 072 wymiary dla text-embedding-3-large. Wielomodalne modele osadzania Azure Vision mają 1024 wymiary zarówno dla obrazów, jak i tekstu.
- Wektory indeksowane przy użyciu typu indeksu płaskiego mogą mieć maksymalnie 505 wymiarów. Wektory indeksowane przy użyciu kwantyzowanego typu indeksuFlat lub DiskANN mogą mieć maksymalnie 4096 wymiarów.
- Można indeksować wektory o wymiarowości do 16 000 za pomocą DiskANN i kwantyzacji iloczynowej. Hierarchical Navigable Small World (HNSW) lub IVFFlat z półprecyzją obsługują indeksy wektorowe o wymiarach do 4 000. Bez kompresji domyślny maksymalny wymiar wektora indeksowania wynosi 2000. Aby uzyskać więcej informacji, zobacz wymiary wektorów dla Azure DocumentDB.
- Wektory mogą mieć maksymalnie 16 000 wymiarów. Jednak indeksowanie przy użyciu algorytmów IVFFlat i HNSW obsługuje wektory z maksymalnie 2000 wymiarami.
- Wyszukiwanie AI obsługuje przycinanie wymiarów oparte na Matryoshka Representation Learning. Modele osadzania tekstu–3 mogą zmniejszyć wymiary wektorów. Można na przykład użyć wymiarów 256 lub 512.
- Usługa SQL Database obsługuje natywny typ danych wektorowych z maksymalnie 1998 wymiarami.
Metody wyszukiwania
Obciążenia często muszą łączyć wyszukiwanie wektorów z wyszukiwaniem pełnotekstowym lub wyszukiwaniem hybrydowym. Wyszukiwanie hybrydowe to wyszukiwanie pełnotekstowe lub wyszukiwanie semantyczne połączone z wyszukiwaniem wektorowym. Po połączeniu wyszukiwanie hybrydowe i ponowne rangowanie zapewniają wysoką dokładność w przypadku obciążeń roboczych. Możesz ręcznie zaimplementować wyszukiwanie hybrydowe i ponowne klasyfikowanie przy użyciu własnego kodu lub rozważyć, jak Twój magazyn wektorów wspiera tę potrzebę obciążenia.
| Metoda wyszukiwania | Azure Cosmos DB for NoSQL | Azure DocumentDB | Azure Database for PostgreSQL | Zarządzany Redis w Azure | Wyszukiwanie AI | Baza danych SQL |
|---|---|---|---|---|---|---|
| Wyszukiwanie pełnotekstowe | Tak12 | Tak2 | Tak3 | Tak4 | Tak | Tak5 |
| Wyszukiwanie hybrydowe | Tak6 | Tak7 | Tak8 | Tak9 | Tak10 | Tak11 |
| Wbudowane ponowne rangowanie | Tak | Nie. | Nie. | Nie. | Tak1 | Nie. |
- Rangowanie semantyczne ponownie szereguje wyniki wyszukiwania pełnotekstowego i wyszukiwania wektorowego.
- Usługa Azure DocumentDB obsługuje wyszukiwanie i wykonywanie zapytań przy użyciu indeksów tekstowych.
- Baza danych PostgreSQL obsługuje wyszukiwanie pełnotekstowe.
- usługa Azure Managed Redis obsługuje wyszukiwanie pełnotekstowe przy użyciu modułu RediSearch, w tym tokenizacji tekstu, stemmingu i klasyfikacji.
- SQL Server obsługuje wyszukiwanie pełnotekstowe.
- Azure Cosmos DB dla NoSQL obsługuje wyszukiwanie hybrydowe.
- Azure DocumentDB natywnie obsługuje wyszukiwanie hybrydowe, które łączy wyszukiwanie pełnotekstowe i wektorowe z wzajemnym łączeniem rangi.
- Wyszukiwanie hybrydowe nie jest wbudowane, ale dostępny jest przykładowy kod.
- usługa Azure Managed Redis obsługuje wyszukiwanie hybrydowe przy użyciu usługi VSS połączonej z filtrowaniem atrybutów w polach tekstowych, liczbowych, tagowych i geograficznych.
- Wyszukiwanie hybrydowe, które łączy wyszukiwanie pełnotekstowe, wyszukiwanie wektorów i klasyfikację semantyczną, jest funkcją wyszukiwania sztucznej inteligencji.
- Dostępny jest przykład wyszukiwania hybrydowego dla SQL Database i SQL Server.
- Azure Cosmos DB dla NoSQL obsługuje wyszukiwanie pełnotekstowe i ocenianie pełnotekstowe.
Algorytmy indeksowania danych wektorowych
Indeksowanie danych wektorowych to możliwość wydajnego przechowywania i pobierania wektorów. Indeksowanie wpływa na szybkość i dokładność wyszukiwań podobieństw i zapytań najbliższych sąsiadów w źródłach danych.
Indeksy zazwyczaj używają wyczerpującego algorytmu k najbliższego sąsiada (Ek-NN) lub algorytmu ANN. Ek-NN wykonuje wyczerpujące wyszukiwanie wszystkich punktów danych i zwraca dokładne k najbliższych sąsiadów. Podczas wyszukiwania niewielkiej ilości danych Ek-NN działa w milisekundach. W przypadku większych zestawów danych może wystąpić opóźnienie.
DiskANN, HNSW i IVFFlat to indeksy algorytmów ANN. Wybranie odpowiedniej strategii indeksowania wymaga starannego rozważenia różnych czynników, takich jak charakter zestawu danych, określone wymagania zapytań i dostępne zasoby. Funkcja DiskANN może dostosować się do zmian w zestawie danych i zapisać zasoby obliczeniowe. Usługa HNSW wyróżnia się w systemach wymagających szybkich odpowiedzi na zapytania i może dostosować się do zmian w zestawie danych. Narzędzie IVFFlat jest skuteczne w środowiskach, w których zasoby sprzętowe są ograniczone lub woluminy zapytań nie są wysokie.
W poniższej tabeli przedstawiono dostępne typy indeksowania danych wektorowych.
| Podejście indeksowania | Azure Cosmos DB for NoSQL | Azure DocumentDB | Azure Database for PostgreSQL | Zarządzany Redis w Azure | Wyszukiwanie AI | Baza danych SQL |
|---|---|---|---|---|---|---|
| DiskANN | Tak | Tak1 | Tak2 | Nie. | Nie. | Tak3 |
| Ek-NN | Tak | Tak | Tak | Tak4 | Tak | Tak |
| HNSW | Nie. | Tak1 | Tak | Tak5 | Tak | Nie. |
| IVFFlat | Nie. | Tak | Tak | Nie. | Nie. | Nie. |
| Inne | Płaskie, kwantyzowaneflat6 | Ograniczenie pola wektorowego,7 ograniczenie indeksu wektorowego8 |
- | - | Kwantyzacja skalarna, kwantyzacja binarna9 | - |
- Aby uzyskać więcej informacji, zobacz Zintegrowany magazyn wektorów w usłudze Azure DocumentDB.
- Aby uzyskać więcej informacji, zobacz DiskANN for Azure Database for PostgreSQL.
- Indeksowanie wektorów DiskANN natywne jest w wersji zapoznawczej. Aby uzyskać więcej informacji, zobacz Wyszukiwanie wektorowe i indeksy wektorowe w aparacie bazy danych SQL.
- Usługa Azure Managed Redis obsługuje wyszukiwanie eK‑NN przy użyciu typu indeksu FLAT do wyszukiwania metodą brute force.
- usługa Azure Managed Redis obsługuje usługę HNSW na potrzeby wyszukiwania ANN. Aby uzyskać więcej informacji, zobacz VSS.
- Aby uzyskać więcej informacji, zobacz Zasady indeksowania wektorów.
- Indeksowanie dotyczy tylko jednego wektora na ścieżkę.
- Można utworzyć tylko jeden indeks na ścieżkę wektora.
- Funkcja wyszukiwania sztucznej inteligencji obsługuje kwantyzację skalarną i binarną w celu zmniejszenia rozmiaru wektora w indeksie wyszukiwania.
Możliwości obliczania podobieństwa i odległości
Wyszukiwanie wektorowe obsługuje obliczanie podobieństwa cosinusowego, iloczynu skalarnego i odległości euklidesowej. Użyj tych metod, aby obliczyć podobieństwo lub odległość między dwoma wektorami.
Wstępna analiza danych używa metryk i odległości euklidesowych, dzięki czemu można wyodrębnić różne szczegółowe informacje o strukturze danych. Klasyfikacja tekstu zazwyczaj działa lepiej pod odległościami euklidesowymi. Pobieranie tekstów najbardziej podobnych do danego zwykle działa lepiej przy użyciu podobieństwa cosinusowego.
Osadzenia w Azure OpenAI opierają się na podobieństwie cosinusa do obliczania podobieństwa między dokumentami a zapytaniem.
| Wbudowane obliczenie porównania wektorów | Azure Cosmos DB for NoSQL | Azure DocumentDB | Azure Database for PostgreSQL | Zarządzany Redis w Azure | Wyszukiwanie AI | Baza danych SQL |
|---|---|---|---|---|---|---|
| Podobieństwo cosinusowe | Tak1 | Tak | Tak | Tak2 | Tak | Tak3 |
| Odległość euklidesowa | Tak1 | Tak | Tak | Tak2 | Tak | Tak3 |
| Produkt kropkowy | Tak1 | Tak | Tak | Tak2 | Tak | Tak3 |
- Aby uzyskać więcej informacji, zobacz obliczenia odległości wektorów dla Azure Cosmos DB dla NoSQL.
- usługa Azure Managed Redis obsługuje podobieństwo cosinusowe, odległość euklidesa i wewnętrzne metryki odległości produktu. Aby uzyskać więcej informacji, zobacz VSS.
- Aby uzyskać więcej informacji, zobacz przykłady obliczeń odległości dla usługi SQL Database i SQL Server.
Integracja z usługą Azure OpenAI i innymi składnikami
Wyszukiwanie wektorów można połączyć z innymi składnikami Microsoft. Na przykład Azure OpenAI ułatwia tworzenie wektorów dla danych i zapytań wejściowych dla usługi VSS.
| Zdolność | Azure Cosmos DB for NoSQL | Azure DocumentDB | Azure Database for PostgreSQL | Zarządzany Redis w Azure | Wyszukiwanie AI | Baza danych SQL |
|---|---|---|---|---|---|---|
| Integracja z Foundry IQ | Nie. | Nie. | Nie. | Nie. | Tak | Nie. |
| Integracja z usługą agenta Foundry | Tak1 | Nie. | Tak2 | Tak2 | Tak3 | Tak2 |
| Zintegrowane generowanie osadzeń w usłudze Azure OpenAI | Nie. | Nie. | Tak4 | Nie. | Tak5 | Tak6 |
| Integracja z Semantic Kernel | Tak7 | Tak8 | Tak9 | Tak10 | Tak11 | Tak12 |
- Integracja z usługą agenta Foundry jest realizowana za pośrednictwem magazynu stanów agenta.
- Integracja z usługą Foundry Agent Service odbywa się za pośrednictwem danych, wyszukiwania wektorowego lub dostępu do narzędzi.
- Integracja usługi Foundry Agent Service jest zapewniana za pośrednictwem pobierania wiedzy i wyszukiwania wektorowego.
- Dostępne jest rozszerzenie azure AI.
- Wyszukiwanie AI obejmuje umiejętność, która przekształca fragmenty tekstu w wektory.
- Możesz utworzyć procedurę składowaną na potrzeby wdrożenia modelu embeddingu.
- Ta usługa jest dostępna jako konektor pamięci oraz konektor do wektorowej bazy danych. Aby uzyskać więcej informacji, zobacz dokumentację języka C# i dokumentację Python.
- Ta usługa działa jako konektor bazy danych wektorowych. Aby uzyskać więcej informacji, zobacz dokumentację języka C# i dokumentację Python.
- Ta usługa jest obsługiwana w roli konektora pamięci i konektora bazy danych wektorowych. Aby uzyskać więcej informacji, zobacz dokumentację języka C#.
- Ta usługa działa jako konektor bazy danych wektorowych. Aby uzyskać więcej informacji, zobacz Using the Redis connector (Korzystanie z łącznika usługi Redis).
- Ta usługa jest wspierana jako konektor pamięci i konektor do wektorowej bazy danych. Aby uzyskać więcej informacji, zobacz dokumentację języka C# i dokumentację Python.
- Ta usługa jest wspierana jako konektor pamięci.
Współautorzy
Firma Microsoft utrzymuje ten artykuł. Następujący współautorzy napisali ten artykuł.
Główni autorzy
- Yu Saito | Inżynier rozwiązań
- Miho Yamamoto | Starszy inżynier rozwiązań
Inny współautor:
- Keita Onabuta | Starszy inżynier rozwiązań
Aby wyświetlić niepubliczne profile serwisu LinkedIn, zaloguj się do serwisu LinkedIn.
Dalsze kroki
- Inteligentne aplikacje i sztuczna inteligencja
- Usługa VSS przy użyciu Azure SQL i Azure OpenAI
- Natywna obsługa wektorów w usługach Azure SQL i SQL Server
- Wektorowa baza danych w usłudze Azure Cosmos DB
- VSS w Azure Managed Redis
- Wyszukiwanie wektorowe w usłudze Wyszukiwanie AI platformy Azure
- Wyszukiwanie wektorowe w usłudze Azure Cosmos DB dla NoSQL