Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Przekształcenia w Azure Monitor filtrują lub modyfikują dane przychodzące przed pozyskaniem danych w obszarze roboczym Log Analytics. Przekształcenia w czasie pozyskiwania przetwarzają dane po dostarczeniu ich przez źródło danych do Azure Monitor i zanim Azure Monitor wyśle je do miejsca docelowego. Przekształcenia wieloetapowe mogą również przetwarzać dane na agencie, zanim agent wyśle je do Azure Monitor. Przekształcenia są definiowane w regule zbierania danych (DCR).
Przekształcenia standardowe używają instrukcji języka KQL (Kusto Query Language) stosowanej indywidualnie do każdego wpisu w danych przychodzących. Wieloetapowe przekształcenia rozszerzają ten model o potok deklaratywnych procesorów, w którym zapytanie KQL jest jednym z wielu dostępnych typów procesorów w łańcuchu transformacji.
Na poniższym diagramie przedstawiono proces przekształcania danych przychodzących i pokazano przykładowe zapytanie, które może być używane. W tym przykładzie są zbierane tylko rekordy, w których kolumna message zawiera wyraz error .

Obsługiwane tabele
Poniższe tabele w obszarze roboczym Log Analytics obsługują przekształcenia.
- Każda tabela Azure wymieniona w Obsługa funkcji tabel dzienników ze wskaźnikiem
 .
- Dowolna tabela niestandardowa utworzona dla agenta usługi Azure Monitor.
- Tabele niestandardowe z planem pomocniczym.
Utwórz przekształcenie
Niektóre scenariusze zbierania danych umożliwiają dodanie przekształcenia w portalu Azure, ale większość scenariuszy wymaga utworzenia nowego obiektu DCR na podstawie jego definicji JSON lub dodania przekształcenia do istniejącego obiektu DCR. Zobacz Tworzenie transformacji w Azure Monitor, aby poznać różne opcje, oraz Najlepsze praktyki i przykłady transformacji w Azure Monitor, aby zapoznać się z przykładowymi zapytaniami transformacji dla typowych scenariuszy.
W kodzie JSON DCR properties.dataFlows[].transformKql definiuje wbudowane przekształcenie KQL. Przekształcenia wieloetapowe zamiast tego definiują nazwane potoki w properties.transformations i przypisują je za pomocą transform w obsługiwanym źródle danych lub przepływie danych. Nie należy określać jednocześnie elementów transform i transformKql w tym samym przepływie danych. Aby dowiedzieć się, jak te właściwości odnoszą się do scenariuszy zbierania danych, zobacz Omówienie przepływu danych DCR.
Przekształcenia wieloetapowe (wersja zapoznawcza)
Ważne
Przekształcenia wieloetapowe są obecnie dostępne w publicznej wersji zapoznawczej. Zobacz dodatkowe warunki użytkowania dla wersji zapoznawczych platformy Microsoft Azure, aby zapoznać się z postanowieniami prawnymi dotyczącymi funkcji platformy Azure, które są w wersji beta, wersji zapoznawczej lub w inny sposób nie zostały jeszcze wydane w wersji ogólnodostępnej.
Przekształcenia standardowe stosują pojedyncze zapytanie KQL do danych przychodzących podczas ich pozyskiwania. Przekształcenia wieloetapowe rozszerzają ten model, umożliwiając definiowanie potoku przetwarzania składającego się z wielu uporządkowanych etapów przetwarzania, stosowanych jako przepływ danych przez system.
W przypadku wieloetapowych transformacji DCR definiuje potok przetwarzania danych, a nie pojedynczy etap transformacji. Dane przepływają przez następujące etapy:
- Zbieranie danych. Azure Monitor Agent (AMA) zbiera dane z zasobu na podstawie ustawień źródła danych w kontrolerze domeny.
- Przetwarzanie po stronie klienta. Przekształcenia są uruchamiane lokalnie na agencie przed wysłaniem danych za pośrednictwem sieci. Przekształcenie dotyczy danych w postaci pierwotnej, która może różnić się od standardowej reprezentacji tabeli.
- Przetwarzanie podczas pozyskiwania danych. Gdy dane trafią do usługi Azure Monitor, przekształcenia są stosowane podczas pozyskiwania, zanim dane zostaną zapisane do tabeli docelowej w usłudze Log Analytics. Ta transformacja ma zastosowanie po tym, jak dane są w pełni schematowane i wzbogacone.
- Dostarczanie danych. Przetworzone dzienniki są dostarczane do ich końcowego miejsca docelowego.
Processors
Przekształcenia w wieloetapowych DCR są definiowane przy użyciu procesorów — małych, deklaratywnych bloków konstrukcyjnych, z których każdy wykonuje określony rodzaj operacji. Procesory mają następujące cechy:
- Modułowe. W ramach jednej transformacji można połączyć wiele procesorów.
- Zamówiono. Procesory są uruchamiane sekwencyjnie w kolejności zdefiniowanej w transformacji.
- Niezależny od etapów. Ten sam typ procesora może być używany w różnych źródłach danych, etapach lub scenariuszach, z pewnymi ograniczeniami w okresie obowiązywania wersji zapoznawczej.
Każda transformacja rozpoczyna się od procesora nagłówków, który przekształca surowe dane do znanego tabelarycznego formatu zgodnego ze schematem. Po nagłówku można połączyć dodatkowe procesory w celu filtrowania, mapowania, analizowania, agregowania, wzbogacania lub stosowania wyrażeń KQL do danych.
Dostępne są następujące rodziny procesorów:
| Rodzina | Processors | Description |
|---|---|---|
| Nagłówka |
header.Syslog, header.WindowsEvents, , header.TextLogheader.StandardStream, header.CustomStream, i inne |
Schematuj nieprzetworzone dane w formacie tabelarycznym. Musi być pierwszym procesorem. |
| Filter | filter.Basic |
Odrzuć rekordy na podstawie wyniku oceny warunku. |
| Map |
map.Rename, map.Drop |
Zmień nazwę, zmień typ lub usuń kolumny. |
| Parse |
parse.JsonPath, parse.XmlPath, parse.CEFAttribute |
Wyodrębnij pola z ciągów w formacie JSON, XML lub CEF. |
| Aggregation | aggregate.Basic |
Podsumowywanie rekordów przy użyciu operatorów agregacji z wymiarami grupowania. |
| Wzbogacenie | enrich.DNSLookup |
Wyszukaj adres IP i dodaj kolumnę nazwy DNS. |
| Transformacja niestandardowa | transform.KQL |
Zastosuj dowolne wyrażenie KQL. Tylko po stronie importu. |
Aby uzyskać pełną dokumentację procesora, w tym schematy konfiguracji i schematy wyjściowe, zobacz Struktura dcR — przekształcenia.
Przekształcenia po stronie klienta a przekształcenia po stronie ingestii danych
Każde przekształcenie jest przypisywane do określonego etapu przetwarzania. To rozróżnienie określa, gdzie dzieje się obliczenia, jakie dane są wysyłane przez sieć i jakie koszty można zoptymalizować wcześnie.
| Aspect | Client-side | Czas pozyskiwania |
|---|---|---|
| Przypisanie | Źródło danych (dataSources) |
Przepływ danych (dataFlows) |
| Działa na | Agent usługi Azure Monitor (VM) | usługa Azure Monitor |
| Procesor nagłówków | Specyficzne dla źródła danych (na przykład header.Syslog) |
header.StandardStream lub header.CustomStream |
| Analiza kosztów i korzyści | Zmniejsza koszty sieciowe i koszty pozyskiwania danych dzięki filtrowaniu/agregacji, zanim dane opuszczą zasób | Stosuje się po nadaniu danym schematu i wzbogaceniu ich o dodatkowe kolumny tabeli |
Pojedynczy element DCR może łączyć zarówno transformacje po stronie klienta, jak i transformacje podczas pozyskiwania danych. Dane wyjściowe etapu po stronie klienta automatycznie stają się danymi wejściowymi etapu pozyskiwania danych.
Zagadnienia dotyczące wieloetapowego DCR
- Przekształcenia wieloetapowe wymagają wersji interfejsu API
2025-05-11lub nowszej. Sekcjatransformationsoraz właściwośćtransformw źródłach danych i przepływach danych nie są rozpoznawane przez starsze wersje interfejsu API. - Właściwość
transformwyklucza się wzajemnie ztransformKqldla każdego przepływu danych. DCR może mieszać stare i nowe przepływy danych w różnych strumieniach. - Podczas korzystania z wersji zapoznawczej należy ręcznie koordynować nagłówek przekształcenia podrzędnego z wynikiem przekształcenia nadrzędnego. Na przykład jeśli zastosujesz agregację do surowego strumienia zdarzeń systemu Windows, wynik może nie być zgodny z odpowiadającą mu tabelą Event, a transformacja w czasie pozyskiwania danych powinna zaczynać się od niestandardowego nagłówka strumienia.
Podejście projektowe do przetwarzania wieloetapowego
Wykonaj następujące kroki podczas projektowania wieloetapowego DCR:
- Ocena źródeł danych i miejsc docelowych. Zidentyfikuj typy źródeł danych i zdecyduj, gdzie poszczególne lądują: domyślną tabelę standardową lub tabelę niestandardową.
- Identyfikowanie potrzeb agregacji. Zagregowane dzienniki powinny przejść do oddzielnej tabeli, ponieważ ich kształt różni się od postaci pierwotnej.
- Plan przetwarzania różnicowego. Jeśli musisz przetworzyć fragmenty tych samych dzienników inaczej, utwórz wiele źródeł danych tego samego typu z różnymi ustawieniami kolekcji i zastosuj różne przekształcenia po stronie klienta do każdego.
- Tworzyć przekształcenia po stronie klienta. Użyj strumieni standardowych (
Microsoft-*), jeśli dane wyjściowe zachowują schemat nagłówka, lub strumieni niestandardowych (Custom-*), jeśli go nie zachowują. Zdefiniuj strumienie niestandardowe w plikustreamDeclarations. - Definiowanie przepływów danych. Dla każdego strumienia utwórz przepływ danych. Użyj przepływów danych podczas pozyskiwania, aby podzielić pojedynczy strumień na wiele tabel docelowych, stosując różne kryteria filtrowania dla każdego przepływu danych.
Przekształcanie przestrzeni roboczej DCR
Przekształcenia są definiowane w regule zbierania danych (DCR). Niektóre kolekcje danych usługi Azure Monitor nie używają DCR. Przykłady obejmują dzienniki zasobów zbierane przez ustawienia diagnostyczne i dane aplikacji zebrane przez usługę Application Insights.
Reguła zbierania danych przekształcania obszaru roboczego (DCR) to specjalna reguła zbierania danych (DCR) stosowana bezpośrednio do obszaru roboczego usługi Log Analytics. Celem tego DCR jest wykonanie przekształceń na danych, które jeszcze nie używają DCR do zbierania danych, i przez to nie można zdefiniować przekształceń.
Dla każdego obszaru roboczego może istnieć tylko jeden DCR dla obszaru roboczego, ale może zawierać przekształcenia dla dowolnej liczby obsługiwanych tabel. Te przekształcenia są stosowane do wszystkich danych wysyłanych do tych tabel, chyba że dane pochodzą z innego kontrolera domeny.

Na przykład tabela zdarzeń służy do przechowywania zdarzeń z maszyn wirtualnych z systemem Windows. Jeśli utworzysz przekształcenie w obszarze roboczym DCR dla tabeli zdarzeń, zostanie ono zastosowane do zdarzeń zebranych przez maszyny wirtualne z uruchomionym agentem Log Analytics1, ponieważ ten agent nie używa DCR. Przekształcenie zostałoby zignorowane przez dowolne dane wysyłane z agenta usługi Azure Monitor (AMA), ponieważ do zdefiniowania jego zbierania danych jest używana funkcja DCR. Nadal można użyć przekształcenia z agentem usługi Azure Monitor, ale należy uwzględnić to przekształcenie w regule zbierania danych (DCR) skojarzonej z agentem, a nie w regule zbierania danych dla przekształcenia obszaru roboczego.

1 Agent Log Analytics został wycofany, ale niektóre środowiska mogą nadal go używać. Jest to tylko jeden przykład źródła danych, które nie używa DCR.
Przekształcenia potoków usługi Azure Monitor
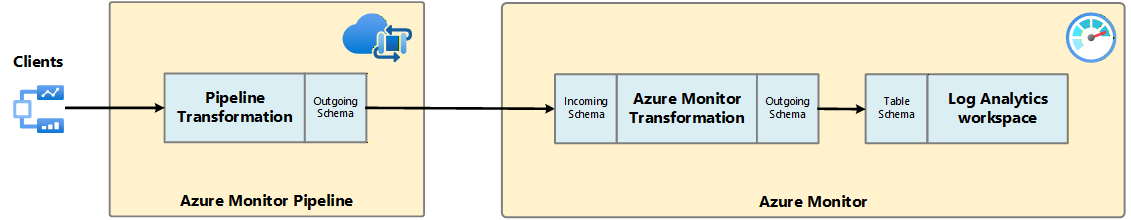
Przekształcenia danych potoku w usłudze Azure Monitor oferują funkcje podobne do przekształceń po stronie klienta w usłudze Azure Monitor. Obie umożliwiają zastosowanie zapytania KQL do danych przychodzących w celu filtrowania lub modyfikowania tych danych przed wysłaniem ich do następnego kroku przepływu danych.
Transformacje w czasie pozyskiwania danych w usłudze Azure Monitor są uruchamiane po odebraniu danych przez usługę Azure Monitor, ale przed ich pozyskaniem do obszaru roboczego Log Analytics. Przekształcenia potoku usługi Azure Monitor są stosowane wcześniej w przepływie danych, co umożliwia kształtowanie i filtrowanie danych przed wysłaniem danych do usługi Azure Monitor. Dzięki temu przekształcenia potoków są przydatne do zmniejszenia ilości danych i przepustowości sieci podczas wysyłania danych ze środowisk brzegowych lub wielochmurowych.
W poniższej tabeli podsumowano kluczowe różnice między przekształceniami potoku Azure Monitor a standardowymi przekształceniami Azure Monitor podczas pozyskiwania danych. Przekształcenia wieloetapowe obsługują również procesor agregacji podczas podglądu.
| Funkcja | Przekształcenia potoków usługi Azure Monitor | Standardowe przekształcenia Azure Monitor w czasie pozyskiwania danych |
|---|---|---|
| Po zastosowaniu | Przed wysłaniem danych do usługi Azure Monitor | Po odebraniu danych przez usługę Azure Monitor. Przed zapisaniem go w obszarze roboczym usługi Log Analytics |
| Definition | Zdefiniowane w przepływach danych w potoku Azure Monitor | Zdefiniowane w regułach zbierania danych (DCR) w usłudze Azure Monitor |
| Język | Język zapytań Kusto (KQL) | Język zapytań Kusto (KQL) |
| Obsługiwane agregacje? | Tak | Nie. |
| Obsługiwany szablon? | Tak | Nie. |
Dane przyjmowane przez usługę Azure Monitor są wynikiem połączenia transformacji potoku oraz wszelkich późniejszych przekształceń w czasie pozyskiwania danych w usłudze Azure Monitor. Jedynym wymaganiem jest to, aby schemat wyjściowy transformacji w potoku był zgodny ze schematem wejściowym wymaganym przez transformację Azure Monitor wykonywaną w czasie pozyskiwania danych. Chociaż można filtrować dane w obu przekształceniach, ogólnie bardziej wydajne jest filtrowanie danych w przekształceniach w potoku, gdyż zmniejsza to ilość danych wysyłanych przez sieć. Schemat danych wyjściowych generowanych przez transformację w czasie pozyskiwania w usłudze Azure Monitor musi być zgodny ze schematem tabeli docelowej w obszarze roboczym usługi Log Analytics.
Koszt przekształceń
Przetwarzanie logów (przekształcanie i filtrowanie) w potoku chmury Azure Monitor ma różne implikacje dla rozliczeń w zależności od typu tabeli, do której dane są wprowadzane w obszarze roboczym Log Analytics.
Dzienniki pomocnicze
Korzystanie z funkcji Auxiliary Logs wiąże się z kosztem przetwarzania danych oraz danych pozyskanych do obszaru roboczego Log Analytics. Opłata za przetwarzanie danych dotyczy wszystkich przychodzących danych odbieranych przez usługę Azure Monitor, jeśli miejscem docelowym w obszarze roboczym Log Analytics jest tabela Dzienniki pomocnicze. Obejmuje to ilość danych przetwarzanych przez transformacje Azure Monitor podczas pozyskiwania danych. Opłata za pozyskanie danych dotyczy wyłącznie danych po transformacji wykonywanej w czasie pozyskiwania, dostarczanych do tabeli Auxiliary Logs. Przekształcenia mogą zwiększyć lub zmniejszyć rozmiar danych.
W poniższej tabeli przedstawiono kilka przykładów:
| Rozmiar danych przychodzących | Dane porzucone lub dodane przez przekształcenie | Dane zaimportowane do obszaru roboczego Log Analytics jako tabela dzienników pomocniczych | Rozliczane GB do przetwarzania danych | Rozliczane gigabajty dotyczące pozyskiwania danych |
|---|---|---|---|---|
| 20 GB | Utracone 12 GB | 8 GB | 20 GB | 8 GB |
| 20 GB | Pominięte 8 GB | 12 GB | 20 GB | 12 GB |
| 20 GB | Dodano 4 GB | 24 GB | 20 GB | 24 GB |
Zobacz Cennik usługi Azure Monitor dla cen przetwarzania dzienników i pozyskiwania danych dzienników.
Logi analityczne lub podstawowe
W przypadku dzienników analitycznych lub podstawowych przekształcenia nie generują zwykle żadnych kosztów, ale następujące scenariusze mogą spowodować dodatkowe opłaty:
- Jeśli transformacja zwiększy rozmiar danych przychodzących, na przykład przez dodanie kolumny obliczeniowej, naliczana jest standardowa stawka pozyskiwania dodatkowych danych.
- Jeśli transformacja zmniejszy pozyskane dane o ponad 50%, opłata jest naliczana za ilość przefiltrowanych danych powyżej 50%.
Aby obliczyć opłatę za przetwarzanie danych wynikające z przekształceń, użyj następującej formuły:
[GB danych porzuconych przez przekształcenie] — ([GB rozmiar danych przychodzących] / 2).
W poniższej tabeli przedstawiono przykłady.
| Rozmiar danych przychodzących | Dane porzucone lub dodane przez przekształcenie | Dane wprowadzone do obszaru roboczego usługi Log Analytics jako tabela Analiza lub Dzienniki podstawowe | Rozliczane GB do przetwarzania danych | Rozliczane gigabajty dotyczące pozyskiwania danych |
|---|---|---|---|---|
| 20 GB | Utracone 12 GB | 8 GB | 2 GB | 8 GB |
| 20 GB | Pominięte 8 GB | 12 GB | 0 GB | 12 GB |
| 20 GB | Dodano 4 GB | 24 GB | 0 GB | 24 GB |
Aby uniknąć tej opłaty, należy filtrować pozyskane dane przy użyciu alternatywnych metod przed zastosowaniem przekształceń. Dzięki temu można zmniejszyć ilość danych przetwarzanych przez przekształcenia, a tym samym zminimalizować wszelkie dodatkowe koszty.
Zobacz Cennik usługi Azure Monitor , aby uzyskać informacje na temat przetwarzania dzienników i pozyskiwania danych dzienników.
Ważne
Jeśli usługa Microsoft Sentinel jest włączona dla obszaru roboczego usługi Log Analytics, nie ma opłat za przekształcenie do tabel analitycznych bez względu na ilość danych filtrowanych podczas transformacji.
Treści powiązane
- Przeczytaj więcej na temat reguł zbierania danych (DCR).
- Utwórz przekształcenie w Azure Monitor, w tym przekształcenie wieloetapowe.
-
Struktura reguły zbierania danych (DCR) dla kompletnego schematu JSON, w tym sekcji wieloetapowej
transformations. - Utwórz regułę DCR przekształcenia obszaru roboczego dla danych, które nie są zbierane za pomocą reguły DCR.
- Zapowiedź wieloetapowych transformacji na blogu Azure Observability Blog, aby uzyskać więcej informacji na temat publicznej wersji zapoznawczej.