Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
O Azure Copilot Agente de Observabilidade ajuda você a identificar, investigar e explicar degradações de serviço. Quando essas degradações ocorrem, você geralmente deseja preservar o contexto, compartilhar descobertas com sua equipe e continuar trabalhando no problema ao longo do tempo.
Um problema é o registro persistente que torna isso possível. Ele mantém os sinais relacionados juntos e oferece à sua equipe um espaço compartilhado para continuar a investigação, em vez de recomeçar a partir de alertas, recursos ou sessões de investigação separados.
Problemas versus alertas
Alertas e problemas atendem a diferentes finalidades.
Um alerta representa um sinal específico observado em um recurso. Ele é disparado quando os dados monitorados atendem às condições de uma regra de alerta.
Um problema é o registro persistente usado para investigar, gerenciar e resolver uma degradação de serviço. Embora os alertas ajudem a identificar sintomas individuais, os problemas ajudam as equipes a entender e gerenciar o problema operacional mais amplo. Um único problema pode envolver vários alertas e recursos, oferecendo uma visão unificada do incidente durante todo o seu ciclo de vida.
Como os problemas são criados
Você pode criar um problema de duas maneiras:
- A partir de uma investigação aprofundada quando você deseja continuar trabalhando com base no contexto gerado por uma investigação do Agente de Observabilidade. Para o caminho de investigação iniciado pelo usuário, consulte Investigações profundas no agente de observabilidade do Azure Copilot.
- De forma autônoma, quando o Azure Copilot Observability Agent executa operações autônomas em segundo plano. Dependendo da configuração, o agente pode criar problemas correlacionando alertas relacionados em um único incidente ou promovendo alertas individuais proeminentes em problemas. Para o caminho da correlação em segundo plano, consulte Operações autônomas no Agente de Observabilidade do Azure Copilot.
Cada problema é salvo em Workspace do Azure Monitor (AMW).
Você precisa da função Colaborador, Colaborador de Monitoramento ou Colaborador de Problemas no Workspace do Azure Monitor para criar um problema. Para obter mais informações sobre o gerenciamento de funções, consulte Atribuir funções do Azure usando o portal do Azure.
O que um problema contém
Um problema preserva o contexto de uma degradação de serviço à medida que passa da detecção inicial para a investigação e a resposta em andamento. Dependendo de como o problema foi criado, ele pode incluir:
- Emita metadados como título, gravidade, estado e tempo de impacto.
- Informações em segundo plano que resumem o problema, seu impacto e o contexto coletado até agora.
- Investigações realizadas pelo Agente de Observabilidade do Azure Copilot, incluindo os resultados da investigação, a análise, as próximas etapas recomendadas e a capacidade de continuar refinando a investigação com o Agente de Observabilidade.
- Alertas relacionados ao problema.
- Recursos relacionados que são afetados ou conectados ao problema.
Esse modelo cria problemas com o ponto de entrega durável entre a investigação conduzida pelo agente e o fluxo de trabalho com resposta humana.
Exibir problemas
Você pode exibir uma lista de problemas nos seguintes locais:
- Azure Monitor — Mostra problemas em todos os Workspaces (AMWs) do Azure Monitor nas assinaturas selecionadas.
- Área de Trabalho do Azure Monitor – mostra problemas armazenados em uma Área de Trabalho do Azure Monitor específica.
Workspace do Azure Monitor como um contêiner de problemas
Os AMWs (Workspaces) do Azure Monitor atuam como contêineres para problemas.
Você pode configurar um AMW como o contêiner padrão para todas as edições de uma assinatura. Quando você define um AMW padrão, o processo de investigação salva problemas no mesmo workspace quando alertas são acionados em recursos nessa assinatura. Salvá-los no mesmo workspace ajuda a garantir que todos os problemas relacionados sejam armazenados e gerenciados em um local consistente.
Para aprender a associar uma assinatura a um espaço de trabalho do Azure Monitor, consulte Usar problemas do Azure Monitor.
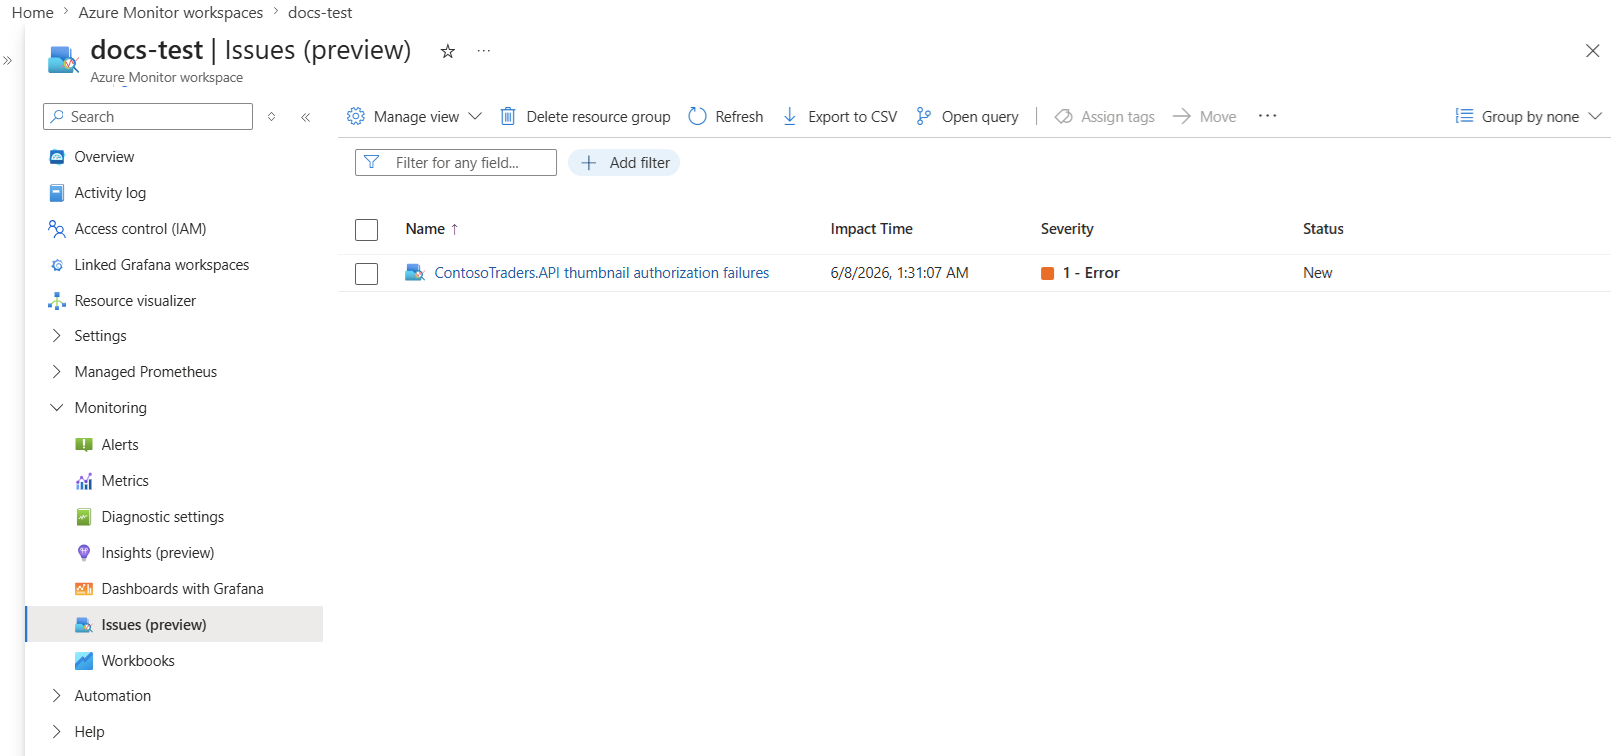
Aqui está um exemplo de um problema presente em um AMW.
Ações de problema
Quando um problema é criado ou atualizado, as ações de problema permitem disparar notificações ou fluxos de trabalho automatizados nesse ponto no fluxo de resposta. Como as ações se baseiam em um problema correlacionado e enriquecido, e não em alertas individuais, elas têm contexto consolidado: gravidade, recursos afetados e resultados de investigação. Isso fornece a fluxos de trabalho downstream informações suficientes para aplicar respostas direcionadas e consistentes em vez de reagir a sinais isolados.
Quando as notificações são disparadas
As notificações são enviadas nas seguintes situações:
- Um novo problema é criado , seja como resultado de uma investigação salva ou por um agente autônomo.
- Um problema existente é atualizado quando a gravidade ou o status do problema é alterado.
Tipos de ação com suporte
Há suporte para os seguintes tipos de ação:
- Email (destinatários individuais ou funções de Azure Resource Manager)
- SMS/texto
- Serviço de Voz
- Aplicativos Lógicos
- Hubs de Eventos
- Azure Functions
- Manual de automação
- Webhook seguro (use para conectar ao ServiceNow)
- Webhook
Configurar ações
Configure ações por meio de grupos de ações no AMW (workspace Azure Monitor), em que o problema é armazenado. Você pode configurar um ou mais grupos de ações como as ações padrão para esse workspace.
Quando um problema é criado ou atualizado, os grupos de ações configurados no AMW associado são disparados automaticamente.
Você também pode definir ações por meio da configuração de recursos do Azure Copilot Observability Agent. Para obter mais informações, consulte Criar um recurso de Agente de Observabilidade do Azure Copilot no portal do Azure.
Para obter mais informações sobre grupos de ações, consulte Grupos de ações.
Cenários de exemplo
Os exemplos a seguir mostram como as ações de problema podem dar suporte a diferentes cenários de resposta:
Coordene a investigação técnica e o gerenciamento de incidentes com o ServiceNow. Envie um problema para o SERVICENow ITOM por meio de um webhook seguro. O problema no Azure Monitor continua sendo o espaço de trabalho técnico para engenheiros de plantão, contendo alertas e recursos relacionados, bem como resultados de investigação do agente de observabilidade. O alerta correspondente do ServiceNow e o incidente correspondente no ITSM dão suporte à atribuição, ao escalonamento, às comunicações e ao fechamento. Quando você habilita a sincronização bidirecional, as alterações de status relevantes permanecem alinhadas em ambos os sistemas.
Criação de tíquetes e integração de fluxo de trabalho – use um Aplicativo Lógico para criar ou atualizar um item de trabalho em sistemas como Azure DevOps ou Jira quando um problema for criado ou atualizado. O item de trabalho pode incluir detalhes do problema, como gravidade, recursos afetados e contexto operacional, ajudando as equipes a rastrear a propriedade, coordenar o trabalho e gerenciar a resolução por meio de seus processos de engenharia existentes.
Roteamento inteligente – use uma função Azure ou aplicativo lógico para inspecionar propriedades de problema como gravidade, serviço afetado ou recursos afetados e rotear o problema para a equipe, canal ou fluxo de trabalho apropriado. Por exemplo, encaminhe problemas que afetam um aplicativo voltado para o cliente para uma equipe de engenharia de chamada, enquanto roteia problemas que afetam sistemas internos para um fluxo de trabalho operacional diferente.
Transmissão de dados de itens para sistemas de destino — Envie eventos do ciclo de vida de itens ao Hubs de Eventos do Azure para processamento por sistemas externos. Use essa abordagem para alimentar painéis personalizados, análises operacionais, pipelines de geração de relatórios, data lakes ou plataformas internas que consomem e analisam dados de incidentes em conjunto com outros sinais operacionais.