Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
As transformações no Azure Monitor filtram ou modificam os dados de entrada antes de serem enviados para um workspace Log Analytics. As transformações são executadas após a fonte de dados entregar os dados e antes de serem enviadas para o destino. Eles são definidos em uma DCR (regra de coleta de dados).
As transformações padrão usam uma instrução KQL (Kusto Query Language) aplicada individualmente a cada entrada nos dados de entrada. As transformações de vários estágios estendem esse modelo com um pipeline de processadores declarativos, em que uma consulta KQL é um dos muitos tipos de processador disponíveis na cadeia de transformação.
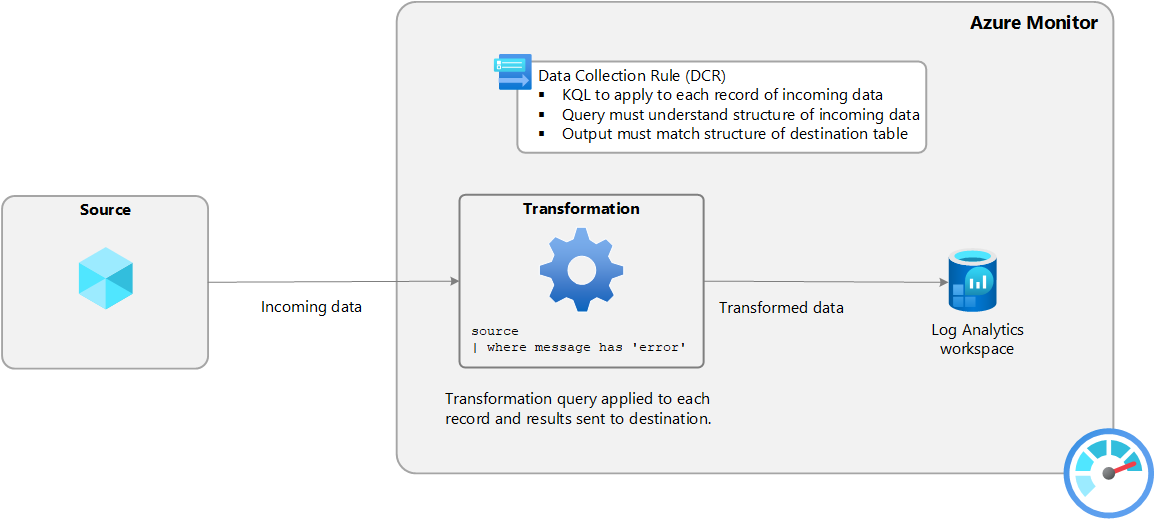
O diagrama a seguir ilustra o processo de transformação de dados de entrada e mostra uma consulta de exemplo que pode ser usada. Neste exemplo, apenas os registros em que a message coluna contém a palavra error são coletados.
Tabelas com suporte
As tabelas a seguir em um workspace do Log Analytics dão suporte a transformações.
- Qualquer tabela do Azure listada em suporte ao recurso de tabela do Logs com o indicador
 .
- Qualquer tabela personalizada criada para o Agente do Azure Monitor.
- Tabelas personalizadas com o plano auxiliar.
Criar uma transformação
Alguns cenários de coleta de dados dão suporte à adição de uma transformação por meio do portal Azure, mas a maioria dos cenários exige a criação de um novo DCR usando sua definição JSON ou a adição de uma transformação a um DCR existente. Consulte Criar uma transformação no Azure Monitor para conhecer diferentes opções e Práticas recomendadas e exemplos para transformações no Azure Monitor para consultar exemplos de consultas de transformação para cenários comuns.
Transformações de vários estágios (versão prévia)
Importante
As transformações em vários estágios estão atualmente em prévia pública. Veja os Termos de Uso Complementares para Versões Prévias do Microsoft Azure para obter termos legais que se aplicam aos recursos do Azure que estão em versão beta, versão prévia ou que, de outra forma, ainda não foram lançados em disponibilidade geral.
As transformações padrão aplicam uma única consulta KQL aos dados de entrada durante a ingestão. As transformações de vários estágios estendem esse modelo, permitindo que você defina um pipeline de processamento composto por vários estágios de processamento ordenado, aplicados como fluxos de dados por meio do sistema.
Com transformações de vários estágios, um DCR define um pipeline de processamento de dados em vez de uma única etapa de transformação. Os dados fluem pelos seguintes estágios:
- Recolha de dados. Azure Monitor Agent (AMA) coleta dados do recurso com base nas configurações da fonte de dados no DCR.
- Processamento do lado do cliente. As transformações são executadas localmente no agente antes que os dados sejam enviados pela rede. A transformação se aplica aos dados em sua forma bruta, que podem ser diferentes da representação de tabela padrão.
- Processamento em tempo de ingestão. Depois que os dados atingem Azure Monitor, as transformações são aplicadas durante a ingestão antes que os dados sejam gravados em sua tabela de destino em Log Analytics. Essa transformação se aplica depois que os dados são totalmente esquematizados e enriquecidos.
- Entrega de dados. Os logs processados são entregues ao destino final.
Processadores
As transformações em DCRs de vários estágios são definidas usando processadores – blocos de construção pequenos e declarativos que cada um executa um tipo específico de operação. Os processadores têm as seguintes características:
- Combináveis. Vários processadores podem ser encadeados em uma única transformação.
- Pedido realizado. Os processadores são executados sequencialmente na ordem definida na transformação.
- Independentemente do estágio. O mesmo tipo de processador pode ser usado em diferentes fontes de dados, estágios ou cenários, com algumas limitações durante a visualização.
Cada transformação começa com um processador de cabeçalho que converte dados brutos em um formato tabular esquematizado conhecido. Após o cabeçalho, você pode encadear processadores adicionais para filtrar, mapear, analisar, agregar, enriquecer ou aplicar expressões KQL aos dados.
As seguintes famílias de processadores estão disponíveis:
| Família | Processadores | Description |
|---|---|---|
| Cabeçalho |
header.Syslog, header.WindowsEvents, header.TextLog, header.StandardStream, header.CustomStreame outros |
Esquematar dados brutos em um formato tabular. Deve ser o primeiro processador. |
| Filter | filter.Basic |
Descartar registros com base na avaliação da condição. |
| Map |
map.Rename, map.Drop |
Renomear, digitar ou soltar colunas. |
| Parse |
parse.JsonPath, parse.XmlPath, parse.CEFAttribute |
Extraia campos de cadeias de caracteres formatadas em JSON, XML ou CEF. |
| Agregação | aggregate.Basic |
Resumir registros usando operadores de agregação com dimensões de agrupamento. |
| Enriquecimento | enrich.DNSLookup |
Procure um endereço IP e adicione uma coluna de nome DNS. |
| Transformação personalizada | transform.KQL |
Aplique uma expressão KQL arbitrária. Somente no lado da ingestão. |
Para obter a referência completa do processador, incluindo esquemas de configuração e esquemas de saída, consulte a estrutura DCR – Transformações.
Transformações do lado do cliente versus do lado da ingestão
Cada transformação é atribuída a um estágio de processamento específico. Essa distinção determina onde a computação acontece, quais dados são enviados pela rede e quais custos podem ser otimizados antecipadamente.
| Aspecto | Client-side | Tempo de ingestão |
|---|---|---|
| Atribuição | Fonte de dados (dataSources) |
Fluxo de dados (dataFlows) |
| Executado em | agente de Azure Monitor (VM) | serviço Azure Monitor |
| Processador de cabeçalho | Específico da fonte de dados (por exemplo, header.Syslog) |
header.StandardStream ou header.CustomStream |
| Benefício de custo | Reduz os custos de rede e ingestão filtrando/agregando antes que os dados saiam do recurso | Aplica-se depois que os dados são esquematizados e enriquecidos com colunas de tabela adicionais |
Um único DCR pode combinar tanto transformações do lado do cliente quanto transformações no momento da ingestão. A saída da etapa no lado do cliente passa automaticamente a ser a entrada da etapa no momento da ingestão.
Considerações sobre DCR de múltiplos estágios
- As transformações de vários estágios exigem a versão
2025-05-11da API ou posterior. Atransformationsseção e atransformpropriedade em fontes de dados e fluxos de dados não são reconhecidas por versões anteriores da API. - A propriedade
transformé mutuamente exclusiva comtransformKqlem cada fluxo de dados. Um DCR pode misturar fluxos de dados antigos e novos em fluxos diferentes. - Durante a pré-visualização, você deve alinhar manualmente o cabeçalho da transformação posterior ao resultado da transformação anterior. Por exemplo, se você aplicar a agregação a um fluxo bruto de eventos Windows, o resultado poderá não ser compatível com a tabela evento correspondente e a transformação em tempo de ingestão deverá começar com um cabeçalho de fluxo personalizado.
Abordagem de design para processamento em vários estágios
Siga estas etapas ao projetar um DCR de vários estágios:
- Avaliar fontes de dados e destinos. Identifique os tipos de fontes de dados e decida em qual tabela cada um será inserido: a tabela padrão ou uma tabela personalizada.
- Identificar as necessidades de agregação. Os logs agregados devem ir para uma tabela separada porque a forma é diferente da forma bruta.
- Preveja o processamento diferencial. Se você precisar processar partes dos mesmos logs de forma diferente, crie várias fontes de dados do mesmo tipo com configurações de coleção diferentes e aplique diferentes transformações do lado do cliente a cada um.
- Criar transformações do lado do cliente. Use fluxos padrão (
Microsoft-*) se a saída mantiver o esquema de cabeçalho ou fluxos personalizados (Custom-*) se não o fizer. Definir fluxos personalizados emstreamDeclarations. - Definir fluxos de dados. Para cada fluxo, crie um fluxo de dados. Use fluxos de dados em tempo de ingestão para dividir um único fluxo entre várias tabelas de destino aplicando diferentes critérios de filtro por fluxo de dados.
DCR de transformação do workspace
As transformações são definidas em uma DCR (regra de coleta de dados), mas ainda há coletas de dados no Azure Monitor que ainda não usam uma DCR. Exemplos incluem logs de recursos coletados por configurações de diagnóstico e dados de aplicativo coletados pelo Application Insights.
A DCR (regra de coleta de dados) de transformação de workspace é uma DCR especial que é aplicada diretamente a um workspace do Log Analytics. A finalidade desse DCR é executar transformações em dados que ainda não usam um DCR para sua coleta de dados e, portanto, não tem meios para definir uma transformação.
Pode haver apenas uma DCR de workspace para cada workspace, mas pode incluir transformações para qualquer número de tabelas com suporte. Essas transformações são aplicadas a todos os dados enviados a essas tabelas, a menos que os dados sejam provenientes de outro DCR.
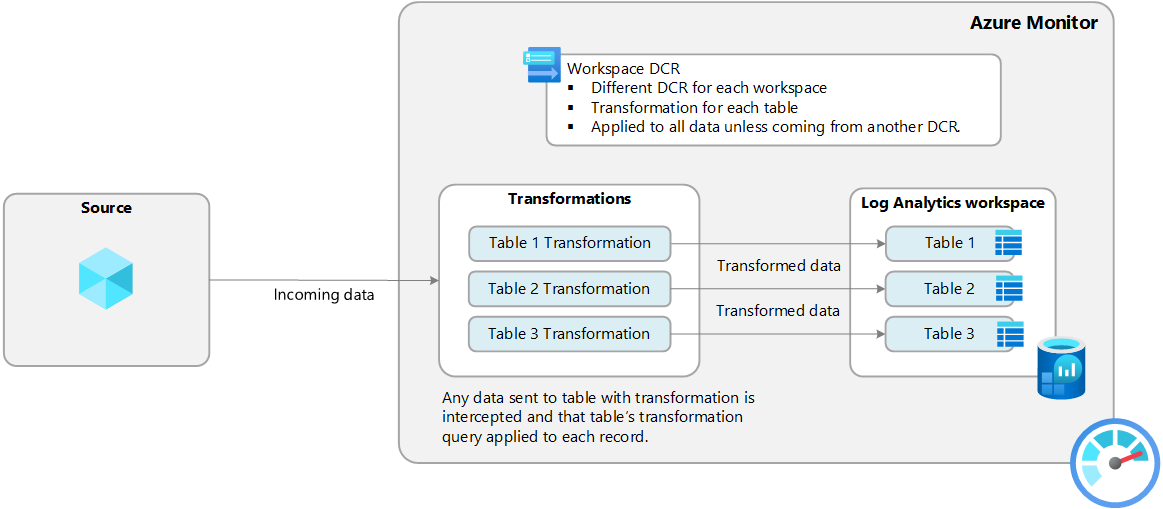
Por exemplo, a tabela Evento é usada para armazenar eventos de máquinas virtuais do Windows. Se você criar uma transformação na DCR de transformação do workspace para a tabela de eventos, ela será aplicada aos eventos coletados por máquinas virtuais que executam o agente do Log Analytics 1, pois esse agente não utiliza uma DCR. A transformação será ignorada por todos os dados enviados do AMA (Agente do Azure Monitor) porque ele usa uma DCR para definir sua coleta de dados.coleção de dados. Você ainda pode usar uma transformação com o agente do Azure Monitor, mas incluiria essa transformação na DCR associada ao agente e não na DCR de transformação do workspace.
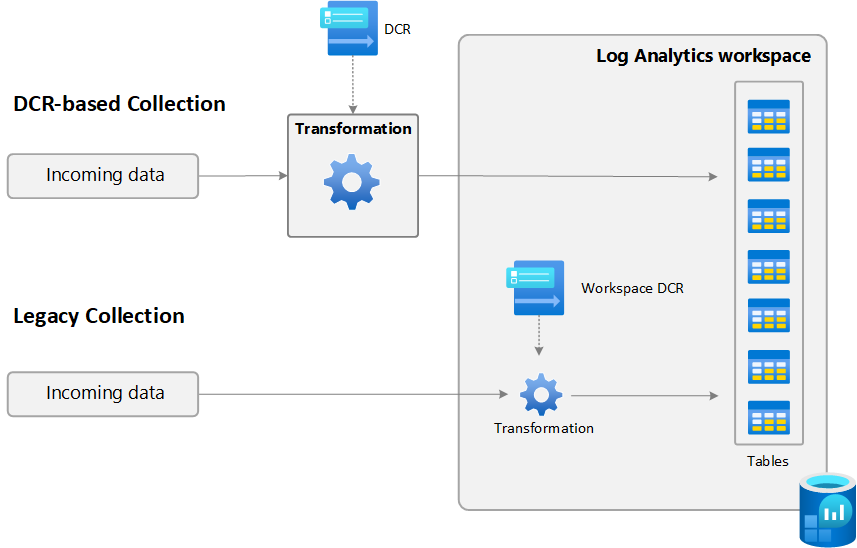
1 O agente Log Analytics foi preterido, mas alguns ambientes ainda podem usá-lo. É apenas um exemplo de uma fonte de dados que não usa uma DCR.
Transformações de pipeline do Azure Monitor
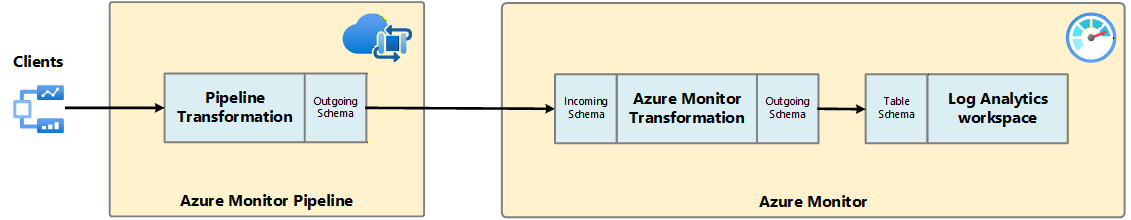
As transformações de dados de pipeline do Azure Monitor oferecem funcionalidade semelhante às transformações no lado do cliente no Azure Monitor. Ambos permitem que você aplique uma consulta KQL aos dados de entrada para filtrar ou modificar esses dados antes que eles sejam enviados para a próxima etapa no fluxo de dados.
As transformações no momento da ingestão do Azure Monitor são executadas depois que os dados são recebidos pelo Azure Monitor, mas antes de serem ingeridos no espaço de trabalho do Log Analytics. As transformações de pipeline do Azure Monitor são aplicadas anteriormente no fluxo de dados, permitindo a formatação e filtragem de dados antes que os dados sejam enviados ao Azure Monitor. Isso torna as transformações de pipeline úteis para reduzir o volume de dados e a largura de banda de rede ao enviar dados de ambientes de borda ou multinuvem.
A tabela a seguir resume as principais diferenças entre as transformações de pipeline do Azure Monitor e as ingestion-time transformations do Azure Monitor:
| Característica | Transformações de pipeline no Azure Monitor | Transformações no momento da ingestão do Azure Monitor |
|---|---|---|
| Quando aplicado | Antes que os dados sejam enviados para o Azure Monitor | Depois que os dados são recebidos pelo Azure Monitor. Antes de ser armazenado no workspace do Log Analytics |
| Definition | Definido em fluxos de dados no pipeline do Azure Monitor | Definido em DCRs (Regras de Coleta de Dados) no Azure Monitor |
| Linguagem | KQL (Kusto Query Language) | KQL (Kusto Query Language) |
| Suporte a agregações? | Yes | Não |
| Template suportado? | Yes | Não |
Os dados ingeridos no Azure Monitor são uma combinação da transformação do pipeline e de quaisquer transformações subsequentes do Azure Monitor no momento da ingestão. O único requisito é que o esquema de saída da transformação do pipeline deve corresponder ao esquema de entrada esperado pela transformação do Azure Monitor no momento da ingestão. Embora você possa filtrar dados em qualquer transformação, geralmente é mais eficiente filtrar dados nas transformações de pipeline, pois isso reduz a quantidade de dados enviados pela rede. O esquema dos dados gerados pela transformação no momento da ingestão do Azure Monitor deve corresponder ao da tabela de destino no workspace do Log Analytics.
Custo para transformações
O processamento de logs (transformação e filtragem) no pipeline de nuvem do Azure Monitor tem implicações de cobrança diferentes, dependendo do tipo de tabela em que os dados são ingeridos em um workspace do Log Analytics.
Logs auxiliares
Os logs auxiliares geram um custo para os dados processados e ingeridos no workspace do Log Analytics. A cobrança de processamento de dados se aplica a todos os dados recebidos pelo Azure Monitor quando o destino em um workspace do Log Analytics for uma tabela de Logs Auxiliares. Isso inclui a quantidade de dados processados por quaisquer transformações no momento da ingestão do Azure Monitor. A taxa de ingestão de dados aplica-se apenas aos dados após a transformação no momento da ingestão enviados para uma tabela de Logs Auxiliares. As transformações podem aumentar ou diminuir o tamanho dos dados.
A tabela seguinte mostra alguns exemplos:
| Tamanho dos dados de entrada | Dados descartados ou adicionados por transformação | Dados ingeridos em um workspace do Log Analytics como uma tabela de Logs Auxiliares | GBs faturáveis de processamento de dados | GBs faturáveis de ingestão de dados |
|---|---|---|---|---|
| 20 GB | 12 GB perdidos | 8 GB | 20 GB | 8 GB |
| 20 GB | 8 GB descartados | 12 GB | 20 GB | 12 GB |
| 20 GB | 4 GB adicionados | 24 GB | 20 GB | 24 GB |
Consulte os preços do Azure Monitor para obter preços para processamento de log e ingestão de dados de log.
Logs de análise ou Logs Básicos
Para Analytics ou registros básicos, as transformações geralmente não geram custos, mas os seguintes cenários podem resultar em custos adicionais:
- Se uma transformação aumentar o tamanho dos dados de entrada, como adicionar uma coluna calculada, você será cobrado pela taxa de ingestão padrão para os dados extras.
- Se uma transformação reduzir os dados de ingrestão em mais de 50%, você será cobrado pela quantidade de dados filtrados acima de 50%.
Para calcular a cobrança de processamento de dados resultante de transformações, use a seguinte fórmula:
[Dados de GB eliminados na transformação] – ([Tamanho dos dados de entrada GB] / 2).
A tabela a seguir mostra exemplos.
| Tamanho dos dados de entrada | Dados descartados ou adicionados por transformação | Dados ingeridos em um workspace do Log Analytics como uma tabela de Logs Analíticos ou Básicos | GBs faturáveis de processamento de dados | GBs faturáveis de ingestão de dados |
|---|---|---|---|---|
| 20 GB | 12 GB perdidos | 8 GB | 2 GB | 8 GB |
| 20 GB | 8 GB descartados | 12 GB | 0 GB | 12 GB |
| 20 GB | 4 GB adicionados | 24 GB | 0 GB | 24 GB |
Para evitar essa cobrança, você precisa filtrar dados ingeridos usando métodos alternativos antes de aplicar transformações. Ao fazer isso, você pode reduzir a quantidade de dados processados por transformações e, portanto, minimizar os custos adicionais.
Consulte os preços do Azure Monitor para obter preços para processamento de log e ingestão de dados de log.
Importante
Se o Microsoft Sentinel estiver habilitado para o workspace do Log Analytics, não haverá custo de transformação para tabelas de Análise, independentemente da quantidade de dados que a transformação filtra.
Conteúdo relacionado
- Leia mais sobre as Regras de coleta de dados(DCRs).
- Criar uma transformação em Azure Monitor, incluindo transformações de vários estágios.
-
Estrutura de uma DCR (regra de coleta de dados) para o esquema JSON completo, incluindo a seção de vários estágios
transformations. - Crie um DCR de transformação do espaço de trabalho para dados que não são coletados usando um DCR.
- Anúncio sobre transformações em vários estágios no blog Azure Observability para saber mais sobre a versão prévia pública.