Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Importante
Os itens marcados (versão prévia) neste artigo estão atualmente em versão prévia pública. Essa versão prévia é fornecida sem um contrato de nível de serviço e não recomendamos isso para cargas de trabalho de produção. Alguns recursos podem não ter suporte ou podem ter restrição de recursos. Para obter mais informações, consulte Termos de Uso Complementares para Versões Prévias do Microsoft Azure.
Este artigo aborda a geração de conjuntos de dados com base em rastros. Para ver todas as opções de preparação do conjunto de dados e os nomes de campo padrão, consulte Conjuntos de dados de avaliação no Microsoft Foundry e Esquema do conjunto de dados de avaliação.
Os rastreamentos de produção são a fonte mais representativa de como seu agente se comporta com usuários reais. Este artigo mostra como usar a geração de dados no Microsoft Foundry para transformar os rastros que seu agente já emite em um conjunto de dados selecionado e versionado que você pode usar como base para avaliação. Em seguida, execute uma avaliação sobre o resultado. Quando você seleciona rastreamentos, o Foundry usa amostragem inteligente para selecionar automaticamente um conjunto representativo, para que você obtenha um conjunto de dados de alto valor sem limpeza manual.
Converter rastreamentos em um conjunto de dados fecha o loop de observabilidade: o comportamento de produção que você captura por meio do rastreamento se torna o conjunto de testes que você usa para medir e melhorar a qualidade. O mesmo trabalho também pode produzir dados de ajuste fino.
A geração baseada em rastreamentos e a geração sintética são complementares: os rastreamentos de produção refletem o comportamento real do usuário, enquanto a geração sintética abrange cenários de pré-lançamento e casos extremos. Se o agente ainda não tiver rastreamentos de produção, ou se você quiser estender a cobertura além do que o tráfego de produção cobre, consulte Gerar um conjunto de dados sintético para avaliação.
Amostragem inteligente
Quando você seleciona um intervalo de tempo dos rastreamentos, o serviço não faz simplesmente uma amostragem aleatória desse intervalo. Ele seleciona automaticamente um conjunto representativo usando amostragem inteligente, que seleciona um conjunto de traces de alto valor a partir de dados brutos e ruidosos de produção. Você não configura estágios de filtro individuais; o serviço manipula a seleção para você. A amostragem inteligente realiza as seguintes tarefas:
- Filtra rastros irrelevantes, como mensagens com um único caractere e outro tráfego de baixa intenção que não acrescenta nenhum sinal útil para avaliação.
- Seleciona uma amostra diversificada e representativa usando MinHash para que o resultado cubra toda a gama de cenários do seu agente, em vez de dar peso excessivo a prompts frequentes e quase idênticos.
- Manipula conteúdo confidencial , incluindo dados pessoais.
Esse processo é importante porque as avaliações são caras e a maioria dos traços brutos agrega pouca informação útil. Pesquisas recentes mostram que uma seleção cuidadosa pode alcançar a mesma qualidade de avaliação com apenas uma pequena fração dos rastreamentos originais. Um conjunto representativo produz melhor sinal a um custo menor do que avaliar tudo. A amostragem inteligente é o mecanismo que torna prática a seleção de rastreamentos em escala de produção, assim você obtém conjuntos de dados prontos para avaliação sem precisar escrever código personalizado de filtragem ou remoção de duplicatas.
Amostragem inteligente usa o mesmo algoritmo de seleção de rastreamentos nas três experiências do Foundry:
- Criando um conjunto de dados a partir de rastreamentos , abordado neste artigo.
- Criando uma avaliação baseada em rastreamentos - avalie com base nos rastreamentos existentes usando uma amostra representativa do intervalo de tempo selecionado.
- Gerar um avaliador de rubrica a partir de rastreamentos de produção – o mesmo algoritmo de amostragem seleciona rastreamentos usados como entrada.
No fluxo do conjunto de dados baseado em traces, a opção Amostragem inteligente aparece no seletor de intervalo de tempo e fica ativada por padrão.
Pré-requisitos
- Python versão do SDK
2.4.0ou posterior:pip install "azure-ai-projects>=2.4.0" azure-identity(somente caminho do SDK) - Uma URL de endpoint de um projeto do Microsoft Foundry no formato
https://<your-resource>.services.ai.azure.com/api/projects/<your-project> - Função de Usuário do Foundry ou superior no projeto.
- Configure o rastreamento para um agente implantado que emite rastreamentos. Os agentes do Foundry emitem rastreamentos automaticamente, e agentes de terceiros instrumentados com OpenTelemetry também são compatíveis. Para ver as etapas de configuração, consulte Configurar o rastreamento para seu agente.
- A identidade gerenciada do projeto deve ter a função Leitor da Análise de Logs no recurso do Application Insights conectado para que o serviço possa consultar dados de rastreamento. Se as tabelas que armazenam seus rastreamentos estiverem protegidas, atribua também a função Leitor de Dados de Monitoramento Privilegiado .
- Uma região com suporte. Para a lista, consulte regiões com suporte para geração de dados.
Gerar um conjunto de dados de avaliação a partir de rastreamentos (portal)
Você pode criar um conjunto de dados a partir de rastreamentos diretamente no portal sem escrever código. Esse método é a maneira mais rápida de transformar o tráfego de produção recente em um conjunto de dados de avaliação.
No portal, abra a guia Geração de Dados . Selecione Criar conjunto>de dados de rastreamentos.
Na caixa de diálogo Criar conjunto de dados , confirme o subtítulo Coletar um conjunto de dados de rastreamentos de produção para avaliação ou ajuste fino. Em seguida, configure o conjunto de dados:
- Uso do conjunto de dados: definido como Avaliação.
- Nome: insira um nome de conjunto de dados.
- Agente: selecione o agente implantado cujos rastreamentos você deseja usar.
- Intervalo de datas: escolha a janela da qual extrair rastreamentos, como o último dia ou os últimos sete dias.
- Exemplos máximos: defina o limite em linhas no conjunto de dados. Use pelo menos 15 amostras.
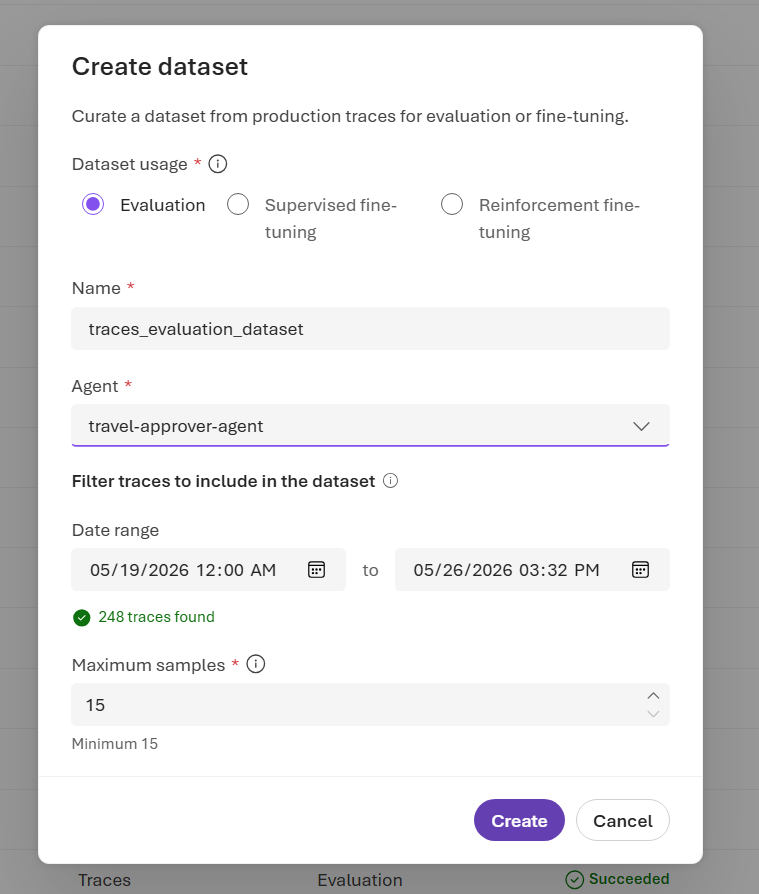
Selecione Criar para enviar o trabalho. A geração do conjunto de dados é executada como um trabalho em segundo plano. Você pode acompanhar seu status na guia Geração de Dados .
Quando o trabalho for concluído, vá para a guia Dados e selecione o conjunto de dados para visualizar as linhas geradas, incluindo a descrição, a consulta e a resposta para cada uma. A partir daí, você pode baixar ou excluir o conjunto de dados.
Use o conjunto de dados. Os trabalhos de geração concluídos levam diretamente à próxima etapa: os trabalhos de avaliação levam ao início de uma execução de avaliação, e os trabalhos de ajuste fino levam ao início de um trabalho de ajuste fino.
Gerar um conjunto de dados de avaliação a partir de rastreamentos (SDK)
Conduza seu agente implantado com tráfego realista e, em seguida, use essas conversas para criar um conjunto de dados de avaliação. O fluxo é: definir uma janela de tempo, apontar para o seu agente, definir um limite de linhas e enviar a tarefa.
Primeiro, crie um AIProjectClient usando o endpoint do projeto e DefaultAzureCredential. Você pode encontrar todas as operações de geração de dados em project_client.beta.datasets.
from azure.identity import DefaultAzureCredential
from azure.ai.projects import AIProjectClient

credential = DefaultAzureCredential()
project_client = AIProjectClient(
    endpoint="https://<your-resource>.services.ai.azure.com/api/projects/<your-project>",
    credential=credential,
)
Note
O Application Insights leva de 30 a 90 segundos para processar intervalos. Se você enviar a tarefa rápido demais após capturar o tráfego, ela será executada em um intervalo vazio e não produzirá amostras.
import time
from datetime import datetime, timedelta, timezone

from azure.ai.projects.models import (
    DataGenerationJob,
    DataGenerationJobInputs,
    DataGenerationJobOutputOptions,
    DataGenerationJobScenario,
    DatasetDataGenerationJobOutput,
    TracesDataGenerationJobOptions,
    TracesDataGenerationJobSource,
)

AGENT_NAME = "retail-agent"
poll_interval_seconds = 10

# 1. Record the window around your traffic.
end_time = datetime.now(tz=timezone.utc)
start_time = end_time - timedelta(days=7)

# 2. Define the job. Note the EVALUATION scenario.
job = DataGenerationJob(
    inputs=DataGenerationJobInputs(
        name="retail-agent-eval-set",
        scenario=DataGenerationJobScenario.EVALUATION,
        sources=[
            TracesDataGenerationJobSource(
                description="Application Insights conversation traces for the Foundry agent.",
                agent_name=AGENT_NAME,
                start_time=start_time,
                end_time=end_time,
                # agent_version="3",   # pin to a specific version (recommended)
            ),
        ],
        options=TracesDataGenerationJobOptions(
            # Service requires max_samples to be between 15 and 1000.
            max_samples=100,
        ),
        output_options=DataGenerationJobOutputOptions(name="retail-agent-eval-set"),
    ),
)

# 3. Submit and wait for completion.
poller = project_client.beta.datasets.begin_create_generation_job(job=job)
while not poller.done():
    print(f"\tstatus=`{poller.status()}`")
    time.sleep(poll_interval_seconds)
result = poller.result()

# 4. Resolve the generated dataset.
output_name = ""
output_version = ""
for output in (result.outputs if result is not None else None) or []:
    if isinstance(output, DatasetDataGenerationJobOutput):
        output_name = output.name or ""
        output_version = output.version or ""
        break

dataset = project_client.datasets.get(name=output_name, version=output_version)
print(f"Generated dataset: {dataset.name} v{dataset.version} (id: {dataset.id})")
if result is not None and result.generated_samples is not None:
    print(f"Generated samples: {result.generated_samples}")
O trabalho produz um conjunto de dados versionado registrado no seu projeto. O número de linhas é limitado por max_samples, mas pode ser menor se a janela não contiver rastreamentos distintos e de alta qualidade suficientes após a amostragem inteligente.
Se você criou o conjunto de dados do portal ou do SDK, pode visualizá-lo na guia Dados para inspecionar as linhas geradas antes de avaliar. Você também pode baixá-lo ou excluí-lo daí.
Executar uma avaliação no conjunto de dados gerado
Depois de criar o conjunto de dados, avalie seu agente com base nele. O conjunto de dados gerado usa o esquema de consulta-resposta padrão, portanto, ele funciona diretamente com as APIs de avaliação. Passe o name e o version do conjunto de dados (ou seu id) para sua execução de avaliação.
Para o fluxo de avaliação completo, incluindo a seleção de avaliadores e a revisão de resultados, consulte Avaliar um alvo de agente. Para obter um exemplo executável completo que filtra rastreamentos, gera um conjunto de dados de avaliação e o pontua, consulte sample_agent_trace_evaluation_smart_filter.py em GitHub.
Gerenciar trabalhos de geração de dados
Use project_client.beta.datasets APIs para listar, inspecionar, cancelar e excluir trabalhos de geração de dados.
from azure.ai.projects.models import DataGenerationJobScenario

# List recent evaluation jobs.
for job in project_client.beta.datasets.list_generation_jobs(
    limit=20,
    order="desc",
    scenario=DataGenerationJobScenario.EVALUATION,
):
    print(f"{job.id}  {job.status:<12}  {job.inputs.name}")

# Cancel a running job.
project_client.beta.datasets.cancel_generation_job(job_id="job_...")

# Delete a job record (produced datasets are not deleted).
project_client.beta.datasets.delete_generation_job(job_id="job_...")
Limitações
- O recurso do Application Insights conectado ao projeto do Foundry deve permitir o acesso à rede pública para que o serviço possa consultar dados do Application Insights. Se o Application Insights estiver por trás de um escopo de link privado do Azure Monitor, verifique se o acesso à consulta de rede pública está habilitado.
- Se o projeto do Foundry estiver conectado à sua própria conta de armazenamento, o acesso à rede pública deverá ser habilitado nessa conta de armazenamento para a criação bem-sucedida do conjunto de dados.
Práticas recomendadas
- Fixe
agent_versionpara tarefas de rastreamento. Sem ele, o trabalho mistura trechos de todas as versões ativas, o que pode incluir comportamento obsoleto e enfraquecer a qualidade do sinal de avaliação. - Verifique
generated_samplesapós cada tarefa.max_samplesé um teto, não uma garantia. Amostragem inteligente remove duplicatas e traços de baixa qualidade, por isso você pode obter menos linhas do que esse limite. - Use uma janela de tempo representativa. Uma janela de sete dias geralmente captura variedade suficiente. Janelas estreitas em torno de um incidente conhecido são úteis para criar conjuntos de regressão direcionados.
Conteúdo relacionado
- Gere um conjunto de dados de avaliação sintética — inicialize um conjunto de dados de avaliação sem rastreamentos de produção.
- Rastreamento de agente no Microsoft Foundry
- Executar avaliações de nuvem
- Avaliação de rastros de vários turnos por amostra de ID (Python)
- Avaliação de rastros de vários turnos usando um exemplo de filtro de agente (Python)
- Avaliação baseada em rastreamento com amostragem inteligente (Python)