Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Служба "Анализ ошибок" предназначена для тестирования служб, созданных на базе Microsoft Azure Service Fabric. С помощью службы "Анализ ошибок" можно вызвать значимые ошибки и выполнить полные сценарии тестирования для приложений. Эти неисправности и сценарии тестируют и подтверждают многочисленные состояния и переходы, которые служба проходит на протяжении всего жизненного цикла, все в управляемом, безопасном и согласованном режиме.
Действия — это отдельные сбои, нацеленные на проверку службы. Разработчик службы может использовать их в качестве стандартных блоков для создания сложных сценариев. Рассмотрим пример.
- Перезапустите узел для моделирования любого количества ситуаций, в которых выполняется перезагрузка компьютера или виртуальной машины.
- Переместите реплику вашей службы с состоянием для имитации балансировки нагрузки, переключения при отказе или обновления приложения.
- Вызовите потерю кворума в состоянии службы для создания ситуации, в которой операции записи невозможны, так как нет достаточного количества "резервных" или "вторичных" реплик для приема новых данных.
- Вызовите потерю данных в услуге с удержанием состояния, чтобы создать ситуацию, в которой все данные о состоянии в памяти полностью уничтожаются.
Сценарии — это сложные операции, состоящие из одного или нескольких действий. Служба анализа сбоев включает два полных встроенных сценария:
- Сценарий хаоса
- Сценарий аварийного переключения
Тестирование как услуга
Служба "Анализ ошибок" — это системная служба Service Fabric, которая автоматически запускается с кластером Service Fabric. Эта служба выступает в качестве узла для внедрения ошибок, выполнения сценария тестирования и анализа работоспособности.
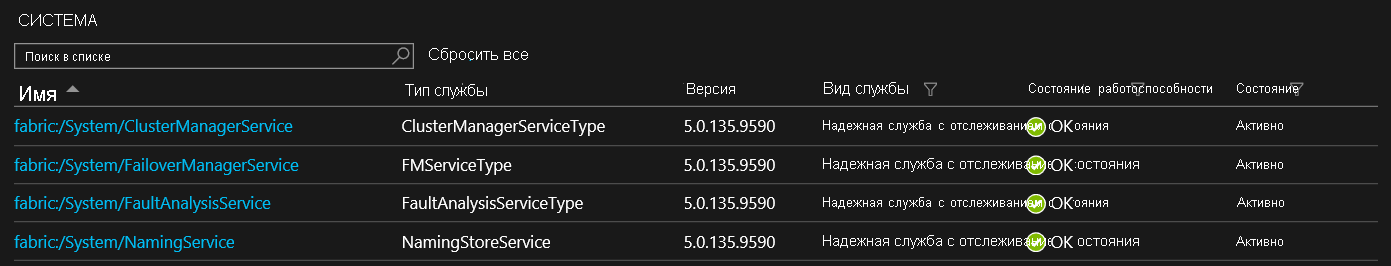
При запуске действия сбоя или сценария тестирования команда отправляется в службу анализа ошибок для выполнения действия сбоя или сценария тестирования. Служба "Анализ ошибок" имеет состояние, что позволяет надежно моделировать ошибки и сценарии и проверять результаты. Например, длительный сценарий тестирования может быть надежно выполнен службой анализа ошибок. Так как тесты выполняются в кластере, служба может проверить состояние кластера и служб, чтобы получить более подробные сведения о сбоях.
Тестирование распределенных систем
Service Fabric упрощает написание распределенных масштабируемых приложений и управление ими. Служба "Анализ ошибок" упрощает тестирование распределенного приложения. Во время тестирования необходимо решить три основных проблемы:
- Имитация и создание сбоев, которые могут возникнуть в реальных сценариях: одним из важных аспектов Service Fabric является то, что распределенные приложения могут восстанавливаться после различных сбоев. Однако для проверки того, что приложение может восстановиться после этих сбоев, нам нужен механизм имитации и создания этих реальных сбоев в управляемой тестовой среде.
- Возможность создавать коррелированные сбои: основные сбои в системе, такие как сбои сети и сбои компьютера, легко создавать по отдельности. Создание значительного количества сценариев, которые могут произойти в реальном мире в результате взаимодействия этих отдельных сбоев, является нетривиальным.
- Унифицированный опыт на различных уровнях разработки и развертывания: существует множество систем внедрения ошибок, которые могут осуществлять различные типы сбоев. Однако качество работы сильно ухудшается при переходе от однопользовательских сценариев разработчика к выполнению тех же тестов в крупных тестовых средах и их использованию для тестирования в производственных условиях.
Хотя существует множество механизмов для решения этих проблем, отсутствует система, которая выполняет то же самое с необходимыми гарантиями - от единого окружения разработчика до тестирования на рабочих кластерах. Служба "Анализ ошибок" помогает разработчикам приложений сосредоточиться на тестировании бизнес-логики. Служба "Анализ сбоев" предоставляет все возможности, необходимые для тестирования взаимодействия службы с базовой распределенной системой.
Имитация и создание сценариев сбоя в реальном мире
Чтобы проверить надежность распределенной системы по сбоям, нам нужен механизм для создания сбоев. Хотя в теории создание сбоя, такого как отказ узла, кажется простым, он сталкивается с таким же набором проблем согласованности, которые пытается решить Service Fabric. Например, если требуется завершить работу узла, требуется следующий рабочий процесс:
Из клиента отправьте запрос на завершение работы узла.
Отправьте запрос на правый узел.
a. Если узел не найден, он должен завершиться ошибкой.
б. Если узел найден, он должен вернуться только в том случае, если узел завершает работу.
Чтобы проверить сбой с точки зрения теста, тест должен знать, что при возникновении этого сбоя фактически происходит сбой. Гарантия предоставления Service Fabric заключается в том, что узел будет спускаться или уже был вниз, когда команда достигла узла. В любом случае тест должен быть способен правильно рассуждать о состоянии и правильно завершаться успехом или неудачей в своей проверке. Система, реализованная за пределами Service Fabric для того же набора сбоев, может повлиять на множество проблем с сетью, оборудованием и программным обеспечением, что не позволит ему предоставлять предыдущие гарантии. При наличии проблем, указанных ранее, Service Fabric перенастроит состояние кластера для решения проблем, и, следовательно, служба анализа ошибок по-прежнему сможет предоставить правильный набор гарантий.
Создание необходимых событий и сценариев
Хотя моделирование реального сбоя само по себе сложно, способность создавать коррелированные сбои еще сложнее. Например, потеря данных происходит в постоянном сервисном приложении с сохранением состояния, когда происходят следующие события:
- При репликации перехватываются только кворум записи реплик. Все вторичные реплики отстают от основной реплики.
- Кворум записи снижается из-за отказа реплик (из-за выхода из строя пакета кода или узла).
- Кворум записи не может восстановиться, так как данные для реплик потеряны (из-за повреждения диска или повторного создания образа компьютера).
Эти коррелированные сбои происходят в реальном мире, но не так часто, как отдельные сбои. Возможность тестирования этих сценариев перед их выполнением в рабочей среде имеет решающее значение. Еще более важно имитировать эти сценарии с рабочими нагрузками в контролируемых обстоятельствах (в середине дня со всеми инженерами на палубе). Это гораздо лучше, чем если это произойдет в продакшен-среде в 2:00 утра.
Унифицированный интерфейс в разных средах
Практика традиционно состоит в создании трех различных наборов возможностей, один для среды разработки, один для тестов и один для рабочей среды. Модель была:
- В среде разработки создаются переходы состояния, позволяющие выполнять модульные тесты отдельных методов.
- В тестовой среде создаются сбои, позволяющие проведение сквозных тестов, охватывающих различные сценарии сбоев.
- Сохраняйте рабочую среду нетронутой, чтобы предотвратить любые неестественные сбои и обеспечить оперативный человеческий ответ на них.
В Service Fabric через службу "Анализ ошибок" мы предлагаем развернуть эту методику и использовать ту же методологию от среды разработчика к рабочей среде. Это можно сделать двумя способами.
- Чтобы вызвать контролируемые сбои, используйте API-интерфейсы службы Анализа сбоев из одноблочной среды вплоть до рабочих кластеров.
- Чтобы дать кластеру лихорадку, которая вызывает автоматическую индукцию сбоев, используйте службу анализа сбоев для создания автоматических сбоев. Управление скоростью сбоев с помощью конфигурации позволяет тестировать одну и ту же службу по-разному в разных средах.
При использовании Service Fabric, хотя масштаб сбоев будет отличаться в разных средах, фактические механизмы будут идентичны. Это обеспечивает гораздо более быстрый процесс от разработки к развертыванию и возможность тестировать службы под реальными нагрузками.
Использование службы "Анализ ошибок"
C#
Функции службы "Анализ ошибок" находятся в пространстве имен System.Fabric в пакете NuGet Microsoft.ServiceFabric. Чтобы использовать функции службы "Анализ сбоев", включите пакет nuget в качестве ссылки в проекте.
PowerShell
Чтобы использовать PowerShell, необходимо установить пакет SDK Service Fabric. После установки пакета SDK модуль ServiceFabric PowerShell автоматически загружается для использования.
Дальнейшие действия
Чтобы создать действительно облачные службы, крайне важно обеспечить как до, так и после развертывания, что службы могут противостоять реальным сбоям. В мире служб сегодня способность быстро внедрять и перемещать код в рабочую среду очень важна. Служба "Анализ ошибок" помогает разработчикам служб точно это сделать.
Начните тестирование приложений и служб с помощью встроенных сценариев тестирования или создайте собственные сценарии тестирования с помощью действий сбоя , предоставляемых службой анализа ошибок.