Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Transformeringar i Azure Monitor filtrera eller ändra inkommande data innan de skickas till en Log Analytics arbetsyta. Transformeringar körs efter att datakällan levererar data och innan de skickas till målet. De definieras i en datainsamlingsregel (DCR).
Standardtransformeringar använder en KQL-instruktion (Kusto Query Language) som tillämpas individuellt på varje post i inkommande data. Omvandlingar i flera steg utökar den här modellen med en pipeline med deklarativa processorer, där en KQL-fråga är en av många tillgängliga processortyper i transformeringskedjan.
Följande diagram illustrerar omvandlingsprocessen för inkommande data och visar en exempelfråga som kan användas. I det här exemplet samlas endast poster in där kolumnen message innehåller ordet error.

Tabeller som stöds
Följande tabeller i en Log Analytics-arbetsyta stöder transformeringar.
- Alla Azure-tabeller som anges i Logs table feature support med indikatorn
 .
- Alla anpassade tabeller som skapats för Azure Monitor-agenten.
- Anpassade tabeller med Auxiliary-abonnemanget.
Skapa en transformation
Vissa scenarier för datainsamling stöder tillägg av en transformering via Azure-portalen, men de flesta scenarier kräver att du skapar en ny DCR med dess JSON-definition eller lägger till en transformering i en befintlig DCR. Se Skapa en transformering i Azure Monitor för olika alternativ och Best-metoder och exempel för omvandlingar i Azure Monitor för exempeltransformeringsfrågor i vanliga scenarier.
Omvandlingar i flera steg (förhandsversion)
Viktigt!
Omvandlingar i flera steg är för närvarande i offentlig förhandsversion. Se Tilläggsvillkor för användning av Microsoft Azure-förhandsversioner för juridiska villkor som gäller för Azure-funktioner som är i beta, förhandsvisning eller på annat sätt ännu inte släppta för allmän tillgänglighet.
Standardtransformeringar tillämpar en enda KQL-fråga på inkommande data under inmatning. Omvandlingar i flera steg utökar den här modellen genom att du kan definiera en bearbetningspipeline som består av flera ordnade bearbetningssteg, som tillämpas som dataflöden genom systemet.
Med transformeringar i flera steg definierar en DCR en databearbetningspipeline i stället för ett enda transformeringssteg. Data flödar genom följande steg:
- Datainsamling. Azure Monitor Agent (AMA) samlar in data från resursen baserat på datakällans inställningar i DCR.
- Bearbetning på klientsidan. Transformeringar körs lokalt på agenten innan data skickas via nätverket. Omvandlingen gäller för data i dess rådataform, vilket kan skilja sig från standardtabellrepresentationen.
- Inmatningstidsbearbetning. När data når Azure Monitor tillämpas transformeringar under inmatningen innan data skrivs till måltabellen i Log Analytics. Den här omvandlingen gäller när data är helt schematiserade och berikade.
- Dataleverans. Bearbetade loggar levereras till slutmålet.
Processors
Transformeringar i dcr:er i flera steg definieras med hjälp av processorer – små, deklarativa byggstenar som var och en utför en viss typ av åtgärd. Processorer har följande egenskaper:
- Komponerbar. Flera processorer kan länkas samman i en enda transformering.
- Beställd. Processorer körs sekventiellt i den ordning som definieras i omvandlingen.
- Scenagnostisk. Samma processortyp kan användas mellan olika datakällor, faser eller scenarier, med vissa begränsningar under förhandsversionen.
Varje transformering börjar med en huvudprocessor som konverterar rådata till ett känt schemaiserat tabellformat. Efter rubriken kan du länka ytterligare processorer för att filtrera, mappa, parsa, aggregera, berika eller tillämpa KQL-uttryck på data.
Följande processorfamiljer är tillgängliga:
| Familj | Processors | beskrivning |
|---|---|---|
| Header |
header.Syslog, header.WindowsEvents, header.TextLog, header.StandardStream, header.CustomStreamoch andra |
Schemaisera rådata i tabellformat. Måste vara den första processorn. |
| Filter | filter.Basic |
Ta bort poster baserat på villkorsutvärdering. |
| Map |
map.Rename, map.Drop |
Byt namn på, typomvandla eller ta bort kolumner. |
| Parse |
parse.JsonPath, parse.XmlPath, parse.CEFAttribute |
Extrahera fält från JSON-, XML- eller CEF-formaterade strängar. |
| Aggregation | aggregate.Basic |
Sammanfatta poster med hjälp av aggregeringsoperatorer och grupperingsdimensioner. |
| Berikning | enrich.DNSLookup |
Slå upp en IP-adress och lägg till en DNS-namnkolumn. |
| Anpassad omvandling | transform.KQL |
Använd ett godtyckligt KQL-uttryck. Endast på ingestionssidan. |
Fullständig processorreferens, inklusive konfigurationsscheman och utdatascheman, finns i DCR-struktur – transformeringar.
Omvandlingar på klientsidan jämfört med inmatningssidan
Varje transformering tilldelas till en specifik bearbetningsfas. Den här skillnaden avgör var beräkning sker, vilka data som skickas via nätverket och vilka kostnader som kan optimeras tidigt.
| Aspect | Client-side | Inmatningstid |
|---|---|---|
| Tilldelning | Datakälla (dataSources) |
Dataflöde (dataFlows) |
| Körs på | Azure Monitor Agent (VM) | Azure Monitor tjänst |
| Processor för sidhuvud | Datakällaspecifik (till exempel header.Syslog) |
header.StandardStream eller header.CustomStream |
| Kostnadsförmån | Minskar kostnaderna för nätverk och inmatning genom att filtrera/aggregera innan data lämnar resursen | Gäller efter att data schemaiserats och berikats med ytterligare tabellkolumner |
En enda DCR kan kombinera både omvandlingar på klientsidan och inmatningstid. Utdata från fasen på klientsidan blir automatiskt indata till inmatningstidssteget.
Överväganden för DCR i flera steg
- Omvandlingar i flera steg kräver API-version
2025-05-11eller senare. Avsnittettransformationsochtransformegenskapen för datakällor och dataflöden identifieras inte av tidigare API-versioner. - Egenskapen
transformkan inte användas tillsammans medtransformKqli varje dataflöde. En DCR kan blanda gamla och nya dataflöden mellan olika strömmar. - I förhandsgranskningen måste du manuellt matcha rubrikraden för den efterföljande transformationen mot resultatet från den föregående transformationen. Om du till exempel tillämpar aggregering på en råström med Windows händelser kanske resultatet inte är kompatibelt med motsvarande händelsetabell och inmatningstidstransformeringen bör börja med ett anpassat flödeshuvud.
Designmetod för bearbetning i flera steg
Följ dessa steg när du utformar en DCR i flera steg:
- Utvärdera datakällor och mål. Identifiera dina datakälltyper och bestäm var varje typ ska hamna: i standardtabellen som standard eller i en anpassad tabell.
- Identifiera aggregeringsbehov. Aggregerade loggar bör gå till en separat tabell eftersom deras form skiljer sig från det råa formuläret.
- Planera för differentiell bearbetning. Om du behöver bearbeta delar av samma loggar på olika sätt skapar du flera datakällor av samma typ med olika samlingsinställningar och tillämpar olika omvandlingar på klientsidan på var och en.
- Skapa omvandlingar på klientsidan. Använd standardströmmar (
Microsoft-*) om utdata behåller huvudschemat eller anpassade strömmar (Custom-*) om det inte gör det. Definiera anpassade strömmar istreamDeclarations. - Definiera dataflöden. Skapa ett dataflöde för varje ström. Använd dataflöden för inmatningstid för att dela en enda ström över flera måltabeller genom att tillämpa olika filtervillkor per dataflöde.
DCR för arbetsytetransformering
Transformeringar definieras i en datainsamlingsregel (DCR), men det finns fortfarande datasamlingar i Azure Monitor som ännu inte använder en DCR. Exempel är resursloggar som samlas in av diagnostikinställningar och programdata som samlas in av Application Insights.
Datainsamlingsregeln för arbetsytetransformering (DCR) är en särskild DCR som tillämpas direkt på en Log Analytics-arbetsyta. Syftet med denna DCR är att utföra transformeringar på data som ännu inte använder en DCR för sin datainsamling och därför inte har något sätt att definiera en transformering.
Det kan bara finnas en arbetsyte-DCR för varje arbetsyta, men den kan innehålla transformeringar för valfritt antal tabeller som stöds. Dessa transformeringar tillämpas på alla data som skickas till dessa tabeller om inte dessa data kom från en annan DCR.

Händelsetabellen används till exempel för att lagra händelser från virtuella Windows-datorer. Om du skapar en transformering i arbetsytans transformerings-DCR för händelsetabellen tillämpas den på händelser som samlas in av virtuella datorer som kör Log Analytics-agenten1 eftersom den här agenten inte använder någon DCR. Omvandlingen ignoreras dock av data som skickas från Azure Monitor Agent (AMA) eftersom den använder en DCR för att definiera sin datainsamling. Du kan fortfarande använda en transformation med Azure Monitor-agenten, men du inkluderar den transformationen i den DCR som är associerad med agenten och inte i DCR:n för arbetsytetransformationer.

1 Log Analytics-agenten har blivit inaktuell, men vissa miljöer kan fortfarande använda den. Det är bara ett exempel på en datakälla som inte använder en DCR.
Azure Monitor-pipeline-transformationer
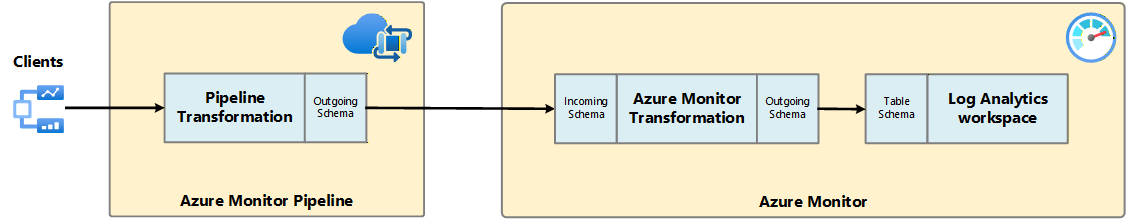
Azure Monitor pipeline-datatransformeringar erbjuder liknande funktioner som transformeringar på klientsidan i Azure Monitor. Båda låter dig tillämpa en KQL-fråga på inkommande data för att filtrera eller ändra dessa data innan de skickas till nästa steg i dataflödet.
Azure Monitor-transformeringar vid inmatning körs efter att data har tagits emot av Azure Monitor men innan den matas in i Log Analytics-arbetsytan. Azure Monitor-pipelinetransformeringar tillämpas tidigare i dataflödet, vilket möjliggör dataformning och filtrering innan data skickas till Azure Monitor. Detta gör pipelinetransformeringar användbara för att minska datavolymen och nätverksbandbredden när data skickas från kantmiljöer eller miljöer med flera moln.
I följande tabell sammanfattas de viktigaste skillnaderna mellan Azure Monitor pipelinetransformeringar och Azure Monitor inmatningstidstransformationer:
| Egenskap | Azure Monitor-pipelineomvandlingar | Azure Monitor-transformeringar vid inmatning |
|---|---|---|
| När det används | Innan data skickas till Azure Monitor | När data har tagits emot av Azure Monitor. Innan den lagras på Log Analytics-arbetsytan |
| Definition | Definieras i dataflöden i Azure Monitor-pipeline | Definieras i datainsamlingsregler (DCR) i Azure Monitor |
| Language | Kusto Query Language (KQL) | Kusto Query Language (KQL) |
| Stöds sammansättningar? | Yes | Nej |
| Är mallen stödd? | Yes | Nej |
De data som matas in i Azure Monitor är en kombination av transformeringen i pipelinen och eventuella efterföljande transformeringar vid inmatning i Azure Monitor. Det enda kravet är att utdataschemat för pipelinetransformeringen måste matcha indataschemat som förväntas av Azure Monitor inmatningstidstransformering. Även om du kan filtrera data i någon av transformeringarna är det i allmänhet mer effektivt att filtrera data i pipelinetransformeringar eftersom det minskar mängden data som skickas via nätverket. Schemat för utdata från Azure Monitor-transformeringen vid inmatning måste matcha schemat för destinationstabellen i Log Analytics-arbetsytan.
Kostnad för transformeringar
Bearbetning av loggar (transformering och filtrering) i Azure Monitor-molnpipelinen har olika faktureringskonsekvenser beroende på vilken typ av tabell som data matas in i på en Log Analytics-arbetsyta.
Tilläggsloggar
Hjälploggar medför en kostnad för data som bearbetas och data som matas in i en Log Analytics-arbetsyta. Databehandlingsavgiften gäller för alla inkommande data som tas emot av Azure Monitor när målet i en Log Analytics-arbetsyta är en hjälploggstabell. Detta omfattar mängden data som bearbetas av alla transformeringar vid inmatning i Azure Monitor. Avgiften för datainmatning gäller endast de data efter transformeringen vid inmatningstillfället som skickas till en Auxiliary Logs-tabell. Transformeringar kan antingen öka eller minska datastorleken.
Följande tabell visar några exempel:
| Inkommande datastorlek | Data som har tagits bort eller lagts till genom transformeringens process | Data som importeras i en Log Analytics-arbetsyta som en hjälploggstabell | Fakturerbara GB:er för databearbetning | Fakturerbara GB:er för datainmatning |
|---|---|---|---|---|
| 20 GB | 12 GB har förlorats | 8 GB | 20 GB | 8 GB |
| 20 GB | 8 GB minskat | 12 GB | 20 GB | 12 GB |
| 20 GB | 4 GB har lagts till | 24 GB | 20 GB | 24 GB |
Se Prissättning för Azure Monitor för priser för loggbearbetning och loggdatainmatning.
Analys- eller grundläggande loggar
För analys- eller grundläggande loggar medför transformeringar i sig vanligtvis inte några kostnader, men följande scenarier kan resultera i ytterligare avgifter:
- Om en transformering ökar storleken på inkommande data, till exempel genom att lägga till en beräknad kolumn, debiteras du standardinmatningshastigheten för extra data.
- Om en transformering minskar inmatade data med mer än 50%debiteras du för mängden filtrerade data över 50%.
Använd följande formel för att beräkna databearbetningsavgiften till följd av transformeringar:
[GB data som förlorats vid transformering] – ([GB inkommande datavolym] / 2).
Följande tabell visar exempel.
| Inkommande datastorlek | Data som har tagits bort eller lagts till genom transformeringens process | Data som matas in i en Log Analytics-arbetsyta som en Analys- eller Basic Logs-tabell | Fakturerbara GB:er för databearbetning | Fakturerbara GB:er för datainmatning |
|---|---|---|---|---|
| 20 GB | 12 GB har förlorats | 8 GB | 2 GB | 8 GB |
| 20 GB | 8 GB minskat | 12 GB | 0 GB | 12 GB |
| 20 GB | 4 GB har lagts till | 24 GB | 0 GB | 24 GB |
För att undvika den här avgiften bör du filtrera inmatade data med hjälp av alternativa metoder innan du tillämpar transformeringar. På så sätt kan du minska mängden data som bearbetas av transformeringar och därmed minimera eventuella ytterligare kostnader.
Se Prissättning för Azure Monitor för priser för loggbearbetning och loggdatainmatning.
Viktigt!
Om Microsoft Sentinel är aktiverat för Log Analytics-arbetsytan kostar det ingen kostnad för transformering till Analytics-tabeller oavsett hur mycket data transformeringsfiltren filtrerar.
Relaterat innehåll
- Läs mer om regler för datainsamling (DCR).
- Skapa en transformering i Azure Monitor, inklusive omvandlingar i flera steg.
-
Strukturen för en datainsamlingsregel (DCR) för det fullständiga JSON-schemat, inklusive avsnittet med flera steg
transformations. - Skapa en DCR för arbetsytetransformering för data som inte samlas in med hjälp av en DCR.
- Meddelandet om flerfasomvandlingar på Azure Observability Blog för bakgrundsinformation om den offentliga förhandsversionen.