Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Anteckning
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
Azure AI-sökning erbjuder två prismodeller som hanterar kapaciteten på olika sätt:
Dedikerad: Planera kapacitet genom att ändra storlek på repliker och partitioner och välja en tjänstnivå.
- Företablera kapacitet direkt genom att använda repliker och partitioner.
- Beräkna nödvändig lagring (partitioner) och nödvändigt dataflöde (repliker).
- Välj en tjänstnivå för att etablera den kapacitet som behövs baserat på förväntad toppefterfrågan.
- När du har konfigurerat kapaciteten i förväg betalar du en timtaxa som mäts av sökenheter (SUS), oavsett användning.
Serverlös (förhandsversion): Tjänsten hanterar automatiskt kapacitet baserat på användnings- och tjänstgränser. Du behöver inte etablera kapacitet i förväg. Optimera i stället arbetsbelastningens effektivitet för att hantera kostnader.
- Kapaciteten skalas automatiskt med efterfrågan (kan skalas till noll när den är inaktiv).
- Du debiteras utifrån faktisk användning, mätt i Compute Units (CU) och lagring.
- I stället för infrastruktur fokuserar planeringen på dessa kostnadsdrivrutiner: Frågemönster, indexstorlek och tillväxt samt datainmatningsmönster. Se Optimera kostnader för den serverlösa modellen.
| Dimension | Dedicated | Serverless |
|---|---|---|
| Kapacitetsmodell | Etablerad kapacitet (repliker × partitioner) | Förbrukningsbaserad |
| Scaling | Manuell | Automatiskt |
| Användarkontroll | Explicit (konfigurera repliker och partitioner) | Indirekt (påverkas av arbetsbelastningsegenskaper) |
| Billing | Fast timtaxa per sökenheter (SUS) | Förbrukningsbaserade betalningar för beräkningsenheter (CUS) och lagring |
| Inaktiv kostnad | Debiteras alltid (minsta allokerade kapacitet) | Skalar till noll när den är inaktiv |
| Fokus på optimering | Dimensionering av infrastruktur | Arbetsbelastningseffektivitet |
| Bäst för | Förutsägbara, stadiga arbetsbelastningar | Variabla, ojämna eller för flera klientorganisationer avsedda arbetsbelastningar, inklusive agentdrivna scenarier |
| Kapacitetsplaneringsmetod | Infrastruktur för storlek och skalning (repliker och partitioner) | Optimera arbetsbelastningens effektivitet och användningsmönster |
| Ineffektivitetspåverkan | Latens och skaleringspress | Direkt kostnadsökning |
Important
Nivån Serverless Developer är för närvarande i förhandsversion. Den här förhandsversionen tillhandahålls utan ett serviceavtal och rekommenderas inte för produktionsarbetsbelastningar. Vissa funktioner kanske inte stöds eller kan vara begränsade. Mer information finns i Kompletterande villkor för användning av Microsoft Azure-förhandsversioner.
Faktureringen för nivån Serverlös utvecklare började den 13 september 2026. Avgifter för användning på eller efter det datumet visas på din Azure faktura. Du debiteras inte för användning före den 13 september 2026.
Nivån Serverlös utvecklare stöder inte migrering till eller från andra prisnivåer och vissa funktioner som är tillgängliga på andra nivåer stöds inte under den offentliga förhandsversionen. Tjänstbegränsningar, funktioner som stöds och prisinformation kan ändras före allmän tillgänglighet.
Under förhandsversionen stöds den serverlösa prismodellen endast i specifika regioner.
Mer information finns i avsnittet om hur du gör så här:
- Planera och hantera kostnader
- Välj en prismodell och tjänstnivå
- Optimera kostnader med den serverlösa prismodellen
Planera kapacitet för den dedikerade modellen
I den dedikerade modellen etablerar du kapacitet med hjälp av sökenheter (SU):
- Sökenhet (SU) = repliker × partitioner
- Replik: Kopior av sökmotorn. Ger frågedataflöde och hög tillgänglighet.
- Partition: Lagringsenheter. Tillhandahåller dataflöde för lagring och indexering.
Varje tjänst börjar med 1 replik × 1 partition (1 SU). Du kan lägga till eller ta bort repliker och partitioner oberoende av varandra för att hantera fluktuerande arbetsbelastningar. Om du lägger till kapacitet ökar kostnaden för att köra en söktjänst.
| Begrepp | Definition |
|---|---|
| Sökenhet | En enda ökning av den totala tillgängliga kapaciteten. Minst en sökenhet krävs för att köra tjänsten. Beroende på prisnivån varierar det maximala antalet från en till 36 enheter. Antalet sökenheter är lika med antalet repliker multiplicerat med antalet partitioner: R × P = SU. Varje tjänst börjar med en replik och en partition, som förbrukar en enhet: 1 × 1 = 1. Att lägga till en andra kopia använder två enheter: 2 × 1 = 2. En sökenhet är också faktureringsenheten för en söktjänst. |
| Replik | Instanser av söktjänsten, som främst används för belastningsutjämning av frågeoperationer. Varje replik innehåller en kopia av ett index. Om du allokerar tre repliker har du tre kopior av ett index som är tillgängligt för service av frågebegäranden. |
| Partition | Fysisk lagring och I/O för läs-/skrivåtgärder (till exempel vid återskapande eller uppdatering av ett index). Varje partition har en del av det totala indexet. Om du allokerar tre partitioner delas ditt index upp i tredjedelar. |
Granska tabellen för partitioner och repliker för möjliga kombinationer som håller sig under gränsen på 36 enheter.
De fysiska egenskaperna för repliker och partitioner, till exempel bearbetningshastighet och disk-I/O, varierar beroende på tjänstnivå. I en standard söktjänst är replikerna och partitionerna snabbare och större än de i en grundläggande tjänst.
När du ska lägga till kapacitet för den dedikerade modellen
Överväg att lägga till repliker eller partitioner när:
- Frågelatensen ökar eller så uppfylls inte SLA-kriterierna.
- Frekvensen för HTTP 503-fel (tjänsten är inte tillgänglig) ökar.
- Frekvensen för HTTP 429-fel (för många begäranden) ökar, vilket indikerar begränsning av begäran.
- Stora frågevolymer förväntas.
- Indexeringsjobb är långsamma eller släpar efter.
- Dataflödet för lagring eller indexering är otillräckligt.
Skalningsvägledning:
- Lägg till repliker för att öka frågedataflödet och tillgängligheten.
- Lägg till partitioner för att öka lagrings - och indexeringsprestanda.
- Frågeintensiva arbetsbelastningar kräver vanligtvis fler repliker.
- Stora index kan kräva extra repliker för att upprätthålla prestanda.
Important
Skalningsåtgärder kan ta tid att slutföra och öka kostnaderna. Verifiera alltid ändringar med hjälp av prestandatestning och prisuppskattningar.
Den tjänstnivå som du väljer avgör partitionens storlek och hastighet. Varje nivå är optimerad kring en uppsättning egenskaper som passar olika scenarier. Om du väljer en högre nivå kan du behöva färre partitioner än om du använder S1. En av de frågor du behöver besvara via självstyrd testning är om en större och dyrare partition ger bättre prestanda än två billigare partitioner på en tjänst som etableras på en lägre nivå.
En enskild tjänst måste ha tillräckligt med resurser för att hantera alla arbetsbelastningar (indexering och frågor). Ingen av arbetslasterna körs i bakgrunden. Du kan schemalägga indexering för tider då frågebegäranden naturligtvis är mindre frekventa, men tjänsten prioriterar annars inte en uppgift framför en annan. Dessutom jämnar en viss mängd redundans ut frågeprestanda när tjänster eller noder uppdateras internt.
Som en allmän regel tenderar sökprogram att behöva fler repliker än partitioner, särskilt när tjänstens verksamhet är inriktad på frågearbetsbelastningar. Varje replik är en kopia av ditt index, så tjänsten kan lastbalansera begäranden mot flera kopior. Azure AI-sökning hanterar all belastningsutjämning och replikering av ett index. Du kan när som helst ändra antalet repliker som allokerats för tjänsten. Du kan allokera upp till 12 repliker i en Standard-söktjänst och 3 repliker i en grundläggande söktjänst. Du kan göra replikallokering från antingen Azure-portalen eller något av de programmatiska alternativen.
Extra partitioner är användbara för intensiva indexeringsarbetsbelastningar. Extra partitioner sprider läs- och skrivåtgärder över ett större antal beräkningsresurser.
Slutligen tar det längre tid att köra frågor mot större index. Därför kan det hända att varje inkrementell ökning av partitioner kräver en mindre men proportionell ökning av repliker. Komplexiteten i dina frågor och frågevolymen påverkar hur snabbt frågorna körs.
För tjänstbegränsningar och giltiga skalningsintervall, se:
Anteckning
Om du lägger till fler repliker eller partitioner ökar kostnaden för att köra tjänsten och kan medföra små variationer i hur resultaten sorteras. Kontrollera priskalkylatorn för att förstå faktureringskonsekvenserna av att lägga till fler noder. Tabellen med kombinationer av partitioner och repliker kan hjälpa dig att korsreferensa antalet sökenheter som krävs för en specifik konfiguration. Mer information om hur extra repliker påverkar frågebearbetning finns i Beställa resultat.
Hantera och justera kapacitet
Att ändra kapacitet är inte omedelbart. Beroende på datavolym och åtgärdstyp kan skalning ta från minuter till flera timmar.
När du skalar en söktjänst kan du välja mellan följande verktyg och metoder:
Anteckning
Om söktjänsten skapades före april eller maj 2024 kan den vara berättigad till en engångsuppgradering till nyare infrastruktur med större partitionsstorlekar utan extra kostnad. Den här uppgraderingen kan öka den tillgängliga lagringen per partition och minska antalet partitioner som krävs för din arbetsbelastning. Mer information finns i Uppgradera söktjänsten.
Om du vill öka eller minska kapaciteten för din tjänst har du två alternativ:
Lägga till eller ta bort partitioner och repliker
Gå till söktjänsten i Azure-portalen.
I den vänstra rutan väljer du Skalning av inställningar>.
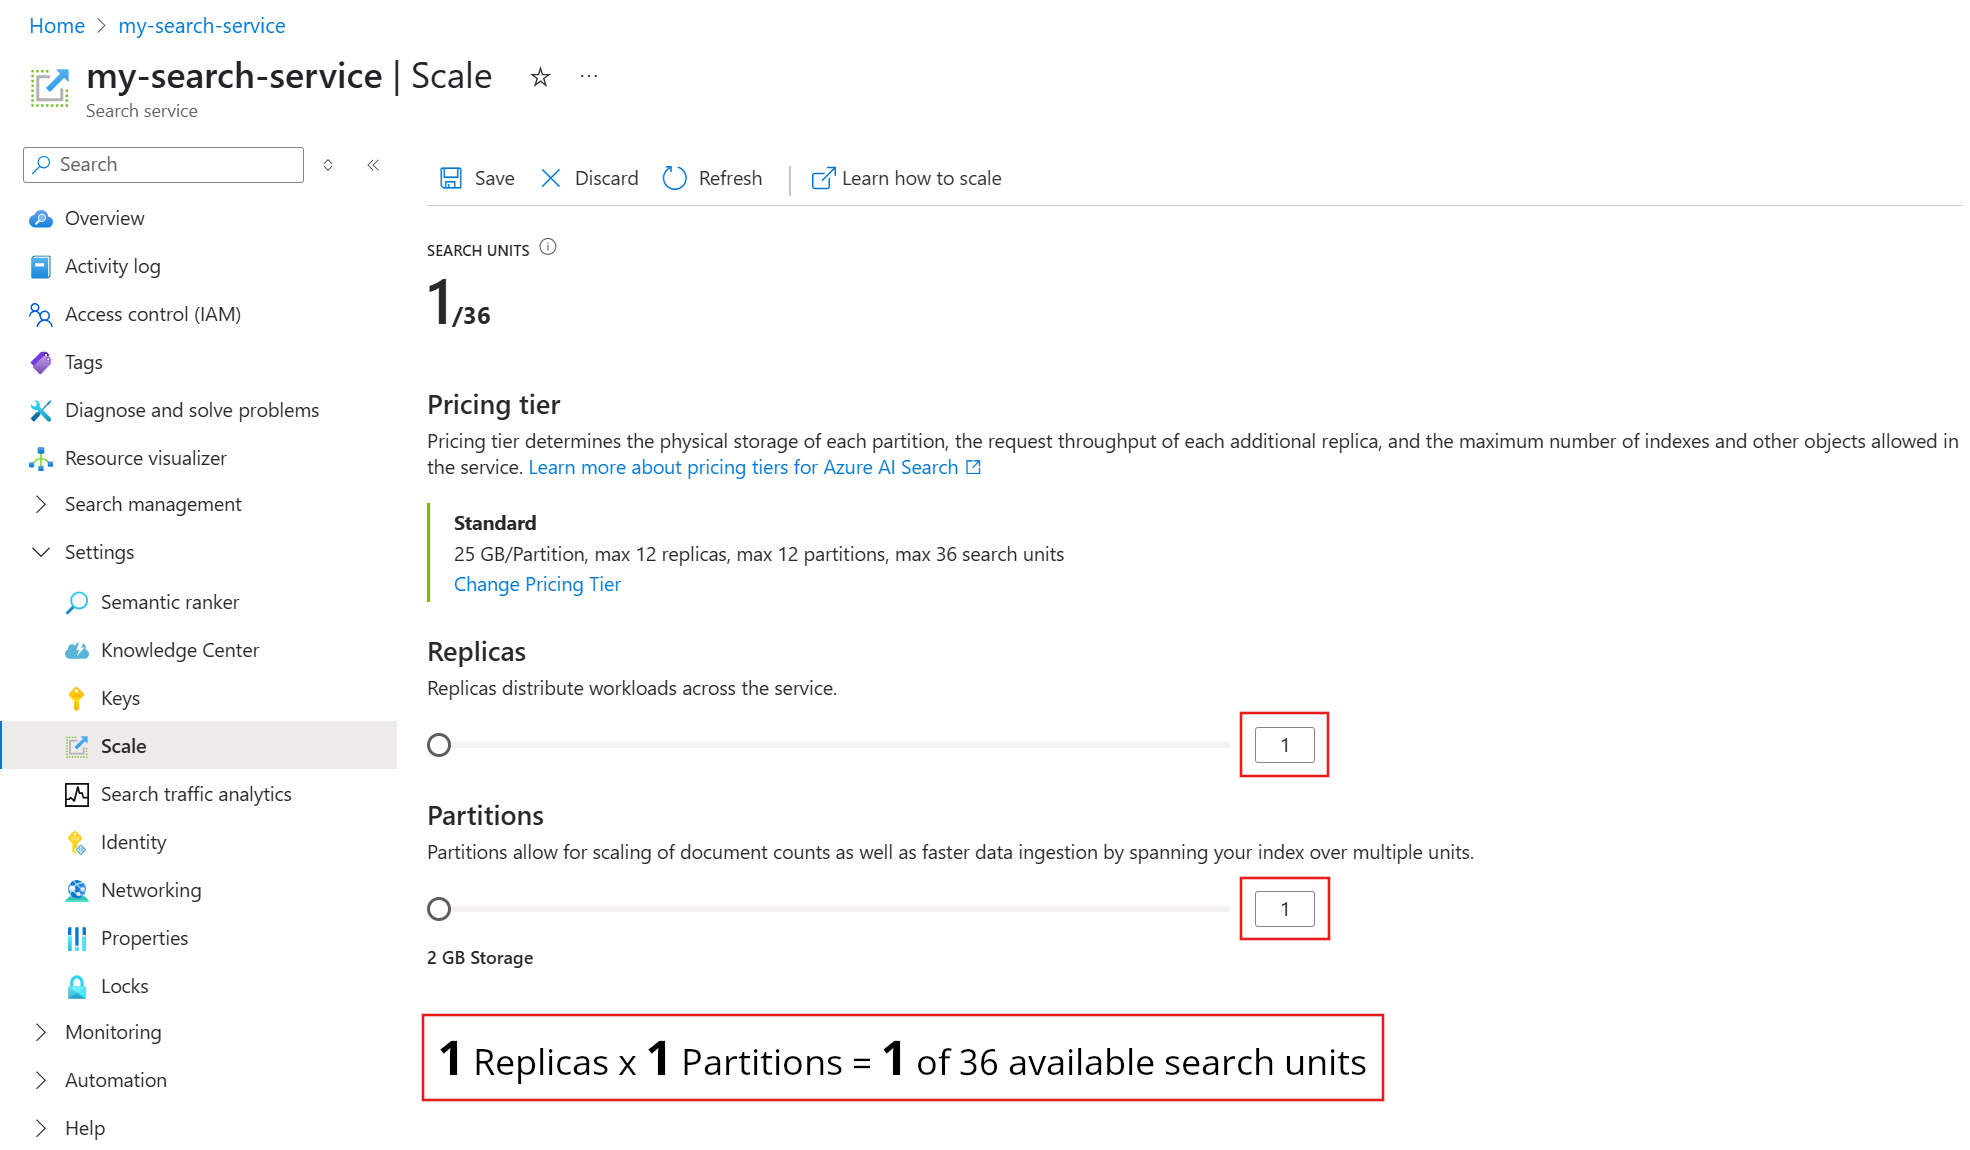
Följande skärmbild visar en standardtjänst som har tilldelats en replik och en partition. Formeln längst ned anger hur många sökenheter som används (1). Om enhetspriset var 100 USD (inte ett verkligt pris) skulle den månatliga kostnaden för att köra den här tjänsten vara 100 USD i genomsnitt.
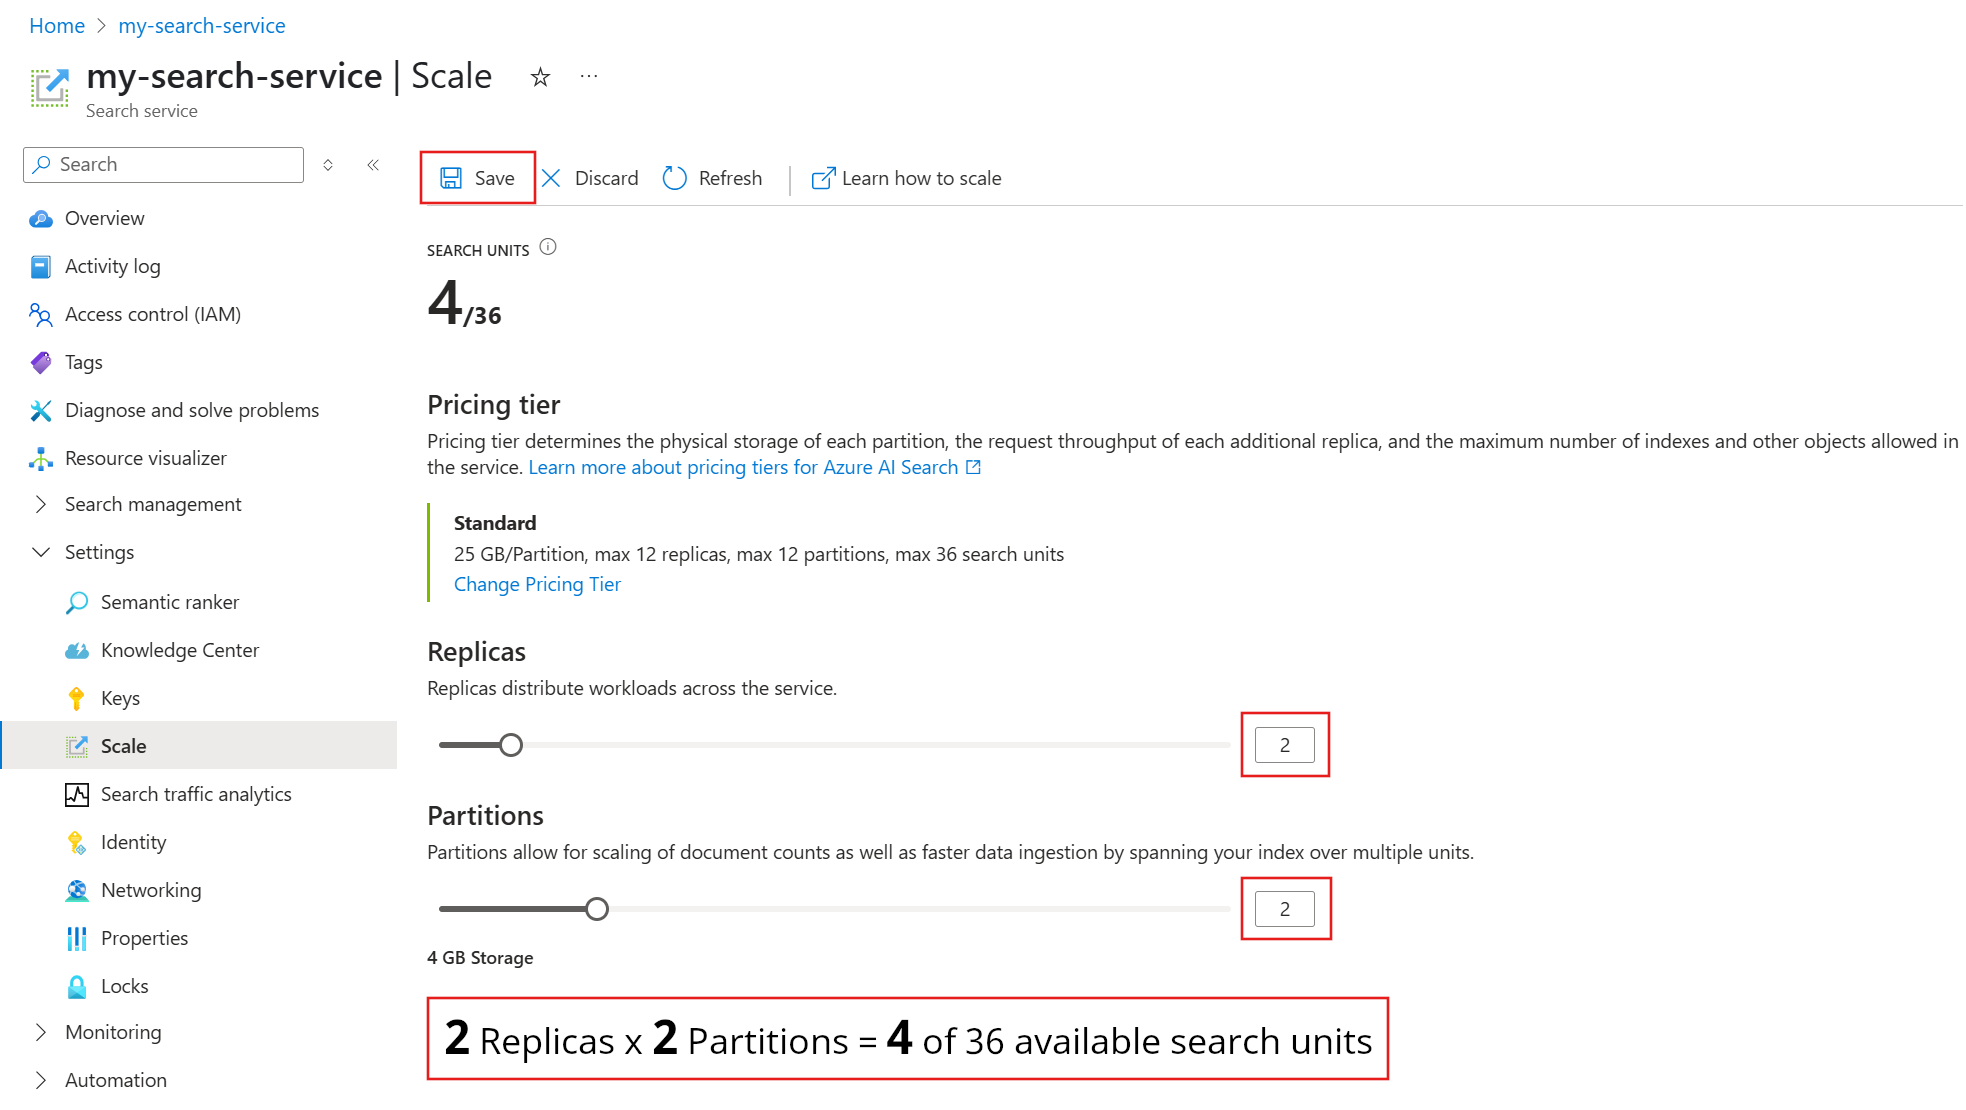
Använd skjutreglaget för att öka eller minska antalet partitioner och välj sedan Spara.
Det här exemplet lägger till en andra replik och partition. Notera antalet sökenheter. Det är nu fyra eftersom faktureringsformeln är replikerna multiplicerade med partitionerna (2 x 2). En fördubbling av kapaciteten mer än fördubblar kostnaden för att köra tjänsten. Om kostnaden för sökenheten var 100 USD skulle den nya månadsfakturan nu vara 400 USD.
För de aktuella enhetskostnaderna för varje nivå går du till prissidan.
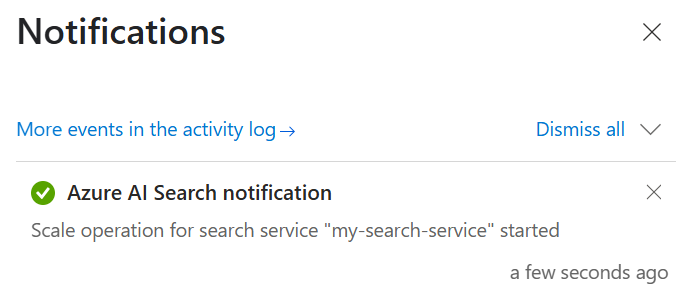
Kontrollera dina meddelanden för att bekräfta att åtgärden startade.
Den här åtgärden kan ta flera timmar att slutföra. Den förekommer i bakgrunden, så söktjänsten förblir fullt fungerande och tillgänglig för läs- och skrivåtgärder.
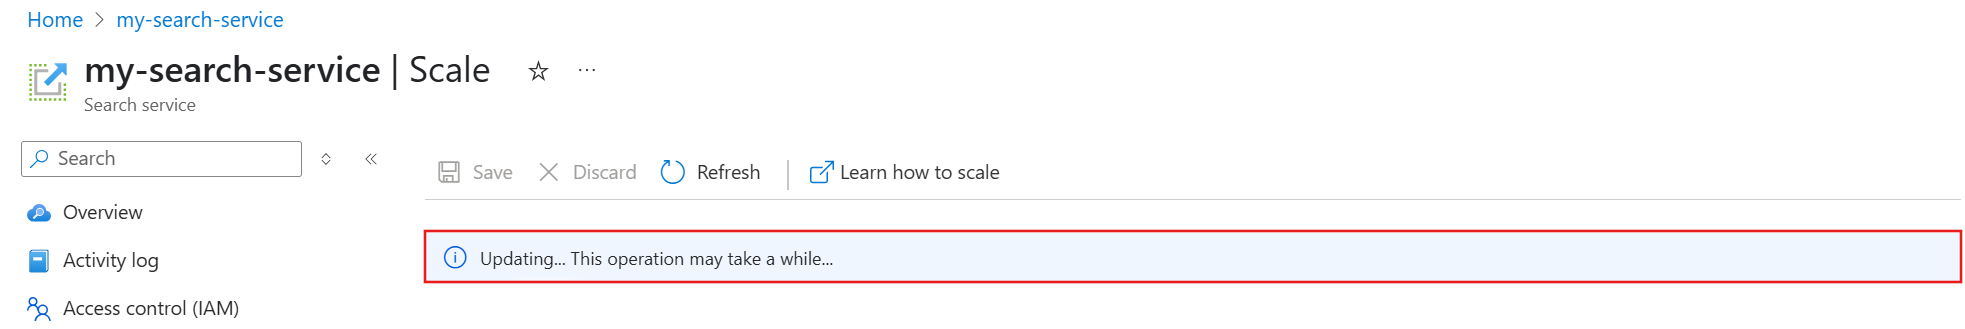
Du kan inte avbryta åtgärden eller övervaka dess förlopp. Följande meddelande visas dock när ändringar pågår.
Ändra prisnivå
Anteckning
Azure-portalen och Services – Update (REST API) stöder ändringar mellan nivåerna Basic och Standard (S1, S2 och S3). Du kan uppgradera eller nedgradera nivåer, förutsatt att den aktuella tjänstkonfigurationen inte överskrider gränserna för målnivån. Din region kan inte heller ha kapacitetsbegränsningar på målnivån.
Prisnivån avgör den maximala lagringen av söktjänsten för den dedikerade prismodellen. Om du behöver mer eller mindre kapacitet kan du byta till en annan prisnivå som passar dina lagringsbehov. (Detta gäller endast för de dedikerade prismodellnivåerna. Nivån Serverlös modellutvecklare kan inte ändras när den har valts).
Förutom kapacitet fastställer prisnivåerna gränser för index, indexerare och andra sökobjekt. Jämför tjänstgränserna för den aktuella nivån och önskad nivå innan du fortsätter. Att växla till en högre nivå ökar vanligtvis lagringsgränsen och vektorgränsen, ökar dataflödet för begäranden och minskar svarstiden, medan byte till en lägre nivå har motsatt effekt.
Om du byter till en högre prisnivå ökar också kostnaden för att köra söktjänsten. Mer information finns på prissidan.
Så här ändrar du prisnivån:
Gå till söktjänsten i Azure-portalen.
I den vänstra rutan väljer du Skalning av inställningar>.
Under den aktuella nivån väljer du Ändra prisnivå.
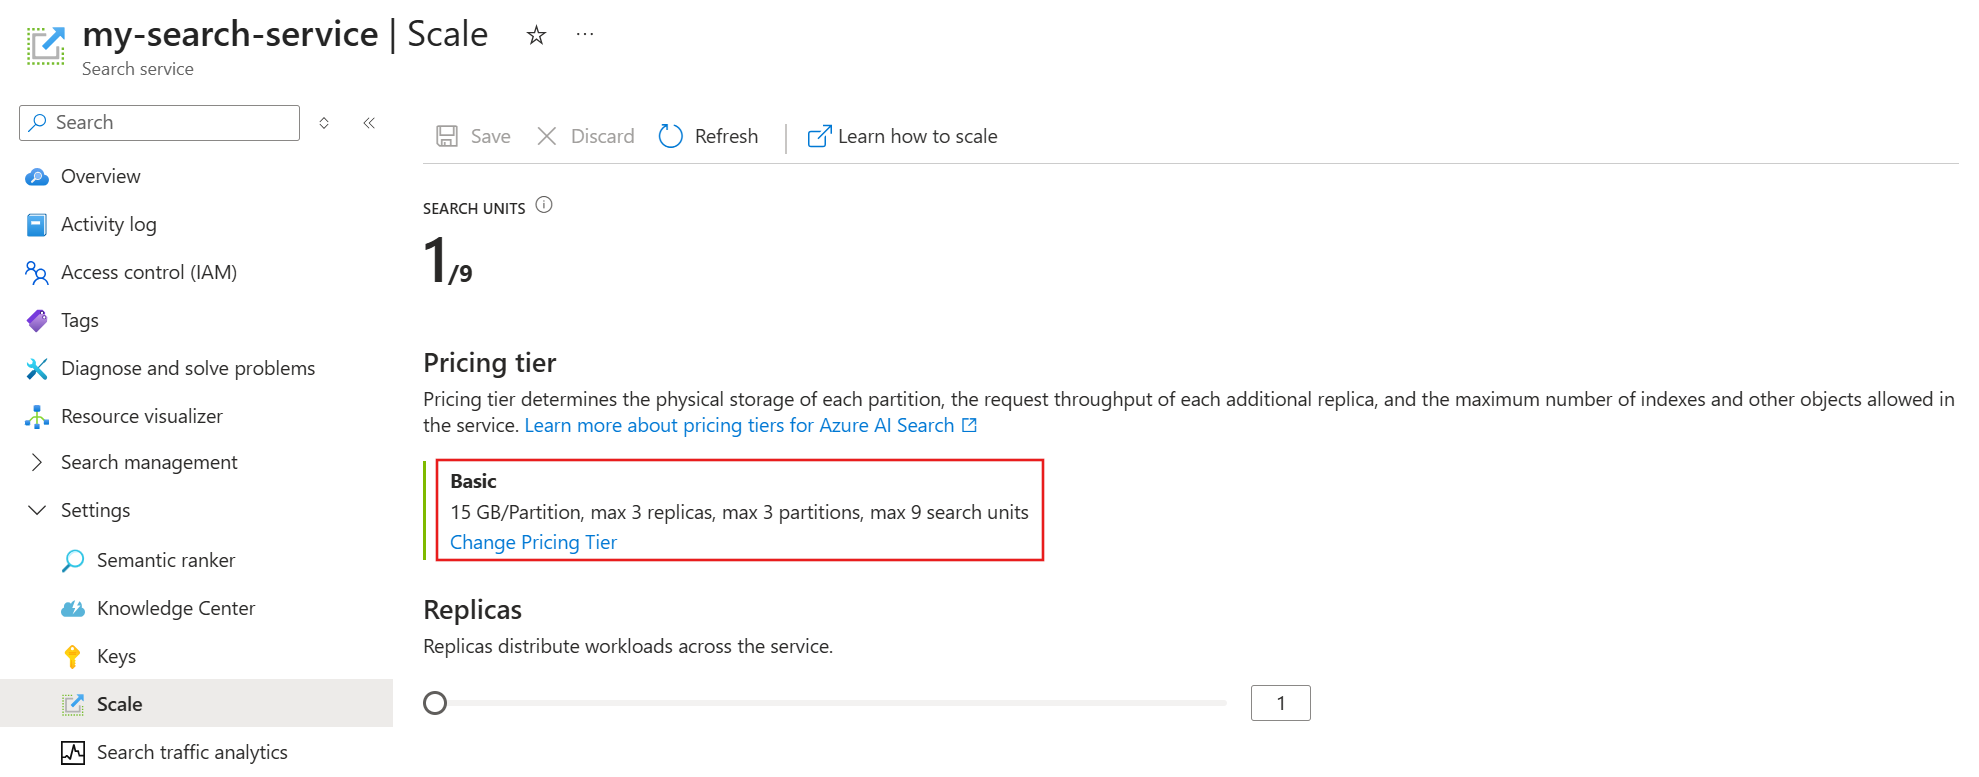
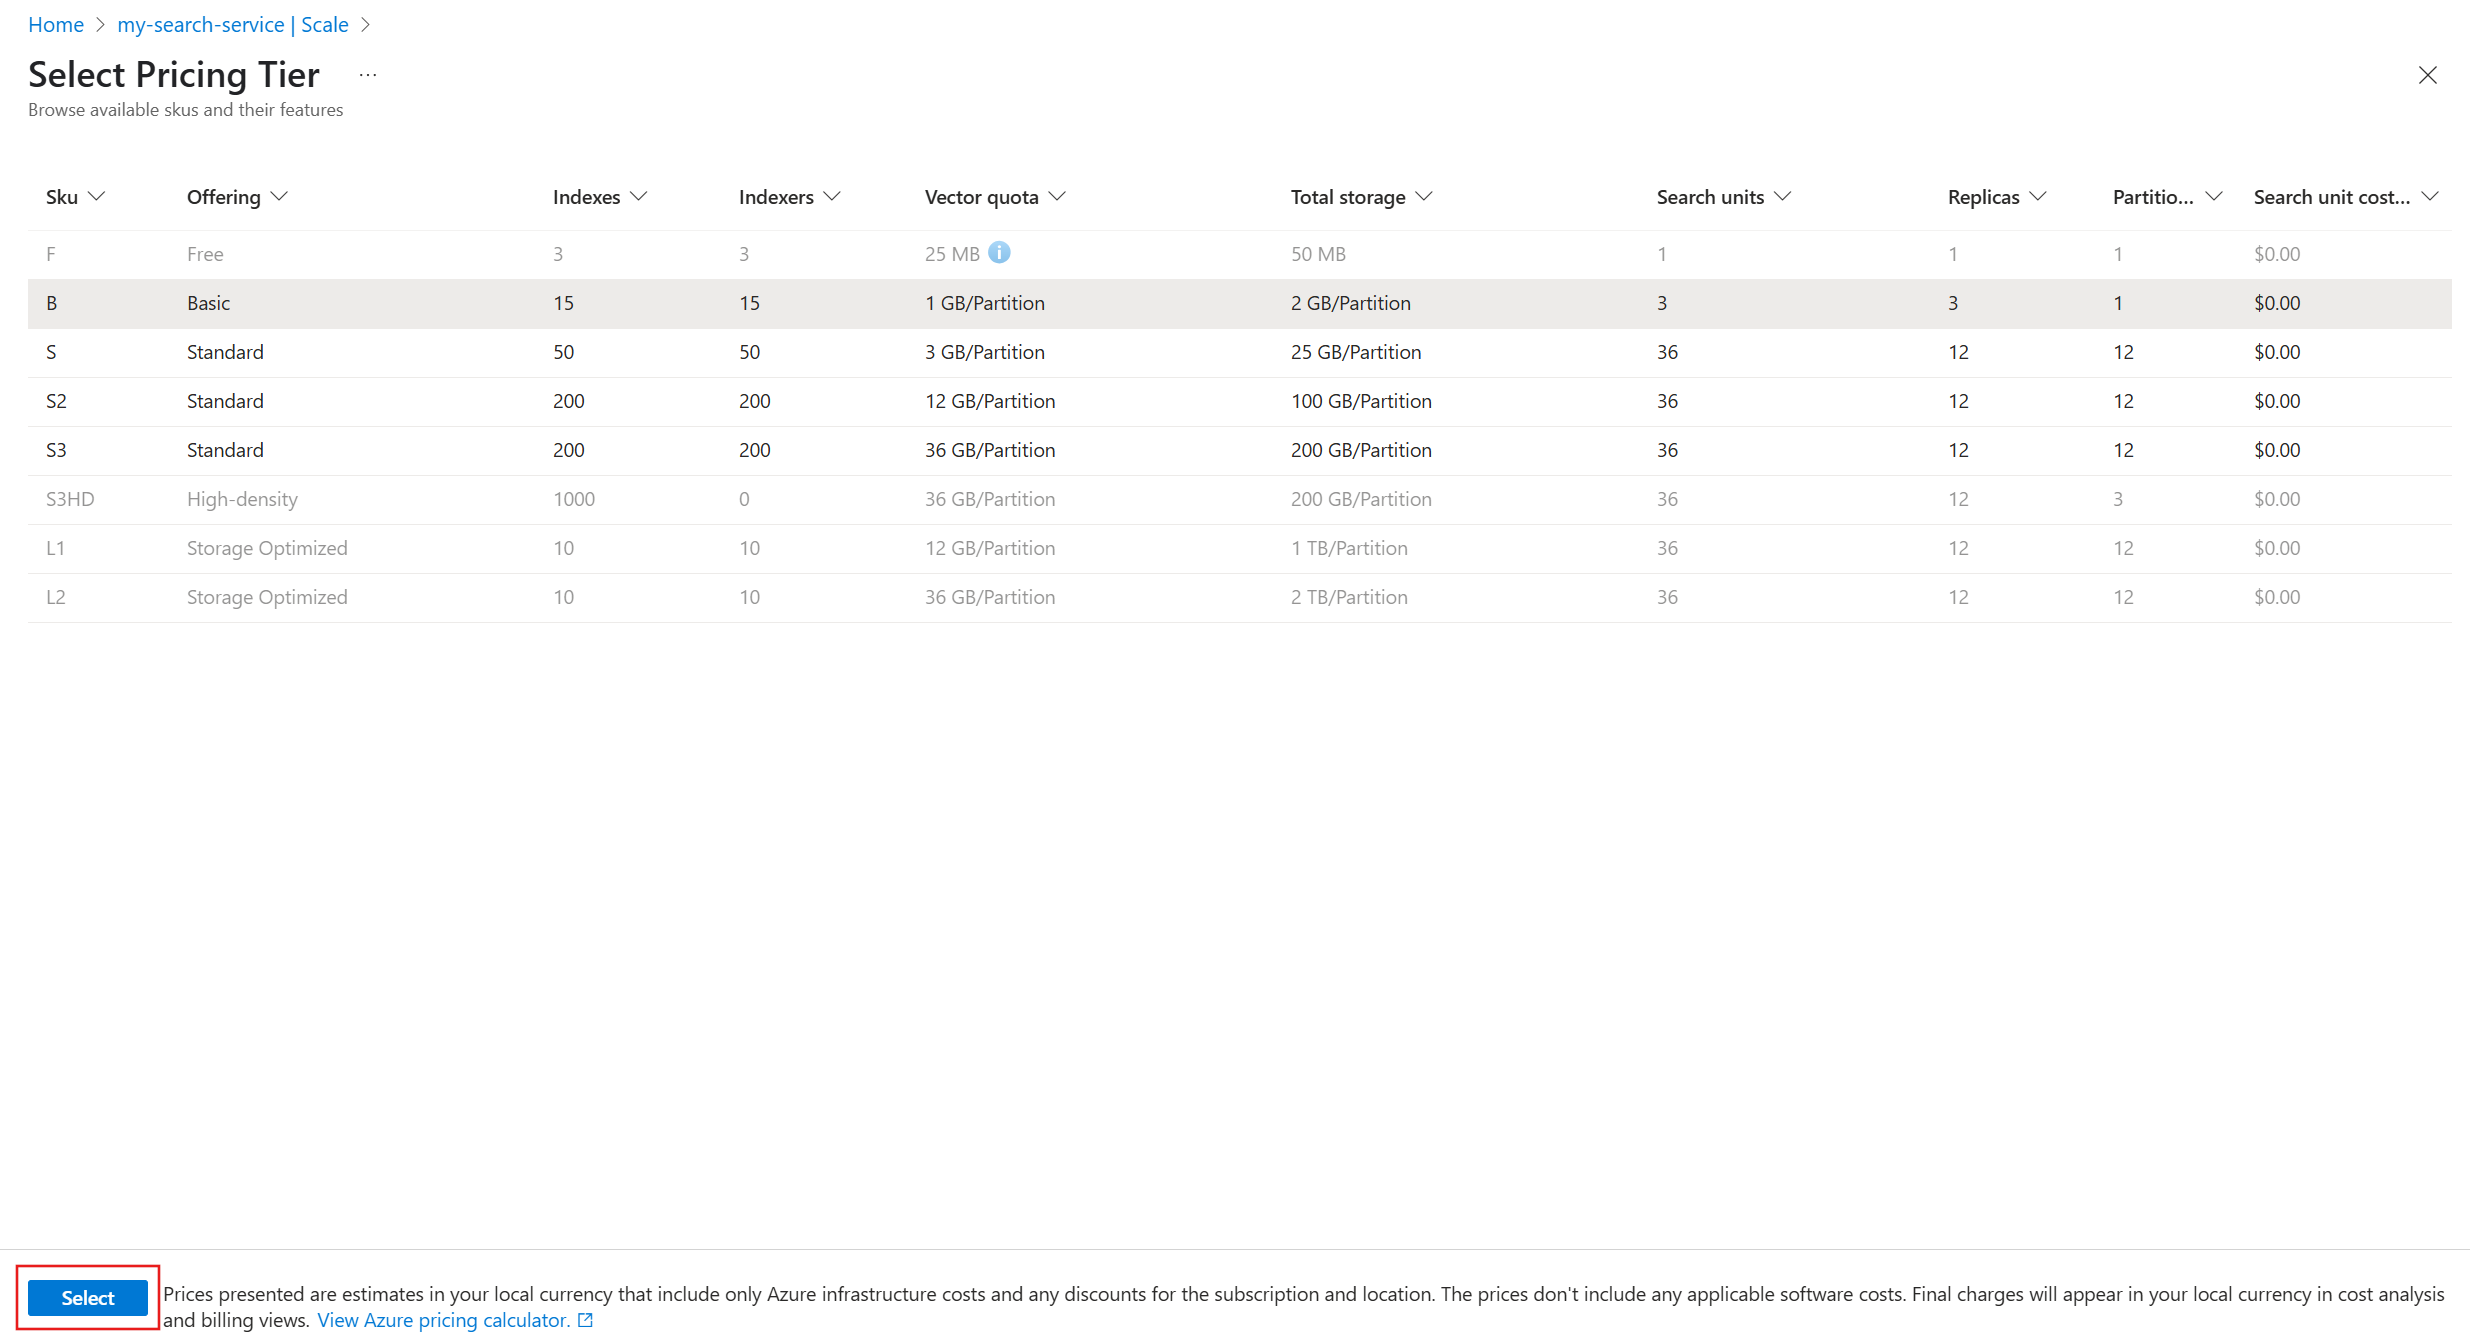
På sidan Välj prisnivå väljer du en annan nivå i listan.
Du kan växla mellan Basic, S1, S2 och S3, men du kan inte växla till eller från Kostnadsfri, S3HD, L1 eller L2. Dessa nivåer kan inte väljas och visas nedtonade.
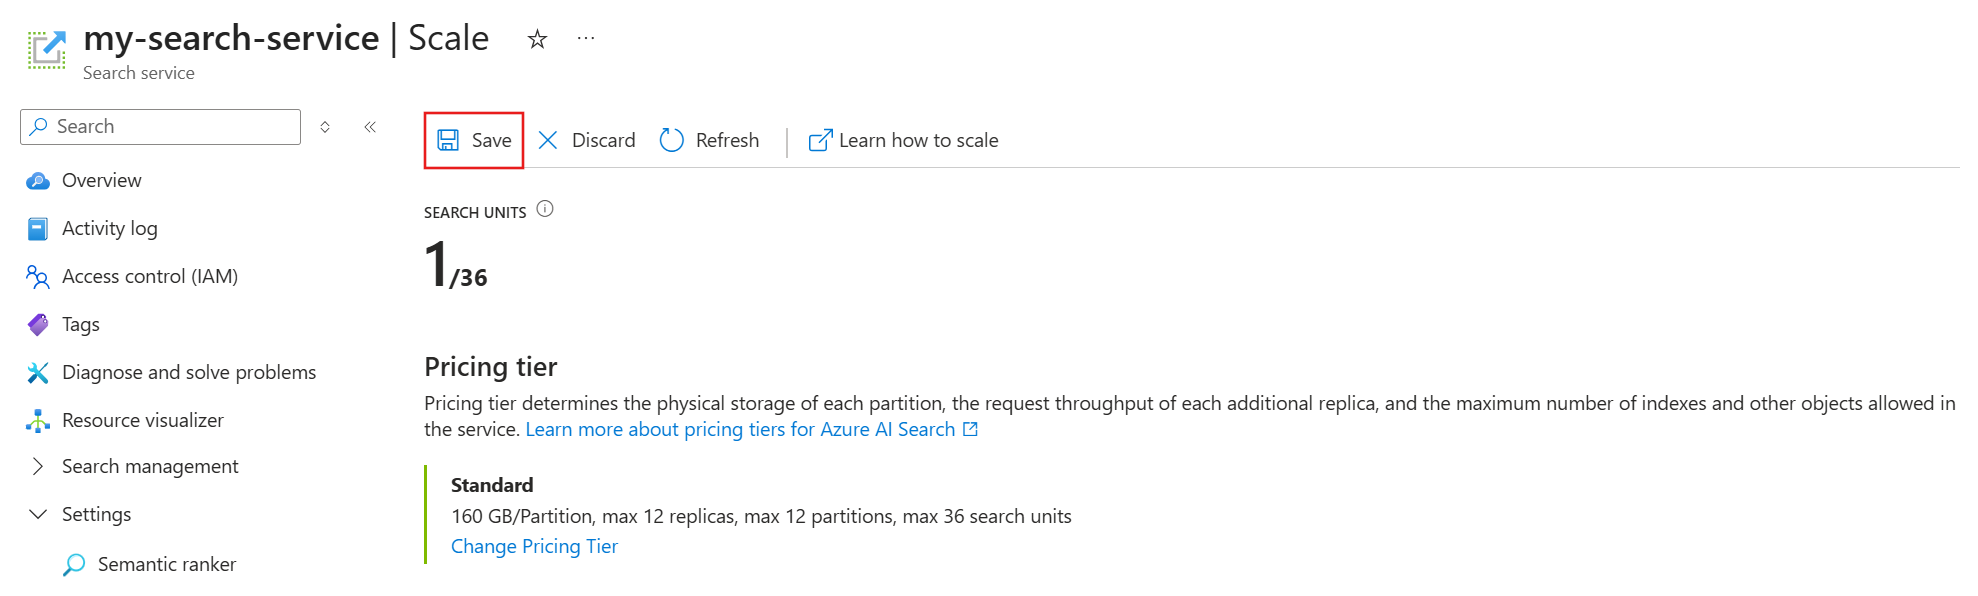
Starta skalningsåtgärden genom att välja Spara.
Den här åtgärden kan ta flera timmar att slutföra. Den förekommer i bakgrunden, så söktjänsten förblir fullt fungerande och tillgänglig för läs- och skrivåtgärder.
Du kan inte avbryta åtgärden eller övervaka dess förlopp. Följande meddelande visas dock när ändringar pågår.
Så här hanteras skalningsbegäranden för den dedikerade modellen
När söktjänsten tar emot en skalningsbegäran:
- Kontrollerar om begäran är giltig.
- Börjar säkerhetskopiera data och systeminformation.
- Kontrollerar om tjänsten redan är i levereringstillstånd (för närvarande lägger till eller eliminerar antingen repliker eller partitioner).
- Startar provisionering.
Det kan ta flera minuter till flera timmar att skala en tjänst, beroende på tjänstens storlek och begärans omfattning. Säkerhetskopieringens varaktighet varierar också beroende på mängden data och antalet partitioner och repliker.
Stegen för att hantera en skalningsbegäran är inte helt i följd. Systemet börjar till exempel tilldela resurser när det kan göra det på ett säkert sätt, vilket kan vara när säkerhetskopieringen avslutas.
Fel vid skalning
I följande tabell visas orsaker och lösningar för fel som kan uppstå under skalningsåtgärder.
| Felmeddelande | Orsak | Lösning |
|---|---|---|
| "Tjänstuppdateringsåtgärder tillåts inte just nu eftersom vi bearbetar en tidigare begäran." | En annan skalningsåtgärd pågår. | Kontrollera sidan Overview i Azure-portalen eller använd rest-API:et Search Management, Azure PowerShell eller Azure CLI för att hämta status för söktjänsten. Om statusen är "Etablering" väntar du tills den blir "Lyckades" eller "Misslyckades" innan du försöker igen. 1, 2 |
| "Det gick inte att skala söktjänstens tjänstnamn. Fel: objektantalet ActualCount överskrider den tillåtna gränsen: MaximumCount. | Den aktuella tjänstkonfigurationen överskrider gränserna för målprisnivån. | Kontrollera att din lagringsanvändning, vektoranvändning, index, indexerare och andra objekt passar inom den lägre nivåns tjänstgränser. Basic-nivån stöder till exempel upp till 15 index, så du kan inte växla från S1 till Basic om du har 16 index. Justera dina resurser innan du försöker igen. |
1 Det finns ingen status för säkerhetskopieringar, vilket är interna åtgärder som sannolikt inte kommer att störa en skalningsövning.
2 Om söktjänsten verkar vara stoppad i ett tillstånd för etablering, kontrollera om det finns oanvändbara restindex med noll frågevolymer och inga indexuppdateringar. Ett oanvändbart index kan blockera ändringar i tjänstkapaciteten. Leta särskilt efter CMK-krypterade index vars nycklar inte längre är giltiga. Ta antingen bort indexet eller återställ nycklarna så att indexet är online igen och avblockera skalningsåtgärden.
Kombinationer av partitioner och repliker
Följande diagram gäller för standardnivån och högre. Den visar alla möjliga kombinationer av partitioner och repliker, med högst 36 sökenheter per tjänst.
| 1 partition | 2 partitioner | 3 partitioner | 4 partitioner | 6 partitioner | 12 partitioner | |
|---|---|---|---|---|---|---|
| 1 replika | 1 SU | 2 SU | 3 SU | 4 SU | 6 SU | 12 SU |
| 2 repliker | 2 SU | 4 SU | 6 SU | 8 SU | 12 SU | 24 SU |
| 3 repliker | 3 SU | 6 SU | 9 SU | 12 SU | 18 SU | 36 SU |
| 4 repliker | 4 SU | 8 SU | 12 SU | 16 SU | 24 SU | Ej tillämpligt |
| 5 repliker | 5 SU | 10 SU | 15 SU | 20 SU | 30 SU | Ej tillämpligt |
| 6 repliker | 6 SU | 12 SU | 18 SU | 24 SU | 36 SU | Ej tillämpligt |
| 12 repliker | 12 SU | 24 SU | 36 SU | Ej tillämpligt | Ej tillämpligt | Ej tillämpligt |
Grundläggande söktjänster har lägre antal sökenheter.
På söktjänster som skapats före den 3 april 2024 kan Basic-tjänster ha exakt en partition och upp till tre repliker för en maximal gräns på tre SU:er. Den enda justerbara resursen är repliker. Du kan dock öka antalet partitioner genom att uppgradera tjänsten.
På söktjänster som skapats efter den 3 april 2024 i regioner som stöds kan Basic-tjänster ha upp till tre partitioner och tre repliker. Den maximala SU-gränsen är nio för att stödja ett fullständigt komplement av partitioner och repliker.
För söktjänster på valfri fakturerbar nivå, oavsett skapandedatum, behöver du minst två repliker för hög tillgänglighet vid sökningar.
Faktureringspriser per nivå och valuta finns på prissättningssidan för Azure AI-sökning.
Beräkna kapacitet med hjälp av en dedikerad prismodellnivå
Dina lagringsbehov beror på storleken på de index som du förväntar dig att skapa. Det finns inga solida heuristiker eller allmänna riktlinjer som hjälper till med uppskattningar. Det enda sättet att fastställa storleken på ett index är att skapa ett. Storleken beror på tokenisering och inbäddningar, och om du aktiverar förslagsgivare, filtrering och sortering eller kan dra nytta av vektorkomprimering.
Uppskatta kapaciteten på en fakturerbar nivå, Basic eller högre. Den kostnadsfria nivån körs på fysiska resurser som delas av flera kunder och omfattas av faktorer som ligger utanför din kontroll. Endast de dedikerade resurserna för en fakturerbar söktjänst kan hantera större samplings- och bearbetningstider för mer realistiska uppskattningar av indexkvantitet, storlek och frågevolymer under utvecklingen.
Granska tjänstbegränsningarna på varje nivå för att avgöra om lägre nivåer kan stödja det antal index du behöver. Fundera på om du behöver flera kopior av ett index för aktiv utveckling, testning och produktion.
En söktjänst omfattas av objektgränser (maximalt antal index, indexerare, kompetensuppsättningar och så vidare) och lagringsgränser. Den gräns som uppnås först är den effektiva gränsen.
Skapa en tjänst på en fakturerbar nivå. Nivåerna är optimerade för vissa arbetsbelastningar. Nivån Lagringsoptimerad har till exempel en gräns på 10 index eftersom den är utformad för att stödja ett lågt antal stora index.
Börja lågt, på Basic eller S1, om du inte är säker på den planerade belastningen.
Börja högt, på S2 eller till och med S3, om testningen omfattar storskalig indexering och frågebelastningar.
Börja med Lagringsoptimerad, vid L1 eller L2, om du indexerar en stor mängd data och frågebelastningen är relativt låg, som med ett internt affärsprogram.
Skapa ett första index för att avgöra hur källdata översätts till ett index. Det här är det enda sättet att beräkna indexstorleken. Attribut för fältdefinitionerna påverkar fysiska lagringskrav:
För nyckelordssökning ökar indexstorleken genom att markera fält som filterbara och sorterbara.
För vektorsökning kan du ange parametrar för att minska vektorstorleken.
Övervaka lagring, tjänstgränser, frågevolym och svarstid i Azure portalen. I Azure portalen visas frågor per sekund, begränsade frågor och svarstid för sökning. Dessa värden kan hjälpa dig att avgöra om du har valt rätt nivå.
Lägg till repliker för att öka tillgängligheten eller förbättra svarstiden för långsamma frågor.
Det finns inga riktlinjer för hur många repliker som behövs för att hantera frågebelastningar. Frågeprestanda beror på frågans komplexitet och konkurrerande arbetsbelastningar. Även om tillägg av repliker tydligt ger bättre prestanda, är resultatet inte strikt linjärt: att lägga till tre repliker garanterar inte tredubbel genomströmning. Information om hur du beräknar QPS för din lösning finns i Analysera prestanda och Övervaka frågor.
För ett inverterat index bestäms storlek och komplexitet av innehåll, inte nödvändigtvis av mängden data som du matar in i det. En stor datakälla med hög redundans kan resultera i ett mindre index än en mindre datauppsättning som innehåller mycket variabelt innehåll. Därför är det sällan möjligt att härleda indexstorlek baserat på storleken på den ursprungliga datamängden.
Lagringskraven kan blåsas upp om du inkluderar data som du aldrig söker efter. Helst innehåller dokument endast de data som du behöver för sökupplevelsen.
Överväganden för serviceavtal
Serviceavtal (SLA) täcker inte funktionerna på den kostnadsfria nivån och förhandsversionen. För alla fakturerbara nivåer träder serviceavtal i kraft när du etablerar tillräcklig redundans för din tjänst.
Två eller flera repliker uppfyller SLA:er för frågor (läsning).
Tre eller fler repliker uppfyller SLA:erna för sökfrågor och indexering (läsa och skriva).
Antalet partitioner påverkar inte serviceavtal.
Optimera kostnaden för den serverlösa modellen
I prismodellen Serverlös:
- Tjänsten hanterar automatiskt kapacitet.
- Du behöver inte konfigurera repliker, partitioner eller sökenheter.
- Beräkning skalar dynamiskt baserat på arbetsbelastningen (fråge- och indexeringsefterfrågan) och kan skalas till noll när den är inaktiv.
Mer information om begränsningar för den serverlösa modellen finns i Tjänstbegränsningar.
Faktureringen baseras på två dimensioner:
- Beräkningsanvändning (CUS): Debiteras baserat på fråge- och indexeringsåtgärder.
- Indexerad lagring: Debiteras per GB per månad.
Eftersom faktureringen är förbrukningsbaserad är kostnaden direkt kopplad till användning:
- Komplexa frågor förbrukar mer beräkning.
- Ineffektiv schemadesign ökar både indexerings- och frågekostnader.
- Dåliga frågemönster med stora eller ofta uppdaterade index ökar lagrings- och beräkningsanvändningen.
Optimera arbetsbelastningens effektivitet
Eftersom ineffektiviteten visas som kostnad i den serverlösa modellen betalar du mer för samma arbete om du inte tränar arbetsbelastningsmedveten design. Det bästa sättet att styra serverlösa utgifter är att utforma dina index och frågor effektivt från början.
Om du vill utforma arbetsbelastningar för effektivitet när du använder den serverlösa prismodellen bör du tänka på följande:
Indexdesign
- Inkludera endast fält som används i frågor.
- Minska vektordimensioner där det är möjligt.
- Undvik onödiga filterbara, sorterbara eller fasettbara attribut.
Frågemönster
- Använd
$selectför att begränsa returnerade fält. - Använd filter tidigt för att minska resultatuppsättningar.
- Undvik djup paginering (
$skip). - Föredra riktade frågor framför breda fulltextfrågor.
- Använd hybridsökning noggrant på grund av högre beräkningskostnad.
Monitoring
- Övervaka CU-förbrukningen för att identifiera dyra frågor.
- Spåra lagringstillväxt och ta bort oanvända data.
I Serverlös minskar prestandan (snabbare och mer riktade frågor) vanligtvis kostnaden.
Om du vill veta mer, se Optimera kostnaderna med den serverlösa prismodellen i Azure AI-sökning.
Överväganden för regional kapacitet
Kapacitet och tillgänglighet kan variera beroende på vilken region som stöds. Vissa regioner kan ha begränsningar för etablering av nya tjänster eller skalning av befintliga.
Anteckning
Under den offentliga förhandsversionen är prismodellen Serverlös endast tillgänglig i specifika regioner.
Om din önskade Azure AI-sökning region inte är tillgänglig på grund av kapacitetsbegränsningar kan du läsa Så här hanterar du regionala kapacitetsbegränsningar i Azure AI-sökning.