重要
此功能目前以公共预览版提供。
本页介绍什么是异常情况检测、它监视的内容以及如何使用它。
重要
异常情况检测使用 默认存储 将扫描结果 system.data_quality_monitoring.table_results 存储在系统表中。 您不会因为此存储而被收费。
什么是异常情况检测?
通过异常情况检测,可以监视架构中所有表的数据质量。 通过分析历史模式,Azure Databricks会自动评估每个表的完整性和新鲜度。 结果在目录资源管理器中可用。
要求
- 已启用 Unity Catalog 的工作区。
- 无服务器计算 必须在工作区中可用(默认情况下在具有 Unity 目录的工作区中启用)。
- 若要对架构启用异常情况检测,必须对架构或父目录具有
MANAGE特权。 - 若要查看表的健康指标状态,需要 SELECT 或 BROWSE 权限。
异常情况检测的工作原理是什么?
Azure Databricks创建一个后台作业,用于监视表的新鲜度和完整性。
新鲜度 是指最近更新表的方式。 数据质量监视可分析对表的提交历史记录,并生成每表模型来预测下一次提交的时间。 如果提交异常迟到,表将标记为过时。
完整性 是指预期在过去 24 小时内写入表的行数。 数据质量监视可分析历史行计数,并根据此数据预测一系列预期的行数。 如果过去 24 小时内提交的行数小于此范围的下限,则表将标记为不完整。
Azure Databricks使用智能扫描来自动化调节表扫描频率。 智能扫描根据受欢迎程度和下游使用情况确定高影响表,并降低不太关键表的频率。 若要手动排除表,请使用“创建监视器”或“更新监视器 API”并在参数中指定排除的 excluded_table_full_names 表。 有关详细信息,请参阅 API 文档。
异常情况检测 不会 修改它监视的任何表,也不会为填充这些表的任何作业增加开销。
注释
事件新鲜度基于事件时间列和引入延迟,仅适用于数据质量监视 beta 版本的用户。 在当前版本中,不支持事件的最新性。
百分比 null 用于完整性
重要
此功能在 Beta 版中。 工作区管理员可以从 预览 页控制对此功能的访问。 请参阅 Manage Azure Databricks 预览版。
百分比 null 向完整性添加了额外的质量细节。 百分比 null 是过去 24 小时内写入表的行中,给定列预期为 null 值的行的百分比。 数据质量监视可分析每列的历史趋势,并基于此数据预测范围。 如果过去 24 小时内某列的百分比高于此范围的上限,则表将标记为不完整。
完整性切片
重要
此功能在 Beta 版中。 工作区管理员可以从 预览 页控制对此功能的访问。 请参阅 Manage Azure Databricks 预览版。
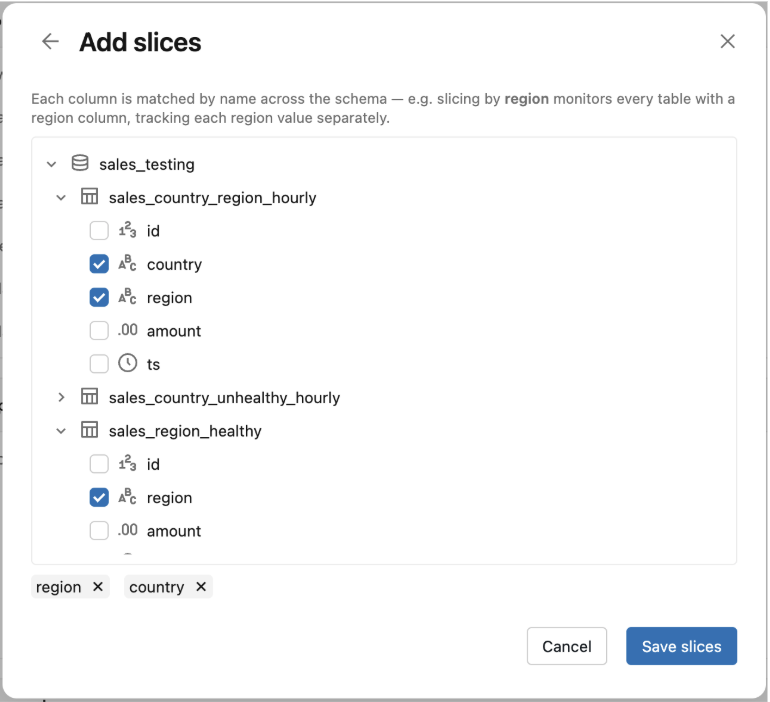
完整性切片在现有的表级检查基础上,新增了针对表内各组的完整性检查。 异常检测通过指定列将表分组,并分别评估该列的不同值的完整性。 例如,通过一 region 列切割会为每个区域产生独立的完备性结果,如 AMER、 APAC和 EMEA。 如果任何片不完整,该表将被标记为不健康。
一个架构最多可以有三个切片列,并且每个切片列都是独立切片的(不会合并为一个分组)。 你在对某个模式启用异常检测时配置 切片,并且该配置会应用于该模式中的每个表。
注释
异常检测仅在切片列有50个或更少不同值时评估该列的完备性。 如果某一列有超过50个不同的值,或者某个表没有该列,则该表会被整体监控。
Cost
异常检测在 无服务器计算 上运行,并归入 DATA_QUALITY_MONITORING 计费产品,按无服务器 DBU 计费。 成本随着架构中监视的表的数量和大小而变化。 智能扫描通过确定重要表的优先级并跳过低影响表来帮助控制成本。
若要查看和跟踪异常情况检测费用,请参阅 异常情况检测费用。
启用异常情况检测
可以在单个架构或目录级别的多个架构上启用异常情况检测。
对模式启用异常检测
若要对架构启用异常情况检测,请导航到 Unity 目录中的架构。
在架构页上,单击“ 详细信息 ”选项卡。
对于 数据质量监视,请单击“ 启用”。
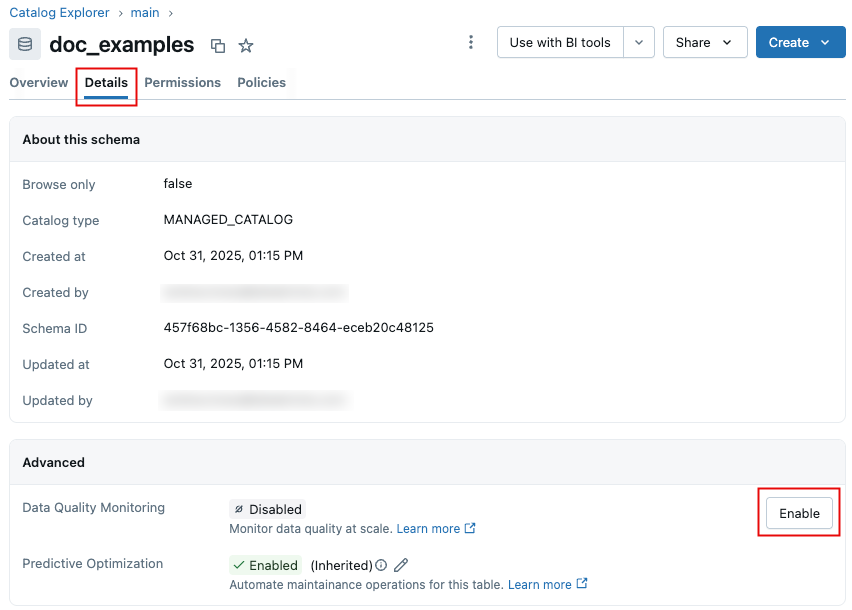
在 “数据质量监视 ”对话框中,确保 打开异常情况检测 ,然后单击“ 保存”。
扫描已启动。 Azure Databricks 会按照每个表的更新频率自动扫描该表,无需为每个表进行手动配置即可提供最新洞察。
扫描完成后,可以通过以下方式查看表的异常情况检测结果:
- 架构中每个表的健康指标会在目录资源管理器中显示。 请参阅 健康指标。
- 在启用了数据质量监视的架构的“详细信息”选项卡上,单击“查看结果”,然后在“数据质量监视”中查看结果。 请参阅 在 UI 中查看数据质量监视结果。
- 检测到的质量问题记录在输出系统表中。 请参阅 “查看异常情况检测”记录的结果。
为目录启用异常检测
可以从目录中同时对多个架构启用异常情况检测。 转到 Unity Catalog 中的目录。
在目录页上,单击“ 详细信息 ”选项卡。
对于 数据质量监视,请单击“ 启用”。
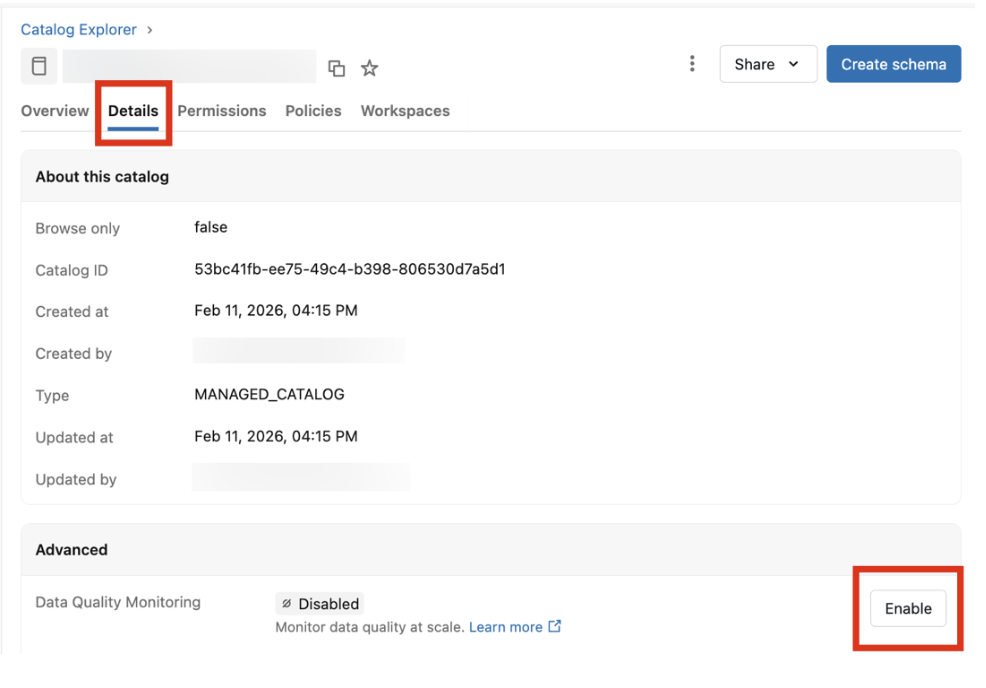
在 “数据质量监视 ”对话框中,选择要监视的架构,然后单击“ 保存”。
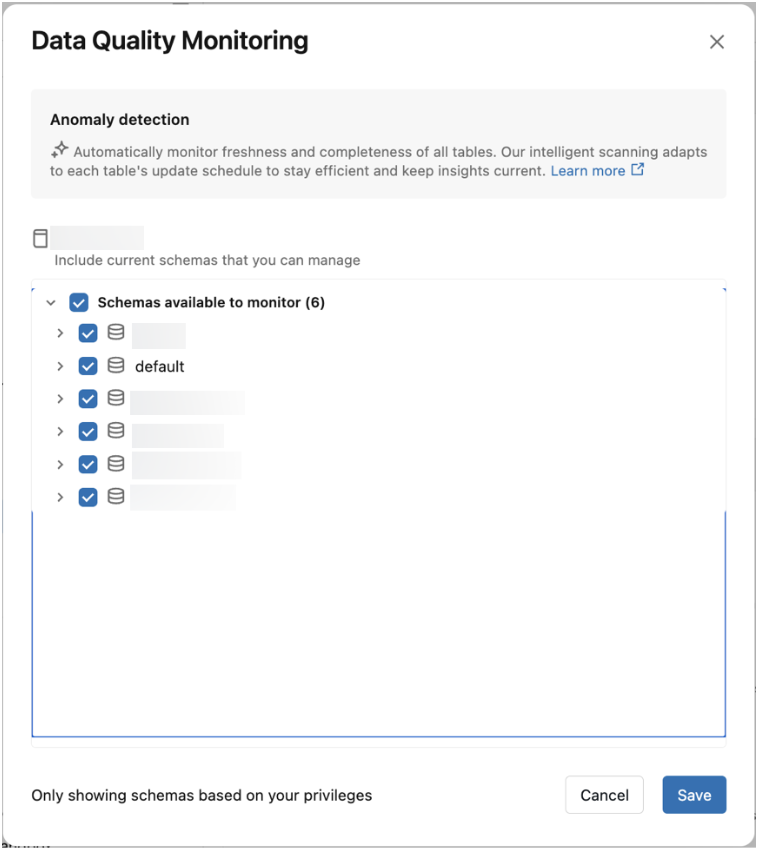
注释
一次最多可以启用 50 个架构。 选中顶级复选框以启用当前可用于监视的所有架构。 这不会启用将来添加到目录中的架构。
你只能看到该目录中你是其所有者或拥有
MANAGE特权的架构。Azure Databricks 会为每个已启用的架构启动扫描,并按照每个表的更新频率自动扫描各个表,无需为每个表手动进行配置。
扫描完成后,可以使用 在架构上启用异常情况检测中所述的任何方法查看异常情况检测结果。
禁用异常情况检测
若要禁用异常情况检测,请执行:
单击铅笔图标。
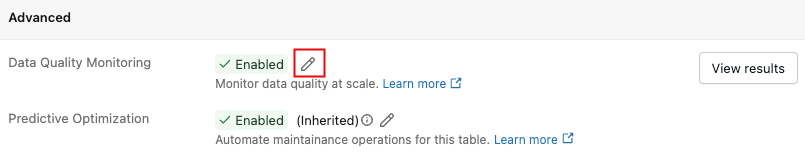
在数据质量监视对话框中,单击切换开关。
重要
禁用异常情况检测时,将删除异常情况检测作业和所有异常情况检测表和信息。 此操作不可撤消。
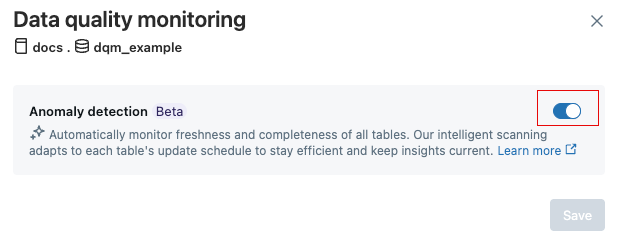
单击“ 保存”。
若要一次性禁用多个架构的异常情况检测,请从“目录详细信息”选项卡中打开“数据质量监视”对话框,清除不再需要监视的架构,然后单击“保存”。
其他配置
配置完整性切分
重要
此功能在 Beta 版中。 工作区管理员可以从 预览 页控制对此功能的访问。 请参阅 Manage Azure Databricks 预览版。
为某个模式在数据质量监控对话框中配置完整度切片:
在 “逐片监控”下,点击 添加切片。
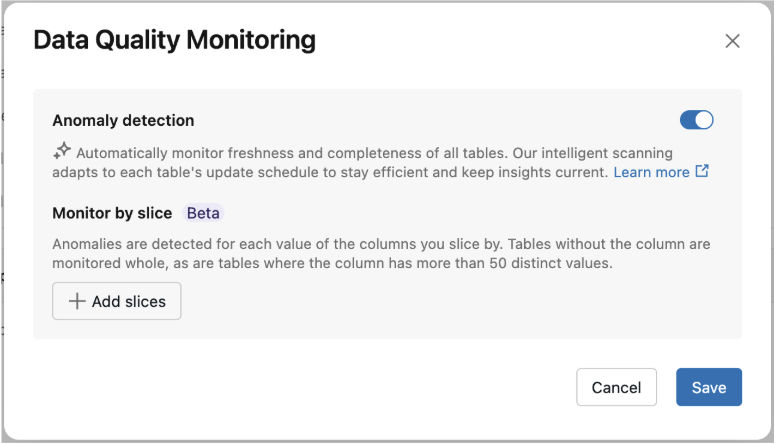
在 “添加切片 ”面板中,选择最多三列进行切片,然后点击 “保存切片”。
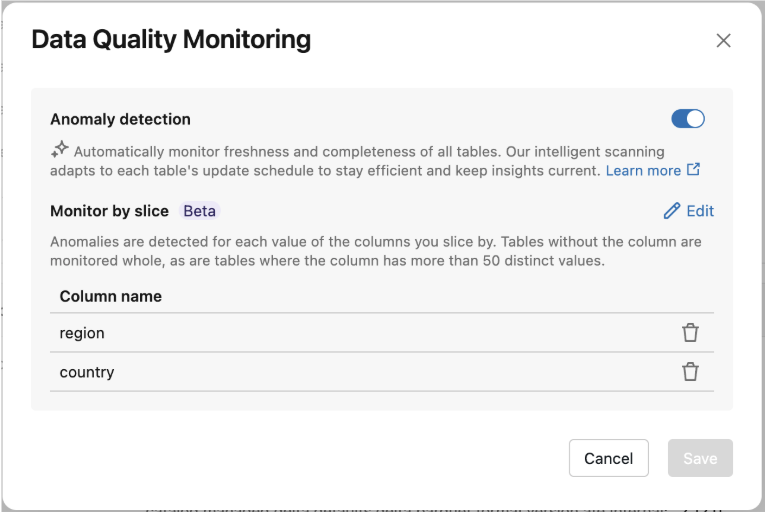
单击“ 保存”。 选中的列会显示在 Monitor by slice 下。 要稍后更改,请点击 编辑。
健康指标
在架构上启用异常情况检测后,运行状况指示器会显示在目录资源管理器的架构和表概述页上。 健康指标显示数据消费者和业务用户的表格健康状况摘要,而无需他们导航到 数据质量监视 UI。 用户需要 SELECT 或 BROWSE 权限才能查看健康指示器状态。
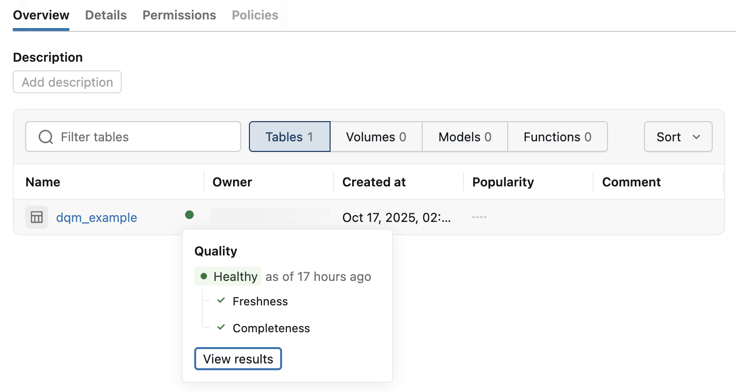
下表描述了每个健康指标状态:
| 地位 | 说明 |
|---|---|
| 正常 | 最近的扫描中所有的异常检测都通过了。 |
| 不正常 | 一个或多个检查检测到异常,例如新鲜度或完整性问题。 |
| 训练 | 异常检测是利用历史数据建立基线模型。 新监视的表会显示此状态,直到模型有足够的数据来评估质量。 |
| Error | 在监视此表时,异常检测遇到了错误。 |
| 排除 | 明确将该表排除在异常检测之外。 |
| 未启用 | 在包含此表的架构上未启用异常情况检测。 |
注释
如果表在初始扫描期间被跳过,智能扫描可能会将某些表的健康指示器填充延迟最多两周。 在下次计划的重新扫描中将更新健康指标。
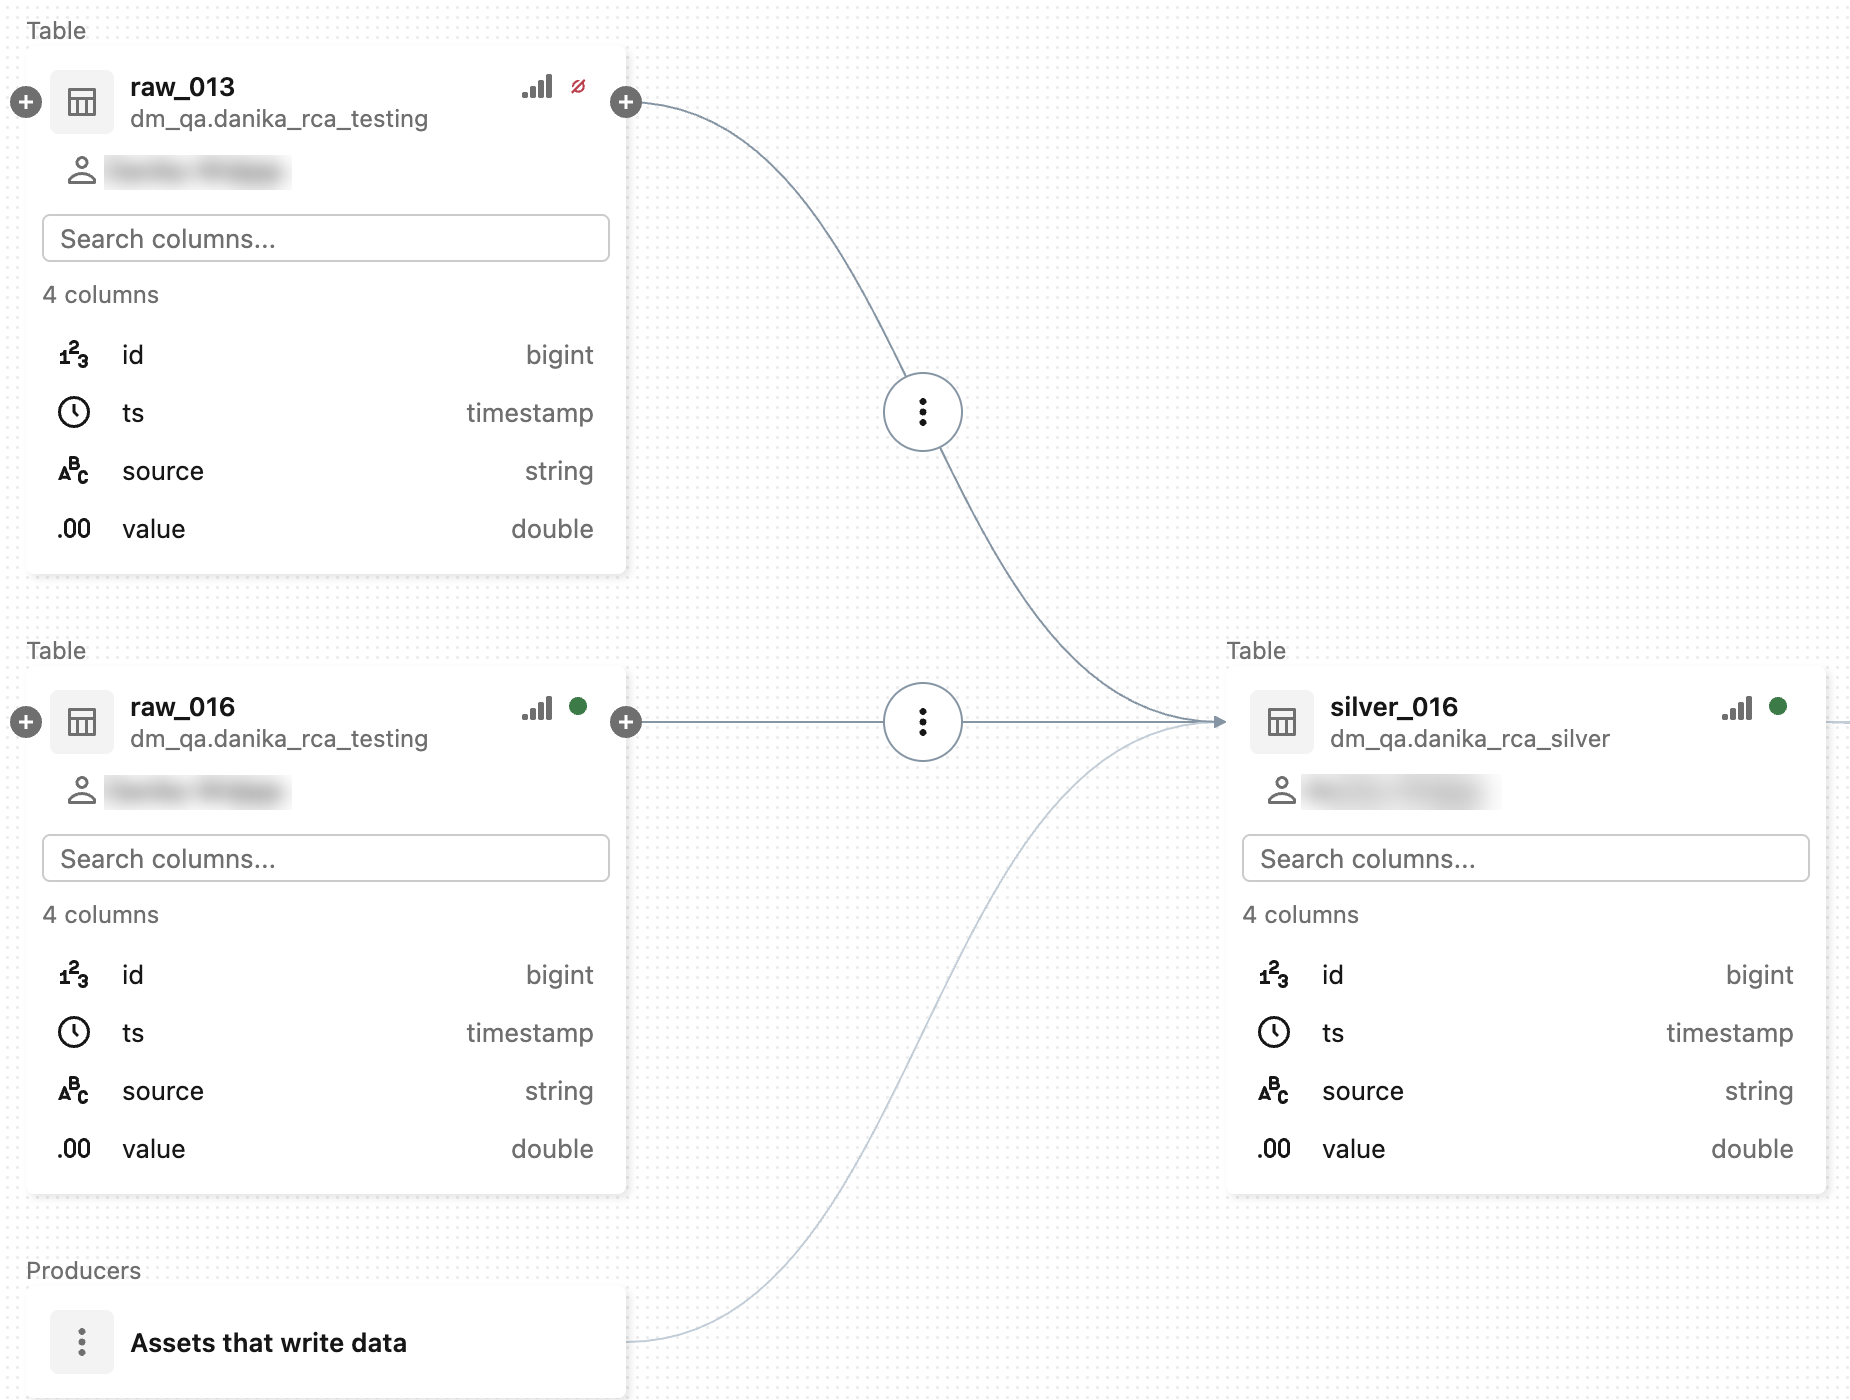
健康指标也会出现在 谱系图的表节点上,这样你可以在探索谱系时查看上游和下游表的健康状态。
在 UI 中查看数据质量监视结果
重要
2025 年 10 月 7 日,Databricks 发布了新版本的数据质量监视 UI。 在该日期或之后启用数据质量监视的架构会自动使用此新 UI。 本部分介绍此最新版本的 UI。
有关旧 UI 的信息,请参阅数据质量仪表板(旧版)。
Databricks 建议为所有现有架构启用新版本。
若要启用新版本,请单击 “数据质量监视 ”开关以关闭该功能,然后再次单击以重新打开该功能。
在架构上启用数据质量监视后,可以通过单击“ 查看结果”打开结果页。 您还可以从目录资源管理器中访问所有已启用监控的架构的结果。
结果界面包含目录和模式下拉列表。 选择目录时,架构下拉列表中填充了启用了数据质量监视的目录中的架构。
如果对目录具有 “管理 ”或 SELECT “特权”,则可以在目录级别查看事件。 若要查看目录中的所有事件,请从“架构”下拉菜单中选择“所有架构”。
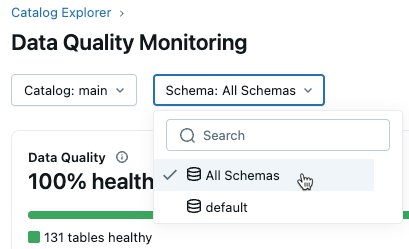
要查看特定模式的事件,你还必须对该模式拥有MANAGE或SELECTREAD元数据权限。 选择架构后,仅显示该架构的事件。
结果页显示顶部的摘要部分,其中显示了所选范围的总体数据质量,包括正常表的百分比和当前监视的架构/表的百分比。 在本部分下方的表格中,列出了在所选范围内所有受监视表格中的事件。 使用按钮显示 “不正常”、“ 正常”或 “错误 ”表。
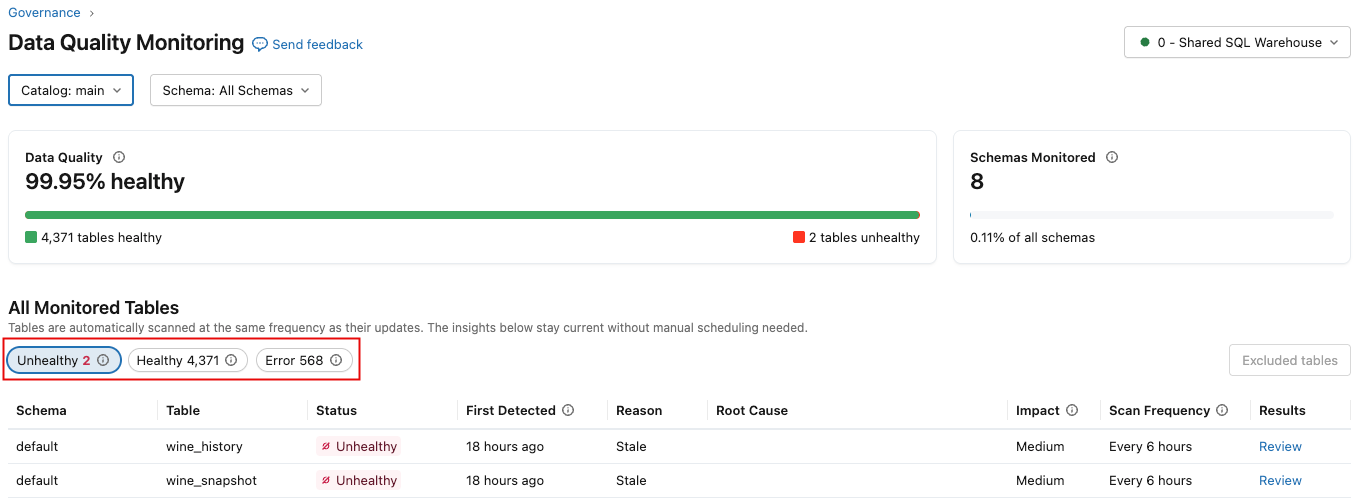
下表描述了这些列,这些列根据所选择的运行不正常、正常或错误而略有不同。
| 列 | 说明 |
|---|---|
| 地位 |
Healthy, Unhealthy 或 Training。 |
| 首次检测到 | 检测到第一个事件时。 仅在 “不正常 ”选项卡中显示。 |
| 上次扫描 | 上次扫描表的时间。 仅显示在 “正常 ”选项卡中。 |
| 原因 | 表是否因新鲜度或完整性而不健康。 仅在 “不正常 ”选项卡中显示。 |
| 根源 | 有关导致问题的上游作业、管道或表的信息。 仅在 “不正常 ”选项卡中显示。 |
| 影响 | 下游影响的定性度量值基于受影响的下游表和查询的数量(高、中或低)。 |
| 扫描频率 | 表在过去一周被扫描的频率有多高。 |
| Results | 指向 表质量页 的链接,可在其中查看历史趋势和可视化效果,说明为何检测到异常。 |
| 错误状态 | 错误消息。 仅显示在 “错误 ”选项卡中。 |
| 详细信息 | 有关错误消息的详细信息。 仅显示在 “错误 ”选项卡中。 |
管理不健康的表事件
在“运行状况不正常”选项卡的“结果”列中,单击“查看”以打开该表的事件详细信息。 在此视图中,有两个操作可用:
- 分配给我:声明事件的所有权,表示正在积极调查中。 该表保持 不正常 状态。 该分配会持续 7 天。
- 不是问题:将事件标记为误报并予以消除。 表的状态从“不正常”更改为“正常”,“最近解决的事件”部分中的“解决方法”列显示“未出现问题”。 解雇持续了 7 天。
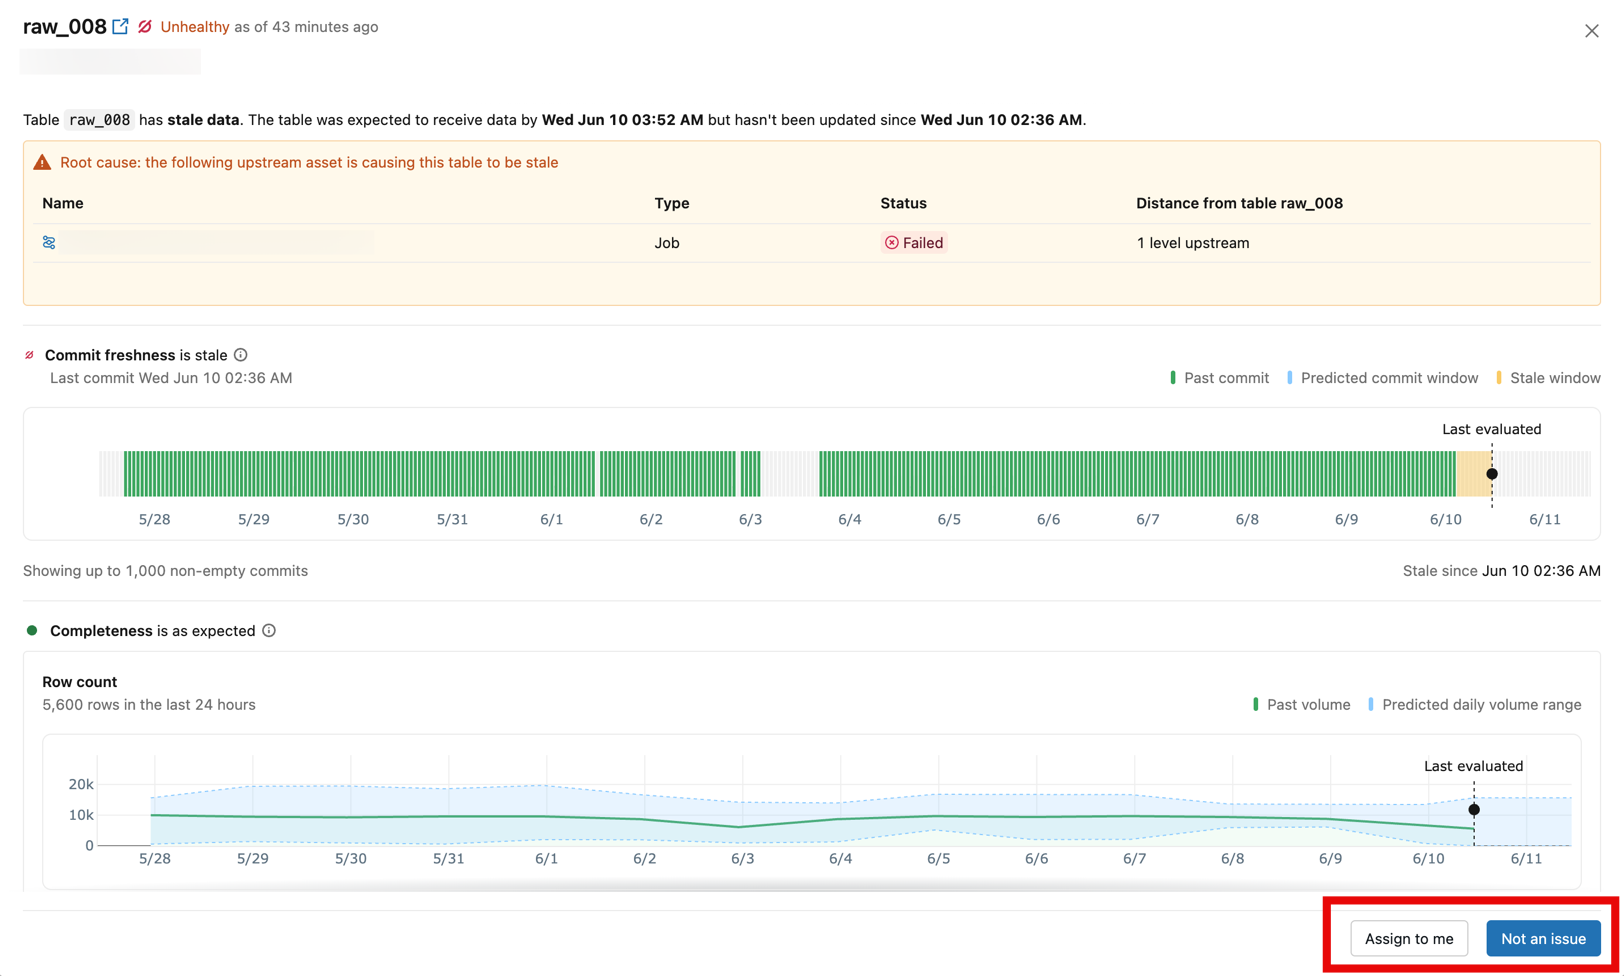
根本原因分析
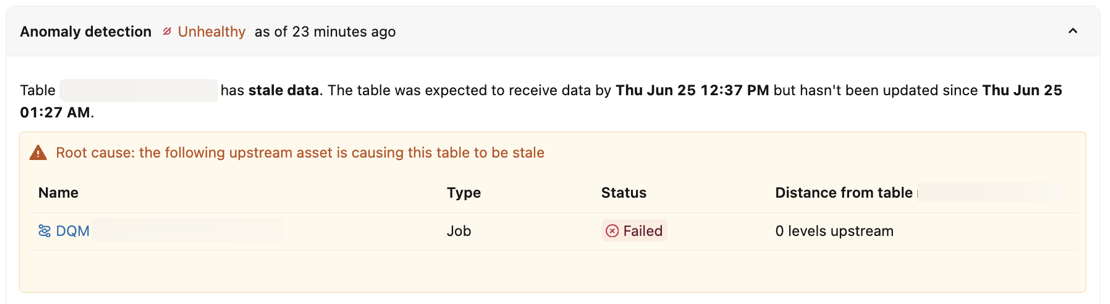
对于每个状态异常的表,异常检测都会识别出导致质量问题的最可能来源。 它分析受监视资产之间的关系,以确定问题是源自表本身还是上游依赖项。 此分析使用 Unity 目录 数据世系 来推断资产之间的多级关系。
当异常情况检测标识可能的来源时,该源将显示在数据质量监视 UI 中“不正常”选项卡的“根本原因”列中。 该列显示问题的最可能原因,例如作业失败或上游表健康问题。
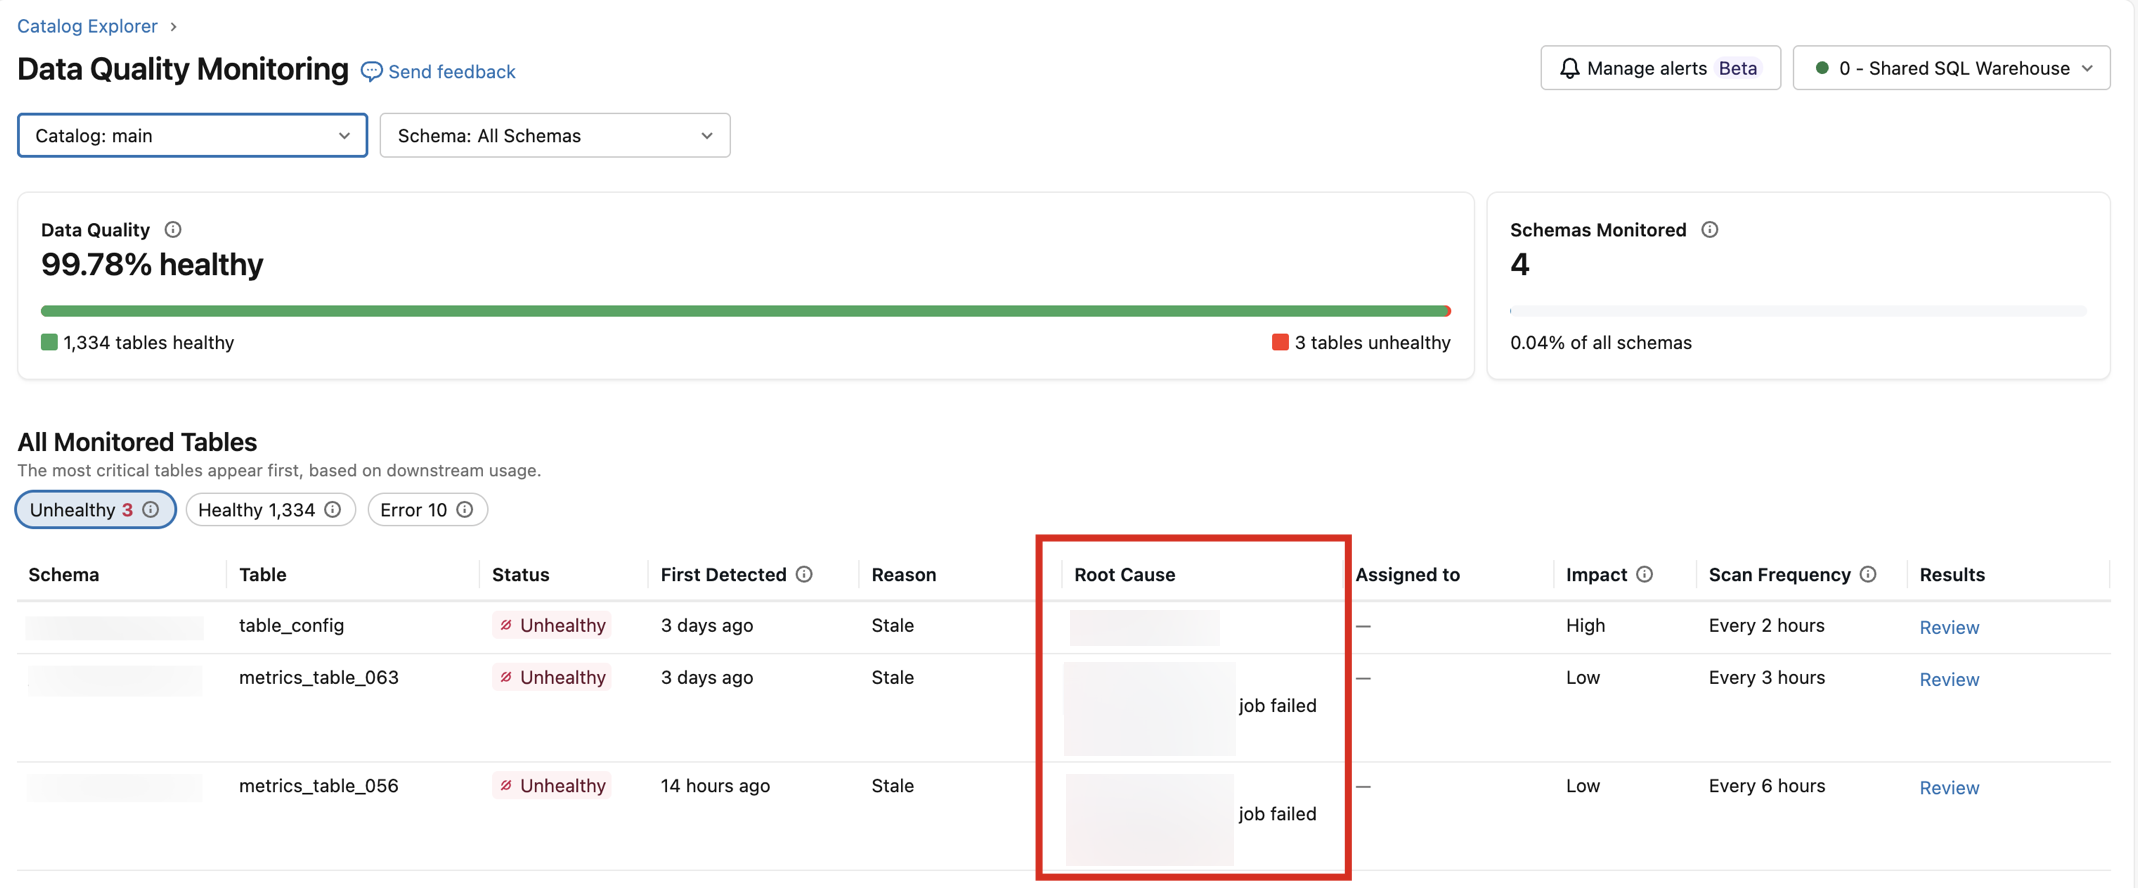
异常情况检测的警报中也提供了根本原因信息。 请参阅 异常检测警报。
查看最近解决的事件
重要
此功能在 Beta 版中。 工作区管理员可以从 预览 页控制对此功能的访问。 请参阅 Manage Azure Databricks 预览版。
数据质量监视仪表板的 “最近解决的事件” 部分显示以前不正常但此后自行恢复的表。 当表的状态自动从 “不正常 ”更改为“ 正常 ”时,此部分中会显示一个表,无需手动干预。
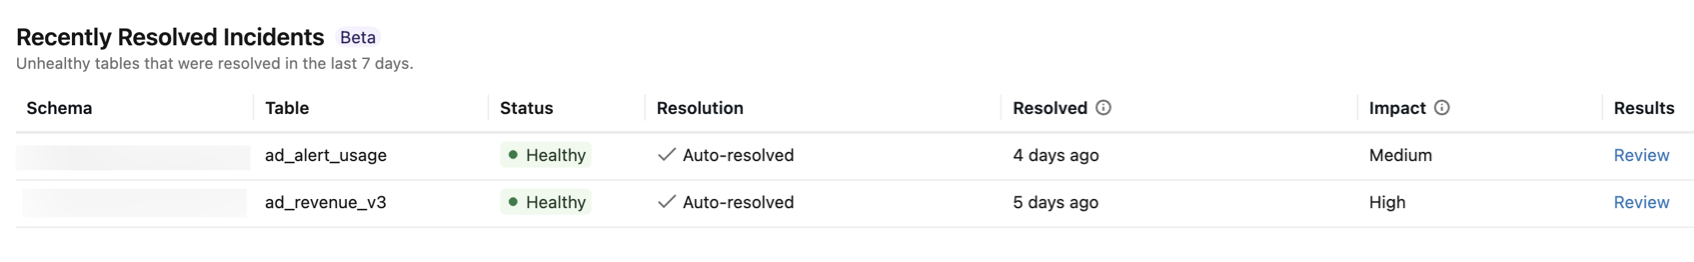
监视最近自动解决的事件有助于识别自我修复的数据质量问题。 通常,这些问题是暂时性故障,例如上游延迟或陈旧窗口,在新鲜数据到达后得到解决。 审查自动解决的事件有助于区分不稳定的问题和持续存在的问题,并确保你的表随时间保持健康。
下表描述了本节中的列:
| 列 | 说明 |
|---|---|
| Schema | 包含表的架构。 |
| Table | 表的名称。 |
| 地位 | 表的当前状态。 本节中的表始终显示 “正常”。 |
| 解决方案 | 事件是如何解决的。 如果表自行恢复,则显示自动恢复;如果用户使用不是问题操作忽略了该事件,则显示不是问题。 |
| 已解析 | 表状态上次更改为 “正常”的时间。 |
| 影响 | 下游影响的定性度量值基于受影响的下游表和查询的数量(高、中或低)。 |
| Results | 指向 表质量页 的链接,可在其中查看表的历史趋势和可视化效果。 |
查看元存储级别的结果
若要查看整个元存储中的数据质量结果,可使用以下任一方式:
数据质量监视仪表板
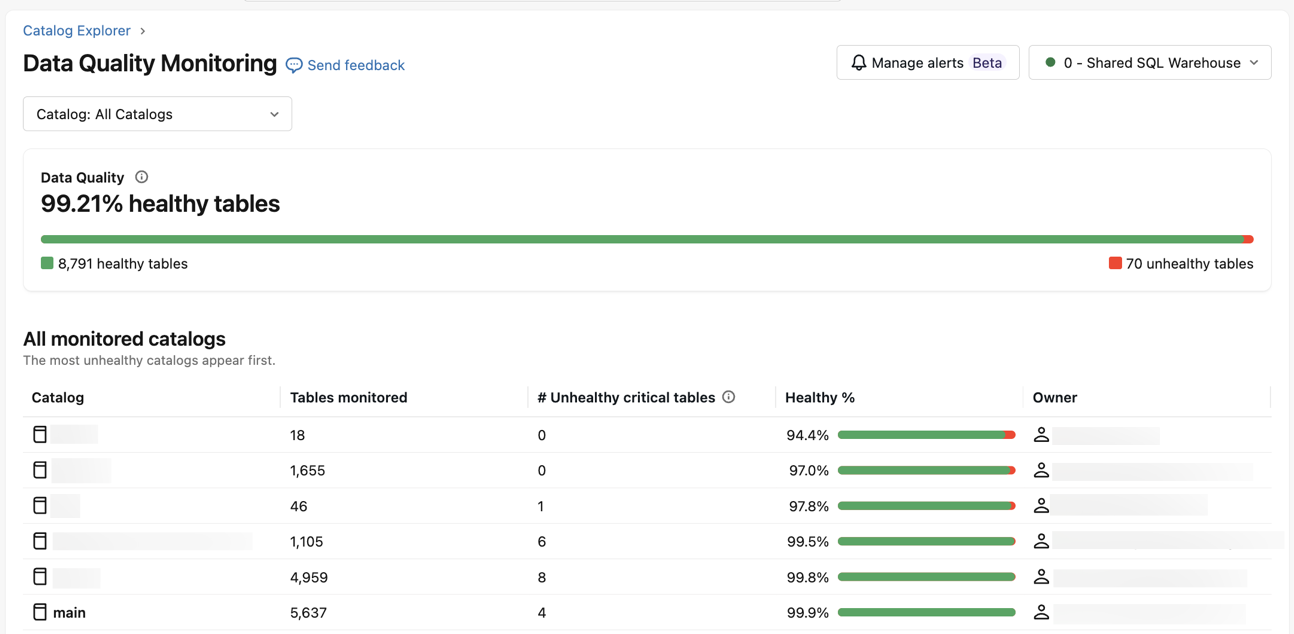
数据质量监控仪表板汇总了整个元存储中各表的运行状况。 若要打开它,请单击 工作区边栏中的目录,然后选择
 治理>数据质量监视。
任何用户可以查看仪表板。 结果的范围限定为用户有权访问的目录和表。
默认情况下,仪表板显示 所有目录 的结果,包括:
- 数据质量:元存储中正常表的百分比,以及正常和不正常表的总数。
- 所有受监视目录:受监视目录的列表,首先按最不正常的目录进行排序。 对于每个目录,该列表显示受监视的表数量、状态不健康的关键表数量、健康表所占百分比以及目录的所有者。
若要将结果范围限定为单个目录,请从 “目录 ”下拉菜单中选择它。
导入仪表板模板
还可以将模板导入工作区。 此模板创建一个仪表板,允许你查看整个元存储的所有质量结果。
若要使用此模板,必须有权访问 system.data_quality_monitoring.table_results 表。 默认情况下,只有帐户管理员有权访问此表。 他们可以根据需要向其他人授予访问权限。
若要导入和使用模板,请执行以下操作:
- 下载模板文件: metastore-quality-dashboard.lvdash.json。
- 在工作区边栏中,单击“
 仪表板。
- 在右上角,从“创建仪表板”下拉菜单中选择“从文件导入仪表板”。
- 在对话框中,单击“ 选择文件”,导航到模板文件,然后单击“ 导入仪表板”。
文件已导入,并显示仪表板。
表质量详细信息
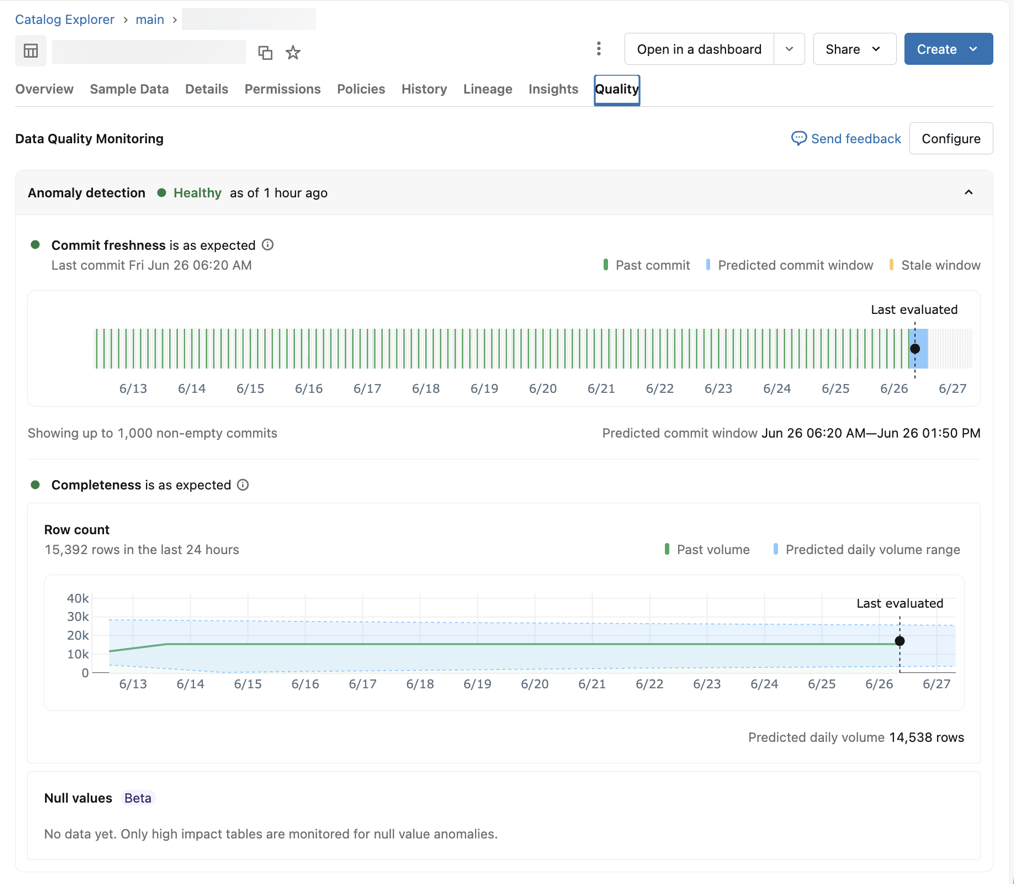
使用“表质量详细信息”UI 可以更深入地了解趋势,并了解在架构中检测到特定表的异常的原因。 可以通过多种方式访问此视图:
- 在 “结果”UI (新体验)中,单击事件列表中的“审阅”链接。
- 在 “监视仪表板 ”(旧版 Lakeview 仪表板)中,单击“质量概述”选项卡中的表名称。
- 从 UC 表查看器,通过访问表页上的“质量”选项卡。
所有选项都会将你带到所选表的同一 “表质量详细信息 ”视图。
在给定表的情况下,UI 会显示每个质量检查的摘要,并在每个评估时点展示预测值和观察值的图表。 图表绘制了过去一周的数据结果。
如果表未通过质量审查,UI 还会显示被识别为根本原因的任何上游作业。
设置警报
要设置在异常检测发现数据质量问题时通知您的警报,请参见 “异常检测警报”。
局限性
- 异常检测不支持视图或外部表。
- 完整性的确定不考虑 null 的占比、零值或 NaN 等指标。
传统异常检测
以下部分介绍两项旧功能:数据质量仪表板和异常情况检测作业配置。 当前版本的异常情况检测不包括这些功能。 仪表板已替换为 数据质量监控结果界面。
数据质量仪表板(旧版)
数据质量仪表板(旧版)
注释
数据质量监视仪表板仅适用于旧用户。 在当前版本中,在 UI 中查看数据质量监控结果。
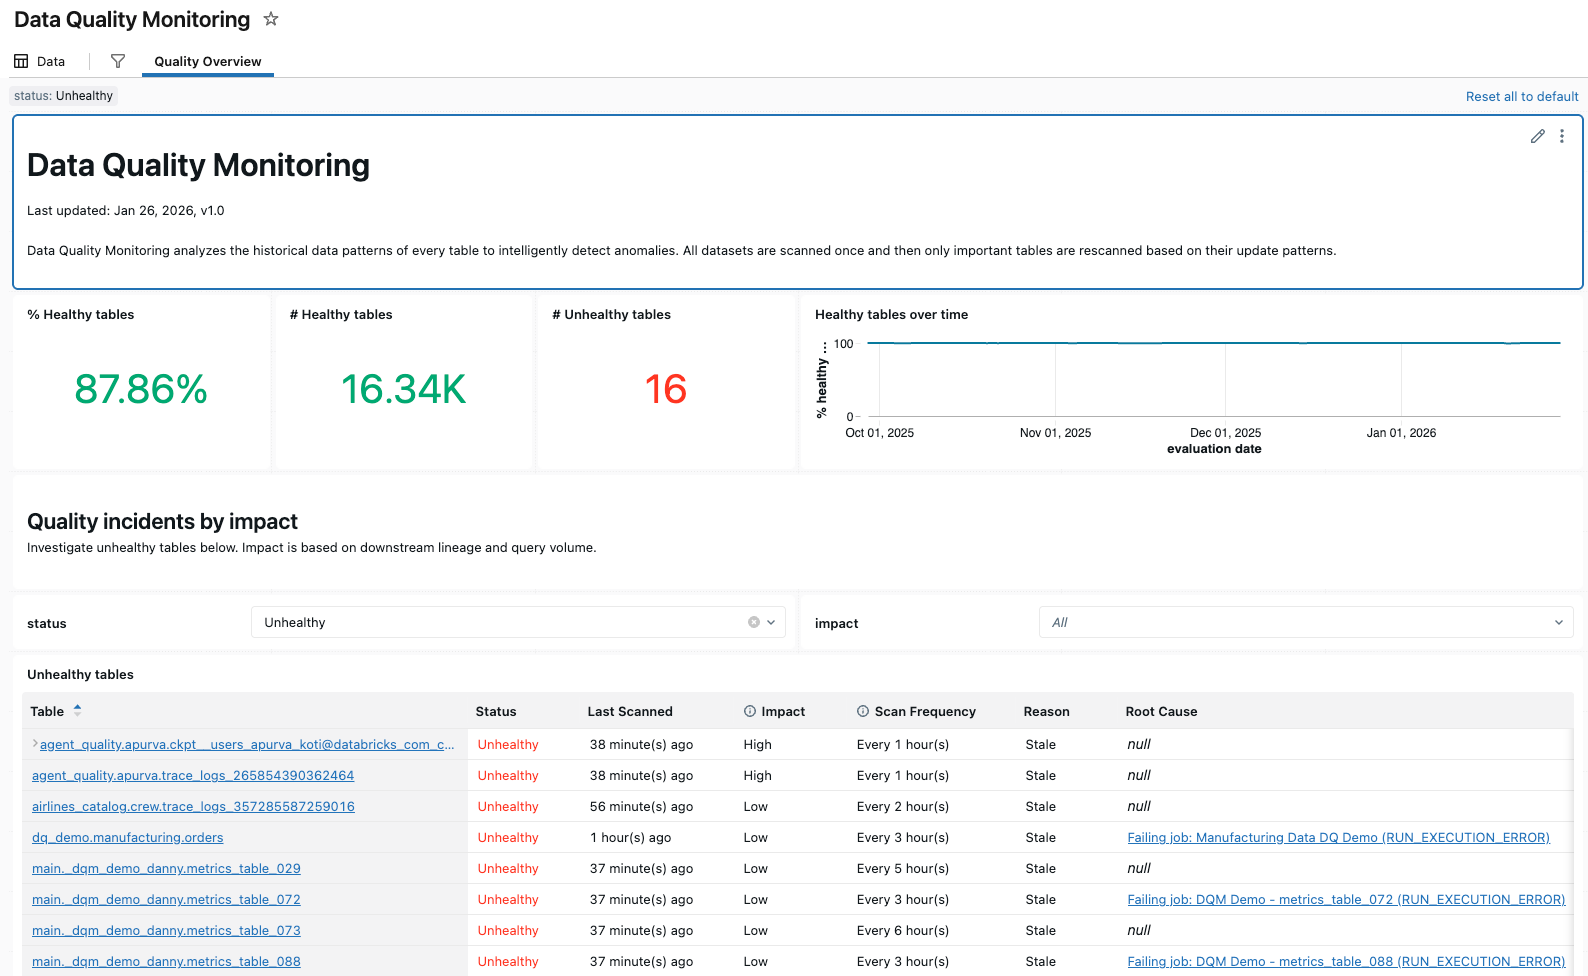
第一个数据质量监测运行会创建一个仪表板,以汇总从日志记录表中得出的结果和趋势。 仪表板会自动填充已扫描架构的见解。 在每个工作区中创建一个仪表板,路径为: /Shared/Databricks Quality Monitoring/Data Quality Monitoring。
质量概述
“ 质量概述 ”选项卡根据最新评估显示架构中表的最新质量状态摘要。
若要开始,必须输入要分析的架构的日志记录表以填充仪表板。
仪表板的顶部部分显示了扫描结果的概述。
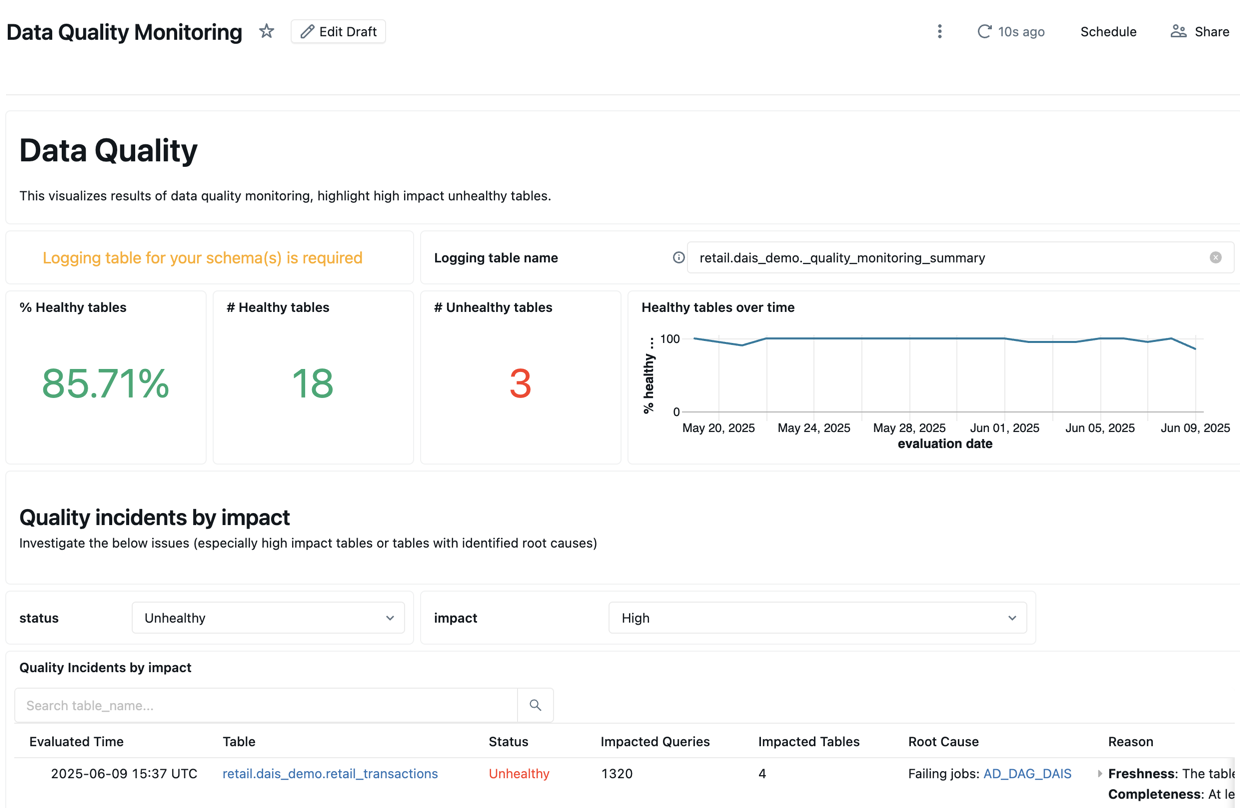
在摘要的下方有一个表格,列出了按影响分类的质量事件。 任何确定的根本原因都显示在 root_cause_analysis 列中。
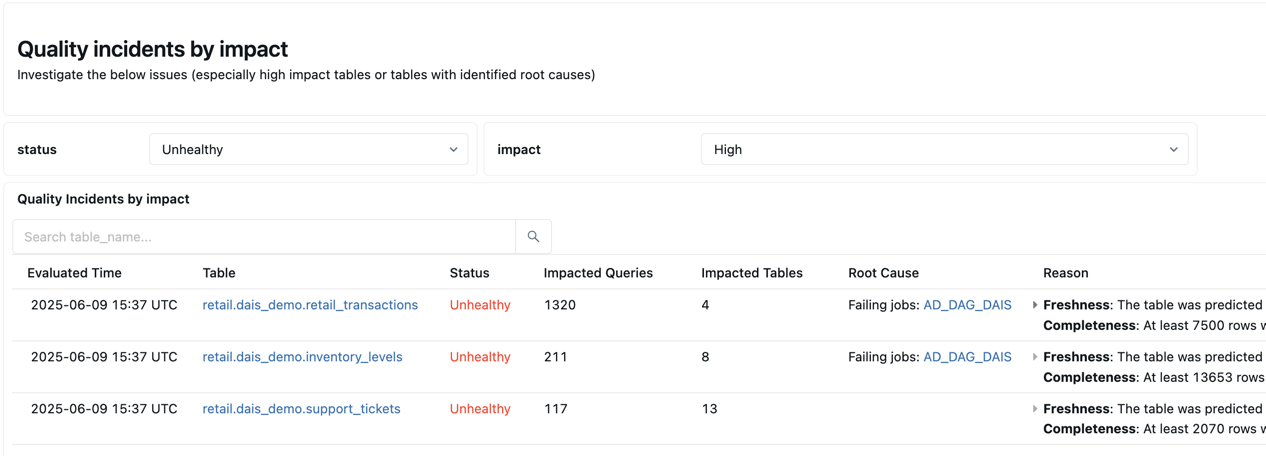
质量事件表下方是一个已识别的静态表,这些静态表在很长一段时间内尚未更新。
为新鲜度和完整性评估设置参数(旧版)
为新鲜度和完整性评估设置参数(旧版)
注释
从 2025 年 7 月 21 日起,新客户不支持配置作业参数。 如果需要配置作业设置,请联系 Databricks。
若要编辑控制作业的参数,例如作业的运行频率或记录的结果表的名称,必须在作业页的“ 任务 ”选项卡上编辑作业参数。
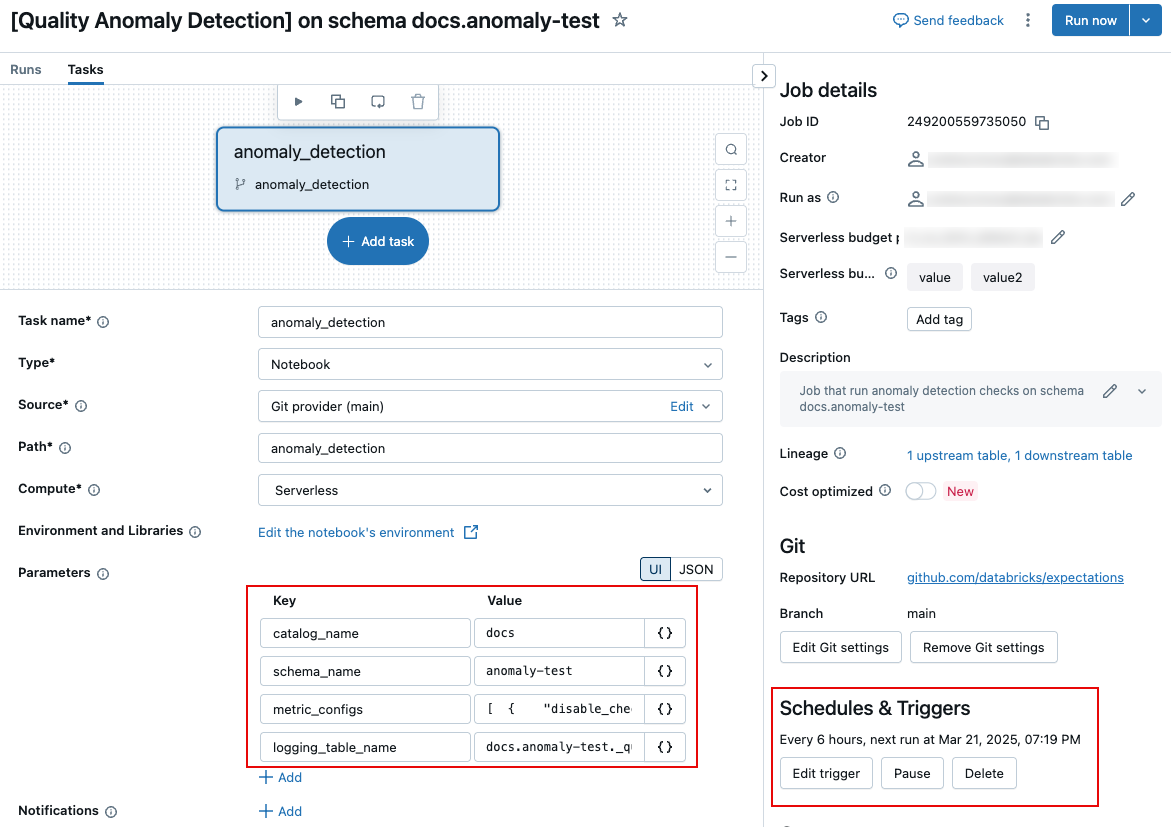
以下部分介绍特定设置。 有关如何设置任务参数的信息,请参阅 “配置任务参数”。
计划和通知(旧版)
若要自定义作业的计划或设置通知,请使用作业页上的 “计划和触发器 ”设置。 请参阅 使用计划和触发器自动执行作业。
日志表名称(旧版)
若要更改日志记录表的名称,或将表保存在其他架构中,请编辑作业任务参数 logging_table_name 并指定所需的名称。 若要将日志记录表保存在其他架构中,请指定完整的 3 级名称。
自定义 freshness 和 completeness 评估(旧版)
本部分中的所有参数都是可选的。 默认情况下,异常情况检测根据表历史记录的分析确定阈值。
这些参数是任务参数 metric_configs内的字段。 格式为具有以下默认值的 metric_configs JSON 字符串:
[
  {
    "disable_check": false,
    "tables_to_skip": null,
    "tables_to_scan": null,
    "table_threshold_overrides": null,
    "table_latency_threshold_overrides": null,
    "static_table_threshold_override": null,
    "event_timestamp_col_names": null,
    "metric_type": "FreshnessConfig"
  },
  {
    "disable_check": true,
    "tables_to_skip": null,
    "tables_to_scan": null,
    "table_threshold_overrides": null,
    "metric_type": "CompletenessConfig"
  }
]
以下参数可用于 freshness 和 completeness 的评估。
| 字段名称 | 说明 | 示例 |
|---|---|---|
tables_to_scan |
仅扫描指定的表。 | ["table_to_scan", "another_table_to_scan"] |
tables_to_skip |
在扫描期间跳过指定的表。 | ["table_to_skip"] |
disable_check |
扫描未运行。 如果要仅禁用 freshness 扫描或仅禁用 completeness 扫描,请使用此参数。 |
true、false |
以下参数仅适用于 freshness 评估:
| 字段名称 | 说明 | 示例 |
|---|---|---|
event_timestamp_col_names |
架构中可能具有的含时间戳列的表的列表。 如果表包含这些列之一,则会在超出此列的最大值时进行标记 Unhealthy 。 使用此参数可能会增加评估时间和成本。 |
["timestamp", "date"] |
table_threshold_overrides |
一个字典,由表名和阈值(以秒为单位)组成,指定自上次表更新以来的最大间隔,然后再将表 Unhealthy标记为 。 |
{"table_0": 86400} |
table_latency_threshold_overrides |
一个字典,由表名和延迟阈值(以秒为单位)组成,指定自表中最后一个时间戳以来的最大时间间隔,然后再将表 Unhealthy标记为 。 |
{"table_1": 3600} |
static_table_threshold_override |
在将表视为静态表(即不再更新的表)之前的时间(以秒为单位)。 | 2592000 |
以下参数仅适用于 completeness 评估:
| 字段名称 | 说明 | 示例 |
|---|---|---|
table_threshold_overrides |
包含表名和行数阈值(指定为整数)的字典。 如果前 24 小时内添加到表中的行数小于指定的阈值,则表示该表将被标记 Unhealthy。 |
{"table_0": 1000} |