通过优化查询,在运行复杂查询时更快地获取结果并避免超时。 有关提高查询性能的指南:
- 常规优化提示 - 在本文中
-
优化
join运算符 - 在本文中 -
优化
summarize运算符 - 在本文中 - 查询场景 - 本文中
- Kusto 查询最佳做法 - 包括提高查询效率的几种方案
- 优化 Azure Monitor 中的日志查询 - 包含有关查询优化的其他指南
- (视频) 优化 KQL 查询 - 改进查询的最常见方法
了解 CPU 资源配额
根据大小,每个租户有权访问为运行高级搜寻查询而分配的一定数量的 CPU 资源。 有关各项使用参数的详细信息,请参阅 高级搜寻配额和使用参数的相关内容。
运行查询后,可以看到执行时间及其资源使用情况 (低、中、高) 。 高表示查询需要更多资源来运行,并且可以改进以更高效地返回结果。
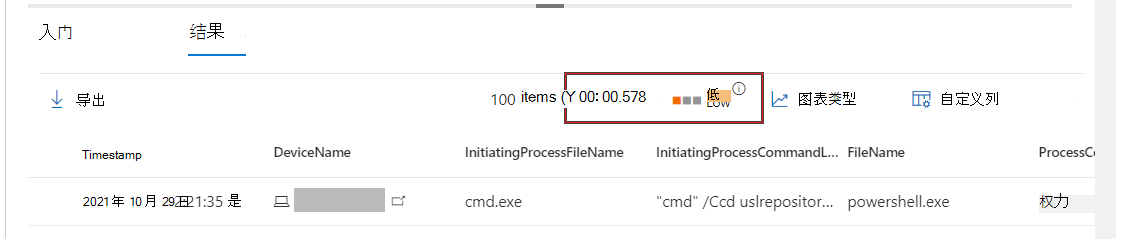
定期运行多个查询的客户应跟踪使用情况并应用本文中的优化指南,以最大程度地减少因超出配额或使用参数而导致的中断。
常规优化提示
评估新查询的规模—如果你怀疑某个查询会返回较大的结果集,请先使用 count 运算符进行评估。 使用 limit 或其同义词
take可避免大型结果集。尽早应用筛选器 - 应用时间筛选器和其他筛选器来减少数据集,尤其是在使用转换和分析函数(例如 子字符串 () 、 替换 () 、 剪裁 () 、 toupper () 或 parse_json () 之前)。 在下面的示例中,分析函数 extractjson () 在筛选运算符减少记录数后使用。
DeviceEvents
| where Timestamp > ago(1d)
| where ActionType == "UsbDriveMount"
| where DeviceName == "user-desktop.domain.com"
| extend DriveLetter = extractjson("$.DriveLetter", AdditionalFields)
Has 优于 contains - 为避免不必要地搜索单词内的子字符串,请使用
has运算符而不是contains运算符。 了解字符串运算符限定搜索范围 - 避免运行范围外的
search查询union,因为它们跨越架构中的所有表,并且可能超出具有多个表的环境中的查询大小限制。 使用search in指定要搜索的表。 例如,使用search "email"而不是search in (EmailEvents, EmailAttachmentInfo, IdentityInfo) "email"。查找特定列 - 查找特定列,而不是运行全文搜索。 不要使用
*来检查所有列。区分大小写以提升速度 - 区分大小写的搜索更精确,通常性能也更好。 区分大小写的 字符串运算符(如
has_cs和contains_cs)的名称通常以_cs结尾。 您也可以使用区分大小写的等于运算符==,而不是=~。分析,不要提取 - 尽可能使用 parse 运算符 或分析函数 (如 parse_json () )。
matches regex避免使用字符串运算符或 extract () 函数,这两者都使用正则表达式。 仅在更复杂的场景中使用正则表达式。 阅读有关分析函数的详细信息筛选表,而不是表达式—如果可以基于表中的列进行筛选,就不要基于计算列进行筛选。
无三字符术语 - 避免使用三个字符或更少字符的术语进行比较或筛选。 这些术语不会编制索引,匹配它们需要更多资源。
选择性投影——只投影所需列,让结果更易于理解。 在运行 联接 或类似操作之前投影特定列也有助于提高性能。
优化 join 运算符
联接运算符通过指定列中的匹配值合并两个表中的行。 应用这些提示来优化使用此运算符的查询。
左侧较小的表 - 运算符
join将联接语句左侧表中的记录与右侧的记录相匹配。 通过将较小的表放在左侧,需要匹配的记录将减少,从而加快查询速度。在下表中,我们先将左侧表
DeviceLogonEvents缩减为仅包含三个特定设备,然后再按账户 SID 将其与IdentityLogonEvents联接。DeviceLogonEvents | where DeviceName in ("device-1.domain.com", "device-2.domain.com", "device-3.domain.com") | where ActionType == "LogonFailed" | join (IdentityLogonEvents | where ActionType == "LogonFailed" | where Protocol == "Kerberos") on AccountSid使用内部联接类型- 默认的联接类型或内部唯一联接,会在为右表的每个匹配项返回一行之前,先按联接键对左表中的行进行重复数据删除。 如果左表的多个行与
join键的值相同,则将删除这些行,以便为每个唯一值保留一个随机行。此默认行为可能会省略左侧表中可提供有用见解的重要信息。 例如,下面的查询将仅显示包含特定附件的一封电子邮件,即使该附件是使用多个电子邮件发送的:
EmailAttachmentInfo
| where Timestamp > ago(1h)
| where Subject == "Document Attachment" and FileName == "Document.pdf"
| join (DeviceFileEvents | where Timestamp > ago(1h)) on SHA256
为了解决这一限制,我们通过指定 来应用
kind=inner类型,以显示左表中所有在右表中有匹配值的行:EmailAttachmentInfo | where Timestamp > ago(1h) | where Subject == "Document Attachment" and FileName == "Document.pdf" | join kind=inner (DeviceFileEvents | where Timestamp > ago(1h)) on SHA256从时间窗口联接记录 - 调查安全事件时,分析师会查找大约在同一时间段内发生的相关事件。 在使用
join时采用相同的方法,也有助于通过减少需要检查的记录数量来提升性能。以下查询用于检查在收到恶意文件后的 30 分钟内发生的登录事件:
EmailEvents
| where Timestamp > ago(7d)
| where ThreatTypes has "Malware"
| project EmailReceivedTime = Timestamp, Subject, SenderFromAddress, AccountName = tostring(split(RecipientEmailAddress, "@")[0])
| join (
DeviceLogonEvents
| where Timestamp > ago(7d)
| project LogonTime = Timestamp, AccountName, DeviceName
) on AccountName
| where (LogonTime - EmailReceivedTime) between (0min .. 30min)
在两侧应用时间筛选器 - 即使不调查特定的时间窗口,对左右表应用时间筛选器也可以减少记录数,以检查并提高
join性能。 以下查询将Timestamp > ago(1h)应用于两个表,以便仅联接过去一小时内的记录:EmailAttachmentInfo | where Timestamp > ago(1h) | where Subject == "Document Attachment" and FileName == "Document.pdf" | join kind=inner (DeviceFileEvents | where Timestamp > ago(1h)) on SHA256使用性能提示—使用
join运算符时添加提示,以指示后端在运行资源密集型操作时分配负载。 详细了解联接提示。例如,使用具有高基数的键(具有许多唯一值的键)联接表时, 随机提示 有助于提高查询性能,如
AccountObjectId以下查询中的 :IdentityInfo | where JobTitle == "CONSULTANT" | join hint.shufflekey = AccountObjectId (IdentityDirectoryEvents | where Application == "Active Directory" | where ActionType == "Private data retrieval") on AccountObjectId当左表较小 (最多 100,000 条记录) 且右侧表非常大时, 广播提示 会有所帮助。 例如,下面的查询尝试将一些具有特定主题的电子邮件与 表中包含链接的
EmailUrlInfo消息联接:EmailEvents | where Subject in ("Warning: Update your credentials now", "Action required: Update your credentials now") | join hint.strategy = broadcast EmailUrlInfo on NetworkMessageId
优化 summarize 运算符
summarize 运算符聚合表的内容。 应用这些提示来优化使用此运算符的查询。
查找不同的值——通常,使用
summarize查找可能重复出现的不同值。 可能不需要使用它来聚合没有重复值的列。虽然单封电子邮件可以属于多个事件,但下面的示例并不是
summarize的高效用法,因为单封电子邮件的网络消息 ID 始终对应唯一的发件人地址。EmailEvents | where Timestamp > ago(1h) | summarize by NetworkMessageId, SenderFromAddress运算符
summarize可以轻松地替换为project,从而产生可能相同的结果,同时消耗更少的资源:EmailEvents | where Timestamp > ago(1h) | project NetworkMessageId, SenderFromAddress以下示例展示了对
summarize的一种更高效的用法,因为同一个发件人地址向同一个收件人地址发送电子邮件时,可能存在多个不同的实例。 此类组合不太明显,并且可能具有重复项。EmailEvents | where Timestamp > ago(1h) | summarize by SenderFromAddress, RecipientEmailAddress重组查询——虽然
summarize最适合用于包含重复值的列,但这些列也可能具有 高基数 或大量唯一值。 与join运算符一样,你也可以将 shuffle 提示 与summarize结合使用,以便在处理高基数列时分散处理负载并潜在地提高性能。下面的查询使用
summarize统计不同的收件人电子邮件地址数量,在大型组织中,该数量可达到数十万。 为了提高性能,它合并了hint.shufflekey:EmailEvents | where Timestamp > ago(1h) | summarize hint.shufflekey = RecipientEmailAddress count() by Subject, RecipientEmailAddress
查询场景
使用进程 ID 识别唯一进程
进程 ID (PID) 在 Windows 中回收,并重新用于新进程。 它们本身不能用作特定进程的唯一标识符。
通常,在特定设备上唯一标识进程的唯一方法是将其进程 ID 与其进程创建时间相结合,以及设备标识符 (DeviceId 或 DeviceName) 。 例如,以下示例查询查找通过端口 445 (SMB) 访问超过 10 个 IP 地址的进程,并可能扫描文件共享。
DeviceNetworkEvents
| where RemotePort == 445 and Timestamp > ago(12h) and InitiatingProcessId !in (0, 4)
| summarize RemoteIPCount=dcount(RemoteIP) by DeviceName, InitiatingProcessId, InitiatingProcessCreationTime, InitiatingProcessFileName
| where RemoteIPCount > 10
上述查询按 InitiatingProcessId 和 InitiatingProcessCreationTime 进行汇总,以便查看单个进程,而无需将多个进程与同一进程 ID 混合。
此方法仍然有效,尤其是对于非 Windows 系统。 不过,在 Windows 中,可以使用 ProcessUniqueId 字段这一更直接的方法。 虽然前面的方法和下面讨论的方法都生成了唯一的进程实例,但作为最佳做法,我们建议在可用时使用 ProcessUniqueId ,因为它简化了查询,并消除了处理 PID 重用方案的需求。
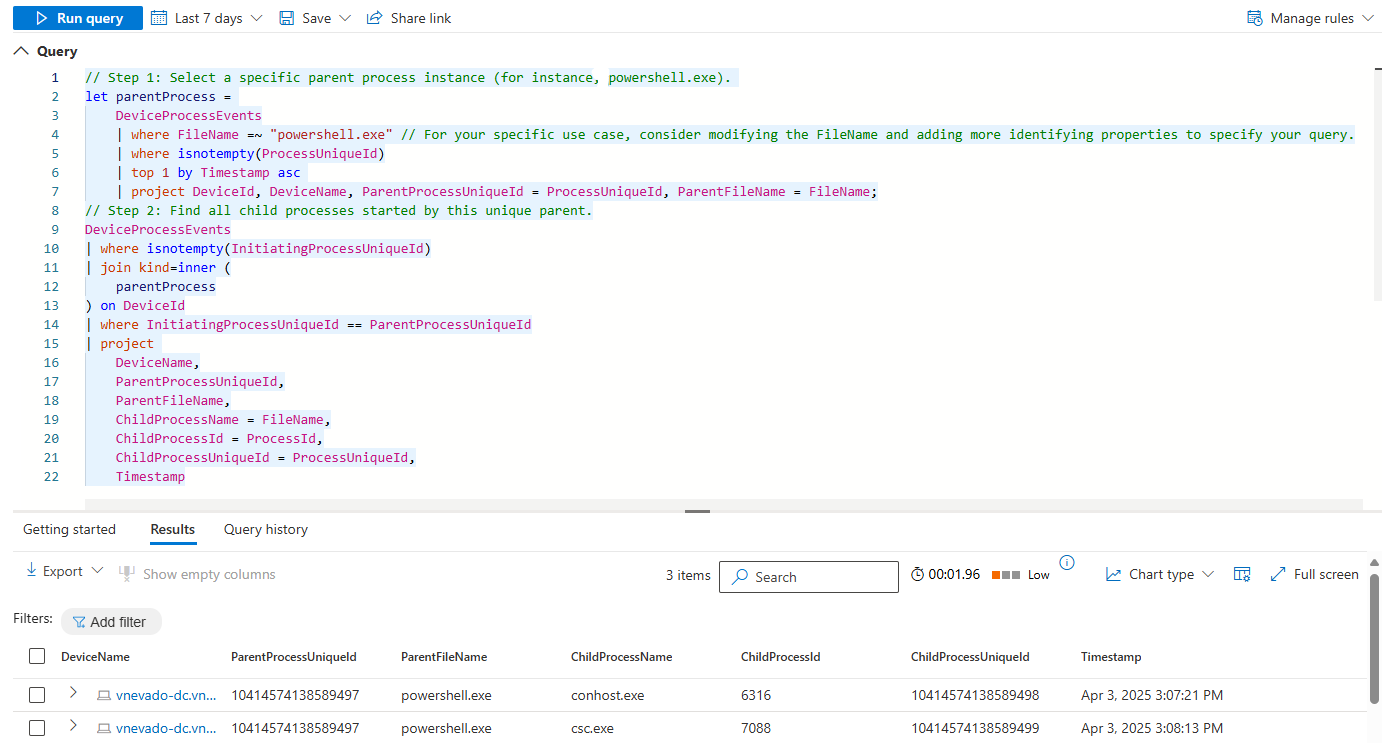
此查询演示如何使用 ProcessUniqueId 和 InitiatingProcessUniqueId 字段将特定父进程链接到其子进程。 通过将每个子级的 InitiatingProcessUniqueId 匹配到父级的 ProcessUniqueId,它仅隔离由该确切的父实例启动的子进程,即使进程 ID 随时间推移重复使用也是如此。
示例查询:
// Step 1: Select a specific parent process instance (for instance, powershell.exe).
let parentProcess =
    DeviceProcessEvents
    | where FileName =~ "powershell.exe" // For your specific use case, consider modifying the FileName and adding more identifying properties to specify your query.
    | where isnotempty(ProcessUniqueId)
    | top 1 by Timestamp asc
    | project DeviceId, DeviceName, ParentProcessUniqueId = ProcessUniqueId, ParentFileName = FileName;
// Step 2: Find all child processes started by this unique parent.
DeviceProcessEvents
| where isnotempty(InitiatingProcessUniqueId)
| join kind=inner (
    parentProcess
) on DeviceId
| where InitiatingProcessUniqueId == ParentProcessUniqueId
| project
    DeviceName,
    ParentProcessUniqueId,
    ParentFileName,
    ChildProcessName = FileName,
    ChildProcessId = ProcessId,
    ChildProcessUniqueId = ProcessUniqueId,
    Timestamp
同样,查询按 InitiatingProcessId 和 InitiatingProcessCreationTime 进行汇总,以便查看单个进程,而无需将多个进程与同一进程 ID 混合。
查询命令行
有很多方法可以构造命令行来完成任务。 例如,攻击者可以引用没有路径、没有文件扩展名、使用环境变量或带引号的图像文件。 攻击者还可以更改参数的顺序或添加多个引号和空格。
若要围绕命令行创建更持久的查询,请应用以下做法:
- 通过对文件名字段进行匹配来识别已知进程 (,例如 net.exe 或 psexec.exe) ,而不是对命令行本身进行筛选。
- 使用 parse_command_line () 函数分析命令行部分
- 查询命令行参数时,请勿按特定顺序查找多个不相关参数的完全匹配。 而是使用正则表达式或使用多个单独的 Contains 运算符。
- 使用不区分大小写的匹配。 例如,使用
=~、in~和contains而不是==、in和contains_cs。 - 若要缓解命令行模糊处理技术,请考虑删除引号,将逗号替换为空格,以及将多个连续空格替换为单个空格。 有更复杂的模糊处理技术需要其他方法,但这些调整可以帮助解决常见方法。
以下示例演示了构造查询的各种方法,该查询查找 文件net.exe 以停止防火墙服务“MpsSvc”:
// Non-durable query - do not use
DeviceProcessEvents
| where ProcessCommandLine == "net stop MpsSvc"
| limit 10

// Better query - filters on file name, does case-insensitive matches
DeviceProcessEvents
| where Timestamp > ago(7d) and FileName in~ ("net.exe", "net1.exe") and ProcessCommandLine contains "stop" and ProcessCommandLine contains "MpsSvc"

// Best query also ignores quotes
DeviceProcessEvents
| where Timestamp > ago(7d) and FileName in~ ("net.exe", "net1.exe")
| extend CanonicalCommandLine=replace("\"", "", ProcessCommandLine)
| where CanonicalCommandLine contains "stop" and CanonicalCommandLine contains "MpsSvc"
从外部源引入数据
若要将长列表或大型表合并到查询中,请使用 externaldata 运算符 从指定的 URI 引入数据。 可以从 TXT、CSV、JSON 或其他格式的文件获取数据。 下面的示例演示如何利用 MalwareBazaar (abuse.ch) 提供的恶意软件 SHA-256 哈希的广泛列表来检查电子邮件附件:
let abuse_sha256 = (externaldata(sha256_hash: string)
[@"https://bazaar.abuse.ch/export/txt/sha256/recent/"]
with (format="txt"))
| where sha256_hash !startswith "#"
| project sha256_hash;
abuse_sha256
| join (EmailAttachmentInfo
| where Timestamp > ago(1d)
) on $left.sha256_hash == $right.SHA256
| project Timestamp,SenderFromAddress,RecipientEmailAddress,FileName,FileType,
SHA256,ThreatTypes,DetectionMethods
分析字符串
可以使用各种函数有效地处理需要分析或转换的字符串。
| 字符串 | 函数 | 用法示例 |
|---|---|---|
| 命令行 | parse_command_line () | 提取命令和所有参数。 |
| 路径 | parse_path () | 提取文件或文件夹路径的各部分。 |
| 版本号 | parse_version () | 解构一个版本号,其中最多包含四个部分,每个节最多八个字符。 使用解析后的数据比较版本新旧。 |
| IPv4 地址 | parse_ipv4 () | 将 IPv4 地址转换为长整数。 若要比较 IPv4 地址而不转换它们,请使用 ipv4_compare () 。 |
| IPv6 地址 | parse_ipv6 () | 将 IPv4 或 IPv6 地址转换为规范 IPv6 表示法。 若要比较 IPv6 地址,请使用 ipv6_compare () 。 |
若要了解所有受支持的分析函数, 请阅读 Kusto 字符串函数。
注意
本文中的某些表在 Microsoft Defender for Endpoint 中可能不可用。 启用Microsoft Defender以使用更多数据源搜寻威胁。 可以按照从 Microsoft Defender for Endpoint 迁移高级搜寻查询中的步骤,将高级搜寻工作流从Microsoft Defender for Endpoint移动到Microsoft Defender。
相关主题
提示
想要了解更多信息? 请在我们的技术社区中与 Microsoft 安全社区互动:Microsoft Defender XDR 技术社区。