إشعار
يتطلب الوصول إلى هذه الصفحة تخويلاً. يمكنك محاولة تسجيل الدخول أو تغيير الدلائل.
يتطلب الوصول إلى هذه الصفحة تخويلاً. يمكنك محاولة تغيير الدلائل.
يدعم قاعدة بيانات Azure لـ PostgreSQL توفر عالي من خلال توفير النسخ الأساسية والاحتياطية المنفصلة فعليا. يضمن نموذج التوفر العالي هذا عدم فقدان البيانات الملتزم بها أبدا أثناء حالات الفشل. في إعداد قابلية الوصول العالية (HA)، يقوم النظام بشكل متزامن بتثبيت البيانات لكل من الخوادم الأساسية والخوادم الاحتياطية. تم تصميم النموذج بحيث لا تكون قاعدة البيانات نقطة فشل واحدة في بنية البرنامج.
بشكل افتراضي في معظم المناطق، تنشر الخدمة النسخة المتماثلة الاحتياطية في منطقة توفر مختلفة عن النسخة المتماثلة الأساسية (المنطقة المكررة). يمكنك أيضا نشر النسخ الأساسية والاحتياطية ضمن نفس منطقة التوفر (المنطقة).
ميزات قابلية الوصول العالية
يستخدم الخادم الأساسي والنسخة المتماثلة الاحتياطية نفس تكوين الجهاز الظاهري، بما في ذلك vCores والتخزين وإعدادات الشبكة.
يمكنك إضافة دعم منطقة التوفر إلى خادم قاعدة بيانات موجود.
بالإضافة إلى خادم الاستعداد، تتضمن البنية خادم النسخة المتماثلة WAL في منطقة توفر منفصلة للحفاظ على تثبيت الحصة. في الحالات التي يكون فيها خادم الاستعداد غير متاح مؤقتا، يتم تنفيذ المعاملات على الخادم الأساسي وخادم النسخ WAL لضمان المتانة. عندما يصبح خادم الاستعداد متوفرا مرة أخرى، فإنه يلحق تلقائيا بالخادم الأساسي. تساعد هذه البنية في ضمان استمرار السجلات الملتزمة بالبقاء بشكل دائم.
إذا حدث تجاوز فشل، تقوم العملية بترقية خادم الاستعداد فقط ليصبح الخادم الأساسي الجديد. خادم النسخ WAL غير مروج له ويستخدم فقط للمساعدة في الحفاظ على نصاب الالتزام.
يمكنك تعطيل التوفر العالي، مما يزيل النسخة الاحتياطية.
يمكنك اختيار مناطق التوفر لخوادم قاعدة البيانات الأساسية وخوادم قاعدة البيانات الاحتياطية لتوفر عالي التكرار في المنطقة.
يمكنك تنفيذ عمليات مثل الإيقاف والبدء وإعادة التشغيل على كل من خوادم قاعدة البيانات الأساسية وخوادم قاعدة البيانات الاحتياطية في نفس الوقت.
يقوم خادم قاعدة البيانات الأساسي بإجراء النسخ الاحتياطي التلقائي بشكل دوري. في الوقت نفسه، تقوم النسخة المتماثلة الاحتياطية بأرشفة سجلات المعاملات باستمرار في تخزين النسخ الاحتياطي. بالنسبة للخوادم الاحتياطية في المناطق، يتم تخزين بيانات النسخ الاحتياطي على تخزين احتياطي للمنطقة (ZRS). بالنسبة للخوادم التي تم تكوينها دون تكرار المنطقة، وخوادم المناطق (منطقة واحدة)، وفي المناطق التي لا تدعم مناطق التوفر، يتم تخزين بيانات النسخ الاحتياطي على التخزين الزائد محليا (LRS).
يتصل العملاء دائما باسم المضيف النهائي لخادم قاعدة البيانات الأساسي.
يتم تطبيق أي تغييرات على المعلمات أيضا على النسخة الاحتياطية.
يمكنك إعادة تشغيل الخادم لالتقاط أي تغييرات ثابتة في المعلمات.
تحدث أنشطة الصيانة الدورية مثل ترقيات الإصدار الثانوي في وضع الاستعداد أولا. لتقليل وقت التعطل، تعزز العملية الاستعداد إلى الأساسي بحيث يمكن الاحتفاظ بأحمال العمل أثناء تطبيق مهام الصيانة على العقدة المتبقية.
ملحوظة
لضمان توفر عالي بشكل صحيح، قم بتكوين قيم و max_replication_slotsmax_wal_senders المعاملات. يتطلب التوفر العالي أربعة من كل منها للتعامل مع عمليات تجاوز الفشل والترقيات السلسة. للحصول على إعداد عالي التوافر مع خمسة نسخ قراءة و12 فتحة تكرار منطقية، اضبط قيم المعلمات إلى max_replication_slotsmax_wal_senders 21. يعد هذا التكوين ضروريا لأن كل نسخة متماثلة للقراءة وفتحة نسخ متماثل منطقية تتطلب واحدة من كل منهما، بالإضافة إلى الأربعة اللازمة لقابلية الوصول العالية لتعمل بشكل صحيح. لمزيد من المعلومات حول max_replication_slots والمعايير max_wal_senders ، راجع وثائقهم.
أنواع دعم مناطق التوافر
يدعم قاعدة بيانات Azure لـ PostgreSQL كل من <نماذج التكرار في المناطق c0> والمناطق المتكررة لتكوينات التوافر العالي. يتيح كل من تكوينات قابلية الوصول العالية إمكانية تجاوز الفشل التلقائي مع عدم فقدان البيانات أثناء كل من الأحداث المخطط لها وغير المخطط لها.
المنطقة زائدة عن الحاجة. تنشر قابلية الوصول العالية المكررة للمنطقة نسخة متماثلة احتياطية في منطقة مختلفة مع إمكانية تجاوز الفشل التلقائي. يوفر تكرار المنطقة أعلى مستوى من التوفر، ولكنك تحتاج إلى تكوين تكرار التطبيق عبر المناطق. لهذا السبب، اختر تكرار المنطقة عندما تريد الحماية من حالات فشل مستوى منطقة التوفر وعندما يكون زمن الانتقال عبر مناطق التوفر مقبولا. بينما يمكن أن يكون هناك بعض تأثير زمن الانتقال على عمليات الكتابة والتثبيت بسبب النسخ المتماثل المتزامن، فإنه لا يؤثر على استعلامات القراءة. هذا التأثير خاص بأحمال العمل الخاصة بك ونوع SKU الذي تحدده والمنطقة.
يمكنك اختيار المنطقة ومناطق التوفر لكل من الخوادم الأساسية والخوادم الاحتياطية. يتم توفير خادم النسخة المتماثلة الاحتياطية في منطقة التوفر المختارة في نفس المنطقة مع حساب وتخزين وتكوين شبكة مماثلة كخادم أساسي. يتم تخزين ملفات البيانات وملفات سجل المعاملات (سجلات الكتابة المسبقة، والمعروفة أيضا باسم WAL) على مساحة تخزين متكررة محليا (LRS) داخل كل منطقة توافر خدمات، وتخزين ثلاث نسخ بيانات تلقائيا. يوفر التكوين المتكرر للمنطقة عزلا ماديا للمكدس بأكمله بين الخوادم الأساسية وخوادم الاستعداد.
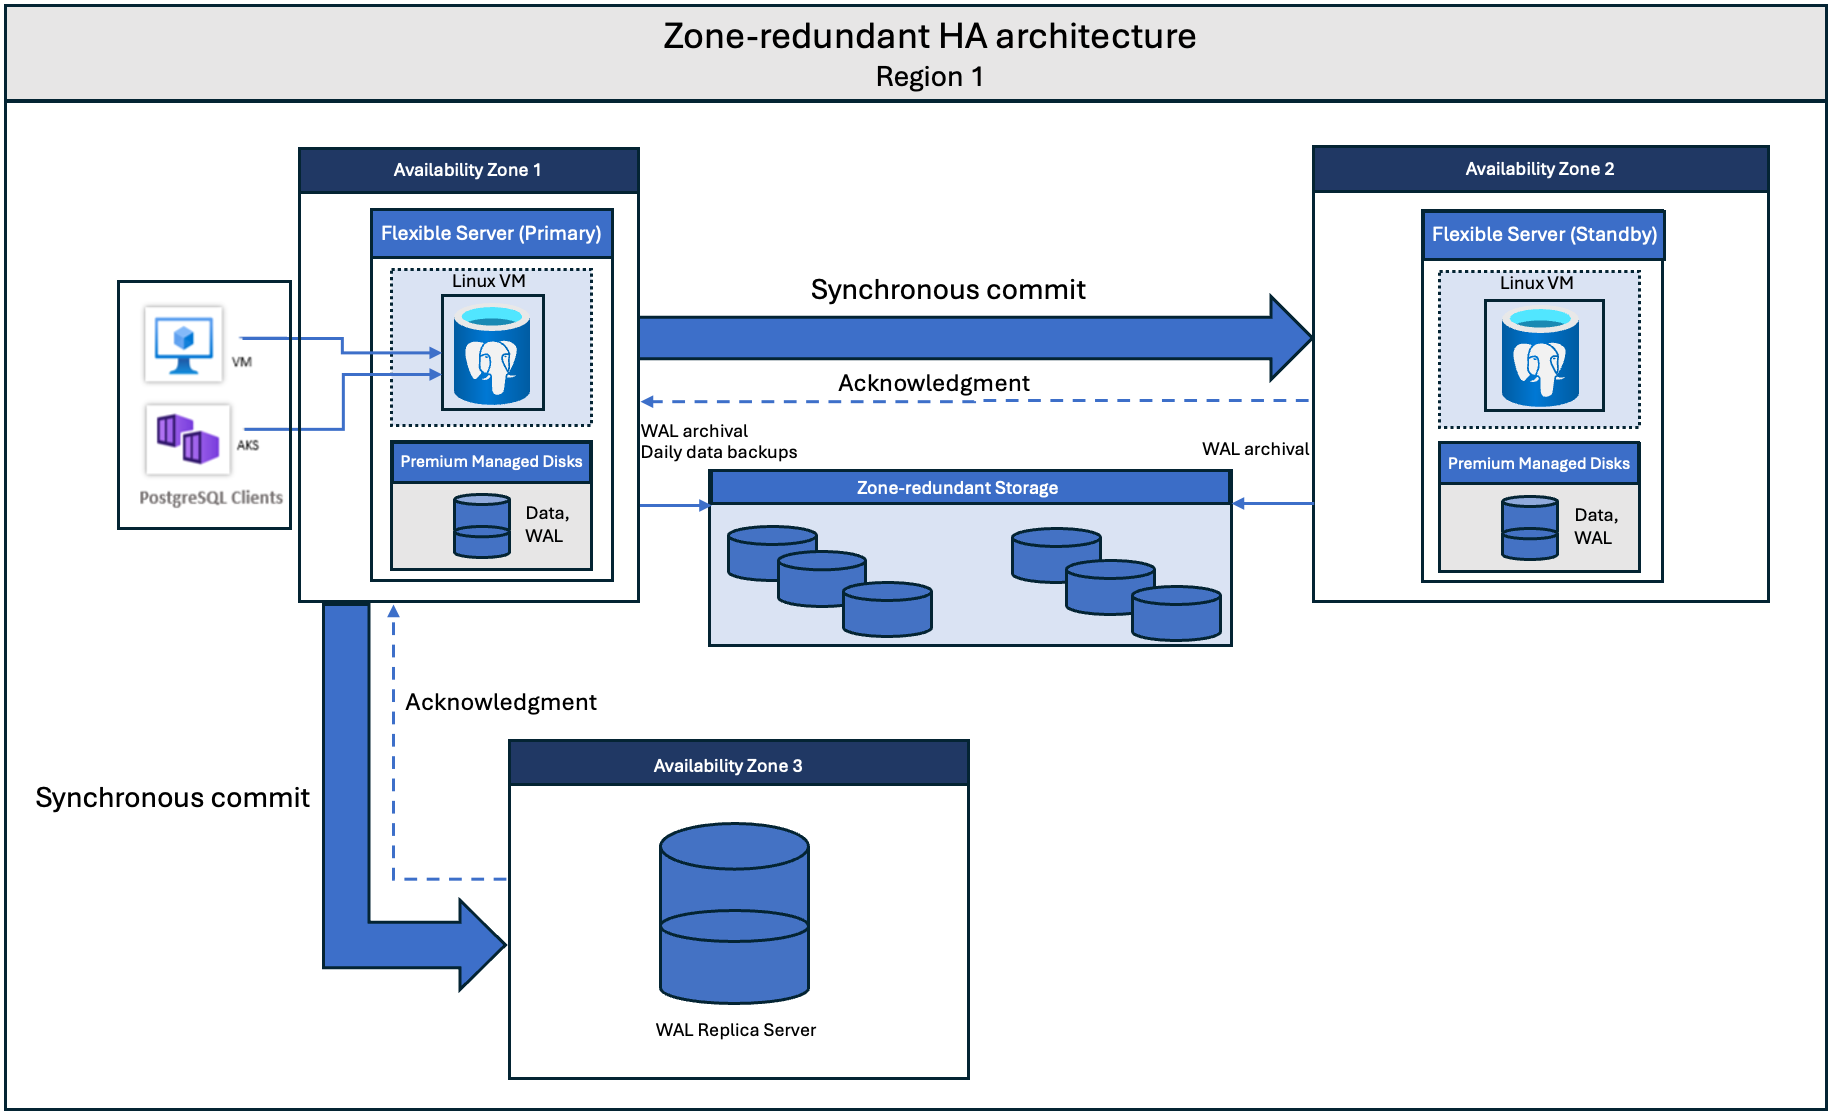
يتوفر خيار المنطقة المكررة فقط في المناطق التي لديها دعم لمناطق التوفر.
المنطقة الزائدة عن الحاجة غير مدعومة لما يلي:
- طبقة الحوسبة القابلة للاندفاع
- المناطق ذات التوفر في منطقة واحدة
نفس المنطقة (المنطقة). اختر توزيع نطاقي عندما تريد تحقيق أعلى مستوى من التوفر داخل منطقة توفر واحدة، ولكن مع أقل زمن انتقال للشبكة. يمكنك اختيار المنطقة ومنطقة التوفر لنشر كل من خادم قاعدة البيانات الأساسي. يتم توفير خادم النسخة المتماثلة الاحتياطية وإدارتها تلقائيا في نفس منطقة التوفر - مع حساب وتخزين وتكوين شبكة مماثلة - كخادم أساسي. يحمي التكوين النطاقي قواعد البيانات الخاصة بك من حالات الفشل على مستوى العقدة ويساعد أيضا في تقليل وقت تعطل التطبيق أثناء أحداث وقت التعطل المخطط لها وغير المخطط لها. يتم نسخ البيانات من الخادم الأساسي إلى النسخة المتماثلة الاحتياطية في وضع متزامن. في حالة حدوث أي انقطاع في الخادم الأساسي، يفشل الخادم تلقائيا في النسخة المتماثلة الاحتياطية.
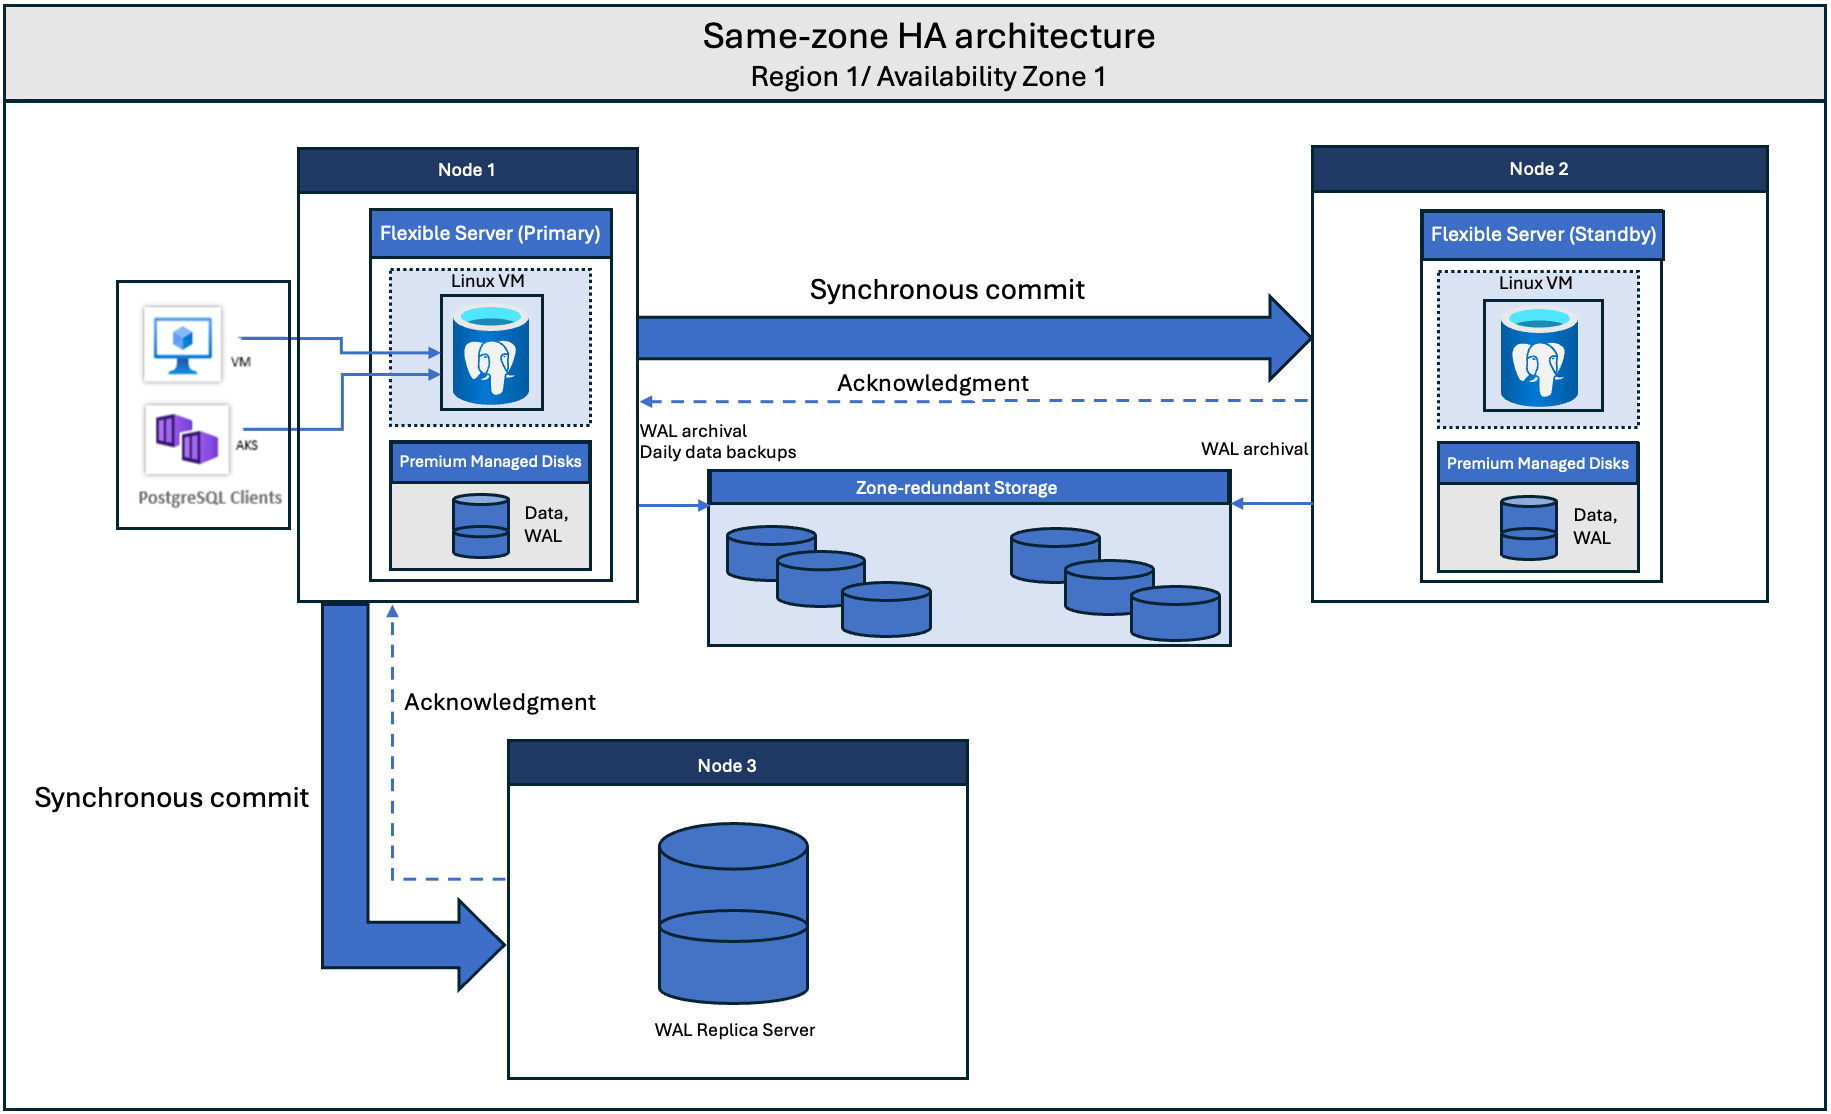
خيار النشر zonal متاح في جميع مناطق Azure حيث يمكنك نشر خادم مرن.
ملحوظة
يتصرف كل من نماذج التوزيع المناطقية ونماذج التوزيع المتكررة في المنطقة بنفس الطريقة من الناحية المعمارية. تنطبق المناقشات المختلفة في الأقسام التالية على كليهما ما لم يتم استدعاؤها بخلاف ذلك.
التعافي من أعطال المناطق
Zone-redundant: قاعدة بيانات Azure لـ PostgreSQL يفشل تلقائيا في الانتقال إلى الخادم الاحتياطي خلال 60-120 ثانية دون فقدان بيانات.
الزونال: إذا فشلت المنطقة، لا تتوفر الخوادم الأساسية أو الاحتياطية. للتعافي من فشل على مستوى المنطقة، يمكنك إجراء استعادة زمنية باستخدام النسخ الاحتياطية. يمكنك اختيار نقطة استعادة مخصصة مع أحدث وقت لاستعادة أحدث البيانات. يتم نشر خادم مرن جديد في منطقة أخرى غير متأثرة. يعتمد الوقت المستغرق للاستعادة على النسخ الاحتياطي السابق وحجم سجلات المعاملات للاسترداد.
لمزيد من المعلومات حول الاستعادة الزمنية النقطية، راجع النسخ الاحتياطي والاستعادة في قاعدة بيانات Azure لـ PostgreSQL-Flexible Server.
اتفاقية مستوى الخدمة (SLA)
نموذج التكرار في المنطقة يوفر وقت تشغيل لاتفاقية مستوى الخدمة (SLA) حوالي 99.99%. يوفر نموذج زونال وقت تشغيل لنظام SLA حوالي 99.95%.
قاعدة بيانات Azure لـ PostgreSQL بدون توفر عالي
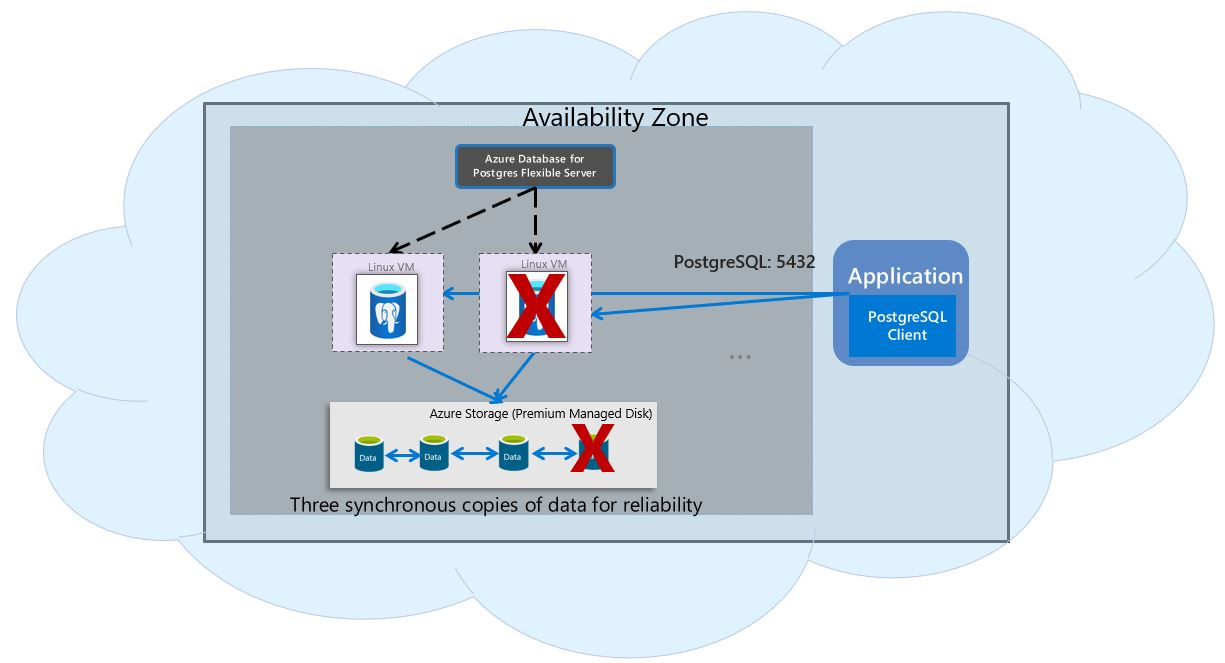
على الرغم من عدم التوصية بذلك، يمكنك تكوين خادمك المرن دون تفعيل توفر عالي. بالنسبة للخوادم المرنة التي تم تكوينها بدون توفر عالي، توفر الخدمة تخزينا محليا احتياطيا مع ثلاث نسخ من البيانات، ومرونة مدمجة لإعادة تشغيل خادم معطل تلقائيا ونقل الخادم إلى عقدة فيزيائية أخرى. يوفر هذا التكوين نظام مستوى خدمة (SLA) أقل من الخوادم ذات التوفر العالي. أثناء أحداث تجاوز الفشل المخطط لها أو غير المخطط لها، في حالة تعطل الخادم، تحتفظ الخدمة بتوفر الخوادم باستخدام الإجراء التلقائي التالي:
- تم توفير آلة افتراضية جديدة للحوسبة على لينكس.
- يتم تعيين التخزين مع ملفات البيانات إلى الجهاز الظاهري الجديد.
- يتم إحضار محرك قاعدة بيانات PostgreSQL عبر الإنترنت على الجهاز الظاهري الجديد.
توضح الصورة التالية الانتقال بين الجهاز الظاهري وفشل التخزين.
تكوين خيارات الأعمال الحرجة (عالية التوافر)
يمكنك تكوين التوافر العالي (HA) بطريقتين: HA الاحتياطي في المنطقة، الذي يضع خادم الاستعداد في منطقة توفر مختلفة لتحقيق أقصى مرونة في المنطقة، أو HA في نفس المنطقة، الذي ينشر الخادم الاحتياطي في نفس المنطقة مع الخادم الأساسي لتقليل التأخير.
يوفر قسم Business Critical (قابلية وصول عالية) خيارا لإنشاء خادم قابلية وصول عالية الاستعداد مع تكوين المنطقة المكررة . لتبسيط التكوين وضمان مرونة المناطق، توفر البوابة خيار مرونة المناطق مع زرين للراديو: مفعل ومعطل. يحاول تحديد ممكن إنشاء خادم الاستعداد في منطقة توفر مختلفة (وضع HA المتكرر في المنطقة). إذا لم تكن المنطقة تدعم ال HA المتكرر في المنطقة، يمكنك اختيار خيار الاحتياط لتفعيل HA في نفس المنطقة (المنطقة) بدلا من ذلك.
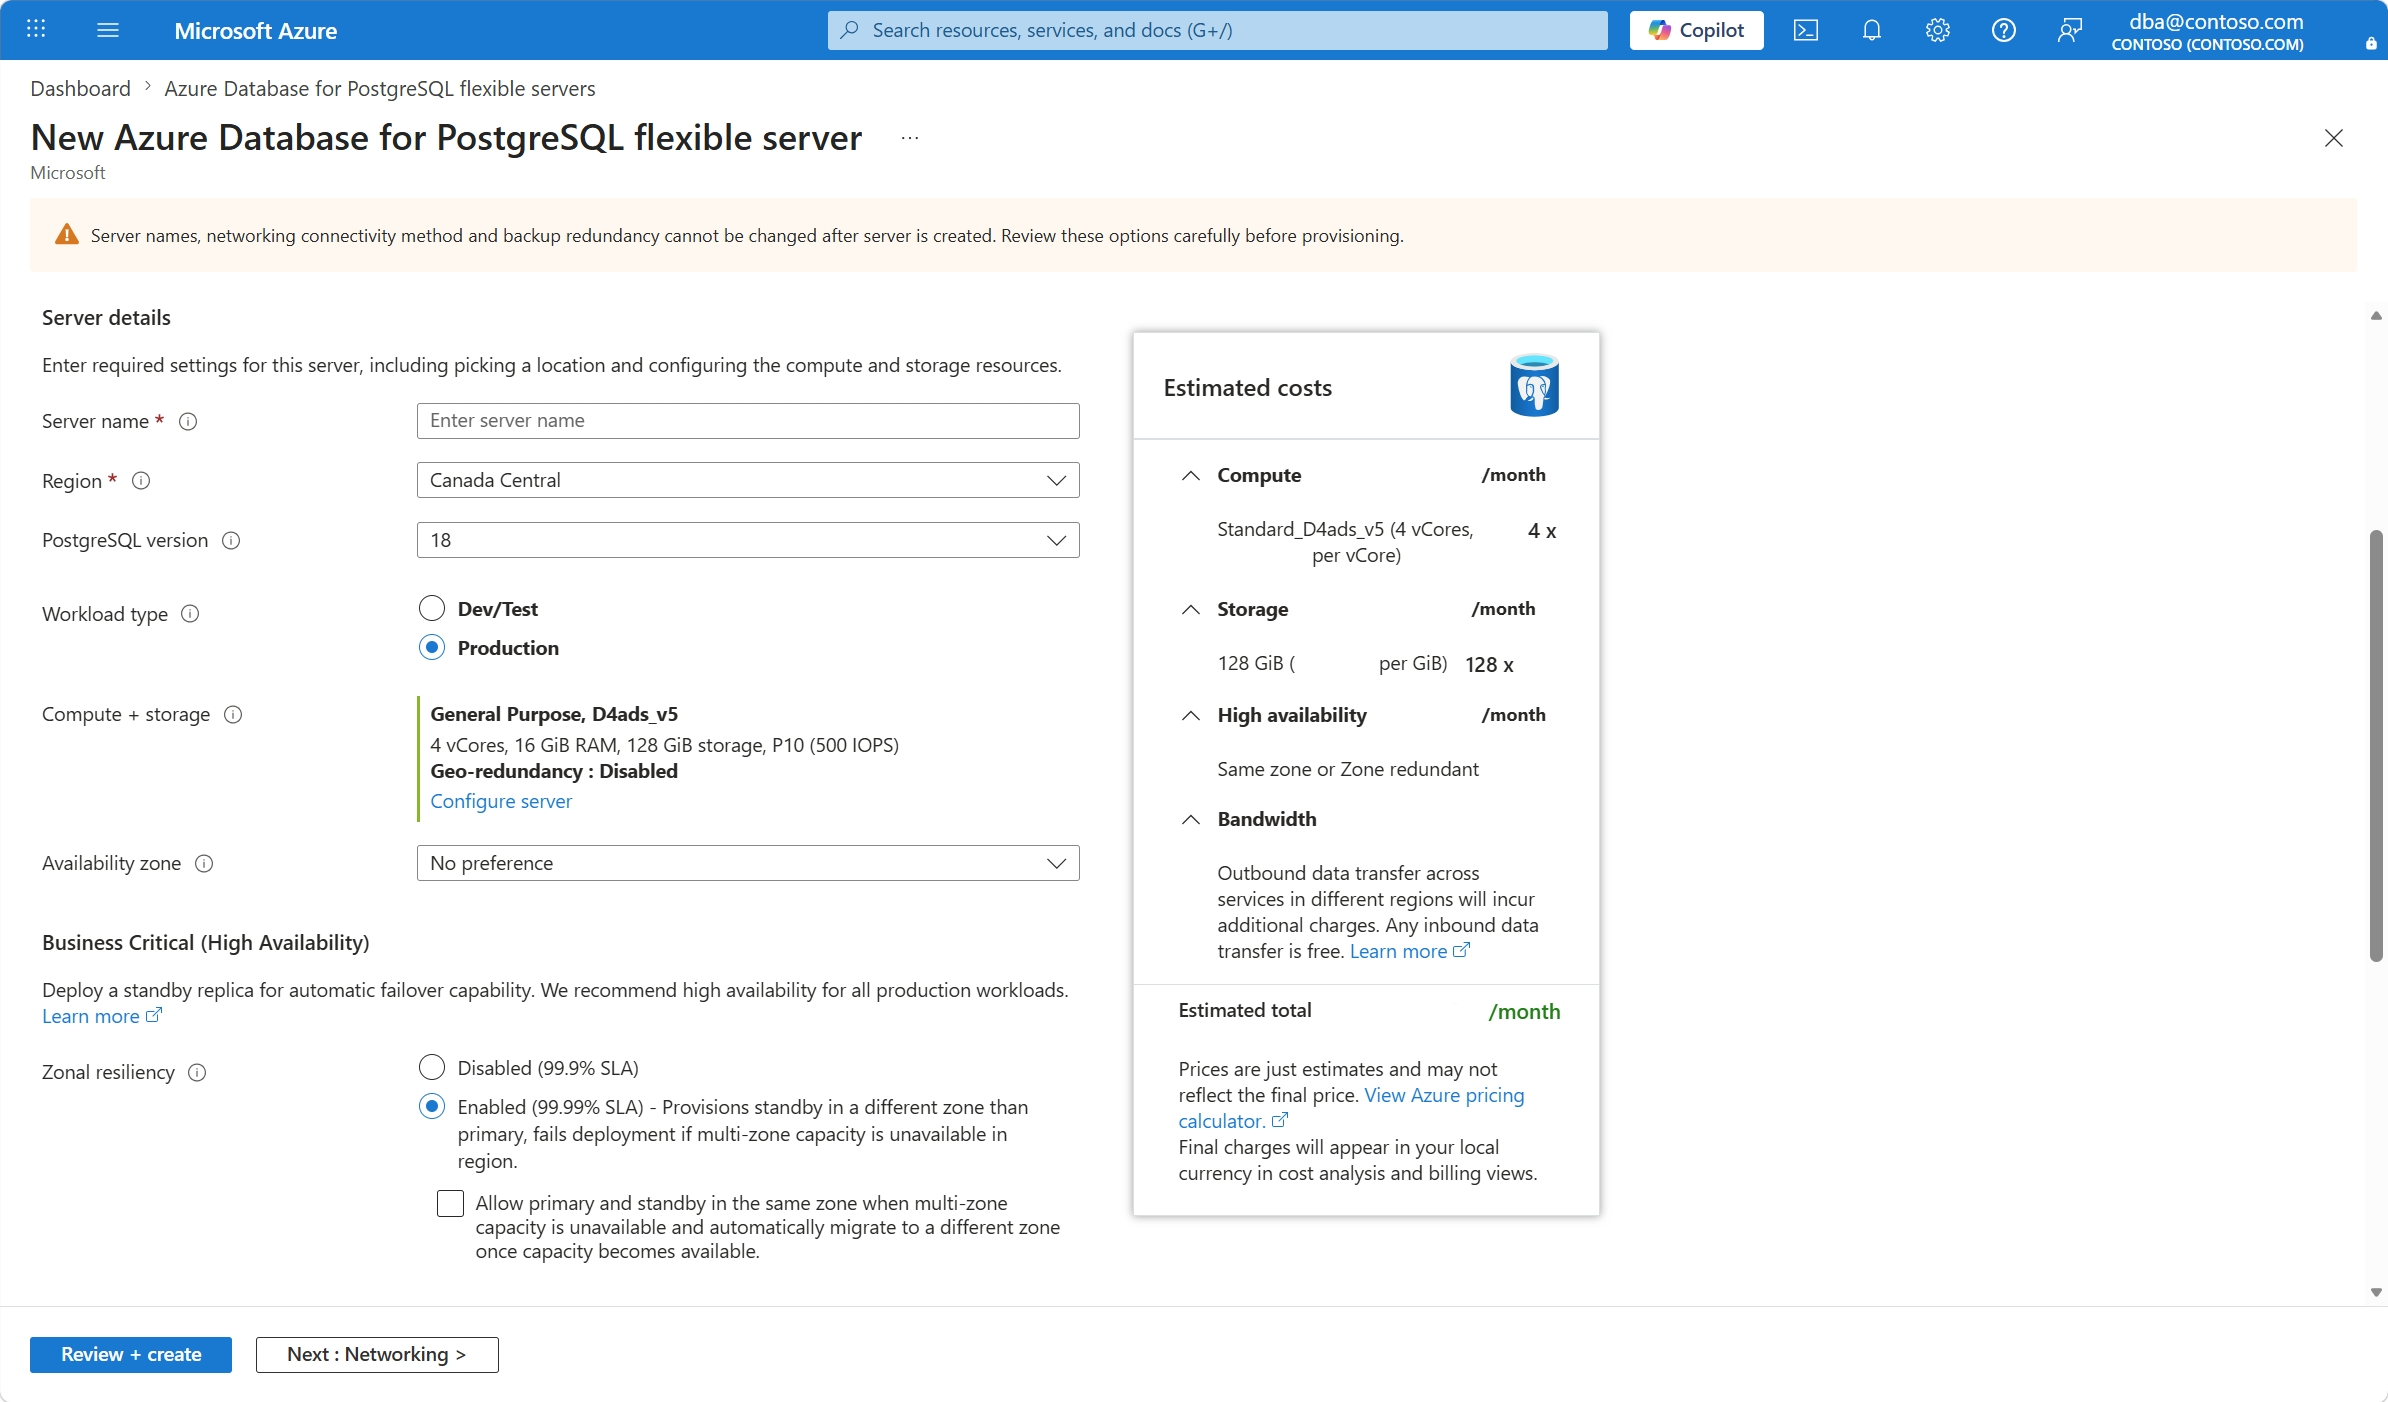
عند اختيار مربع اختيار الاحتياط، ينشئ النظام خادم الاحتياط في نفس المنطقة. إذا أصبحت سعة المناطق متاحة لاحقا، يقوم Azure تلقائيا بنقل أحمال العمل من HA في نفس المنطقة إلى HA المتكرر في المنطقة. إذا لم تقم بتحديد خانة الاختيار ولم تكن سعة المنطقة غير متوفرة، فسيفشل تمكين HA. يفرض هذا التصميم الاعتماد الثابت المتكرر في المنطقة كخيار افتراضي مع توفير بديل متحكم فيه لمنطقة HA نفسها، مما يضمن أن تحقق أعباء العمل في النهاية مرونة كاملة للمنطقة.
إنشاء قاعدة بيانات قاعدة بيانات Azure لـ PostgreSQL مع تفعيل منطقة التوفر
لتعلم كيفية إنشاء قاعدة بيانات Azure لـ PostgreSQL للتوافر العالي مع مناطق التوفر، راجع Quickstart: إنشاء قاعدة بيانات Azure لـ PostgreSQL في بوابة Azure.
إعادة توزيع منطقة التوفر وترحيلها
لمعرفة كيفية تمكين أو تعطيل تكوين قابلية الوصول العالية في الخادم المرن لديك في كل من نماذج النشر المتكررة للمنطقة والمناطق، راجع إدارة قابلية التوفر العالية في الخادم المرن.
مراقبة الصحة عالية التوفر
يوفر مراقبة حالة الصحة عالية التوافر (HA) في قاعدة بيانات قاعدة بيانات Azure لـ PostgreSQL نظرة عامة مستمرة على صحة وجاهزية النسختين المفعلة ب HA. تطبق هذه الميزة المراقبة إطار عمل Resource Health Check (RHC) في
استخدم مراقبة الحالة الصحية لحمض الهيالورونيك من أجل:
- احصل على رؤى في الوقت الحقيقي حول صحة كل من النسخ المتماثلة الأساسية والاحتياطية، مع مؤشرات الحالة التي تكشف عن المشكلات المحتملة، مثل تدهور الأداء أو حظر الشبكة.
- قم بإعداد تنبيهات للإشعارات في الوقت المناسب حول أي تغييرات في حالة HA، حتى تتمكن من اتخاذ إجراء فوري لمعالجة الاضطرابات المحتملة.
- تحسين جاهزية تجاوز الفشل عن طريق تحديد المشكلات ومعالجتها قبل أن تؤثر على عمليات قاعدة البيانات.
للحصول على دليل مفصل حول تكوين وتفسير حالات صحة HA، راجع High Availability Health Monitoring (HA) ل قاعدة بيانات Azure لـ PostgreSQL.
قيود قابلية الوصول العالية
التكرار بين الخادم الأساسي والخادم الاحتياطي يكون متزامن.
لا يمكنك استخدام خادم HA الاحتياطي لاستعلامات القراءة.
اعتمادا على حمل العمل والنشاط على الخادم الأساسي، قد تستغرق عملية تجاوز الفشل أكثر من 120 ثانية لأن النسخة المتماثلة في وضع الاستعداد تحتاج إلى الاسترداد قبل ترقيتها.
عادة ما يسترد خادم الاستعداد ملفات WAL بمعدل 40 ميغابايت/ثانية. بالنسبة للإصدارات الأكبر ، يمكن أن يزيد هذا المعدل إلى 200 ميجابايت / ثانية. إذا تجاوز حمل العمل هذا الحد، يمكنك أن تواجه وقتا ممتدا لإكمال الاسترداد إما أثناء تجاوز الفشل أو بعد إنشاء وضع الاستعداد الجديد.
تؤدي إعادة تشغيل خادم قاعدة البيانات الأساسي أيضا إلى إعادة تشغيل النسخة المتماثلة الاحتياطية.
لا يمكنك تكوين وضع استعداد إضافي.
لا يمكنك جدولة مهام الإدارة التي بدأها العميل أثناء نافذة الصيانة المدارة.
تحدث الأحداث المخطط لها مثل الحوسبة على نطاق واسع وتخزين القياس في وضع الاستعداد أولا ثم على الخادم الأساسي. حاليا، الخادم لا يفشل في هذه العمليات المخطط لها.
تكوين مناطق التوفر بين الوصول الخاص (الشبكة الظاهرية) والوصول العام مع نقاط النهاية الخاصة غير مدعوم. يجب تكوين مناطق التوفر داخل شبكة ظاهرية (تمتد عبر مناطق التوفر داخل المنطقة) أو الوصول العام باستخدام نقاط النهاية الخاصة.
يمكنك فقط تكوين مناطق التوفر داخل منطقة واحدة. لا يمكنك تكوين مناطق التوفر عبر المناطق.
مكونات قابلية الوصول العالية وسير العمل
إكمال المعاملة
تؤدي معاملة التطبيق إلى عملية كتابة والتزام تسجل أولا إلى WAL على الخادم الرئيسي. يقوم الخادم الأساسي بدفق هذه السجلات إلى خادم الاستعداد باستخدام بروتوكول دفق Postgres. عندما يستمر تخزين الخادم الاحتياطي في السجلات، يقر الخادم الأساسي بإكمال الكتابة. لا يلتزم التطبيق معاملته إلا بعد هذا الإقرار. تضيف هذه الرحلة الإضافية ذهابا وإيابا زمن انتقال إلى طلبك. تعتمد نسبة التأثير على التطبيق. لا تنتظر عملية الإقرار هذه حتى يتم تطبيق السجلات على خادم الاستعداد. يظل خادم الاستعداد في وضع الاسترداد حتى يتم ترقيته.
فحص الصحة
تتحقق المراقبة المرنة لسلامة الخادم بشكل دوري من صحة كل من الخوادم الأساسية والاحتياطية. بعد إختبارات الاتصال المتعددة، إذا اكتشفت مراقبة السلامة أنه لا يمكن الوصول إلى خادم أساسي، تبدأ الخدمة تجاوز الفشل التلقائي إلى الخادم الاحتياطي. تستخدم خوارزمية مراقبة الصحة نقاط بيانات متعددة لتجنب المواقف الإيجابية الخاطئة.
أوضاع تجاوز الفشل
يدعم الخادم المرن وضعي تجاوز الفشل، تجاوز الفشل المخطط له وتجاوز الفشل غير المخطط له. في كلا الوضعين، بمجرد توقف النسخ المتماثل، يقوم خادم الاستعداد بتشغيل الاسترداد قبل الترقية كأساسي ويفتح للقراءة/الكتابة. مع تحديث إدخالات DNS التلقائية بنقطة نهاية الخادم الأساسي الجديدة، يمكن للتطبيقات الاتصال بالخادم باستخدام نفس نقطة النهاية. يتم إنشاء خادم الاستعداد الجديد في الخلفية، بحيث يمكن للتطبيق الخاص بك الحفاظ على الاتصال.
حالة قابلية الوصول العالية
يراقب النظام باستمرار صحة الخوادم الأساسية والاحتياطية. يتخذ الإجراءات المناسبة لإصلاح المشكلات، بما في ذلك تشغيل تجاوز الفشل إلى الخادم الاحتياطي. يسرد الجدول التالي حالات قابلية الوصول العالية المحتملة:
| Status | الوصف |
|---|---|
| تتم الآن تهيئة | في عملية إنشاء خادم احتياطي جديد. |
| النسخ المتماثل للبيانات | بعد إنشاء وضع الاستعداد، يتم اللحاق بالمرحلة الأساسية. |
| صحية | النسخ المتماثل في حالة ثابتة وصحية. |
| تجاوز الفشل | خادم قاعدة البيانات في عملية تجاوز الفشل في وضع الاستعداد. |
| إزالة وضع الاستعداد | في عملية حذف خادم الاستعداد. |
| غير ممكن | لم يتم تمكين قابلية الوصول العالية. |
ملحوظة
يمكنك تمكين قابلية الوصول العالية أثناء إنشاء الخادم أو في وقت لاحق. إذا قمت بتمكين قابلية الوصول العالية أو تعطيلها أثناء مرحلة ما بعد الإنشاء، فقم بذلك عندما يكون نشاط الخادم الأساسي منخفضا.
عمليات الحالة الثابتة
تتصل تطبيقات عميل PostgreSQL بالخادم الأساسي باستخدام اسم خادم قاعدة البيانات. يخدم الخادم الأساسي قراءات التطبيق مباشرة. في الوقت نفسه، يتلقى التطبيق تأكيدا للالتزامات ويكتب فقط بعد استمرار بيانات السجل على كل من الخادم الأساسي والنسخة المتماثلة الاحتياطية. نظرا لهذه الرحلة الإضافية ذهابا وإيابا، يمكن للتطبيقات توقع زمن انتقال مرتفع للكتابات والتثبيتات. يمكنك مراقبة صحة قابلية الوصول العالية على المدخل.
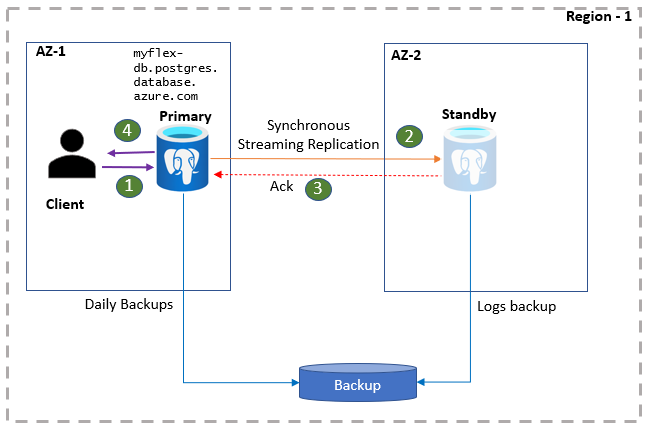
- يتصل العملاء بالخادم المرن وينفذون عمليات الكتابة.
- يتم نسخ التغييرات إلى موقع الاستعداد.
- يتلقى الأساسي إقرارا.
- يتم الاعتراف بالكتابة والالتزامات.
استعادة الخوادم عالية التوفر في نقطة زمنية
بالنسبة للخوادم المرنة التي تم تكوينها بقابلية وصول عالية، يقوم النظام بنسخ بيانات السجل في الوقت الفعلي إلى الخادم الاحتياطي. يتم نسخ أي أخطاء مستخدم على الخادم الأساسي - مثل السقوط العرضي لجدول أو تحديثات البيانات غير الصحيحة - إلى النسخة المتماثلة الاحتياطية. لذلك ، لا يمكنك استخدام وضع الاستعداد للتعافي من مثل هذه الأخطاء المنطقية. للتعافي من مثل هذه الأخطاء، يجب عليك إجراء استعادة في نقطة زمنية من النسخة الاحتياطية. باستخدام إمكانية الاستعادة في نقطة زمنية لخادم مرن، يمكنك الاستعادة إلى الوقت السابق لحدوث الخطأ. يتم استعادة خادم قاعدة بيانات جديد كخادم مرن لمنطقة واحدة (منطقة واحدة) مع اسم خادم جديد مقدم من المستخدم لقواعد البيانات المهيأة بتوفر عالي. يمكنك استخدام الخادم المستعاد لعدة حالات استخدام:
استخدم الخادم المستعاد للإنتاج وقم اختياريا بتمكين قابلية الوصول العالية باستخدام النسخة المتماثلة في وضع الاستعداد إما في نفس المنطقة أو منطقة أخرى في نفس المنطقة.
إذا كنت تريد استعادة كائن، فقم بتصديره من خادم قاعدة البيانات المستعادة واستيراده إلى خادم قاعدة بيانات الإنتاج.
إذا كنت ترغب في استنساخ خادم قاعدة البيانات لأغراض الاختبار والتطوير أو الاستعادة لأي أغراض أخرى، يمكنك إجراء الاستعادة في نقطة زمنية.
لمعرفة كيفية إجراء استعادة في نقطة زمنية لخادم مرن، راجع استعادة خادم مرن في نقطة زمنية.
دعم تجاوز الفشل
تجاوز الفشل المخطط له
تشمل أحداث التوقف المخطط لها تحديثات برمجية دورية مجدولة من Azure وترقيات طفيفة للإصدارات. يمكنك أيضا استخدام تجاوز فشل مخطط لإرجاع الخادم الأساسي إلى منطقة توفر مفضلة. عند تكوين قابلية وصول عالية، تنطبق هذه العمليات أولا على النسخة المتماثلة الاحتياطية بينما تستمر التطبيقات في الوصول إلى الخادم الأساسي. بمجرد أن تقوم العملية بتحديث النسخة المتماثلة في وضع الاستعداد، فإنها تستنزف اتصالات الخادم الأساسي وتؤدي إلى تجاوز الفشل الذي ينشط النسخة المتماثلة الاحتياطية كخادم أساسي بنفس اسم خادم قاعدة البيانات. تعيد تطبيقات العميل الاتصال بنفس اسم خادم قاعدة البيانات بالخادم الأساسي الجديد ويمكنها استئناف عملياتها. تنشئ العملية خادم احتياطيا جديدا في نفس المنطقة مثل الخادم الأساسي القديم.
نصيحة
عندما يكون لديك خادم مرن احتياطي من المنطقة، يمكنك أيضا استخدام نظام الفشل المخطط له لإعادة الخادم الأساسي إلى منطقة توفر مفضلة مع تقليل وقت التوقف. على سبيل المثال، قد يكون الخادم الأساسي في منطقة توفر مختلفة عن التطبيق بعد تجاوز الفشل غير المخطط له. عملية التبديل المخطط لها تعيد الخادم الأساسي إلى منطقته الأصلية، وتنشئ خادم احتياطي جديد في نفس المنطقة مع الخادم الأساسي القديم.
بالنسبة للعمليات الأخرى التي بدأها المستخدم مثل الحوسبة على نطاق واسع أو تخزين القياس، تطبق العملية التغييرات على وضع الاستعداد أولا، ثم الأساسي. حاليا، لا تفشل الخدمة في وضع الاستعداد. وبالتالي، أثناء تشغيل عملية القياس على الخادم الأساسي، تواجه التطبيقات وقت تعطل قصير.
يمكنك أيضا استخدام هذه الميزة للفشل في الانتقال إلى خادم الاستعداد مع تقليل وقت التوقف. على سبيل المثال، قد يكون الخادم الأساسي في منطقة توفر مختلفة عن التطبيق بعد تجاوز الفشل غير المخطط له. تريد إعادة الخادم الأساسي إلى المنطقة السابقة للتكوين مع التطبيق الخاص بك.
عند تنفيذ هذه الميزة، تقوم العملية أولا بإعداد الخادم الاحتياطي للتأكد من أنه يلحق بالمعاملات الأخيرة، مما يسمح للتطبيق بمواصلة إجراء عمليات القراءة والكتابة. تعزز العملية وضع الاستعداد وتقطع الاتصالات بالأساسي. يمكن أن يستمر تطبيقك في الكتابة إلى الأساسي بينما تنشئ العملية خادما احتياطيا جديدا في الخلفية. يصف الجدول التالي الخطوات المتضمنة في تجاوز الفشل المخطط له:
| خطوة |
الوصف | هل من المتوقع أن يكون وقت تعطل التطبيق؟ |
|---|---|---|
| 1 | انتظر حتى يلحق الخادم الاحتياطي بالأساسي. | لا. |
| 2 | يبدأ نظام المراقبة الداخلية سير عمل تجاوز الفشل. | لا. |
| 3 | يتم حظر عمليات كتابة التطبيق عندما يكون خادم الاستعداد قريبا من رقم تسلسل السجل الأساسي (LSN). | نعم |
| 4 | تتم ترقية خادم الاستعداد ليكون خادماً مستقلاً. | نعم |
| 5 | يتم تحديث سجل DNS بعنوان IP الخاص بخادم الاستعداد الجديد. | نعم |
| 6 | يعيد التطبيق الاتصال ويستأنف القراءة / الكتابة مع أساسي جديد. | لا. |
| 7 | تم إنشاء خادم احتياطي جديد. بالنسبة للخوادم الاحتياطية في المناطق، يكون الخادم الجديد في منطقة أخرى. | لا. |
| 8 | يبدأ خادم الانتظار في استعادة السجلات (من Azure Blob) التي فاتته أثناء تأسيسه. | لا. |
| 9 | يتم إنشاء حالة ثابتة بين الخادم الأساسي وخادم الاستعداد. | لا. |
| 10 | اكتملت عملية تجاوز الفشل المخطط لها. | لا. |
يبدأ وقت تعطل التطبيق في الخطوة 3 ويمكن أن يستأنف التشغيل بعد الخطوة 5. تحدث بقية الخطوات في الخلفية دون التأثير على عمليات الكتابة والتثبيت للتطبيق.
نصيحة
مع الخادم المرن، يمكنك اختيار جدولة أنشطة الصيانة التي بدأها Azure باختيار نافذة مدتها 60 دقيقة في يوم تفضله عندما من المتوقع أن تكون الأنشطة على قواعد البيانات منخفضة. مهام صيانة Azure مثل التحديثات أو ترقيات الإصدارات البسيطة تحدث خلال تلك الفترة. إذا لم تختر نافذة مخصصة، يخصص النظام نافذة مدتها ساعة واحدة بين الساعة 11 مساء و7 صباحا بالتوقيت المحلي للخادم الخاص بك. تعمل هذه الأنشطة الصيانة التي بدأتها Azure أيضا على نسخة الاستعداد للخوادم المرنة المكونة بمناطق التوفر.
للحصول على قائمة بأحداث وقت التعطل المخطط لها المحتملة، راجع أحداث وقت التعطل المخطط لها.
تجاوز الفشل غير المخطط له
يمكن أن تحدث أوقات تعطل غير مخطط لها بسبب اضطرابات غير متوقعة مثل أخطاء الأجهزة الأساسية ومشاكل الشبكات وأخطاء البرامج. إذا انخفض خادم قاعدة البيانات الذي قمت بتكوينه بقابلية وصول عالية بشكل غير متوقع، تقوم العملية بتنشيط النسخة المتماثلة الاحتياطية ويمكن للعملاء استئناف عملياتهم. إذا لم تقم بتكوين قابلية وصول عالية (HA) وفشلت محاولة إعادة التشغيل، تقوم العملية تلقائيا بتوفير خادم قاعدة بيانات جديد. بينما لا يمكنك تجنب وقت التعطل غير المخطط له، يساعد الخادم المرن على التخفيف من وقت التعطل عن طريق إجراء عمليات الاسترداد تلقائيا دون الحاجة إلى تدخل بشري.
للحصول على معلومات حول تجاوز الفشل غير المخطط له ووقت التعطل، بما في ذلك السيناريوهات المحتملة، راجع التخفيف من وقت التعطل غير المخطط له.
تجاوز الفشل القسري
استخدم تجاوز فشل إجباري لاختبار تجاوز الفشل لمحاكاة سيناريو انقطاع غير مخطط له أثناء تشغيل حمل عمل الإنتاج. يمكنك مراقبة وقت تعطل التطبيق الخاص بك. يمكنك أيضا استخدام تجاوز الفشل القسري عندما يصبح الخادم الأساسي غير مستجيب.
يؤدي تجاوز الفشل القسري إلى خفض الخادم الأساسي وبدء سير عمل تجاوز الفشل الذي يتم فيه تنفيذ عملية ترقية وضع الاستعداد. بمجرد أن يكمل وضع الاستعداد عملية الاسترداد حتى آخر بيانات ملتزم بها، يتم ترقيته ليكون الخادم الأساسي. يتم تحديث سجلات DNS، ويمكن للتطبيق الاتصال بالخادم الأساسي الذي تمت ترقيته. يمكن أن يستمر تطبيقك في الكتابة إلى الأساسي أثناء إنشاء خادم الاستعداد الجديد في الخلفية، والذي لا يؤثر على وقت التشغيل.
يصف الجدول التالي الخطوات أثناء تجاوز الفشل الإجباري:
| خطوة |
الوصف | هل من المتوقع أن يكون وقت تعطل التطبيق؟ |
|---|---|---|
| 1 | يتوقف الخادم الأساسي بعد فترة وجيزة من تلقي طلب تجاوز الفشل. | نعم |
| 2 | يواجه التطبيق وقت تعطل لأن الخادم الأساسي معطل. | نعم |
| 3 | يكتشف نظام المراقبة الداخلية الفشل ويبدأ تجاوز الفشل إلى خادم الاستعداد. | نعم |
| 4 | يدخل خادم الاستعداد وضع الاسترداد قبل ترقيته بالكامل كخادم مستقل. | نعم |
| 5 | تنتظر عملية تجاوز الفشل حتى يكتمل الاسترداد في وضع الاستعداد. | نعم |
| 6 | بمجرد تشغيل الخادم، تقوم العملية بتحديث سجل DNS بنفس اسم المضيف ولكنها تستخدم عنوان IP الخاص بالاستعداد. | نعم |
| 7 | يمكن للتطبيق إعادة الاتصال بالخادم الأساسي الجديد واستئناف العملية. | لا. |
| 8 | يتم إنشاء خادم الاستعداد في المنطقة المفضلة. | لا. |
| 9 | يبدأ خادم الانتظار في استعادة السجلات (من Azure Blob) التي فاتته أثناء تأسيسه. | لا. |
| 10 | يتم إنشاء حالة ثابتة بين الخادم الأساسي وخادم الاستعداد. | لا. |
| 11 | اكتملت عملية تجاوز الفشل القسري. | لا. |
يبدأ وقت تعطل التطبيق بعد الخطوة 1 ويستمر حتى انتهاء الخطوة 6. الخطوات المتبقية تعمل في الخلفية، دون التأثير على كتابة التطبيقات والالتزامات.
مهم
تتضمن عملية تجاوز الفشل من طرف إلى طرف (أ) الفشل في خادم الاستعداد بعد الفشل الأساسي و(ب) إنشاء خادم استعداد جديد في حالة ثابتة. نظرا لأن تطبيقك يتحمل وقت تعطل حتى يكتمل تجاوز الفشل في وضع الاستعداد، فقم بقياس وقت التوقف عن العمل من منظور التطبيق/العميل بدلا من عملية تجاوز الفشل الشاملة من طرف إلى طرف.
اعتبارات عند إجراء عمليات تجاوز الفشل القسري
يمكن أن يكون وقت التشغيل الإجمالي من طرف إلى طرف أطول من وقت التوقف الفعلي الذي يعاني منه التطبيق.
مهم
لاحظ دائما وقت التعطل من منظور التطبيق!
لا تقم بإجراء عمليات تجاوز الفشل الفورية والخلفية. انتظر لمدة 15-20 دقيقة على الأقل بين عمليات تجاوز الفشل، حتى يمكن إنشاء خادم الاستعداد الجديد بالكامل.
قم بإجراء تجاوز فشل إجباري خلال فترة نشاط منخفض لتقليل وقت التوقف عن العمل.
أفضل الممارسات لإحصائيات PostgreSQL بعد تجاوز الفشل
بعد فشل PostgreSQL، يتطلب الحفاظ على الأداء الأمثل لقواعد البيانات فهم الأدوار المميزة ل pg_statistic ومنظورات pg_stat_* .
pg_statistic يخزن الجدول إحصائيات المحسن ، والتي تعتبر ضرورية لمخطط الاستعلام. تتضمن هذه الإحصائيات توزيعات البيانات داخل الجداول وتظل سليمة بعد تجاوز الفشل، ما يضمن أن مخطط الاستعلام يمكنه الاستمرار في تحسين تنفيذ الاستعلام بشكل فعال استنادا إلى معلومات توزيع البيانات التاريخية الدقيقة.
على النقيض من ذلك، توفر العروض pg_stat_* إحصائيات نشاط وقت التشغيل مثل عدد المسحات، وقراءة المجموعات، والتحديثات، ويتم تخزينها في الذاكرة ويتم إعادة ضبطها عند التحويل التلقائي. مثال على ذلك هو pg_stat_user_tables، الذي يتتبع النشاط للجداول المعرفة من قبل المستخدم. تعكس إعادة التعيين هذه بدقة الحالة التشغيلية للمرحلة الأساسية الجديدة ولكنها تعني أيضا فقدان مقاييس النشاط التاريخية التي يمكن أن تعلم عملية التفريغ التلقائي والكفاءات التشغيلية الأخرى.
نظرا لهذا التمييز، يجب أن تفكر في اللعب ANALYZE بعد فشل PostgreSQL. يقوم هذا الإجراء بتحديث pg_stat_* البيانات (على سبيل المثال، pg_stat_user_tables) بإحصائيات نشاط الفراغ الجديدة، مما يساعد عملية التفريغ التلقائي، والتي تضمن بدورها بقاء أداء قاعدة البيانات مثاليا في دورها الجديد. هذه الخطوة الاستباقية سد الفجوة بين الحفاظ على إحصائيات المحسن الأساسية وتحديث مقاييس النشاط لتتماشى مع الحالة الحالية لقاعدة البيانات.
دعم النسخ المنطقي مع HA
عند استخدام النسخ المنطقي أو فك الترميز المنطقي باستخدام التوفر العالي (HA) في قاعدة بيانات Azure لـ PostgreSQL Flexible Server، من المهم فهم كيفية تصرف فتحات النسخ أثناء الفشل وكيفية ضمان استمرارية النسخ.
PostgreSQL 16 وما قبلها
في PostgreSQL 16 وما قبله، لا يتم حفظ فتحات النسخ المنطقية تلقائيا على الخادم الاحتياطي بعد التحويل التلقائي. للحفاظ على التكرار المنطقي عبر التحويل التلقائي، يجب عليك:
- تفعيل الامتداد
pg_failover_slots - قم بضبط الإعدادات المطلوبة مثل:
hot_standby_feedback = on
بدون هذه التكوينات، قد يتوقف التكرار المنطقي عن العمل بعد التحويل المؤقت لأن فتحات النسخ غير متوفرة على النسخة الأساسية الجديدة.
PostgreSQL 17 وما بعده
بدءا من PostgreSQL 17، يتم دعم مزامنة فتحات النسخ المنطقية بشكل أصلي. عند تكوين هذه الميزة بشكل صحيح، يقوم النظام تلقائيا بمزامنة فتحات النسخ المتماثل إلى خادم الاستعداد.
لتمكين هذا السلوك:
- عيّن
sync_replication_slotsإلىon. - عيّن
hot_standby_feedbackإلىon.
مع هذه الإعدادات، يحافظ النظام على فتحات النسخ المتماثل المنطقية أثناء تجاوز الفشل، ويمكن أن يستمر النسخ المتماثل دون الحاجة إلى ملحقات. للحصول على التفاصيل، راجع وثائق ملحق PG_Failover_Slots .
اعتبارات مهمة
- يمكنك إدارة فتحات النسخ المتماثل المنطقية على الخادم الأساسي، ولكن يجب أن يحتوي خادم الاستعداد أيضا على هذه الفتحات لضمان استمرار النسخ المتماثل المنطقي بعد تجاوز فشل HA.
- تظهر عروض النظام (مثل الاستعلام)
pg_replication_slotsالحالة فقط على النقطة الأساسية ولا تؤكد ما إذا كانت الفتحات متزامنة مع الوضع الاحتياطي. يمكن أن يبدو النظام سليما على النقطة الأساسية لكنه لا يزال غير جاهز لتجاوز الفشل للحفاظ على فتحات التكرار المنطقي في الوضع الاحتياطي.
مراقبة جاهزية تجاوز الفشل للتكرار المنطقي
للمساعدة في التحقق من جاهزية تجاوز الفشل، استخدم مقياس logical_replication_slot_sync_statusAzure Monitor .
مهم
لإصدار هذا المقياس، تأكد من تعيين المعامل metrics.collector_database_activity على on.
تشير هذه المقياس إلى ما إذا كانت فتحات النسخ المنطقية متزامنة بين الفتحات الأساسية للذاكرة الهوماتية وفتحات الاستعداد الاحتياطية:
-
1يشير إلى أن الفتحات متزامنة عبر النقطة الأساسية والاحتياطية. -
0يشير إلى أن الفتحات غير متزامنة في وضع الاستعداد.
إذا كانت قيمة المقياس 0، فقد يستمر التكرار المنطقي في العمل على المرجع الأساسي الحالي، لكنه قد لا يستمر بعد التحويل. للحصول على قائمة كاملة بمقاييس التكرار المنطقي، انظر مراقبة التكرار المنطقي.
ملحوظة
تعكس حالة المزامنة هذه الحالة عبر عقد قابلية الوصول العالية ولا يمكن التحقق منها باستخدام طرق عرض النظام على الأساسي وحده. فكر في استخدام هذا المقياس مع التنبيهات لاكتشاف متى لا يكون التكرار المنطقي جاهزا لتجاوز الخطاب، خاصة قبل الصيانة المخطط لها أو أحداث التجاوز الخاطئ. فكر في تكوين التنبيهات عندما يبقى هذا المقياس صفرا لفترة طويلة.