الشبكات العصبية الالتفافية
- 15 دقائق
في الوحدة السابقة تعلمنا كيفية تعريف شبكة عصبية متعددة الطبقات بشكل عام. في هذه الوحدة سنتعرف على الشبكات العصبية الالتوائية (CNNs)، المصممة لرؤية الحاسوب.
الرؤية الحاسوبية تختلف عن التصنيف العام، لأنه عندما نحاول إيجاد جسم معين في الصورة، نقوم بمسح الصورة بحثا عن أنماط محددة وتركيباتها. على سبيل المثال، عند البحث عن قطة، قد نبحث أولا عن خطوط أفقية يمكن أن تشكل شوارب شعرية، ثم يمكن لتركيبة معينة من الشوارب أن تخبرنا أنها في الواقع صورة لقطة. موقع ووجود أنماط معينة مهمان. لاستخراج الأنماط، سنستخدم مفهوم المرشحات الالتفافية.
لكن أولا، دعونا نحمل جميع التبعيات ونحدد الدوال المساعدة التي سنستخدمها:
import keras
import tensorflow as tf
import matplotlib.pyplot as plt
import numpy as np


def plot_convolution(data, t, title=''):
    t = tf.constant(t, dtype=tf.float32)
    t = tf.reshape(t, [*t.shape, 1, 1])
    fig, ax = plt.subplots(len(data), 2)
    fig.suptitle(title, fontsize=16)
    for i in range(len(data)):
        d = tf.reshape(tf.constant(data[i], dtype=tf.float32), [1, *data[i].shape, 1])
        ax[i][0].imshow(data[i])
        ax[i][1].imshow(tf.nn.conv2d(d, t, [1, 1, 1, 1], 'SAME')[0, ..., 0])


def plot_results(hist):
    plt.figure(figsize=(12, 4))
    plt.subplot(1, 2, 1)
    plt.plot(hist.history['accuracy'], label='Training acc')
    plt.plot(hist.history['val_accuracy'], label='Validation acc')
    plt.legend()
    plt.subplot(1, 2, 2)
    plt.plot(hist.history['loss'], label='Training loss')
    plt.plot(hist.history['val_loss'], label='Validation loss')
    plt.legend()


def display_dataset(dataset, labels=None, n=10, classes=None):
    fig, ax = plt.subplots(1, n)
    for i in range(n):
        ax[i].imshow(dataset[i])
        ax[i].axis('off')
        if labels is not None:
            # Handle both scalar labels (e.g. MNIST) and array labels (e.g. CIFAR-10)
            lbl = int(labels[i][0]) if np.ndim(labels[i]) > 0 else int(labels[i])
            ax[i].set_title(classes[lbl] if classes is not None else str(lbl))
الآن دعونا نحمل مجموعة بيانات MNIST:
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()
x_train = x_train.astype(np.float32) / 255.0
x_test = x_test.astype(np.float32) / 255.0
مرشحات الالتفافية
المرشحات الالتفافية هي نوافذ صغيرة تمتد فوق كل بكسل من الصورة وتحسب متوسطا موزونا للبكسلات المجاورة. يتم تعريفها بواسطة مصفوفات معاملات الوزن. دعونا نرى أمثلة تطبيق مرشحين الالتفافيين مختلفين على أرقامنا المكتوبة بخط اليد من MNIST:
plot_convolution(x_train[:5], [[-1., 0., 1.], [-1., 0., 1.], [-1., 0., 1.]], 'Vertical edge filter')
plot_convolution(x_train[:5], [[-1., -1., -1.], [0., 0., 0.], [1., 1., 1.]], 'Horizontal edge filter')
# Expected output: Two sets of images showing original digits alongside the result of applying vertical and horizontal edge filters
يسمى المرشح الأول مرشح الحافة الرأسية، ويعرف بالمصفوفة التالية: $$ \left( \begin{matrix} -1 & 0 & 1 \ -1 & 0 & 1 \ -1 & 0 & 1 \ \end{matrix} \right) $$ عندما ينزلق هذا المرشح فوق منطقة متجانسة نسبيا من البكسلات، يكون المجموع المرجح الناتج عن الالتفاف قريبا من 0، لأن الأوزان الموجبة والسالبة تلغي بعضها. عندما يصادف حافة رأسية (حيث تتغير شدة البكسلات بشكل حاد من اليسار إلى اليمين)، ينتج الالتفاف قيمة كبيرة موجبة أو سالبة. لهذا السبب في الصور أعلاه يمكنك رؤية الحواف الرأسية تبرز بقيم عالية ومنخفضة، بينما الحواف الأفقية مملوءة.
يحدث شيء معاكس عندما نطبق مرشح الحافة الأفقية - الخطوط الأفقية مضخمة، ويتم متوسط الخطوط الرأسية.
في الرؤية الحاسوبية الكلاسيكية، كانت تطبق عدة مرشحات على الصورة لتوليد الميزات، والتي استخدمتها خوارزمية التعلم الآلي لبناء مصنف. في التعلم العميق، نبني شبكات تتعلم أفضل المرشحات الالتفافية لحل مشكلة التصنيف بمفردها.
للقيام بذلك، نقدم طبقات الالتفافية.
الطبقات الالفافية
تعرف الطبقات الالتفافية باستخدام Conv2D الفئة. نحتاج إلى تحديد ما يلي:
-
filters- عدد الفلاتر التي يجب استخدامها. سنستخدم 9 فلاتر مختلفة، مما سيمنح الشبكة العديد من الفرص لاستكشاف أي الفلاتر تناسب حالتنا. -
kernel_sizeهو حجم النافذة المنزلقة. عادة ما تستخدم فلاتر 3x3 أو 5x5.
أبسط شبكة CNN تحتوي فقط على طبقة التفافية واحدة. بالنظر إلى حجم الإدخال 28x28، بعد تطبيق تسعة مرشحات 5x5 سنحصل على موتر 24x24x9. البعد المكاني أصغر لأن البعد الافتراضي padding='valid' يعني عدم إضافة حشوة، وهناك فقط 24 وضعية يمكن أن تتسع فيها نافذة منزلقة بحجم 5 ضمن 28 بكسل (28 − 5 + 1 = 24). الاستخدام padding='same' سيحافظ على الأبعاد المكانية بإضافة حشوة صفرية حول المدخل.
بعد الالتفاف، نقوم بتسطيح موتر 24×24×9 إلى متجه واحد بحجم 5184، ثم نضيف طبقة كثيفة لإنتاج 10 فئات. يتم تطبيق relu دالة التنشيط بعد الطبقة الالتفاوية لإدخال اللاخطية.
model = keras.Sequential([
    keras.layers.Input(shape=(28, 28, 1)),
    keras.layers.Conv2D(filters=9, kernel_size=(5, 5), activation='relu'),
    keras.layers.Flatten(),
    keras.layers.Dense(10)
])

model.compile(loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])

model.summary()
# Expected output: Model summary showing a Conv2D layer, Flatten, and Dense(10) with ~52k parameters
يمكنك أن ترى أن هذه الشبكة تحتوي على حوالي 52 ألف معلم قابل للتدريب (234 في الطبقة الالتفاوية + 51,850 في الطبقة الكثيفة)، مقارنة بحوالي 80 ألف في الشبكات متعددة الطبقات المتصلة بالكامل. الشبكات الالتفافية تعمم بشكل أفضل، مما يسمح لنا بتحقيق نتائج جيدة على مجموعات بيانات أصغر.
ملحوظة
في معظم الحالات العملية، نريد تطبيق طبقات الالتفاف على الصور الملونة. لذا، Conv2D تتوقع الطبقة أن يكون الإدخال على شكل $H مضروبة في W\مضروبة C$، حيث $H$ و $W$ هما الارتفاع والعرض للصورة، و$C$ هو عدد قنوات الألوان. بالنسبة للصور بدرجات الرمادي، نحتاج إلى نفس الشكل مع $C=1$.
نحتاج إلى إعادة تشكيل بياناتنا قبل بدء التدريب:
x_train_c = np.expand_dims(x_train, 3)
x_test_c = np.expand_dims(x_test, 3)
hist = model.fit(x_train_c, y_train, validation_data=(x_test_c, y_test), epochs=3)
# Expected output: Training for 3 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 3 epochs
كما ترى، نحن قادرون على تحقيق دقة أعلى مع عدد أقل من فترات العصر مقارنة بالشبكات المتصلة بالكامل من الوحدة السابقة. ومع ذلك، فإن التدريب نفسه يتطلب موارد أكثر، وقد يكون أبطأ على الحواسيب غير المزودة بمعالج الرسومات.
تصور الطبقات الالتفافية
يمكننا أيضا تصور أوزان طبقاتنا الالفافية المدربة لمحاولة فهم ما يحدث:
fig, ax = plt.subplots(1, 9)
l = model.layers[0].weights[0]
for i in range(9):
    ax[i].imshow(l[..., 0, i])
    ax[i].axis('off')
# Expected output: 9 small images showing the learned 5x5 convolutional filter weights
يمكنك أن ترى أن بعض هذه المرشحات تبدو وكأنها تتعرف على بعض الضربات المائلة، بينما تبدو أخرى عشوائية.
شبكات CNN متعددة الطبقات وطبقات التجميع
أولا، تبحث الطبقات الالتفافية عن أنماط بدائية، مثل الخطوط الأفقية أو الرأسية. يمكننا تطبيق طبقات الالتفافية إضافية فوقها للبحث عن أنماط أعلى مستويا، مثل الأشكال البدائية. ثم يمكن للطبقات الالتفافية أن تدمج تلك الأشكال في أجزاء من الصورة، حتى الكائن النهائي الذي نحاول تصنيفه.
عند القيام بذلك، قد نطبق أيضا حيلة واحدة: تقليل الحجم المكاني للصورة. بمجرد أن نكتشف وجود ضربة أفقية داخل نافذة منزلقة 3x3، يصبح الأمر غير مهم جدا في أي بكسل حدث بالضبط. وبالتالي يمكننا "تصغير" حجم الصورة، ويتم ذلك باستخدام إحدى طبقات التجميع:
- يأخذ متوسط التجميع نافذة منزلقة (على سبيل المثال، 2x2 بكسل) ويحسب متوسطا للقيم داخل النافذة
- أقصى تجميع (max pooling) يستبدل النافذة بالقيمة القصوى. الفكرة وراء تجميع الحد الأقصى هي اكتشاف وجود نمط معين داخل نافذة الانزلاق.
لذا، في CNN نموذجي سيكون هناك عدة طبقات التفافية، مع تجميع طبقات بينها لتقليل أبعاد الصورة. سنزيد أيضا عدد المرشحات، لأنه مع تقدم الأنماط - هناك المزيد من التركيبات المثيرة للاهتمام التي يجب أن نبحث عنها.
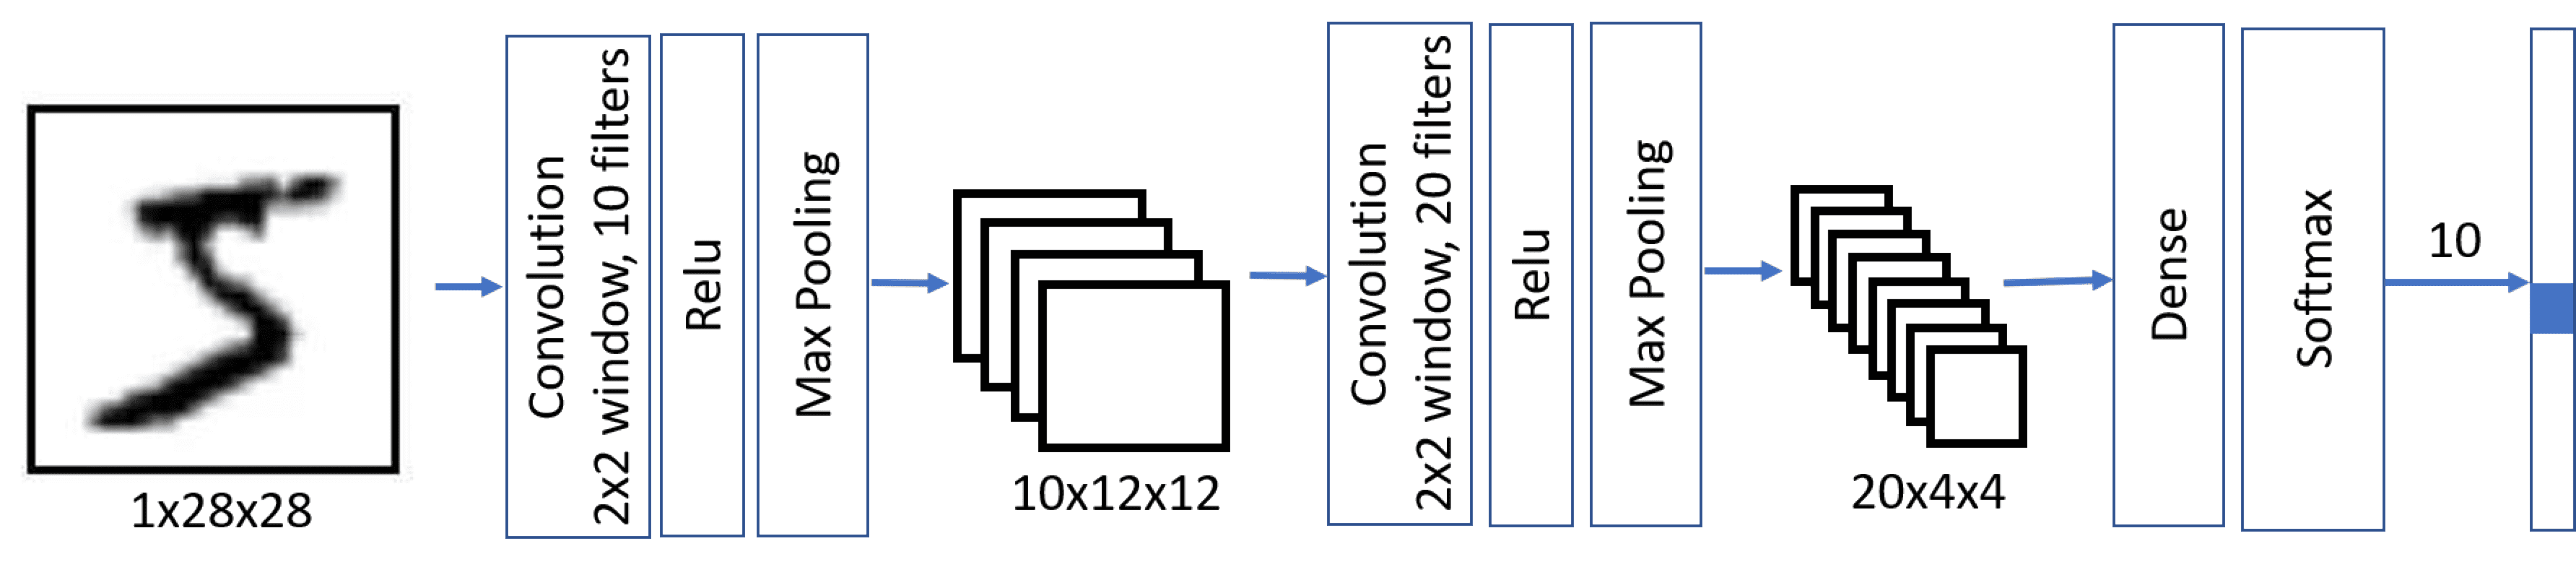
تسمى هذه البنية أيضا بنية الهرم بسبب تقليل الأبعاد المكانية وزيادة أبعاد الميزات/المرشحات.
model = keras.Sequential([
    keras.layers.Input(shape=(28, 28, 1)),
    keras.layers.Conv2D(filters=10, kernel_size=(5, 5), activation='relu'),
    keras.layers.MaxPooling2D(),
    keras.layers.Conv2D(filters=20, kernel_size=(5, 5), activation='relu'),
    keras.layers.MaxPooling2D(),
    keras.layers.Flatten(),
    keras.layers.Dense(10)
])

model.compile(loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])

model.summary()
# Expected output: Model summary showing Conv2D, MaxPooling, Conv2D, MaxPooling, Flatten, Dense with ~8.5k parameters
لاحظ أن عدد المعلمات القابلة للتدريب (~8.5K) أقل بكثير مما كان عليه في الحالات السابقة. يحدث هذا لأن الطبقات الالتفافية عموما تحتوي على معلمات قليلة، ويتم تقليل أبعاد الصورة قبل تطبيق الطبقة النهائية الكثيفة.
hist = model.fit(x_train_c, y_train, validation_data=(x_test_c, y_test), epochs=3)
# Expected output: Training for 3 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 3 epochs
لاحظ أننا قادرون على تحقيق دقة أعلى مع أكثر من طبقة واحدة، ويحتاج ذلك إلى عدد أقل من العصور. هذا يعني أن بنية الشبكة الأكثر تطورا تحتاج إلى بيانات أقل لفهم ما يحدث، ولاستخراج أنماط عامة من صورنا. ومع ذلك، كل عصر يتطلب المزيد من العمليات الحسابية بسبب العمليات الالتفاوية الإضافية، لذا يكون التدريب أسرع مع وحدة معالجة الرسوميات.
اللعب بصور حقيقية من مجموعة بيانات CIFAR-10
بينما قد تبدو مشكلة التعرف على الأرقام المكتوبة بخط اليد كمشكلة لعبة، نحن الآن مستعدون لفعل شيء أكثر جدية. دعونا نستكشف مجموعة بيانات أكثر تقدما من صور لأجسام مختلفة، تسمى CIFAR-10. يحتوي على صور بدقة 60k بدقة 32x32، مقسمة إلى 10 فئات.
ملحوظة
من هذه النقطة فصاعدا، نعيد تحميل x_train، y_train، ، x_testوباستخدام y_test مجموعة بيانات CIFAR-10، لتحل محل بيانات MNIST المستخدمة سابقا في هذه الوحدة. المتغيرات x_train_c الموسعة للتعتيم لم x_test_c تعد ضرورية.
(x_train, y_train), (x_test, y_test) = keras.datasets.cifar10.load_data()
x_train = x_train.astype(np.float32) / 255.0
x_test = x_test.astype(np.float32) / 255.0
classes = ('plane', 'car', 'bird', 'cat',
           'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
display_dataset(x_train, y_train, classes=classes)
# Expected output: A row of 10 CIFAR-10 images with their class labels
تعد بنية CNN الكلاسيكية LeNet، التي اقترحها يان لو كون في الأصل للتعرف على الأرقام المكتوبة بخط اليد. دعونا نعدلها للعبة CIFAR-10. يتبع نفس المبادئ التي ذكرناها أعلاه، والفرق الرئيسي هو وجود 3 قنوات لونية مدخلة بدلا من 1.
model = keras.Sequential([
    keras.layers.Input(shape=(32, 32, 3)),
    keras.layers.Conv2D(filters=6, kernel_size=5, strides=1, activation='relu'),
    keras.layers.MaxPooling2D(pool_size=2, strides=2),
    keras.layers.Conv2D(filters=16, kernel_size=5, strides=1, activation='relu'),
    keras.layers.MaxPooling2D(pool_size=2, strides=2),
    keras.layers.Flatten(),
    keras.layers.Dense(120, activation='relu'),
    keras.layers.Dense(84, activation='relu'),
    keras.layers.Dense(10)
])

model.summary()
# Expected output: Model summary showing the LeNet architecture with Conv2D, MaxPooling, Dense layers
تدريب هذه الشبكة بشكل صحيح يستغرق وقتا كبيرا ويجب أن يتم على حساب مدعوم بمعالج الرسوميات.
model.compile(optimizer='adam', loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])
hist = model.fit(x_train, y_train, validation_data=(x_test, y_test), epochs=10)
# Expected output: Training for 10 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 10 epochs
الدقة التي تمكنا من تحقيقها من خلال فترات تدريب قليلة فقط هي دقة عادية. تذكر أن مشكلتنا أصعب بكثير من تصنيف الأرقام في MNIST. الوصول إلى أكثر من 60% الدقة يعد إنجازا جيدا في فترة تدريب قصيرة، رغم أن النماذج الحديثة يمكنها تحقيق أكثر من 95% على CIFAR-10 باستخدام بنى أعمق، وتعزيز البيانات، وتدريب أطول.
النقاط الرئيسية
في هذه الوحدة، تعلمنا المفهوم الرئيسي وراء شبكات الرؤية الحاسوبية العصبية - الشبكات الالتفاوتية. البنى الواقعية التي تدعم تصنيف الصور، واكتشاف الأجسام، وحتى شبكات توليد الصور كلها مبنية على شبكات CNN، فقط مع طبقات أكثر وبعض الحيل التدريبية الإضافية.
اختبر معلوماتك
الملاحظات
هل كانت هذه الصفحة مفيدة؟
لا
هل تحتاج إلى مساعدة مع هذا الموضوع؟
هل تريد محاولة استخدام Ask Learn لتوضيح هذا الموضوع أو إرشادك خلاله؟