التعرّف البصري على الحروف (OCR)
Tip
راجع علامة التبويب النص والصور لمزيد من التفاصيل!
التعرف البصري على الحروف (OCR) هو تقنية تقوم تلقائيا بتحويل النص البصري في الصور - سواء من المستندات الممسوحة ضوئيا، أو الصور الفوتوغرافية، أو الملفات الرقمية - إلى بيانات نصية قابلة للتحرير وقابلة للبحث. بدلا من نسخ المعلومات يدويا، يتيح OCR استخراج البيانات تلقائيا من:
- الفواتير والإيصالات الممسوحة ضوئيا
- الصور الرقمية للوثائق
- ملفات PDF تحتوي على صور نصية
- لقطات الشاشة والمحتوى الملتقط
- النماذج والملاحظات المكتوبة بخط اليد
خط أنابيب التعرف الضوئي على الحرارة: عملية خطوة بخطوة
يتكون خط أنابيب OCR من خمس مراحل أساسية تعمل معا لتحويل المعلومات البصرية إلى بيانات نصية.
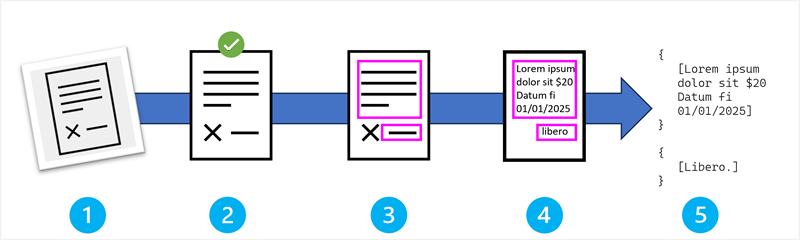
مراحل عملية الرقابة الضمادية (OCR) هي:
- اكتساب الصور وإدخالها.
- المعالجة المسبقة وتحسين الصورة.
- اكتشاف منطقة النص.
- التعرف على الشخصيات وتصنيفها.
- توليد المخرجات والمعالجة اللاحقة.
دعونا نفحص كل مرحلة بعمق أكبر.
المرحلة الأولى: اكتساب الصور والمدخلات
يبدأ خط الأنابيب عندما تدخل صورة تحتوي على نص إلى النظام. قد يكون هذا:
- صورة التقطت بكاميرا هاتف ذكي.
- مستند ممسح ضوئيا من جهاز مسطح أو ماسح ضوئي للمستندات.
- إطار مستخرج من تدفق فيديو.
- صفحة PDF تعرض كصورة.
Tip
جودة الصورة في هذه المرحلة تؤثر بشكل كبير على الدقة النهائية لاستخراج النص.
المرحلة 2: المعالجة المبدئية وتحسين الصورة
قبل بدء اكتشاف النصوص، تستخدم التقنيات التالية لتحسين الصورة من أجل دقة أفضل في التعرف:
يقلل الضوضاء من الشوائب البصرية، وبقع الغبار، والعيوب التي قد تعيق اكتشاف النص. تشمل التقنيات المحددة المستخدمة لتقليل الضوضاء ما يلي:
- خوارزميات التصفية ومعالجة الصور: مرشحات غاوسية، مرشحات وسيط، وعمليات شكلية.
- نماذج التعلم الآلي: مشفرات ذاتية إزالة الضوضاء وشبكات عصبية الالتفافية (CNNs) مدربة خصيصا لتنظيف صور الوثائق.
تعديل التباين يعزز الفرق بين النص والخلفية لجعل الشخصيات أكثر تميزا. مرة أخرى، هناك عدة طرق ممكنة:
- الطرق الكلاسيكية: معادلة المدرجات التكرارية، العتبة التكيفية، وتصحيح غاما.
- تعلم الآلة: نماذج التعلم العميق التي تتعلم معايير التحسين المثلى لأنواع المستندات المختلفة.
يكتشف تصحيح الانحراف ويصحح دوران المستندات، مما يضمن أن أسطر النص محاذاة أفقيا بشكل صحيح. تشمل تقنيات تصحيح الانحراف ما يلي:
- التقنيات الرياضية: تحويل هوف لاكتشاف الخطوط، ملفات الإسقاط، وتحليل المكونات المتصلة.
- نماذج الشبكات العصبية: شبكات CNN الانحدارية التي تتنبأ بزوايا الدوران مباشرة من ميزات الصورة.
تحسين الدقة يضبط دقة الصورة إلى المستوى الأمثل لخوارزميات التعرف على الحروف. يمكنك تحسين دقة الصورة من خلال:
- طرق الاستيفاء: خوارزميات إعادة العينات Bicubic، ثنائية الخطية، وخوارزميات Lanczos.
- نماذج فائقة الدقة: الشبكات العدائية التوليدية (GANs) والشبكات المتبقية التي تقوم بذكاء برفع حجم الصور النصية منخفضة الدقة.
المرحلة 3: اكتشاف مناطق النص
يقوم النظام بتحليل الصورة المعالجة مسبقا لتحديد المناطق التي تحتوي على نص باستخدام التقنيات التالية:
تحليل التخطيط يميز بين مناطق النص، والصور، والرسومات، ومناطق المساحات البيضاء. تشمل تقنيات تحليل التخطيط:
- الأساليب التقليدية: تحليل المكونات المتصلة، الترميز بطول التشغيل، والتقسيم القائم على الإسقاط.
- نماذج التعلم العميق: شبكات تقسيم دلالي مثل U-Net وMask R-CNN، ونماذج تحليل تخطيط المستندات المتخصصة (مثل LayoutLM أو نماذج مدربة من PubLayNet).
يجمع تحديد كتل النص الحروف الفردية إلى كلمات وأسطار وفقرات بناء على العلاقات المكانية. تشمل الأساليب الشائعة ما يلي:
- الطرق الكلاسيكية: التجميع القائم على المسافة، تحليل الفراغ الأبيض، والعمليات الشكلية
- الشبكات العصبية: رسم بياني للشبكات العصبية ونماذج المحولات التي تفهم بنية الوثائق المكانية
تحديد ترتيب القراءة يحدد تسلسل قراءة النص (من اليسار إلى اليمين، من الأعلى إلى الأسفل في اللغة الإنجليزية). يمكن تحديد الترتيب الصحيح من خلال:
- الأنظمة القائمة على القواعد: خوارزميات هندسية تستخدم إحداثيات صناديق الحدود والقواعد الفضائية.
- نماذج التعلم الآلي: نماذج التنبؤ بالتسلسل والأساليب القائمة على الرسوم البيانية التي تتعلم أنماط القراءة من بيانات التدريب.
تصنيف المناطق يحدد أنواعا مختلفة من مناطق النصوص (الرؤوس، النص الرئيسي، الترجمات، الجداول).
- مصنفات قائمة على الميزات: أجهزة متجهة تدعم (SVMs) تستخدم ميزات يدوية مثل حجم الخط، الموضع، والتنسيق
- نماذج التعلم العميق: الشبكات العصبية الالفافية ومحولات الرؤية المدربة على مجموعات بيانات الوثائق المعنونة
المرحلة 4: التعرف على الشخصيات وتصنيفها
هذا هو جوهر عملية التعرف الضوئي على الحروف حيث يتم تحديد الشخصيات الفردية:
استخراج الميزات: يحلل الشكل والحجم والخصائص المميزة لكل حرف أو رمز.
- الطرق التقليدية: السمات الإحصائية مثل العزوم، وواصفات فورييه، والميزات البنيوية (الحلقات، نقاط النهاية، التقاطعات)
- أساليب التعلم العميق: الشبكات العصبية الالتفافية التي تتعلم تلقائيا الميزات التمييزية من بيانات البكسل الخام
مطابقة الأنماط: تقارن الميزات المستخرجة مع نماذج مدربة تتعرف على خطوط وأحجام وأنماط كتابة مختلفة.
- مطابقة القوالب: مقارنة مباشرة مع قوالب الحروف المخزنة باستخدام تقنيات الارتباط
- المصنفات الإحصائية: نماذج ماركوف المخفية (HMMs)، آلات متجهات الدعم، وأقرب الجيران باستخدام متجهات الميزات
- الشبكات العصبية: البيرسيبترونات متعددة الطبقات، CNNs، والهياكل المتخصصة مثل LeNet للتعرف على الأرقام
- التعلم العميق المتقدم: الشبكات المتبقية (ResNet)، DenseNet، وEfficientNet لتصنيف الأحرف المتين
تحليل السياق: يستخدم الحروف والكلمات المحيطة لتحسين دقة التعرف من خلال البحث في القواميس ونماذج اللغة.
- نماذج N-gram: نماذج لغوية إحصائية تتنبأ بتتابع الأحرف بناء على توزيعات الاحتمالات.
- التصحيح المعتمد على القاموس: البحث عن المعجم باستخدام خوارزميات مسافة التحرير (مثل مسافة ليفنشتين) لتصحيح الإملاء.
- نماذج اللغة العصبية: نماذج LSTM ونماذج قائمة على المحولات (مثل متغيرات BERT) التي تفهم العلاقات السياقية.
- آليات الانتباه: نماذج ترانسفورمر تركز على الأجزاء ذات الصلة من المدخلات عند إجراء توقعات الشخصية.
تقييم الثقة: يمنح درجات احتمالية لكل شخصية معترف بها بناء على مدى يقين النظام بشأن تحديدها.
- المناهج البايزية: نماذج احتمالية تقيس عدم اليقين في توقعات الشخصية.
- مخرجات سوفت ماكس: تم تحويل تفعيل الطبقة النهائية لشبكة الأعصاب إلى توزيعات احتمالية.
- طرق المجموعة: دمج التنبؤات من نماذج متعددة لتحسين تقديرات الثقة.
المرحلة 5: توليد المخرجات والمعالجة اللاحقة
المرحلة النهائية تحول نتائج التعرف إلى بيانات نصية قابلة للاستخدام:
تجميع النصوص: يجمع التعرف على الشخصيات الفردية في كلمات وجمل كاملة.
- التجميع القائم على القواعد: خوارزميات حتمية تجمع بين توقعات الأحرف باستخدام عتبات القرب المكاني وثقة الثقة.
- نماذج التسلسل: شبكات عصبية متكررة (RNNs) وشبكات ذاكرة Short-Term طويلة (LSTM) التي تنمذج النص كبيانات متسلسلة.
- نماذج قائمة على الانتباه: هياكل ترانسفورمر يمكنها التعامل مع تسلسلات متغيرة الطول وتخطيطات نصوص معقدة.
حفظ التنسيق: يحافظ على هيكل المستند بما في ذلك الفقرات، فواصل الأسطر، والتباعد.
- الخوارزميات الهندسية: أنظمة قائمة على القواعد تستخدم إحداثيات صناديق الحدود وتحليل المساحات البيضاء.
- نماذج فهم التخطيط: رسم الشبكات العصبية البيانية وتوثق نماذج الذكاء الاصطناعي التي تتعلم العلاقات الهيكلية.
- المحولات متعددة الوسائط: نماذج مثل LayoutLM تجمع بين النص ومعلومات التخطيط للحفاظ على الهيكل.
تعيين الإحداثيات: يسجل الموقع الدقيق لكل عنصر نصي داخل الصورة الأصلية.
- تحويل الإحداثيات: التعيين الرياضي بين بكسلات الصورة وإحداثيات المستندات.
- الفهرسة المكانية: هياكل بيانات مثل أشجار R وأشجار الرباعية لاستعلامات مكانية فعالة.
- نماذج الانحدار: شبكات عصبية مدربة على التنبؤ بدقة بإحداثيات تحديد موقع النص.
التحقق من الجودة: يطبق فحوصات الإملاء والقواعد لتحديد أخطاء التعرف المحتملة.
- التحقق المعتمد على القاموس: ابحث مع قوائم كلمات شاملة ومفردات المجالات المتخصصة.
- نماذج اللغة الإحصائية: نماذج N-gram ومحللات احتمالية للقواعد والتحقق من السياق.
- نماذج اللغة العصبية: نماذج مدربة مسبقا مثل GPT أو BERT مضبوطة بدقة لاكتشاف وتصحيح أخطاء التعرف الضوئي على الحرارة.
- التحقق الجماعي: يجمع بين عدة طرق تحقق لتحسين دقة اكتشاف الأخطاء.