تحليل النصوص الإحصائية.
نصيحة
راجع علامة التبويب النص والصور لمزيد من التفاصيل!
بعد تقسيم مجموعة نصية إلى رموز مكونة له، وتحضيرها للتحليل؛ هناك بعض تقنيات التحليل الإحصائي الشائعة التي يمكنك استخدامها لاستنتاج المعنى من النص.
تحليل التردد
ربما أوضح طريقة لتحديد المواضيع التي نوقشت في المستند هي ببساطة عد عدد مرات ظهور كل رمز مطبع. الافتراض هو أن المصطلحات المستخدمة بشكل أكثر تكرارا في الوثيقة يمكن أن تساعد في تحديد المواضيع أو المواضيع التي نوقشها. ببساطة، إذا استطعت تحديد الكلمات الأكثر استخداما في مستند معين، يمكنك غالبا أن تحصل على فكرة جيدة عن موضوع المستند.
على سبيل المثال، انظر إلى النص التالي:
AI in modern business delivers transformative benefits by enhancing efficiency, decision-making, and customer experiences. Businesses can leverage AI to automate repetitive tasks, freeing employees to focus on strategic work, while predictive analytics and machine learning models enable data-driven decisions that improve accuracy and speed. AI-powered tools like Copilot streamline workflows across marketing, finance, and operations, reducing costs and boosting productivity. Additionally, intelligent applications personalize customer interactions, driving engagement and loyalty. By embedding AI into core processes, businesses benefit from the ability to innovate faster, adapt to market changes, and maintain a competitive edge in an increasingly digital economy.
بعد الترميز، والطبيعة، وتطبيق الليماتيزيشن على النص، يمكن عد وتعدد تكرار كل مصطلح وجدوله؛ مما أدى إلى نتائج جزئية تذكر:
| مصطلح | التكرار |
|---|---|
ai |
4 |
business |
3 |
benefit |
2 |
customer |
2 |
decision |
2 |
market |
2 |
ability |
1 |
accuracy |
1 |
| ... | ... |
ومن هذه النتائج، تشير المصطلحات الأكثر تكرارا إلى أن النص يناقش الذكاء الاصطناعي وفوائده التجارية.
تردد المدة - تردد المستند العكسي (TF-IDF)
تحليل التكرار البسيط الذي تحسب فيه عدد تكرارات كل رمز يمكن أن يكون طريقة فعالة لتحليل مستند واحد، ولكن عندما تحتاج إلى التمييز بين عدة مستندات ضمن نفس المجموعة، تحتاج إلى طريقة لتحديد أي الرموز الأكثر صلة في كل مستند على حدة.
على سبيل المثال، اعتبر العينتين النصيتين التاليتين:
العينة أ:
Microsoft Copilot Studio enables declarative AI agent creation using natural language, prompts, and templates. With this declarative approach, an AI agent is configured rather than programmed: makers define intents, actions, and data connections, then publish the agent to channels. Microsoft Copilot Studio simplifies agent orchestration, governance, and lifecycles so an AI agent can be iterated quickly. Using Microsoft Copilot Studio helps modern businesses deploy Microsoft AI agent solutions fast.
العينة ب:
Microsoft Foundry enables code‑based AI agent development with SDKs and APIs. Developers write code to implement agent conversations, tool calling, state management, and custom pipelines. In Microsoft Foundry, engineers can use Python or Microsoft C#, integrate Microsoft AI services, and manage CI/CD to deploy the AI agent. This code-first development model supports extensibility and performance while building Microsoft Foundry AI agent applications.
أعلى ثلاثة مصطلحات شيوعا في هذه العينات موضحة في الجداول التالية:
العينة أ:
| مصطلح | التكرار |
|---|---|
agent |
6 |
ai |
4 |
microsoft |
4 |
العينة ب:
| مصطلح | التكرار |
|---|---|
microsoft |
5 |
agent |
4 |
ai |
4 |
كما ترى من النتائج، الكلمات الأكثر شيوعا في كلا العينتين هي نفسها ("agent", "Microsoft", و "AI"). هذا يخبرنا أن كلا الوثيقتين تغطيان موضوعا عاما مشابها، لكنه لا يساعدنا على التمييز بين الوثائق الفردية. قد يساعد فحص عدد المصطلحات الأقل استخداما، لكن يمكنك بسهولة تخيل تحليل مجموعة مبنية تعتمد على وثائق الذكاء الاصطناعي من مايكروسوفت، مما يؤدي إلى عدد كبير من المصطلحات المشتركة في جميع المستندات؛ مما يصعب تحديد المواضيع المحددة التي يغطيها كل وثيقة.
لمعالجة هذه المشكلة، تقنية تكرار المصطلحات - تكرار المستند العكسي (TF-IDF) هي تقنية تحسب الدرجات بناء على عدد مرات ظهور كلمة أو مصطلح في مستند واحد مقارنة بتكراره العام عبر مجموعة المستندات بأكملها. باستخدام هذه التقنية، يفترض وجود درجة عالية من الصلة للكلمات التي تظهر بشكل متكرر في مستند معين، ولكن بشكل غير متكرر نسبيا عبر مجموعة واسعة من المستندات الأخرى. لحساب TF-IDF للمصطلحات في مستند فردي، يمكنك استخدام العملية المكونة من ثلاث خطوات التالية:
احسب تكرار المصطلح (TF): هذا ببساطة عدد مرات ظهور الكلمة في المستند. على سبيل المثال، إذا ظهرت الكلمة
"agent"6 مرات في مستند، فإنtf(agent) = 6.حساب تردد المستند العكسي (IDF): يتحقق هذا من مدى شيوع أو ندرة الكلمة عبر جميع المستندات. إذا ظهرت كلمة في كل وثيقة، فهي ليست مميزة. الصيغة المستخدمة لحساب IDF هي
idf(t) = log(N / df(t))(حيثNهو إجمالي عدد المستندات وdf(t)هو عدد الوثائق التي تحتوي على الكلمةt)اجمعها لحساب TF-IDF: اضرب TF و IDF للحصول على الدرجة:
tfidf(t, d) = tf(t, d) * log(N / df(t))
تشير درجة TF-IDF العالية إلى أن كلمة تظهر كثيرا في وثيقة واحدة ونادرا في وثائق أخرى. تشير الدرجة المنخفضة إلى أن الكلمة شائعة في العديد من الوثائق. في عينتين عن عملاء الذكاء الاصطناعي، لأن "AI"، ، و "Microsoft" تظهر في كلا العينتين ("agent")، فإن IDF الخاص بهم هو N = 2, df(t) = 2، لذا لا يحملون وزنا تمييزيا في TF-IDFlog(2/2) = 0. أفضل ثلاثة نتائج TF-IDF للعينات هي:
العينة أ:
| مصطلح | TF-IDF |
|---|---|
copilot |
2.0794 |
studio |
2.0794 |
declarative |
1.3863 |
العينة ب:
| مصطلح | TF-IDF |
|---|---|
code |
2.0794 |
develop |
2.0794 |
foundry |
2.0794 |
من هذه النتائج، يتضح أن العينة A تتعلق بإنشاء وكيل إعلاني مع Copilot Studio، بينما العينة B تتعلق بتطوير الوكلاء المعتمدين على الشيفرة مع Microsoft Foundry.
تقنيات التعلم الآلي "كيس الكلمات"
حقيبة الكلمات هو الاسم المطلق لتقنية استخراج الميزات التي تمثل رموز النص كمتجه لتكرار أو تكرارات الكلمات، متجاهلة القواعد وترتيب الكلمات. يصبح هذا التمثيل مدخلا لخوارزميات التعلم الآلي مثل Naive Bayes، وهو مصنف احتمالي يطبق نظرية بايز للتنبؤ بالفئة المحتملة لمستند بناء على تكرار الكلمات.
على سبيل المثال، قد تستخدم هذه التقنية لتدريب نموذج تعلم آلي يقوم بتصفية البريد المزعج عبر البريد الإلكتروني. قد تظهر الكلمات "miracle cure"و "lose weight fast"و بشكل "anti-aging" متكرر في رسائل البريد الإلكتروني العشوائي حول المنتجات الصحية المشكوك فيها من رسائل البريد الإلكتروني العادية، وقد يقوم نموذج مدرب بوضع علامة على الرسائل التي تحتوي على هذه الكلمات على أنها بريد عشوائي محتمل.
يمكنك تطبيق تحليل المشاعر باستخدام نفس الطريقة لتصنيف النص حسب النبرة العاطفية. يوفر كيس الكلمات الميزات، ويستخدم النموذج تلك الميزات لتقدير الاحتمالات وتعيين تسميات للمشاعر مثل "إيجابي" أو "سلبي".
TextRank
تيكست رانك هو خوارزمية غير خاضعة للإشراف تعتمد على الرسوم البيانية تقوم بنمذجة النص كشبكة من العقد المتصلة. على سبيل المثال، يمكن اعتبار كل جملة في مستند عقدة، ويتم تقييم الروابط (الحواف) بينها بناء على تشابه الكلمات التي تحتويها. يستخدم TextRank عادة لتلخيص النص بناء على تحديد مجموعة فرعية من الجمل داخل المستند التي تمثل موضوعه العام بأفضل شكل.
خوارزمية TextRank تطبق نفس مبدأ خوارزمية PageRank من جوجل (التي تصنف صفحات الويب بناء على الروابط بينها) على النصوص. الفكرة الأساسية هي أن الجملة مهمة إذا كانت مشابهة للعديد من الجمل المهمة الأخرى. تعمل الخوارزمية من خلال الخطوات التالية:
بناء رسم بياني: كل جملة تصبح عقدة، والحواف التي تربطها توزن حسب التشابه (غالبا ما تقاس باستخدام تداخل الكلمات أو تشابه جيب تمام بين متجهات الجمل).
حساب الترتيب بشكل تكراري: يتم حساب نقاط كل عقدة بناء على درجات العقد المرتبطة بها. الصيغة هي: (حيث
TextRank(Sᵢ) = (1-d) + d * Σ(wⱼᵢ / Σwⱼₖ) * TextRank(Sⱼ)هو عامل تخميد، عادة 0.85،dهو وزن الحافة من جملةwⱼᵢإلى أخرىj، والمجموع يتكرر على جميع الجمل المرتبطة بi).iاستخلاص الجمل ذات الأعلى ترتيبا: بعد التقارب، يتم اختيار الجمل التي حصلت على أعلى الدرجات كملخص.
على سبيل المثال، انظر إلى الوثيقة التالية حول الحوسبة السحابية:
Cloud computing provides on-demand access to computing resources. Computing resources include servers, storage, and networking. Azure is Microsoft's cloud computing platform. Organizations use cloud platforms to reduce infrastructure costs. Cloud computing enables scalability and flexibility.
لإنشاء ملخص لهذا المستند، تبدأ عملية TextRank بتقسيم هذا المستند إلى جمل:
Cloud computing provides on-demand access to computing resources.Computing resources include servers, storage, and networking.Azure is Microsoft's cloud computing platform.Organizations use cloud platforms to reduce infrastructure costs.Cloud computing enables scalability and flexibility.
بعد ذلك، يتم إنشاء حواف بين الجمل بأوزان تعتمد على التشابه (تداخل الكلمات). في هذا المثال، قد تكون أوزان الحواف:
- الجملة 1 <-> الجملة 2: 0.5 (مشاركة
"computing resources") - الجملة 1 <-> الجملة 3: 0.6 (مشاركة
"cloud computing") - الجملة 1 <-> الجملة 4: 0.2 (مشاركة
"cloud") - الجملة 1 <-> الجملة 5: 0.7 (مشاركة
"cloud computing") - الجملة 2 <-> الجملة 3: 0.2 (تداخل محدود)
- الجملة 2 <-> الجملة 4: 0.1 (تداخل محدود)
- الجملة 2 <-> الجملة 5: 0.1 (مشاركة
"computing") - الجملة 3 <-> الجملة 4: 0.5 (مشاركة
"cloud platforms") - الجملة 3 <-> الجملة 5: 0.4 (مشاركة
"cloud computing") - الجملة 4 <-> الجملة 5: 0.3 (تداخل محدود)
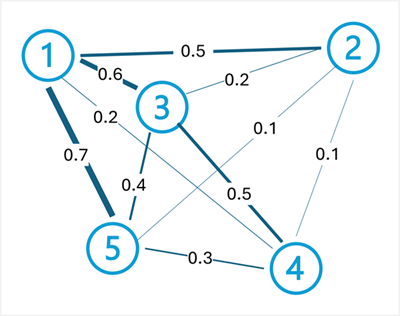
بعد حساب درجات TextRank بشكل تكراري باستخدام هذه الأوزان، قد تحصل الجمل 1 و3 و5 على أعلى الدرجات لأنها ترتبط جيدا بجمل أخرى من خلال المصطلحات والمفاهيم المشتركة. يتم اختيار هذه الجمل لتشكيل ملخص موجز: "Cloud computing provides on-demand access to computing resources. Azure is Microsoft's cloud computing platform. Cloud computing enables scalability and flexibility."
ملاحظة
إنشاء ملخص مستند باختيار الجمل الأكثر صلة هو شكل من أشكال التلخيص الاستخراجي . في هذا النهج، لا يتم توليد نص جديد - يتكون الملخص من مجموعة فرعية من النص الأصلي. كما تتيح التطورات الحديثة في النمذجة الدلالية التلخيص التجريدي ، حيث يتم توليد لغة جديدة تلخص المواضيع الرئيسية للمستند المصدر.
يمكن أيضا تطبيق TextRank على مستوى الكلمة لاستخراج الكلمات المفتاحية، حيث تصبح الكلمات (بدلا من الجمل) عقدا، وتمثل الحواف التزامن ضمن نافذة ثابتة. يتم استخراج الكلمات الأعلى ترتيبا كمصطلحات رئيسية تمثل المواضيع الرئيسية للوثيقة.