Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
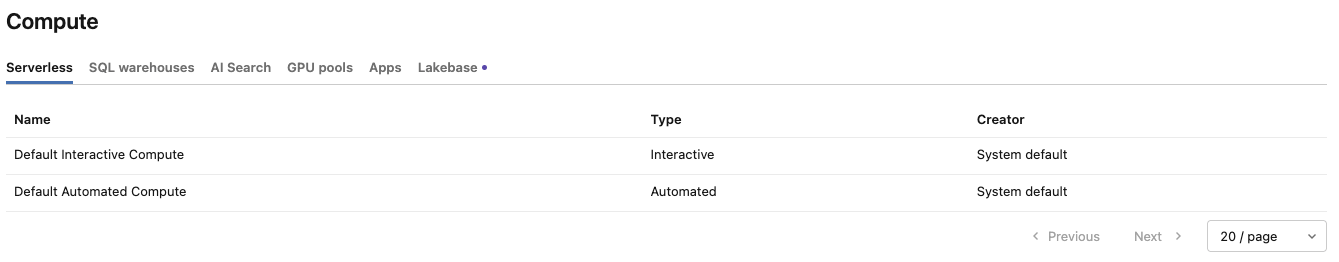
Diese Seite erklärt, wie man den Zugriff auf serverlose Rechenleistungen verwaltet und wie serverlose Rate-Limits implementiert werden. Workspace-Administratoren steuern serverlose Rechenleistungen mithilfe integrierter serverloser Rechenobjekte. Ein serverloses Computeobjekt ist ein Ressourcentyp, der die Berechtigungsgrenze für serverlose Workloads definiert. Ihr Arbeitsbereich erhält automatisch zwei standardmäßige Compute-Objekte:
- Standard-interaktive Compute: Regelt den Zugriff auf Notizbücher und Databricks Connect.
- Default Automated Compute: Regelt den Zugriff auf Jobs und Spark-Deklarative Pipelines auf Lakeflow.
Standardmäßig haben alle Arbeitsbereichsbenutzer für beide Objekte die Berechtigung Can Use, sodass vorhandene Workloads ohne Änderungen weiter ausgeführt werden. Ein Arbeitsbereichsadministrator kann Benutzer oder Gruppen aus einem objekt entfernen, um den Zugriff einzuschränken. Ein Benutzer, der den Zugriff verliert, sieht die Serverless Compute-Option als nicht verfügbar in seinen Produktoberflächen.
Zugriff auf serverlose Rechenressourcen verwalten
Um zu steuern, wer Zugriff auf serverlose Compute hat, können Arbeitsbereichsadministratoren die Berechtigungen für die Objekte "Default Interactive Compute " und "Default Automated Compute " bearbeiten. Arbeitsbereichsadministratoren verfügen standardmäßig über die Berechtigung "Kann verwalten ", aber sie können jedem Benutzer die Berechtigung erteilen. Diese Standard-Rechenobjekte können nicht umbenannt oder gelöscht werden.
Jedes serverlose Computeobjekt unterstützt zwei Berechtigungsstufen:
| Erlaubnis | Zweck: |
|---|---|
| Verwendbar | Ausführen von Workloads auf diesem Compute |
| Kann verwalten | Ausführen von Workloads auf diesem Compute und Bearbeiten der Berechtigungen des Computes |
Du kannst auch Berechtigungen für serverlose Rechenobjekte programmatisch über die Permissions API verwalten. Serverlose Compute-Objekte verwenden den serverless-compute Objekttyp, und jedes Objekt wird durch seine ID identifiziert.
Zugriff auf serverlose interaktive Sitzungen beschränken
So legen Sie fest, wer Serverless für Notebooks und Databricks Connect verwenden darf:
- Klicken Sie auf " Berechnen" in der Arbeitsbereich-Randleiste.
- Klicken Sie auf der Registerkarte „Serverless“ auf das Kebab-Menü
 neben „Default Interactive Compute“ und dann auf „Berechtigungen bearbeiten“.
- Entfernen Sie die Gruppe "Alle Benutzer" oder die Gruppe, die alle Arbeitsbereichsbenutzer enthält.
- Fügen Sie nur die spezifischen Benutzer, Gruppen oder Dienstprinzipale hinzu, die Sie autorisieren möchten.
Wenn Sie die Berechtigungen von Benutzenden für interaktives Serverless-Computing widerrufen, können Notebooks, die bereits mit Serverless verbunden sind, keine Verbindung mehr herstellen, wenn die Benutzenden eine Zelle ausführen, und den Benutzenden die Option Serverless in der Compute-Auswahl des Notebooks nicht mehr als verfügbar angezeigt wird. Wenn Benutzer versuchen, Databricks Connect zu verwenden, schlägt die Verbindungsanfrage fehl, und es wird ein Fehler angezeigt, dass der Benutzer keinen Zugriff auf Serverless hat.
Einschränken des Zugriffs auf serverlose Aufträge und Pipelines
So beschränken Sie, wer Serverless in Jobs und Pipelines verwenden darf:
- Klicken Sie auf " Berechnen" in der Arbeitsbereich-Randleiste.
- Klicken Sie auf der Registerkarte Serverlos auf das Kebab-Menü neben Standard für automatisierte Rechenleistung und dann auf Berechtigungen bearbeiten.
- Entfernen Sie die Gruppe "Alle Benutzer" oder die Gruppe, die alle Arbeitsbereichsbenutzer enthält.
- Fügen Sie nur die spezifischen Benutzer, Gruppen oder Dienstprinzipale hinzu, die Sie autorisieren möchten.
Wenn Sie einem Benutzer den Zugriff auf Default Automated Compute entziehen, können Aufträge und Pipelines, die unter diesem Benutzer ausgeführt werden und dieses Compute-Objekt verwenden, nicht ausgeführt werden. Workloads, die ein benutzerdefiniertes automatisiertes Computeobjekt auswählen, erfordern eine Berechtigung für das ausgewählte Objekt.
Bevor Sie den Zugriff eines Benutzers auf die automatische Standardberechnung widerrufen, überwachen Sie, welche Aufträge und Pipelines die betroffenen Benutzer besitzen. Die folgende Abfrage identifiziert aktuelle serverlose Workloads für einen bestimmten Benutzer:
SELECT *
FROM system.billing.usage
WHERE usage_date >= date_add(now(), -30)
  AND billing_origin_product IN ('JOBS', 'DLT')
  AND identity_metadata.run_as = '<user_email>';
Überprüfen Sie die usage_metadata Spalte, um die betroffenen Ressourcen anzuzeigen, z. B. Auftrags-IDs und Pipeline-IDs.
Serverlose Verwendung überwachen
Serverlose Abrechnungsdaten enthalten ein serverless_compute_id Feld in usage_metadata. Verwenden Sie sie, um nachzuverfolgen, auf welchem Computeobjekt eine Workload ausgeführt wurde:
SELECT
  usage_metadata.serverless_compute_id,
  identity_metadata.run_as,
  SUM(usage_quantity) AS total_dbus
FROM system.billing.usage
WHERE billing_origin_product IN ('JOBS', 'DLT', 'INTERACTIVE')
  AND usage_metadata.serverless_compute_id IS NOT NULL
  AND usage_date >= date_add(now(), -30)
GROUP BY 1, 2
ORDER BY 3 DESC;
Unterstützte serverlose Compute-Zugriffskontrollfunktionen
Die folgenden Funktionen sind in serverlose Rechenzugangskontrollen integriert.
Interaktiv (Standard-interaktive Compute)
- Notebooks und AI Runtime-Notebooks
- Databricks Connect
Automatisiert (Standard-automatisierte Rechenleistung)
- Jobs und KI-Laufzeitjobs
- Spark Declarative Pipelines auf Lakeflow
Nicht unterstützte serverlose Compute-Zugriffskontrollfunktionen
Die folgenden Funktionen sind nicht in serverlose Rechenzugriffskontrollen integriert:
- Databricks SQL (DBSQL)
- Batch-Ableitung (
ai_query()) - Bereitstellung von Modellen
- Bereitgestellte Durchsatzendpunkte der Foundation-Modell-API
- Lakebase
- Databricks-Apps
- Bewertung von Agenten und synthetische Daten
- KI-Suchindexierung
- Prädiktive Optimierung
- Datenprofilierung
- Feingranulare Zugriffskontrolle auf dedizierter Compute-Ressource. Der Zugriff auf die dedizierte Berechnung bestimmt, ob ein Benutzer eine feingranulare Zugriffskontrolle nutzen kann.
Wenden Sie sich für alle features, die hier nicht aufgeführt sind, an Ihr Azure Databricks Kontoteam, um den Status zu fragen.
Einschränkungen der serverlosen Zugriffskontrolle
Important
Im Falle einer Serviceunterbrechung können Zugriffsprüfungen beim Öffnen scheitern, und Nutzer, denen sonst der Zugriff verweigert würde, könnten serverlose Workloads starten. Diese Funktion soll helfen, den Zugriff auf serverloses Rechnen zu steuern. Nutzen Sie diese Funktion nicht, um eine absolute Ausgabenobergrenze für die endgültig berechneten Beträge sicherzustellen. Azure Databricks ist nicht verantwortlich für Kosten, die durch Arbeitslasten entstehen, die während eines solchen Ereignisses laufen.
- Standardmäßige Computeobjekte können nicht umbenannt oder gelöscht werden.
- Jobs und Pipelines, die Default Automated Compute verwenden, benötigen Berechtigungen für dieses Objekt. Überprüfen Sie aktive Workloads, bevor Sie den Zugriff eines Benutzers entfernen.
- Die Hintergrundverarbeitung (systeminitiierte Jobs) ist von den Zugriffssteuerungen für serverlose Rechenressourcen ausgenommen.
Setze Rate-Limits für serverloses Rechnen
Important
Serverless-Ratelimits befinden sich in der Beta. Workspace-Administratoren können Ratelimits über die Previews-Seite mit der Einstellung Serverless Compute Rate Limit aktivieren.
Ein Ratelimit steuert, wie weit die Spark-Executoren einer automatisierten Workload automatisch skalieren können. Workspace-Administratoren können benutzerdefinierte automatisierte Rechenobjekte erstellen und jedem eine Größe zuweisen. Wenn eine Workload das Compute-Objekt verwendet, legt diese Größe die maximale Autoskalierungskapazität für Spark-Executors fest.
Ratenbegrenzungen gelten nur für automatisierte Workloads (Jobs und Lakeflow-Pipelines). Interaktive Workloads (Notebooks und Databricks Connect) unterliegen keiner Ratenbegrenzung.
Eine Größe entspricht einer ungefähren Databricks-Einheitenverbrauchsrate (DBU) für Spark-Executoren. Nutzungsgrenzen setzen keine feste Begrenzung für die Gesamtkosten der Arbeitsbelastung oder die endgültig abgerechneten Beträge. Sie begrenzen keine Kosten für Treiber, REPL-virtuelle Maschinen, GPUs oder für die Aktualisierung materialisierter Ansichten und von Streaming-Tabellen.
Das Ratelimit gilt unabhängig von jeder Workload, die das Compute-Objekt verwendet. Zwei Jobs, die dasselbe Compute-Objekt verwenden, erhalten jeweils die volle Obergrenze. Innerhalb eines Jobs wird das Limit über seine serverlosen Aufgaben hinweg geteilt, selbst wenn die Aufgaben auf separaten Clustern ausgeführt werden. Ein Compute-Objekt setzt keine aggregierte Begrenzung für alle Workloads, die es verwenden.
Anforderungen an das Tariflimit
- Um ein serverloses Compute-Objekt zu erstellen, müssen Sie Workspace-Admin sein oder über das Berechtigungsrecht zur uneingeschränkten Cluster-Erstellung verfügen.
- Um die Größe oder die Berechtigungen eines benutzerdefinierten Rechenobjekts zu bearbeiten, müssen Sie für dieses Objekt über „Kann verwalten“ verfügen.
- Um eine Workload auf einem Compute-Objekt auszuführen, müssen Sie auf diesem Objekt Can Use oder Can Manage haben.
Erstellen Sie eine serverlose Berechnung mit einer Ratenbegrenzung
- Klicken Sie auf " Berechnen" in der Arbeitsbereich-Randleiste.
- Klicken Sie auf der Registerkarte Serverless auf Serverlose Rechenressource erstellen.
- Geben Sie einen Namen ein.
- Für Größe wählen Sie die anzuwendende Ratenbegrenzung aus, von Klein bis 2X-Large. Lass es auf Standard eingestellt, um die Standardobergrenze deines Arbeitsbereichs zu verwenden.
- Klicke auf Erstellen.
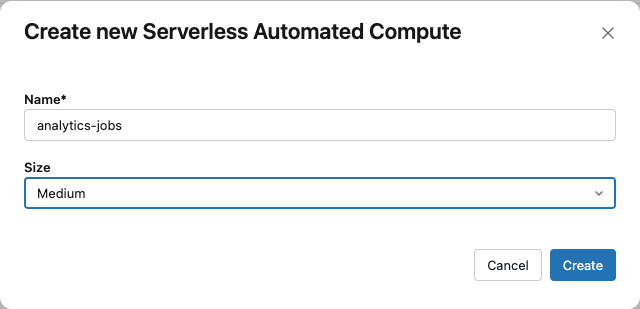
Das neue Compute-Objekt wird auf der Registerkarte Serverless mit dem Typ Automatisiert angezeigt. Gewähren Sie Benutzern Zugriff, bevor sie Workloads darauf ausführen. Du kannst die Größe eines Standard-Compute-Objekts nicht bearbeiten.
Zugriff auf kontingentierte Rechenleistung gewähren
- Öffnen Sie auf der Registerkarte "Serverless " das benutzerdefinierte Computeobjekt.
- Klicken Sie auf Aktionen und dann auf Berechtigungen bearbeiten.
- Fügen Sie die Benutzer, Gruppen oder Dienstprinzipale hinzu, die Zugriff benötigen.
- Gewähren Sie Can Use, um Workloads auszuführen, oder Can Manage, um zusätzlich die Größe und Berechtigungen zu bearbeiten.
- Klicke auf Speichern.
Änderung einer Ratenbegrenzung
- Öffnen Sie auf der Registerkarte "Serverless " das benutzerdefinierte Computeobjekt.
- Klicken Sie auf Bearbeiten.
- Wählen Sie für Größe eine Größe aus.
- Klicke auf Speichern.
Geschwindigkeitsbegrenzungsgrößen
Die folgenden Größen entsprechen ungefähr den Verbrauchsraten von Spark-Executoren:
| Größe | Ungefähre Verbrauchsrate des Executors |
|---|---|
| Klein | ~60 DBUs pro Stunde |
| Medium | ~120 DBU pro Stunde |
| Groß | ~240 DBU pro Stunde |
| X-Large | ~480 DBU pro Stunde |
| 2X-Large | ~960 DBU pro Stunde |
Diese Werte sind Schätzungen. Die tatsächliche Nutzung kann diese überschreiten, da es bei der serverlosen Infrastruktur zu Schwankungen kommen kann und Kosten anfallen können, die vom Ratenlimit nicht abgedeckt werden.
Die Wahl "Standard " nutzt die bestehende maximale Autoskalierungskapazität Ihres Arbeitsbereichs für serverlose automatisierte Workloads. Die Standardeinstellung hängt von der Ebene Ihres Arbeitsbereichs und etwaigen arbeitsbereichsspezifischen Einschränkungen ab.
Führen Sie einen Workload auf ratenbegrenzter Rechenkapazität aus
Ein Benutzer mit Can Use auf einem Compute-Objekt kann es auswählen, wenn er einen Job oder eine Pipeline konfiguriert. Die Arbeitslast läuft dann unter dem Rate-Limit der Rechenleistung. Wenn eine Workload kein Computeobjekt angibt, greift sie auf die automatisierte Standardcomputeressource Ihres Arbeitsbereichs zurück. Wenn der Benutzer keinen Zugriff auf diese Standardeinstellung hat, kann die Arbeitslast nicht ausgeführt werden.
- Jobs: Verwenden Sie in den Compute-Einstellungen des Jobs Compute policy, um das automatisierte serverlose Compute-Objekt auszuwählen. Der Selektor kann auch als Serverless Compute bezeichnet werden. Die Liste zeigt die Compute-Objekte, die die Run-as-Identität des Jobs nutzen darf. Um einen Job mit der Jobs-API zu konfigurieren, siehe Verwenden von rate-limited compute mit der Jobs-API.
- Pipelines: Wählen Sie das automatisierte Compute-Objekt als serverloses Compute-Objekt für eine Pipeline im Lakeflow-Editor aus.
Wenn ein Rate-Limit einen Job oder eine Pipeline drosselt, können Sie die Auswirkungen im Abfrageverlauf als EinblickCOMPUTE_SIZE oder für Pipelines in der Lakeflow-Benutzeroberfläche anzeigen.
Verwenden Sie ratenbegrenzte Compute-Ressourcen mit der Jobs-API
Um einen Job auf einem ratebegrenzten Rechenobjekt mit der Jobs-API auszuführen, definieren Sie einen Jobcluster, der serverless_compute.policy_id auf die ID des Compute-Objekts setzt. Dies ist dasselbe automatisierte serverlose Compute-Objekt, das als Compute-Richtlinie des Jobs ausgewählt wurde. Dann stellen Sie job_cluster_key auf jeder serverlosen Aufgabe im Job ein, um diesen Jobcluster zu referenzieren. Um die ID zu kopieren, klicken Sie im Serverless-Tab auf das Kebab-Menü für das Compute-Objekt und klicken Sie dann auf Compute-ID kopieren.
{
  "job_clusters": [
    {
      "job_cluster_key": "rate_limited",
      "serverless_compute": { "policy_id": "<compute-id>" }
    }
  ],
  "tasks": [
    {
      "task_key": "ingest",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/ingest" }
    },
    {
      "task_key": "transform",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/transform" }
    }
  ]
}
Ein Job kann höchstens einen Jobcluster definieren, mit dem serverless_compute festgelegt wird. Die gleiche Konfiguration gilt, wenn Sie einen Job erstellen, aktualisieren, zurücksetzen oder übermitteln sowie einen Job mit Declarative Automation Bundles bereitstellen. Für das vollständige Anforderungsschema siehe Erstellen eines neuen Jobs in der REST-API-Referenz.
Note
Das job_clusters[].serverless_compute_id Feld ist veraltet. Verwenden Sie stattdessen serverless_compute.policy_id.
Ratenbegrenzungen
- Die Ratenbegrenzungen begrenzen nur die automatische Skalierung des Spark-Executors. Andere Kostenbestandteile, wie der Treiber, REPL-VMs, GPUs und Aktualisierungen materialisierter Ansichten oder von Streaming-Tabellen, unterliegen keiner Obergrenze.
- Die DBU-pro-Stunden-Obergrenze für jede Größe ist eine Schätzung. Die tatsächliche Nutzung kann das Ziel übersteigen, da es nur geringe Schwankungen im angelegten Limit und die inhärente Variabilität der serverlosen Infrastruktur gibt.
- Eine Arbeitslast mit der 2x-Large Größe könnte unter den Erwartungen liegen, da die physische Clustergröße auf 256 Ausführende begrenzt ist. Wenn zwei oder mehr 2x-Large Workloads auf demselben Laufzeitcluster geplant sind, kann jeder weniger als die erwartete Leistung erzielen.
- Aufgrund der Abrechnungsimplementierungsdetails kann dieselbe Arbeitslast unterschiedliche DBU-Nutzung bei unterschiedlichen Tarifbegrenzungsgrößen verursachen.
- Man kann kein Ratenlimit für ein Standard-Rechenobjekt festlegen.