Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Migrieren Sie Ihre Workloads von klassischem Compute zu serverloser Berechnung. Serverlose Berechnungsdienste übernehmen automatisch die Bereitstellung, Skalierung, Laufzeitupgrades und Optimierung.
Die meisten klassischen Workloads können mit minimalen oder ohne Codeänderungen migriert werden. Zum Beispiel migrieren Workloads, die df.cache() und df.persist() verwenden, größtenteils ohne Codeänderungen. Diese Seite konzentriert sich auf diese Workloads. Bestimmte Workloads, die auf R- oder Scala-Notebooks angewiesen sind, erfordern klassische Compute-Ressourcen und können nicht auf serverlose Systeme migrieren. Eine vollständige Liste der aktuellen Einschränkungen finden Sie unter Serverless Compute Limitations.
Migrieren mit Genie Migrate for Serverless
Important
Dieses Feature befindet sich in der Betaversion. Workspace-Administratoren können sie über die Vorschauseite aktivieren, indem sie sich für die Compute Agent-Vorschau entscheiden. Siehe Manage Azure Databricks Previews.
Genie Migrate for Serverless ist ein Agent, der ein einzelnes Notebook oder einen Job zu serverlosem Computing migriert. Der Agent überprüft die Umgebung der Arbeitslast, Bibliotheken, Spark-Konfigurationen, Tags und Code und schlägt dann jede Änderung als individuellen Vorschlag vor, den Sie akzeptieren oder ablehnen können. Akzeptierte Änderungen werden an Ort und Stelle angewendet und können rückgängig gemacht werden.
Verwenden Sie Genie Code, um ein Notizbuch oder einen Job interaktiv zu migrieren, oder verwenden Sie die Databricks-CLI, um Jobs im Hintergrund zu migrieren, einschließlich vieler Jobs aus einem Skript. Siehe Jobs mit der Databricks-CLI migrieren.
Was der Agent überprüft und ändert
| Region | Was der Agent tut |
|---|---|
| Umwelt und Bibliotheken | Übersetzt Bibliotheksinstallationen in eine Spezifikation für eine serverlose Umgebung, einschließlich %pip-Installationen, Cluster-Init-Skripten, Cluster-Bibliotheken in Jobs und Verweise auf einen privaten Paketindex. |
| Umgebungsvariablen | Übersetzt Clusterumgebungsvariablen in ihre serverlosen Entsprechungen, bewahrt Workspace-Secret-Referenzen und lässt plattformverwaltete Werte weg. |
| Daten- und Speicherzugriff | Schreibt serverlos-inkompatible Pfade, wie lokale Festplatte dbfs:/und Mount-Pfade, auf Unity Catalog-Volumes um. Der Agent wednet eindeutige Umschreibungen automatisch an und bittet Sie, ein Volume auszuwählen, wenn das Ziel unklar ist. |
| Spark-Konfigurationen | Klassifiziert jede Spark-Konfiguration, kommentiert Konfigurationen, die sicher zum Entfernen sind, und markiert und entfernt Konfigurationen, die serverless nicht unterstützt. Deckt sowohl clustergebundene als auch In-Notebook-Konfigurationen ab. |
| Workloadcode | Schreibt Code, den serverless nicht unterstützt, in kompatible Äquivalente um, wie RDD-Operationen, die in DataFrame-Operationen umgeschrieben werden, und passt den Code an das ANSI-Mode-SQL-Verhalten auf serverless an. |
| Stichwörter | Übersetzt benutzerdefinierte Cluster-Tags, wie zum Beispiel einen Cost-Center-Tag, in deren serverlose Äquivalente. |
| Leistungsmodus | Schlägt einen Leistungsmodus basierend auf der Konfiguration des Clusters vor. Weitere Informationen finden Sie unter "Auswählen eines Leistungsmodus". |
Anforderungen
Ein Workspace-Admin-Zugriff wird empfohlen, um eine vollständige Migration sicherzustellen. Das liegt daran, dass der Agent auch globale Init-Skripte auf Arbeitsflächenebene über die Zielarbeitslast hinaus inspiziert. Du kannst möglicherweise migrieren, wenn du über die Berechtigung
CAN MANAGEfür die Arbeitslast verfügst, aber ohne Administratorrechte kann es zu fehlenden Bibliotheken, Umgebungseinstellungen oder Tags kommen.Bestätigen Sie, dass Sie Zugang zum Agenten haben. Gib Genie-Code
/computeein./computesollte im Autocomplete-Menü erscheinen. Wenn sie nicht angezeigt wird, muss ein Workspace-Administrator die Vorschau in Ihrem Workspace aktivieren.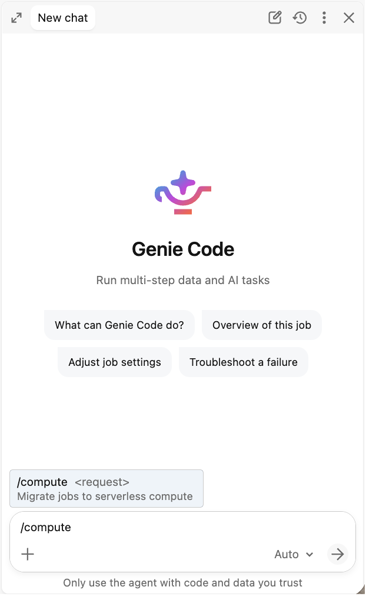
Ein Notizbuch migrieren
- Öffne das Notizbuch, das du migrieren möchtest.
- Öffne Genie Code und starte
/compute migrate to serverlessaus der/Befehlspalette. - Überprüfen Sie die Erkenntnisse des Agenten. Der Agent scannt die Umgebung, die Bibliotheken und den Code des Notebooks und schlägt für jedes benötigte Element eine Änderung vor, wie zum Beispiel das Verschieben einer Bibliotheksinstallation in eine Umgebungsspezifikation oder das Umschreiben einer Codezelle für serverlosen Betrieb.
- Akzeptieren oder lehnen Sie jede vorgeschlagene Änderung ab.
- Wenden Sie die von Ihnen akzeptierten Änderungen an. Sie werden direkt im Notebook geschrieben.
- Verbinde das Notebook mit Serverless und lasse es laufen, um sicherzugehen, dass es sich wie erwartet verhält. Siehe Überprüfen Sie eine migrierte Workload.
Einen Job migrieren
- Öffne den Job, zu dem du wechseln möchtest.
- Öffne Genie Code und starte
/compute migrate to serverlessaus der/Befehlspalette. - Der Agent klont deinen Job und versucht, den geklonten Job auf serverlos zu migrieren.
- Überprüfen Sie die Erkenntnisse des Agenten. Für einen Multitask-Job zählt der Agent jede Aufgabe und deren Cluster-Konfiguration pro Aufgabe auf und schlägt Änderungen für jeden vor, während der Zeitplan des Jobs erhalten bleibt.
- Akzeptieren oder lehnen Sie jede vorgeschlagene Änderung auf der Migrationsfläche ab: Umgebung und Bibliotheken, Spark-Konfigurationen und jeglichen Workload-Code, der geändert werden muss.
- Wenden Sie die von Ihnen akzeptierten Änderungen an. Die Rechenkapazität des Jobs wird auf Serverless umgestellt.
- Führe den Job serverlos aus und bestätige die Ergebnisse. Siehe die Überprüfung einer migrierten Workload.
- Optional kann der Agent als letzten Schritt den migrierten Klon heraufstufen. Es kopiert die Konfiguration und Notizbücher des Klons zurück auf deinen ursprünglichen Job (wobei die gleiche Job-ID, der Zeitplan und die Berechtigungen bebleiben), und löscht dann den Klon. Wenn du die Promotion überspringst, hält sich dein ursprünglicher Job an seinen Zeitplan und läuft weiterhin mit klassischem Compute. Der Klon hat keinen Zeitplan oder Trigger, daher läuft er nur, wenn du ihn startest.
Jobs mit der Databricks-CLI migrieren
Verwenden Sie die compute-migrations Befehlsgruppe in der Databricks-CLI, um Genie Migrate for Serverless auf einem Job im Hintergrund auszuführen, ohne eine offene Genie Code-Sitzung zu haben. Du kannst Migrationen für viele Jobs aus einem Skript starten und jeden überprüfen, sobald er fertig ist.
Der Databricks CLI-Pfad hat folgende Anforderungen:
- Ein Workspace-Administrator hat die Vorschau des Compute Agents aktiviert. Ohne sie scheitert jeder
compute-migrationsBefehl mitPERMISSION_DENIED. - Databricks CLI Version 1.24.0 oder höher. Siehe Installieren oder Aktualisieren der Databricks CLI.
-
Sie benötigen die Berechtigung
CAN MANAGEfür jeden Job, den Sie migrieren.
Der Agent sichert den Job und erstellt dann eine serverlose Arbeitskopie. Die Arbeitskopie ist ein neuer Job mit dem Namen [Serverless Migration - <timestamp>] <job name>, der Kopien der Notizbücher und Dateien des Auftrags verwendet. Es hat keinen Zeitplan oder Trigger, daher läuft es nur, wenn Sie es starten oder wenn Azure Databricks es zur Validierung ausführt. Dein ursprünglicher Job wird nicht geändert, bis du die Migration genehmigt hast.
Warnung
Ein Validierungslauf ist nicht isoliert. Die Arbeitskopie läuft gegen dieselben Tabellen, Volumes, Checkpoints und externen Systeme wie der ursprüngliche Job. Wenn der Auftrag in Produktionstabellen schreibt, Benachrichtigungen sendet, externe APIs aufruft oder Streaming-Checkpoints fortschreibt, tut das auch der Validierungslauf. Setzen Sie run_validation nur für Jobs, bei denen ein zusätzlicher Durchlauf sicher ist. Sie können diese Einstellung nicht ändern, nachdem Sie die Migration erstellt haben.
Bearbeite den Originalauftrag oder die Arbeitskopie nicht, während eine Migration im Gange ist. Die Genehmigung der Migration ersetzt die Einstellungen und Dateien der Arbeitsversion durch die des ursprünglichen Auftrags.
Starten Sie eine Migration für den Auftrag:
databricks compute-migrations create -o json --request-id "<uuid>" --json '{
  "asset_type": "JOB",
  "asset_uri": "jobs/<job-id>",
  "auto_approve": false,
  "run_validation": false
}'
Die Antwort enthält die Migrations-ID. Verwenden Sie für jeden Job einen neuen
request-idund verwenden Sie ihn wieder, wenn Sie es nach einem Timeout erneut versuchen, damit keine doppelte Migration entsteht. Sie könnenauto_approveoderrun_validationnicht mehr ändern, nachdem Sie die Migration erstellt haben.Überprüfen Sie den Zustand der Migration mit
databricks compute-migrations get <migration-id> -o json. Die Planung und Erstellung der Arbeitsversion dauert in der Regel mehrere Minuten. Um viele Migrationen zu überprüfen, verwenden Sielist, und bestätigen Sie dann jede einzelne mitget, bevor Sie Maßnahmen dazu ergreifen.Wenn die Migration
TRANSLATION_READYerreicht, überprüfen Sie die Arbeitskopie.migration_report.primary_asset.idist die Job-ID der Arbeitskopie. Vergleichen Sie dessen Einstellungen und Code mit dem ursprünglichen Job und führen Sie dannapprove-migration-translationoderreject-migration-translationmit dem--etagaus Ihrem letztengetaus.Wenn Sie
run_validationfestlegen, führt Azure Databricks die Arbeitskopie einmal aus und zeichnet das Ergebnis invalidation_reportauf. Die Migration wechselt unabhängig davon, ob der Lauf erfolgreich ist oder fehlschlägt, zuMIGRATION_REVIEW, prüfen Sie dahervalidation_report.passedvor der Genehmigung.Wenn die Migration
MIGRATION_REVIEWerreicht, überprüfen Sie die Arbeitskopie und das Validierungsergebnis und führen Sie dannapprove-migration-executionoderreject-migration-executionmit dem--etagaus Ihrem letztengetaus. Durch die Genehmigung werden die Einstellungen und Dateien der Arbeitskopie auf den ursprünglichen Auftrag angewendet, wobei dieser seine Job-ID, seinen Zeitplan und seine Berechtigungen behält.Wenn die Migration
MIGRATION_COMPLETEerreicht, ist der ursprüngliche Job geändert worden. Überprüfe es sofort. Siehe Überprüfen Sie eine migrierte Workload.Nachdem Sie den ursprünglichen Auftrag überprüft haben, löschen Sie den Auftrag der Arbeitskopie.
migration_report.secondary_assetslistet Notizbücher auf, die in der Arbeitskopie ausgeführt werden. Lösche sie erst, nachdem du bestätigt hast, dass der ursprüngliche Auftrag nicht darauf verweist.
Jeder Ablehnungsbefehl erfordert einen Ablehnungsgrund, den Sie nach der Migrations-ID angeben. Beispiele:
databricks compute-migrations reject-migration-translation <migration-id> "Keep the existing output table names." --etag <etag>
Gib einen konkreten Grund an. Der Agent überarbeitet die Arbeitsversion und schickt sie zur Überprüfung zurück. Wenn Sie eine Migration wiederholt ablehnen, scheitert sie.
Die folgende Tabelle listet die Befehle compute-migrations auf:
| Command | Description |
|---|---|
create |
Beginnt eine Migration für einen Job. Scheitert mit ALREADY_EXISTS, wenn der Job eine laufende Migration hat oder eine Migration bereits erfolgreich abgeschlossen wurde. |
get, list |
Gibt den Zustand, die Berichte und etag einer Migration oder aller Migrationen zurück. |
approve-migration-translation, reject-migration-translation |
Genehmigt oder lehnt die Arbeitskopie im Status TRANSLATION_READY ab. Das Festlegen von auto_approve beim Erstellen überspringt diese Überprüfung. |
approve-migration-execution, reject-migration-execution |
Genehmigt oder lehnt die Migration im Status MIGRATION_REVIEW ab. Das Genehmigen ändert die ursprüngliche Aufgabe. |
cancel-migration |
Stoppt eine Migration. Ein Abbruch macht weder bereits auf den ursprünglichen Auftrag angewandte Änderungen noch die Nebenwirkungen eines Validierungslaufs rückgängig. |
delete |
Entfernt den Migrationsdatensatz. Rollt keine Änderungen zurück oder entfernt nicht die Arbeitskopie oder das Sicherungsbackup. Eine Migration, die fehlgeschlagen ist oder abgebrochen wurde, freigibt den Job bereits, sodass Sie ihn nicht löschen müssen, bevor Sie eine neue Migration starten. |
Übergebe bei jedem Genehmigen-, Ablehnen- oder Abbrechen-Befehl get aus deinem neuesten --etag. Wenn sich die Migration seit dem Lesen geändert hat, schlägt der Befehl mit ABORTED fehl, anstatt auf einen Zustand zu handeln, den Sie nicht überprüft haben. Wenn der Agent den Job nicht migrieren kann, verschiebt sich die Migration zu NOT_SUPPORTED oder FAILED, und state_history erklärt, warum.
Überprüfen Sie eine migrierte Workload
Der Agent schlägt Änderungen vor und wendet sie an, überprüft jedoch nicht die Ausgabe Ihrer Workload. Ein Validierungslauf mit der Databricks-CLI überprüft nur, ob der Lauf erfolgreich ist. Führe immer eine migrierte Workload serverlos aus und überprüfe die Ergebnisse, bevor du darauf angewiesen bist, besonders bei Workloads, die in Produktionstabellen schreiben. Wenn der Makler eine Änderung vorschlägt, die falsch aussieht, lehnen Sie sie ab und schicken Sie uns Feedback, damit wir den Makler verbessern können. Siehe "Produktfeedback übermitteln".
Tip
Während du eine migrierte Arbeitslast validierst, führe sie im leistungsoptimierten Modus aus. Er startet schneller als im Standardmodus, sodass du schnelleres Feedback bekommst, wenn du das Ergebnis bestätigt. Wechsle zu dem Modus, der am besten zur Arbeitslast passt, bevor du es in der Produktion ausführst. Weitere Informationen finden Sie unter "Auswählen eines Leistungsmodus".
Wenn der Agent etwas findet, das er nicht sicher migrieren kann, meldet er einen Blocker und stoppt standardmäßig. Sie können explizit anweisen, bestimmte Kompatibilitäts- oder Abhängigkeitsblocker zu übergehen, akzeptieren damit jedoch das Risiko, dass diese Abhängigkeiten, die Kostenzuordnung oder das Laufzeitverhalten nicht erhalten bleiben und die Workload in serverlosen Umgebungen fehlschlagen kann.
Migrationsänderungen zurücksetzen
Die Änderungen, die der Agent vornimmt, sind rückgängig.
Für ein Notizbuch öffne es und stelle die Version von kurz vor der Migration wieder her. Siehe Versionsverlauf in Databricks-Notizbüchern.
Bei einem Job: Wenn Sie den migrierten Klon nicht im Genie Code heraufgestuft oder die Migration mit der Databricks-CLI nicht bestätigt haben, wurde Ihr ursprünglicher Job nie geändert. Führen Sie es wie zuvor aus und löschen Sie den Klon oder die Arbeitskopie. Andernfalls stellen Sie das Backup wieder her, das der Agent erstellt hat, bevor er Änderungen vorgenommen hat:
- Öffnen Sie den Backup-Ordner:
/Workspace/Users/<username>/serverless-migration/backups/job-<job-id>/<timestamp>/. Das Backup befindet sich im Home-Verzeichnis des Benutzers, der die Migration durchgeführt hat; bei der Databricks-CLI ist das der Benutzer, der sie erstellt hat. Im Genie Code zeigt der Agent diesen Pfad während der Migration ebenfalls an. Wenn es mehrere Zeitstempel gibt, wähle den, der kurz vor der Migration war. - Öffne
job.yaml, das deine Jobeinstellungen vor der Migration enthält, und wende diese Einstellungen mit einerPOST /api/2.2/jobs/resetAnfrage wieder auf denselben Job an, wodurch die Einstellungen des Jobs mit den von dir bereitgestellten Einstellungen überschreibt werden. Du kannst sie auch in die JSON-Definition des Jobs in der Benutzeroberfläche einfügen. Dadurch wird der Job auf klassische Berechnung zurückgegeben. - Öffnen
mapping.yaml, das jede gesicherte Datei und den ursprünglichen Pfad auflistet, von dem sie stammt. Kopieren Sie jede Sicherungsdatei zurück an ihren ursprünglichen Speicherort, um die Codeänderungen rückgängig zu machen. - Führe den Job aus, um sicherzustellen, dass er sich genauso wie vor der Migration verhält.
Die Migration löscht dieses Backup nie. Aufgaben, die der Agent nicht geändert hat, etwa aus Git stammende, SQL- oder dbt-Aufgaben, werden in job.yaml erfasst, ihre Dateien werden jedoch nicht in das Backup kopiert. Stellen Sie sie daher bei Bedarf aus Ihrer maßgeblichen Quelle wieder her.
Bekannte Einschränkungen
- Folgende Versionen werden als Blocker gemeldet: benutzerdefinierte Images, ML-Runtime-Varianten, Databricks Runtime-Versionen vor 13, Spark-Konfigurationen, die serverlos nicht sicher ignoriert werden können, sowie Abhängigkeiten wie Eggs, JARs und Maven-Bibliotheken. Ein Blocker bedeutet, dass der Agent aufhört, anstatt diesen Gegenstand zu migrieren. Du kannst es entweder selbst lösen und die Migration erneut ausführen oder dem Agenten sagen, dass er trotzdem migrieren soll, wodurch das Element ungelöst bleibt und die Arbeitslast auf Serverless versagt.
- Der Agent liest Init-Skripte, die in Workspace-Dateien oder Unity-Catalog-Volumes gespeichert sind. Init-Skripte, die in ABFSS oder DBFS gespeichert sind, können nicht gelesen werden und werden als Blocker gemeldet.
- Der Agent inspiziert nicht jedes klassische Compute-Attribut. Die Bereitstellung von Cluster-Protokollen und SSH-Schlüssel werden nicht abgebildet, und obwohl viele DBFS-Mount-Abhängigkeiten im Workload-Code erkannt werden, werden nicht alle Mounts aufgelistet oder aufgelöst.
- Cache- und Checkpoint-APIs, globale temporäre Ansichten, DBFS-Mount-Management-Aufrufe sowie Scala- oder R-Code sind standardmäßig harte Blocker. Du kannst den Agenten anweisen, fortzufahren, aber die ungelöste Funktionalität bleibt unverändert und kann auf Serverless versagen.
- Jobs mit mehr als 10 migrierbaren Aufgaben können nicht migriert werden.
- Der Agent in Genie Code migriert jeweils eine Workload. Um mehrere Jobs zu migrieren, erstellen Sie mit der Databricks-CLI pro Job eine Migration. Es gibt keinen geräteparkweiten Erkennungs- oder Admin-Genehmigungsworkflow.
- Mit der Databricks-CLI migriert der Agent nur Jobs. Ein Job, bei dem ein Notebook oder eine Python-Aufgabe aus einem entfernten Git-Repository stammt, kann nicht migriert werden.
- Der Agent schlägt Änderungen vor und wendet die von Ihnen akzeptierten Änderungen an, überprüft jedoch nicht die Korrektheit der Ausgabe. Verifiziere eine migrierte Arbeitslast, bevor du dich darauf für Produktionsdaten verlässt.
- Wenn die Quelle der Wahrheit deines Workloads ein Databricks Asset Bundle oder ein Git-Ordner ist, wendet der Agent Änderungen am jeweiligen Workspace-Objekt vor. Gleiche diese Änderungen mit deinem Bundle oder Repository ab, damit ein späterer Deployment die Migration nicht überschreibt.
Manuell auf serverlos migrieren
Führen Sie die folgenden Schritte aus, um Ihre Workloads von der klassischen Compute zur serverlosen Berechnung zu migrieren:
- Prüfen Sie die Voraussetzungen: Stellen Sie sicher, dass Ihr Arbeitsbereich, Netzwerk und Cloud-Speicherzugriff die Anforderungen erfüllen. Siehe Voraussetzungen.
- Code aktualisieren: Nehmen Sie alle erforderlichen Code- und Konfigurationsänderungen vor. Informationen finden Sie unter Aktualisieren des Codes.
- Testen Sie Ihre Workloads: Überprüfen Sie Kompatibilität und Korrektheit, bevor Sie umstellen. Weitere Informationen finden Sie unter "Testen Ihrer Workloads".
- Wählen Sie einen Leistungsmodus: Wählen Sie den Leistungsmodus aus, der am besten zu Ihren Workload-Anforderungen passt. Weitere Informationen finden Sie unter "Auswählen eines Leistungsmodus".
- Migrieren in Phasen: Serverless schrittweise ausrollen, beginnend mit neuen und risikoarmen Workloads. Siehe Migrieren in Phasen.
- Kosten überwachen: Serverless-DBU-Verbrauch verfolgen und Warnungen einrichten. Siehe "Kosten überwachen".
Prerequisites
Bevor Sie mit der Migration beginnen, müssen Sie möglicherweise einige ältere Konfigurationen in Ihrem Arbeitsbereich aktualisieren.
| Voraussetzung | Action | Einzelheiten |
|---|---|---|
| Der Arbeitsbereich ist für Unity Catalog aktiviert | Migrieren von Hive Metastore bei Bedarf | Einen Azure Databricks-Arbeitsbereich auf Unity Catalog aktualisieren |
| Netzwerkkonfiguration abgeschlossen | Ersetzen des VPC-Peerings durch NCCs, Private Link oder Firewallregeln | Serverlose Computeebenennetzwerke |
| Cloudspeicherzugriff | Ersetzen Sie Altdatenzugriffsmuster durch externe Speicherorte im Unity-Katalog. | Verbinden Sie sich mit Cloud-Objektspeicher über den Unity Catalog |
Vergewissern Sie sich, dass sich Ihr Arbeitsbereich in einer unterstützten Region befindet.
Aktualisieren Ihres Codes
In den folgenden Abschnitten werden die Code- und Konfigurationsänderungen aufgeführt, die erforderlich sind, um Ihre Workloads mit serverlosen Servern kompatibel zu machen.
Datenzugriff
Ältere Datenzugriffsmuster werden auf serverlosen Servern nicht unterstützt. Aktualisieren Sie Ihren Code, um stattdessen Unity-Katalog zu verwenden.
| Klassisches Muster | Serverlose Ersetzung | Einzelheiten |
|---|---|---|
DBFS-Pfade (dbfs:/...) |
Unity Catalog-Volumes | Was sind Unity Catalog-Volumes? |
| Hive-Metastore-Tabellen | Unity Catalog-Tabellen (oder HMS-Verbund) | Einen Azure Databricks-Arbeitsbereich auf Unity Catalog aktualisieren |
| Anmeldeinformationen für Speicherkonto | Externe Speicherorte des Unity-Katalogs | Verbinden Sie sich mit Cloud-Objektspeicher über den Unity Catalog |
| Benutzerdefinierte JDBC-JARs | Lakehouse-Verbund | Was ist Abfrageföderation? |
Warnung
DER DBFS-Zugriff ist auf serverlosen Servern beschränkt. Aktualisieren Sie alle dbfs:/ Pfade zu Unity-Katalogvolumes vor der Migration. Weitere Informationen finden Sie unter Migrieren von Dateien, die in DBFS gespeichert sind.
Beispiel: DBFS-Pfade und Hive Metastore-Verweise ersetzen
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
APIs und Code
Bestimmte APIs und Codemuster werden auf serverlosen Servern nicht unterstützt. Verweisen Sie auf diese Tabelle, um festzustellen, ob Ihr Code aktualisiert werden muss.
| Klassisches Muster | Serverlose Ersetzung | Einzelheiten |
|---|---|---|
RDD-APIs (sc.parallelize, rdd.map) |
DataFrame-APIs | Spark Connect mit Spark Classic vergleichen |
spark.sparkContext, sqlContext |
Verwenden Sie spark (SparkSession) direkt |
Spark Connect mit Spark Classic vergleichen |
Hive-Variablen (${var}) |
SQL DECLARE VARIABLE oder Python f-Zeichenfolgen |
DECLARE VARIABLE |
| Nicht unterstützte Spark-Konfigurationen | Entfernen Sie nicht unterstützte Konfigurationen. Die meisten Einstellungen werden von Serverless automatisch optimiert. | Konfigurieren Sie Spark-Eigenschaften für serverlose Notebooks und Jobs |
Beispiel: RDD-Operationen durch DataFrames ersetzen
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Beispiel: SparkContext-APIs ersetzen
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")
Unterschiede im SQL-Verhalten
Serverloses Computing aktiviert den ANSI-Modus standardmäßig. Databricks Runtime aktiviert standardmäßig den ANSI-Modus in Version 17.0 und höher. Wenn Ihr klassisches Compute auf einer früheren Version läuft, führen einige Abfragen, die dort erfolgreich sind, auf Serverless zu Laufzeitfehlern.
Genie Migrate for Serverless passt den Code automatisch für das Verhalten im ANSI-Modus an. Wenn Sie manuell migrieren, überprüfen Sie die folgenden Operationen, die am häufigsten das Verhalten ändern:
| Operation | Klassische Berechnung mit deaktiviertem ANSI-Modus | Serverloses Rechnen |
|---|---|---|
Ungültige Typumwandlung, wie zum Beispiel CAST('abc' AS INT) |
Gibt NULL zurück |
Löst CAST_INVALID_INPUT aus |
| Arithmetischer Überlauf bei ganzen Zahlen | Wickelt sich um.
2147483647 + 1 gibt beispielsweise -2147483648 zurück. |
Löst ARITHMETIC_OVERFLOW aus |
| Dezimalarithmetischer Überlauf | Gibt NULL zurück |
Löst NUMERIC_VALUE_OUT_OF_RANGE aus |
| Division durch Null | Gibt NULL zurück |
Löst DIVIDE_BY_ZERO aus |
| Fehlerhafte URL in parse_url | Gibt NULL zurück |
Erhöht INVALID_URL |
Um NULL zurückzugeben, anstatt einen Fehler auszulösen, ersetzen Sie die Operation durch ihr try_* Äquivalent, wie try_cast, try_add, try_divide oder try_parse_url. Databricks empfiehlt diesen Ansatz anstelle des Deaktivierens des ANSI-Modus, da der ANSI-Modus Datenqualitätsprobleme aufdeckt, die ein stilles NULL verbirgt.
Um den ANSI-Modus für Casts, Arithmetik und Parsing abzuschalten, setzen Sie spark.sql.ansi.enabled auf false. Serverless Compute wendet ANSI-Regeln auf implizite Casts bei Tabelleneinfügungen an, unabhängig von dieser Einstellung, da spark.sql.storeAssignmentPolicy auf serverless Compute nicht geändert werden kann. Für eine vollständige Beschreibung des ANSI-Verhaltens siehe ANSI-Compliance in Databricks Runtime.
Bibliotheken und Umgebungen
Sie können Bibliotheken und Umgebungen auf Arbeitsbereichsebene mithilfe von Basisumgebungen und auf Notizbuchebene mithilfe der serverlosen Umgebung des Notizbuchs verwalten.
| Klassisches Muster | Serverlose Ersetzung | Einzelheiten |
|---|---|---|
| Init-Skripte | Serverlose Umgebungen | Konfigurieren der Serverless-Umgebung |
| Clusterweite Bibliotheken | Notebook-relevante oder Umgebungsbibliotheken | Konfigurieren der Serverless-Umgebung |
| Maven/JAR-Bibliotheken | JAR-Aufgabenunterstützung für Aufgaben; PyPI für Notebooks | JAR-Task für Jobs |
| Docker-Container | Serverlose Umgebungen für Bibliotheksanforderungen | Konfigurieren der Serverless-Umgebung |
Anheften Python Pakete in requirements.txt für reproduzierbare Umgebungen. Siehe Specify Python Paketversionen.
Streamen
Streamingworkloads werden auf serverlosen Servern unterstützt, aber bestimmte Trigger werden nicht unterstützt. Aktualisieren Sie Ihren Code, um die unterstützten Trigger zu verwenden.
| Spark-Trigger | Unterstützt | Hinweise |
|---|---|---|
Trigger.AvailableNow() |
Ja | Empfohlen |
Trigger.Once() |
Ja | Dies ist veraltet. Verwenden Sie stattdessen Trigger.AvailableNow(). |
Trigger.ProcessingTime(interval) |
No | Gibt INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED zurück |
Trigger.Continuous(interval) |
No | Verwenden Sie stattdessen den kontinuierlichen Modus für Lakeflow-Pipelines. |
Standardwert (kein .trigger() festgelegt) |
No | Das Weglassen von .trigger() führt standardmäßig zu ProcessingTime("0 seconds"), was auf einer serverlosen Architektur nicht unterstützt wird. Setzen Sie .trigger(availableNow=True) immer explizit. |
Migrieren Sie für kontinuierliches Streaming zum Spark Declarative-Pipelines im kontinuierlichen Modus oder verwenden Sie kontinuierlich-geplante Einzelvorgänge mit AvailableNow. Setzen Sie bei großen Quellen maxFilesPerTrigger oder maxBytesPerTrigger ein, um Speicherfehler zu verhindern.
Beispiel: Streaming-Trigger beheben
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Testen Sie Ihre Workloads
- Schneller Kompatibilitätstest: Führen Sie die Workload auf Classic Compute mit Standard-Zugriffsmodus und Databricks Runtime 14.3 oder höher aus. Wenn die Ausführung erfolgreich ist, kann die Workload ohne Codeänderungen zu serverlosen Servern migriert werden.
- A/B-Vergleich (empfohlen für die Produktion): Führen Sie dieselbe Workload auf Classic (Kontrollgruppe) und serverless (Experiment) aus. Diff-Ergebnistabellen und Korrektheit überprüfen. Iteriere, bis die Ausgaben übereinstimmen.
- Temporäre Konfigurationen: Sie können während des Tests vorübergehend unterstützte Spark-Konfigurationen festlegen. Entfernen Sie sie, sobald sie stabil sind.
Auswählen eines Leistungsmodus
Serverlose Aufträge und Pipelines unterstützen zwei Leistungsmodi: Standard- und Leistungsoptimiert. Der von Ihnen ausgewählte Leistungsmodus hängt von Ihren Workloadanforderungen ab.
| Modus | Verfügbarkeit | Unternehmensgründung | Am besten geeignet für: |
|---|---|---|---|
| Standard | Aufträge, Lakeflow-Pipelines | Typischerweise 4–6 Minuten | Kostensensitiver Batch |
| Leistungsoptimiert | Aufträge, Lakeflow-Pipelines | In der Regel weniger als eine Minute | Interaktiv, latenzempfindlich |
Der Standardmodus verbraucht weniger DBUs als der leistungsoptimierte Modus, wodurch er weniger kostet. Um die Modi zu vergleichen und den Modus für einen migrierten Job oder eine Pipeline einzustellen, siehe "Einen Performance-Modus für serverlose Jobs und Pipelines auswählen".
Migrieren in Phasen
- Neue Workloads: Alle neuen Notebooks und Aufgaben auf Serverless starten.
- Risikoarme Workloads: Migrieren Sie PySpark/SQL-Workloads, die bereits im Standardzugriffsmodus und Databricks Runtime 14.3 oder höher sind.
- Komplexe Workloads: Migrieren Sie Workloads, die Codeänderungen benötigen (RDD-Neuschreibungen, DBFS-Updates, Trigger-Fixes).
- Verbleibende Workloads: Überprüfen Sie regelmäßig, wenn die Funktionen erweitert werden.
Kosten überwachen
Serverlose Abrechnung basiert auf DBU-Verbrauch und nicht auf Cluster-Uptime. Überprüfen Sie die Kostenerwartungen mit repräsentativen Workloads, bevor Sie die Migration im großen Maßstab durchführen. Tools und Strategien zur Überwachung serverloser Kosten finden Sie unter Überwachen der Kosten für serverloses Berechnen.
Weitere Ressourcen
- Best Practices für Serverless-Computing: Optimierungstipps für serverlose Workloads
- Einschränkungen bei serverlosem Computing: Vollständige Liste der aktuellen Einschränkungen und nicht unterstützter Funktionen
- Serverlose Umgebung konfigurieren: Bibliotheken und Abhängigkeiten verwalten
- Unterstützte Spark-Konfigurationen: Spark-Konfigurationen auf Serverless verfügbar
- Spark Connect vs. klassisches Spark: Verhaltensunterschiede in der serverlosen Architektur
-
DataFrames auf serverloser Rechenleistung cachen: DataFrames mit
df.cache()unddf.persist()cachen - Serverlose Netzwerksicherheit: NCCs, Private Link und Firewall-Konfiguration
- Serverless Compute Release Notes: Verfolgen Sie neue Funktionen, sobald sie ausgeliefert werden
- Unity Catalog Upgrade Leitfaden: Migrieren von Hive Metastore in Unity Catalog
Weitere Informationen finden Sie auch in den folgenden Blogbeiträgen:
- Was ist serverloses Computing?: Überblick über serverless-Funktionalitäten und Kundenergebnisse
- Entwicklung des Data Engineering: Wie serverloses Computing Notebooks und Lakeflow-Jobs transformiert: Wie serverloses Computing Lakeflow Jobs und Pipelines antreibt