Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Dateningenieure müssen häufig Daten aus quellen vor Azure Databricks replizieren, z. B. relationale Datenbanken (Oracle, Postgres, SQL Server), in Azure Databricks für Analysen, Berichte und maschinelles Lernen. Da sich die betriebstechnischen Systeme ändern, müssen analytische Tabellen mit diesen Änderungen synchronisiert bleiben.
Einige Teams müssen den aktuellen Status ihrer betriebstechnischen Datenbanken für Berichte und Analysen widerspiegeln. Andere müssen einen vollständigen Verlauf der Änderungen für die Auditierbarkeit, behördliche Anforderungen oder Kundenanalysen beibehalten.
Änderungsdatenerfassung (Data Capture, CDC) behandelt eine Datenbank als eine Reihe von Änderungen und nicht als vollständige statische Datenbank. Das folgende Diagramm zeigt, dass beim Aktualisieren einer Zeile in einer Quelltabelle, die Mitarbeiterdaten enthält, ein neuer Satz von Zeilen in einem CDC-Feed generiert wird, der nur die Änderungen enthält. Jede Zeile des CDC-Feeds enthält in der Regel zusätzliche Metadaten, einschließlich des Vorgangs wie UPDATE z. B. und einer Spalte, die verwendet werden kann, um jede Zeile im CDC-Feed deterministisch zu ordnen, sodass Sie Out-of-Order-Updates verarbeiten können. Die sequenceNum-Spalte im folgenden Diagramm bestimmt die Reihenfolge der Zeilen im CDC-Feed.
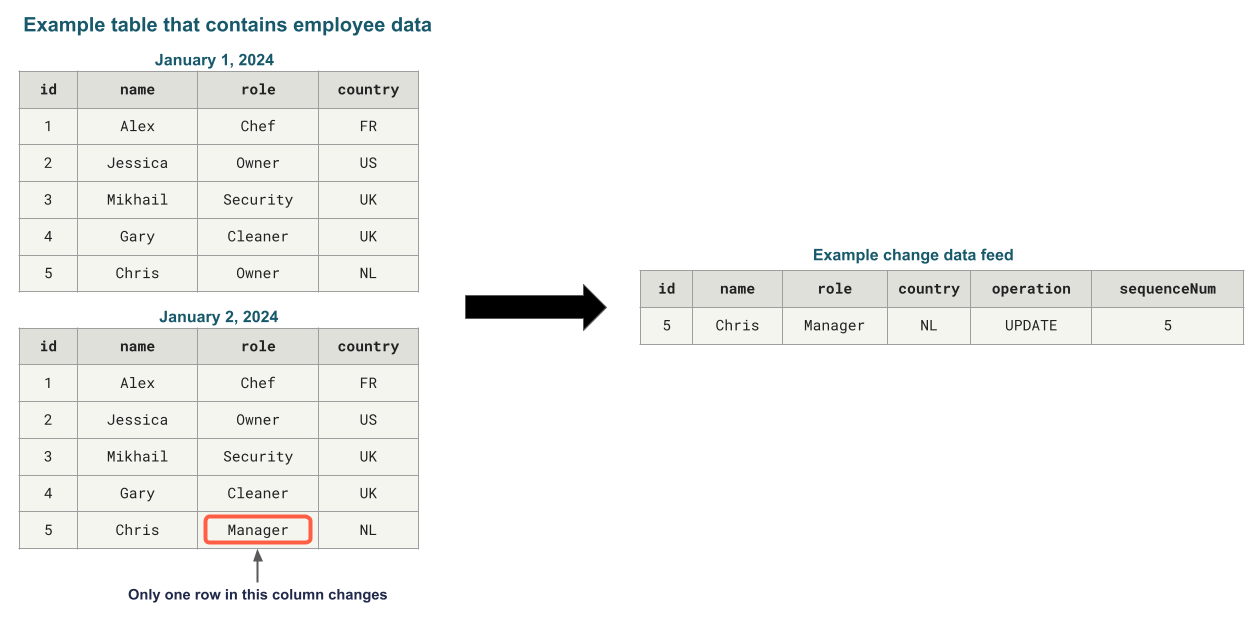
MIT CDC können Sie nur die Änderungen an den Daten für einfachere Transaktionen anzeigen, wenn sie die Datenbank in einem nachgelagerten System aktualisieren. Wenn dies eine Anforderung ist, können Sie auch den Verlauf der Datenbank anzeigen.
Die Herausforderung besteht darin, dass Quellsysteme Daten in verschiedenen Formaten bereitstellen. Einige emittieren Änderungsfeeds, die einzelne Änderungen erfassen (Einfügungen, Aktualisierungen, Löschungen). Andere stellen nur regelmäßige Momentaufnahmen der gesamten Tabelle bereit. Jedes Format erfordert unterschiedliche Verarbeitungsansätze, um nachgeschaltete Tabellen präzise und auf dem neuesten Stand zu halten.
In der Vergangenheit haben sich Teams auf benutzerdefinierte MERGE INTO-Logik verlassen, um diese Änderungen anzuwenden, sei es anhand von Änderungsfeeds oder durch den Vergleich von Snapshots. Dieser Ansatz ist komplex und fehleranfällig und erfordert Stagingtabellen, Fensterfunktionen und Sequenzierungsannahmen, die schwierig zu begründen und aufrechtzuerhalten sind, wenn sich Pipelines entwickeln.
Vorteile von CDC
Die Datenerfassung von Änderungen bietet mehrere Vorteile in Ihren Workloads.
- Änderungsdaten sind in der Regel kleiner als das vollständige Dataset, und Änderungen können von nachgelagerten Abfragen als inkrementelle Aktualisierungen der Daten verarbeitet werden.
- Änderungsdaten können auf eine Weise gespeichert werden, mit der Sie Datensätze wie zu einem bestimmten Zeitpunkt rekonstruieren können, sodass Sie einen vollständigen Verlauf für Überwachung, Point-in-Time-Berichterstellung oder Trendanalyse erhalten.
- Änderungsdaten ermöglichen im Laufe der Zeit stabile Ersatzschlüssel.
Anwenden von Änderungen: Aktueller Status oder vollständiger Verlauf der Änderungen
Langsam ändernde Dimensionen (ScD) definieren, wie upstream-Änderungen angewendet und modelliert werden, nachdem sie in analytischen Tabellen landen. Organisationen verwenden möglicherweise unterschiedliche Ansätze basierend auf ihren Datenanforderungen. MIT SCD Typ 1 können Sie nur den aktuellen Zustand des Datasets speichern. SCD Typ 2 speichert den vollständigen Verlauf der Änderungen am Dataset. Bitemporal erweitert SCD-Typ 2, um den Verlauf entlang zweier Zeitachsen zu speichern: zu welchem Zeitpunkt jede Änderung wirksam wurde und wann Ihr System davon Kenntnis erlangt hat. In diesem Abschnitt werden diese ausführlicher beschrieben.
SCD-Typ 1: Nur aktueller Zustand
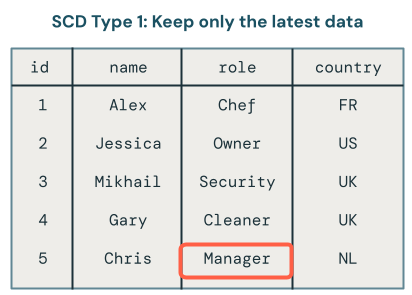
SCD Type 1 überschreibt alte Daten mit neuen Daten, wenn Änderungen vorgenommen werden, wobei nur die neueste Version jedes Datensatzes beibehalten wird. Die Historie wird nicht beibehalten.
Verwenden Sie SCD Typ 1 in folgenden Fällen:
- Sie benötigen nur den aktuellen Status der Daten.
- Sie möchten, dass nachgelagerte materialisierte Ansichten inkrementell aktualisiert werden, anstatt vollständig neu zu komputieren.
- Sie benötigen stabile Ersatzschlüssel für Verknüpfungen.
Nur die neueste Version der Daten ist in SCD1 verfügbar. Es ist ein einfacher Ansatz, bei dem Sie sich vorstellen können, nur die endgültige Tabelle zu speichern. Wenn sich ein Datensatz von Owner zu Manager, ändert, bleibt nur Manager in der Tabelle:
SCD-Typ 2: Historische Nachverfolgung
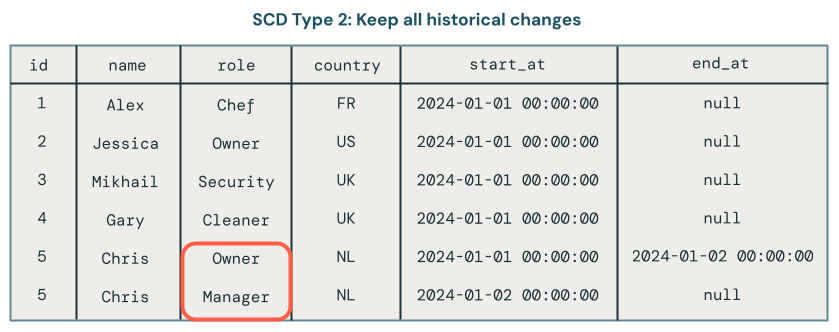
SCD Type 2 verwaltet einen vollständigen Verlaufsdatensatz, indem im Laufe der Zeit mehrere Datenversionen erstellt werden, wobei jede Version mit einem Zeitstempel und Metadaten versehen wird. Die Spalten __START_AT und die __END_AT Spalten definieren den Gültigkeitszeitraum für jede Version eines Datensatzes. Aktive Datensätze haben __END_AT = NULL. Sie können den Status des Datasets jederzeit so anzeigen, wie es war.
Verwenden Sie SCD Typ 2 in folgenden Fällen:
- Auditierbarkeit oder regulatorische Anforderungen erfordern historische Nachverfolgung.
- Kundenanalysen müssen verstehen, wie Sich Entitäten im Laufe der Zeit weiterentwickelt haben.
- Geschäftslogik erfordert zeitpunktbezogene Berichterstattung.
- Sie müssen Trends analysieren oder historische Zustände vergleichen.
Die SCD Typ 2-Verarbeitung verwaltet einen historischen Datensatz von Datenänderungen. Wenn beispielsweise für einen Datensatz das Rollenfeld derzeit auf Manager festgelegt ist, können Sie auch sehen, dass die Rolle zuvor auf Owner festgelegt war. In der folgenden Abbildung ist das genau das, was mit dem Datensatz Chris passiert ist. Sie können den aktuellen Datensatz angeben, da er einen null Wert für das end_at Feld hat:
Bitemporal: Verlauf über Geschäftszeit und Systemzeit hinweg
SCD Typ 1 und SCD Typ 2 verfolgen Änderungen entlang einer einzigen Zeitleiste. Bitemporale Tabellen erfassen für jeden Datensatz zwei Zeitachsen:
- Geschäftszeit, auch gültige Zeit genannt: wenn eine Änderung in der realen Welt wirksam wurde. Zum Beispiel das Datum, an dem die Beförderung eines Mitarbeiters wirksam wurde.
- Systemzeit, auch Transaktionszeit genannt: Wenn Ihr System die Änderung aufgezeichnet hat. Zum Beispiel die Zeit, als das HR-System die Beförderung an Azure Databricks weitergeleitet hat.
Die beiden Zeitlinien unterscheiden sich oft. Änderungen kommen zu spät an, kommen in falscher Reihenfolge an oder sind falsch und müssen korrigiert werden. SCD Typ 2 kann zeigen, dass sich die Historie geändert hat, aber nach einer späten Änderung oder Korrektur wird nicht mehr angezeigt, was in der Tabelle vor der Korrektur stand. Eine bitemporale Tabelle beantwortet zwei verschiedene Fragen:
- Was galt zu einer bestimmten Geschäftszeit, laut allem, was heute bekannt ist?
- Was glaubte das System zu einem bestimmten Systemzeitpunkt? Zum Beispiel: Auf welchen Daten basierte ein Bericht oder eine Entscheidung?
Bitemporale Tabellen überschreiben nicht das, was das System zuvor glaubte. Wenn eine Änderung eintritt, schließt das System die zuvor angenommenen Zeilen zum Zeitpunkt der Änderung und fügt Zeilen hinzu, die die korrigierte Historie widerspiegeln. Jede Zeile hat einen Geschäftszeitbereich, __START_AT und __END_AT, sowie einen Systemzeitbereich, __SYSTEM_START_AT und __SYSTEM_END_AT.
Verwenden Sie bitemporal, wenn:
- Regulatorische oder Audit-Anforderungen verlangen, dass Sie das wiedergeben, was Ihre Daten zu einem früheren Zeitpunkt gezeigt haben, einschließlich vor Korrekturen.
- Quelldaten kommen verspätet oder in falscher Reihenfolge an, und Sie müssen sowohl wissen, wann die Änderungen in Kraft traten als auch wann Sie davon erfahren haben.
- Sie korrigieren fehlerhafte Werte und müssen eine Aufzeichnung der zuvor gemeldeten Werte aufbewahren.
- Sie müssen frühere Entscheidungen, Berichte oder Modellergebnisse auf Basis der damals verfügbaren Daten erklären.
Zum Beispiel beginnt Chris am 1. Januar als Owner, und das System zeichnet dies am 2. Januar auf. Chris wird mit Wirkung zum 1. März zum Manager befördert, und das System verzeichnet die Beförderung an diesem Tag. Am 15. März erscheint ein später Datensatz. Es zeigt, dass Chris ab dem 1. Februar ein Team Lead war, bevor er Manager wurde. SCD-Typ 2 schreibt den Verlauf von Chris um, sodass dieser Team Lead enthält. Eine bitemporale Tabelle behält auch die frühere Annahme bei, dass Chris bis zum 1. März ein Owner war, und verzeichnet, dass diese Annahme am 15. März ersetzt wurde:
| Name | role | __START_AT | __END_AT | __SYSTEM_START_AT | __SYSTEM_END_AT |
|---|---|---|---|---|---|
| Chris | Owner | 1. Januar | null | 2. Januar | 1. März |
| Chris | Owner | 1. Januar | 1. März | 1. März | 15. März |
| Chris | Owner | 1. Januar | 1\. Februar | 15. März | null |
| Chris | Teamleiter | 1\. Februar | 1. März | 15. März | null |
| Chris | Leiter | 1. März | null | 1. März | null |
Reihen mit __SYSTEM_END_AT = null sind das, was das System derzeit annimmt: Owner bis zum 1. Februar, Team Lead bis zum 1. März, dann Manager. Die anderen Zeilen dokumentieren, was das System glaubte, bevor der verspätete Datensatz einging. Zum Beispiel zeigte ein Bericht vom 10. März über den 15. Februar Chris als Owner. Eine bitemporale Tabelle ermöglicht es dir, diese Antwort zu reproduzieren.
Ein End-to-End-Beispiel finden Sie unter Bitemporal AUTO CDC.
Vergleichen Sie SCD Typ 1, SCD Typ 2 und Bitemporalität
| Feature | SCD-Typ 1 | SCD-Typ 2 | Bitemporal |
|---|---|---|---|
| Verlauf beibehalten | None. Nur der aktuelle Zustand. | Vollständiger Verlauf auf einer Zeitleiste. | Vollständige Geschichte entlang zweier Zeitlinien, einschließlich früherer Überzeugungen. |
| Verfolgte Zeitlinien | Geschäftszeit (SEQUENCE BY), nur zum Ordnen von Änderungen verwendet |
Geschäftszeit (SEQUENCE BY) |
Geschäftszeit (SEQUENCE BY) und Systemzeit (SYSTEM SEQUENCE BY) |
| Hinzugefügte Spalten | None |
__START_AT, __END_AT |
__START_AT, __END_AT, __SYSTEM_START_AT, __SYSTEM_END_AT |
| Verspätete oder nicht ordnungsgemäße Änderungen | In der Reihenfolge angewendet. Verspätete Änderungen, die älter sind als die aktuelle Version, werden verworfen. | In der Reihenfolge in den Verlauf eingefügt. Die vorherige Version des Verlaufs wird nicht beibehalten. | In der Reihenfolge in den Verlauf eingefügt. Die vorherige Version des Verlaufs wird beibehalten. |
| Beantwortete Fragen | Was ist jetzt wahr? | Was war zu einem bestimmten Zeitpunkt wahr? | Was galt zu einem bestimmten Zeitpunkt und was glaubte das System zu einem bestimmten Zeitpunkt? |
| Unterstützte APIs |
AUTO CDC, AUTO CDC FROM SNAPSHOT |
AUTO CDC, AUTO CDC FROM SNAPSHOT |
AUTO CDC |
| Typische Verwendungen | Berichterstattung über den aktuellen Zustand, inkrementelle Downstream-Verarbeitung | Prüfprotokolle, Stichtagsberichterstattung, Trendanalyse | Regulatorische Berichterstattung, Finanzprüfungen, Reproduktion vergangener Entscheidungen, Korrekturen |
Was ist ein CDC-Feed?
Change Data Capture (CDC) ist ein Datenintegrationsmuster, das Änderungen an Daten in einem Quellsystem erfasst: Einfügungen, Aktualisierungen und Löschungen. Anstatt ganze Datasets zu verarbeiten, generiert CDC Feeds, die nur die geänderten Datensätze enthalten.
Wenn Sie beispielsweise eine Mitarbeitertabelle in Oracle mit 50 Zeilen haben und sich die Position eines Mitarbeiters ändert, enthält der CDC-Feed einen einzelnen UPDATE Datensatz für diesen Mitarbeiter. Auf diese Weise können Azure Databricks nur die geänderten Datensätze verarbeiten, anstatt die gesamte Quelltabelle für jede Ausführung zu lesen.
Jeder CDC-Eintrag aus der Quelldatenbank umfasst:
- Der Vorgangstyp (
INSERT,UPDATE,DELETE) - Die Datenwerte für den Datensatz
- Eine Sequenznummer oder ein Zeitstempel für die deterministische Sortierung
Die Sequenznummer stellt sicher, dass verspätete oder nicht in der richtigen Reihenfolge eintreffende Daten korrekt angewendet werden. Transaktionsdatenbanken wie SQL Server, MySQL und Oracle generieren CDC-Feeds nativ. Delta-Tabellen generieren auch ihren eigenen CDC-Feed, der als Change Data Feed (CDF) bezeichnet wird, wodurch es auch einfach ist, Änderungen aus Delta-Quellen zu verarbeiten.
Was ist eine Momentaufnahme?
Eine Momentaufnahme stellt den vollständigen Zustand einer Tabelle zu einem bestimmten Zeitpunkt dar. Im Gegensatz zu CDC-Feeds, die nur Änderungen erfassen, enthalten Momentaufnahmen jede Zeile in der Quelltabelle.
Teams aktivieren aus verschiedenen Gründen nicht immer CDC-Feeds auf betriebsbereiten Datenbanken:
- Kosten (CDC kann die Auslastung von Produktionsdatenbanken erhöhen)
- Leistungsbedenken in der Quelldatenbank
- Ältere Systeme, die CDC nicht unterstützen
- Organisationseinschränkungen (die Teams, die die Erfassung verwalten, besitzen nicht die upstream-Datenbanken)
Wenn ein Änderungsfeed nicht verfügbar ist, ist die snapshotbasierte Aufnahme die einzige Option. Momentaufnahmen können aus Folgendem stammen:
- Regelmäßige Exporte aus relationalen Datenbanken (Oracle, Postgres, SQL Server)
- Cloud-Speicher-Dateidumps von Upstream-Systemen
- Delta-Tabellen (jede Tabellenversion ist effektiv eine Momentaufnahme)
- OpenSharing von Upstream-Mandanten
Da Momentaufnahmen keine Änderungen auf Datensatzebene erfassen, müssen Datensätze über Momentaufnahmen hinweg verglichen werden, um Einfügungen, Aktualisierungen und Löschungen abzuleiten.
Automatisches Verarbeiten von CDC-Feeds
Azure Databricks vereinfacht die CDC-Verarbeitung mithilfe der AUTO CDC API innerhalb von Lakeflow-Pipelines. Diese API wurde entwickelt, um Änderungen von CDC-Feeds auf Quelldatenbanken oder Delta-Tabellen mit aktiviertem Change Data Feed zu verarbeiten.
Beispiele für SQL- und Python-Code finden Sie in AUTO CDC-Beispielen.
Verwenden Sie AUTO CDC, wenn eine der folgenden Bedingungen erfüllt ist:
- Ihr Quellsystem erzeugt einen CDC-Feed
- Sie lesen aus einer Delta-Tabelle mit aktiviertem "Datenfeed ändern"
- Sie verfügen über einen CDC-Feed aus einer relationalen Datenbank (über Tools wie Debezium oder Oracle GoldenGate)
AUTO CDC verarbeitet Datensätze, die nicht in der richtigen Reihenfolge vorliegen, automatisch, indem Ereignisse in der durch die Sequenzierungsspalte definierten Reihenfolge verarbeitet werden. Die Sequenzierungsspalte muss eine monoton zunehmende Darstellung der richtigen Ereignisreihenfolge sein, wobei bei jedem Sequenzierungswert eine eindeutige Aktualisierung pro Schlüssel erfolgt.
NULL Sequenzierungswerte werden nicht unterstützt. Für SCD Typ 2 gibt die Pipeline Sequenzierungswerte an die Spalten __START_AT und __END_AT der Zieltabelle weiter.
Anfängliche Hydratation: Wenn Sie eine vorhandene operative Datenbanktabelle in Azure Databricks replizieren, müssen Sie zuerst alle historischen Daten laden, bevor Sie laufende Änderungen verarbeiten.
AUTO CDC unterstützt dies durch Einmal-Flüsse, einen Modus, der alle verfügbaren Daten einmal verarbeitet und dann stoppt. Verwenden Sie nach Abschluss des anfänglichen Ladevorgangs einen Flow im ausgelösten oder kontinuierlichen Modus für die fortlaufende CDC-Verarbeitung. Dadurch wird eine konsistente Logik sowohl für Massen- als auch für inkrementelle Lasten sichergestellt.
Automatisches Verarbeiten von Momentaufnahmen
Wenn CDC-Feeds nicht verfügbar sind, stellt Azure Databricks die AUTO CDC FROM SNAPSHOT API bereit. Diese API ist für die momentaufnahmenbasierte Erfassung konzipiert. Sie vergleicht aufeinanderfolgende Momentaufnahmen, generiert einen synthetischen Änderungsfeed und wendet SCD Typ 1- oder Typ 2-Logik auf die Zieltabelle an. Die Zieltabelle kann einen CDC-Feed (in Delta-Tabellen als Change Data Feed (CDF) bezeichnet) vom SCD Typ 1 oder Typ 2 für nachgelagerte Abfragen bereitstellen.
Für Codebeispiele siehe AUTO CDC FROM SNAPSHOT Beispiele.
AUTO CDC FROM SNAPSHOTwird in den Python- und SQL-Pipeline-Schnittstellen unterstützt. Schnappschüsse müssen in aufsteigender Reihenfolge nach Version verarbeitet werden. In beiden Schnittstellen muss jede Snapshot-Version nach einem erfolgreichen Commit größer sein als die zuvor committierte Version. Eine nicht steigende Version lässt das Update fehlschlagen. Downstream-Verarbeitung, wie eine materialisierte Ansicht, die die Ausgabe eines AUTO CDC FROM SNAPSHOT Datensatzes abfragt, profitiert von den Vorteilen der CDC, einschließlich inkrementeller Verarbeitung und stabiler Surrogatschlüssel.
Note
AUTO CDC FROM SNAPSHOT ist nicht nur für anfängliche Lasten vorgesehen. Sie ist für die fortlaufende Verarbeitung konzipiert, wenn Momentaufnahmen Ihr einziges verfügbares Format sind. Jedes Mal, wenn eine neue Momentaufnahme eingeht, vergleicht die API sie mit der vorherigen Momentaufnahme, um Änderungen und einen Änderungsdatenfeed abzuleiten.
Für SCD-Typ-1-Ziele kann man AUTO CDC FROM SNAPSHOT mit AUTO CDC kombinieren, wenn eine Quelle sowohl periodische autoritative Snapshots als auch einen CDC-Feed mit geringerer Latenz bereitstellt. Siehe Hinzufügen einer Auffüllung zu einer AUTO CDC SCD Typ 1-Tabelle.
Verwenden Sie AUTO CDC FROM SNAPSHOT in folgenden Fällen:
- CDC ist in der Quelldatenbank nicht aktiviert.
- Sie haben nur Zugriff auf regelmäßige Schnappschüsse (vollständige Tabellendumps)
- Sie möchten die Vorteile von CDC für die inkrementelle Verarbeitung oder einen vollständigen Verlauf der Änderungen haben.
AUTO CDC FROM SNAPSHOT behandelt Folgendes automatisch:
- Vergleicht aufeinander folgende Momentaufnahmen, um eingefügte, aktualisierte und gelöschte Datensätze zu identifizieren.
- Generiert einen Synthetischen Änderungsfeed basierend auf den Unterschieden zwischen Momentaufnahmen.
- Wendet dieselbe SCD-Logik wie
AUTO CDCfür die Berechnung von SCD Typ 1 oder Typ 2 an.
Note
AUTO CDC FROM SNAPSHOT kennt nur Änderungen von einer Momentaufnahme zur nächsten und erhält keine Zwischenänderungen. Wenn Sie beispielsweise tägliche Momentaufnahmen erhalten und ein Benutzer seine Adresse zweimal in einem Tag ändert (von A bis B, dann von B zu C), kann Ihr Änderungsfeed direkt von A zu C" gehen, da Sie nur Momentaufnahmen für diese Zeiten erhalten haben.
Momentaufnahmeverarbeitungsmuster
In Python AUTO CDC FROM SNAPSHOT werden zwei Muster zur Bestimmung von Snapshot-Versionen unterstützt.
Momentaufnahmenverarbeitung mithilfe der Pipelineerfassungszeit
Die Momentaufnahme wird zum Zeitpunkt der Pipelineausführung gelesen, und die Erfassungszeit wird als Momentaufnahmenversion verwendet. Mit jedem Pipeline-Update wird eine neue Momentaufnahme eingespielt. Wenn eine Pipeline im kontinuierlichen Modus ausgeführt wird, werden basierend auf der Triggerintervalleinstellung für den Flow mehrere Momentaufnahmen erfasst.
Verwenden Sie dieses Muster, wenn Momentaufnahmen regelmäßig und in der Reihenfolge eingehen, und Sie können sich auf den Laufzeitstempel der Pipeline für die Versionsverwaltung verlassen.
Momentaufnahmeverarbeitung mithilfe von Versionsfunktionen
Du stellst eine Python-Funktion bereit, die angibt, welche Snapshot-Version zum Zeitpunkt des Pipeline-Runs verarbeitet werden soll. Die Funktion gibt ein Tupel zurück: (DataFrame, version_number). Die API verarbeitet Momentaufnahmen in der durch Versionsnummern definierten Reihenfolge. Wenn die Funktion eine Version zurückgibt, die nicht größer ist als die zuletzt erfolgreich committierte Version, schlägt das Update fehl.
Verwenden Sie dieses Muster in folgenden Fällen:
- Mehrere Momentaufnahmen können gleichzeitig eingehen und eine sequenzielle Verarbeitung benötigen.
- Momentaufnahmen können in ungeordneter Reihenfolge eintreffen.
- Sie benötigen explizite Kontrolle über die Reihenfolge der Momentaufnahmen.
Snapshot-Verarbeitung in SQL
In SQL verwenden Sie die erforderliche FROM SNAPSHOT Abfrage, um Snapshot-Daten zu lesen. Um geordnete Snapshots über Pipeline-Updates hinweg zu verarbeiten, fügen Sie eine WITH VERSION Abfrage hinzu, die die nächste Version auswählt. Ein einzelnes Update verarbeitet verfügbare Versionen, bis die Versionsabfrage keine Zeilen mehr zurückgibt. Jede Version, die nach einem erfolgreichen Commit zurückgegeben wird, muss größer sein als die zuvor committete Version.
Ein SQL-Snapshot-Flow ohne WITH VERSION unterstützt nur eine Anfangsladung, wenn das Ziel leer ist. Für Syntax und Beispiele siehe CREATE FLOW (pipelines).
Zusätzliche CDC-Funktionen
Änderungsvorgänge für AUTO CDC-Ziele
Im Gegensatz zu standardmäßigen Streamingtabellen unterstützen Unity Catalog-Tabellen, die AUTO CDC-Ziele sind, INSERT-, UPDATE-, DELETE- und MERGE-Anweisungen, auch während die Pipeline ausgeführt wird. Details und Einschränkungen finden Sie unter Hinzufügen, Ändern oder Löschen von Daten in einer Zielstreamingtabelle.
Lesen von Change Data Feeds aus AUTO CDC-Zielen
AUTO CDC-Zielstreamingtabellen können ihren eigenen Change Data Feed (CDF) ausgeben, sodass nachgelagerte Pipelines Änderungen aus der AUTO CDC-Ausgabe nutzen können. Ausführliche Informationen finden Sie unter Lesen eines Änderungsdatenfeeds aus einer Zieltabelle mit AUTO CDC.
Lesen von Änderungsdatenfeeds aus materialisierten Ansichten
Materialisierte Ansichten können ihren eigenen Change Data Feed (CDF) aussenden, sodass nachgelagerte Konsumenten materialisierte Ansichtsänderungen verarbeiten können, einschließlich der Replikation außerhalb von Azure Databricks. Dieses Feature befindet sich in der Betaversion. Für Details siehe Lesen Sie einen Änderungsdatenfeed aus einer materialisierten Ansicht.
Metriken und Überwachung
AUTO CDCErfasst automatisch num_upserted_rows- und num_deleted_rows-Metriken bei jedem Pipeline-Durchlauf. Ausführliche Informationen finden Sie in den Themen "Advanced AUTO CDC".
Nachverfolgen von Spaltenteilmengen für SCD Typ 2
Standardmäßig erstellt SCD Type 2 immer dann eine neue Version, wenn sich ein Spaltenwert ändert.
AUTO CDC ermöglicht es Ihnen, anzugeben, welche Spalten für den Verlauf nachverfolgt werden sollen, sodass Änderungen an nicht nachverfolgten Spalten die aktuelle Version direkt aktualisieren, anstatt einen neuen historischen Datensatz zu erstellen. Dadurch werden Speicherkosten sowie die Komplexität von Abfragen reduziert, während der Verlauf für wichtige Attribute beibehalten wird. Ein Beispiel finden Sie unter "Nachverfolgen einer Spaltenuntermenge mit SCD Typ 2".
Empfehlungen
Verwenden Sie die Änderungsdatenerfassung (Change Data Capture, CDC), wenn Sie nur mit den Änderungen an Ihren Daten arbeiten möchten, z. B. damit nachgelagerte materialisierte Ansichten inkrementell aktualisiert werden können. Verwenden Sie auch CDC, wenn Sie einen Verlauf der Änderungen an Ihren Daten beibehalten möchten, um beispielsweise zu wissen, wer zu einem bestimmten Zeitpunkt welche Rolle hatte.
Verwenden Sie die AUTO CDC-APIs, wenn Sie Upstreamdaten in Azure Databricks replizieren und mit Quelländerungen synchronisieren müssen. Die richtige API hängt davon ab, wie Ihr Quellsystem Änderungen verfügbar macht:
-
Verwenden
AUTO CDCwenn Ihre Quelle einen Änderungsfeed ausgibt, z. B. eine relationale Datenbank mit aktiviertem CDC (über Tools wie Debezium oder Oracle GoldenGate), eine Delta-Tabelle mit aktiviertem Änderungsdatenfeed oder eine beliebige Quelle, die einen Datenstrom von Einfügungen, Aktualisierungen und Löschvorgängen mit einer Sequenzierungsspalte erzeugt. -
Verwenden Sie
AUTO CDC FROM SNAPSHOT, wenn die Quelle CDC nicht unterstützt und nur periodische vollständige Tabellenabbilder bereitstellt. Diese API leitet Änderungen ab, indem aufeinander folgende Momentaufnahmen verglichen und ein synthetischer Änderungsfeed generiert wird, sodass Sie dieselben SCD-Verarbeitungsvorteile auch ohne einen systemeigenen CDC-Feed erhalten. -
Kombinieren
AUTO CDC FROM SNAPSHOTundAUTO CDCfür ein SCD Typ-1-Ziel, wenn periodische Schnappschüsse den autoritativen Zustand liefern und ein CDC-Feed Änderungen mit geringerer Latenz zwischen den Schnappschüssen liefert.
Wählen Sie dann, wie Sie die Änderungen speichern:
- SCD Typ 1: Verwenden Sie, wenn Sie nur den aktuellen Zustand jedes Datensatzes benötigen.
- SCD Typ 2: Verwenden Sie, wenn Sie eine vollständige Änderungshistorie für Prüfungen, Zeitpunktberichte oder Trendanalysen benötigen.
-
Bitemporal: Verwenden Sie, wenn Sie auch wissen müssen, was das System zu einem früheren Zeitpunkt glaubte, zum Beispiel, weil Änderungen zu spät ankommen oder korrigiert werden und Sie frühere Berichte reproduzieren müssen. Bitemporal erfordert
AUTO CDCund eine Spalte mit der Zeit, zu der jede Änderung erfasst wurde. Siehe Vergleich von SCD Typ 1, SCD Typ 2 und bitemporal.
Weitere Ressourcen
-
Die AUTO CDC-APIs: Vereinfachen der Änderungsdatenerfassung mit Pipelines: Erfahren Sie, wie Sie CDC mit den
AUTO CDCUNDAUTO CDC FROM SNAPSHOTAPIs implementieren. - Bitemporale AUTO CDC: Lernen Sie, wie Sie die Historie über Geschäftszeit und Systemzeit hinweg verfolgen.
- Erweiterte AUTO CDC-Themen: Erfahren Sie mehr über erweiterte CDC-Themen, z. B. die Verwendung von DML-Vorgängen, das Lesen von Änderungsdatenfeeds und Überwachungsmetriken.