Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Jede visuelle Datenvorbereitungsdatei, die Sie in Lakeflow Designer erstellen, wird von produktionsbereitem Code unterstützt und als Notizbuch mit dem Namen <name>.designer.ipynbgespeichert. Sie können sie in die Produktion mit den gleichen Tools verschieben, die Sie für andere Azure Databricks Code verwenden: Speichern Sie sie in Git, führen Sie sie als Auftrag aus, und stellen Sie sie mit deklarativen Automatisierungsbundle bereit.
Damit Geschäftsanwender eine visuelle Datenvorbereitung mit eigenen Werten ausführen können, veröffentlichen Sie sie als Designer-App. Siehe Designer-Apps in Lakeflow Designer.
In Git speichern und versionieren
Der Arbeitsbereich speichert visuelle Datenvorbereitungsdateien nativ. Um eine visuelle Datenvorversionsdatei zu erstellen, platzieren Sie sie in einem Git-Ordner, und verfolgen Sie sie wie jedes andere Notizbuch:
- Erstellen Sie einen Git-Ordner in Ihrem Arbeitsbereich.
- Verschieben Sie die visuelle Datenvorbereitungsdatei in diesen Git-Ordner.
- Verfolgen, committen und versionieren Sie die Datei wie jedes andere Notebook in Git. In Git erscheint die Datei als
<file_name>.designer.ipynb.
Weitere Informationen zu Git-Ordnern finden Sie unter Azure Databricks Git-Ordner. Informationen zum Exportieren oder Importieren einer visuellen Datenvorbereitungsdatei finden Sie unter Exportieren und Importieren einer visuellen Datenvorbereitungsdatei.
Extern modifizierter Operatorcode behandeln
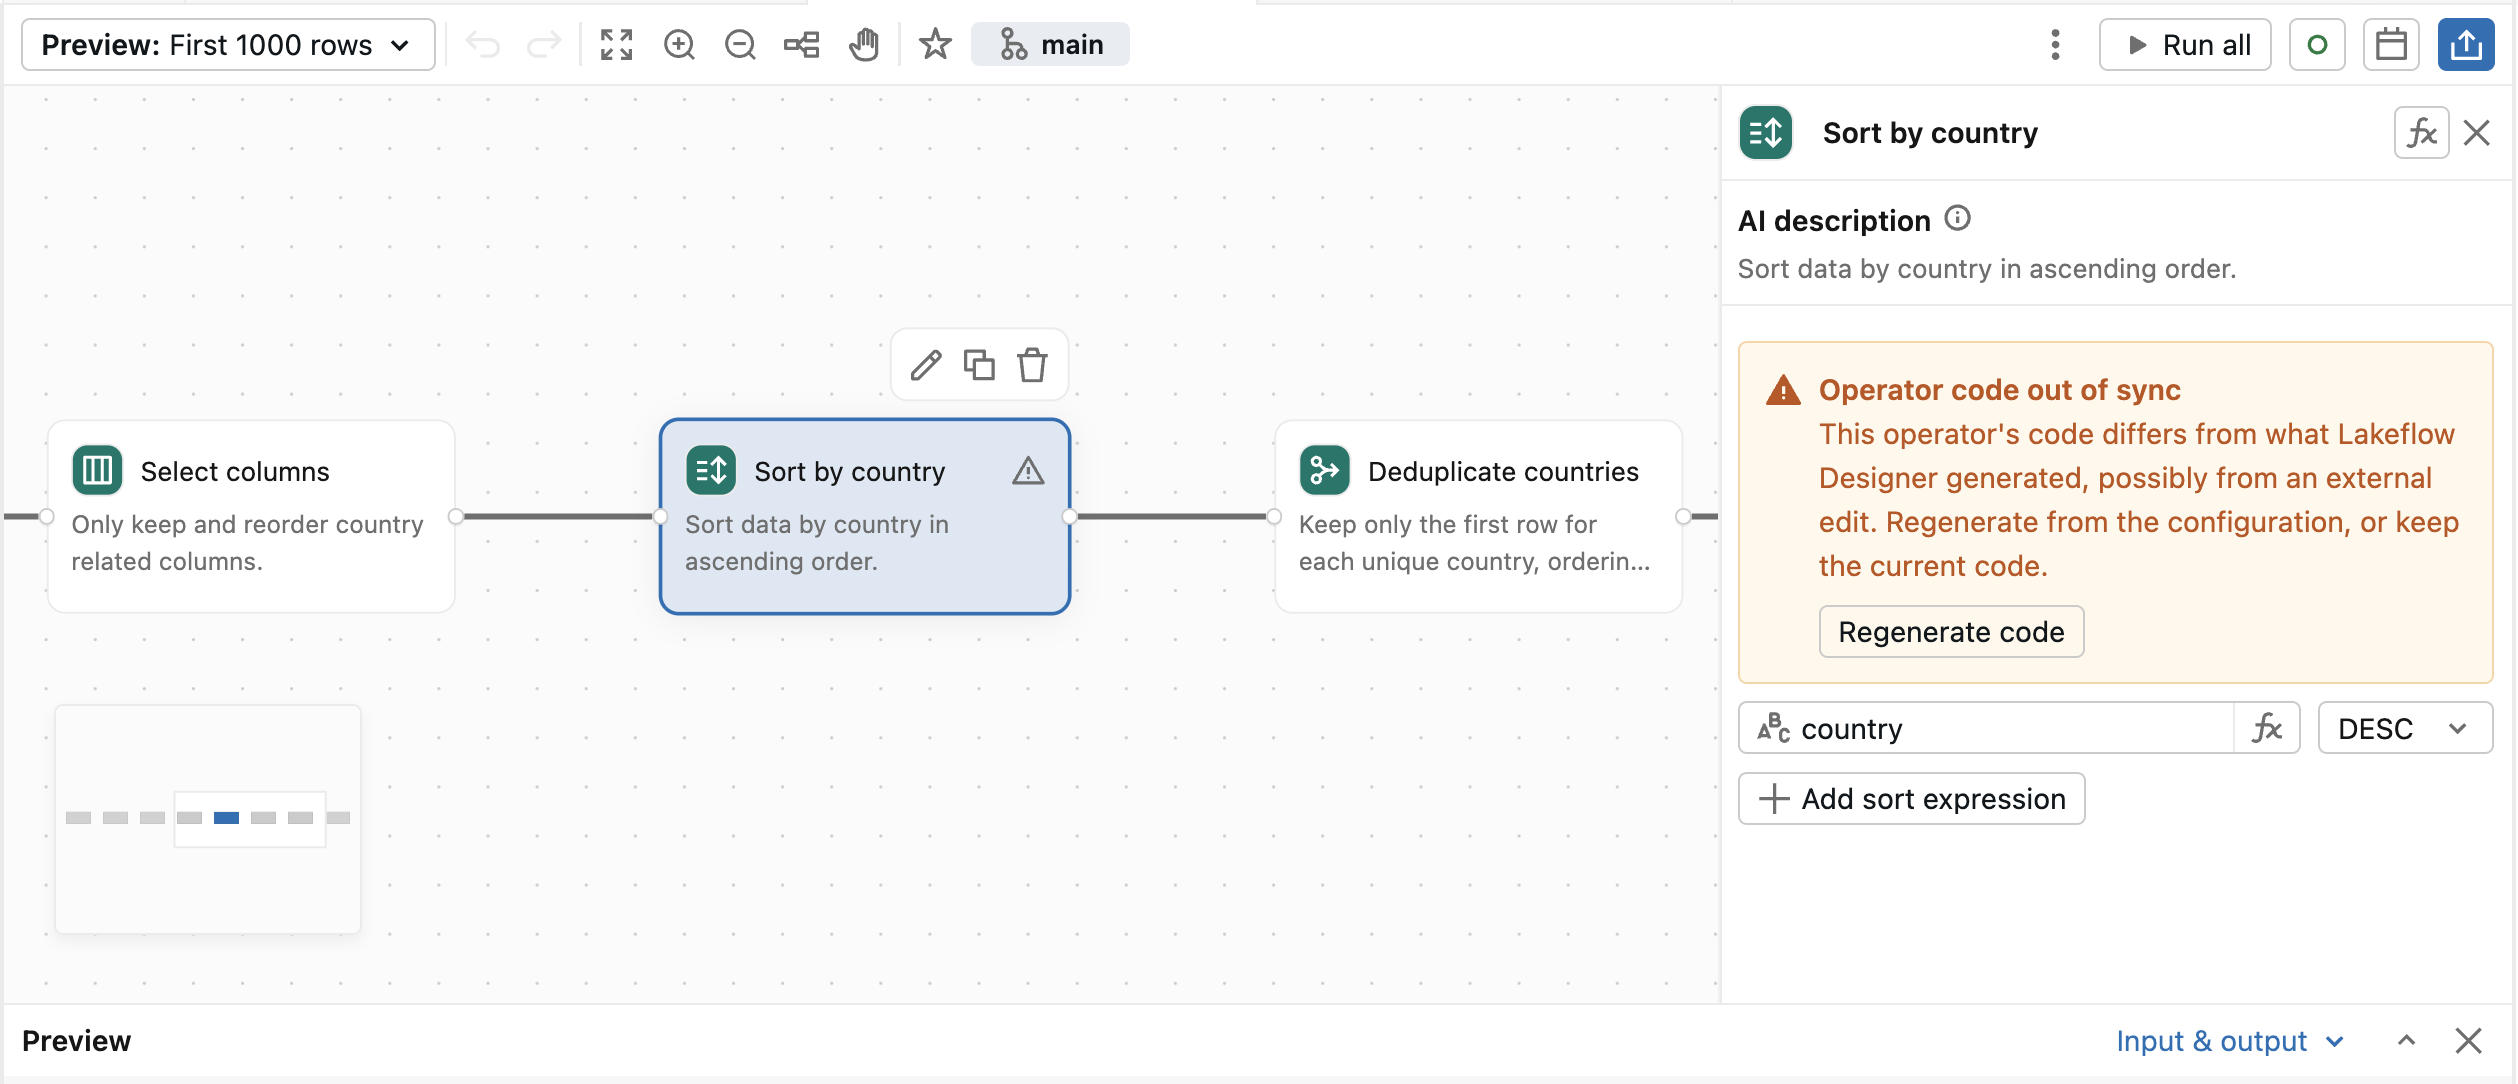
Der Designer erkennt, wenn sich der von einem Operator generierte Code außerhalb des Visual Data Prep Editor ändert, beispielsweise über Git oder eine Bundle-Bereitstellung. Um den geänderten Code beizubehalten, verhindert der Designer Bearbeitungen am Operator in der UI oder durch Genie Code. Um die Änderungen zu verwerfen, öffnen Sie den Operator, wählen Sie Code neu generieren und bestätigen. Der Designer erstellt den Code aus der Operator-Konfiguration neu.
Planen als Job
Sie können eine visuelle Datenvorbereitungsdatei automatisieren, indem Sie sie als Auftrag planen.
- Direkt planen: Klicken Sie im oberen Menü auf die Schaltfläche Planen, um einen geplanten Auftrag für Ihre visuelle Datenvorbereitungsdatei zu erstellen.
- Zu einem Job hinzufügen: Erstellen Sie einen Azure Databricks-Job und fügen Sie Ihre visuelle Datenvorbereitungsdatei als Aufgabe hinzu. Auf diese Weise können Sie diese visuelle Datenvorbereitungsdatei mit anderen Aufgaben in einer größeren Pipeline kombinieren. Wählen Sie in der Dropdownliste " Vorgangstyp " die Option "Visuelle Datenvorbereitung" aus, und wählen Sie dann die Datei aus.
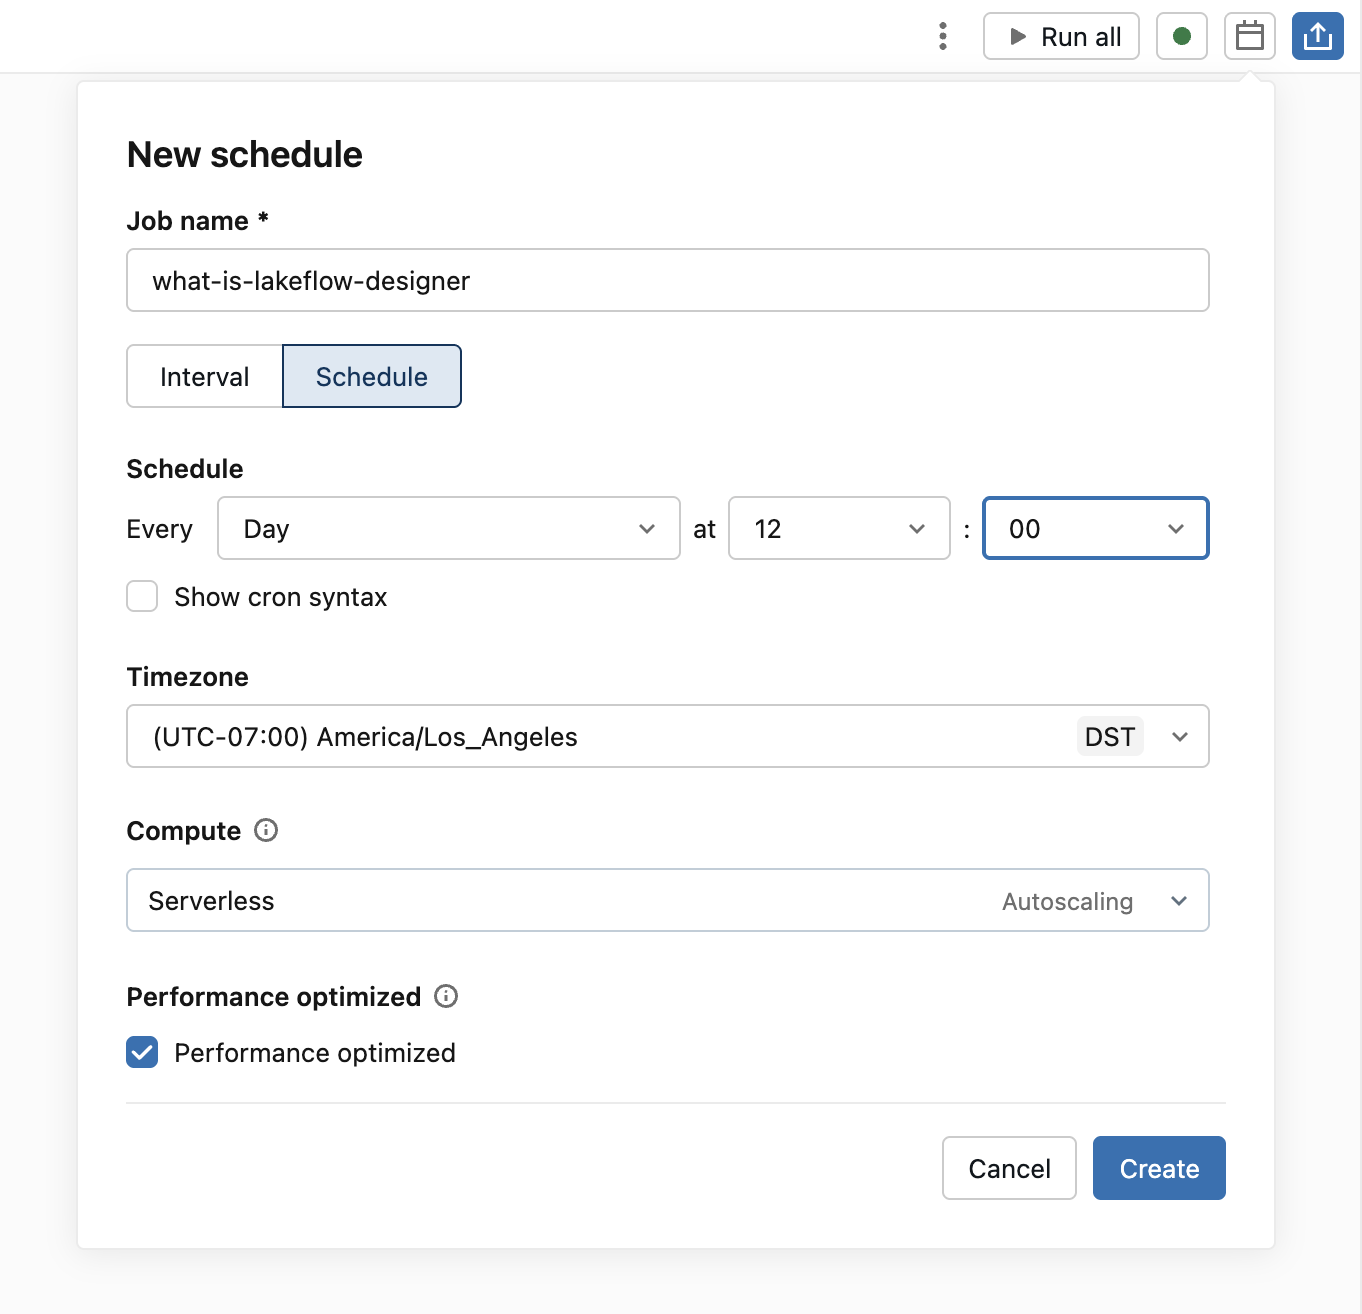
Geplante Ausführungen zeigen jeden Operator als einzelnen Knoten im Aufgaben-Graphen „Aufträge“ an, sodass Sie die Ergebnisse pro Operator in einer Ausführung genauso prüfen können wie auf der Canvas.
Um vorhandene Zeitpläne anzuzeigen und zu verwalten, klicken Sie erneut auf "Zeitplan ", um die Liste zu öffnen. Gehen Sie auf Zeitplan hinzufügen, um einen weiteren Zeitplan zu erstellen, oder öffnen Sie das  Kebab-Menü eines Zeitplans, um ihn die Option Bearbeiten, Jetzt ausführen, Anhalten, Klonen, In Einzelvorgängen anzeigen oder Löschen auszuführen.
Operatorausgabe in einem Durchlauf anzeigen
Standardmäßig generiert eine geplante Ausführung nur Ausgabe für Terminaloperatoren (Operatoren ohne Downstreamverbindung), z. B. einen Ausgabeoperator. Um die Ergebnisse aller Operatoren im Lauf zu sehen, erweitern Sie im Zeitplan-Dialog die Erweiterten Einstellungen und wählen Sie unter Anzeige der Operatorausgabedie Ergebnisse jedes Operators in der Laufausgabe anzeigen.
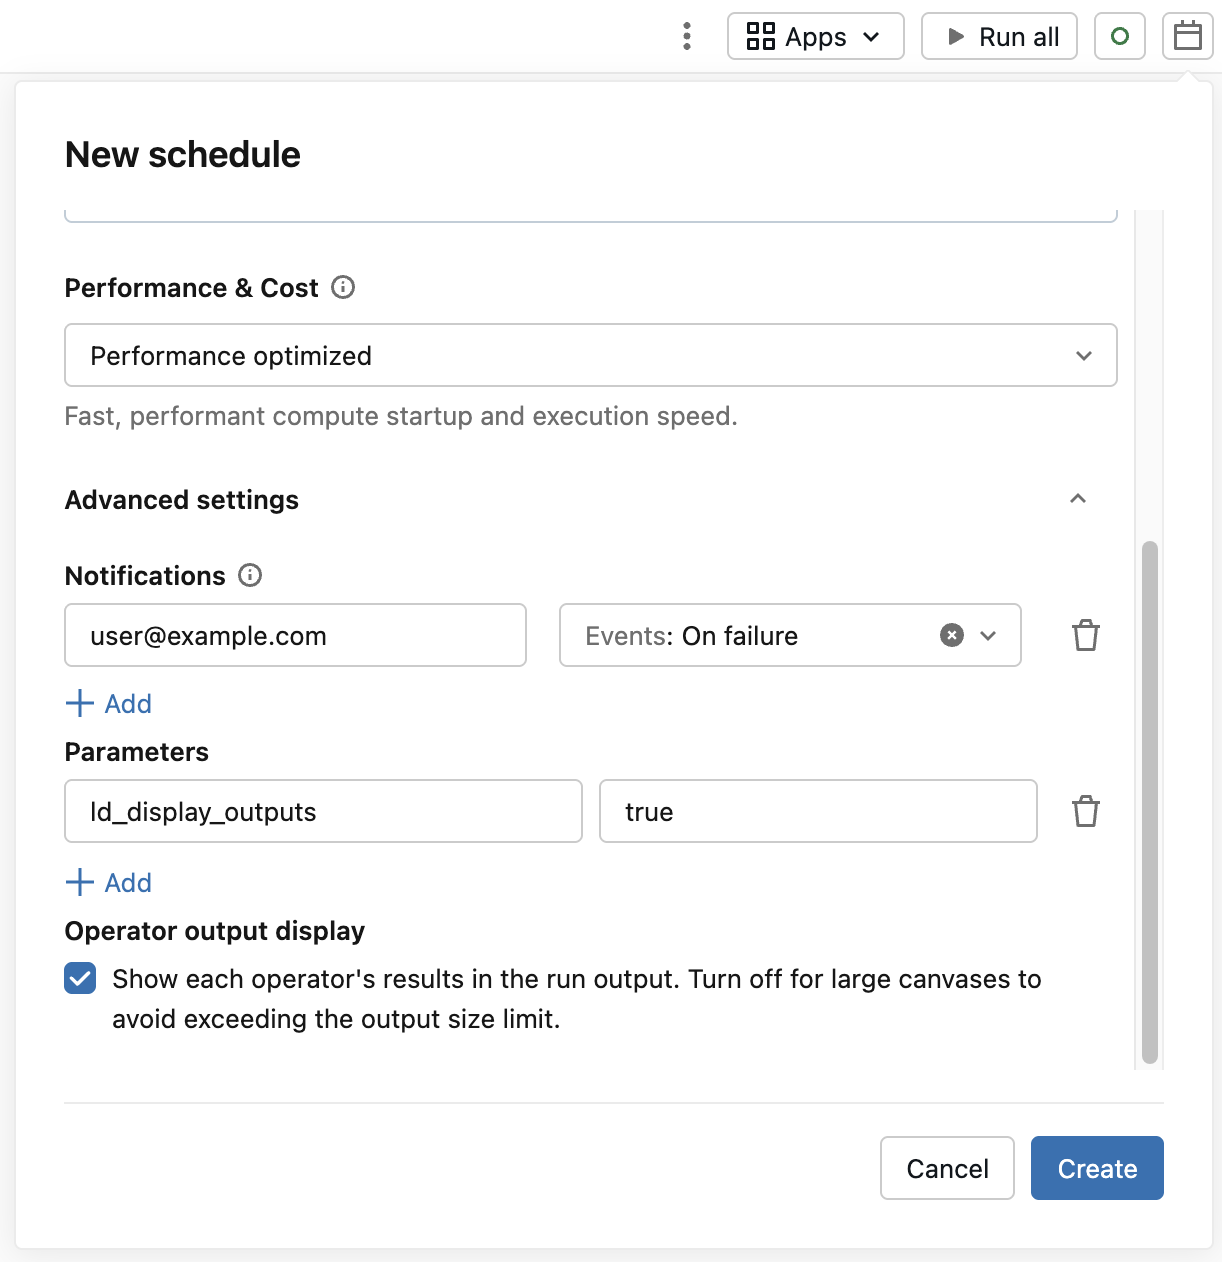
Deaktivieren Sie diese Option für große Canvas, um zu verhindern, dass die Größenbeschränkung der Ausführungsausgabe überschritten wird.
Wählen Sie die serverlose Umgebung aus
Wenn Sie mit einer visuellen Datenvorbereitungsdatei arbeiten, können Sie die serverlose Umgebung auswählen, die sowohl für interaktive Ausführungen als auch für geplante Aufträge verwendet wird. Konfigurieren Sie es über das  Randbereich der Umgebung in der rechten Randleiste auf die gleiche Weise wie für ein Notizbuch. Wählen Sie unter "Basisumgebung" eine Umgebungsversion aus. Siehe Konfigurieren der serverlosen Umgebung.
Parameterisieren Sie über verschiedene Umgebungen hinweg
Mithilfe von Parametern können Sie dieselbe visuelle Datenvorbereitungsdatei für verschiedene Umgebungen ausführen, z. B. einen Testkatalog während der Entwicklung und einen Produktionskatalog in der Produktion. Überschreiben Sie Parameterwerte für jeden Zeitplan oder geben Sie sie pro Bundle-Ziel an. Siehe Parameterwerte in der Produktion überschreiben.
Bereitstellen mit deklarativen Automation Bundles
Deklarative Automatisierungspakete ermöglichen Es Ihnen, Azure Databricks Ressourcen wie Aufträge wie Quelldateien zu definieren und bereitzustellen, sodass Sie bewährte Methoden wie Quellcodeverwaltung, Codeüberprüfung, Tests und CI/CD auf Ihre visuellen Datenvorbereitungsdateien anwenden können. Erfahren Sie , was deklarative Automatisierungspakete sind?.
Um eine Datei zur visuellen Datenaufbereitung mit einem Bündel bereitzustellen, definieren Sie eine Notebook-Aufgabe und verweisen Sie in notebook_task.notebook_path auf den Dateipfad .designer.ipynb. In einem Paket verwendet eine Datei für die visuelle Datenaufbereitung den notebook_task-Schlüssel, auch wenn die Jobs-Benutzeroberfläche sie als Aufgabentyp Visual data prep anzeigt.
Im folgenden Beispiel wird ein Auftrag definiert, der eine visuelle Datenvorbereitungsdatei ausführt, die sich neben der Bundlekonfigurationsdatei befindet:
resources:
  jobs:
    daily_prep_job:
      name: daily_prep_job
      tasks:
        - task_key: run_visual_data_prep
          notebook_task:
            notebook_path: ./my_transformation.designer.ipynb
Bereitstellen und Ausführen des Bundles mit der Azure Databricks CLI:
databricks bundle deploy
databricks bundle run daily_prep_job
Den vollständigen Satz von Notizbuch-Aufgabenschlüsseln finden Sie unter " Notizbuchaufgabe". Eine vollständige exemplarische Vorgehensweise zum Definieren eines Auftrags in einem Bündel finden Sie unter Entwickeln eines Auftrags mit deklarativen Automatisierungspaketen.
Automatisierung mit CI/CD
Um visuelle Datenvorbereitungspakete automatisch zu überprüfen und bereitzustellen, integrieren Sie sie in eine CI/CD-Pipeline. Ein Beispiel für die Verwendung von GitHub Actions finden Sie unter GitHub Actions.