Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Zugriffskontrolle
Features sind regelbare Unity Catalog-Objekte. Der Zugriff auf ein Feature wird durch die Rechte des Unity-Katalogs und CREATE FEATURE die READ FEATUREMANAGERechte des Unity-Katalogs gesteuert. Vollständige Beschreibungen finden Sie unter Unity Catalog-Berechtigungsreferenz.
-
CREATE FEATURE: Erforderlich, um ein Merkmal in einem Schema zu erstellen.create_featureundregister_featureim Elternschema erforderlichCREATE FEATUREsind. Nach dem Prinzip der geringsten Berechtigung können Sie sie auf Schemaebene gewährenCREATE FEATURE. Sie können es auch einem Katalog erteilen, um das Erstellen von Features in einem beliebigen Schema in diesem Katalog zu ermöglichen. -
READ FEATURE: Erforderlich zum Lesen von Feature-Metadaten.get_feature,create_training_set, undlist_materialized_featureserfordernREAD FEATUREdas Merkmal. Dieses Privileg gewährt keinen Zugriff auf Feature-Daten in Quell- oder materialisierten Ausgabetabellen. Um diese Daten für Ausbildung oder Dienst zu lesen, müssen Sie auch die entsprechenden Tabellen habenSELECT.READ FEATUREgewährt auf einem Schema oder Katalog gilt für alle aktuellen und zukünftigen Merkmale, die es enthält. -
MANAGE: Erforderlich, um den Lebenszyklus und die Zuteilungen einer Funktion zu verwalten. Das Löschen eines Merkmals mitdelete_featureund das Materialisieren eines Merkmals mitmaterialize_featureserfordernMANAGEdas Merkmal. Das Löschen eines materialisierten Merkmals mitdelete_materialized_featurewird nicht durchMANAGE: geregelt, nur der Ersteller des materialisierten Merkmals kann es löschen.
Alle Featurevorgänge erfordern USE CATALOG auch den übergeordneten Katalog und USE SCHEMA das übergeordnete Schema. Informationen MANAGE zur Materialisierung und READ FEATURE Anwendung auf die Materialisierung finden Sie unter "Berechtigungen".
Featureansichts-API
Feature Konstruktor und register_feature()
Der empfohlene Ansatz besteht darin, ein Feature Objekt lokal zu erstellen und zu verwenden register_feature , um es im Unity-Katalog zu speichern. Mit diesem zweistufigen Workflow können Sie mit Features (einschließlich create_training_set) experimentieren, bevor Sie sie registrieren.
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() registriert ein lokal konstruiertes Feature Verzeichnis im Unity-Katalog.
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() validiert, konstruiert und registriert sofort eine Funktion in Unity Catalog in einem einzigen Schritt. Verwenden Sie diese Option, wenn Sie nicht zuerst mit dem Feature experimentieren müssen.
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
Parameter:
-
source: Die Datenquelle, die bei der Merkmalsberechnung verwendet wird (DeltaTableSource,StreamSource,RequestSource, oderFeatureViewSource). -
function: AnAggregationFunction, der einen Operator und ein Zeitfenster bündelt,ColumnSelection("column_name")für Durchlaufmerkmale oderCustomUDFfür zeilenweise Transformationen. Siehe Unterstützte Funktionen für kompatible Quelltypen. -
catalog_name: Der Name des Unity-Katalogs für das Feature. -
schema_name: Der Unity-Catalog-Schemaname für das Feature. -
entity: Liste von Spaltennamen, die die Aggregations- oder Nachschlageschlüssel (Primärschlüssel) definieren. Erforderlich fürDeltaTableSourceundStreamSource. Beispielsweise["user_id"]Aggregate oder Nachschlageaktionen pro Benutzer. Lass fürRequestSourceundFeatureViewSourceweg. -
timeseries_column: Die Zeitstempel-Spalte, die für die Zeitfensteraggregation oder die Auswahl des neuesten Wertes verwendet wird. Erforderlich fürDeltaTableSourceundStreamSource. Lass fürRequestSourceundFeatureViewSourceweg. -
name: Optionaler Feature-Name. Wenn sie nicht angegeben wird, wird automatisch aus der Eingabespalte, Funktion und dem Fenster generiert (z. Bamount_avg_rolling_7d. ). -
description: Optionale Beschreibung des Merkmals.
Returns: Eine validierte Feature-Instanz
Erhöht: ValueError, falls eine Validierung fehlschlägt
delete_feature()
Löscht ein Feature aus dem Unity-Katalog anhand seines vollqualifizierten Namens.
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
Bevor Sie ein Feature löschen, entfernen oder aktualisieren Sie alle Modelle oder Featurespezifikationen, die darauf verweisen. Eine Funktion kann nicht gelöscht werden, solange sie noch materialisierte Merkmale hat. Lösche zuerst die materialisierten Features, dann lösche die Feature. Erfahren Sie , wie Sie ein materialisiertes Feature löschen.
Automatisch generierte Namen
Wenn name dieser Parameter nicht angegeben wird, wird automatisch ein Name generiert. Generierte Namen folgen dem Muster: {column}_{function}_{window}. Beispiel:
-
price_avg_rolling_1h(1-Stunden-Durchschnittspreis) -
transaction_count_rolling_30d_1d(30-tägige Transaktionszählung mit 1d Verzögerung durch den Zeitstempel des Ereignisses)
Unterstützte Funktionen
Aggregationsfunktionen
Note
Aggregationsfunktionen werden zusammen AggregationFunction mit einem Zeitfenster umschlossen, wie in Zeitfenstern beschrieben. Jede Funktion verwendet einen input Parameter, der die zu aggregierende Quellspalte angibt.
| Funktion | Description | Exemplarischer Anwendungsfall |
|---|---|---|
Sum(input="column") |
Summe der Werte | Tägliche App-Nutzung pro Benutzer in Minuten |
Avg(input="column") |
Mittelwert der Werte | Mittlerer Transaktionsbetrag |
Count(input="column") |
Anzahl der Datensätze | Anzahl der Anmeldungen pro Benutzer |
Min(input="column") |
Minimalwert | Niedrigste Von einem tragbaren Gerät aufgezeichnete Herzfrequenz |
Max(input="column") |
Maximalwert | Höchster Transaktionsbetrag pro Sitzung |
StddevPop(input="column") |
Standardabweichung der Population | Tägliche Transaktionsbetragsvariabilität für alle Kunden |
StddevSamp(input="column") |
Stichprobenstandardabweichung | Variabilität der Klickraten für Anzeigenkampagnen |
VarPop(input="column") |
Varianz der Population | Verbreitung von Sensorwerten für IoT-Geräte in einer Fabrik |
VarSamp(input="column") |
Stichprobenabweichung | Verteilung von Filmbewertungen über eine ausgewählte Gruppe |
ApproxCountDistinct(input="column", relativeSD=0.05) |
Ungefähre eindeutige Anzahl | Unterschiedliche Anzahl der gekauften Artikel |
ApproxPercentile(input="column", percentile=0.95, accuracy=100) |
Ungefähres Perzentil | p95-Antwortverzögerung |
First(input="column") |
Erster Wert | Erster Anmeldezeitstempel |
Last(input="column") |
Letzter Wert | Zuletzt erworbener Betrag |
FirstN(input="column", n=3) |
Erste Werte n als Array |
Erste drei Produkte, die in einer Sitzung betrachtet werden |
LastN(input="column", n=3) |
Letzte n Werte als Array |
Drei jüngste Statuszustände von Unterstützungsfällen |
FirstDistinct(input="column", n=3) |
Zuerst n unterscheidende Werte als Array |
Die ersten drei unterschiedlichen Produktkategorien |
LastDistinct(input="column", n=3) |
Letzte n unterschiedliche Werte als Array |
Drei jüngste unterschiedliche Händlerkategorien |
Note
First, , , , , FirstDistinctund LastDistinct akzeptieren unterstützte skalare Werte und ARRAY, MAP, sowie STRUCT Werte, einschließlich verschachtelter Kombinationen. LastNFirstNLast Sie enthalten standardmäßig Nullwerte. Um NULL-Werte zu überspringen, fügen Sie ein filter_condition , das Eingabespalten explizit ausschließt, die NULL sind.
FirstN, LastN, , FirstDistinctund LastDistinct nutzt die Merkmale, timeseries_column um Eingabezeilen zu ordnen und ein Array mit bis zu bestimmten Werten n zurückzugeben. Der Parameter n muss eine positive ganze Zahl sein.
FirstN und FirstDistinct Werte vom frühesten bis zum neuesten auswählen.
LastN und wählt LastDistinct Werte vom neuesten bis frühesten aus und gibt dann die ausgewählten Werte in Zeitstempelreihenfolge zurück.
FirstDistinct und LastDistinct beim Auswählen von Werten in diese Richtung doppelte Werte entfernen.
Wenn zum Beispiel die Quellzeilen einer Entität nach event_time["A", "A", "B", "C", "B", "B"]geordnet sind, geben folgende Funktionen zurück:
| Funktion | Result |
|---|---|
FirstN(input="event_type", n=3) |
["A", "A", "B"] |
LastN(input="event_type", n=3) |
["C", "B", "B"] |
FirstDistinct(input="event_type", n=3) |
["A", "B", "C"] |
LastDistinct(input="event_type", n=3) |
["A", "C", "B"] |
FirstN, LastN, , FirstDistinctund LastDistinct erfordern databricks-feature-engineering Version 0.17.0 oder neuer.
CustomUDF
CustomUDFauf jede Zeile eine registrierte Unity Catalog Python benutzerdefinierte Funktion (UDF) anwendet. Nutze es, um Anfrageeingaben zu transformieren oder Feature-Werte zu kombinieren. Sie aggregiert keine Zeilen und definiert kein Zeitfenster.
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings jeden UDF-Parameternamen auf eine Eingabe abbildet. Für RequestSourceist die Eingabe ein Quellspaltenname. Für FeatureViewSource, ist es eine Upstream-Feature-Referenz. Binde jeden UDF-Parameter, einschließlich Parameter mit Standardeinstellungen. Eingabetypen müssen exakt mit den UDF-Parametertypen übereinstimmen, ohne implizite numerische Casts. Du kannst skalare und komplexe (, MAP, und STRUCT) Eingabe- und Rückgabetypen verwenden, einschließlich verschachtelter KombinationenARRAY.
| Source | Behavior |
|---|---|
RequestSource |
Transformiert Spalten aus dem Trainings-DataFrame oder der Inferenzanfrage. |
FeatureViewSource |
Kombiniert upstream-Feature-Werte. Siehe FeatureViewSource. |
Delta-unterstützte CustomUDF Funktionen können nicht materialisiert oder online bereitgestellt werden. Um tabellenbasierte Merkmalswerte für Training und Serving zu transformieren, definiert man eine Delta-gestützte Aggregations- oder Spaltenauswahlfunktion und referenziert sie über FeatureViewSource.
CustomUDF wird nicht mit StreamSourceunterstützt. Um die Ausgabe eines Streaming-Features zu transformieren, referenziere dieses Merkmal durch FeatureViewSource.
CustomUDF mit RequestSource benötigt databricks-feature-engineering Version 0.17.0 oder neuer.
Um ein CustomUDFzu verwenden, benötigt man das EXECUTE Privileg auf dem UDF, das USE CATALOG Privileg auf seinem Elternkatalog und das USE SCHEMA Privileg auf dem Elternschema.
Das folgende Beispiel verwendet NumPy zur Berechnung log(1 + amount), wodurch der Umfang großer Transaktionsbeträge reduziert wird. Führe es auf serverless Compute mit aktivierten benutzerdefinierten UDF-Abhängigkeiten aus. Das Schema main.ecommerce muss existieren.
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '6'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
Registrieren Sie eine Funktion, die die Anfragespalte transaction_amount an den UDF-Parameter amountbindet:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
Die UDF ENVIRONMENT konfiguriert Abhängigkeiten für Offline-Berechnungen. Für Online-Bedienung geben Sie die Pakete ebenfalls in create_feature_spec(extra_pip_requirements=...) oder log_model(extra_pip_requirements=...)an. Sie werden nicht automatisch aus dem UDF kopiert.
Siehe Feature Serving Abhängigkeiten und Modellabhängigkeiten.
CustomUDF Merkmale können nicht materialisiert werden. Request-backed und feature-backed UDFs laufen während der Ausbildung und des Dienstes auf Abruf. Jede UDF in einer Abhängigkeitskette fügt Berechnungen hinzu, daher sollten Funktionen und Ketten klein bleiben. UDFs müssen fehlende Eingaben verarbeiten, die offline oder NaN online sein None können.
Für Hinweise zum Umgang mit fehlenden Werten siehe Wie man mit fehlenden Merkmalswerten umgeht.
ColumnSelection (Durchfahrt)
ColumnSelection wählt eine einzelne Spalte aus einer Quelle aus, ohne eine Aggregation anzuwenden. Er wird direkt in den function Parameter eingeschlossen (nicht innerhalb AggregationFunction). Der Rückgabetyp, einschließlich verschachtelter ARRAY, MAP, und STRUCT Typen, wird aus dem Quellschema abgeleitet, wenn das Merkmal erstellt wird. Das Ändern des Typs der Quellspalte nach der Erstellung der Funktion wird nicht unterstützt.
| Funktion | Description | Exemplarischer Anwendungsfall |
|---|---|---|
ColumnSelection("col") |
Letzter Wert einer Spalte (keine Aggregation) | Neueste Anbieterkategorie, Pass-Through eines Anforderungsfelds |
ColumnSelection unterstützt folgende Datenquellen:
-
DeltaTableSource: Gibt den neuesten Wert pro Entitätsschlüssel über einen Punkt-in-Zeit-Join zurück (keine Aggregation des Rückblickfensters). -
SdpSource: Gibt den neuesten Wert pro Entitätsschlüssel aus der Ausgabetabelle der Pipeline zurück, genau wieDeltaTableSource. -
StreamSource: Gibt den neuesten Wert pro Entitätsschlüssel aus dem Stream zurück (keine Rückblickfensteraggregation). -
RequestSource: Geht durch den zum Inferenzzeitpunkt angegebenen Wert (oder beim Training aus dem beschrifteten DataFrame extrahiert).
Für ein DeltaTableSource, unterstützen filter_condition die ColumnSelection Funktionen und transformation_sql, angewendet vor der neuesten, Wertauswahl, dasselbe wie bei der Aggregation von Features.
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
Beispiel: Aggregations- und Spaltenauswahlfeatures
Das folgende Beispiel zeigt Features, die über dieselbe Datenquelle definiert sind.
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
Funktionen mit Filterbedingungen
Der Parameter filter_condition erlaubt es, Zeilen aus der Quelltabelle zu filtern , bevor Aggregationen berechnet oder der letzte Spaltenwert ausgewählt wird. Dies funktioniert als SQL-Klausel WHERE , die vor dem Gruppieren und Aggregieren von Daten angewendet wird.
Note
Für Aggregationsfunktionen filtert filter_condition man Zeilen vor der Aggregation, wie eine SQL-Klausel WHERE , die vor GROUP BY. angewendet wurde. Sie ändert nicht die Granularität, die immer von entity der Featuredefinition definiert wird.
Filter sind nützlich, wenn Sie mit großen Quelltabellen arbeiten, die eine Obermenge von Daten enthalten, die für die Featureberechnung erforderlich sind, und die Notwendigkeit minimieren, separate Ansichten über diesen Tabellen zu erstellen.
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
Datenquellen
DeltaTableSource
DeltaTableSourceist ein ephemeres Python-Objekt, das verwendet wird, um zu definieren, wie Features aus einer Quelltabelle berechnet werden. Es wird keine neue Tabelle erstellt. Sie gibt die Konfiguration zum Lesen von Daten und Aggregierungsfeatures an.
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
Parameter:
-
catalog_name,schema_name,table_name: Identifizieren Sie die Quell-Delta-Tabelle im Unity-Katalog. -
filter_condition: Eine SQL-KlauselWHERE, die vor der Aggregation oder Spaltenauswahl angewendet wird. Beispiel:"status = 'completed'". -
transformation_sql: Ein SQL-AusdruckSELECT, der auf die Quelltabelle angewendet wird. Verwenden Sie dies, um Spalten umzubenennen, Typen zu casten oder abgeleitete Spalten vor der Aggregation oder Spaltenauswahl zu berechnen. Wenn nicht angegeben, werden alle Spalten ausgewählt (*). Beispiel:"user_id, CAST(amount AS DOUBLE) AS amount, event_time". -
dataframe_schema: Das Schema des resultierenden DataFrame nach Transformationen im Spark StructType JSON-Format (ausdf.schema.json()). Erforderlich, wenntransformation_sqlangegeben ist. Dadurch wird dem System die Spaltennamen und -typen mitgeteilt, die aus der Transformation resultieren. -
lateness: EinSourceLatenessObjekt, das beschreibt, wie lange die Quelle normalerweise braucht, um in Ereigniszeit vollständig zu werden. Wenn sie weggelassen wird, gilt die Quelle sofort als vollständig.
Wenn beide filter_condition und transformation_sql festgelegt werden, lautet die resultierende Abfrage: SELECT {transformation_sql} FROM {table} WHERE {filter_condition}.
SourceLateness.settling_delay ist die empfohlene Methode, während des Trainings eine konstante ETL-Verzögerung zu simulieren, die die Online-Materialisierung beeinflusst. Azure Databricks verschiebt die berechtigte Trainingsbewertungszeit um diese Dauer nach hinten, sodass ein Trainingsbeispiel keine Daten verwendet, die sich noch online übertragen hätten. Während der Materialisierung wartet Azure Databricks genauso lange, bevor ein abgeschlossenes Fenster veröffentlicht wird, und bedient das zuletzt abgeschlossene Fenster während der dazwischenliegenden Zeit.
Angenommen, ein täglicher ETL-Job wird 8 Stunden nach Mitternacht in einer lokalen Zeitzone abgeschlossen, in der Mitternacht 07:00 UTC entspricht. Verwenden Sie eine Setling-Verzögerung von 8 Stunden und einen Fensterversatz von 7 Stunden:
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
Note
Die timeseries_column müssen vom Typ TimestampType oder TimestampNTZTypesein.
DateType wird für Zeitreihen nicht unterstützt; beschreibe die Spalte zuerst TimestampType (zum Beispiel mit transformation_sql).
Beispiel: Verwendung transformation_sql für Spaltentransformationen
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
Beispiel: Ableitung transformation_sql und dataframe_schema von einem PySpark DataFrame
Sie können Ihre Transformation als PySpark-Abfrage schreiben und dann das Schema aus dem resultierenden DataFrame extrahieren:
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
Unterstützte transformation_sql Ausdrücke
Die gleichen Regeln gelten für transformation_sql auf DeltaTableSource und StreamSource.
transformation_sql unterstützt beliebige zeilenweise Ausdrücke; Operationen werden unabhängig für jede Zeile ausgewertet. Sie ändern weder die Anzahl der Zeilen noch die Eins-zu-eins-Entsprechung mit der Quelle. Zeilenweise Ausdrücke umfassen Spaltenumbenennungen, Guss, arithmetische Operationen und mehr.
Operationen, die die Form oder Zeilenanzahl verändern, werden nicht unterstützt, wie z. B. Aggregationen wie SUM() oder COUNT(). Verwenden Sie AggregationFunction stattdessen die Featuredefinition.
DeltaTableSource.from_sql()
Als Einfachheit können Sie eine DeltaTableSource aus einer SQL-Abfrage erstellen. Die Methode analysiert die Abfrage, um den Tabellennamen automatisch zu extrahieren, transformation_sqlund filter_condition.
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
Nur einfache SELECT ... FROM ... [WHERE ...] Abfragen werden unterstützt. Komplexe SQL (JOINs, Unterabfragen, CTEs, UNIONs) werden abgelehnt. Erstellen Sie für komplexe Abfragen DeltaTableSource direkt mit transformation_sql und filter_condition.
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
Durchlaufen mit to_dataframe()
Wird source.to_dataframe() verwendet, um eine Vorschau der Daten anzuzeigen, die für die Featureberechnung verwendet werden. Dies ist nützlich für die Iterierung filter_condition und transformation_sql bis sie die erwarteten Ergebnisse erzeugen.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
Grundlegendes zu Entitäten
Entitätsspalten definieren die Aggregationsebene für Ihre Features. Sie werden für die Feature Definition angegeben, nicht für DeltaTableSource. Entitäten bestimmen:
-
Wie Daten gruppiert werden: Features werden per eindeutiger Kombination von Entitätswerten aggregiert (ähnlich wie
GROUP BYbei SQL) - Die primäre Schlüsselstruktur: Jede eindeutige Entitätskombination ergibt eine Zeile berechneter Features
Beispiel: Funktionen auf Kundenebene
Der folgende Code aggregiert Features auf Kundenebene (eine Zeile pro Kunde):
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Beispiel: Funktionen auf Kundenladenebene
Um Features auf einer detaillierteren Ebene zu aggregieren (eine Zeile pro Kundenspeicherkombination), verwenden Sie mehrere Entitätsspalten:
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Wenn Sie Features auf verschiedenen Aggregationsebenen benötigen (z. B. Auf Kundenebene und Kundenspeicherebene), verwenden Sie in Ihren Featuredefinitionen unterschiedliche entity Werte. Dasselbe DeltaTableSource kann für Features mit unterschiedlichen Entitätskonfigurationen gemeinsam verwendet werden.
StreamSource
StreamSource bezieht sich auf einen Stream. Der Stream enthält Verbindungs-, Authentifizierungs-, Schema- und Aufnahmekonfiguration für die Streamingquelle. Für Kafka müssen Spaltenverweise in Featuredefinitionen mit value.key. einem Präfix versehen oder angeben, welcher Teil der Nachricht gelesen werden soll.
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
Parameter:
-
full_name: Der vollständige dreiteilige Name eines Stroms (zum Beispiel,"my_catalog.my_schema.my_stream"). -
filter_condition(optional): Eine SQL-KlauselWHERE, die vor der Aggregation auf Stromdaten angewendet wird, wobei Punkt-präfixierte Spaltenreferenzen verwendet werden (zum Beispiel"value.event_type = 'purchase'"). -
transformation_sql(optional): Ein SQL-AusdruckSELECT, der vor der Aggregation oder Spaltenauswahl angewendet wird, wobei punktpräfixierte Referenzen auf diekeyund-Strukturenvalueverwendet werden. Unterstützt dieselben zeilenweisen Ausdrücke wieDeltaTableSource. Wenn weggelassen, verwendet die Quelle alle Spalten (*). -
dataframe_schema: Das Spark-JSON-SchemaStructTypeder projizierten Ausgabe. Erforderlich, wenn du .transformation_sql -
lateness: EinSourceLatenessObjekt, das beschreibt, wie lange der Strom normalerweise braucht, um in der Ereigniszeit vollständig zu werden. SieheSourceLateness.settling_delay.
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
Man leitet dataframe_schema ab, indem man die Projektion gegen den Aufnahmetisch des Stroms ausführt, der die key und value Strukturen freilegt.
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
SdpSource
SdpSource definiert Features in einer Ausgabetabelle einer ausgelösten Lakeflow-Pipeline. Feature Store führt die Pipeline vor jeder Materialisierung und jedem Backfill aus und liest dann die Ausgabetabelle genauso aus, wie er eine DeltaTableSourceliest. Für den End-to-End-Workflow siehe Verwenden Sie eine Lakeflow-Pipeline als Feature-Quelle.
SdpSource(
    pipeline_id: str,                            # Required: ID of the pipeline that produces the output table
    output_table: str,                           # Required: Three-part name of the pipeline output table to read
    input_tables: Optional[List[str]] = None,    # Optional: Three-part names of the tables the pipeline reads from
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause to filter the output table
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
)
Parameter:
-
pipeline_id: Die ID einer bestehenden ausgelösten Pipeline. Die Pipeline muss noch nicht verlaufen sein. Du brauchst CAN RUN, CAN MANAGE oder IS OWNER-Erlaubnis dafür. Kontinuierliche Pipelines werden abgelehnt. -
output_table: Der dreiteilige Name (catalog.schema.table) der Pipeline-Ausgabetabelle zum Lesen. Die Tabelle muss erst existieren, wenn die Pipeline ausgeführt wird. Wenn es existiert, muss es ein Output der Pipeline sein, und du brauchstSELECTes darauf. -
input_tables: Die dreiteiligen Namen der Tabellen, aus denen die Pipeline liest. Muss mit einem materialisieren,TableTriggerwas einen Run startet, wenn diese Tabellen aktualisiert werden.ColumnSelectionMerkmale materialisieren sich auf einem Tabellentrigger, daher benötigeninput_tablessie . Du kannst bis zu 25 Tabellen ohne Duplikate auflisten, und jede Tabelle muss existieren, wenn du die Funktion erstellst. ATableTriggerüberwacht mehr als 10 Tabellen nur, wenn Dateiereignisse auf jeder überwachten Tabelle aktiviert sind. -
filter_condition,transformation_sql, :dataframe_schemaAngewandt auf die Ausgabetabelle auf die gleiche Weise wie auf einemDeltaTableSource.dataframe_schemaist erforderlich, wenn du setzttransformation_sql.
SdpSource Funktionen zur Unterstützung ColumnSelection und Aggregation von Funktionen. Sie unterstützen CustomUDFnicht.
Nachdem Sie eine Funktion erstellt haben, meldet deren Quelle eine Nur-Lese-Funktion pipeline_state:
-
PENDING: Die Pipeline ist noch nicht ausgeführt, daher existiert die Ausgabetabelle nicht. -
RESOLVED: Die Ausgabetabelle existiert, und die Spalten des Features werden dagegen validiert. -
ERROR: Der Pipeline-Run oder die Validierung der Ausgabetabelle scheiterte.
Das folgende Beispiel definiert ein SdpSource:
from databricks.feature_engineering.entities import SdpSource

source = SdpSource(
    pipeline_id="1234abcd-5678-90ef-1234-567890abcdef",
    output_table="main.features.tutor_review_stats",
    input_tables=["main.raw.reviews", "main.raw.tutors"],
)
refresh_sdp_source()
refresh_sdp_source betreibt die Pipelines hinter den gegebenen Merkmalen. Es startet für jede Pipeline ein Update oder hängt ein bereits laufendes Update an.
FeatureEngineeringClient.refresh_sdp_source(
    *,                                  # Arguments are keyword-only
    features: List[Feature],            # Features with an SdpSource
    wait: bool = True,                  # Wait for the updates to finish
) -> Dict[str, str]                     # Pipeline ID to update ID
Mit wait=Truewartet der Anruf, bis jedes Update abgeschlossen ist, ohne Timeout, und löst dann die Funktionen pipeline_stateauf. Sie wird aktiviert, ValueError wenn ein Update fehlschlägt oder abgebrochen wird oder wenn eine Funktion ungelöst bleibt. Mit , kehrt wait=Falseder Anruf sofort zurück, sobald die Updates beginnen.
Um die Pipeline eines Features vor dem Training auszuführen, führen Sie Folgendes aus:
fe.refresh_sdp_source(features=[fe.get_feature(full_name="main.features.tutor_avg_score_7d")], wait=True)
RequestSource
RequestSource definiert ein Schema für Daten, die zur Inferenzzeit im Anfragepayload bereitgestellt werden, anstatt aus einer vormaterialisierten Tabelle nachgeschlagen zu werden. Während der Schulung werden diese Spalten aus dem beschrifteten DataFrame extrahiert, das an create_training_set. Während der Modellbereitstellung muss der Aufrufer sie in die HTTP-Anforderungsnutzlast einschließen.
RequestSource kann mit Funktionen CustomUDF oder ColumnSelection Feature View verwendet werden. Es unterstützt keine Aggregationsfunktionen oder Zeitfenster.
Definieren des Schemas
Definieren Sie das Schema als Eine Liste von FieldDefinition Objekten, wobei jeder einen Spaltennamen und ein ScalarDataType:
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
Für Schemata, die Arrays, Maps oder Structs enthalten, übergebe dataframe_schema (das Spark-JSON StructType von df.schema.json()) statt schema, oder leite das Schema aus einem DataFrame mit RequestSource.from_dataframeab:
from databricks.feature_engineering.entities import RequestSource

request_source = RequestSource.from_dataframe(dataframe=labeled_df.select("cart_items", "device_info"))
Unterstützte Datentypen
RequestSourceUnterstützt die skalaren Typen, die in definiert sindScalarDataType: , , FLOAT, BOOLEAN, STRING, DOUBLE, SHORTLONGTIMESTAMPDATE. BINARYINTEGER Es unterstützt ARRAYauch , MAP, und STRUCT Spalten, die aus diesen Typen gebaut werden, wenn man das Schema mit dataframe_schema oder from_dataframedefiniert.
MAPDie Schlüssel müssen .STRING
Wie Anforderungsdaten hydratisiert werden
| Kontext | Behavior |
|---|---|
Ausbildung (create_training_set) |
Spalten werden aus dem beschrifteten DataFrame extrahiert. Typen werden anhand des deklarierten Schemas überprüft. Bei Nichtübereinstimmungen wird ein Fehler ausgelöst (keine implizite Umwandlung). |
| Serving (Modellendpunkt) | Spalten werden aus dataframe_records oder dataframe_split in der HTTP-Anforderung abgerufen. JSON-Werte werden in die deklarierten Typen (z. B. JSON-Nummer → DOUBLE) umgesetzt. |
Modellsignatur
Wenn ein Modell mit log_model einem Schulungssatz protokolliert wird, der Features enthält RequestSource , werden die RequestSource Spalten der MLflow-Modellsignatur als erforderliche Eingaben hinzugefügt. Dies bedeutet, dass das API-Schema des dienstenden Endpunkts widerspiegelt, welche Felder Aufrufer zur Ableitungszeit bereitstellen müssen.
FeatureViewSource
FeatureViewSource verwendet die Ausgaben anderer Feature Views als Eingaben für ein CustomUDF. Das Verketten von Merkmalen erzeugt einen gerichteten azyklischen Graphen (DAG). Zum Beispiel kann eine Margenfunktion Umsatz- und Kostenaggregate kombinieren, und eine andere Funktion kann die Marge transformieren.
Verwenden Sie databricks-feature-engineering Version 0.18.0 oder später für FeatureViewSource.
Übergebe eine Liste von Feature Objekten an , nicht an featuresFeature-Name-Strings. Abrufe registrierte Merkmale mit get_feature. In input_bindings, verwenden Sie die Merkmale jedes registrierten Merkmals full_name. Für ein lokales, nicht registriertes Merkmal verwenden Sie stattdessen dieses name .
Das folgende Beispiel nimmt zwei registrierte Merkmale an, revenue_sum_7d und cost_sum_7d, die Werte durch customer_id zurückgeben DOUBLE und für die Zeitpunktberechnung verwendenevent_time:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
Es gelten folgende Einschränkungen:
- Nur
CustomUDFwird als Funktion unterstützt. Upstream-Funktionen können Aggregationen, Spaltenauswahlen oder andereCustomUDFFeatures sein. - Lass das abgeleitete Merkmal weg
entitytimeseries_column. Jede Upstream-Funktion behält ihre eigene Entität, Zeitstempel und Fensterdefinition bei. - Ein Merkmal hat eine einzige Quelle. Um einen Anfragewert mit einer tabellenbasierten Funktion zu kombinieren, definiert man ein
RequestSourceMerkmal und referenziert beide überFeatureViewSource. - Jede deklarierte Upstream-Funktion muss in
input_bindingsverwendet werden. Zyklen sind nicht erlaubt. - Registrieren Sie upstream-Features, bevor Sie das abgeleitete Feature registrieren. Lokale, nicht registrierte Graphen können für Experimente verwendet
create_training_setwerden. - Für Training oder Serving benötigt man das oder
MANAGEPrivilegREAD FEATUREauf dem abgeleiteten Merkmal und seinen transitiven vorgelagerten Merkmalen. Verwenden Sie unterschiedliche Merkmalsnamen im gesamten Diagramm für Registrierung und Bedienung, sogar für Kataloge oder Schemata. - Ein Merkmal kann sich auf bis zu 20 direkte Upstream-Merkmale beziehen. Registrierte Graphen unterstützen eine maximale Tiefe von fünf Merkmalen entlang eines Abhängigkeitspfads, einschließlich des Basismerkmals.
- Trainingsanfragen unterliegen der Begrenzung von fünf Unity Catalog UDF-Aufrufen pro Abfrage, die über den vollständigen Abhängigkeitsgraphen gezählt werden. Um das zu übertreffen, verwenden Sie klassische Rechenleistung mit Databricks Runtime 18.1 oder höher. Bei serverless Compute sowie auf Pro- und Serverless-SQL-Warehouses ist in jeder UDF-Definition auf oder
6höher gesetztenvironment_version. -
FeatureViewSourceMerkmale können mit nicht materialisiert oder bewertet werdencompute_features. Nutze siecreate_training_set, um sie offline zu bewerten. Für Online-Bedienung sollten stattdessen die unterstützten, tabellengestützten Upstream-Funktionen implementiert werden.
Für Abhängigkeitsbewertung und Ausgabeauswahl siehe Trainieren mit FeatureViewSource-Funktionen. Für die Bereitstellung siehe Serve abgeleitete Features.
Schulungs- und Rückschluss-API
create_training_set und score_batch berechnen zeitweise korrekte Merkmalswerte auf Anfrage aus den Quelldaten. Bei Features, die die Offlinematerialisierung unterstützen, z. B. Gleitfensteraggregationen in Delta-Tabellenquellen, verbessert die Materialisierungsfeatures zuerst in einem Offlinespeicher die Leistung beider Vorgänge. Wenn materialisierte Offlinefeatures verfügbar sind, lesen die Vorgänge vorkompilierte Offlinedaten, anstatt Featurewerte aus der Quelle neu zu komputieren. Siehe Materialisieren von Featureansichten , um Features in einem Offlinespeicher zu materialisieren.
create_training_set()
Erstellt ein Schulungsdatenset mit Punkt-in-Time-korrekter Featureberechnung. Ausführliche Informationen finden Sie unter "Train models with Feature Views".
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
Protokolliert ein Modell mit Featuremetadaten für die Nachverfolgung von Linien und die automatische Featuresuche während der Ableitung. Ausführliche Informationen finden Sie unter "Train models with Feature Views".
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
Führt die Offlinebatch-Ableitung mit automatischer Featuresuche durch. Verwendet die featuremetadaten, die mit dem Modell gespeichert sind, um punktintime korrekte Features zu berechnen, um die Konsistenz mit der Schulung sicherzustellen.
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
Der Eingabedatenrahmen muss die Entitäts- und Zeitserienspalten enthalten, die während der Schulung verwendet werden. Features werden automatisch aus den Quelldaten berechnet.
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
Zeitfenster
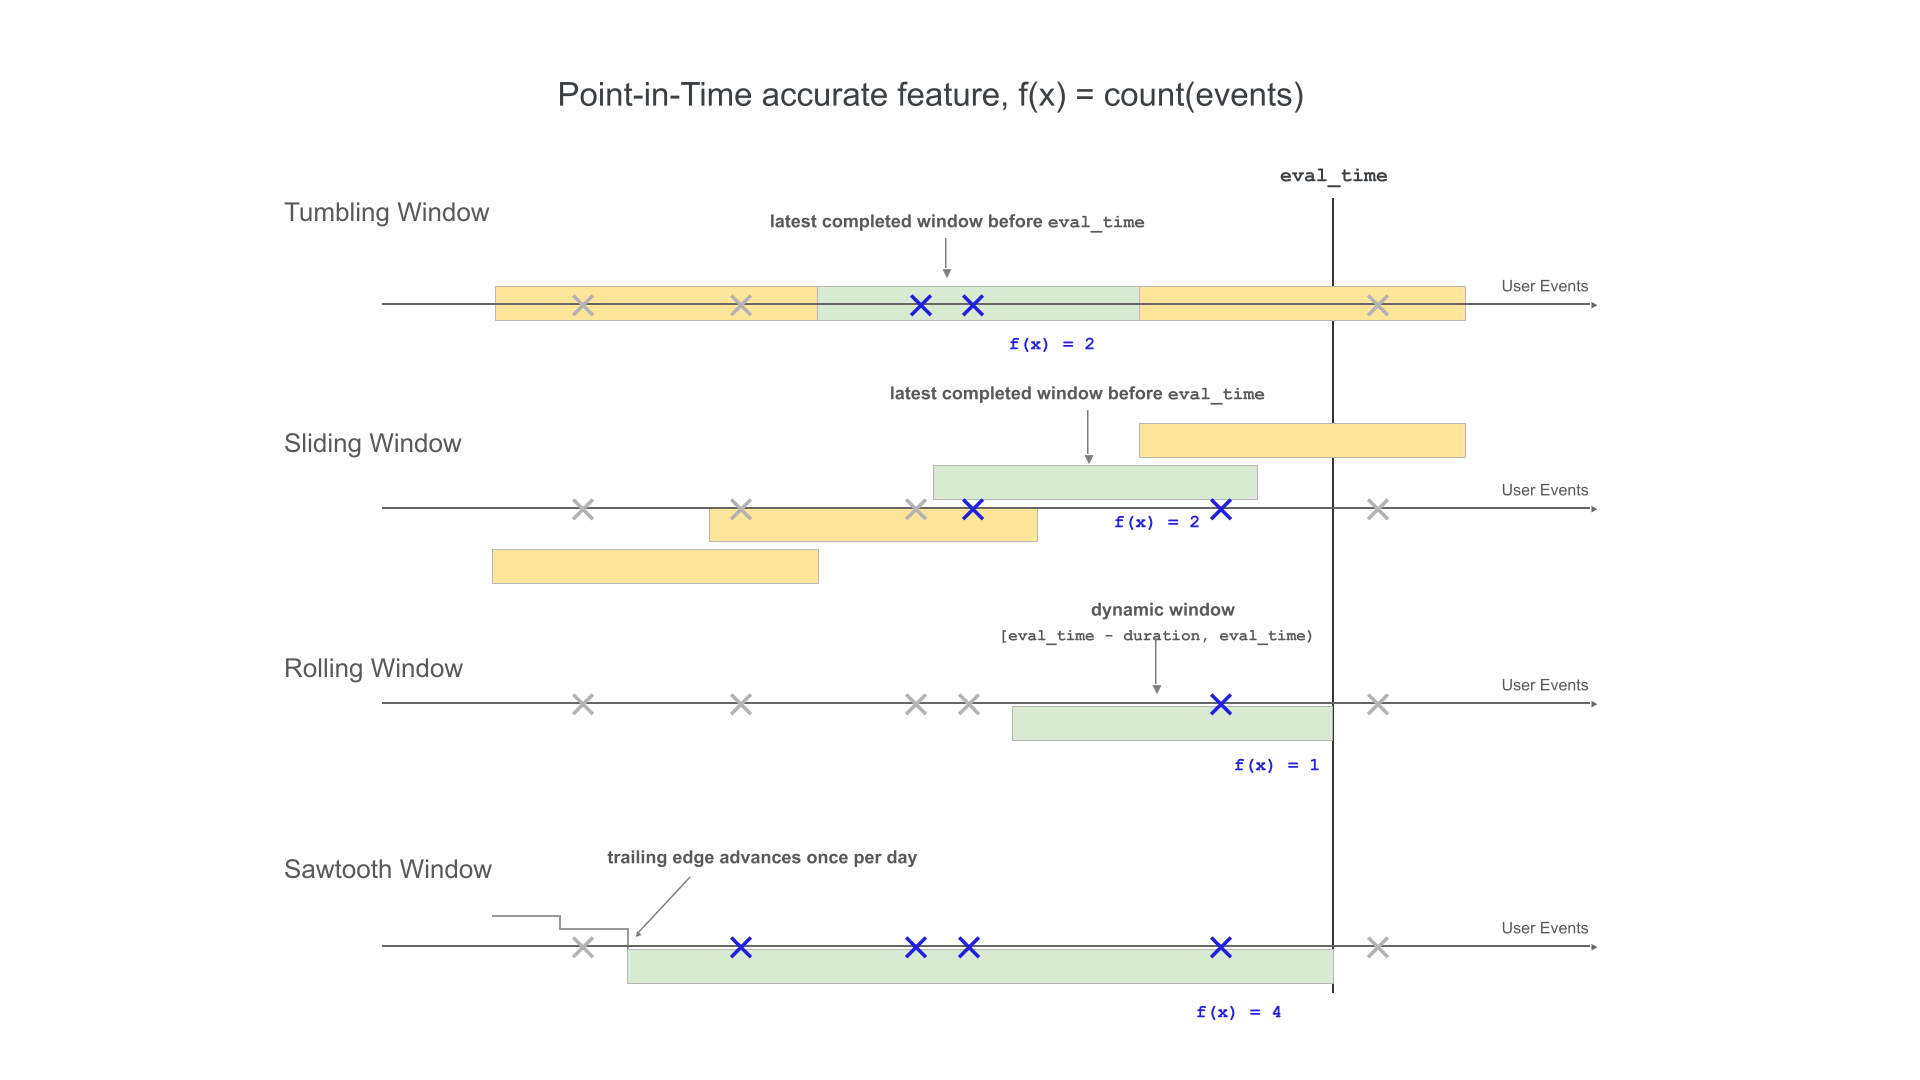
Feature Views unterstützen vier Fenstertypen, um das Rückblickverhalten für zeitfensterbasierte Aggregationen zu steuern. Die verfügbaren Fenstertypen hängen von der Quelle des Features ab: Streaming-Quellen-Funktionen können Roll- und Sägezahnfenster verwenden, und Batch-Quellen-Funktionen können rollende, Roll- und Schiebefenster verwenden.
- Rollfenster kehren von der Ereigniszeit zurück. Dauer und Verzögerung werden explizit definiert.
- Springende Fenster sind feste, nicht überlappende Zeitfenster. Jeder Datenpunkt gehört zu genau einem Fenster.
- Gleitfenster sind überlappende und rollende Zeitfenster mit einem konfigurierbaren Slide-Intervall.
- Sawtooth-Fenster halten ein langes Rückblickfenster über eine Streamingquelle frisch, indem sie einen hybriden Batch- und Streaming-Pfad verwenden. Siehe Sawtooth-Fenster.
Die folgende Abbildung zeigt die Typen mit Roll-, Schieb-, Roll- und Sägezahnfenstern.
Zeitfenster-Timing
Verwenden Sie, delay um ein Fenster zu einem früheren analytischen Zeitpunkt zu bewerten. Zum Beispiel berechnet ein 30-Tage-Fenster mit einer 7-tägigen Verzögerung einen 30-Tage-Wert eine Woche vor der Bewertungszeit.
delay unabhängig von der Ankunftszeit der Quelle. Um die Zeit zu modellieren, die die Quelldaten benötigen, um anzukommen, konfigurieren Sie SourceLateness.settling_delay stattdessen.
Wenn beide Settings vorhanden sind, komponieren sie. Azure Databricks behandelt das Fenster als abgeschlossen nach der Quell-Setling-Verzögerung und bewertet es mit der analytischen Verzögerung.
Verwenden Sie, offset um die Ausrichtung fester Fenstergrenzen zu ändern. Standardmäßig sind Tumbling-Fenster und Schiebefenster auf Mitternachts-UTC ausgerichtet. Zum Beispiel richtet ein Offset von 22 Stunden eine Tagesgrenze auf 22:00 UTC aus. Um Grenzen in einer lokalen Zeitzone zu approximieren, konfigurieren Sie einen statischen Offset relativ zum UTC. Der Offset passt nicht an die Sommerzeit an, verschiebt die Auswertungszeit nicht und modelliert nicht verspätete Daten.
Die folgende Tabelle fasst die Unterstützung für diese Felder zusammen:
| Feld | Unterstützte Fenster | Constraint |
|---|---|---|
delay |
Rollen, Rollen und Gleiten | Muss ein nicht-negativ sein. datetime.timedelta |
offset |
Rollen und Rutschen | Muss nicht negativ sein und kürzer als die Periode* |
SourceLateness.settling_delay |
Roll-, Roll- und Gleitfunktionen | Muss ein nicht-negativ sein. datetime.timedelta |
start_time |
Rollen, Rollen, Rutschen und Sägezahn | Muss ein datetime.datetime. Für Sägezahn darf dies nicht später als zum Zeitpunkt der Feature-Erstellung erfolgen. |
*Punkt: Für ein Tumbling-Fenster muss der Offset kürzer als window_durationsein. Für ein Schiebefenster muss es kürzer als slide_durationsein.
Startzeitpunkt
Verwenden start_time Sie, um die früheste Ereigniszeitgrenze in UTC festzulegen, bei der ein Merkmal eine Ausgabe emittieren kann. Die Grenze ist inklusiv.
start_time Gates-Ausgaben. Es schränkt die historischen Quellzeilen, die ein Fenster lesen kann, nicht ein und ändert auch nicht die Fensterausrichtung. Liegt start_time zwischen zwei ausgerichteten Grenzen, ist die erste zulässige Ausgabe mit festem Fenster die nächste Grenze.
Mit , können Fenster mit fester Dauer start_timeemittieren, bevor eine vollständige Fensterdauer in der Quelle abgelaufen ist. Diese frühen Ausgaben verwenden die verfügbare Quellgeschichte. Betrachten wir zum Beispiel ein gleitendes Zeitfenster mit einem Jahr window_duration und einem Tag slide_duration, über eine Quelle, deren Daten am 1. Januar 2024 beginnen:
- Ohne
start_time, wird die Funktion erstmals am 1. Januar 2025 ausgestrahlt, sobald ein vollständiges Einjahresfenster geschaffen werden kann. - Mit der Einstellung zum 21. August 2024 startet
start_timedas Feature erstmals am 21. August 2024. Diese Ausgabe deckt nur die bisher verfügbare Quellengeschichte ab dem 1. Januar 2024 ab. Das Zeitfenster erreicht seine volle Einjahreslaufzeit am 1. Januar 2025 und liefert von da an vollständige Ergebnisse.
Da start_time sich die Fensterausrichtung nicht ändert, erzeugt ein Wert zwischen zwei ausgerichteten Grenzen keine neue Grenze. Bei einem Tumbling-Fenster mit täglichen Grenzen um Mitternacht UTC wird ein start_time von 06:00 UTC zuerst an der nächsten Mitternachtsgrenze ausgestrahlt. A start_time , die genau auf einer Grenze landet, wirkt an dieser Grenze, weil die Grenze inklusiv ist.
Wenn start_time nicht gesetzt ist, können Tumbling-Fenster und Sliding-Fenster mit fester Dauer zuerst an einer ausgerichteten Grenze nach der Bildung eines vollständigen Fensters ausgestrahlt werden. Lebenszeitliche Schiebefenster und rollende Fenster werden ausgestrahlt, sobald berechtigte Quelldaten vorhanden sind.
Note
start_time wird für Sägezahnfenster sowie für Roll-, Roll- und Gleitfenster bei Batch-Funktionen unterstützt, die DeltaTableSource. Es wird nicht unterstützt für RollingWindow mit StreamSource. Siehe Sawtooth-Fenster.
Beispiel:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
Rollfenster
Note
RollingWindow zuvor hieß ContinuousWindower . Wenn Sie von einer früheren SDK-Version migrieren, aktualisieren Sie Die Importe entsprechend.
Rollfenster sind up-to-Datums- und Echtzeitaggregate, die in der Regel über Streamingdaten verwendet werden. In Streamingpipelines gibt das Rollfenster nur dann eine neue Zeile aus, wenn sich der Inhalt des Fensters mit fester Länge ändert, z. B. wenn ein Ereignis eintritt oder verlässt. Wenn ein Rollfensterfeature in Schulungspipelinen verwendet wird, wird eine genaue Punkt-in-Time-Featureberechnung für die Quelldaten mithilfe der Dauer fester Länge ausgeführt, die unmittelbar vor dem Zeitstempel eines bestimmten Ereignisses liegt. Auf diese Weise können Online-Offline-Abweichungen oder Datenverluste verhindert werden. Merkmale zum Zeitpunkt T aggregieren Ereignisse im Zeitraum von [T − Dauer, T).
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
In der folgenden Tabelle sind die Parameter für ein rollierendes Fenster aufgeführt. Die Start- und Endzeiten des Fensters basieren wie folgt auf diesen Parametern:
- Startzeit:
evaluation_time - window_duration - delay(einschließlich) - Endzeitpunkt:
evaluation_time - delay(exklusiv)
| Parameter | Constraints |
|---|---|
delay (optional) |
Muss ≥ 0 sein. Verschiebt das analytische Fenster rückwärts vom Bewertungszeitstempel. Nutze SourceLateness.settling_delay sie, um eine konsistente Basislinie für die Verzögerung der Quellankunft in deinem Stream zu modellieren. |
window_duration |
Muss 0 sein > |
start_time (optional) |
Früheste Ereigniszeitgrenze, an der das Merkmal eine Ausgabe emittieren kann. |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
Definieren Sie ein rollierendes Fenster mit Verzögerung unter Verwendung von Code unten.
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
Beispiele für rollierende Fenster
window_duration=timedelta(days=7): Dies erzeugt ein 7-tägiges Rückblickfenster, das mit der aktuellen Bewertungszeit endet. Für eine Veranstaltung um 2:00 Uhr am Tag 7 umfasst dies alle Ereignisse von 2:00 Uhr am Tag 0 bis (aber nicht einschließlich) 2:00 Uhr am Tag 7.window_duration=timedelta(hours=1), delay=timedelta(minutes=30): Dies erzeugt ein einstündiges Rückblickfenster, das 30 Minuten vor der Evaluierungszeit endet. Für eine Veranstaltung um 13:00 Uhr umfasst dies alle Veranstaltungen von 1:30 bis (aber nicht einschließlich) 2:30 Uhr.
Verwenden Last Sie, um die Frische eines neuesten Wertes zu begrenzen
Kombiniert Last mit RollingWindow wenn ein aktueller Wert nur für eine begrenzte Zeit gültig ist. Zur Evaluierungszeit gibt das Merkmal den Wert aus der Zeile mit dem neuesten Zeitstempel in diesem Intervall zurück:
[evaluation_time - delay - window_duration, evaluation_time - delay)
Wenn die letzte Zeile im Intervall einen Nullwert enthält, gibt das Merkmal Null zurück. Wenn du Null-Eingabewerte ausschließen willst, setze ein filter_condition A auf der Quelle.
Diese Kombination unterscheidet sich von ColumnSelection.
ColumnSelection gibt den zuletzt beobachteten nicht-nullen Wert zurück, ohne ihn aufgrund des Alters zu verfallen.
Für Batch-Funktionen verfügt diese Kombination über einen speziellen, nur online verfügbaren Materialisierungsmodus. Es unterstützt nur DeltaTableSource, Last, RollingWindow, und TableTrigger. Siehe Materialize freshness-bounded latest values.
Rollierendes Fenster
Für Features, die mithilfe von Sturzfenstern definiert sind, werden Aggregationen über ein vordefiniertes Fenster mit fester Länge berechnet, das durch ein Folienintervall voranschreitet, wodurch nicht überlappende Fenster erzeugt werden, die die vollständige Partitionszeit aufweisen. Daher trägt jedes Ereignis in der Quelle zu genau einem Fenster bei. Features zur zeitaggregatieren t Daten von Fenstern, die auf oder vor t (exklusiv) enden. Windows beginnt in der Unix-Epoche.
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
In der folgenden Tabelle sind die Parameter für ein Sturzfenster aufgeführt.
| Parameter | Constraints |
|---|---|
window_duration |
Muss 0 sein > |
delay (optional) |
Muss ≥ 0 sein. Verschiebt das analytische Fenster rückwärts vom Bewertungszeitstempel. |
offset (optional) |
Muss ≥ 0 sein und kürzer als window_duration. Verschiebt die Fenstergrenzen ab Mitternacht UTC. |
start_time (optional) |
Früheste Ereigniszeitgrenze, an der das Merkmal eine Ausgabe emittieren kann. |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Beispiel für ein Tumbling-Fenster
-
window_duration=timedelta(days=5): Dies schafft vorab festgelegte feste Zeitfenster von jeweils 5 Tagen. Beispiel: Fenster #1 erstreckt sich über Tag 0 bis Tag 4, Fenster #2 erstreckt sich über Tag 5 bis Tag 9, Fenster #3 erstreckt sich über Tag 10 bis Tag 14 usw. Insbesondere enthält Window #1 alle Ereignisse mit Zeitstempeln, die am00:00:00.00Tag 0 bis (aber nicht einschließlich) aller Ereignisse mit Zeitstempel00:00:00.00am Tag 5 beginnen. Jedes Ereignis gehört zu genau einem Fenster.
Gleitendes Fenster
Für Merkmale, die mit gleitenden Fenstern definiert sind, werden Aggregationen über ein Fenster berechnet, das um ein Schiebeintervall voranschreitet. Ein gleitendes Fenster kann entweder eine feste Dauer oder eine Lebensdauer haben. Fenster mit fester Dauer überlappen sich, sodass jedes Quellereignis zur Feature-Aggregation für mehrere Fenster beitragen kann. Ein Lebenszeitfenster umfasst alle Quellereignisse vor dem Ende des Fensters. Features zur zeitaggregatieren t Daten von Fenstern, die auf oder vor t (exklusiv) enden. Windows sind auf die Unix-Epoche ausgerichtet.
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
In der folgenden Tabelle sind die Parameter für ein Gleitfenster aufgeführt.
| Parameter | Constraints |
|---|---|
window_duration |
Muss für ein Fenster mit fester Dauer positiv sein. Auf ein lebenslanges Zeitfenster eingestellt None . |
slide_duration |
Muss positiv sein. Für ein Fenster mit fester Dauer muss es außerdem kürzer als window_durationsein. |
delay (optional) |
Muss ≥ 0 sein. Verschiebt das analytische Fenster rückwärts vom Bewertungszeitstempel. |
offset (optional) |
Muss ≥ 0 sein und kürzer als slide_duration. Verschiebt die Fenstergrenzen ab Mitternacht UTC. |
start_time (optional) |
Früheste Ereigniszeitgrenze, an der das Merkmal eine Ausgabe emittieren kann. |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Beispiel für gleitendes Fenster
-
window_duration=timedelta(days=5), slide_duration=timedelta(days=1): Dies erzeugt überlappende 5-Tage-Fenster, die jeweils um einen Tag voranschreiten. Beispiel: Fenster Nr. 1 erstreckt sich über Tag 0 bis Tag 4, Fenster #2 erstreckt sich über Tag 1 bis Tag 5, Fenster #3 erstreckt sich über Tag 2 bis Tag 6 usw. Jedes Fenster enthält Ereignisse vom00:00:00.00Starttag bis zum (aber nicht einschließlich)00:00:00.00am Endtag. Da sich Fenster überlappen, kann ein einzelnes Ereignis zu mehreren Fenstern gehören (in diesem Beispiel gehört jedes Ereignis zu bis zu 5 verschiedenen Fenstern).
Lebenszeitfenster
Stellen Sie ein, window_duration=None um ein Lebenszeitfenster zu erstellen. An jeder Rutschgrenze aggregiert das Merkmal alle Quellereignisse der Entität mit Zeitstempeln vor dieser Grenze. Zum Beispiel erzeugt eine Ein-Tages-Folie einmal pro Tag einen kumulativen Wert.
Lebenszeitfenster werden nur von SlidingWindowunterstützt.
RollingWindow und TumblingWindow erfordern ein endliches window_duration.
Note
Lebenszeitfenster erfordern eine databricks-feature-engineering Client-Version, die Workspace-Enablement unterstützt window_duration=None . Frühere Client-Versionen unterstützen diese Syntax nicht.
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
Sägezahnfenster
Ein Sägezahnfenster ist eine Aggregation, die hochgradig aktuelle Updates aktueller Ereignisse zusammen mit der täglichen Verdichtung historischer Daten unterstützt. Seine hintere (ältere) Kante schreitet in festen, täglichen Schritten voran, während die vordere (jüngste) Kante mit den neuesten Ereignissen aktuell bleibt, sodass die effektive Fensterlänge im Laufe des Tages "sägt". Der Großteil des Fensters wird aus Daten in der Aufnahmetabelle des Streams bereitgestellt, und nur die beiden letzten Tage stammen aus dem Live-Stream. Dies ist ein Kompromiss, der langfristige Fenster effizient berechnet (auf Jahre skalierend) und gleichzeitig auf frische Updates reagiert.
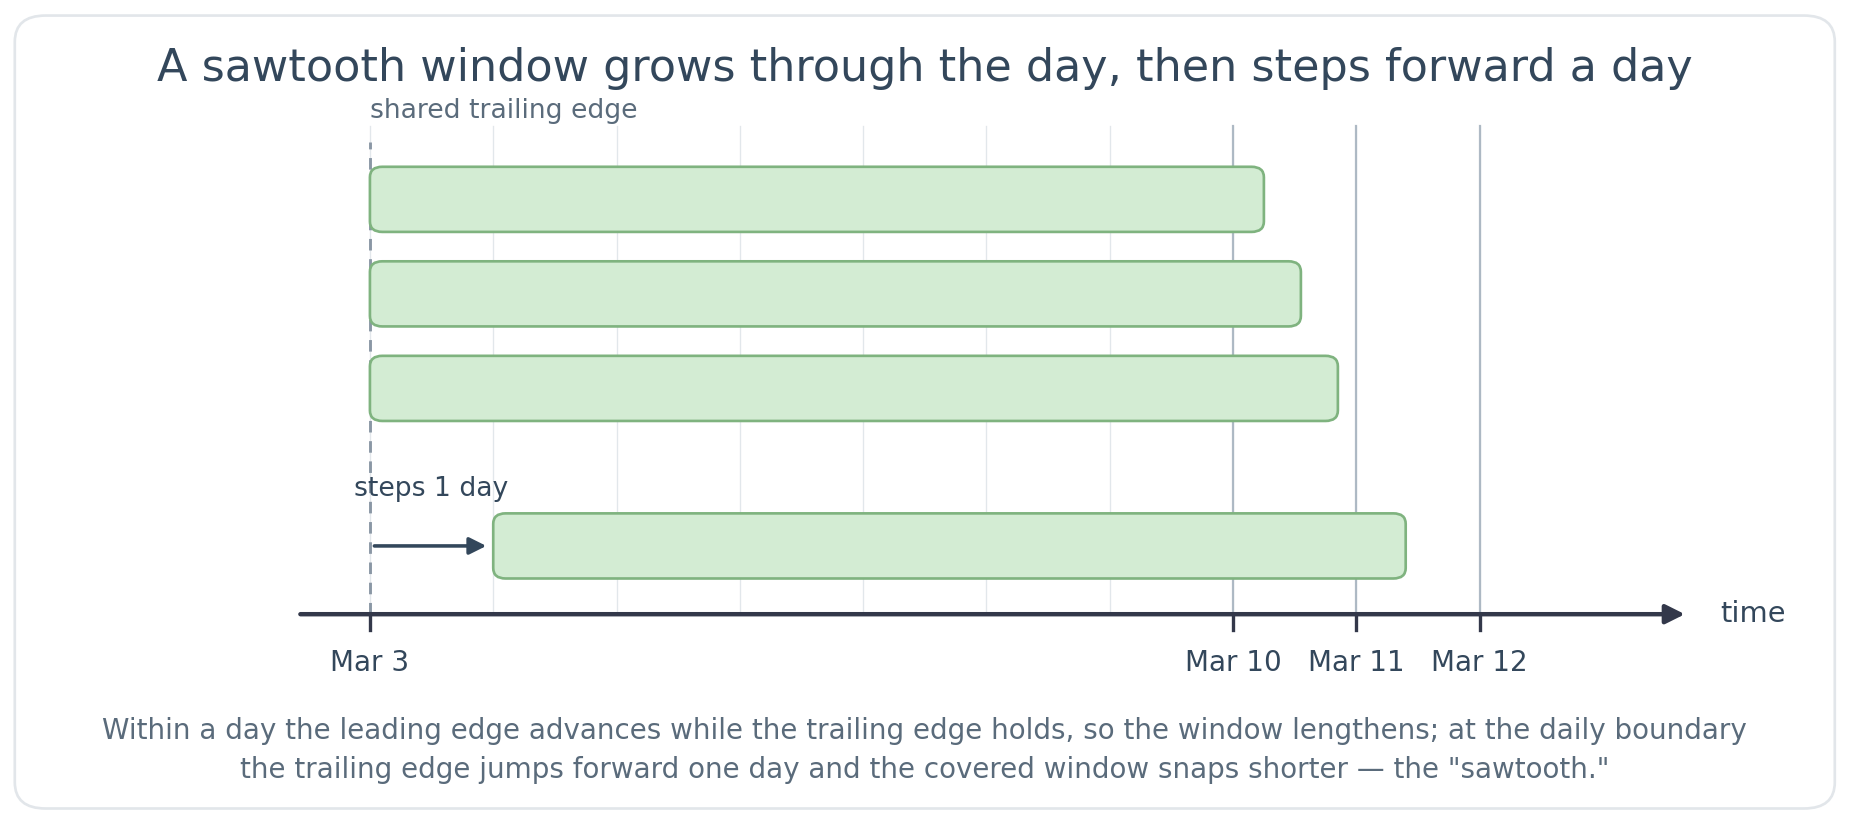
Sägezahnfenster entstehen auf einem hybriden Batch- und Strömungspfad. Eine Batch-Pipeline hält den Großteil des Fensters aufrecht, während eine Streaming-Pipeline die aktuellsten Daten in Echtzeit frisch hält. Die beiden werden beim Lesen zusammengeführt, sodass es für das Modell oder den Kunden eine einzige Funktion ist.
Da der historische Teil des Fensters durch die Batch-Pipeline berechnet wird, ist ein Sägezahn-Feature kurz nach Materialisierungsbeginn einsatzbereit, selbst wenn das Fenster Monate oder Jahre umfasst. Ein rollendes Fenster ist erst fertig, wenn die volle Fensterdauer abgelaufen ist. Das Minimum window_duration muss länger als zwei Tage sein (die vorgeschriebene untere Grenze). Databricks empfiehlt ein Sägezahnfenster für längere Dauern als 7 Tage. Bei Fenstern, die länger als zwei Tage und bis zu sieben Tagen sind, wählen Sie zwischen der festen Genauigkeit eines Rollfensters und der schnelleren Produktionsbereitschaft eines Sägezahnfensters.
Note
Ein Sägezahn-Merkmal beruht auf bereits vorhandener Geschichte. Die Aufnahmetabelle des Stroms muss Daten enthalten, die mindestens die gesamte Fensterdauer abdecken, sonst ist das berechnete Fenster unvollständig. Wenn nicht, setze start_time den frühesten Zeitpunkt, an dem du möchtest, dass das Feature Werte ausliefert, spätestens zum Zeitpunkt der Erstellung. Werte ab start_time diesem Zeitpunkt decken die verfügbare Geschichte ab. Bevor zwei volle Tage vergangen sind, spiegelt die Funktion nur die bisher materialisierten Daten wider. Zeigen Sie den Film erst nach zwei vollen Tagen in Produktion. Eine Aggregation über einem leeren Fenster gibt 0 für Sum und Count, und null für Avg, Min, , FirstMax, Last, VarPop, VarSamp, StddevPop, und StddevSampzurück.
Um festzustellen, ob ein Sägezahn-Feature bereit ist, öffnen Sie die Feature-Ansicht im Katalog-Explorer. Im Bereich Materialisierte Merkmale ist das Batch-Backfill abgeschlossen, sobald die letzte Materialisierungszeit des Features voranschreitet und sein Status Erfolg zeigt. Der Strömungsteil wird durch eine deklarative Lakeflow-Pipeline materialisiert. Nachdem die Feature View die Validierung bestanden hat, wird das materialisierte Feature mit dieser Pipeline verknüpft, wo man den Laufstatus überwachen kann.
Sägezahnfenster benötigen ein StreamSource und werden mit StreamingMode.
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
    start_time: Optional[datetime.datetime] = None
Die Kanten eines Sägezahnfensters bewegen sich anders als die eines rollenden Fensters: Die Vorderkante verfolgt das neueste Ereignis, während die Hinterkante einmal pro Tag statt kontinuierlich vorrückt. Jeden Tag an einem festen Cutoff um 18:00 UTC tritt die hintere Kante zur UTC-Mitternachtsgrenze des Tages vor. Dadurch ist das effektive Zeitfenster etwas länger window_duration und wächst über den Tag hinweg, bevor es an einem Tag beim nächsten Cutoff wieder zurückspringt. Training und Serving verwenden die gleiche 18:00 UTC-Grenze, sodass Offline-Training und Online-Dienst konstant bleiben.
| Parameter | Constraints |
|---|---|
window_duration |
Muss länger als zwei Tage sein. Eine Dauer, die nicht eine ganze Anzahl von Tagen beträgt (zum Beispiel timedelta(days=3, minutes=15)), ist erlaubt, aber das Fenster wird weiterhin täglich granularisiert. |
start_time (optional) |
Es darf nicht später als die Zeit der Feature-Erstellung sein. |
Setzen start_time Sie, wenn die Aufnahmetabelle des Streams weniger Geschichte als window_durationenthält. Ohne sie wartet die Batch-Pipeline, bis ein vollständiges Fenster der Geschichte existiert. Stellen Sie es auf den frühesten Zeitpunkt ein, zu dem Sie möchten, dass die Funktion Werte bedient. Der Wert hängt nicht von den bereits im Fenster gespeicherten Daten ab. Das Feature liefert von nun an Teilfensterwerte start_time und erreicht die volle Fenster-Dauer, nachdem genügend Geschichte angesammelt ist.
Man kann die Sägezahnfenster start_time nicht später als den Zeitpunkt der Erstellung des Features einstellen.
start_time Gates nur den Batch-Teil des Fensters, sodass ein späterer Wert erlaubt, dass der Streaming-Teil Werte vor start_time.
Sägezahnfenster unterstützen die Sum, Avg, Count, Min, Max, First, Last, LastDistinctVarPopStddevPopFirstDistinctLastNVarSampFirstNundStddevSamp die Aggregationsfunktionen.
Beispiel mit einem Sägezahnfenster
Das folgende Beispiel zeigt eine 7-tägige Zählung der Transaktionen eines Nutzers. Die Spitze verfolgt das aktuelle Ereignis, während die Hinterkante Tag für Tag vorwärts tritt. Für Veranstaltungen am 10. März reicht das Zeitfenster etwa bis zum 3. März zurück. Im Verlauf des 10. März rückt die Vorderkante weiter vor, während die Hinterkante hält, sodass die überdachte Spannweite wächst. Dann, zu Beginn des 11. März, steigt die Hinterkante etwa auf den 4. März an. Das effektive Zeitfenster ist immer etwas länger als sieben Tage. Die beiden letzten Tage werden vom Live-Stream bedient, die ersten Tage vom Aufnahmetisch des Streams.
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
Das folgende Beispiel ist eine 365-Tage-Summe über einer Aufnahmetabelle, deren Daten am 1. Januar 2026 beginnen. Mit start_time der Einstellung zum 1. Januar 2026 bedient das Feature Teilfensterwerte ab diesem Tag und deckt ein ganzes Jahr ab dem 1. Januar 2027 ab:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SawtoothWindow

window = SawtoothWindow(
    window_duration=timedelta(days=365),
    start_time=datetime(2026, 1, 1),
)
Grenzen von Sägezahnfenstern
- Der
delayParameter wird nicht unterstützt. -
SourceLateness.settling_delaywird nicht unterstützt. - Du kannst keinen
start_timespäteren Zeitpunkt als die Erstellung der Funktion festlegen. - Aggregationsfunktionen außer , , , , ,
FirstMax, ,Last,LastNFirstN,LastDistinctVarSampFirstDistinctStddevPopVarPopundStddevSampwerden nicht unterstützt (zum BeispielApproxCountDistinctund ).ApproxPercentileMinCountAvgSum - Sägezahnfenster benötigen ein
StreamSource. ADeltaTableSourcewird nicht unterstützt.
Materialisierungsauslöser
Löst die Steuerung aus, wenn eine Materialisierungspipeline ausgeführt wird. Der Triggertyp hängt vom Featuretyp ab.
CronSchedule
Verwendung CronSchedule für Batch-Aggregationsfunktionen. Standardmäßig leitet Azure Databricks einen Zeitplan aus dem Aggregationsfenster ab. Ein abgeleiteter Zeitplan berücksichtigt die Fensterperiode, das Fenster delay und offset, sowie die Quelle, settling_delay sodass ein Lauf kein Fenster veröffentlicht, bevor die Quelldaten voraussichtlich vollständig sind. Abgeleitete Zeitpläne unterstützen Tumbling und Sliding Windows.
Um einen abgeleiteten Zeitplan anzufordern, lassen Sie den cron-Ausdruck weg.
CronSchedule() und die explizite CronSchedule(mode=CronScheduleMode.DERIVED) Form sind äquivalent:
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
Setzen quartz_cron_expression Sie nicht mit CronScheduleMode.DERIVED. Wenn Sie die materialisierte Funktion abrufen, kann der zurückgegebene Zeitplan den von Azure Databricks berechneten Cron-Ausdruck enthalten.
Um den Zeitplan direkt zu steuern, bereite einen Quarz-Cron-Ausdruck an.
CronScheduleMode.MANUAL wird abgeleitet, wenn man einen Ausdruck angibt:
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
Verwendung TableTrigger für ColumnSelection Features oder Aggregationsfeatures (AggregationFunction), die von einem DeltaTableSource oder einem gestützt SdpSourcewerden. Für ein DeltaTableSourceläuft die Pipeline immer dann, wenn die upstream-Delta-Tabelle einen neuen Commit erhält.
Bei Aggregationsfunktionen wird die Pipeline gedrosselt, sodass sie nicht bei jedem Commit läuft. Standardmäßig beträgt die Zeit zwischen den Durchläufen mindestens die Hälfte der Fensterlänge des Features (die slide_duration eines Schiebefensters oder eines window_duration Tumbling-Fensters), gehalten zwischen 5 Minuten und 1 Stunde. Zum Beispiel läuft ein Feature mit einem Drehfenster von einer Stunde höchstens alle 30 Minuten, und ein Feature mit 8-Stunden-Fenster höchstens alle Stunde. Legen Sie min_time_between_triggersfest, um dies zu ändern. Der 5-Minuten-Floor gilt, wenn die Hälfte des Fensters kleiner ist, also werden Fenster, die 10 Minuten oder weniger dauern, höchstens alle 5 Minuten verlaufen. Aggregationsfunktionen mit einem Fenster unter 5 Minuten können nicht verwendet TableTriggerwerden, verwenden Sie stattdessen einen Streaming-Trigger.
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
Für Features, die von einem gestützt werden SdpSource, beobachtet die TableTrigger Quellen statt der Ausgabetabelle input_tables . Funktionen auf derselben Ausgabetabelle und im selben Trigger, die du in einem Anruf materialisierst, teilen sich einen Job, der alle input_tables überwacht, insgesamt bis zu 25 Tabellen. Um mehr als 10 Tabellen zu überwachen, aktivieren Sie Dateiereignisse auf jeder beobachteten Tabelle. Sieh dir an, wie Tabellen zum Trigger-Limit zählen. Jeder Lauf aktualisiert die Pipeline, bevor die Features materialisiert werden.
Um zu steuern, wann die Läufe starten, setzen Sie die folgenden optionalen Parameter:
TableTrigger(
    min_time_between_triggers: Optional[timedelta] = None,     # Optional: Shortest gap between two runs
    wait_after_last_change: Optional[timedelta] = None,        # Optional: Quiet period after the last update before a run starts
    condition: Optional[TableTriggerCondition] = None,         # Optional: Which table updates start a run
)
-
min_time_between_triggers: Die kürzeste erlaubte Zeit zwischen zwei Runs. Muss mindestens 5 Minuten dauern. Wenn nicht gesetzt, verwenden Schiebefensterfunktionen die Hälfte derslide_duration, und Tumbling-Fenster-Funktionen die Hälfte derwindow_duration, die zwischen 5 Minuten und 1 Stunde gehalten werden. Andere Merkmale haben kein Minimum. -
wait_after_last_change: Wie lange müssen die Quellcodetabellen ohne Update auskommen, bevor ein Durchlauf beginnt, damit zuerst eine Reihe von Updates erfolgt. Muss null oder mindestens 60 Sekunden sein. Wenn nicht gesetzt oder null, beginnt ein Run, sobald eine Quelltabelle aktualisiert wird. -
condition:TableTriggerCondition.TABLE_TRIGGER_CONDITION_ANY_UPDATED(der Standard) startet einen Run, sobald eine Quelltabelle aktualisiert wird.TableTriggerCondition.TABLE_TRIGGER_CONDITION_ALL_UPDATEDstartet einen Run erst, nachdem jede Quelltabelle aktualisiert wurde.
Das folgende Beispiel wartet, bis alle Eingabetabellen aktualisiert sind, dann 10 Minuten auf weitere Updates und läuft höchstens stündlich:
from datetime import timedelta
from databricks.feature_engineering.entities import TableTrigger, TableTriggerCondition

trigger = TableTrigger(
    condition=TableTriggerCondition.TABLE_TRIGGER_CONDITION_ALL_UPDATED,
    wait_after_last_change=timedelta(minutes=10),
    min_time_between_triggers=timedelta(hours=1),
)
StreamingMode
Verwenden StreamingMode Sie es, um Funktionen mit einer kontinuierlichen strukturierten Streaming-Pipeline zu berechnen, die Ergebnisse direkt in den Online-Shop schreibt. Sie ist für Funktionen erforderlich, die von einem gestützt werden StreamSource, und Sie können sie auch für Funktionen verwenden, die von einem gestützt werden DeltaTableSource.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
Stream aus einem DeltaTableSource
Wenn du eine Funktion übergibst StreamingMode() , die von einer gestützt wird DeltaTableSource, liest die Pipeline den Änderungsdatenfeed der Tabelle als Streaming-Quelle, anstatt als geplanten Batch-Job auszuführen. Es läuft im Micro-Batch-Modus, der neue Comits in kleinen Chargen verarbeitet. Ein Beispiel finden Sie unter Definiere eine Streaming-Funktion mit DeltaTableSource.
Folgende Anforderungen und Verhaltensweisen gelten:
- Die Quelltabelle muss den Wechseldatenfeed aktiviert haben (
delta.enableChangeDataFeed = true). Die Pipeline prüft diese Eigenschaft beim Start und scheitert, wenn sie nicht gesetzt ist. -
ColumnSelectionFunktionen und Aggregationsfunktionen, die ARollingWindowmit Awindow_durationverwenden, werden unterstützt. Roll-, Schieb- und Sägezahnfenster werden für Streaming-FunktionenDeltaTableSourcenicht unterstützt. - Die Materialisierung beginnt mit der neuesten Version der Tabelle und verarbeitet keine bereits vorhandenen Zeilen in der Tabelle. Bis ein vollständiges Fenster mit neuen Daten eintrifft,
RollingWindowspiegeln die Werte nur die Daten wider, die nach Beginn der Pipeline verpflichtet wurden. - Eingefügte und aktualisierte Zeilen tragen zu Feature-Werten bei. Das Löschen von Zeilen aus der Quelltabelle entfernt sie nicht aus bereits aggregierten Werten.
- Sie müssen eine
online_configangeben. Streaming-Funktionen erscheinen ausschließlich im Online-Shop.
Auswählen eines Triggers
Jede Funktion verwendet einen Trigger; Die Optionen nach Funktionstyp sind:
| Featuretyp | Trigger | Wenn es ausgeführt wird |
|---|---|---|
Aggregation (AggregationFunction) von DeltaTableSource |
CronSchedule |
Nach einem abgeleiteten oder manuellen Zeitplan |
Aggregation (AggregationFunction) von DeltaTableSource |
TableTrigger |
Bei jedem Quelltabellen-Commit |
ColumnSelection (von DeltaTableSource) |
TableTrigger |
Bei jedem Quelltabellen-Commit |
Aggregation (AggregationFunction) von SdpSource |
CronSchedule |
Nach einem abgeleiteten oder manuellen Zeitplan |
Aggregation oder ColumnSelection aus SdpSource |
TableTrigger |
Über Updates zu input_tables |
Features von StreamSource |
StreamingMode |
Kontinuierliches Streaming |
RollingWindow Aggregation oder ColumnSelection aus DeltaTableSource |
StreamingMode |
Kontinuierliches Streaming (Mikrobatch) |
Ein Aufruf materialize_features kann Batch-Funktionen mit verschiedenen Triggern SdpSource sowie DeltaTableSource Features und SdpSource Features aus verschiedenen Pipelines enthalten. Jede Quelle, jede Pipeline und jeder Zeitplan hat ihren eigenen Job. Funktionen, die verwendet StreamingMode werden, benötigen einen separaten Aufruf.