Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Die Materialisierung für metrische Ansichten beschleunigt Abfragen mithilfe materialisierter Ansichten zur Vorberechnung von Aggregationen. Lakeflow-Pipelines orchestrieren benutzerdefinierte materialisierte Ansichten für eine gegebene Metrikansicht. Zur Abfragezeit leitet der Abfrageoptimierer Abfragen mithilfe des automatischen aggregatfähigen Abfrageabgleichs (Abfrageumschreibung) an die beste materialisierte Sicht weiter. Sie fragen die Metrikansicht wie gewohnt ohne zusätzlichen manuellen Aufwand ab. Databricks aktualisiert die Materialisierungen, um sie auf dem neuesten Stand zu halten. Außerdem wählt es aus, welche Materialisierung für schnellere Abfragen bei geringeren Kosten verwendet wird.
Funktionsweise der Materialisierung
Die Materialisierung für metrische Ansichten umfasst zwei Phasen: Definieren der Materialisierung und Ausführen von Abfragen.
Definitionsphase
Wenn Sie eine Metrikansicht mit Materialisierung definieren, geben Sie Ihre Felder, Measures und Aktualisierungszeitpläne in der Metrikansicht YAML an. Mit dieser Definition erstellt Databricks eine verwaltete Lakeflow-Pipeline , die die materialisierten Ansichten erstellt und verwaltet.
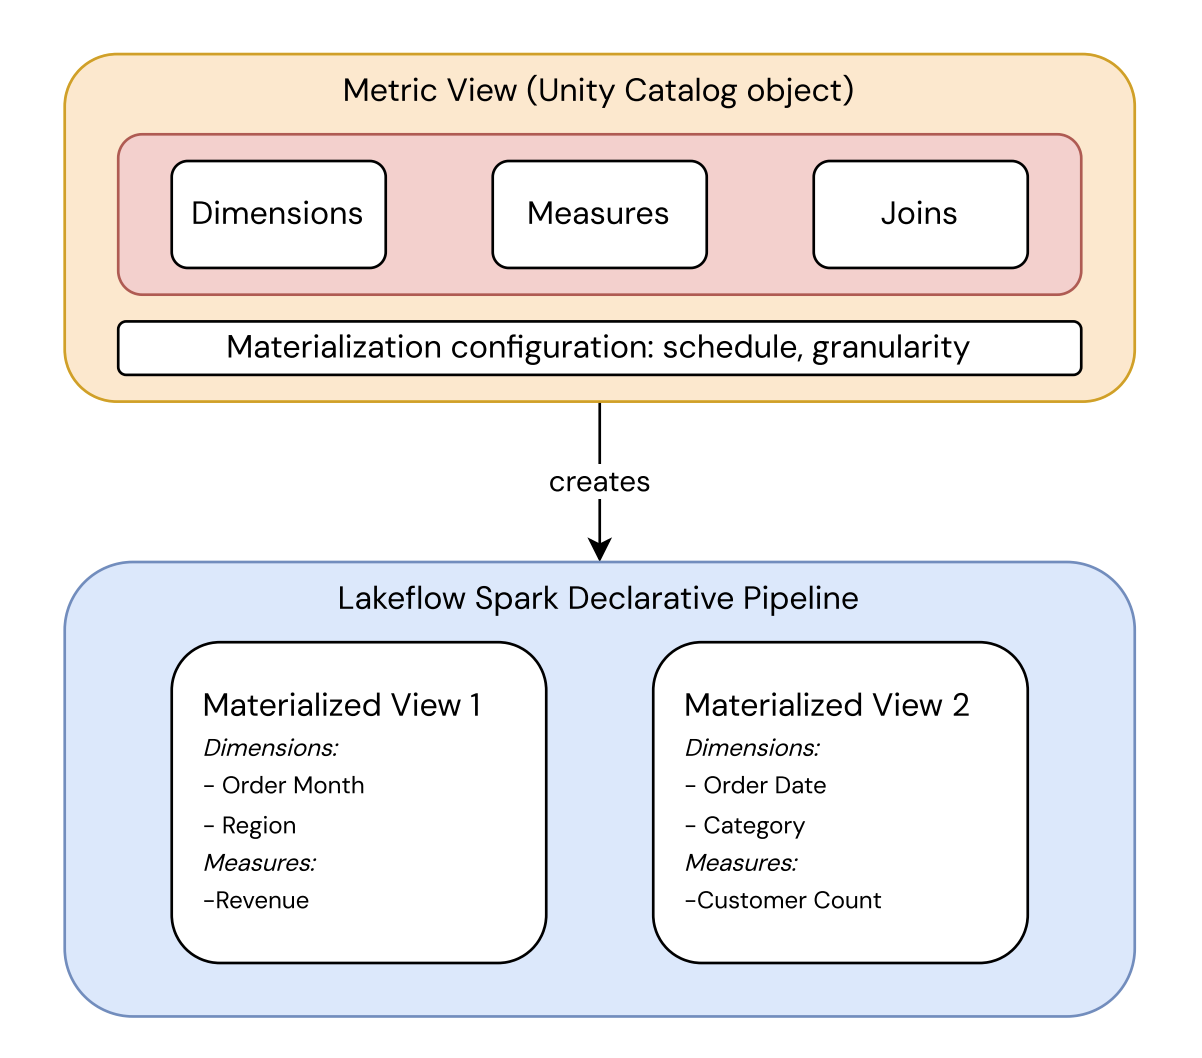
Dadurch bleibt die Definition der Metrik davon getrennt, wie sie gespeichert wird:
- Die Metrik-Ansicht ist ein Unity Catalog-Objekt, das die Felder, Maße und Joins der Metrik zusammen mit der Materialisierungskonfiguration (Plan und Granularität) definiert. Es ist die einzige Quelle der Wahrheit für das, was die Metrik bedeutet.
- Die Pipeline materialisiert diese Definition in eine oder mehrere materialisierte Ansichten, die jeweils mit einer bestimmten Granularität vorberechnet wurden. Databricks wählt aus, welcher zur Abfragezeit gelesen werden soll.
Abfrageausführung
Wenn Sie SELECT ... FROM <metric_view> ausführen, verwendet der Abfrageoptimierer die aggregatbasierte Abfrageüberschreibung, um die Leistung zu optimieren.
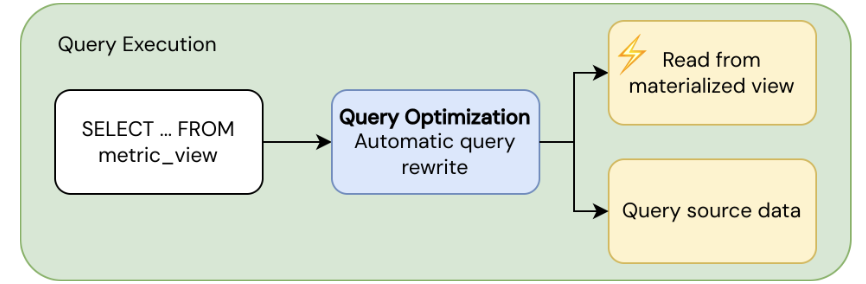
- Schneller Pfad: Liest aus vorab berechneten materialisierten Ansichten, wenn eine geeignete Materialisierung existiert.
- Rückfallpfad: Liest direkt aus den Quelldaten, wenn keine geeignete Materialisierung verfügbar ist.
Der Abfrageoptimierer gleicht die Leistung und Aktualität automatisch aus, indem zwischen materialisierten und Quelldaten ausgewählt wird. Sie erhalten unabhängig davon, welchen Pfad der Optimierer verwendet, transparent Ergebnisse. Weitere Informationen zum Ausführen von Abfragen für Metrikansichten finden Sie unter Abfragemetrikansichten.
Note
Beziehungen zwischen Metrikansichten sind nur Metadaten und beeinflussen die Materialisierung nicht. Konfigurieren Sie die Materialisierung auf jeder Metrikansicht, die Sie beschleunigen möchten. Siehe Beziehungen und Abfrageleistung.
Anforderungen
So verwenden Sie die Materialisierung für Metrikansichten:
- Dein Arbeitsbereich muss die serverlose Rechenleistung aktiviert haben, um Lakeflow-Pipelines auszuführen.
- Ein SQL Warehouse oder eine Computeressource mit Databricks Runtime 17.3 oder höher. Metrikansichten ohne Materialisierung werden ab Databricks Runtime 16.4 unterstützt. Die Mindestlaufzeit für jedes Feature finden Sie unter Verfügbarkeit der Metrikansichtsfeatures.
Important
Man kann keine Metrik-Ansicht materialisieren, wenn die Ansicht oder eine beliebige ihrer Quelltabellen Sicherheit auf Zeilenebene (RLS), Spaltenmasken oder attributbasierte Zugriffskontrollrichtlinien (ABAC) verwendet. Da eine Materialisierung einmal vorab unter Verwendung der Identität des Besitzers berechnet wird, würde die Bereitstellung an andere Benutzer die benutzerspezifischen Zugriffskontrollen umgehen, die diese Funktionen zur Abfragezeit durchsetzen. Weitere Informationen finden Sie unter Modus für die Abfrageumschreibung.
Konfigurationsreferenz
Sie konfigurieren die Materialisierung in einem Feld auf oberster Ebene materialization in der YAML-Definition der Metrikansicht. Dieses Feld legt die Abfrageumschreibung mode (immer relaxed), eine optionale Aktualisierung schedule und eine Liste von materialized_views, die beibehalten werden sollen, fest. Jede materialisierte Ansicht ist entweder aggregated, die bestimmte Dimensionen und Measures vorab berechnet, oder unaggregated, die das vollständige Datenmodell materialisiert.
Die vollständige Feld-nach-Feld-Spezifikation, einschließlich erforderlicher und optionaler Felder, zulässiger Werte und der schedule Klauseleinschränkungen, finden Sie unter Materialization.
Beispieldefinition
Im folgenden Beispiel wird eine Metrikansicht mit einer nicht aggregierten und zwei aggregierten Materialisierungen definiert:
version: 1.1

source: prod.operations.orders_enriched_view

filter: revenue > 0

fields:
  - name: category
    expr: substring(category, 5)

  - name: color
    expr: color

measures:
  - name: total_revenue
    expr: SUM(revenue)

  - name: number_of_suppliers
    expr: COUNT(DISTINCT supplier_id)

materialization:
  schedule: every 6 hours
  mode: relaxed

  materialized_views:
    - name: baseline
      type: unaggregated

    - name: revenue_breakdown
      type: aggregated
      dimensions:
        - category
        - color
      measures:
        - total_revenue
      cluster_by:
        cols:
          - category
          - color

    - name: suppliers_by_category
      type: aggregated
      dimensions:
        - category
      measures:
        - number_of_suppliers
Note
Der materialization-Block verwendet das Schlüsselwort dimensions:, um Felder aufzulisten, die materialisiert werden sollen, obwohl die Definition auf oberster Ebene fields: verwendet. Die beiden Schlüsselwörter sind gleichwertig. Siehe Felder.
Die revenue_breakdown Materialisierung wird verwendet cluster_by , um zu steuern, wie die materialisierten Daten physisch angeordnet werden, ähnlich wie die CLUSTER BY Klausel bei einer materialisierten Ansicht. Du kannst stattdessen partition_by verwenden, aber nicht zusammen mit cluster_by, da flüssiges Clustering nicht mit Partitionierung kombiniert werden kann. Die vollständige Feldspezifikation finden Sie unter Materialisierung.
Erstellen Sie die Metrikansicht mit SQL
Um diese Metrikansicht außerhalb des Katalog-Explorers zu erstellen, schließen Sie das YAML in CREATE OR REPLACE VIEW ... WITH METRICS LANGUAGE YAML AS ein und platzieren Sie die Definition zwischen den Trennzeichen $$:
CREATE OR REPLACE VIEW catalog.schema.orders_materialized WITH METRICS LANGUAGE YAML AS
$$
  version: 1.1

  source: prod.operations.orders_enriched_view

  filter: revenue > 0

  dimensions:
    - name: category
      expr: substring(category, 5)

    - name: color
      expr: color

  measures:
    - name: total_revenue
      expr: SUM(revenue)

    - name: number_of_suppliers
      expr: COUNT(DISTINCT supplier_id)

  materialization:
    schedule: every 6 hours
    mode: relaxed

    materialized_views:
      - name: baseline
        type: unaggregated

      - name: revenue_breakdown
        type: aggregated
        dimensions:
          - category
          - color
        measures:
          - total_revenue

      - name: suppliers_by_category
        type: aggregated
        dimensions:
          - category
        measures:
          - number_of_suppliers
$$
Joker-Kurzform für Dimensionen und Maße
Für type: aggregated materialisierte Ansichten verwenden Sie einen Wildcard-Ausdruck als alleiniges Element einer dimensions- oder measures-Liste, anstatt jeden Namen aufzuzählen.
-
"*"wählt alle deklarierten Dimensionen oder Maße in der metrischen Ansicht aus. -
"* EXCEPT (name1, name2, ...)"wählt alle außer den benannten Elementen aus.
Der Wildcard-Wert muss in YAML in Anführungszeichen gesetzt werden. Bare * ist ein YAML-Ankerreferenzzeichen und verursacht einen Parsefehler.
Der Platzhalter muss das einzige Element in seiner Liste sein. Das Schreiben von ["*", "region"] ist ein Validierungsfehler. Um alles außer einem kleinen Set auszuwählen, verwenden Sie "* EXCEPT (region)" stattdessen.
Wildcards erweitern sich dynamisch bei jedem Pipeline-Refresh, nicht zu dem Zeitpunkt, an dem du die Metrikansicht erstellst oder änderst. Wenn Sie eine neue Dimension oder Maßgröße zur Metrikansicht hinzufügen, wird sie bei der nächsten Aktualisierung der Pipeline automatisch in jede Materialisierung aufgenommen, die "*" verwendet, ohne dass ein ALTER erforderlich ist.
Das folgende Beispiel verwendet Wildcards über mehrere materialisierte Ansichten in derselben Metrikansicht:
materialization:
  schedule: every 6 hours
  mode: relaxed
  materialized_views:
    # All dimensions and all measures
    - name: full_coverage
      type: aggregated
      dimensions:
        - '*'
      measures:
        - '*'

    # All dimensions, specific measures only
    - name: revenue_only
      type: aggregated
      dimensions:
        - '*'
      measures:
        - total_revenue
        - order_count

    # Named dimensions, all measures except one
    - name: category_most_measures
      type: aggregated
      dimensions:
        - category
      measures:
        - '* EXCEPT (expensive_computed_measure)'
Note
Namen in EXCEPT (...) müssen mit deklarierten Dimensions- oder Maßnamen übereinstimmen. Unbekannte Namen verursachen zur Zeit von CREATE oder ALTER einen Validierungsfehler.
Wenn eine Wildcard auf null Namen erweitert wird (zum Beispiel measures: ["*"] in einer Metrikansicht ohne definierte Messgrößen), gibt Databricks einen Validierungsfehler zurück, wenn Sie die Metrikansicht erstellen oder verändern.
Abfrageumschreibungsmodus
Im Modus relaxed überprüft die automatische Abfrageumschreibung nur, ob infrage kommende materialisierte Sichten über die erforderlichen Felder und Measures verfügen, um die Abfrage zu bedienen.
Die folgenden Prüfungen werden übersprungen:
- Freshness: Es bestätigt nicht, ob die Materialisierung aktuell ist.
-
SQL-Einstellungen: Es wird nicht überprüft, ob Einstellungen wie
TIMEZONEoderANSI_MODEübereinstimmen. - Determinismus: Es überprüft nicht, dass die materialisierten Ergebnisse vollständig deterministisch sind.
Abfragen, die mit einer Materialisierung übereinstimmen, greifen auf den letzten Aktualisierungsstand zurück. Abfragen, die nicht übereinstimmen, greifen auf die Quelldaten zurück und geben Live-Daten zurück. Daher kann die Aktualität der Daten variieren, je nachdem, ob eine Abfrage für die Neuschreibung qualifiziert ist. Um die Konsistenz zu überprüfen, stimmen Sie Ihren Zeitplan für die Aktualisierung der Materialisierung auf Ihre Quellpipeline ab. Wenn Ihre Quelle beispielsweise täglich mit einer Batchpipeline aktualisiert wird, planen Sie die Aktualisierung der Materialisierung so, dass sie nach Abschluss dieser Pipeline ausgeführt wird. Verwenden Sie alternativ eine nicht aggregierte Materialisierung, um sicherzustellen, dass alle Abfragen aus derselben Momentaufnahme gelesen werden.
Sie können keine Materialisierung erstellen, wenn die Metrikansicht oder eine der Quelltabellen folgendes verwendet:
- Sicherheitsrichtlinien auf Zeilenebene (RLS),Spalten-Maskierung (CLM) oder ABAC-Richtlinien. Vorab berechnete Ergebnisse können benutzerspezifische Zugriffskontrollen umgehen, die zur Abfragezeit erzwungen werden sollen.
- Aufruferabhängige Ausdrücke, deren Ergebnis sich danach richtet, wer die Abfrage ausführt (zum Beispiel
current_user()oderis_member()). Eine Materialisierung wird einmal vorkonfiguriert und freigegeben, sodass die Bereitstellung an einen anderen Benutzer falsche oder unsichere Ergebnisse zurückgibt.
Databricks überprüft diese Einschränkung, wenn Sie eine Materialisierung erstellen, ändern oder aktualisieren. Diese Vorgänge schlagen mit der Fehlerbedingung METRIC_VIEW_MATERIALIZATION_WITH_INVOKER_DEPENDENT_EXPRESSIONS_NOT_SUPPORTED (SQLSTATE 42K0E) fehl. Siehe METRIC_VIEW_MATERIALIZATION_WITH_INVOKER_DEPENDENT_EXPRESSIONS_NOT_SUPPORTED.
Arten von Materialisierungen für metrische Ansichten
In den folgenden Abschnitten werden die Für Metrikansichten verfügbaren Typen von materialisierten Ansichten erläutert und Anleitungen zum Auswählen der geeigneten Konfiguration für Ihre Datenquellen und Abfragemuster bereitgestellt.
Aggregierter Typ
Dieser Typ berechnet Aggregationen für angegebene Metrik- und Feldkombinationen im Voraus, um eine gezielte Abdeckung zu erreichen.
Verwenden Sie einen Aggregationstyp, wenn bestimmte Dimensions- und Kennzahlkombinationen häufig abgefragt werden. Bei aggregierten Materialisierungen gelten sowohl strategien für genaue Übereinstimmungen als auch Rollup-Übereinstimmungen , die die beste Abfrageleistung für diese Muster bieten.
Für optimale Aggregationen:
- Schließen Sie die am häufigsten verwendeten Dimensionen in
GROUP BYKlauseln ein. - Fügen Sie alle potenziellen Filterspalten hinzu (Spalten, die in
WHEREzum Abfragezeitpunkt verwendet werden). - Materialisieren Sie auf der detailliertesten Ebene, die Ihre Abfragen benötigen. Beispielsweise kann eine Materialisierung bei
(region, sku, event_day)allen folgenden Zwecken dienen:GROUP BY regionGROUP BY region, event_month-
GROUP BY skumitWHERE region = 'US'
- Vermeiden Sie zu fein aufgelöste Dimensionen, die überwiegend Gruppen mit nur einer Zeile erzeugen (z. B. einen unverarbeiteten Zeitstempel mit Millisekundengenauigkeit). Dies hat keinen Vorteil und überblasen Speicher.
- Achten Sie auf Maßnahmen, die nicht additiv sind. Nicht-additive Kennzahlen können nicht aus Teilergebnissen erneut aggregiert werden (z. B.
COUNT(DISTINCT),MEDIANund Perzentile) und erfordern eine exakte Übereinstimmung mit einer Materialisierung.
Eine einzelne Aggregation kann nur Abfragen bereitstellen, die ihren spezifischen Dimensionen (genaue Übereinstimmung) oder einer Teilmenge ihrer Dimensionen (Rollupübereinstimmung) entsprechen. Databricks empfiehlt das Erstellen mehrerer aggregierter Materialisierungen für verschiedene Abfrage-Shapes.
Nicht aggregierter Typ
Dieser Typ materialisiert das gesamte nicht aggregierte Datenmodell (die Felder source, joins, filter und fields) für eine umfassendere Abdeckung mit geringerem Leistungsaufwand im Vergleich zum aggregierten Typ.
Verwenden Sie einen nicht aggregierten Typ, wenn einer der folgenden Werte zutrifft:
- Ihre Metrikansicht umfasst teure Quelltransformationen oder Verknüpfungen.
- Abfragemuster sind unvorhersehbar oder vielfältig.
- Alle Benutzer, die die Metrikansicht abfragen, müssen die Konsistenz innerhalb der Daten sehen.
Bei nicht aggregierten Materialisierungen werden teure Quellsichten und Joins einmal bei der Aktualisierung und nicht bei jeder Abfrage berechnet. Wenn sowohl aggregierte als auch nicht aggregierte Materialisierungen vorhanden sind, berechnet Databricks die aggregierten Materialisierungen aus dem nicht aggregierten Material. Dadurch wird eine konsistente Momentaufnahme bereitgestellt und eine redundante Neukompilierung der Quelle vermieden. Eine nicht aggregierte Übereinstimmung ist unabhängig von der Abfragestruktur immer zulässig, vorbehaltlich der in Modus zur Abfrageumschreibung beschriebenen Einschränkungen.
Eine nicht aggregierte Materialisierung hilft nicht, wenn es sich bei der Quelle um einen direkten Tabellenverweis ohne selektiven Filter handelt. In diesem Fall hat es keinen Vorteil, die Quelle direkt zu abfragen.
Weitere Hinweise dazu, wie und wann diese Materialisierungstypen verwendet werden, finden Sie unter Einen Materialisierungstyp für Metrikansichten auswählen.
Automatische Abfragenneuschreibung
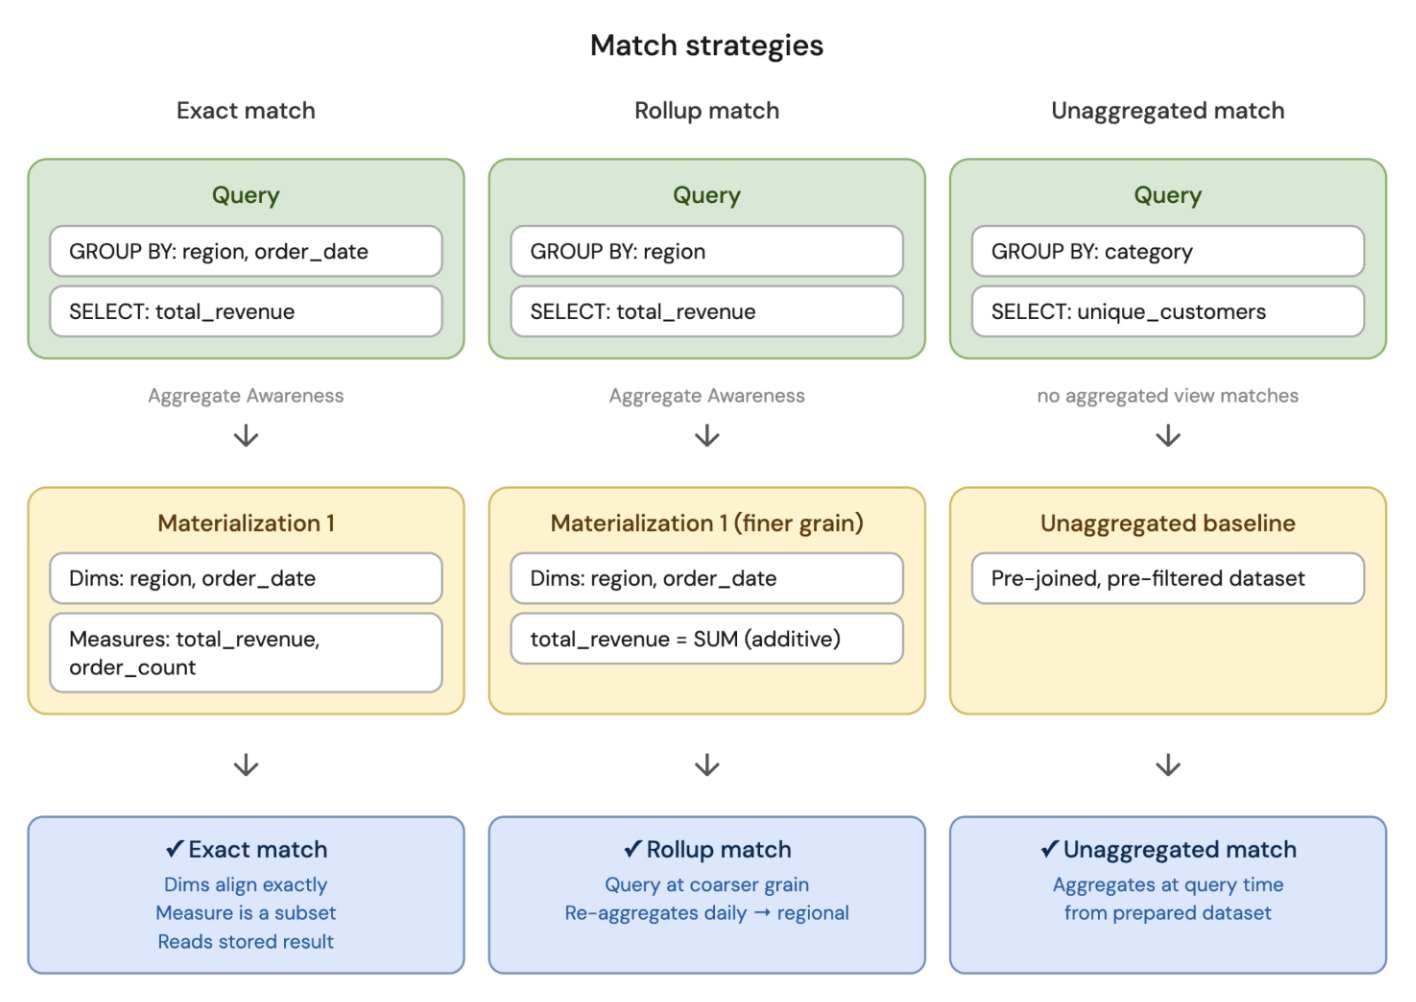
Wenn Sie eine Metrikansicht abfragen, leitet die Abfrageumschreibung Ihre Abfrage automatisch an die beste verfügbare Materialisierung weiter. Es verwendet drei Abfrageumschreibungsstrategien: genaue Übereinstimmung, Rollup-Übereinstimmung und nicht aggregierte Übereinstimmung.
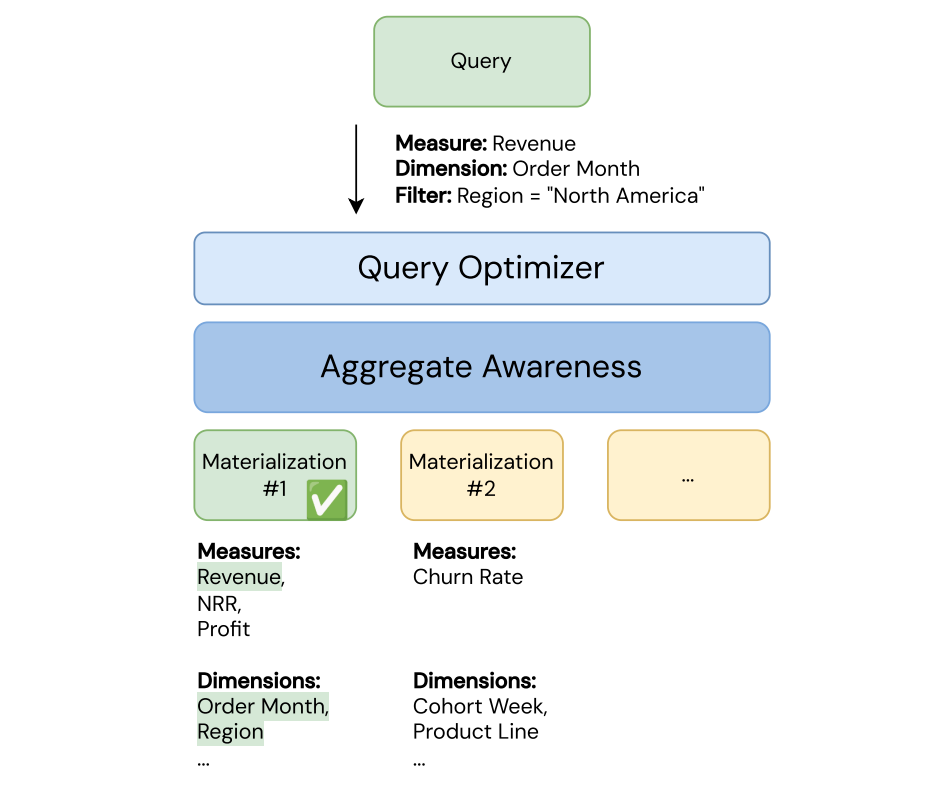
Die Abfrage wird automatisch für die beste Materialisierung anstelle der Basistabellen mit diesem Algorithmus ausgeführt:
- Zuerst versucht der Abfrageoptimierer eine genaue Übereinstimmung.
- Wenn es keine genaue Übereinstimmung gibt, versucht der Abfrageoptimierer eine Rollup-Übereinstimmung.
- Wenn keine Rollupübereinstimmung vorliegt und eine nicht aggregierte Materialisierung vorhanden ist, versucht der Abfrageoptimierer eine nicht aggregierte Übereinstimmung.
- Wenn keine nicht aggregierte Übereinstimmung vorhanden ist, liest die Abfrage direkt aus den Quelltabellen.
In den folgenden Abschnitten wird erläutert, wie jede Strategie funktioniert.
Note
Materialisierungen müssen die Materialisierung abschließen, bevor die Abfrageumschreibung wirksam werden kann.
Genaue Übereinstimmung
Die Abfrage fragt genau, was in der Materialisierung vorab berechnet wurde. Die Abfrage schreibt das gespeicherte Ergebnis ohne zusätzliche Arbeit um und ermöglicht schnelle Ergebnisse.
Voraussetzungen für eine genaue Übereinstimmung:
- Die Ausdrücke der
GROUP BYAbfrage müssen exakt den Materialisierungsdimensionen entsprechen. - Die Kennzahlen der Abfrage müssen eine Teilmenge der Kennzahlen der Materialisierung sein.
Beispielsweise verfügt eine Materialisierung über Dimensionen [region, order_date] und Maße [total_revenue, order_count]. Eine Abfrage, die nach region und order_date gruppiert und total_revenue abfragt, ist eine exakte Übereinstimmung, da die Dimensionen identisch sind und die Kennzahl vorab berechnet wurde.
Rollup-Übereinstimmung
Die Abfrage fordert eine Zusammenfassung auf einer groberen Ebene als das, was zuvor berechnet wurde. Der Optimierer liest das vorab berechnete Ergebnis und aggregiert es bis zur Ebene, die die Abfrage benötigt.
Voraussetzungen für eine Rollupübereinstimmung:
- Groberes Korn: Die Abfrage gruppiert nach weniger Dimensionen oder einer breiteren Zeitgranularität als die Materialisierung.
-
Alle Maße sind additiv: Jedes Maß, das Ihre Abfrage anfordert, muss eines sein, das durch Kombination von Teilergebnissen korrekt neu berechnet werden kann (zum Beispiel
SUMvonSUMs oderMAXvonMAXes).MEDIANKann nicht zusammengerollt werden, weil es von der Gruppenverteilung abhängt. -
Alle teilnehmenden Filter müssen deterministische Ausdrücke sein: Wenn Ihre Abfrage eine
WHEREKlausel enthält, muss der Filter immer dasselbe Ergebnis für dieselbe Eingabe liefern. Beispielsweise istWHERE region = 'US'deterministisch, Ausdrücke wierand()oderuuid()sind es jedoch nicht.
Die Rollupübereinstimmung ist für nicht additive Measures nicht zulässig, da sie aus Teilergebnissen nicht korrekt neu aggregiert werden können. Siehe Additive Maßnahmen.
Wenn Sie beispielsweise dieselbe Materialisierung mit den Dimensionen [region, order_date] und den Measures [total_revenue, order_count] verwenden, ist eine Abfrage, die nur nach region gruppiert und nach total_revenue fragt, eine Rollupübereinstimmung. Die Abfrage benötigt weniger Dimensionen als materialisiert wurden, sodass die Engine die Tagessummen zu Summen auf Regionsebene zusammenfasst.
Note
Der Rollup-Abgleich ist nicht verfügbar, wenn die Metrikansicht einen Join one_to_many verwendet. In diesem Fall fällt jede Materialisierung nur auf eine genaue Übereinstimmung zurück. Weitere Informationen zu Eins-zu-viele-Verknüpfungen finden Sie unter Eins-zu-viele-Verknüpfungen.
Additive Maßnahmen
Eine Kennzahl ist additiv, wenn ihr aggregiertes Ergebnis durch erneute Aggregation bereits vorhandener aggregierter Materialisierungen korrekt neu berechnet werden kann. Dies ist die Kernanforderung für den Rollupabgleich.
Jede Aggregation mit DISTINCT (zum Beispiel COUNT(DISTINCT), SUM(DISTINCT)) ist nicht additiv und kann nicht hochgerollt werden.
Die folgenden Funktionen sind additiv:
SUMCOUNTMINMAXBIT_ANDBIT_ORBIT_XORBOOL_ANDBOOL_OR
Zusätzliche Einschränkungen gelten für additive Maßnahmen:
- Die Measuredefinition muss genau eine Aggregatfunktion enthalten. Ein Maß, dessen Definition mehrere Aggregate kombiniert (zum Beispiel
sum(cost) + min(revenue)), ist nicht für den Rollupabgleich geeignet. - Wenn die Measuredefinition eine
FILTERKlausel enthält, muss sie deterministisch sein. - Das Measure darf kein Fenstermeasure sein (z. B. eine gleitende 7-Tage-Summe oder ein Jahresvergleich, der mit einem Fensterblock definiert ist).
Die folgende Tabelle fasst zusammen, welchen Übereinstimmungstypen gängige Übereinstimmungstypen zugeordnet sind:
| Messmuster | Übereinstimmungstyp | Grund |
|---|---|---|
Ein einzelnes additives Aggregat (SUM, COUNT, MIN, MAX) |
Rollup-fähig | Kann aus Teilergebnissen neu aggregiert werden |
COUNT(DISTINCT) oder ein anderes nicht-additives Aggregat |
Nur exakte Übereinstimmung | Kann nicht erneut aggregiert werden |
Mehrere Aggregate in einem Ausdruck (SUM(x) + MIN(y)) |
Nur exakte Übereinstimmung | Einzelne Aggregate können nicht für ein Rollup isoliert werden. |
Additives Aggregat mit deterministischer FILTER |
Rollup-fähig | Filter ist deterministisch, Aggregat ist additiv |
| Fenstermaß | Nur exakte Übereinstimmung | Der Fensterrahmen hängt von der genauen Körnung ab. |
Nicht aggregierte Übereinstimmung
Die Abfrage stimmt nicht mit einer vorab berechneten Aggregation überein, aber die teure Vorbereitung (Verknüpfungen und Filter) ist bereits abgeschlossen. Die Abfrageumschreibung beginnt mit dem vorbereiteten Dataset der nicht aggregierten Materialisierung, anstatt zu den Quelltabellen zurückzukehren.
Wenn eine nicht-aggregierte Materialisierung vorhanden ist, steht diese Strategie immer als Fallback zur Verfügung, bevor auf die Quelle zurückgegriffen wird. Jedes Abfrage-Shape kann es verwenden, vorbehaltlich der im Abfrageumschreibmodus beschriebenen Einschränkungen.
Ihre Abfrage gruppiert zum Beispiel nach category und fragt unique_customers ab, aber keine aggregierte Materialisierung umfasst diese Felder und Messwerte. Es existiert jedoch eine nicht aggregierte Materialisierung, bei der der verknüpfte, gefilterte Datensatz bereits vorliegt. Der Abfrageoptimierer liest aus diesem vorbereiteten Datensatz und führt zur Abfragezeit GROUP BY category, COUNT(DISTINCT customer_id) aus, anstatt die Rohdaten-Tabellen von Grund auf neu zu verknüpfen.
Überprüfen Sie, ob eine Abfrage materialisierte Ansichten verwendet
Es gibt zwei Möglichkeiten, zu überprüfen, ob eine Abfrage eine materialisierte Ansicht verwendet:
- Wenden Sie
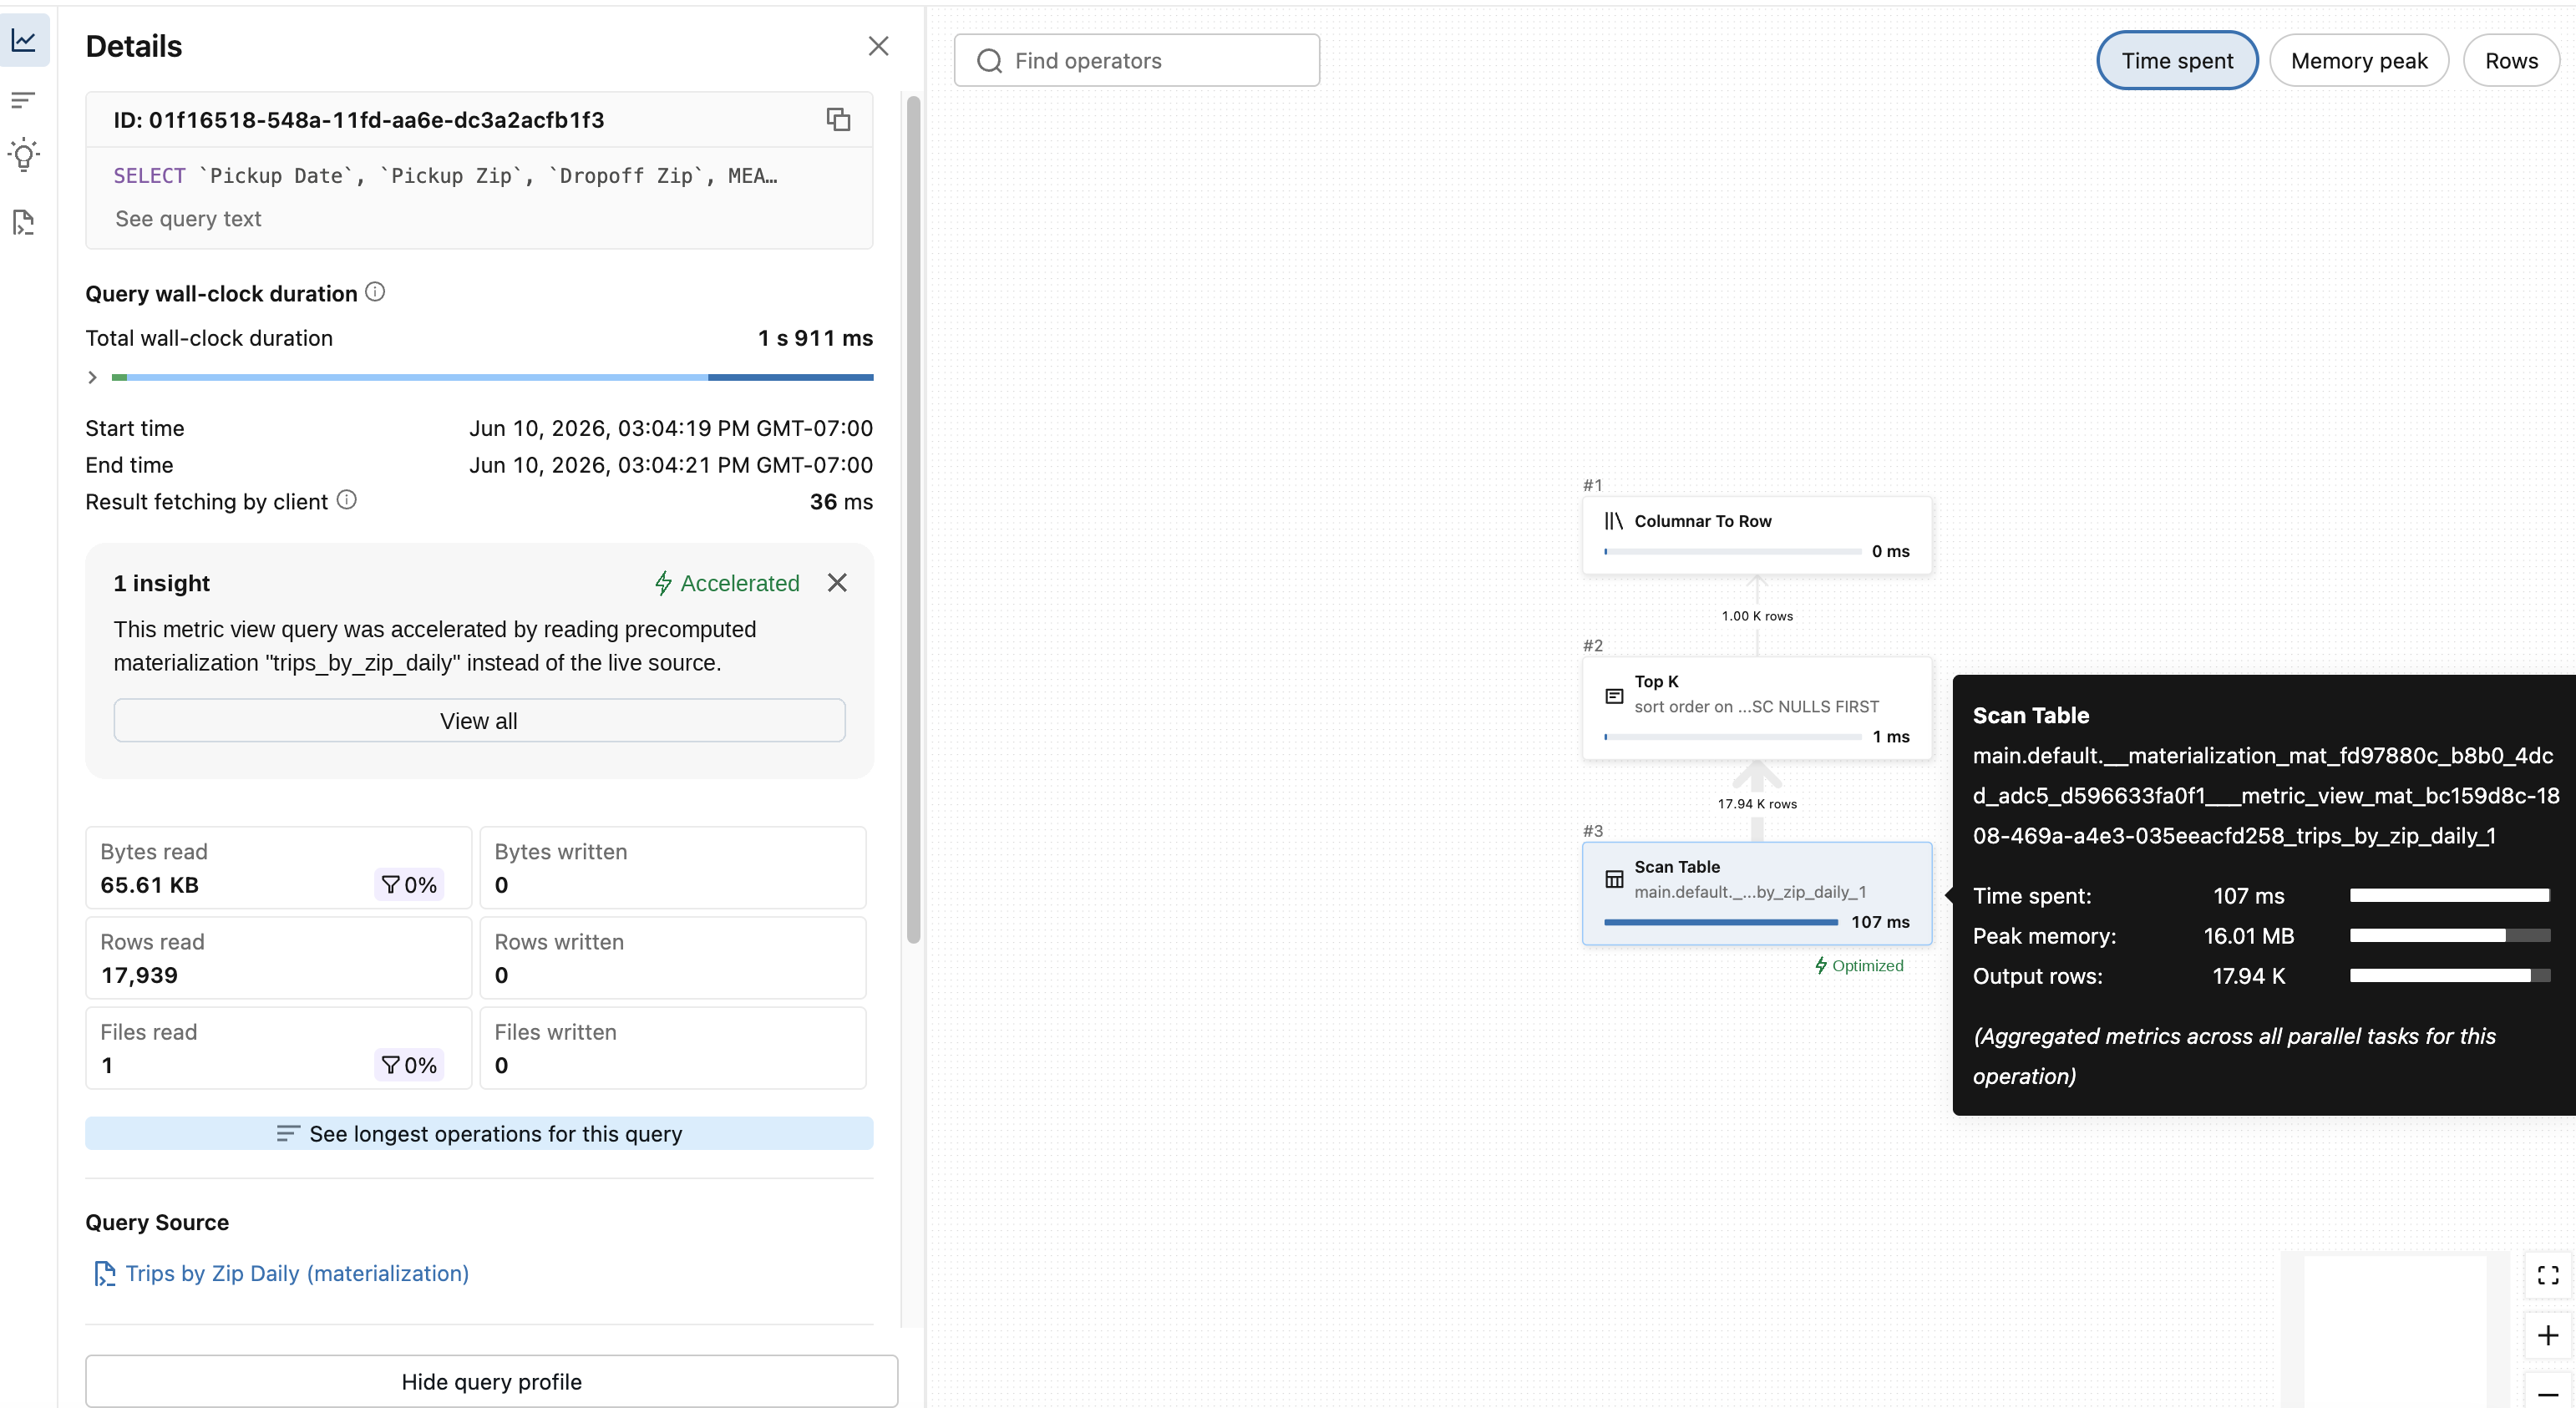
EXPLAIN EXTENDEDauf Ihre Abfrage an, um den Abfrageplan anzuzeigen. Wenn die Materialisierung verwendet wurde, enthält der Blattknoten__materialization_mat_<pipeline ID>___metric_view_mat_sowie den Namen der Materialisierung aus der YAML-Datei. - Sehen Sie sich das Abfrageprofil für eine Erkenntnis zur Übereinstimmung der Materialisierung einer Metrikansicht an, wie unten gezeigt.
Materialisierungslebenszyklus
In diesem Abschnitt wird erläutert, wie Materialisierungen während des gesamten Lebenszyklus erstellt, verwaltet und aktualisiert werden.
Erstellen und Ändern
Wenn Sie eine Metrikansicht erstellen oder ändern (mit CREATE, ALTER oder dem Catalog Explorer), wird die Definition der Metrikansicht sofort aktualisiert. Materialisierte Ansichten werden mithilfe einer verwalteten Pipeline asynchron im Hintergrund aktualisiert.
So definieren Sie eine neue Materialisierung im Katalog-Explorer-Editor:
- Klicken Sie auf Materialisierungen.
- Klicken Sie auf "Zeitplan ", um einen Zeitplan festzulegen. Sie können einen Intervallzeitraum auswählen oder die Materialisierung festlegen, die zu einem bestimmten Zeitpunkt ausgeführt werden soll.
- Wählen Sie einen Typ aus. Pro Metrikansicht ist nur eine nicht aggregierte Materialisierung zulässig. Weitere Informationen finden Sie unter Typen von Materialisierungen für Metrikansichten.
- Verwenden Sie die Dropdownliste "Felder ", um die Felder auszuwählen, die in die Materialisierung einbezogen werden sollen.
- Verwenden Sie die Dropdown-Liste Measures, um die einzuschließenden Kennzahlen auszuwählen.
Wenn Sie eine Metrikansicht erstellen, erstellt Databricks eine Lakeflow-Pipeline und plant sofort ein erstes Update, wenn materialisierte Ansichten definiert sind. Die Metrikansicht bleibt ohne Materialisierungen abfragbar, indem sie auf die Abfrage der Quelldaten zurückgreift.
Wenn Sie eine Metrikansicht ändern, plant Databricks keine neuen Updates, es sei denn, Sie aktivieren die Materialisierung zum ersten Mal. Materialisierte Ansichten werden erst dann für die automatische Neugenerierung von Abfragen verwendet, wenn die nächste geplante Aktualisierung abgeschlossen ist.
Das Ändern des Materialisierungszeitplans löst keine Aktualisierung aus.
Ohne Zeitplan führt die Pipeline bei der Erstellung eine erste Aktualisierung aus, nachfolgende Aktualisierungen müssen jedoch manuell ausgelöst werden, andernfalls veralten die Daten. Databricks empfiehlt, immer einen Zeitplan zu definieren, sodass Daten aktuell bleiben, es sei denn, Sie testen oder prototypieren.
Weitere Informationen finden Sie unter "Manuelle Aktualisierung ", um das Aktualisierungsverhalten genauer zu steuern.
Inspizieren Sie die zugrunde liegende Pipeline
Die Materialisierung für Metrikansichten wird mithilfe von Lakeflow-Pipelines implementiert. Um die Pipeline anzuzeigen, müssen Sie der Eigentümer der Metrikansicht sein oder das MANAGE Recht auf der Metrikansicht haben. Siehe Berechtigungen zum Verwalten von Materialisierungen erteilen.
Sie können auf zwei Arten auf die Pipeline zugreifen:
- In Catalog Explorer: Der Übersichtstab für die Metrikansicht enthält einen direkten Link unter der Überschrift Auffrischungsplan. Informationen zum Zugreifen auf den Katalog-Explorer finden Sie unter Was ist der Katalog-Explorer?.
-
Mit SQL: Ausführen Sie
DESCRIBE EXTENDED. Der Abschnitt "Aktualisierungsinformationen" enthält den Pipelinelink und den aktuellen Aktualisierungsstatus.
DESCRIBE EXTENDED my_metric_view;
Beispielausgabe:
-- Returns additional metadata such as parent schema, owner, access time etc.
> DESCRIBE EXTENDED my_metric_view;
                      col_name                       data_type    comment
 ------------------------------- ------------------------------ ----------
                           ...                             ...        ...

 # Detailed Table Information
                           ...                             ...

                      Language                            YAML
              Table properties                             ...
 # Refresh Information
         Latest Refresh Status                       Succeeded
                Latest Refresh                     https://...
              Refresh Schedule                   EVERY 6 HOURS
Manuelle Aktualisierung
Über den Link zur Lakeflow-Pipeline-Seite können Sie manuell eine Pipeline-Aktualisierung starten, um die Materialisierungen zu aktualisieren. Sie können eine manuelle Aktualisierung auch mit dem folgenden SQL-Befehl auslösen:
REFRESH MATERIALIZED VIEW <metric-view-name>
Schrittweise Aktualisierung
Die materialisierten Ansichten verwenden nach Möglichkeit eine inkrementelle Aktualisierung und haben dieselben Einschränkungen wie standardmaterialisierte Ansichten in Bezug auf Datenquellen und Planstruktur.
Ausführliche Informationen zu Voraussetzungen und Einschränkungen finden Sie unter Inkrementelles Aktualisieren von materialisierten Ansichten.
Um zu steuern, ob eine Materialisierung auf eine vollständige Neuberechnung zurückfällt, setzen Sie refresh_policy beim Eintrag in materialized_views. Mit incremental oder incremental strictschlägt das Erstellen oder Ändern der Metrikansicht fehl, wenn diese Materialisierung nicht schrittweise aktualisiert werden kann. Siehe Materialisierung.
Berechtigungen zum Verwalten von Materialisierungen erteilen
Berechtigungen für Materialisierungen stammen aus der metrischen Ansicht im Unity Catalog, nicht aus der zugrunde liegenden Pipeline. Wenn Sie das MANAGE Privileg auf eine metrische Ansicht oder auf das Schema oder den Katalog gewähren, der sie enthält, gilt das Privileg für die Materialisierungen der metrischen Ansicht.
Um MANAGE zu gewähren, musst du der Eigentümer des Objekts sein oder darüber MANAGE verfügen. Details zu der MANAGE-Berechtigung finden Sie unter VERWALTEN.
Berechtigung für ein Schema oder einen Katalog
Databricks empfiehlt, MANAGE für das Schema oder den Katalog zu erteilen. Eine einzelne Berechtigung deckt alle aktuellen und zukünftigen Metrikansichten in diesem Schema oder Katalog ab.
-- Every metric view in one schema (current and future)
GRANT USE CATALOG ON CATALOG my_catalog TO `data-engineering`;
GRANT USE SCHEMA, MANAGE ON SCHEMA my_catalog.my_schema TO `data-engineering`;

-- Every metric view in the catalog (current and future)
GRANT USE CATALOG, USE SCHEMA, MANAGE ON CATALOG my_catalog TO `data-engineering`;
Fügen Sie SELECT derselben Anweisung hinzu, wenn der Prinzipal auch die Metrikansichten abfragen muss. Im Catalog Explorer öffnen Sie das Schema oder den Katalog (keine einzelne Metrikansicht), klicken Sie auf den Reiter Berechtigungen und klicken Sie auf Grant.
Note
MANAGE auf ein Schema oder einen Katalog gilt für jedes darin enthaltene Objekt, nicht nur für metrische Ansichten.
Grant auf eine einzelne Metrikansicht
SQL
GRANT USE CATALOG ON CATALOG my_catalog TO `teammate@example.com`;
GRANT USE SCHEMA ON SCHEMA my_catalog.my_schema TO `teammate@example.com`;
GRANT MANAGE ON TABLE my_catalog.my_schema.my_metric_view TO `teammate@example.com`;
Um einer Gruppe Berechtigungen zu erteilen, verwenden Sie den Gruppennamen statt der E-Mail-Adresse.
Katalog-Explorer
- Klicken Sie im Azure Databricks-Arbeitsbereich auf das
 Katalog.
- Wechsle zur Metrikansicht.
- Klicken Sie auf die Registerkarte Berechtigungen.
- Klicken Sie auf Erlauben.
- Wählen Sie den Benutzer, die Gruppe oder den Dienstprinzipal aus.
- Wählen Sie VERWALTEN sowie alle weiteren benötigten Privilegien, die der Prinzipal benötigt.
- Klicken Sie auf Bestätigen.
CLI
databricks grants update table my_catalog.my_schema.my_metric_view --json '{
  "changes": [
    { "principal": "teammate@example.com", "add": ["MANAGE"] }
  ]
}'
Für weitere Informationen siehe grantsKommandogruppe.
Berechtigung mit deklarativen Automatisierungsbündeln erteilen
Deklarative Automatisierungsbündel können nicht auf eine einzelne Metrikansicht abzielen, daher gewähren Sie MANAGE auf Schema-Ebene:
resources:
  schemas:
    my_schema:
      name: my_schema
      catalog_name: my_catalog
      grants:
        - principal: data-engineering
          privileges:
            - USE_SCHEMA
            - MANAGE
Dann deploye das Bündel:
databricks bundle deploy
Dies funktioniert nur für Schemata, die das Bundle erstellt. Für bestehende Schemata verwenden Sie SQL oder Catalog Explorer.
Weitere Informationen zu Schema-Grants in Bundles finden Sie unter schema (Unity Catalog).
Abrechnung
Für das Aktualisieren von materialisierten Ansichten fallen Nutzungsgebühren für Lakeflow-Pipelines an. Um den Databricks-Einheitenverbrauch (DBU) der Pipeline zu finden, siehe Was ist der DBU-Verbrauch einer serverlosen Pipeline?.
Materialisierungspipelines übernehmen die benutzerdefinierten Tags des SQL-Warehouses, das die Anweisung ausführt, sodass ihre Nutzung in system.billing.usage diesem Warehouse zugeschrieben werden kann. System-Tags werden nicht übertragen. Der erste CREATE speichert die Tags des Warehouse in der Pipeline. Jede spätere CREATE oder manuelle REFRESH wendet die Tags des Warehouse an, das sie ausführt, und geplante Aktualisierungen verwenden die bei der Erstellung gespeicherten Tags. Metrikansichten haben keine eigene Tag-Einstellung, also ändere die Tag-Einstellungen des SQL Warehouses, um die Tags zu ändern. Siehe Attributkosten für das SQL-Lager mit benutzerdefinierten Tags.
Bekannte Einschränkungen
Die folgenden Einschränkungen gelten für die Materialisierung für Metrikansichten:
- Sie können keine Metrikansicht materialisieren, die Parameter definiert.
- Nachdem eine Materialisierung für eine Metrikansicht erstellt wurde, können Sie den Besitzer nicht mehr ändern.
- Databricks unterstützt keinen Gruppenbesitz materialisierter Metrikansichten.
- Nur die Strategie für genaue Übereinstimmungen ist für Metrikansichten mit 1:n-Joins zulässig.
- Die Materialisierung
scheduleunterstützt dieTRIGGER ON UPDATEKlausel nicht.