Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Mit dem Fabric SDK zur Bewertung können Sie programmatisch testen, wie gut Ihr Data Agent auf Fragen in natürlicher Sprache reagiert. Mit einer einfachen Python-Oberfläche können Sie Beispiele für Ground Truth definieren, Bewertungen durchführen und Ergebnisse analysieren – alles innerhalb Ihrer Notizbuchumgebung. Dieser Prozess hilft Ihnen, die Genauigkeit zu validieren, Fehler zu debuggen und Ihren Agenten sicher zu verbessern, bevor Sie ihn in die Produktion einsetzen.
Von Bedeutung
Dieses Feature befindet sich in der Vorschauphase.
Voraussetzungen
- Eine bezahlte F2 oder höhere Fabric-Kapazität oder eine Power BI Premium pro Benutzer (P1 oder höher) Kapazität mit Microsoft Fabric aktiviert.
- Aktivieren Sie die geoübergreifende Verarbeitung und die geoübergreifende Speicherung für KI basierend auf den Anforderungen, die in den Fabric-Daten-Agent-Mandanteneinstellungen erläutert werden.
- Mindestens eine dieser Datenquellen mit Daten: Ein Warehouse, ein Lakehouse, ein Power BI-Semantikmodell, eine KQL-Datenbank, eine gespiegelte Datenbank oder eine Ontologie. Sie müssen über Lesezugriff auf die Datenquelle verfügen.
Installieren des Daten-Agent-SDK
Um mit der programmatischen Bewertung Ihres Fabric-Datenagenten zu beginnen, installieren Sie das Fabric Data Agent Python SDK. Dieses SDK stellt die Tools und Methoden bereit, die erforderlich sind, um mit Ihrem Daten-Agent zu interagieren, Auswertungen auszuführen und Ergebnisse zu protokollieren. Installieren Sie die neueste Version, indem Sie den folgenden Befehl in Ihrem Notizbuch ausführen:
%pip install -U fabric-data-agent-sdk
Mit diesem Schritt wird sichergestellt, dass Sie über die aktuellsten Features und Korrekturen im SDK verfügen.
Laden des Grundwahrheitsdatasets
Um Ihren Fabric-Datenagenten zu bewerten, benötigen Sie eine Reihe von Beispielfragen zusammen mit den erwarteten Antworten. Nutzen Sie diese Fragen, um zu überprüfen, wie genau der Agent auf reale Anfragen antwortet.
Definieren Sie diese Fragen direkt in Ihrem Code mit einem pandas DataFrame:
import pandas as pd

# Define a sample evaluation set with user questions and their expected answers.
# You can modify the question/answer pairs to match your scenario.
df = pd.DataFrame(
    columns=["question", "expected_answer"],
    data=[
        ["Show total sales for Canadian Dollar for January 2013", "46,117.30"],
        ["What is the product with the highest total sales for Canadian Dollar in 2013", "Mountain-200 Black, 42"],
        ["Total sales outside of the US", "19,968,887.95"],
        ["Which product category had the highest total sales for Canadian Dollar in 2013", "Bikes (Total Sales: 938,654.76)"]
    ]
)
Alternativ, wenn Sie einen bestehenden Evaluationsdatensatz haben, laden Sie ihn aus einer CSV-Datei mit den Spalten question und expected_answer:
# Load questions and expected answers from a CSV file
input_file_path = "/lakehouse/default/Files/Data/Input/curated_2.csv"
df = pd.read_csv(input_file_path)
Dieses Dataset dient als Eingabe für die Ausführung automatisierter Auswertungen für Ihren Datenagent, um die Genauigkeit und Abdeckung zu bewerten.
Auswerten und Bewerten Ihres Datenagent
Der nächste Schritt besteht darin, die Auswertung mit der evaluate_data_agent Funktion auszuführen. Diese Funktion vergleicht die Antworten des Agents mit den erwarteten Ergebnissen und speichert die Auswertungsmetriken.
Note
Dieser Schritt erfordert einen Datenagenten, der bereits in der Phase veröffentlicht ist, die du bewertest (production oder sandbox). Falls du noch keinen hast, siehe Create a Fabric Data Agent.
from fabric.dataagent.evaluation import evaluate_data_agent

# Name of your data agent
data_agent_name = "AgentEvaluation"

# (Optional) Name of the workspace if the data agent is in a different workspace
workspace_name = None

# (Optional) Name of the output table to store evaluation results (default: "evaluation_output")
# Two tables will be created:
# - "<table_name>": contains summary results (e.g., accuracy)
# - "<table_name>_steps": contains detailed reasoning and step-by-step execution
table_name = "demo_evaluation_output"

# Specify the data agent stage: "production" (default) or "sandbox"
data_agent_stage = "production"

# Run the evaluation and get the evaluation ID
try:
    evaluation_id = evaluate_data_agent(
        df,
        data_agent_name,
        workspace_name=workspace_name,
        table_name=table_name,
        data_agent_stage=data_agent_stage
    )
    print(f"Unique ID for the current evaluation run: {evaluation_id}")
except Exception as e:
    print(f"Evaluation failed: {e}")
Nachdem der Durchlauf abgeschlossen ist, wird eine Ausgabe ähnlich dem folgenden Text angezeigt:
Unique ID for the current evaluation run: <evaluation-id>
Zusammenfassung der Auswertung abrufen
Nach der Ausführung der Auswertung können Sie mit der get_evaluation_summary Funktion eine hochrangige Zusammenfassung der Ergebnisse abrufen. Diese Funktion liefert Einblicke darin, wie gut Ihr Data Agent insgesamt abgeschnitten hat, einschließlich Kennzahlen wie, wie viele Antworten mit den erwarteten Antworten übereinstimmten.
from fabric.dataagent.evaluation import get_evaluation_summary

# Retrieve a summary of the evaluation results
summary_df = get_evaluation_summary(table_name)
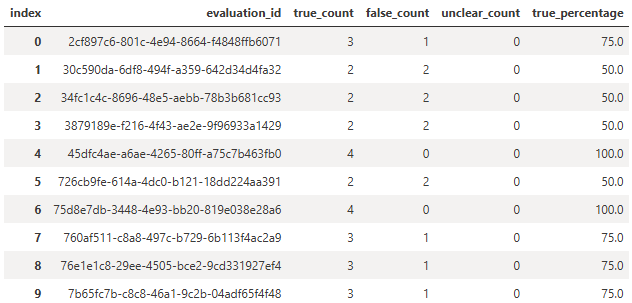
Standardmäßig sucht diese Funktion nach einer Tabelle namens evaluation_output. Wenn du während der Bewertung einen benutzerdefinierten Tabellennamen angegeben hast (wie demo_evaluation_output), gib diesen Namen als Argument table_name an.
Der zurückgegebene DataFrame enthält aggregierte Metriken wie die Anzahl der korrekten, falschen oder unklaren Antworten. Dieses Ergebnis hilft Ihnen, die Genauigkeit des Agenten schnell zu bewerten und Bereiche zur Verbesserung zu identifizieren.
Überprüfen detaillierter Auswertungsergebnisse
Um tiefer zu verstehen, wie Ihr Data Agent auf jede einzelne Frage reagiert hat, nutzen Sie die get_evaluation_details Funktion. Diese Funktion gibt eine detaillierte Aufschlüsselung der Auswertungsausführung zurück, einschließlich der tatsächlichen Agentantworten, ob sie der erwarteten Antwort entsprechen, und einen Link zum Auswertungsthread (nur für den Benutzer sichtbar, der die Auswertung ausgeführt hat).
from fabric.dataagent.evaluation import get_evaluation_details

# Table name used during evaluation
table_name = "demo_evaluation_output"

# Whether to return all evaluation rows (True) or only failures (False)
get_all_rows = False

# Whether to print a summary of the results
verbose = True

# Retrieve evaluation details for a specific run
eval_details = get_evaluation_details(
    evaluation_id,
    table_name,
    get_all_rows=get_all_rows,
    verbose=verbose
)
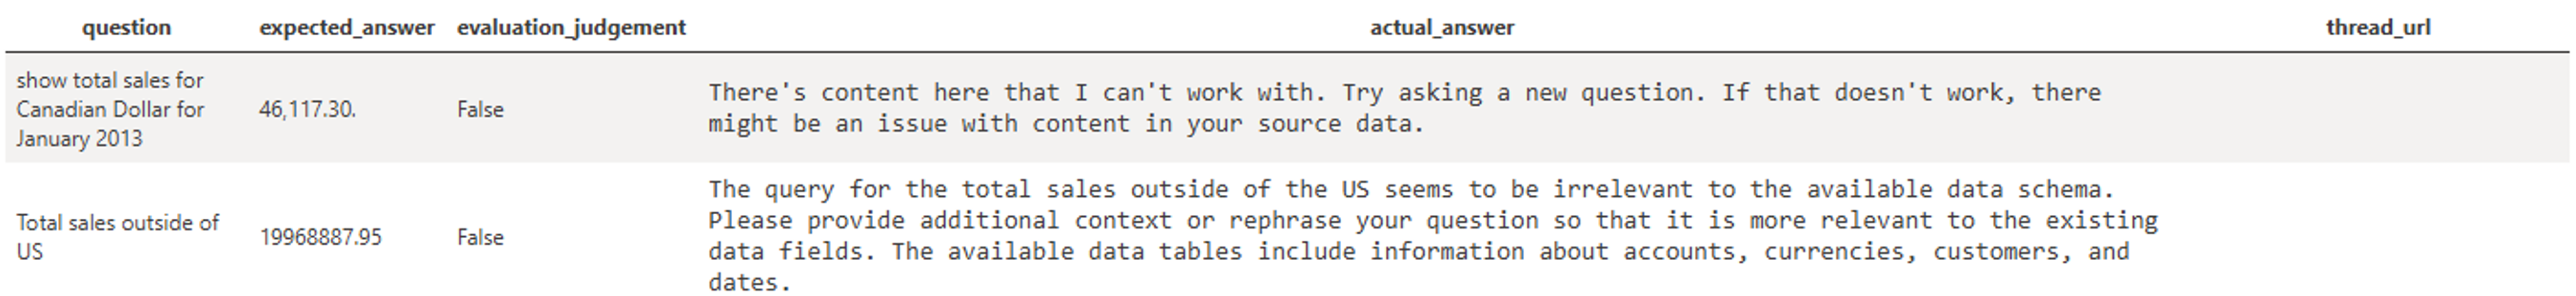
Anpassen Ihres Prompts für die Auswertung
Standardmäßig verwendet das Fabric SDK einen eingebauten Prompt, um zu bewerten, ob die tatsächliche Antwort des Data Agents mit der erwarteten Antwort übereinstimmt. Sie können jedoch Ihren eigenen Prompt für nuanciertere oder domänenspezifische Bewertungen angeben, indem Sie den Parameter critic_prompt verwenden.
Ihre benutzerdefinierte Eingabeaufforderung sollte die Platzhalter {query}, {expected_answer} und {actual_answer} enthalten. Der Bewertungsprozess ersetzt diese Platzhalter dynamisch für jede Frage.
from fabric.dataagent.evaluation import evaluate_data_agent

# Define a custom prompt for evaluating agent responses
critic_prompt = """
    Given the following query, expected answer, and actual answer, please determine if the actual answer is equivalent to expected answer. If they are equivalent, respond with 'yes'.

    Query: {query}

    Expected Answer:
    {expected_answer}

    Actual Answer:
    {actual_answer}

    Is the actual answer equivalent to the expected answer?
"""

# Name of the data agent
data_agent_name = "AgentEvaluation"

# Run evaluation using the custom critic prompt
evaluation_id = evaluate_data_agent(df, data_agent_name, critic_prompt=critic_prompt)
Dieses Feature ist besonders nützlich, wenn:
- Du solltest lockerere oder strengere Kriterien dafür anwenden, was als Übereinstimmung gilt.
- Deine erwarteten und tatsächlichen Antworten können im Format variieren, aber semantisch gleichwertig sein.
- Sie müssen domänenspezifische Nuancen erfassen, um zu ermitteln, wie Antworten beurteilt werden sollen.
Diagnoseknopf
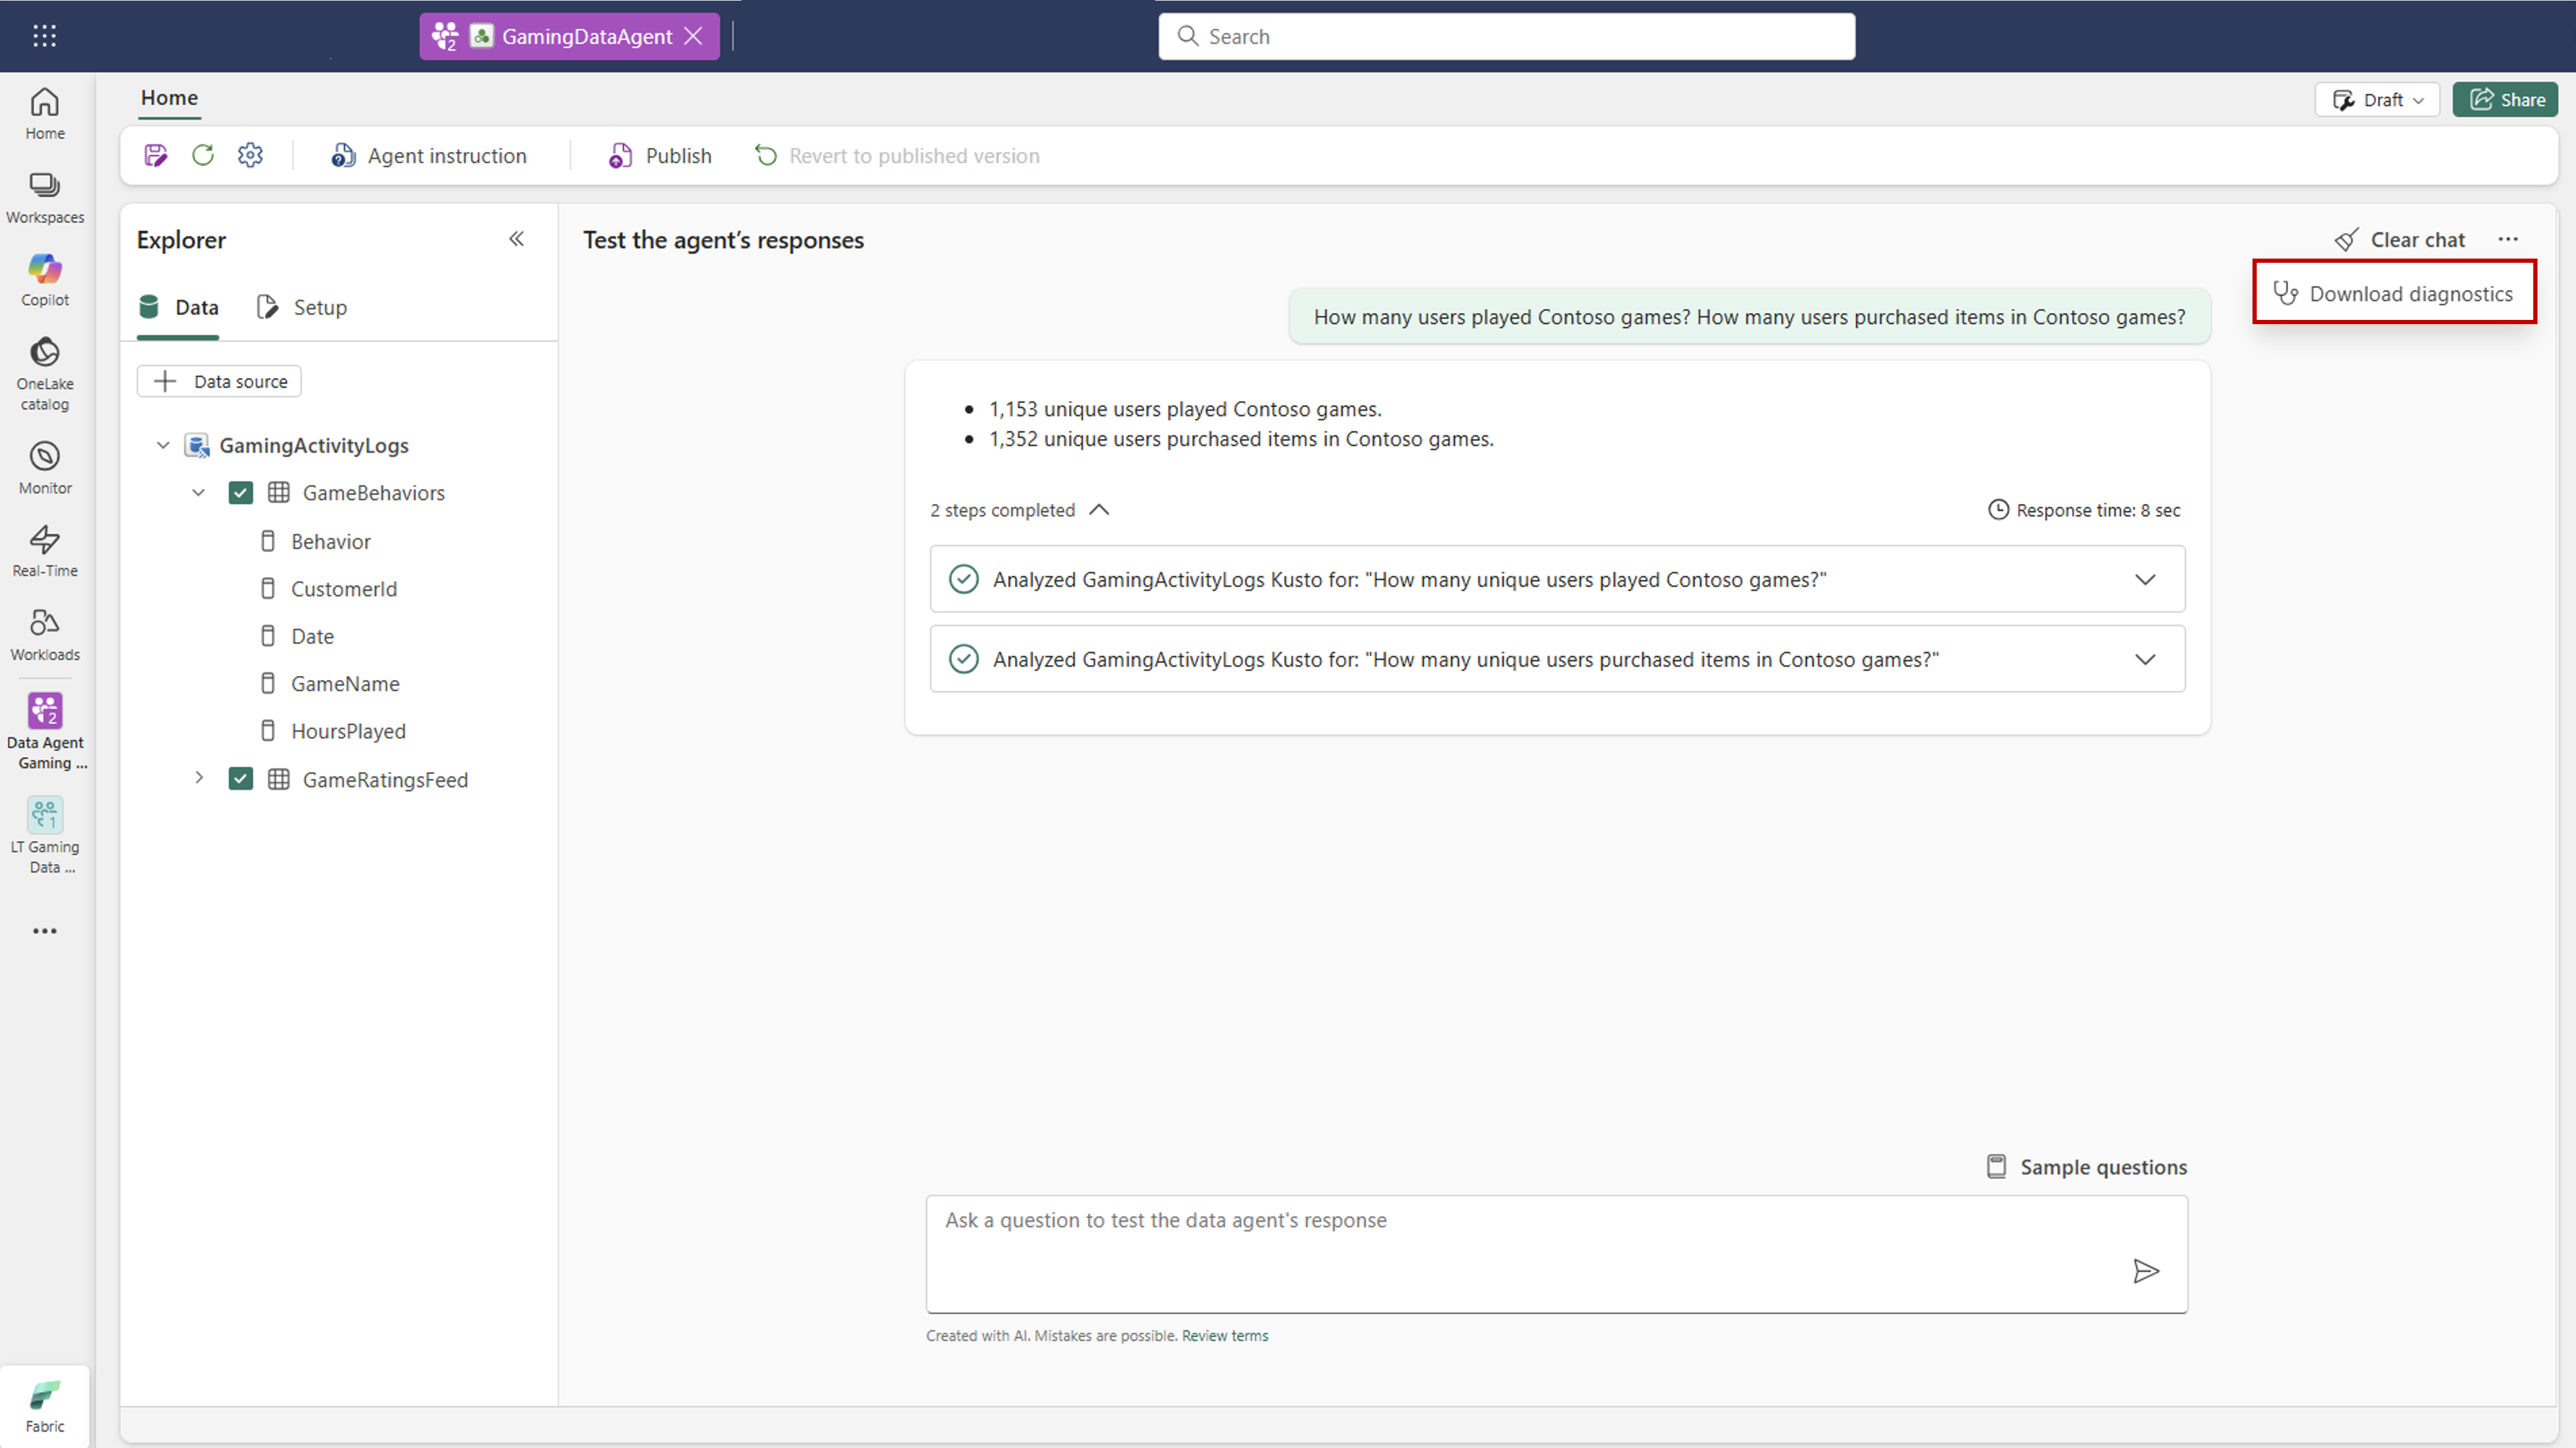
Mit der Schaltfläche 'Diagnostik ' können Sie einen vollständigen Schnappschuss der Konfiguration und der Ausführung Ihres Datenagenten herunterladen. Dieser Export enthält Details wie Datenquelleneinstellungen, angewandte Anweisungen, verwendete Beispielabfragen und die zugrunde liegenden Schritte, die der Datenagent zur Antwortgenerierung unternommen hat.
Nutzen Sie diese Funktion, wenn Sie mit Microsoft-Support zusammenarbeiten oder unerwartetes Verhalten beheben. Durch die Überprüfung der heruntergeladenen Datei können Sie genau sehen, wie der Data Agent Ihre Anfrage verarbeitet hat, welche Konfigurationen angewendet wurden und wo potenzielle Probleme aufgetreten sind. Dieses Maß an Transparenz erleichtert das Debuggen und die Optimierung der Leistung Ihres Datenagenten.
Problembehandlung
| Issue | Ursache | Resolution |
|---|---|---|
| Datenagent nicht gefunden |
data_agent_name oder workspace_name ist ungültig, oder der Agent ist nicht veröffentlicht. |
Überprüfen Sie den Namen des Agenten und den Arbeitsbereich und stellen Sie sicher, dass der Agent auf die angegebene data_agent_stageDomain veröffentlicht wird. |
| Leere oder fehlende Ergebnisse | Der Tabellenname stimmt nicht mit dem während evaluate_data_agent verwendeten überein. |
Übergebe dasselbe table_name an get_evaluation_summary und get_evaluation_details. |
message_url ist nicht zugänglich |
Evaluationsthreads sind nur für den Benutzer sichtbar, der die Bewertung durchgeführt hat. | Führe die Bewertung unter deiner eigenen Identität erneut durch, um auf die Thread-Links zuzugreifen. |
| Benutzerdefinierter Prompt hat keine Wirkung oder verursacht Fehler | Dem critic_prompt fehlen erforderliche Platzhalter. |
Füge {expected_answer}, {actual_answer} und {query} in deinen Prompt ein. |
| Berechtigungs- oder Kapazitätsfehler | Fehlende F2- oder höhere Kapazität oder fehlender Lesezugriff auf die Datenquelle. | Bestätigen Sie die Voraussetzungen, einschließlich Kapazität und Lesezugriff auf die Datenquelle. |