Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Zutreffend für: ✅ Warehouse in Microsoft Fabric
Dieser Artikel beschreibt Methoden zur Migration von Azure Synapse Analytics dedizierten SQL-Pools zu Microsoft Fabric Data Warehouse.
Tipp
Weitere Informationen zur Strategie und zur Planung Ihrer Migration finden Sie unter Migrationsplanung: Azure Synapse Analytics dedizierte SQL-Pools zu Fabric Data Warehouse.
Eine automatisierte Oberfläche für die Migration von dedizierten SQL-Pools von Azure Synapse Analytics ist über den Fabric-Migrations-Assistenten für Data Warehouseverfügbar. Der Rest dieses Artikels enthält weitere manuelle Migrationsschritte.
Die folgende Tabelle fasst Methoden zur Migration des Datenschemas (DDL), des Datenbankcodes (DML) und der Daten zusammen. Die Option-Spalte verlinkt zu Details für jedes Szenario.
| Optionsnummer | Option | Funktionsbeschreibung | Fähigkeit oder Vorliebe | Szenario |
|---|---|---|---|---|
| 1 | Datenfabrik | Schemakonvertierung (DDL) Datenextraktion Datenaufnahme |
ADF/Pipeline | Vereinfachtes Alles-in-Einem-Schema (DDL) und Datenmigration. Empfohlen für Dimensionstabellen. |
| 2 | Datenfabrik mit Partition | Schemakonvertierung (DDL) Datenextraktion Datenaufnahme |
ADF/Pipeline | Verwenden von Partitionierungsoptionen zum Erhöhen des Lese-/Schreib-Parallelismus, der zehnmal den Durchsatz gegenüber Option 1 bereitstellt, empfohlen für Faktentabellen. |
| 3 | Data Factory mit beschleunigtem Code | Schemakonvertierung (DDL) | ADF/Pipeline | Konvertieren und migrieren Sie zuerst das Schema (DDL), und verwenden Sie dann CETAS zum Extrahieren und COPY/Data Factory, um Daten für eine optimale Gesamtaufnahmeleistung aufzunehmen. |
| 4 | Gespeicherte Prozeduren beschleunigen Code | Schemakonvertierung (DDL) Datenextraktion Codebewertung |
T-SQL | SQL-Anwender, die die IDE benutzen, um genauer zu kontrollieren, an welchen Aufgaben sie arbeiten möchten. Verwenden Sie COPY/Data Factory, um Daten zu erfassen. |
| 5 | SQL-Datenbankprojekterweiterung für Visual Studio Code | Schemakonvertierung (DDL) Datenextraktion Codebewertung |
SQL-Projekt | SQL-Datenbankprojekt für die Bereitstellung mit der Integration von Option 4. Verwenden Sie COPY oder Data Factory, um Daten zu erfassen. |
| 6 | EXTERNE TABELLE ALS SELECT ERSTELLEN (CETAS) | Datenextraktion | T-SQL | Kostengünstige und leistungsstarke Datenextraktion in Azure Data Lake Storage (ADLS) Gen2. Verwenden Sie COPY/Data Factory, um Daten zu erfassen. |
| 7 | Migrieren mithilfe von dbt | Schemakonvertierung (DDL) Konvertierung von Datenbankcode (DML) |
dbt | Vorhandene dbt-Benutzer können den dbt Fabric-Adapter verwenden, um ihre DDL und DML zu konvertieren. Anschließend müssen Sie Daten mithilfe anderer Optionen in dieser Tabelle migrieren. |
Auswählen einer Workload für die erste Migration
Wenn Sie entscheiden, wo Sie mit dem Synapse-dedizierten SQL-Pool für Fabric Data Warehouse Migrationsprojekt anfangen möchten, wählen Sie einen Arbeitslastbereich, in dem Sie:
- Beweisen Sie die Tragfähigkeit der Migration zu Fabric Data Warehouse, indem Sie die Vorteile der neuen Umgebung schnell umsetzen. Fang klein und einfach an und bereite dich auf mehrere kleine Migrationen vor.
- Geben Sie Ihrem technischen Personal Zeit, relevante Erfahrungen mit den Prozessen und Tools zu sammeln, die sie nutzen werden, wenn sie in andere Bereiche wechseln.
- Erstellen Sie eine Vorlage für weitere Migrationen, die speziell auf die Synapse-Quellumgebung und die vorhandenen Tools und Prozesse zugeschnitten ist.
Tipp
Erstellen Sie ein Inventar der zu migrierenden Objekte und dokumentieren Sie den Migrationsprozess von Anfang bis Ende, damit Sie ihn für andere dedizierte SQL-Pools oder Workloads wiederholen können.
Das Volumen der migrierten Daten bei einer Erstmigration sollte groß genug sein, um die Fähigkeiten und Vorteile der Fabric Data Warehouse-Umgebung zu demonstrieren, aber nicht zu groß, um schnell den Wert zu zeigen. In der Regel liegt die Größe im Bereich von 1 bis 10 TB.
Migration mit Fabric Data Factory
Dieser Abschnitt beschreibt die Data Factory-Optionen für Nutzer, die mit Azure Data Factory- und Synapse-Pipelines vertraut sind. Die Drag-and-Drop-Oberfläche bietet eine einfache Möglichkeit, DDL zu konvertieren und Daten zu migrieren.
Fabric Data Factory kann die folgenden Aufgaben ausführen:
- Konvertiere das Schema (DDL) in Fabric Data Warehouse Syntax.
- Erstellen Sie das Schema (DDL) auf Fabric Data Warehouse.
- Migriere die Daten zu Fabric Data Warehouse.
Option 1: Schema- und Datenmigration – Assistent zum Kopieren von Daten und ForEach Copy Activity
Diese Methode verwendet Data Factory Copy Data Assistant, um sich mit dem dedizierten SQL-Pool des Quellcodes zu verbinden, die DDL-Syntax des dedienten SQL-Pools in Fabric umzuwandeln und Daten in Fabric Data Warehouse zu kopieren. Sie können eine oder mehr Zieltabellen auswählen (für das TPC-DS-Dataset gibt es 22 Tabellen). Das Programm generiert ForEach, um eine Schleife durch die Liste der in der Benutzeroberfläche ausgewählten Tabellen zu ziehen und 22 parallele Copy-Aktivität-Threads zu erzeugen.
- 22
SELECTAbfragen (eine für jede ausgewählte Tabelle) werden im dedizierten SQL-Pool generiert und ausgeführt. - Stellen Sie sicher, dass Sie die passende DWU und Ressourcenklasse haben, damit die generierten Abfragen ausgeführt werden können. In diesem Fall benötigen Sie mindestens DWU1000,
staticrc10damit maximal 32 Abfragen 22 übermittelte Abfragen verarbeiten können. - Das Kopieren von Daten direkt aus dem dedizierten SQL-Pool in das Fabric Data Warehouse mithilfe von Data Factory erfordert Staging. Der Aufnahmeprozess besteht aus zwei Phasen:
- Die erste Phase extrahiert Daten aus dem dedizierten SQL-Pool in ADLS. Diese Phase nennt man Staging.
- Die zweite Phase lädt die bereitgestellten Daten in Fabric Data Warehouse. Der Großteil der Zeit für die Datenaufnahme entfällt auf die Staging-Phase, sodass das Staging einen erheblichen Einfluss auf die Leistung hat.
Empfohlene Verwendung
Die Verwendung des Copy Assistant zur Generierung einer ForEach-Aktivität bietet eine einfache Schnittstelle zur Umwandlung von DDL und zum Aufnehmen ausgewählter Tabellen aus dem dedizierten SQL-Pool in Fabric Data Warehouse in einem Schritt.
Diese Option bietet jedoch keinen optimalen Gesamtdurchsatz. Staging und die Notwendigkeit, Lese- und Schreibvorgänge während der Quelle-zu-Stufe-Phase zu parallelisieren, sind die Hauptquellen der Latenz. Verwenden Sie diese Option nur für Dimensionstabellen.
Option 2. DDL/Datenmigration – Pipeline mit Partitionsoption
Um den Durchsatz zu verbessern, wenn Sie größere Faktentabellen mit einer Fabric-Pipeline laden, verwenden Sie für jede Faktentabelle eine Copy-Aktivität und aktivieren Sie die Partitionierung. Diese Konfiguration bietet die beste Copy-Aktivität-Performance.
Verwenden Sie die physischen Partitionen der Quelltabelle, wenn verfügbar. Wenn die Tabelle nicht physisch partitioniert ist, geben Sie eine Spaltungsspalte sowie Mindest- und Maximalwerte für die dynamische Partitionierung an. Im folgenden Screenshot geben die Pipeline-Quelloptionen einen dynamischen Partitionsbereich basierend auf der Spalte ws_sold_date_sk an.

Partitionierung kann den Staging-Durchsatz erhöhen. Beachten Sie beim Konfigurieren folgende Empfehlungen:
- Je nach Partitionsbereich kann der Vorgang mehr als 128 Abfragen generieren und alle Parallelitätsplätze im dedizierten SQL-Pool verwenden.
- Du musst auf ein Minimum von DWU6000 skalieren, damit alle Abfragen ausgeführt werden können.
- Beispielsweise wurden für die TPC-DS-Tabelle
web_sales163 Abfragen an den dedizierten SQL-Pool übermittelt. Zum DWU6000 wurden 128 Abfragen ausgeführt, während 35 Anfragen in der Warteschlange standen. - Dynamische Partition wählt automatisch die Bereichspartition aus. In diesem Fall wird ein 11-tägiger Bereich für jede SELECT-Abfrage an den dedizierten SQL-Pool übermittelt. Beispiel:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
Empfohlene Verwendung
Für Faktentabellen verwenden Sie Data Factory mit der Partitionierungsoption, um den Durchsatz zu erhöhen.
Parallele Lesungen erfordern jedoch, dass du den dedizierten SQL-Pool auf eine höhere DWU skalierst, damit die Extraktionsabfragen ausgeführt werden können. Partitionierung verbessert die Rate um ein Zehnfaches im Vergleich zum Nicht-Partitionieren. Man kann die DWU für mehr Durchsatz erhöhen, aber ein dedizierter SQL-Pool erlaubt maximal 128 aktive Abfragen.
Weitere Informationen zur Zuordnung von Synapse-DWU zu Fabric finden Sie unter Blog: Zuordnung von dedizierten SQL-Pools in Azure Synapse zur Rechenkapazität von Fabric Data Warehouse.
Option 3. DDL-Migration – Daten-Kopierassistent für jede Kopieraktivität
Die beiden vorherigen Optionen eignen sich für kleinere Datenbanken. Wenn Sie einen höheren Durchsatz benötigen, nutzen Sie diese Alternative:
- Extrahiere die Daten aus dem dedizierten SQL-Pool in ADLS, um den Staging-Overhead zu reduzieren.
- Verwenden Sie entweder Data Factory oder den COPY-Befehl, um die Daten in Ihr Data Warehouse zu laden.
Empfohlene Verwendung
Sie können weiterhin Data Factory verwenden, um Ihr Schema (DDL) zu konvertieren. Mit dem Datenassistenten Kopieren können Sie die spezifische Tabelle oder Alle Tabellen auswählen. Diese Methode migriert das Schema designweise in einem Schritt, wobei das Schema ohne Zeilen unter Verwendung der falschen Bedingung TOP 0 in der Abfrageanweisung extrahiert wird.
Im folgenden Codebeispiel wird die Schemamigration (DDL) mit Data Factory behandelt.
Codebeispiel: Schemamigration (DDL) mit Data Factory
Sie können Fabric Pipelines verwenden, um Ihre DDLs (Schemata) für Tabellenobjekte einfach aus einer beliebigen Azure SQL-Datenbank als Quelle oder aus einem dedizierten SQL-Pool zu migrieren. Diese Pipeline migriert das Schema (DDL) für die dedizierten Quellcode-SQL-Pooltabellen zu Fabric Data Warehouse.

Pipelineentwurf: Parameter
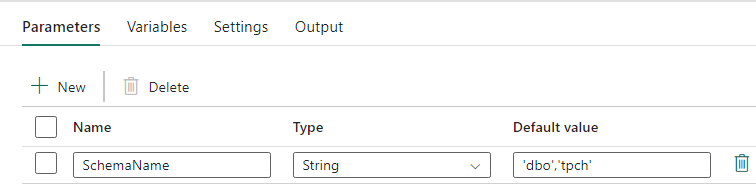
Diese Pipeline akzeptiert einen Parameter SchemaName, den Sie verwenden, um anzugeben, welche Schemata migriert werden sollen. Das Standardschema ist dbo.
Geben Sie in das Feld Standardwert eine durch Komma getrennte Liste von Tabellenschemata ein, die angibt, welche Schemata migriert werden sollen: 'dbo','tpch' um zwei Schemata bereitzustellen, dbo und tpch.
Pipelineentwurf: Lookup-Aktivität
Erstellen Sie eine Lookup-Aktivität, und legen Sie die Verbindung so fest, dass sie auf Ihre Quelldatenbank verweist.
Auf der Registerkarte Einstellungen:
Setzen Sie den Datenspeichertyp auf Extern.
Die Verbindung ist Ihr dedizierter SQL-Pool in Azure Synapse. Verbindungstyp ist Azure Synapse Analytics.
Verwendungsabfrage ist auf Abfrage festgelegt.
Erstellen Sie das Abfragefeld mit einem dynamischen Ausdruck, sodass Sie den Parameter
SchemaNamein einer Abfrage verwenden können, die eine Liste der Zielquellentabellen zurückgibt. Wählen Sie Abfrage aus, und wählen Sie dann Dynamischen Inhalt hinzufügen aus.Dieser Ausdruck innerhalb der Lookup-Aktivität generiert eine SQL-Anweisung zur Abfrage der Systemansichten, um eine Liste von Schemas und Tabellen abzurufen. Er verweist auf den Parameter
SchemaName, um das Filtern von SQL-Schemata zu ermöglichen. Die Ausgabe dieses Ausdrucks ist ein Array von SQL-Schemata und Tabellen, die die ForEach-Aktivität als Eingabe verwendet.Verwenden Sie den folgenden Code, um eine Liste aller Benutzertabellen mit ihrem Schemanamen zurückzugeben.
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')

Pipelineentwurf: ForEach-Schleife
Konfigurieren Sie für die ForEach-Schleife die folgenden Optionen auf der Registerkarte Einstellungen:
- Deaktiviere Sequential, damit mehrere Iterationen gleichzeitig ausgeführt werden können.
- Setzen Sie Batch-Anzahl auf
50, um die maximale Anzahl der gleichzeitigen Iterationen zu begrenzen. - Verwenden Sie dynamische Inhalte im Items-Feld , um auf die Ausgabe der LookUp-Aktivität zuzuweisen. Verwenden Sie den folgenden Codeausschnitt:
@activity('Get List of Source Objects').output.value

Pipelineentwurf: Copy-Aktivität in der ForEach-Schleife
Fügen Sie in der ForEach-Aktivität eine Kopieraktivität hinzu. Diese Methode verwendet die Dynamic Expression Language innerhalb von Pipelines, um eine SELECT TOP 0 * FROM <TABLE> Anweisung zu erstellen, die nur das Schema ohne Daten in ein Warehouse migriert.
Auf der Registerkarte Quelle:
- Setzen Sie den Datenspeichertyp auf Extern.
- Die Verbindung ist Ihr dedizierter SQL-Pool in Azure Synapse. Verbindungstyp ist Azure Synapse Analytics.
- Legen Sie Abfrage verwenden auf Abfrage fest.
- Im Abfragefeld fügen Sie die dynamische Inhaltsanfrage ein und verwenden Sie diesen Ausdruck, der null Zeilen zurückgibt, aber das Tabellenschema enthält:
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)

Gehen Sie in der Registerkarte Ziel folgendermaßen vor:
- Setzen Sie den Datenspeichertyp auf Arbeitsbereich.
- Setzen Sie den Workspace-Datenspeichertyp auf Data Warehouse und setzen Sie das Data Warehouse auf das Warehouse.
- Das Schema und der Tabellenname der Zieltabelle werden mithilfe dynamischer Inhalte definiert.
- Schema bezieht sich auf das aktuelle Iterationsfeld
SchemaNamemit dem Ausschnitt:@item().SchemaName - Tabellenreferenzen
TableNamemit dem Snippet:@item().TableName
- Schema bezieht sich auf das aktuelle Iterationsfeld

Pipelineentwurf: Senke
Für Senke zeigen Sie auf Ihr Warehouse und verweisen auf das Quellschema und den Tabellennamen.
Wenn du diese Pipeline ausführst, siehst du, dass dein Warehouse mit jeder Tabelle in deinem Quellcode gefüllt wird, wobei das richtige Schema verwendet wird.
Migration mittels Verwendung gespeicherter Prozeduren im Synapse-dedizierten SQL-Pool
Diese Option verwendet gespeicherte Prozeduren, um die Migration zu Fabric Data Warehouse durchzuführen.
Sie können die Codebeispiele bei der Microsoft/Fabric-Migration auf GitHub.comabrufen. Dieser Code wird als Open Source freigegeben. Sie können also zur Zusammenarbeit beitragen und der Community helfen.
Was die Fabric Migration-Lagerverfahren leisten können:
- Konvertiere das Schema (DDL) in Fabric Data Warehouse Syntax.
- Erstellen Sie das Schema (DDL) auf Fabric Data Warehouse.
- Extrahieren Sie Daten aus dem dedizierten SQL-Pool von Synapse in ADLS.
- Markiere nicht unterstützte Fabric-Syntax für T-SQL-Codes (gespeicherte Prozeduren, Funktionen, Ansichten).
Empfohlene Verwendung
Diese Option ist ideal für Sie, wenn Sie:
- Mit T-SQL vertraut sind.
- Ich möchte eine integrierte Entwicklungsumgebung für T-SQL-Entwicklung verwenden.
- Ich möchte eine detailliertere Kontrolle darüber, an welchen Aufgaben du arbeitest.
Sie können die spezifische gespeicherte Prozedur für die Schemakonvertierung (DDL), den Datenextrakt oder die T-SQL-Codebewertung ausführen.
Für die Datenmigration verwenden Sie entweder COPY INTO oder Fabric Data Factory, um die Daten in Ihr Warehouse zu importieren.
Migration mit SQL-Datenbankprojekten
Fabric Data Warehouse unterstützt die SQL Database Projects-Erweiterung, die in Visual Studio Code verfügbar ist.
Diese Erweiterung ist in Visual Studio Code verfügbar. Dieses Feature ermöglicht Funktionen für Quellcodeverwaltung, Datenbanktests und Schemaüberprüfung.
Weitere Informationen zur Quellkontrolle finden Sie unter Entwicklung und Bereitstellungsübersicht.
Empfohlene Verwendung
Nutzen Sie diese Option, wenn Sie SQL Database Project für Ihre Bereitstellung verwenden möchten. Diese Option integriert die gespeicherten Fabric-Migrationsprozeduren in das SQL-Datenbankprojekt, um ein nahtloses Migrationserlebnis zu bieten.
Ein SQL-Datenbankprojekt kann:
- Konvertiere das Schema (DDL) in Fabric Data Warehouse Syntax.
- Erstellen Sie das Schema (DDL) auf Fabric Data Warehouse.
- Extrahieren Sie Daten aus dem dedizierten SQL-Pool von Synapse in ADLS.
- Nicht unterstützte Syntax für T-SQL-Codes (gespeicherte Prozeduren, Funktionen, Ansichten) markieren.
Für die Datenmigration verwenden Sie entweder COPY INTO oder Data Factory, um die Daten in Ihr Warehouse einzutragen.
Das Microsoft Fabric CAT-Team stellt PowerShell-Skripte bereit, um Schema (DDL) und Datenbankcode (DML) über ein SQL-Datenbankprojekt zu extrahieren, zu erstellen und bereitzustellen. Für einen Walkthrough siehe microsoft/fabric-migration auf GitHub.
Weitere Informationen zu SQL-Datenbankprojekten finden Sie unter "Erste Schritte mit der Erweiterung SQL-Datenbankprojekte " und "Erstellen eines Datenbankprojekts" über die Befehlszeile.
Migration von Daten mit CETAS
Der Befehl T-SQL CREATE EXTERNAL TABLE AS SELECT (CETAS) bietet die kosteneffizienteste und optimalste Methode, um Daten aus Azure Synapse dedizierten SQL-Pools für Azure Data Lake Storage (ADLS) Gen2 zu extrahieren.
Was CETAS tun kann:
- Daten nach ADLS extrahieren.
- Diese Option erfordert, dass du das Schema (DDL) in deinem Warehouse erstellst, bevor du die Daten einsprichst. Berücksichtigen Sie die Optionen in diesem Artikel zum Migrieren des Schemas (DDL).
Die Vorteile dieser Option sind:
- Die Migration sendet pro Tabelle nur eine einzige Abfrage an den dedizierten SQL-Pool der Quellinstanz von Synapse. Diese Abfrage belegt nicht alle Slots für die gleichzeitige Ausführung und blockiert weder parallel laufende ETL-Prozesse von Kunden in der Produktionsumgebung noch deren Abfragen.
- Du musst nicht auf DWU6000 skalieren, da pro Tabelle nur ein Parallelitäts-Slot verwendet wird, sodass du niedrigere DWUs verwenden kannst.
- Der Extrakt läuft parallel über alle Rechenknoten, und diese Funktion verbessert die Leistung.
Empfohlene Verwendung
Verwenden Sie CETAS, um die Daten als Parquet-Dateien in ADLS zu extrahieren. Parquet-Dateien bieten den Vorteil einer effizienten Datenspeicherung mit spaltenorientierter Komprimierung, die bei der Übertragung über das Netzwerk weniger Bandbreite benötigt. Da Fabric die Daten im Delta-Parquet-Format speichert, ist die Datenaufnahme 2,5-mal schneller als im Textdateiformat, da während der Aufnahme kein Overhead in das Delta-Format konvertiert wird.
So erhöhen Sie den CETAS-Durchsatz:
- Fügen Sie parallele CETAS Vorgänge hinzu, was die Nutzung von Parallelitätsslots erhöht, aber einen höheren Durchsatz ermöglicht.
- Skalierung der DWU auf dem dedizierten SQL-Pool von Synapse.
Migration über dbt
Dieser Abschnitt beschreibt die DBT-Option für Kunden, die bereits DBT in ihrer Synapse-dedizierten SQL-Pool-Umgebung verwenden.
Was dbt tun kann:
- Konvertiere das Schema (DDL) in Fabric Data Warehouse Syntax.
- Erstellen Sie das Schema (DDL) auf Fabric Data Warehouse.
- Konvertieren von Datenbankcode (DML) in Fabric-Syntax.
Das dbt-Framework generiert automatisch DDL- und DML-Skripts (SQL-Skripts) mit jeder Ausführung. Durch Verwendung von Modelldateien, die in SELECT Anweisungen ausgedrückt werden, übersetzt dbt das DDL/DML sofort auf jede Zielplattform, indem es das Profil (Verbindungszeichenfolge) und den Adaptertyp ändert.
Empfohlene Verwendung
Das DBT-Framework verwendet einen Code-First-Ansatz. Migrieren Sie die Daten über die in diesem Dokument aufgeführten Optionen, wie CETAS oder COPY/Data Factory.
Mit dem DBT-Adapter für Microsoft Fabric Data Warehouse können Sie bestehende DBT-Projekte, die auf verschiedene Plattformen abzielen, wie Azure Synapse dedizierte SQL-Pools, Snowflake, Databricks, Google BigQuery oder Amazon Redshift, mit einer einfachen Konfigurationsänderung auf ein Warehouse migrieren.
Um mit einem DBT-Projekt zu beginnen, das sich auf Fabric Data Warehouse abzielt, siehe Tutorial: DBT für Fabric Data Warehouse einrichten. Dieses Dokument enthält außerdem eine Möglichkeit, zwischen verschiedenen Lagern und Plattformen zu wechseln.
Datenaufnahme in Fabric Data Warehouse
Zum Laden in Fabric Data Warehouse verwenden Sie je nach Ihren Vorlieben COPY INTO oder Fabric Data Factory. Beide Methoden sind die empfohlenen und leistungsstärksten Optionen, da sie einen gleichwertigen Durchsatz bieten, vorausgesetzt, dass die Dateien bereits nach Azure Data Lake Storage (ADLS) Gen2 extrahiert wurden.
Gestalten Sie Ihren Prozess für maximale Leistung, indem Sie die folgenden Faktoren berücksichtigen:
- Bei Fabric gibt es keinen Ressourcenkonflikt, wenn mehrere Tabellen gleichzeitig von ADLS auf Fabric Data Warehouse geladen werden. Daher gibt es keine Leistungsbeeinträchtigung beim Laden paralleler Threads. Der maximale Aufnahmedurchsatz ist nur durch die Rechenleistung Ihrer Fabric-Kapazität begrenzt.
- Die Fabric-Workload-Verwaltung bietet eine Trennung der für Last und Abfragen zugewiesenen Ressourcen. Es gibt keinen Ressourcenkonflikt, während Abfragen und Datenladen gleichzeitig ausgeführt werden.
Verwandte Inhalte
- Fabric Migration Assistant für Data Warehouse
- Erstellen eines Warehouse in Microsoft Fabric
- Leistungsrichtlinien des Fabric Data Warehouse
- Sicherheit in Fabric Data Warehouse
- Blog: Zuordnung dedizierter SQL-Pools in Azure Synapse zur Rechenkapazität von Fabric Data Warehouse
- Übersicht über die Microsoft-Fabric-Migration