Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Gilt für: SQL ServerAzure SQL-DatenbankVerwaltete Azure SQL-InstanzSQL-Datenbank in Microsoft Fabric
Die SQL Server-Datenbank-Engine verarbeitet Abfragen für verschiedene Datenspeicherarchitekturen, z.B. lokale Tabellen, partitionierte Tabellen und über mehrere Server verteilte Tabellen. Die folgenden Abschnitte behandeln, wie die Datenbank-Engine Abfragen verarbeitet und die Wiederverwendung von Abfragen durch die Zwischenspeicherung von Ausführungsplänen optimiert.
Die Codebeispiele in diesem Artikel verwenden die AdventureWorks2025, AdventureWorksDW2025, oder AdventureWorksLT2025 Beispieldatenbank, die Sie aus dem Azure Data SQL Samples Repository GitHub-Repository herunterladen können.
Ausführungsmodi
Der SQL Server-Datenbank-Engine kann Transact-SQL (T-SQL)-Anweisungen mit zwei unterschiedlichen Verarbeitungsmodi verarbeiten:
- Zeilenmodusausführung
- Batch-Modus-Ausführung
Zeilenmodusausführung
Zeilenmodus-Ausführung ist eine Abfrageverarbeitungsmethode, die mit Rowstore-Tabellen und Indizes verwendet wird, bei der Daten im Zeilenformat gespeichert werden. Wenn eine Abfrage ausgeführt wird und auf Daten in Rowstore-Tabellen und -Indizes zugreift, lesen die Ausführungsbaum-Operatoren und Kindoperatoren jede erforderliche Zeile in allen im Objektschema angegebenen Spalten. Aus jeder gelesenen Zeile ruft die Datenbank-Engine dann die Spalten ab, die für die Ergebnismenge benötigt werden und auf die in einer JOIN Anweisung, einem SELECT Prädikat oder einem Filterprädikat verwiesen wird.
Hinweis
Die Ausführung des Zeilenmodus ist für OLTP-Szenarien sehr effizient, kann aber beim Scannen großer Datenmengen, zum Beispiel in Data Warehousing-Szenarien, weniger effizient sein.
Batch-Modus-Ausführung
Ausführung im Batchmodus ist eine Abfrageverarbeitungsmethode, die mehrere Zeilen gemeinsam verarbeitet (daher der Begriff Batch). Jede Spalte innerhalb eines Batchs wird als Vektor in einem separaten Bereich des Arbeitsspeichers gespeichert. Die Batchmodusverarbeitung ist also vektorbasiert. Die Batch-Mode-Verarbeitung verwendet außerdem Algorithmen, die für die fortgeschrittenen Befehlssätze und den erhöhten Speicherdurchsatz moderner Prozessoren optimiert sind.
Die Ausführung des Batch-Modus war ursprünglich in das Columnstore-Speicherformat integriert und darauf optimiert. Ab SQL Server 2019 (15.x) und in Azure SQL-Datenbank erfordert die Ausführung im Batch-Modus keine Columnstore-Indizes mehr. Weitere Informationen finden Sie unter Batchmodus bei Rowstore.
Die Verarbeitung im Batchmodus arbeitet, wenn möglich, mit komprimierten Daten und eliminiert den Austauschoperator , den die Zeilenmodus-Ausführung verwendet. Das Ergebnis ist eine bessere Parallelität und schnellere Leistung.
Wenn eine Abfrage im Batch-Modus ausgeführt wird und auf Daten in Spaltenspeicherindizes zugreift, lesen die Ausführungsbaum-Operatoren und Kindoperatoren mehrere Zeilen zusammen in Spaltensegmenten. Die Datenbank-Engine liest nur die für das Ergebnis erforderlichen Spalten, wie in einer JOIN Anweisung, einem SELECT Prädikat oder einem Filterprädikat angegeben. Weitere Informationen zu Columnstore-Indizes finden Sie unter Columnstore Index Architecture.
Hinweis
Die Ausführung im Batch-Modus ist sehr effizient für Data-Warehousing-Szenarien, in denen große Datenmengen gelesen und aggregiert werden können.
Verarbeiten von SQL-Anweisungen
Die Verarbeitung einer einzelnen T-SQL-Anweisung ist die grundlegendste Art, wie die Datenbank-Engine T-SQL-Anweisungen ausführt. Die folgenden Schritte veranschaulichen den Grundprozess, indem eine einzelne SELECT Anweisung verarbeitet wird, die nur lokale Basistabellen (keine Ansichten oder entfernte Tabellen) referenziert.
Rangfolge logischer Operatoren
Wenn Sie mehr als einen logischen Operator in einer Anweisung verwenden, werden NOT zuerst, dann AND und schließlich OR ausgewertet. Arithmetische und bitweise Operatoren werden vor logischen Operatoren behandelt. Weitere Informationen finden Sie unter Operatorrangfolge.
Im folgenden Beispiel gilt die Farbbedingung für das Produktmodell 21 und nicht für das Produktmodell 20, da AND Vorrang vor OR hat.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
Die Verwendung von Klammern, auch wenn sie nicht erforderlich sind, kann die Lesbarkeit von Abfragen verbessern und die Wahrscheinlichkeit von Fehlern aufgrund der Operatorpriorität verringern. Das folgende Beispiel ist lesbarer als das vorherige und hat dieselbe Bedeutung.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
Sie können die Bedeutung der Abfrage ändern, indem Sie Klammern hinzufügen, um die Auswertung des OR zuerst zu erzwingen. Die folgende Abfrage findet nur Produkte unter den Modellen 20 und 21, deren Farbe „red“ (rot) ist.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
Optimieren von SELECT-Anweisungen
Eine SELECT-Anweisung ist nicht prozedural; sie gibt nicht die genauen Schritte vor, die der Datenbankserver verwenden soll, um die angeforderten Daten abzurufen. Dieses deklarative Verhalten bedeutet, dass der Datenbankserver die Anweisung und die Datenbank analysieren muss, um die effizienteste Methode zur Extraktion der angeforderten Daten zu bestimmen. Dieser Prozess wird als Abfrageplan-Optimierung bezeichnet. Die Komponente, die diese Aufgabe ausführt, ist der Abfrageoptimierer. Die Eingabe für den Abfrageoptimierer besteht aus der Abfrage, dem Datenbankschema (Objektdefinitionen) und den Objektstatistiken. Die Ausgabe des Abfrageoptimierers ist ein Abfrageausführungsplan, der manchmal auch als Abfrageplan oder Ausführungsplan bezeichnet wird. Der Inhalt eines Ausführungsplans wird ausführlicher in Ausführungsplan-Caching und -wiederverwendung beschrieben.
Das folgende Diagramm veranschaulicht die Eingaben und Ausgaben des Query Optimizers während der Optimierung einer einzelnen SELECT Anweisung:
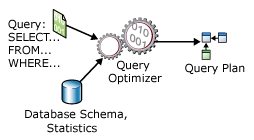
Eine Anweisung SELECT definiert nur:
- Das Format des Resultsets. Dieses wird meistens in der Auswahlliste angegeben. Das endgültige Format des Resultsets wird jedoch auch von anderen Klauseln, wie z.B.
ORDER BYundGROUP BY, beeinflusst. - Die Tabellen, die die Quelldaten enthalten. Dies wird in der
FROM-Klausel angegeben. - Die logischen Beziehungen zwischen den Tabellen, die für die
SELECT-Anweisung relevant sind. Dies ist im Join-Ausdruck definiert, der in der KlauselWHEREoder in einerON-Klausel erscheinen kann, die aufFROMfolgt. - Die Bedingungen, die die Zeilen in den Quelltabellen erfüllen müssen, um für die
SELECT-Anweisung qualifiziert zu sein. Diese werden in denWHERE- undHAVING-Klauseln angegeben.
Ein Abfrageausführungsplan definiert:
Die Reihenfolge des Zugriffs auf die Quelltabellen.
Typischerweise kann der Datenbankserver in vielen Reihenfolgen auf die Basistabellen zugreifen, um den Ergebnissatz zu erstellen. Wenn die
SELECT-Anweisung z.B. auf drei Tabellen verweist, könnte der Datenbankserver zuerst aufTableAzugreifen, dann die Daten ausTableAverwenden, um die entsprechenden Zeilen ausTableBzu extrahieren, und dann die Daten ausTableBverwenden, um Daten ausTableCzu extrahieren. Die anderen Abfolgen, in denen der Datenbankserver auf die Tabellen zugreifen kann, lauten:TableC,TableB,TableAoder
TableB,TableA,TableCoder
TableB,TableC,TableAoder
TableC,TableATableBDie Methoden, die verwendet werden, um Daten aus den einzelnen Tabellen zu extrahieren.
Für den Zugriff auf die Daten in den einzelnen Tabellen gibt es in der Regel unterschiedliche Methoden. Wenn nur wenige Zeilen mit bestimmten Schlüsselwerten benötigt werden, kann der Datenbankserver schnell Zeilen nachschlagen oder einen kleinen Indexbereich scannen. Wenn alle Zeilen in der Tabelle benötigt werden, kann der Datenbankserver stattdessen die gesamte Tabelle oder den gesamten Index scannen. Wenn alle Zeilen in einer Tabelle benötigt werden, aber es einen Index gibt, dessen Schlüsselspalten in einem
ORDER BYliegen, könnte ein Index-Scan statt eines Tabellen-Scans eine separate Sortierung der Ergebnismenge einsparen. Wenn eine Tabelle sehr klein ist, könnten vollständige Scans die effizienteste Methode für fast den gesamten Zugriff auf die Tabelle sein.Die Methoden, die für Berechnungen und zum Filtern, Aggregieren und Sortieren von Daten aus den einzelnen Tabellen verwendet werden.
Beim Zugriff auf Daten aus Tabellen führen verschiedene Methoden Berechnungen über Daten durch, wie zum Beispiel die Berechnung von Skalarwerten, und aggregieren und sortieren die Daten gemäß dem Abfragetext. Zum Beispiel bei Verwendung einer
GROUP BY- oderORDER BY-Klausel und wie man Daten filtert, zum Beispiel bei Verwendung einerWHERE- oderHAVING-Klausel.
Der Vorgang, in dessen Verlauf ein bestimmter Ausführungsplan aus einer Anzahl möglicher Ausführungspläne ausgewählt wird, wird Optimierung genannt. Der Abfrageoptimierer ist eine der wichtigsten Komponenten des Datenbank-Engine. Während der Abfrageoptimierer einen Teil des Overheads verwendet, um die Abfrage zu analysieren und einen Plan auszuwählen, wird dieser Overhead typischerweise um ein Vielfaches eingespart, wenn der Abfrageoptimierer einen effizienten Ausführungsplan auswählt. Nehmen Sie z. B. an, zwei Bauunternehmer erhalten dieselben Konstruktionszeichnungen für ein Haus. Wenn ein Unternehmen am Anfang ein paar Tage plant, wie das Haus gebaut werden soll, und das andere Unternehmen ohne Planung beginnt, ist das Unternehmen, das sich die Zeit nimmt, das Projekt zu planen, wahrscheinlich zuerst fertig.
Der Query Optimizer ist ein kostenbasierter Optimierer. Jeder denkbare Ausführungsplan verfügt über zugeordnete Kosten hinsichtlich des Umfangs der benötigten Verarbeitungsressourcen. Der Abfrageoptimierer muss die möglichen Pläne analysieren und den Plan auswählen, der die geringsten geschätzten Kosten verursacht. Einige komplexe Anweisungen haben tausende mögliche Ausführungspläne. In einem solchen Fall werden nicht alle denkbaren Kombinationen vom Abfrageoptimierer analysiert. Stattdessen werden komplexe Algorithmen verwendet, um einen Ausführungsplan zu ermitteln, dessen Kosten sich in vernünftigem Rahmen an die möglichen Mindestkosten annähern.
Der Query Optimizer wählt nicht unbedingt den Ausführungsplan mit den niedrigsten geschätzten Kosten aus. Es findet einen Plan mit einem angemessenen geschätzten Kostenwert innerhalb der zur Verfügung stehenden Optimierungszeit. Ein paralleler Ausführungsplan könnte mehr Ressourcen benötigen als ein sequentieller Plan und gleichzeitig die geschätzte verstrichene Zeit reduzieren.
Der SQL Server Query Optimizer stützt sich auf Statistiken, wenn er die Ressourcenkosten verschiedener Methoden zur Extraktion von Informationen aus einer Tabelle oder einem Index schätzt. Statistiken werden für Spalten und Indizes geführt und enthalten Informationen über die Dichte1 der zugrunde liegenden Daten. Diese Information zeigt die Selektivität der Werte in einem bestimmten Index oder einer bestimmten Spalte an. In einer Tabelle für Autos stammen z. B. viele Autos von demselben Hersteller, jedes Auto verfügt jedoch über eine eindeutige Fahrzeugnummer. Ein Index für das VIN-Objekt weist eine höhere Selektivität auf als ein Index für den Hersteller, da „VIN“ eine niedrigere Dichte als „Hersteller“ aufweist. Wenn die Indexstatistik nicht auf dem aktuellen Stand ist, wählt der Abfrageoptimierer möglicherweise nicht den Plan aus, der für den aktuellen Status der Tabelle am besten geeignet ist. Weitere Informationen zu Dichte finden Sie unter Statistik.
1 Dichte definiert die Verteilung von eindeutigen Werten, die in den Daten vorhanden sind, oder die durchschnittliche Anzahl doppelter Werte für eine bestimmte Spalte. Bei einer Verringerung der Dichte erhöht sich die Selektivität eines Werts.
Der Abfrageoptimierer ist wichtig, weil er es dem Datenbankserver ermöglicht, sich dynamisch an sich ändernde Bedingungen in der Datenbank anzupassen, ohne Eingaben eines Entwicklers oder Datenbankadministrators zu benötigen. Diese Funktion ermöglicht es Entwicklern, sich auf die Beschreibung des Endergebnisses der Abfrage zu konzentrieren. Sie können darauf vertrauen, dass der Abfrageoptimierer jedes Mal, wenn der Abfrageplan für eine Anweisung optimiert wird, einen effizienten Ausführungsplan für den Zustand der Datenbank erstellt.
Hinweis
SQL Server Management Studio verfügt über drei Optionen zum Anzeigen von Ausführungsplänen:
- Der geschätzte Ausführungsplan, also der vom Abfrageoptimierer erzeugte kompilierte Plan.
- Der tatsächliche Ausführungsplan, der derselbe ist wie der kompilierte Plan plus dessen Ausführungskontext. Dieser Kontext umfasst Laufzeitinformationen, die nach Abschluss der Ausführung verfügbar sind, wie zum Beispiel Ausführungswarnungen oder in neueren Versionen der Datenbank-Engine die verstrichene Zeit und die CPU-Zeit, die während der Ausführung verwendet wurden.
- Die Live Query Statistics sind identisch mit dem kompilierten Plan plus dessen Ausführungskontext. Dieser Kontext enthält Laufzeitinformationen während des Ausführungsfortschritts und wird jede Sekunde aktualisiert. Laufzeitinformationen umfassen beispielsweise die tatsächliche Anzahl der Zeilen, die durch die Operatoren fließen.
Verarbeiten einer SELECT-Anweisung
Die Datenbank-Engine verarbeitet eine einzelne SELECT Anweisung, indem sie folgende Schritte befolgt:
- Der Parser scannt die
SELECT-Anweisung und spaltet sie in ihre logischen Einheiten auf, wie z.B. Schlüsselwörter, Ausdrücke, Operatoren und Bezeichner. - Ein Abfragebaum, manchmal auch als Sequenzbaum bezeichnet, wird aufgebaut, der die logischen Schritte beschreibt, die erforderlich sind, um die Quelldaten in das vom Ergebnisset geforderte Format zu transformieren.
- Der Abfrageoptimierer analysiert verschiedene Möglichkeiten, auf die Quelltabellen zuzugreifen. Es wählt die Schrittfolge aus, die die Ergebnisse am schnellsten liefert und dabei weniger Ressourcen benötigt. Sie aktualisiert den Abfragebaum, um genau diese Abfolge von Schritten aufzuzeichnen. Die endgültige, optimierte Version der Abfragestruktur wird als Ausführungsplan bezeichnet.
- Die relationale Engine beginnt, den Plan auszuführen. Während sie Schritte verarbeitet, die Daten aus den Basistabellen benötigen, fordert sie die erforderlichen Zeilensätze von der Speicher-Engine an.
- Die relationale Engine transformiert die Daten, die von der Speicher-Engine zurückgegeben werden, in das für das Resultset definierte Format und gibt das Resultset an den Client zurück.
Reduktion konstanter Ausdrücke und Ausdrucksauswertung
Die Datenbank-Engine wertet bestimmte konstante Ausdrücke frühzeitig aus, um die Abfrageleistung zu steigern. Diese vom Query Optimizer verwendete Optimierungstechnik zielt darauf ab, Ausdrücke zur Kompilierungszeit und nicht zur Laufzeit zu vereinfachen. Es umfasst die Auswertung konstanter Ausdrücke während der Abfragekompilierung, sodass der resultierende Ausführungsplan effizienter ist. Dieser Prozess wird als Constant Folding bezeichnet. Eine Konstante ist ein T-SQL-Literal, wie z. B. 3, 'ABC', '2025-12-31', 1.0e3 oder 0x12345678. Nehmen Sie beispielsweise diese Abfrage an:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Hier ist 30 * 12 ein konstanter Ausdruck. Die Datenbank-Engine bewertet diesen Ausdruck während der Kompilierung und kann die Abfrage intern umschreiben als:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Faltbare Ausdrücke
Die Datenbank-Engine verwendet Konstantenfaltung mit den folgenden Ausdrückentypen:
- Arithmetische Ausdrücke wie
1 + 1und5 / 3 * 2, die nur Konstanten enthalten. - Logische Ausdrücke wie
1 = 1und1 > 2 AND 3 > 4, die nur Konstanten enthalten. - Eingebaute Funktionen, die die Datenbank-Engine als faltbar betrachtet, darunter
CASTundCONVERT. Im Allgemeinen ist eine intrinsische Funktion faltbar, wenn sie nur von ihren Eingaben abhängt und nicht von anderen kontextuellen Informationen wieSETOptionen, Spracheinstellungen, Datenbankoptionen und Verschlüsselungsschlüsseln. Nichtdeterministische Funktionen sind nicht faltbar. Deterministische integrierte Funktionen sind bis auf einige Ausnahmen reduzierbar. - Deterministische Methoden von CLR-benutzerdefinierten Typen und deterministische skalarwertige CLR-benutzerdefinierte Funktionen. Weitere Informationen finden Sie unter Konstantenfaltung für benutzerdefinierte CLR-Funktionen und -Methoden.
Hinweis
Eine Ausnahme wird für große Objekttypen gemacht. Wenn der Ausgabetyp des Faltungsprozesses ein großer Objekttyp ist (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json oder xml), faltet die Datenbank-Engine den Ausdruck nicht.
Nicht faltbare Ausdrücke
Alle anderen Ausdruckstypen sind nicht faltbar. Das gilt insbesondere für folgende Arten von Ausdrücken:
- Nicht konstante Ausdrücke, wie z. B. Ausdrücke, deren Ergebnisse vom Wert einer Spalte abhängig sind.
- Ausdrücke, deren Ergebnisse von einer lokalen Variable bzw. einem lokalen Parameter abhängig sind, wie z. B.
@x. - Nicht deterministische Funktionen.
- Benutzerdefinierte T-SQL-Funktionen.
- Ausdrücke, deren Ergebnisse von Spracheinstellungen abhängig sind.
- Ausdrücke, deren Ergebnisse von
SETOptionen abhängen. - Ausdrücke, deren Ergebnisse von Serverkonfigurationsoptionen abhängig sind.
Beispiele für faltbare und nicht faltbare konstante Ausdrücke
Betrachten Sie die folgende Abfrage:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Wenn die PARAMETERIZATION Datenbankoption für diese Abfrage nicht auf FORCED gesetzt ist, wird der Ausdruck 117.00 + 1000.00 ausgewertet und durch sein Ergebnis , 1117.00, ersetzt, bevor die Abfrage kompiliert wird. Vorteile dieser Konstantenfaltung umfassen:
- Der Ausdruck muss zur Laufzeit nicht mehrmals ausgewertet werden.
- Der Wert des Ausdrucks nach seiner Auswertung wird vom Abfrageoptimierer verwendet, um die Größe der Ergebnismenge des Abschnitts der Abfrage
TotalDue > 117.00 + 1000.00zu schätzen.
Andererseits, wenn dbo.f eine benutzerdefinierte skalare Funktion ist, wird der Ausdruck dbo.f(100) nicht gefaltet, weil die Datenbank-Engine keine Ausdrücke mit benutzerdefinierten Funktionen faltet, selbst wenn diese deterministisch sind. Für weitere Informationen zur Parametrisierung siehe Erzwungene Parameterisierung.
Ausdrucksauswertung
Außerdem werden bestimmte Ausdrücke, die zwar nicht zur Kompilierzeit ausgewertet werden, deren Argumente jedoch zur Kompilierzeit bekannt sind – unabhängig davon, ob es sich bei den Argumenten um Parameter oder Konstanten handelt – hinsichtlich der Größe ihrer Resultsets (Kardinalität) geschätzt. Dieser Vorgang ist ein Bestandteil der Optimierung.
Insbesondere werden folgende integrierte Funktionen und spezielle Operatoren zur Kompilierzeit ausgewertet, wenn alle diesbezüglichen Eingaben bekannt sind: UPPER, LOWER, RTRIM, DATEPART( YY only ), GETDATE, CAST und CONVERT. Die folgenden Operatoren werden ebenfalls zur Kompilierzeit ausgewertet, wenn alle diesbezüglichen Eingaben bekannt sind:
- Arithmetische Operatoren:
+,-,*,/, unärer Operator- - Logische Operatoren:
AND,OR,NOT - Vergleichsoperatoren:
<,>,<=,>=,<>,LIKE,IS NULL,IS NOT NULL
Während der Kardinalitätsschätzung wertet der Abfrageoptimierer keine anderen Funktionen oder Operatoren aus.
Beispiele für die Kompilierzeitausdrucksauswertung
Sehen Sie sich diese gespeicherte Prozedur an:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Während der Optimierung der SELECT-Anweisung der Prozedur versucht der Abfrageoptimierer, die erwartete Kardinalität des Resultsets für die Bedingung OrderDate > @d + 1 auszuwerten. Der Ausdruck @d + 1 wird nicht konstant gefaltet, da @d ein Parameter ist. Zum Zeitpunkt der Optimierung ist der Wert dieses Parameters jedoch bekannt. Dieser Wert ermöglicht es dem Abfrageoptimierer, die Größe des Ergebnissets genau abzuschätzen, was ihm hilft, einen guten Abfrageplan auszuwählen.
Betrachten Sie nun ein Beispiel, das dem vorherigen ähnelt, mit der Ausnahme, dass eine lokale Variable @d2 in der Abfrage ersetzt @d + 1 und der Ausdruck in einer SET Anweisung statt in der Abfrage ausgewertet wird.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Wenn die SELECT Anweisung in MyProc2 in der Datenbank-Engine optimiert wird, ist der Wert von @d2 nicht bekannt. Daher verwendet der Abfrageoptimierer eine Standardschätzung für die Selektivität von OrderDate > @d2 (in diesem Fall 30 Prozent).
Verarbeiten anderer Anweisungen
Die grundlegenden Schritte zur Verarbeitung einer SELECT Anweisung gelten für andere T-SQL-Anweisungen wie INSERT, UPDATE, und DELETE. Sowohl UPDATE- als auch DELETE-Anweisungen müssen die Zeilenmenge betreffen, die geändert oder gelöscht werden soll. Der Vorgang zum Identifizieren dieser Zeilen ist der gleiche Vorgang, der zum Identifizieren der Quellzeilen verwendet wird, die einen Beitrag zum Resultset einer SELECT -Anweisung leisten. Sowohl UPDATE- und INSERT-Anweisungen können eingebettete SELECT-Anweisungen enthalten, die die Datenwerte zum Aktualisieren oder Einfügen bereitstellen.
Sogar Data Definition Language (DDL)-Anweisungen, wie CREATE PROCEDURE oder ALTER TABLE, entsprechen einer Reihe von relationalen Operationen, die auf den Systemkatalogtabellen und manchmal (wie ALTER TABLE ADD COLUMN) auf den Datentabellen ausgeführt werden.
Arbeitstabellen
Die relationale Engine muss möglicherweise eine Arbeitstabelle erstellen, um eine logische Operation durchzuführen, die in einer T-SQL-Anweisung spezifiziert ist. Arbeitstabellen sind interne Tabellen, die Zwischenergebnisse speichern. Arbeitstabellen werden für bestimmte GROUP BY-, ORDER BY- oder UNION -Abfragen generiert. Wenn beispielsweise eine ORDER BY Klausel auf Spalten verweist, die von keinem Indizes abgedeckt sind, muss die relationale Engine möglicherweise eine Arbeitstabelle erstellen, um die Ergebnismenge in die gewünschte Reihenfolge zu sortieren. Arbeitstabellen werden mitunter auch als Spool-Speicher verwendet, die vorübergehend das Ergebnis der Ausführung eines Teils eines Abfrageplans aufnehmen. Arbeitstabellen werden in tempdb erstellt und dann automatisch gelöscht, wenn sie nicht mehr benötigt werden.
Bildschirmauflösung
Der Datenbank-Engine-Abfrageprozessor behandelt indexierte und nicht-indexierte Ansichten unterschiedlich:
- Die Datenbank speichert die Zeilen einer indexierten Ansicht im gleichen Format wie eine Tabelle. Wenn der Abfrageoptimierer entscheidet, eine indexierte Ansicht in einem Abfrageplan zu verwenden, behandelt er die indexierte Ansicht genauso wie eine Basistabelle.
- Nur die Definition einer nicht indizierten Sicht wird gespeichert, nicht die Zeilen der Sicht. Der Query Optimizer integriert die Logik aus der View-Definition in den Ausführungsplan, den er für die T-SQL-Anweisung erstellt, die auf die nicht indexierte Ansicht verweist.
Die Logik, die der Abfrageoptimierer verwendet, um zu entscheiden, wann eine indexierte Ansicht verwendet wird, ähnelt der Logik, die er verwendet, um zu entscheiden, wann ein Index für eine Tabelle verwendet wird. Wenn die Daten in der indexierten Ansicht die gesamte oder einen Teil der T-SQL-Anweisung abdecken und der Abfrageoptimierer feststellt, dass ein Index auf der Ansicht der kostengünstige Zugriffspfad ist, wählt er den Index unabhängig davon, ob die Abfrage die Ansicht namensgemäß referenziert.
Wenn eine T-SQL-Anweisung auf eine nicht-indexierte Ansicht verweist, analysieren Parser und Query Optimizer sowohl die Quelle der T-SQL-Anweisung als auch der Ansicht und lösen sie dann in einem einzigen Ausführungsplan auf. Die T-SQL-Anweisung und die Ansicht haben keine separaten Pläne.
Nehmen Sie z. B. an, dass die folgende Sicht verwendet wird:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Basierend auf dieser Ansicht führen beide T-SQL-Anweisungen die gleichen Operationen auf den Basistabellen aus und liefern die gleichen Ergebnisse:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
Die SQL Server Management Studio (SSMS) Showplan-Funktion zeigt, dass die relationale Engine denselben Ausführungsplan für beide dieser SELECT Anweisungen erstellt.
Verwenden von Hinweisen mit Sichten
Wenn du Hinweise auf Ansichten in einer Abfrage platzierst, könnten diese mit anderen Hinweisen kollidieren, die entdeckt werden, wenn die Ansicht sich erweitert, um auf ihre Basistabellen zuzugreifen. Wenn dieser Konflikt auftritt, liefert die Abfrage einen Fehler zurück. Zum Beispiel enthält die folgende Sicht einen Tabellenhinweis in ihrer Definition:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Nehmen Sie nun an, dass die folgende Abfrage eingegeben wird:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
Die Abfrage schlägt fehl, weil der SERIALIZABLE Hinweis auf der Person.AddrState Ansicht sowohl auf die Person.Address Tabellen als auch auf die Person.StateProvince-Tabellen übertragen wird, wenn sie erweitert wird. Das Erweitern der Sicht legt jedoch außerdem den NOLOCK -Hinweis für Person.Addressoffen. Da die SERIALIZABLE - und NOLOCK -Hinweise einen Konflikt verursachen, ist die sich ergebende Abfrage falsch.
Die Tabellenhinweise NOLOCK, ROWLOCK, TABLOCK, TABLOCKX und PAGLOCK stehen miteinander im Konflikt, ebenso wie die Tabellenhinweise NOLOCK, READCOMMITTED, REPEATABLEREAD, SERIALIZABLE und HOLDLOCK.
Hinweise können über die Ebenen geschachtelter Ansichten weitergereicht werden. Angenommen, eine Abfrage wendet den HOLDLOCK -Hinweis auf eine v1-Sicht an. Wenn v1 erweitert wird, stellt man fest, dass diese Ansicht v2 Teil ihrer Definition ist. Die Definition von v2 enthält einen NOLOCK-Hinweis auf eine seiner Basistabellen. Diese Tabelle erbt jedoch außerdem den Hinweis HOLDLOCK für die Sicht v1 von der Abfrage. Da die NOLOCK - und HOLDLOCK -Hinweise einen Konflikt verursachen, führt die Abfrage zu einem Fehler.
Wenn du den FORCE ORDER Hinweis in einer Abfrage verwendest, die eine Ansicht enthält, bestimmt die Position der Ansicht im geordneten Konstrukt die Join-Reihenfolge der Tabellen innerhalb der Ansicht. Die folgende Abfrage trifft z. B. eine Auswahl aus drei Tabellen und einer Sicht:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
Und View1 ist definiert, wie im folgenden Beispiel gezeigt:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
Die Joinreihenfolge im Abfrageplan lautet Table1, Table2, TableA, TableB, Table3.
Auflösen von Indizes für Sichten
Wie bei jedem Index verwendet die Datenbank-Engine eine indexierte Ansicht in ihrem Abfrageplan nur, wenn der Query Optimizer dies für vorteilhaft hält.
Sie können in jeder Edition der Datenbank-Engine indexierte Ansichten erstellen. In einigen Editionen berücksichtigt der Query Optimizer automatisch die indexierte Ansicht, während man in anderen Editionen den NOEXPAND Tabellenhinweis verwenden muss. Die automatische Nutzung einer indexierten Ansicht durch den Query Optimizer wird nur in bestimmten Editionen des SQL Server unterstützt.
Hinweis
Die Azure SQL-Datenbank und Azure SQL Managed Instance unterstützen die automatische Verwendung von indizierten Sichten ohne Angabe des NOEXPAND-Hinweises.
Der Abfrageoptimierer verwendet eine indizierte Ansicht, wenn die folgenden Bedingungen erfüllt sind:
- Die folgenden Sitzungsoptionen sind auf
ONfestgelegt:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
- Die Sitzungsoption
NUMERIC_ROUNDABORTist aufOFFgestellt. - Der Abfrageoptimierer findet eine Übereinstimmung zwischen den Ansichtsindex-Spalten und Elementen in der Abfrage, wie zum Beispiel:
- Prädikate der Suchbedingung in der
WHEREAnweisung - Joinvorgänge
- Aggregatfunktionen
-
GROUP BYKlauseln - Tabellenverweise
- Prädikate der Suchbedingung in der
- Die geschätzten Kosten für das Verwenden des Indexes sind die niedrigsten Kosten aller durch den Abfrageoptimierer berücksichtigten Zugriffsmechanismen.
- Für jede Tabelle, auf die in der Abfrage verwiesen wird (entweder direkt oder durch Erweitern einer Sicht zum Zugriff auf die zugrunde liegenden Tabellen), die einem Tabellenverweis in der indizierten Sicht entspricht, muss derselbe Satz von Hinweisen in der Abfrage angewendet werden.
Hinweis
Die READCOMMITTED - und READCOMMITTEDLOCK -Hinweise werden in diesem Kontext immer als unterschiedliche Hinweise angesehen, unabhängig von der aktuellen Transaktionsisolationsstufe.
Abweichend von den Anforderungen für die SET-Optionen und Tabellenhinweise verwendet der Abfrageoptimierer hier dieselben Regeln, mit denen er ermittelt, ob ein Tabellenindex eine Abfrage erfüllt. Sie müssen in der Abfrage nichts anderes angeben, damit eine indexierte Ansicht verwendet werden kann.
Eine Abfrage muss nicht explizit in der FROM-Klausel auf eine indizierte Sicht verweisen, damit der Abfrageoptimierer die indizierte Sicht verwendet. Falls die Abfrage Verweise auf Spalten in den Basistabellen enthält, die auch in der indizierten Sicht vorhanden sind, und der Abfrageoptimierer schätzt, dass das Verwenden der indizierten Sicht den kostengünstigsten Zugriffsmechanismus darstellt, wählt der Abfrageoptimierer die indizierte Sicht aus. Die Vorgehensweise ist dabei ähnlich wie bei der Auswahl von Basistabellenindizes, wenn in einer Abfrage nicht direkt auf diese verwiesen wird. Der Abfrageoptimierer kann die Sicht auswählen, wenn sie Spalten enthält, auf die die Abfrage nicht verweist – vorausgesetzt die Sicht bietet die kostengünstigste Möglichkeit zum Abdecken mindestens einer Spalte, die in der Abfrage angegeben ist.
Der Abfrageoptimierer behandelt eine indizierte Sicht, auf die in der FROM-Klausel verwiesen wird, als Standardsicht. Der Abfrageoptimierer erweitert am Beginn des Optimierungsprozesses die Definition der Sicht in die Abfrage. Dann erfolgt der Abgleich der indexierten Ansicht. Die indizierte Sicht kann im endgültigen Ausführungsplan verwendet werden, der vom Abfrageoptimierer ausgewählt wird, oder stattdessen kann der Plan die erforderlichen Daten aus der Sicht materialisieren, indem auf die Basistabellen zugegriffen wird, auf die durch die Sicht verwiesen wird. Der Abfrageoptimierer wählt die kostengünstigste Alternative aus.
Einsatz von Hinweisen bei indizierten Ansichten
Sie können verhindern, dass Sichtindizes für eine Abfrage verwendet werden, indem Sie den EXPAND VIEWS -Abfragehinweis verwenden oder indem Sie mit dem NOEXPAND -Tabellenhinweis die Verwendung eines Indexes für eine indizierte Sicht erzwingen, die in der FROM -Klausel einer Abfrage angegeben ist. Sie sollten jedoch den Abfrageoptimierer für jede Abfrage dynamisch ermitteln lassen, welches die besten Zugriffsmethoden sind. Verwenden Sie EXPAND und NOEXPAND nur in bestimmten Fällen, wenn Tests gezeigt haben, dass durch sie die Leistung deutlich gesteigert wird.
Die Option
EXPAND VIEWSgibt an, dass der Abfrageoptimierer für die gesamte Abfrage keine Sichtindizes verwendet.Wenn Sie für eine Ansicht
NOEXPANDangeben, zieht der Abfrageoptimierer die Verwendung aller auf der Ansicht definierten Indizes in Betracht.NOEXPANDmit der optionalenINDEX()-Klausel zwingt den Abfrageoptimierer, die angegebenen Indizes zu verwenden. Man kann nur für eine indexierte Ansicht angebenNOEXPANDund nicht für eine Ansicht, die nicht indexiert ist. Die automatische Nutzung einer indexierten Ansicht durch den Query Optimizer wird nur in bestimmten Editionen des SQL Server unterstützt.Hinweis
Die Azure SQL-Datenbank und Azure SQL Managed Instance unterstützen die automatische Verwendung von indizierten Sichten ohne Angabe des
NOEXPAND-Hinweises.
Wenn weder NOEXPAND noch EXPAND VIEWS in einer Abfrage angegeben ist, die eine Sicht enthält, wird die Sicht erweitert, um auf die zugrunde liegenden Tabellen zuzugreifen. Wenn die Abfrage, die die Sicht bildet, irgendwelche Tabellenhinweise enthält, werden diese Hinweise auch an die zugrunde liegenden Tabellen weitergegeben. (Dieser Vorgang wird in View Resolution ausführlicher erklärt.) Solange die Menge der Hinweise, die in den zugrundeliegenden Tabellen der Ansicht vorhanden sind, identisch ist, kann die Abfrage mit einer indizierten Ansicht abgeglichen werden. Meistens stimmen diese Hinweise miteinander überein, weil sie direkt aus der Ansicht übernommen werden. Wenn die Abfrage jedoch auf Tabellen und nicht auf Sichten verweist und die direkt auf diese Tabellen angewendeten Hinweise nicht identisch sind, kommt eine solche Abfrage nicht für den Abgleich mit einer indizierten Sicht infrage. Wenn die Hinweise INDEX, PAGLOCK, ROWLOCK, TABLOCKX, UPDLOCKoder XLOCK auf die Tabellen angewendet werden, auf die die Abfrage nach der Sichterweiterung verweist, kommt die Abfrage nicht für den Abgleich mit einer indizierten Sicht infrage.
Wenn ein Tabellenhinweis in Form von INDEX ( index_val [ ,...n] ) auf eine Sicht in einer Abfrage verweist und Sie nicht gleichzeitig den NOEXPAND-Hinweis angeben, wird der Indexhinweis ignoriert. Zum Angeben eines bestimmten Indexes verwenden Sie NOEXPAND.
Im Allgemeinen wendet der Abfrageoptimierer, wenn er eine indexierte Ansicht einer Abfrage zuordnet, alle Hinweise an, die in den Tabellen oder Ansichten der Abfrage angegeben sind, direkt auf die indexierte Ansicht an. Wenn der Abfrageoptimierer sich entscheidet, eine indizierte Ansicht nicht zu verwenden, gibt er Hinweise direkt an die in der Ansicht referenzierten Tabellen weiter. Für weitere Informationen siehe Auflösung anzeigen. Diese Verteilung gilt nicht für Joinhinweise. Diese werden ausschließlich an ihrer ursprünglichen Position in der Abfrage angewendet. Der Query Optimizer berücksichtigt keine Join-Hinweise, wenn er Anfragen mit indexierten Ansichten abgleicht. Wenn ein Abfrageplan eine indizierte Ansicht verwendet, die mit einem Teil einer Abfrage übereinstimmt, die einen Join-Hinweis enthält, wird der Join-Hinweis im Plan nicht verwendet.
In den Definitionen indizierter Sichten sind Hinweise nicht zulässig. Die Datenbank-Engine ignoriert Hinweise innerhalb von indexierten Ansichtsdefinitionen bei deren Pflege oder bei der Ausführung von Abfragen, die indexierte Ansichten verwenden.
Weitere Informationen finden Sie unter Tabellenhinweise.
Auflösen verteilter partitionierter Sichten
Der Datenbank-Engine-Abfrageprozessor optimiert die Leistung verteilter partitionierter Ansichten. Der wichtigste Aspekt bei der Leistung von verteilten partitionierten Sichten ist das Minimieren der Datenmenge, die zwischen den Mitgliedsservern übertragen wird.
Die Datenbank-Engine erstellt intelligente, dynamische Pläne, die verteilte Abfragen effizient nutzen, um auf Daten aus entfernten Mitgliedstabellen zuzugreifen:
- Zunächst verwendet der Abfrageprozessor OLE DB, um die Definitionen der CHECK-Einschränkungen aus jeder Mitgliedstabelle abzurufen. Diese Methode ermöglicht es dem Abfrageprozessor, die Verteilung der Schlüsselwerte über die Mitgliedstabellen abzubilden.
- Der Abfrageprozessor vergleicht die in einer
WHERE-Klausel einer T-SQL-Anweisung angegebenen Schlüsselbereiche mit der Karte, die zeigt, wie die Zeilen in den Mitgliedstabellen verteilt sind. Der Abfrageprozessor erstellt dann einen Abfrageausführungsplan, der verteilte Abfragen verwendet, um nur jene entfernten Zeilen abzurufen, die zur Ausführung der T-SQL-Anweisung erforderlich sind. Der Ausführungsplan ist zudem so aufgebaut, dass jeglicher Zugriff auf entfernte Mitgliedstabellen, sei es für Daten oder Metadaten, verzögert wird, bis die Informationen benötigt werden.
Stellen Sie sich z. B. ein System vor, in dem eine Customers-Tabelle über Server1 (CustomerID von 1 bis 3299999), Server2 (CustomerID von 3300000 bis 6599999) und Server3 (CustomerID von 6600000 bis 9999999) partitioniert ist.
Stellen Sie sich den Ausführungsplan vor, der für diese auf Server1 ausgeführte Abfrage erstellt wird:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
Der Ausführungsplan für diese Abfrage extrahiert die Zeilen mit CustomerID -Schlüsselwerten von 3200000 bis 3299999 aus der lokalen Mitgliedstabelle und gibt eine verteilte Abfrage aus, um die Zeilen mit Schlüsselwerten von 3300000 bis 3400000 von Server2 abzurufen.
Der Datenbank-Engine Query Processor kann außerdem dynamische Logik in Abfrageausführungspläne für T-SQL-Anweisungen einbauen, bei denen die Schlüsselwerte nicht bekannt sind, wenn der Plan erstellt werden muss. Sehen Sie sich z.B. diese gespeicherte Prozedur an:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
Die Datenbank-Engine kann nicht vorhersagen, welcher Schlüsselwert jedes Mal durch den Parameter @CustomerIDParameter bereitgestellt wird, wenn das Verfahren ausgeführt wird. Da der Schlüsselwert nicht vorhergesagt werden kann, kann der Abfrageprozessor auch nicht vorhersagen, auf welche Mitgliedstabelle er zugreifen muss. Um diesen Fall zu behandeln, erstellt die Datenbank-Engine einen Ausführungsplan mit bedingter Logik, sogenannte dynamische Filter, um zu steuern, auf welche Mitgliedstabelle basierend auf dem Eingabeparameterwert zugegriffen wird. Angenommen, die gespeicherte GetCustomer Prozedur wurde auf Server1 ausgeführt, kann die Ausführungsplanlogik wie in folgender Ausgabe dargestellt werden:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
Die Datenbank-Engine erstellt manchmal solche dynamischen Ausführungspläne sogar für Abfragen, die nicht parametrisiert sind. Der Abfrageoptimierer kann eine Abfrage parametrisieren, sodass der Ausführungsplan wieder verwendet werden kann. Wenn der Query Optimizer eine Abfrage parametrisiert, die auf eine partitionierte Ansicht verweist, kann der Query Optimizer nicht mehr davon ausgehen, dass die erforderlichen Zeilen aus einer bestimmten Basistabelle stammen. Anschließend muss es dynamische Filter im Ausführungsplan verwenden.
Ausführung von gespeicherten Prozeduren und Triggern
Die Datenbank-Engine speichert nur die Quellcode für gespeicherte Prozeduren und Trigger. Wenn eine gespeicherte Prozedur oder ein Trigger das erste Mal ausgeführt wird, wird die Quelle zu einem Ausführungsplan kompiliert. Wenn die gespeicherte Prozedur oder der Trigger erneut ausgeführt wird, bevor der Ausführungsplan aus dem Arbeitsspeicher entfernt wurde, erkennt die relationale Engine den vorhandenen Plan und verwendet ihn erneut. Wenn der Plan aus dem Speicher verdrängt wird, wird ein neuer Plan erstellt. Dieser Prozess ähnelt dem Prozess, dem die Datenbank-Engine für alle T-SQL-Anweisungen folgt. Der Hauptleistungsvorteil, den gespeicherte Prozeduren und Trigger in der Datenbank-Engine im Vergleich zu Chargen dynamischer T-SQL haben, besteht darin, dass ihre T-SQL-Anweisungen immer gleich sind. Aus diesem Grund können sie durch die relationale Engine auf einfache Weise vorhandenen Ausführungsplänen zugeordnet werden. Pläne für gespeicherte Prozeduren und Trigger können einfach erneut verwendet werden.
Der Ausführungsplan für gespeicherte Prozeduren und Trigger wird getrennt von dem Ausführungsplan für den Batch ausgeführt, der die gespeicherte Prozedur aufruft oder den Trigger auslöst. Diese Trennung ermöglicht eine stärkere Wiederverwendung der gespeicherten Prozedur- und Trigger-Ausführungspläne.
Zwischenspeichern und Wiederverwenden von Ausführungsplänen
Die Datenbank-Engine verwendet Speicher, um sowohl Ausführungspläne als auch Datenpuffer zu speichern. Der Prozentsatz des Speichers, der für Ausführungspläne oder Datenpuffer zugewiesen wird, wird dynamisch angepasst, abhängig vom Systemzustand. Der Teil des Speichers, der Ausführungspläne speichert, wird als Plan-Cache bezeichnet.
Plan-Cache-Speicher
Der Plancache enthält zwei Speicher für alle kompilierten Pläne:
- Der Object Plans Cache-Speicher (OBJCP) ist für Pläne im Zusammenhang mit gespeicherten Objekten wie gespeicherten Prozeduren, Funktionen und Triggern bestimmt.
- Der SQL Plans Cache Store (SQLCP) ist für Pläne im Zusammenhang mit autoparametrisierten, dynamischen oder vorbereiteten Abfragen vorgesehen.
Die folgende Abfrage liefert Informationen über den Speicherverbrauch dieser beiden Cache-Stores:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
Der Plan-Cache hat zwei zusätzliche Stores, die keine Pläne speichern:
- Der Bound Trees-Cache-Speicher (PHDR) speichert Datenstrukturen, die während der Plankompilierung für Ansichten, Einschränkungen und Standardeinstellungen verwendet werden. Diese Strukturen werden als gebundene Bäume oder Algebrizerbäume bezeichnet.
- Der Cachespeicher „Extended Stored Procedures“ (XPROC) für vordefinierte Systemprozeduren wie sp_executesql oder xp_cmdshell. Diese gespeicherten Prozeduren verwenden eine DLL anstelle von T-SQL-Anweisungen. Die zwischengespeicherte Struktur enthält nur den Funktionsnamen und den DLL-Namen, in der die Prozedur implementiert ist.
Komponenten des Ausführungsplans
Die Ausführungspläne der Datenbank-Engine bestehen aus folgenden Hauptkomponenten:
Kompilierter Plan (oder Abfrageplan)
Der vom Kompilierungsprozess erstellte Abfrageplan ist größtenteils eine wiedereintrittsfähige, schreibgeschützte Datenstruktur, die von einer beliebigen Anzahl an Benutzern verwendet werden kann. Diese speichert Informationen über:
Physische Operatoren implementieren den durch logische Operatoren beschriebenen Vorgang.
Die Reihenfolge dieser Operatoren, die bestimmt, in welcher Reihenfolge auf Daten zugegriffen, gefiltert und aggregiert werden.
Die Anzahl der geschätzten Zeilen, die die Operatoren durchlaufen.
Hinweis
Der Abfrageplan speichert außerdem Informationen über die Statistikobjekte, die für die Kardinalitätsschätzung verwendet werden.
Welche Unterstützungsobjekte erstellt werden müssen, z. B. Arbeitstabellen oder Arbeitsdateien in
tempdb.
Der Abfrageplan speichert keinen Benutzerkontext oder Laufzeitinformation. Die Datenbank-Engine bestimmt bei jedem Abruf eines Plans aus dem Plan-Cache die Anzahl der Worker-Threads. Ein zwischengespeicherter Parallelplan kann auch seriell ausgeführt werden.
Ausführungskontext
Jeder Nutzer, der die Abfrage aktuell ausführt, verfügt über eine Datenstruktur, die die spezifischen Daten für seine Ausführung enthält, wie zum Beispiel Parameterwerte. Diese Datenstruktur wird als Ausführungskontext bezeichnet. Die Datenstrukturen des Ausführungskontexts werden wiederverwendet, aber nicht ihr Inhalt. Wenn ein anderer Benutzer dieselbe Abfrage ausführt, werden die Datenstrukturen mit dem Kontext für den neuen Benutzer nochmal initialisiert.
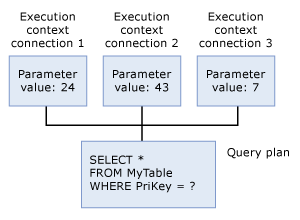
Pläne für identische Aussagen wiederverwenden
Wenn die Datenbank-Engine eine T-SQL-Anweisung ausführt, durchsucht sie zunächst den Plan-Cache, um zu überprüfen, ob ein bestehender Ausführungsplan für dieselbe T-SQL-Anweisung existiert. Die T-SQL-Anweisung gilt als vorhanden, wenn sie buchstäblich mit einer zuvor ausgeführten T-SQL-Anweisung mit zwischengespeichertem Plan übereinstimmt, Zeichen für Zeichen. Die Datenbank-Engine verwendet jeden vorhandenen Plan wieder, den sie findet, und spart so den Aufwand für die Neukompilierung der T-SQL-Anweisung. Wenn kein Ausführungsplan existiert, generiert die Datenbank-Engine einen neuen Ausführungsplan für die Abfrage.
Hinweis
Der Plan-Cache behält keine Ausführungspläne für einige T-SQL-Anweisungen bei, wie etwa Bulk-Operation-Anweisungen, die auf Rowstore ausgeführt werden, oder Anweisungen mit großen String-Literalen. Diese Pläne existieren nur, während die Abfrage läuft.
Die Datenbank-Engine verwendet einen effizienten Algorithmus, um bestehende Ausführungspläne für eine bestimmte T-SQL-Anweisung zu finden. In den meisten Systemen sind die minimalen Ressourcen, die dieser Scan verbraucht, geringer als die Ressourcen, die durch die Wiederverwendung bestehender Pläne gespart werden, anstatt jede T-SQL-Anweisung zu kompilieren.
Die Algorithmen, um neue T-SQL-Anweisungen mit bestehenden, ungenutzten Ausführungsplänen im Plan-Cache abzugleichen, erfordern, dass alle Objektreferenzen vollständig qualifiziert sind. Zum Beispiel nehmen wir an, dass Person das Standardschema für den Benutzer ist, der die folgenden SELECT Anweisungen ausführt. Obwohl in diesem Beispiel die Tabelle Person nicht vollständig qualifiziert werden muss, damit die Ausführung möglich ist, bedeutet dies, dass die zweite Anweisung keinem vorhandenen Ausführungsplan entspricht, die dritte Anweisung jedoch entspricht:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Das Ändern einer der folgenden SET Optionen für eine bestimmte Ausführung beeinflusst die Möglichkeit, Pläne wiederzuverwenden, da die Datenbank-Engine Konstantenfaltung durchführt und diese Optionen die Ergebnisse solcher Ausdrücke beeinflussen:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Zwischenspeichern mehrerer Pläne für dieselbe Abfrage
Abfragen und Ausführungspläne sind in Datenbank-Engine eindeutig identifizierbar, ähnlich wie bei einem Fingerabdruck:
- Der Abfrageplanhash ist ein binärer Hashwert, der im Ausführungsplan für eine jeweilige Abfrage berechnet und dann zur eindeutigen Identifizierung ähnlicher Ausführungspläne verwendet wird.
- Der Abfragehash ist ein binärer Hashwert, der auf dem T-SQL-Text einer Abfrage berechnet wird und verwendet wird, um Abfragen eindeutig zu identifizieren.
Sie können einen kompilierten Plan aus dem Plan-Cache mit einem Plan-Handle abrufen. Diese transiente Kennung bleibt nur konstant, solange der Plan im Cache bleibt. Der Planhandle ist ein Hashwert, der vom kompilierten Plan des gesamten Batches abgeleitet wurde. Der Plan-Handle für einen kompilierten Plan bleibt gleich, selbst wenn eine oder mehrere Anweisungen im Batch neu kompiliert werden.
Hinweis
Wenn Sie einen Plan für einen Batch statt eines einzelnen Statements erstellen, können Sie den Planhandle und Statement-Offsets verwenden, um den Plan für einzelne Statements im Batch zu erhalten.
Das sys.dm_exec_requests DMV enthält die Spalten statement_start_offset und statement_end_offset für jeden Datensatz. Diese Spalten beziehen sich auf die der aktuell ausgeführten Anweisung eines aktuell ausgeführten Batches oder gespeicherten Objekts. Weitere Informationen finden Sie unter sys.dm_exec_requests.
Das sys.dm_exec_query_stats DMV enthält diese Spalten ebenfalls für jeden Datensatz. Diese Spalten beziehen sich auf die Position einer Anweisung innerhalb eines Batches oder persistierten Objekts. Weitere Informationen finden Sie unter sys.dm_exec_query_stats.
Der eigentliche T-SQL-Text eines Batches wird in einem separaten, vom Plan-Cache getrennten Speicherbereich gespeichert, dem sogenannten SQL Manager Cache (SQLMGR). Man kann den T-SQL-Text für einen kompilierten Plan aus dem SQL-Manager-Cache mit einem SQL-Handle abrufen. Dieser Transient-Identifikator bleibt nur konstant, solange mindestens ein Plan, der auf ihn referenziert, im Plan-Cache verbleibt. Der SQL-Handle ist ein Hashwert, der aus dem gesamten Batch-Text abgeleitet wird und garantiert für jeden Batch einzigartig ist.
Hinweis
Wie bei einem kompilierten Plan wird der T-SQL-Text pro Batch gespeichert, einschließlich der Kommentare. Der SQL-Handle enthält den MD5-Hash des gesamten Batch-Textes und ist garantiert für jeden Batch eindeutig.
Die folgende Abfrage liefert Informationen über die Speichernutzung des SQL-Manager-Caches:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Zwischen einem SQL-Handle und mehreren Plan-Handles besteht eine 1:n-Beziehung. Dieser Zustand tritt auf, wenn der Cache-Schlüssel für die kompilierten Pläne anders ist. Dieser Unterschied kann durch Änderungen in den SET Optionen zwischen zwei Ausführungen desselben Batches entstehen.
Sehen Sie sich die folgende gespeicherte Prozedur an:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Überprüfen Sie, was Sie im Plan-Cache finden können, mit folgender Abfrage:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Hier ist das Ergebnis.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Führt nun die gespeicherte Prozedur mit einem anderen Parameter aus, ohne weitere Änderungen am Ausführungskontext:
EXECUTE usp_SalesByCustomer 8;
GO
Überprüfe erneut, was du im Plan-Cache finden kannst. Hier ist das Ergebnis.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Beachten Sie, dass der usecounts Wert auf 2 ansteigt, was bedeutet, dass derselbe zwischengespeicherte Plan unverändert wiederverwendet wird, weil die Ausführungskontext-Datenstrukturen wiederverwendet werden. Ändere nun die SET ANSI_DEFAULTS Option und führe die gespeicherte Prozedur mit demselben Parameter aus.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Überprüfe erneut, was du im Plan-Cache finden kannst. Hier ist das Ergebnis.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Beachten Sie, dass nun zwei Einträge in der DMV-Ausgabe von sys.dm_exec_cached_plans enthalten sind.
- Die Spalte
usecountszeigt den Wert1im ersten Datensatz. Dieser Wert repräsentiert den Plan, der einmal mitSET ANSI_DEFAULTS OFFausgeführt wird. - Die Spalte
usecountszeigt den Wert2im zweiten Datensatz. Dieser Wert repräsentiert den Plan, der mitSET ANSI_DEFAULTS ONausgeführt wurde, da er zweimal ausgeführt wurde. - Die unterschiedlichen
memory_object_address-Werte beziehen sich auf verschiedene Ausführungsplaneinträge im Plancache. Dersql_handle-Wert gilt jedoch für beide Einträge, weil sie sich auf denselben Batch beziehen.- Die Ausführung mit auf
OFFgesetztemANSI_DEFAULTShat ein neuesplan_handle, und es ist für Aufrufe mit denselbenSETOptionen zur Wiederverwendung verfügbar. Das neue Planhandle ist erforderlich, da der Ausführungskontext aufgrund geänderterSETOptionen erneut initialisiert wurde. Aber diese Änderung löst keine Neukompilierung aus: Beide Einträge beziehen sich auf denselben Plan und dieselbe Abfrage, wie die gleichenquery_plan_hashundquery_hashWerte zeigen.
- Die Ausführung mit auf
Diese Situation bedeutet, dass Sie zwei Planeinträge im Cache haben, die derselben Charge entsprechen. Es unterstreicht, wie wichtig es ist, sicherzustellen, dass die den Plan-Cache beeinflussenden SET Optionen gleich sind, wenn dieselben Abfragen wiederholt ausgeführt werden. Dieser Ansatz optimiert die Wiederverwendung von Plänen und hält die Größe des Plan-Caches auf das erforderliche Minimum.
Tipp
Ein allgemeiner Fall ist, dass unterschiedliche Clients unterschiedliche Standardwerte für die SET Optionen aufweisen können. Zum Beispiel wird bei einer Verbindung, die über SQL Server Management Studio hergestellt wird, QUOTED_IDENTIFIER automatisch auf ON gesetzt, während SQLCMD QUOTED_IDENTIFIER auf OFF setzt. Die Ausführung derselben Abfragen von diesen beiden Clients führt zu mehreren Plänen (wie im vorherigen Beispiel beschrieben).
Entfernen von Ausführungsplänen aus dem Plancache
Ausführungspläne bleiben im Plan-Cache, solange genug Speicher vorhanden ist, um sie zu speichern. Wenn Speichermangel besteht, verwendet die SQL Server-Datenbank-Engine einen kostenbasierten Ansatz, um zu entscheiden, welche Ausführungspläne aus dem Plan-Cache entfernt werden. Um eine kostenbasierte Entscheidung zu treffen, erhöht und verringert die SQL Server-Datenbank-Engine für jeden Ausführungsplan eine aktuelle Kostenvariable basierend auf den folgenden Faktoren.
Wenn ein Benutzerprozess einen Ausführungsplan in den Cache einfügt, setzt der Benutzerprozess die aktuellen Kosten gleich den ursprünglichen Abfragekompilierungskosten. Für Ad-hoc-Ausführungspläne setzt der Benutzerprozess den aktuellen Kostenwert auf null. Danach setzt ein Benutzerprozess jedes Mal, wenn er auf einen Ausführungsplan verweist, die aktuellen Kosten auf die ursprünglichen Kompilierungskosten zurück. Bei Ad-hoc-Ausführungsplänen erhöht der Benutzerprozess die derzeitigen Kosten. Für alle Pläne entspricht der maximale Wert für die aktuellen Kosten den Kosten der ursprünglichen Kompilierung.
Wenn Speicherdruck besteht, entfernt die SQL Server-Datenbank-Engine Ausführungspläne aus dem Plan-Cache. Um zu ermitteln, welche Pläne entfernt werden sollen, überprüft die SQL Server Datenbank-Engine wiederholt den Status sämtlicher Ausführungspläne. Die Pläne, deren aktuelle Kosten 0 (null) betragen, werden entfernt. Ein Ausführungsplan mit aktuellen Kosten von null wird nicht automatisch entfernt, wenn Speicherdruck besteht. Sie wird nur entfernt, wenn die SQL Server-Datenbank-Engine den Plan prüft und der aktuelle Kostenwert null ist. Wenn ein Ausführungsplan überprüft wird und eine Abfrage den Plan derzeit nicht verwendet, strebt die SQL Server Datenbank-Engine an, die aktuellen Kosten schrittweise gegen null zu senken.
Die SQL Server-Datenbank-Engine prüft die Ausführungspläne weiter, bis genügend Pläne entfernt werden, um die Speicheranforderungen zu erfüllen. Bei Speicherengpässen kann der Kostenwert eines Ausführungsplans mehrmals erhöht oder verringert werden. Wenn der Speicherdruck nicht mehr besteht, hört die SQL Server-Datenbank-Engine auf, den aktuellen Kostenwert ungenutzter Ausführungspläne zu senken. Alle Ausführungspläne bleiben im Plancache, selbst wenn ihre Kosten null sind.
Wenn ein Speicherengpass vorliegt, verwendet die SQL Server-Datenbank-Engine den Ressourcenmonitor und Benutzerarbeitsthreads, um Speicher aus dem Plancache freizugeben. Der Ressourcenmonitor und die Benutzer-Worker-Threads können gleichzeitig Ausführungspläne prüfen, um die aktuellen Kosten ungenutzter Ausführungspläne zu senken. Der Ressourcenmonitor entfernt Ausführungspläne aus dem Plancache, wenn ein globaler Speicherengpass besteht. Es werden Speicherressourcen freigegeben, um die Einhaltung der Richtlinien für Systemspeicher, Prozessspeicher, Ressourcenpoolspeicher und die maximale Größe aller Caches zu gewährleisten.
Die maximale Größe für alle Caches ist eine Funktion der Pufferpoolgröße und kann den maximalen Serverarbeitsspeicher nicht überschreiten. Für weitere Informationen zur Konfiguration des maximalen Serverspeichers siehe den Artikel zur Einstellung max server memory in sp_configure.
Bei zu hoher Speicherauslastung eines einzelnen Cache werden durch die Benutzerarbeitsthreads Ausführungspläne aus dem Plancache gelöscht. Dadurch wird die Einhaltung der Richtlinien für die maximale Einzelcachegröße und die maximale Anzahl von Einzelcacheeinträgen erzwungen.
In den folgenden Beispielen wird erläutert, welche Ausführungspläne aus dem Plancache entfernt werden:
- Auf einen Ausführungsplan wird regelmäßig verwiesen, sodass seine Kosten nie den Wert 0 (null) erreichen. Der Plan bleibt im Plan-Cache und wird nicht entfernt, es sei denn, dass Speicherdruck besteht und die aktuellen Kosten null sind.
- Ein Ad-hoc-Ausführungsplan wird eingefügt und nicht erneut referenziert, bevor Speicherdruck vorhanden ist. Da Ad-hoc-Pläne mit aktuellen Kosten von null initialisiert werden, erkennt die SQL Server-Datenbank-Engine bei der Prüfung des Ausführungsplans die aktuellen Nullkosten und entfernt den Plan aus dem Plancache. Der Ad-hoc-Ausführungsplan bleibt im Plan-Cache mit aktuellen Kosten von null, wenn kein Speicherdruck besteht.
Um einen einzelnen Plan oder alle Pläne manuell aus dem Cache zu entfernen, verwenden Sie DBCC FREEPROCCACHE. Du kannst auch DBCC FREESYSTEMCACHE verwenden, um jeden Cache zu löschen, einschließlich Plan-Cache. SQL Server 2016 (13.x) und spätere Versionen: Verwenden Sie ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE, um den Procedure (Plan) Cache für die Datenbank im Scope zu leeren.
Eine Änderung einiger Konfigurationseinstellungen durch sp_configure und reconfigure führt ebenfalls dazu, dass Pläne aus dem Plan-Cache entfernt werden. Die Liste dieser Konfigurationseinstellungen finden Sie im Abschnitt „Hinweise“ des DBCC FREEPROCCACHE-Artikels. Wenn Sie diese Konfigurationsänderung vornehmen, wird folgende Informationsmeldung in das Fehlerprotokoll geschrieben:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Erneutes Kompilieren von Ausführungsplänen
Bestimmte Änderungen in einer Datenbank können einen Ausführungsplan ineffizient oder ungültig machen. Die Datenbank-Engine erkennt diese Änderungen und markiert den Plan als nicht gültig. Für die nächste Verbindung, die die Abfrage ausführt, muss dann ein neuer Plan kompiliert werden. Bedingungen, die einen Plan ungültig machen, umfassen:
- Änderungen an einer Tabelle oder Ansicht, die von der Abfrage referenziert wird (
ALTER TABLEundALTER VIEW). - Änderungen an einer einzelnen Prozedur, die alle Pläne für dieses Verfahren aus dem Cache entfernen würde (
ALTER PROCEDURE). - Änderungen an Indizes, die vom Ausführungsplan verwendet werden.
- Aktualisierungen von Statistiken, die vom Ausführungsplan verwendet werden, unabhängig davon, ob sie explizit durch eine Anweisung wie
UPDATE STATISTICSoder automatisch generiert werden. - Löschen eines Indexes, der von dem Ausführungsplan verwendet wird.
- Ein expliziter Aufruf von
sp_recompile. - Eine große Anzahl von Änderungen an Schlüsseln (generiert durch
INSERT- oderDELETE-Anweisungen von anderen Benutzern, die eine Tabelle ändern, auf die in der Abfrage verwiesen wird). - Bei Tabellen mit Triggern, wenn sich die Zeilenanzahl in den eingefügten oder gelöschten Tabellen deutlich erhöht.
- Ausführen einer gespeicherten Prozedur mit der Option
WITH RECOMPILE.
Die meisten Neukompilierungen sind entweder zur Korrektheit von Anweisungen oder um potenziell schnellere Abfrageausführungspläne zu erhalten.
Wenn eine Anweisung innerhalb eines Batchs die Rekompilierung auslöst, wird nur diese Anweisung neu kompiliert, nicht der gesamte Batch. Diese Regel gilt unabhängig davon, ob der Batch über eine gespeicherte Prozedur, einen Trigger, einen Ad-hoc-Batch oder ein Prepared Statement eingereicht wird.
Die Rekompilierung auf Statement-Ebene verbessert die Leistung, da in den meisten Fällen eine kleine Anzahl von Anweisungen Rekompilierungen und die damit verbundenen Einbußen in Bezug auf CPU-Zeit und Sperren verursacht. Diese Strafwerte werden daher für die anderen Anweisungen im Batch vermieden, die keine Neukompilierung benötigen.
Das sql_statement_recompile erweiterte Ereignis (XEvent) meldet Neukompilierungen auf Anweisungsebene. Dieses XEvent tritt auf, wenn eine Neukompilierung auf Anweisungsebene für jede Art von Batch erforderlich ist. Diese Anforderung umfasst gespeicherte Prozeduren, Trigger, Ad-hoc-Batches und Abfragen. Batches können über mehrere Schnittstellen eingereicht werden, darunter sp_executesql, dynamisches SQL, Prepare-Methoden oder Execute-Methoden.
Die recompile_cause Spalte von sql_statement_recompile XEvent enthält einen ganzzahligen Code, der den Grund für die Neukompilierung angibt. Die folgende Liste enthält die möglichen Gründe:
- Cursoroptionen geändert
- Verzögerte Kompilierung
-
FOR BROWSEBerechtigung geändert -
OPTION (RECOMPILE)angefordert - Parametrisierter Plan entleert
- Geänderte partitionierte Ansicht
- Plan geändert, der die Datenbankversion betrifft
- Abfragebenachrichtigungsumgebung geändert
- Plan des Abfragespeichers fehlt
- Erzwingende Richtlinie des Abfragespeicherplans fehlgeschlagen
- Erzwingende Richtlinie des Abfragespeicherplans geändert
- Remote-Rowset geändert
- Schema geändert
-
SETOption geändert - Statistiken geändert
- Temporäre Tabelle geändert
Hinweis
Wenn Sie die AUTO_UPDATE_STATISTICS Datenbankoption auf ONsetzen, werden Abfragen neu kompiliert, wenn sie auf Tabellen oder indexierte Ansichten abzielen, deren Statistiken aktualisiert wurden oder deren Kardinalitäten sich seit der letzten Ausführung deutlich verändert haben. Dieses Verhalten gilt für standardmäßige benutzerdefinierte Tabellen, temporäre Tabellen und die durch DML-Trigger erstellten eingefügten und gelöschten Tabellen.
Das Setzen AUTO_UPDATE_STATISTICS auf OFF stoppt diese Neukompilierungen, aber veraltete Statistiken verschlechtern die Anfrageleistung meist stärker als die Neukompilierungen. Für weitere Informationen siehe die AUTO_UPDATE_STATISTICS-Option . Die eingefügten und gelöschten Tabellen der DML-Trigger INSTEAD OF werden in tempdb erstellt, sodass sie der tempdb-Einstellung von AUTO_UPDATE_STATISTICS folgen.
Verwenden Sie explizite Parameter für die Wiederverwendung von Plänen
Die Verwendung von Parametern, darunter benannte Parameter in ADO.NET-Anwendungen und Parametermarker in OLE DB- und ODBC-Anwendungen, kann die Wiederverwendung von Ausführungsplänen erhöhen.
Warnung
Überprüfen Sie immer alle Benutzereingaben, indem Sie Typ, Länge, Format und Bereich testen. Weitere Informationen finden Sie unter Einschleusung von SQL-Befehlen.
Die zwei folgenden SELECT -Anweisungen unterscheiden sich lediglich im Hinblick auf die Werte, die in der WHERE -Klausel verglichen werden:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Die Ausführungspläne für diese Abfragen unterscheiden sich lediglich hinsichtlich des Werts, der für den Vergleich mit der ProductSubcategoryID -Spalte gespeichert wird. Während das Ziel ist, dass die Datenbank-Engine immer erkennt, dass die Anweisungen im Wesentlichen denselben Plan generieren und die Pläne wiederverwenden, erkennt die Datenbank-Engine diese Ähnlichkeit manchmal nicht bei komplexen T-SQL-Anweisungen.
Das Trennen von Konstanten von der T-SQL-Anweisung durch Verwendung von Parametern hilft der relationalen Engine, doppelte Pläne zu erkennen. Verwenden Sie Parameter auf folgende Weise:
Verwenden Sie in T-SQL
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Diese Methode wird für T-SQL-Skripte, gespeicherte Prozeduren oder Trigger empfohlen, die SQL-Anweisungen dynamisch generieren.
ADO.NET mit
SqlClientverwendet benannte Parameter, wie zum Beispiel@Parm. OLE DB und ODBC verwenden Parametermarker. Parametermarker sind Fragezeichen (?), die eine Konstante in einer SQL-Anweisung ersetzen und an eine Programmvariable gebunden sind. Beispielsweise können Sie in einer ODBC-Anwendung folgende Aktionen ausführen:Verwenden Sie
SQLBindParameter, um eine Integer-Variable an die erste Parametermarkierung in einer SQL-Anweisung zu binden.Legen Sie den ganzzahligen Wert in die Variable.
Führe die Anweisung aus und spezifiziere den Parametermarker (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
Der SQL Server Native Client OLE DB Provider und der SQL Server Native Client ODBC-Treiber verwenden
sp_executesqlzum Senden von Anweisungen an SQL Server, wenn Parametermarker in Anwendungen verwendet werden.Schreibe gespeicherte Prozeduren, die so konzipiert sind, dass sie Parameter verwenden.
Wenn Sie keine expliziten Parameter in das Design Ihrer Anwendungen einbauen, können Sie sich auch darauf verlassen, dass der Query Optimizer bestimmte Abfragen mithilfe des Standardverhaltens der einfachen Parametrisierung automatisch parametrisiert. Alternativ können Sie erzwingen, dass der Abfrageoptimierer die Parametrisierung aller Abfragen in der Datenbank in Betracht zieht, indem Sie die PARAMETERIZATION-Option der ALTER DATABASE-Anweisung auf FORCED festlegen.
Einfache Parametrisierung
In der Datenbank-Engine erhöht die Verwendung von Parametern oder Parametermarkern in T-SQL-Anweisungen die Fähigkeit der relationalen Engine, neue T-SQL-Anweisungen mit bestehenden, bereits kompilierten Ausführungsplänen abzugleichen.
Warnung
Überprüfen Sie immer alle Benutzereingaben, indem Sie Typ, Länge, Format und Bereich testen. Weitere Informationen finden Sie unter Einschleusung von SQL-Befehlen.
Wenn eine T-SQL-Anweisung ohne Parameter ausgeführt wird, parametrisiert die Datenbank-Engine die Anweisung intern, um die Möglichkeit zu erhöhen, sie mit einem bestehenden Ausführungsplan abzugleichen. Dieser Prozess wird Parametrisierung genannt. Die Standardeinstellung ist einfache Parameterisierung, und du kannst die erzwungene Parameterisierung für eine Datenbank aktivieren.
Betrachten Sie diese Aussage:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Du kannst den Wert 1 am Ende der Anweisung als Parameter angeben. Die relationale Engine erstellt den Ausführungsplan für diesen Batch, als hättest du anstelle des Wertes 1einen Parameter angegeben. Aufgrund dieser einfachen Parametrisierung erkennt die Datenbank-Engine, dass die folgenden beiden Anweisungen im Wesentlichen denselben Ausführungsplan generieren, und verwendet den ersten Plan für die zweite Anweisung wieder:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Bei der Verarbeitung komplexer T-SQL-Anweisungen kann die relationale Engine Schwierigkeiten haben zu bestimmen, welche Ausdrücke parametrisiert werden können. Um die Fähigkeit der relationalen Engine zu erhöhen, komplexe T-SQL-Anweisungen mit bestehenden, ungenutzten Ausführungsplänen abzugleichen, spezifizieren Sie die Parameter explizit durch Verwendung von entweder sp_executesql oder Parametermarkern.
Hinweis
Wenn Sie die +, -, *, , /oder % arithmetischen Operatoren verwenden, um implizite oder explizite Umwandlung von int-, smallint-, tinyint- oder bigint-Konstanten in die float-, real-, decimal oder numeric Datentypen durchzuführen, wendet die Datenbank-Engine spezifische Regeln an, um den Typ und die Genauigkeit der Ausdrucksergebnisse zu berechnen. Diese Regeln unterscheiden sich, je nachdem, ob die Abfrage parametrisiert ist. Daher können gleiche Ausdrücke in Abfragen in einigen Fällen zu unterschiedlichen Ergebnissen führen.
Unter dem Standardverhalten der einfachen Parametrisierung parametrisiert die Datenbank-Engine eine relativ kleine Klasse von Abfragen. Allerdings können Sie angeben, dass mit bestimmten Einschränkungen alle Abfragen in einer Datenbank parametrisiert werden, indem Sie die PARAMETERIZATION -Option des Befehls ALTER DATABASE auf FORCEDfestlegen. Diese Änderung kann die Leistung von Datenbanken verbessern, die hohe Mengen gleichzeitiger Abfragen erleben, indem sie die Häufigkeit von Abfragekompilierungen reduziert.
Alternativ können Sie angeben, dass eine einzelne Abfrage und alle anderen Abfragen, die in ihrer Syntax gleichwertig sind, und lediglich in ihren Parameterwerten abweichen, parametrisiert werden.
Tipp
Wenn Sie eine objektrelationale Mapping-Lösung (ORM) wie Entity Framework (EF) verwenden, sind Anwendungsabfragen wie manuelle LINQ-Abfragebäume oder bestimmte Roh-SQL-Abfragen möglicherweise nicht parametrisiert. Diese Einschränkung betrifft die Wiederverwendung von Plänen und die Möglichkeit, Anfragen im Abfragespeicher zu verfolgen. Weitere Informationen finden Sie unter Zwischenspeichern und Parametrisieren von Abfragen und Unformatierte SQL-Abfragen.
Erzwungene Parametrisierung
Man kann das Standardverhalten der einfachen Parametrisierung der Datenbank-Engine überschreiben, indem man angibt, dass alle SELECT, INSERT, UPDATE und DELETE Anweisungen in einer Datenbank parametrisiert werden, mit bestimmten Einschränkungen. Aktivieren Sie die erzwungene Parametrisierung, indem Sie die PARAMETERIZATION Option auf FORCED in der ALTER DATABASE Anweisung setzen. Die erzwungene Parametrisierung kann die Leistungsfähigkeit bestimmter Datenbanken erhöhen, indem die Frequenz der Kompilierungen und Neukompilierungen von Anweisungen verringert wird. Datenbanken, die möglicherweise von erzwungener Parameterisierung profitieren könnten, sind im Allgemeinen diejenigen, die einer hohen Anzahl gleichzeitiger Abfragen ausgesetzt sind, wie zum Beispiel Kassensysteme.
Wenn Sie die PARAMETERIZATION Option auf FORCED setzen, wird jeder literale Wert, der in einer SELECT, INSERT, UPDATE oder DELETE Anweisung erscheint und in beliebiger Form übergeben wird, während der Abfragekompilierung in einen Parameter umgewandelt. Ausnahmen bilden Literalwerte in folgenden Abfragekonstruktionen:
-
INSERT...EXECUTE-Anweisungen. - Anweisungen innerhalb des Hauptteils von gespeicherten Prozeduren, Triggern oder benutzerdefinierten Funktionen. Die Datenbank-Engine verwendet bereits Abfragepläne für diese Routinen wieder.
- vorbereitete Statements, die bereits in der clientseitigen Anwendung parametrisiert sind.
- Anweisungen, die XQuery-Methodenaufrufe enthalten, wo die Methode in einem Kontext angezeigt wird, in dem ihre Argumente normalerweise parametrisiert werden, wie beispielsweise die
WHERE-Klausel. Wenn die Methode in einem Kontext angezeigt wird, in dem ihre Argumente normalerweise nicht parametrisiert werden, wird der Rest der Anweisung parametrisiert. - Anweisungen innerhalb eines T-SQL-Cursors. (
SELECT-Anweisungen innerhalb von API-Cursorn werden parametrisiert.) - Als veraltet markierte Abfragekonstrukte.
- Jede Anweisung, die im Kontext von
ANSI_PADDINGläuft oderANSI_NULLSaufOFFgesetzt ist. - Anweisungen, die mehr als 2.097 literale Werte enthalten, die für die Parametrisierung geeignet sind.
- Anweisungen, die auf Variablen verweisen, wie beispielsweise
WHERE T.col2 >= @bb. - Anweisungen mit
RECOMPILE-Abfragehinweis. - Anweisungen mit
COMPUTE-Klausel. - Anweisungen mit
WHERE CURRENT OF-Klausel.
Die folgenden Abfrageklauseln sind nicht parametrisiert. In diesen Fällen sind nur die Klauseln nicht parametrisiert. Andere Klauseln in derselben Abfrage können für eine erzwungene Parametrisierung in Frage kommen.
- Das
<select_list>einer beliebigenSELECT-Anweisung. Diese Liste enthältSELECTListen von Unterabfragen undSELECTListen inINSERTStatements. - Unterabfragen mit
SELECT-Anweisungen innerhalb einerIF-Anweisung. - Die Abfrageklauseln
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOundFOR XML. - Direkte oder als Teilausdrücke formulierte Argumente der Operatoren
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXMLsowie allerFULLTEXT-Operatoren. - Das pattern-Argument und das escape_character-Argument einer
LIKE-Klausel. - Das style-Argument einer
CONVERT-Klausel. - Integer-Konstanten innerhalb einer
IDENTITY-Klausel. - Über die ODBC-Erweiterungssyntax angegebene Konstanten.
- Zum Kompilierungszeitpunkt auf eine Konstante reduzierbare Ausdrücke, die Argumente der Operatoren
+,-,*,/und%sind. Bei der Betrachtung der Eignung für erzwungene Parametrisierung betrachtet die Datenbank-Engine einen Ausdruck als konstant-faltbar, wenn eine der folgenden Bedingungen erfüllt ist:- Der Ausdruck enthält keine Spalten, Variablen oder Unterabfragen.
- Der Ausdruck enthält eine
CASE-Klausel.
- Argumente zu Abfragehinweisklauseln, einschließlich des number_of_rows-Arguments des
FASTAbfragehinweises, des number_of_processors-Arguments desMAXDOPAbfragehinweises und des number-Arguments desMAXRECURSIONAbfragehinweises.
Die Parametrisierung erfolgt auf der Ebene einzelner T-SQL-Anweisungen. Mit anderen Worten, einzelne Anweisungen in einem Batch werden parametrisiert. Nach der Kompilierung wird eine parametrisierte Abfrage im Kontext des ursprünglich eingereichten Batches ausgeführt. Wenn ein Ausführungsplan für eine Abfrage zwischengespeichert ist, können Sie bestimmen, ob die Abfrage parametrisiert wurde, indem Sie auf die sql Spalte der dynamischen sys.syscacheobjects Managementansicht verweisen. Wenn eine Abfrage parametrisiert ist, stehen die Namen und Datentypen der Parameter vor dem Text des eingereichten Batches in dieser Spalte, wie zum Beispiel (@1 TINYINT).
Hinweis
Parameternamen sind willkürlich. Benutzer oder Anwendungen sollten sich nicht auf eine bestimmte Namensreihenfolge verlassen. Außerdem können sich folgende Elemente zwischen Versionen von SQL Server und kumulativen Aktualisierungen (CU)-Upgrades ändern: Parameternamen, die Auswahl der parametrisierten Literale und der Abstand im parametrisierten Text.
Parameterdatentypen
Wenn die Datenbank-Engine Literale parametrisiert, werden die Parameter in folgende Datentypen umgewandelt:
- Ganzzahlige Literale, deren Größe sonst in den int-Datentyp passen würde, parametrisieren zu int. Größere ganzzahlige Literale, die Teile von Prädikaten sind, die einen beliebigen Vergleichsoperator enthalten (einschließlich
<,<=,=,!=,>=>,!>ANYBETWEENALL<>SOME!<undIN) parametrisieren zu numeric(38,0). Größere Literale, die keine Teile von Prädikaten mit Vergleichsoperatoren sind, parametrisieren zu numeric, deren Präzision gerade groß genug ist, um ihre Größe zu tragen, und deren Skalierung 0 ist. - Fixpunkt-numerische Literale, die Teile von Prädikaten mit Vergleichsoperatoren sind, parametrisieren zu numeric, deren Präzision 38 beträgt und deren Skalierung gerade groß genug ist, um ihre Größe zu tragen. Fixpunkt-numerische Literale, die keine Teile von Prädikaten mit Vergleichsoperatoren sind, parametrisieren zu numeric, dessen Präzision und Skalierung gerade groß genug sind, um ihre Größe zu unterstützen.
- Gleitkomma-numerische Literale werden als float(53) parametrisiert.
- Nicht-Unicode-String-Literale parametrisieren zu varchar(8000), wenn das Literal innerhalb von 8.000 Zeichen passt, und zu varchar(max), wenn es größer als 8.000 Zeichen ist.
- Unicode-String-Literale parametrisieren zu nvarchar(4000), wenn das Literal innerhalb von 4.000 Unicode-Zeichen passt, und zu nvarchar(max), wenn das Literal größer als 4.000 Zeichen ist.
- Binäre Literale parametrisieren zu varbinary(8000), wenn das Literal innerhalb von 8.000 Bytes passt. Wenn es größer als 8.000 Bytes ist, wird es in varbinary(max) umgewandelt.
- Geldliterale werden zu Geld parametrisiert.
Richtlinien für die Verwendung der erzwungenen Parametrisierung
Betrachten Sie die folgenden Punkte, wenn Sie die PARAMETERIZATION Option auf FORCED setzen:
- Die erzwungene Parametrisierung ändert die literalen Konstanten in einer Abfrage in Parameter beim Kompilieren einer Abfrage. Daher kann der Abfrageoptimierer suboptimale Abfragepläne auswählen. Insbesondere verringert sich die Wahrscheinlichkeit, dass der Abfrageoptimierer eine Übereinstimmung zwischen der Abfrage und einer indizierten Sicht oder einem Index für eine berechnete Spalte findet. Außerdem wählt der Abfrageoptimierer möglicherweise auch für Abfragen für partitionierte Tabellen und verteilte partitionierte Sichten nicht optimale Abfragepläne aus. Verwenden Sie keine erzwungene Parametrisierung für Umgebungen, die stark auf indexierten Ansichten und Indizes auf berechneten Spalten angewiesen sind. Im Allgemeinen sollten nur erfahrene Datenbankprofis die
PARAMETERIZATION FORCEDOption nutzen, nachdem festgestellt wurde, dass sie die Leistung nicht negativ beeinträchtigt. - Verteilte Abfragen, die auf mehrere Datenbanken verweisen, sind für die erzwungene Parametrisierung geeignet, solange die
PARAMETERIZATION-Option in der Datenbank aufFORCEDfestgelegt wird, in deren Kontext die Abfrage ausgeführt wird. - Durch Festlegen der Option
PARAMETERIZATIONaufFORCEDwerden alle Abfragepläne aus dem Plan-Cache einer Datenbank gelöscht, außer denen, die gerade kompiliert, neu kompiliert oder ausgeführt werden. Pläne für Abfragen, die während der Einstellungsänderung kompiliert oder ausgeführt werden, werden beim nächsten Ausführen der Abfrage parametrisiert. - Das Setzen der
PARAMETERIZATIONOption ist eine Online-Operation, die keine exklusiven Sperren auf Datenbankebene erfordert. - Die aktuelle Einstellung der
PARAMETERIZATION-Option wird beim erneuten Anfügen oder Wiederherstellen einer Datenbank beibehalten.
Man kann das Verhalten der erzwungenen Parametrisierung überschreiben, indem man angibt, dass bei einer einzigen Abfrage und bei allen anderen syntaktisch äquivalenten Abfragen, die sich nur in ihren Parameterwerten unterscheiden, eine einfache Parametrisierung versucht werden soll. Im Gegensatz dazu können Sie angeben, dass die erzwungene Parametrisierung nur für einen Satz von syntaktisch äquivalenten Abfragen versucht werden soll, selbst wenn die erzwungene Parametrisierung in der Datenbank deaktiviert ist. Verwenden Sie dafür Planhinweise.
Hinweis
Wird die PARAMETERIZATION-Option auf FORCED festgelegt, können sich Fehlermeldungen im Vergleich zu der Option PARAMETERIZATION auf SIMPLE unterscheiden: Bei erzwungener Parametrisierung werden möglicherweise mehr Fehlermeldungen ausgegeben; bei einfacher Parametrisierung hingegen würden weniger gemeldet. Die Zeilennummern, in denen Fehler auftreten, könnten ebenfalls falsch angegeben werden.
Auch wenn die erzwungene Parametrisierung aktiviert ist, kann die einfache Parametrisierung erfolgen. Die folgende Abfrage kann beispielsweise gemäß den Regeln der erzwungenen Parametrisierung nicht parametrisiert werden:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Sie kann jedoch nach den Regeln der einfachen Parametrisierung parametrisiert werden. Wenn die erzwungene Parametrisierung einen Fehler erzeugt, wird anschließend die einfache Parametrisierung versucht.
Vorbereiten von SQL-Anweisungen
Die Datenbank-Engine unterstützt die Vorbereitung von T-SQL-Anweisungen vor der Ausführung. Wenn eine Anwendung eine T-SQL-Anweisung mehrfach ausführen muss, kann sie die Datenbank-API nutzen, um:
- Einmaliges Vorbereiten der Anweisung. Dieser Schritt kompiliert die T-SQL-Anweisung in einen Ausführungsplan.
- Führe den vorkompilierten Ausführungsplan jedes Mal aus, wenn er die Anweisung ausführen muss. Dieser Ansatz verhindert, dass die T-SQL-Anweisung bei jeder Ausführung nach dem ersten Mal neu kompiliert wird. Das Vorbereiten und Ausführen von Anweisungen wird durch API-Funktionen und -Methoden gesteuert. Der SQL Server Native Client OLE DB Provider und der SQL Server Native Client ODBC-Treiber unterstützen das Prepare/Execute-Modell der Ausführung von T-SQL-Anweisungen. Bei einer Vorbereitungsanforderung sendet der Anbieter oder der Treiber die Anweisung zusammen mit der Anforderung zur Vorbereitung der Anweisung an SQL Server. Die Datenbank-Engine erstellt einen Ausführungsplan und gibt einen Handle für diesen Plan an den Anbieter oder Treiber zurück. Bei einer Ausführungsanforderung sendet der Anbieter bzw. Treiber eine Anforderung an den Server, den dem Handle zugeordneten Plan auszuführen.
Vorbereitete Anweisungen können in der Datenbank-Engine keine temporären Objekte erstellen. Vorbereitete Anweisungen können nicht auf gespeicherte Systemprozeduren verweisen, die temporäre Objekte, wie z. B. temporäre Tabellen, erstellen. Diese Prozeduren müssen direkt ausgeführt werden.
Übermäßiger Einsatz des Prepare/Execute-Modells kann die Leistung beeinträchtigen. Wenn eine Anweisung nur einmal ausgeführt wird, benötigt die direkte Ausführung nur eine Netzwerk-Roundtrip zum Server. Die Vorbereitung und Ausführung einer T-SQL-Anweisung, die nur einmal ausgeführt wird, erfordert einen zusätzlichen Netzwerk-Roundtrip: einen Trip zur Vorbereitung der Statement und einen Trip zur Ausführung.
Eine Anweisung vorzubereiten ist effektiver, wenn du Parametermarker verwendest. Nehmen Sie z.B. an, eine Anwendung soll gelegentlich Produktinformationen aus der AdventureWorksLT2025 -Beispieldatenbank abrufen. Es gibt zwei Möglichkeiten, wie die Anwendung diese Aufgabe erfüllen kann.
Mit dem ersten Ansatz kann die Anwendung für jedes angeforderte Produkt eine separate Abfrage ausführen:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
Mit dem zweiten Ansatz führt die Anwendung folgende Operationen durch:
Bereitet eine SQL-Anweisung vor, die einen Parametermarker enthält (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Die Anwendung bindet eine Programmvariable an die Parametermarkierung.
Die Anwendung füllt die gebundene Variable mit dem Schlüsselwert und führt die Anweisung aus, sobald die Produktinformationen benötigt werden.
Der zweite Ansatz ist effizienter, wenn die Anweisung mehr als dreimal ausgeführt wird.
In der Datenbank-Engine hat das Prepare/Execute-Modell keinen signifikanten Leistungsvorteil gegenüber der direkten Ausführung, da die Datenbank-Engine Ausführungspläne wiederverwendet. Die Datenbank-Engine verfügt über effiziente Algorithmen, um aktuelle T-SQL-Anweisungen mit Ausführungsplänen abzugleichen, die für frühere Ausführungen derselben T-SQL-Anweisung erstellt wurden. Wenn eine Anwendung eine T-SQL-Anweisung mit Parametermarkern mehrfach ausführt, verwendet die Datenbank-Engine den Ausführungsplan der ersten Ausführung für die zweite und die folgenden Ausführungen wieder (sofern der Plan nicht aus dem Plancache entfernt wird). Das Vorbereiten/Ausführen-Modell bietet jedoch weiterhin die folgenden Vorteile:
- Einen Ausführungsplan anhand eines identifizierenden Handles zu finden, ist effizienter als die Algorithmen, die eine T-SQL-Anweisung mit bestehenden Ausführungsplänen abgleichen.
- Die Anwendung kann steuern, wann der Ausführungsplan erstellt und wann er wiederverwendet wird.
- Das Vorbereiten/Ausführen-Modell kann auf andere Datenbanken portiert werden, einschließlich früherer Versionen von SQL Server.
Parameterempfindlichkeit
Parametersensitivität, auch bekannt als Parameter-Sniffing, bezeichnet einen Prozess, bei dem die Datenbank-Engine die aktuellen Parameterwerte während der Kompilierung oder Neukompilierung snifft und sie an den Query Optimizer weitergibt, um möglicherweise effizientere Abfrageausführungspläne zu erstellen.
Parameterwerte werden während der Kompilierung oder Neukompilierung für die folgenden Batchtypen ermittelt:
- Gespeicherte Prozeduren
- Abfragen, die über
sp_executesqlübermittelt werden - Vorbereitete Abfragen
Weitere Informationen zur Fehlerbehebung von Parameter-Sniff-Problemen finden Sie unter:
- Untersuchen und beheben Sie parametersensitive Probleme
- Verwenden Sie explizite Parameter für die Wiederverwendung von Plänen
- Optimierung parametersensitiver Pläne
- Behandeln von Problemen bei Abfragen mit parameterempfindlichem Ausführungsplan in Azure SQL-Datenbank
- Behandeln von Problemen bei Abfragen mit parameterempfindlichem Ausführungsplan in Azure SQL Managed Instance
Wenn eine Abfrage in der Datenbank-Engine den Hinweis OPTION (RECOMPILE) verwendet, wandelt der Abfrageoptimierer Parameter und lokale Variablen in Kompilierungszeitkonstanten um, die konstant gefaltet und zu Literalen reduziert werden können. Während der Kompilierung kennt der Optimierer die aktuellen Laufzeitwerte von Parametern und lokalen Variablen, wie sie unmittelbar vor dieser Anweisung existieren, und kann sie verwenden. Der OPTION (RECOMPILE) Hinweis ermöglicht es dem Optimierer, einen optimaleren Abfrageplan zu erstellen, der auf die spezifischen Werte zugeschnitten ist, und die besten zugrunde liegenden Indizes zur Laufzeit zu nutzen. Bei Parametern bezieht sich dieser Prozess nicht auf die Werte, die ursprünglich an die Batch- oder gespeicherte Prozedur übergeben wurden, sondern auf ihre Werte zum Zeitpunkt der Neukompilierung. Diese Werte können im Verfahren modifiziert werden, bevor die Anweisung erreicht wird, die RECOMPILE enthält. Dieses Verhalten kann die Leistung für Abfragen mit stark variablen oder verzerrten Eingabedaten verbessern, allerdings auf Kosten der Kompilierung der Abfrage bei jeder Ausführung. Diese Kostenposition kann hoch sein. Vermeiden Sie es, den RECOMPILE Hinweis zu verwenden, ohne dessen Auswirkungen auf die gesamte Arbeitsbelastung zu bewerten.
Lokale Variablen und Kardinalitätsschätzungen
Wenn eine Abfrage lokale Variablen verwendet, kann die Datenbank-Engine ihre Werte zur Kompilierungszeit nicht ermitteln, daher schätzt sie die Kardinalität anhand verfügbarer Statistiken oder Heuristiken. Wenn Statistiken vorhanden sind, wird in der Regel der Wert "Alle Dichte " (auch als durchschnittliche Dichte bezeichnet) aus dem statistischen Histogramm verwendet, um zu schätzen, wie viele Zeilen mit dem Prädikat übereinstimmen. Wenn jedoch keine Statistiken für die Spalte vorliegen, greift die Datenbank-Engine auf heuristische Schätzungen zurück, etwa die Annahme von 10% Selektivität für Gleichheitsprädikate und 30% für Ungleichungen und Bereiche. Diese Schätzungen könnten zu weniger genauen Ausführungsplänen führen. Hier ist ein Beispiel für eine Abfrage, die eine lokale Variable verwendet.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
In diesem Fall verwendet die Datenbank-Engine den Wert 100 nicht, um die Abfrage zu optimieren. Sie verwendet eine allgemeine Schätzung.
Parallele Abfrageverarbeitung
Die Datenbank-Engine stellt parallele Abfragen bereit, um Abfrageausführung und Indexoperationen für Computer mit mehr als einem Mikroprozessor (CPU) zu optimieren. Da die Datenbank-Engine eine Abfrage- oder Indexoperation parallel durchführen kann, indem mehrere Betriebssystem-Worker-Threads verwendet werden, wird die Operation schnell und effizient abgeschlossen.
Während der Abfrageoptimierung sucht die Datenbank-Engine nach Abfragen oder Indexoperationen, die von paralleler Ausführung profitieren könnten. Für diese Abfragen fügt die Datenbank-Engine Exchange-Operatoren in den Abfrageausführungsplan ein, um die Abfrage für die parallele Ausführung vorzubereiten. Ein Verteilungsoperator ist ein Operator in einem Plan für die Abfrageausführung, der die Prozessverwaltung, die Neuverteilung der Daten und die Ablaufsteuerung ermöglicht. Der Verteilungsoperator schließt die logischen Operatoren Distribute Streams, Repartition Streamsund Gather Streams als Untertypen ein. Einer oder mehrere dieser Operatoren können in der Showplanausgabe eines Abfrageplans für eine parallele Abfrage enthalten sein.
Wichtig
Bestimmte Konstrukte behindern die Fähigkeit der Datenbank-Engine, Parallelität für den gesamten Ausführungsplan oder Teile davon zu nutzen.
Zu den Konstrukten, die Parallelität verhindern, gehören:
| Bauen | Beschreibung |
|---|---|
| Benutzerdefinierte Skalarfunktionen | Weitere Informationen zu skalaren, benutzerdefinierten Funktionen finden Sie unter Benutzer definierte Funktionen erstellen. Ab SQL Server 2019 (15.x) kann die SQL Server-Datenbank-Engine diese Funktionen inline einbetten und die Nutzung von Parallelismus während der Abfrageverarbeitung freischalten. Weitere Informationen zum skalaren UDF-Inlining finden Sie unter Intelligente Abfrageverarbeitung in SQL-Datenbanken. |
| Remote-Abfrage | Weitere Informationen zu Remote Query finden Sie unter Logical and physical showplan operator reference. |
| Dynamische Cursor | Weitere Informationen zu Cursorn finden Sie unter siehe DECLARE CURSOR. |
| Rekursive Abfragen | Weitere Informationen zur Rekursion finden Sie unter Richtlinien zur Definition und Verwendung von rekursiven allgemeinen Tabellenausdrücken und Rekursion in T-SQL. |
| Tabellenwertfunktionen mit mehreren Anweisungen (MSTVFs) | Weitere Informationen zu MSTVFs finden Sie unter Create User-defined Functions (Datenbank-Engine). |
TOP Schlüsselwort |
Weitere Informationen finden Sie unter TOP. |
Ein Abfrageausführungsplan enthält möglicherweise das NonParallelPlanReason-Attribut im QueryPlan-Element, das beschreibt, warum keine Parallelverarbeitung verwendet wurde. Zu den Werten für dieses Attribut gehören:
| NonParallelPlanReason-Wert | Beschreibung |
|---|---|
MaxDOPSetToOne |
Der maximale Grad der Parallelität ist auf 1 gesetzt. |
EstimatedDOPIsOne |
Der geschätzte Grad der Parallelität ist 1. |
NoParallelWithRemoteQuery |
Parallelität wird für Remoteabfragen nicht unterstützt. |
NoParallelDynamicCursor |
Parallele Pläne werden für dynamische Cursor nicht unterstützt. |
NoParallelFastForwardCursor |
Parallele Pläne werden für schnelle Vorwärtscursor nicht unterstützt. |
NoParallelCursorFetchByBookmark |
Parallele Pläne werden nicht für Cursor unterstützt, die anhand von Lesezeichen abrufen. |
NoParallelCreateIndexInNonEnterpriseEdition |
Die parallele Indexerstellung wird für andere Editionen als Enterprise nicht unterstützt. |
NoParallelPlansInDesktopOrExpressEdition |
Parallele Pläne werden für die Desktop- und Express-Edition nicht unterstützt. |
NonParallelizableIntrinsicFunction |
Die Abfrage verweist auf eine nicht parallelisierbare intrinsische Funktion. |
CLRUserDefinedFunctionRequiresDataAccess |
Parallelität wird für eine benutzerdefinierte CLR-Funktion, die Datenzugriff erfordert, nicht unterstützt. |
TSQLUserDefinedFunctionsNotParallelizable |
Die Abfrage verweist auf eine benutzerdefinierte T-SQL-Funktion, die nicht parallelisierbar war. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Tabellenvariablentransaktionen unterstützen keine parallelen verschachtelten Transaktionen. |
DMLQueryReturnsOutputToClient |
Die DML-Abfrage gibt die Ausgabe an den Client zurück und ist nicht parallelisierbar. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
Nicht unterstützte Mischung aus seriellen und parallelen Plänen für eine einzelne Onlineindexerstellung. |
CouldNotGenerateValidParallelPlan |
Fehler bei der Überprüfung des parallelen Plans, Rückgriff auf seriell. |
NoParallelForMemoryOptimizedTables |
Parallelität wird für referenzierte In-Memory-OLTP-Tabellen nicht unterstützt. |
NoParallelForDmlOnMemoryOptimizedTable |
Parallelität wird für DML in einer In-Memory-OLTP-Tabelle nicht unterstützt. |
NoParallelForNativelyCompiledModule |
Parallelität wird für referenzierte nativ compilierte Module nicht unterstützt. |
NoRangesResumableCreate |
Fehler bei der Bereichsgenerierung für einen fortsetzbaren Erstellungsvorgang. |
Nach dem Einfügen eines Verteilungsoperators ist das Ergebnis ein Plan für eine parallele Abfrageausführung. Ein Plan für die parallele Abfrageausführung kann mehrere Arbeitsthreads verwenden. Ein serieller Ausführungsplan, der von einer nicht parallelen (seriellen) Abfrage verwendet wird, verwendet nur einen Arbeitsthread bei seiner Ausführung. Die tatsächliche Anzahl der von einer parallelen Abfrage verwendeten Worker-Threads wird bei der Initialisierung der Abfrageplanausführung bestimmt und hängt von der Komplexität des Plans und dem Grad der Parallelität ab.
Der Grad der Parallelität (DOP) legt die maximale Anzahl von Prozessoren fest, die zur Ausführung einer parallelen Aufgabe verwendet werden können. Der DOP gibt nicht die Gesamtzahl der Worker-Threads an, die von einer Abfrage verwendet werden. Das DOP-Limit wird pro Aufgabe festgelegt. Dieser Grenzwert gilt nicht pro Anforderung oder pro Abfrage. Das bedeutet, dass während einer parallelen Abfrageausführung eine einzelne Anforderung mehrere Tasks erzeugen kann, die einem Scheduler zugeordnet sind. Mehr Prozessoren als durch MAXDOP angegeben können an jedem beliebigen Zeitpunkt der Abfrageausführung gleichzeitig verwendet werden, wenn verschiedene Aufgaben gleichzeitig ausgeführt werden. Weitere Informationen finden Sie im Leitfaden zur Thread- und Aufgabenarchitektur.
Der Abfrageoptimierer verwendet keinen parallelen Ausführungsplan für eine Abfrage, wenn eine der folgenden Bedingungen erfüllt ist:
Der serielle Ausführungsplan ist trivial oder überschreitet die Kostenschwelle für die Parallelisierungseinstellung nicht.
Der Plan für die serielle Ausführung hat geringere geschätzte Gesamtkosten für die Teilstruktur als alle Pläne für die parallele Ausführung, die vom Optimierer untersucht werden.
Die Abfrage enthält skalare oder relationale Operatoren, die nicht parallel ausgeführt werden können. Bestimmte Operatoren können dazu führen, dass ein Abschnitt des Abfrageplans im Einzelschrittmodus ausgeführt wird, oder dass der gesamte Plan im Einzelschrittmodus ausgeführt wird.
Hinweis
Die geschätzten Gesamtkosten für die Teilstruktur eines parallelen Plans können unter dem Kostenschwellenwert für die Parallelitätseinstellung liegen. Mit anderen Worten: Die insgesamt geschätzten Teilbaumkosten des seriellen Plans überstiegen ihn, und der Abfrageplan mit den niedrigeren geschätzten Gesamtkosten wurde gewählt.
Parallelitätsgrad (DOP)
Die Datenbank-Engine erkennt automatisch den besten Grad an Parallelität für jede Instanz einer parallelen Abfrageausführungs- oder Index-DDL-Operation. Dieser Wert wird anhand folgender Kriterien bestimmt:
Wird SQL Server auf einem Computer mit mehreren Mikroprozessoren (oder CPUs) ausgeführt wie z. B. auf einem symmetrischen Multiprozessorcomputer (Symmetric Multiprocessing, SMP)? Nur Computer mit mehreren CPUs können parallele Abfragen verwenden.
Sind ausreichend Arbeitsthreads verfügbar? Jeder Abfrage- oder Indexvorgang setzt zu seiner Ausführung eine bestimmte Anzahl von Arbeitsthreads voraus. Das Ausführen eines parallelen Plans erfordert mehr Arbeitsthreads als ein serieller Plan, und die Anzahl der erforderlichen Arbeitsthreads steigt mit dem Grad der Parallelität. Wenn die Worker-Thread-Anforderung des parallelen Plans für einen bestimmten Grad an Parallelität nicht erfüllt werden kann, verringert die SQL Server-Datenbank-Engine automatisch den Grad der Parallelität oder führt den parallelen Plan seriell aus.
Welcher Abfragetyp oder Indexvorgangstyp soll ausgeführt werden? Indexvorgänge, die einen Index erstellen oder neu erstellen oder einen gruppierten Index löschen, sowie Abfragen, die sehr viele CPU-Zyklen beanspruchen, eignen sich am besten für einen parallelen Plan. So sind z. B. Joins großer Tabellen, umfassende Aggregationen und Sortierungen großer Resultsets gut geeignet. Bei einfachen Abfragen, die häufig in Transaktionsverarbeitungsanwendungen vorkommen, überwiegt der zusätzliche Koordinationsaufwand, der für die parallele Ausführung einer Abfrage erforderlich ist, den potenziellen Leistungsschub. Um zu ermitteln, für welche Abfragen die parallele Ausführung sinnvoll ist und für welche dies nicht gilt, vergleicht die SQL Server Datenbank-Engine die geschätzten Kosten für die Ausführung der Abfrage oder des Indexvorgangs mithilfe des Werts für den Kostenschwellenwert für Parallelität. Benutzer können den Standardwert von
5mit sp_configure ändern, wenn ein guter Test ergibt, dass ein anderer Wert besser für die laufende Arbeitslast geeignet ist.Gibt es eine ausreichende Anzahl von zu verarbeitenden Zeilen? Wenn der Abfrageoptimierer ermittelt, dass die Anzahl der Zeilen zu niedrig ist, werden keine Verteilungsoperatoren eingesetzt, um die Zeilen zu verteilen. Daher werden die Operatoren seriell ausgeführt. Durch das Ausführen der Operatoren in einem seriellen Plan werden Situationen vermieden, in denen die Kosten für Start, Verteilung und Koordinierung den Nutzen übersteigen, der durch die parallele Ausführung der Operatoren erzielt würde.
Ob aktuelle Statistiken vorliegen. Wenn der höchste Grad der Parallelität nicht möglich ist, werden zunächst niedrigere Grade in Betracht gezogen, bevor der parallele Plan verworfen wird. Zum Beispiel können Statistiken beim Erstellen eines Cluster-Index für eine Ansicht nicht ausgewertet werden, weil der Cluster-Index noch nicht existiert. In diesem Fall kann die SQL Server Datenbank-Engine nicht den höchsten Grad an Parallelität für den Indexvorgang bereitstellen. Allerdings können einige Vorgänge, wie z. B. das Sortieren und Scannen, von der parallelen Ausführung profitieren.
Hinweis
Parallele Indexvorgänge sind nur in den Editionen SQL Server Enterprise, Developer und Evaluation verfügbar.
Zur Ausführungszeit ermittelt die SQL Server Datenbank-Engine, ob die aktuelle Systemlast und die oben beschriebenen Konfigurationsinformationen die parallele Ausführung zulassen. Wenn die parallele Ausführung gerechtfertigt ist, ermittelt die SQL Server Datenbank-Engine die optimale Anzahl von Arbeitsthreads und verteilt dann die Ausführung des parallelen Plans auf diese Arbeitsthreads. Wenn die parallele Ausführung eines Abfrage- oder Indexvorgangs mit mehreren Arbeitsthreads gestartet wird, wird dieselbe Anzahl an Arbeitsthreads bis zur Beendigung des Vorgangs verwendet. Die SQL Server-Datenbank-Engine bestimmt die optimale Anzahl von Arbeitsthreads jedes Mal neu, wenn ein Ausführungsplan aus dem Plancache abgerufen wird. Zum Beispiel kann eine Ausführung eines zwischengespeicherten parallelen Plans seriell ausgeführt werden, eine spätere Ausführung desselben Plans kann drei Worker-Threads verwenden, und eine dritte Ausführung kann vier Worker-Threads verwenden.
Die Aktualisierungs- und Löschoperatoren in einem parallelen Abfrageausführungsplan werden seriell ausgeführt, aber die WHERE-Klausel einer UPDATE- oder DELETE-Anweisung wird möglicherweise parallel ausgeführt. Die eigentlichen Datenänderungen werden anschließend seriell auf die Datenbank angewendet.
Ab Datenbankkompatibilitätsstufe 110 kann die SELECT ... INTO Anweisung parallel ausgeführt werden. Andere Formen von Insert-Operatoren funktionieren auf die gleiche Weise wie in früheren Versionen beschrieben.
Ab Datenbankkompatibilitätsstufe 130 kann die INSERT ... SELECT Anweisung parallel ausgeführt werden, beim Einfügen in Heaps oder Clustered Columnstore-Indizes (CCI) und bei Verwendung des Hinweises TABLOCK. Einfügungen in lokale temporäre Tabellen (identifiziert durch das # Präfix) und globale temporäre Tabellen (identifiziert durch ## Präfixe) sind ebenfalls für Parallelität unter Verwendung des Hinweises TABLOCK aktiviert. Weitere Informationen finden Sie unter INSERT.
Statische Cursor und schlüsselsetgesteuerte Cursor können durch Pläne für die parallele Ausführung aufgefüllt werden. Das spezifische Verhalten dynamischer Cursor kann jedoch nur durch die serielle Ausführung gewährleistet werden. Für eine Abfrage, die Teil eines dynamischen Cursors ist, generiert der Abfrageoptimierer immer einen seriellen Ausführungsplan.
Überschreiben der Parallelisierungsgrade
Der Grad an Parallelität legt die Anzahl der bei der Ausführung paralleler Pläne einzusetzenden Prozessoren fest. Du kannst diese Konfiguration auf verschiedenen Ebenen einstellen:
Auf Serverebene durch Verwenden der Serverkonfigurationsoption maximaler Grad an Parallelität (
MAXDOP).Gilt für: SQL Server
SQL Server 2019 (15.x) führte automatische Empfehlungen zur Einstellung der
MAXDOPServerkonfigurationsoption während des Installationsprozesses ein. Auf der Setupbenutzeroberfläche können Sie entweder die empfohlenen Einstellungen übernehmen oder Ihren eigenen Wert eingeben. Weitere Informationen finden Sie unter Konfiguration der Datenbank-Engine – Seite „MaxDOP“.Workloadebene mithilfe der
MAX_DOPKonfigurationsoption für die Resource Governor-Arbeitsauslastungsgruppe.Gilt für: SQL Server
Auf Datenbankebene durch Verwendung der
MAXDOPDatenbank-Scoped-Konfiguration.Gilt für: SQL Server, Azure SQL-Datenbank und Azure SQL Managed Instance
Auf Abfrage- oder Indexanweisungsebene, indem Sie den
MAXDOPquery hint oder dieMAXDOPIndexoption verwenden. Zum Beispiel können Sie dieMAXDOPOption nutzen, um die Anzahl der Prozessoren, die einer Online-Indexoperation zugewiesen sind, durch Erhöhen oder Reduzieren zu steuern. Auf diese Weise können Sie die von einer Indexoperation verwendeten Ressourcen mit denen der gleichzeitigen Benutzer ausbalancieren.Gilt für: SQL Server, Azure SQL-Datenbank und Azure SQL Managed Instance
Die Einstellung max degree of parallelism der Option auf 0 (Standard) ermöglicht es der Datenbank-Engine, alle verfügbaren Prozessoren bis zu maximal 64 Prozessoren in einer parallelen Planausführung zu verwenden. Obwohl die Datenbank-Engine ein Laufzeitziel von 64 logischen Prozessoren setzt, wenn die MAXDOP Option auf 0gesetzt ist, kann man bei Bedarf manuell einen anderen Wert festlegen. Das Festlegen von MAXDOP auf 0 für Abfragen und Indizes ermöglicht es der Datenbank-Engine, alle verfügbaren Prozessoren bis zu maximal 64 Prozessoren für die angegebenen Abfragen oder Indizes in einer parallelen Planausführung zu verwenden.
MAXDOP ist kein erzwungener Wert für alle parallelen Abfragen, sondern vielmehr ein vorläufiges Ziel für alle Abfragen, die für Parallelisierung geeignet sind. Das bedeutet, dass, wenn nicht genügend Worker-Threads zur Laufzeit verfügbar sind, eine Abfrage mit einem geringeren Grad an Parallelität ausgeführt werden kann als durch die MAXDOP-Serverkonfigurationsoption angegeben.
Tipp
Weitere Informationen finden Sie unter MAXDOP-Empfehlungen für Richtlinien zur Konfiguration von MAXDOP auf Server-, Datenbank-, Abfrage- oder Hint-Ebene.
Beispiel für eine parallele Abfrage
Die folgende Abfrage zählt die Anzahl der Bestellungen auf, die in einem bestimmten Quartal ab dem 1. April 2024 aufgegeben wurden und in denen mindestens eine Zeile der Bestellung vom Kunden später als zum vereinbarten Datum erhalten wurde. Die Abfrage listet die Anzahl dieser Bestellungen gruppiert nach Priorität der Bestellung und in aufsteigender Reihenfolge der Priorität auf.
In diesem Beispiel werden erfundene Tabellen- und Spaltennamen verwendet.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Nehmen Sie an, dass die folgenden Indizes für die lineitem- und die orders-Tabelle definiert werden:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Im Folgenden sehen Sie einen möglichen parallelen Plan, der für die zuvor beschriebene Abfrage generiert wurde:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
Die folgende Abbildung zeigt einen Abfrageplan, der mit einem Grad an Parallelität von 4 ausgeführt wird und einen Join zwischen zwei Tabellen umfasst.
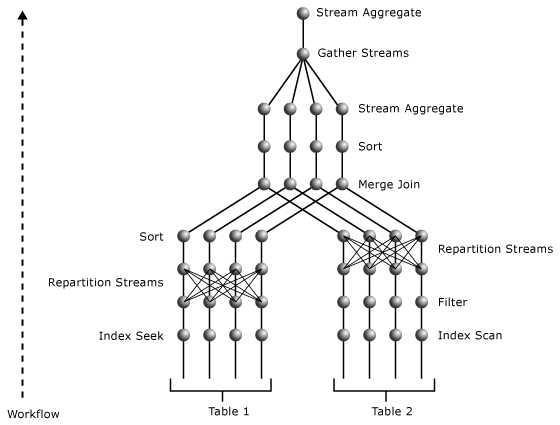
Der parallele Plan enthält drei Parallelismus-Operatoren. Sowohl der „Index Seek“-Operator des o_datkey_ptr-Indexes als auch der „Index Scan“-Operator des l_order_dates_idx-Indexes werden parallel ausgeführt. Dieser Prozess erzeugt mehrere exklusive Ströme, die aus den nächstgelegenen Parallelismus-Operatoren über den Index-Scan- bzw. Index-Seek-Operatoren bestimmt werden können. Beide Operatoren repartitionieren den Börsentyp. Sie mischen die Daten zwischen den Strömen neu und erzeugen die gleiche Anzahl von Strömen auf deren Ausgabe wie auf ihren Eingaben. Diese Anzahl der Datenströme entspricht dem Grad an Parallelität.
Der Parallelismusoperator über dem l_order_dates_idx Index-Scan-Operator teilt seine Eingabeströme neu auf, wobei der Wert von L_ORDERKEY als Schlüssel verwendet wird. Auf diese Weise gelangen identische Werte für L_ORDERKEY in dieselben Ausgabedatenströme. Gleichzeitig behalten die Ausgabedatenströme die Reihenfolge für die L_ORDERKEY-Spalte bei, sodass die Eingabeanforderungen des „Merge Join“-Operators erfüllt sind.
Der Parallelismusoperator über dem Index Seek-Operator teilt seine Eingabeströme mit dem Wert von O_ORDERKEYneu auf. Da die Eingabe nicht auf den Spaltenwerten O_ORDERKEY sortiert ist und diese Spalte die Join-Spalte im Merge Join Operator ist, sorgt der Sortieroperator zwischen dem Parallelismus und dem Merge-Join-Operator dafür, dass die Eingabe für den Merge Join Operator in den Join-Spalten sortiert ist. Der Sort-Operator wird wie der „Merge Join“-Operator parallel ausgeführt.
Der oberste „Parallelism“-Operator fasst die Ergebnisse von mehreren Datenströmen in einem einzigen Datenstrom zusammen. Teilaggregationen, die vom „Stream Aggregate“-Operator unterhalb des „Parallelism“-Operators vorgenommen werden, werden dann in dem „Stream Aggregate“-Operator oberhalb des „Parallelism“-Operators zu einem einzigen SUM-Wert für jeden Wert von O_ORDERPRIORITY aufsummiert. Da dieser Plan zwei Austauschsegmente mit einem Parallelitätsgrad von 4 hat, verwendet er acht Arbeitsstränge.
Weitere Informationen zu den in diesem Beispiel verwendeten Operatoren finden Sie unter der Operatorreferenz Logical and physical Showplan.
Parallele Indexvorgänge
Abfragepläne für Indexoperationen, die einen Index erstellen oder neu aufbauen oder einen Cluster-Index entfernen, können parallele, multithreadige Operationen auf Computern mit mehreren Prozessoren unterstützen.
Hinweis
Parallele Indexoperationen sind nur in der Enterprise-Edition verfügbar.
Datenbank-Engine verwendet dieselben Algorithmen, um den Grad der Parallelität (die Gesamtzahl der separaten Worker-Threads, die ausgeführt werden) für Indexoperationen zu bestimmen wie für andere Abfragen. Die Serverkonfigurationsoption max degree of parallelism legt den maximalen Grad der Parallelität für eine Indexoperation fest. Sie können den max degree of parallelism Wert für einzelne Indexoperationen überschreiben, indem Sie die MAXDOP Indexoption in den CREATE INDEX, ALTER INDEX, DROP INDEX, und ALTER TABLE Anweisungen setzen.
Wenn die SQL Server-Datenbank-Engine einen Indexausführungsplan erstellt, wird die Anzahl der parallelen Operationen auf den niedrigsten Wert aus diesen Werten gesetzt:
- Die Anzahl der Prozessoren, oder CPUs, im Computer.
- Die in der Serverkonfigurationsoption
max degree of parallelismangegebene Zahl. - Die Anzahl der CPUs, deren Arbeitslast für SQL Server-Workerthreads noch nicht über einem Schwellenwert liegt.
Zum Beispiel verwendet die Indexoperation auf einem Computer mit acht CPUs, bei dem max degree of parallelism jedoch auf 6 gesetzt ist, nicht mehr als sechs parallele Worker-Threads. Falls fünf der CPUs in dem Computer bereits den Schwellenwert von SQL Server-Arbeit überschritten haben, wenn ein Indexausführungsplan erstellt wird, legt der Ausführungsplan nur drei parallele Arbeitsthreads fest.
Die Hauptphasen einer parallelen Indexoperation umfassen:
- Ein koordinierender Arbeitsthread scannt die Tabelle schnell und nach dem Zufallsprinzip, um die Verteilung der Indexschlüssel einzuschätzen. Der koordinierende Worker-Thread legt die Schlüsselgrenzen fest, die eine Anzahl von Schlüsselbereichen erzeugen, die dem Grad der parallelen Operationen entsprechen, wobei jeder Schlüsselbereich auf eine ähnliche Anzahl von Zeilen geschätzt wird. Wenn zum Beispiel vier Millionen Zeilen in der Tabelle sind und der Grad der Parallelität 4 beträgt, bestimmt der koordinierende Worker-Thread die Schlüsselwerte, die vier Zeilensätze mit jeweils 1 Million Zeilen in jeder Menge abgrenzen. Wenn der koordinierende Worker-Thread nicht genügend Schlüsselbereiche einrichten kann, um alle CPUs zu nutzen, verringert er entsprechend den Grad der Parallelität.
- Der koordinierende Arbeitsthread verteilt eine Reihe von Arbeitsthreads, die dem Grad an parallelen Vorgängen entsprechen, und wartet, dass diese Arbeitsthreads ihre Arbeit beenden. Jeder Arbeitsthread scannt die Basistabelle mithilfe eines Filters, der nur Zeilen mit Schlüsselwerten in dem Bereich abruft, der dem Arbeitsthread zugewiesen ist. Jeder Arbeitsthread erstellt eine Indexstruktur für die Zeilen in seinem Schlüsselbereich. Bei einem partitionierten Index erstellt jeder Arbeitsthread eine angegebene Anzahl an Partitionen. Partitionen werden von Arbeitsthreads nicht gemeinsam genutzt.
- Nachdem alle parallelen Worker-Threads ihre Ausführung abgeschlossen haben, verbindet der koordinierende Worker-Thread die Index-Untereinheiten zu einem einzigen Index. Diese Phase gilt nur für Offline-Indexvorgänge.
Einzelne CREATE TABLE oder ALTER TABLE Statements können mehrere Einschränkungen haben, die die Erstellung eines Index erfordern. Diese mehrfachen Indexerstellungsvorgänge werden seriell durchgeführt, obwohl jeder einzelne Indexerstellungsvorgang auf einem Computer mit mehreren CPUs als paralleler Vorgang ausgeführt werden kann.
Architektur verteilter Abfragen
Die Datenbank-Engine unterstützt zwei Methoden zum Verweisen auf heterogene OLE DB-Datenquellen in T-SQL-Anweisungen:
Verknüpfte Servernamen
Verwenden Sie die systemgespeicherten Prozeduren
sp_addlinkedserverundsp_addlinkedsrvlogin, um einer OLE DB-Datenquelle einen Servernamen zu geben. Sie können Objekte in diesen verknüpften Servern in T-SQL-Anweisungen mit vierteiligen Namen referenzieren. Wenn z.B. der VerbindungsservernameDeptSQLSrvrfür eine andere Instanz von SQL Server definiert wird, verweist die folgende Anweisung auf eine Tabelle auf diesem Server:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Man kann auch den verknüpften Servernamen in einer
OPENQUERYAnweisung angeben, um ein Rowset aus der OLE DB-Datenquelle zu öffnen. Du kannst dann dieses Zeilenset wie eine Tabelle in T-SQL-Anweisungen referenzieren.Ad-hoc-Konnektornamen
Für seltene Verweise auf eine Datenquelle geben Sie die
OPENROWSEToderOPENDATASOURCEFunktionen mit den Informationen an, die zur Verbindung mit dem verknüpften Server benötigt werden. Du kannst dann die Zeilenmenge genauso referenzieren wie eine Tabelle in T-SQL-Anweisungen:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
Die Datenbank-Engine verwendet OLE DB, um zwischen der relationalen Engine und der Speicher-Engine zu kommunizieren. Die relationale Engine zerlegt jede T-SQL-Anweisung in eine Reihe von Operationen auf grundlegenden OLE-DB-Zeilensätzen, die die Speicher-Engine aus den Basistabellen öffnet. Dieser Prozess bedeutet, dass die relationale Engine auch grundlegende OLE DB-Rowsets auf jeder OLE DB-Datenquelle öffnen kann.
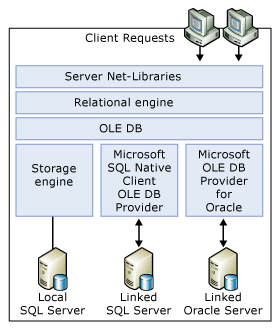
Die relationale Engine verwendet die OLE DB-API (Application Programming Interface), um die Rowsets auf Verbindungsservern zu öffnen, die Zeilen abzurufen und Transaktionen zu verwalten.
Für jede OLE DB-Datenquelle, auf die Sie als verknüpften Server zugreifen, muss auf dem Server, auf dem SQL Server ausgeführt wird, ein OLE DB-Anbieter installiert sein. Die Menge der T-SQL-Operationen, die Sie gegen eine bestimmte OLE DB-Datenquelle verwenden können, hängt von den Fähigkeiten des OLE DB-Anbieters ab.
Für jede Instanz von SQL Server können Mitglieder der sysadmin-festen Serverrolle die Verwendung von Ad-hoc-Anbieternamen für einen OLE DB-Anbieter mithilfe der SQL Server-DisallowAdhocAccess-Eigenschaft aktivieren oder deaktivieren. Wenn Sie Ad-hoc-Zugriff aktivieren, kann jeder Benutzer, der sich in dieser Instanz angemeldet hat, T-SQL-Anweisungen ausführen, die Ad-hoc-Connector-Namen enthalten und auf jede Datenquelle im Netzwerk verweisen, auf die der OLE-Datenbankanbieter zugreifen kann. Um den Zugriff auf Datenquellen zu kontrollieren, können Mitglieder der sysadmin-Serverrolle den Ad-hoc-Zugriff für diesen OLE DB-Anbieter deaktivieren, wodurch die Nutzer auf die Datenquellen beschränkt werden, auf die durch die von den Administratoren definierten Namen verknüpfter Server verwiesen wird. Standardmäßig ist der Ad-hoc-Zugriff für SQL Server-OLE DB-Anbieter aktiviert und für alle anderen OLE DB-Anbieter deaktiviert.
Verteilte Abfragen können es Nutzern ermöglichen, auf eine andere Datenquelle (zum Beispiel Dateien, nicht-relationale Datenquellen wie Active Directory usw.) zuzugreifen, indem sie den Sicherheitskontext des Windows-Kontos verwenden, unter dem der SQL Server-Dienst läuft. Der SQL Server übernimmt entsprechend die Identität des Logins für Windows-Logins. Dieser Identitätswechsel ist jedoch bei SQL Server-Logins nicht möglich. Diese Einschränkung kann es einem verteilten Abfragebenutzer ermöglichen, auf eine andere Datenquelle zuzugreifen, für die er keine Berechtigungen hat, aber das Konto, unter dem der SQL Server-Dienst läuft, hat Berechtigungen. Verwenden Sie sp_addlinkedsrvlogin , um spezifische Anmeldungen mit Zugriffsrechten für die entsprechenden Verbindungsserver zu definieren. Dieses Steuerelement ist für Ad-hoc-Namen nicht verfügbar, daher seien Sie vorsichtig, wenn Sie einen OLE DB-Anbieter für Ad-hoc-Zugriff aktivieren.
Wenn möglich, führt die Datenbank-Engine relationale Operationen wie Joins, Restriktionen, Projektionen, Sortierungen und GROUP BY-Operationen in der OLE DB-Datenquelle aus. Die Datenbank-Engine liest die Basistabelle standardmäßig nicht in SQL Server ein und führt die relationalen Operationen selbst aus. Die Datenbank-Engine fragt den OLE DB-Anbieter ab, um das unterstützte SQL-Grammatikniveau zu bestimmen, und leitet auf Basis dieser Informationen so viele relationale Operationen wie möglich an den Anbieter weiter.
Die Datenbank-Engine spezifiziert einen Mechanismus, mit dem ein OLE DB-Anbieter Statistiken zurückgeben kann, die zeigen, wie Schlüsselwerte innerhalb der OLE DB-Datenquelle verteilt sind. Dieser Mechanismus ermöglicht es dem Datenbank-Engine Query Optimizer, das Datenmuster in der Datenquelle besser anhand der Anforderungen jeder T-SQL-Anweisung zu analysieren und so die Fähigkeit des Query Optimizer zu erhöhen, optimale Ausführungspläne zu erstellen.
Abfrageverarbeitung auf partitionierten Tabellen und Indizes
Die Datenbank-Engine unterstützt partitionsbewusste Abfrageverarbeitung für partitionierte Tabellen und Indexe. Dieser Abschnitt beschreibt, wie der Abfrageprozessor partitionierte Objekte handhabt, wie Ausführungspläne interpretiert werden, die Partitionierung beinhalten, und Best Practices zur Verbesserung der Abfrageleistung bei partitionierten Objekten.
Hinweis
Partitionierte Tabellen und Indizes werden in der SQL Server Standard Edition unterstützt, beginnend mit SQL Server 2016 (13.x) mit Service Pack 1.
Neuer partitionsbewusster Suchvorgang
In der Datenbank-Engine sieht der Abfrageprozessor intern eine partitionierte Tabelle als mehrspaltigen Index mit PartitionID als führender Spalte.
PartitionID ist eine verborgene berechnete Spalte, die intern die ID der Partition, die eine bestimmte Zeile enthält, repräsentiert. Angenommen, die Tabelle T, definiert als T(a, b, c), ist auf Spalte aaufgeteilt und hat einen geclusterten Index auf Spalte b. Diese partitionierte Tabelle wird als nicht-partitionierte Tabelle mit dem Schema T(PartitionID, a, b, c) und einem clusterierten Index auf dem zusammengesetzten Schlüssel (PartitionID, b)behandelt. Diese Darstellung ermöglicht es dem Abfrageoptimierer, Suchoperationen basierend auf PartitionID auf jeder partitionierten Tabelle oder jedem Index durchzuführen.
Die Partitionsentfernung wird jetzt im Suchvorgang vorgenommen.
Zusätzlich wird der Abfrageoptimierer erweitert, sodass eine Such- oder Scan-Operation mit einer Bedingung auf PartitionID (als logische führende Spalte) und möglicherweise anderen Indexschlüsselspalten durchgeführt werden kann. Der Abfrageprozessor führt dann für jeden eindeutigen Wert, der die Qualifikation für die Seek-Operation auf erster Ebene erfüllt, eine Seek-Operation auf zweiter Ebene mit einer anderen Bedingung für eine oder mehrere zusätzliche Spalten durch. Diese Operation, genannt Partition-Skip-Scan, ermöglicht es dem Query Optimizer, eine Such- oder Scan-Operation basierend auf einer Bedingung durchzuführen, um die zu verwendenden Partitionen zu bestimmen, sowie eine zweite Index-Seek-Operation innerhalb dieses Operators, um Zeilen aus diesen Partitionen zurückzugeben, die eine andere Bedingung erfüllen. Sehen Sie sich zum Beispiel die folgende Abfrage an:
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Für dieses Beispiel nehmen wir an, dass die Tabelle T, definiert als T(a, b, c), in der Spalte a partitioniert ist und in der Spalte b einen Clusterindex besitzt. Die folgende Partitionsfunktion definiert die Partitionsgrenzen für die Tabelle T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Zur Auflösung der Abfrage führt der Abfrageprozessor zunächst einen Suchvorgang der ersten Ebene durch, in dem alle Partitionen mit Zeilen, die die Bedingung T.a < 10erfüllen, gesucht werden. Diese Operation identifiziert die Partitionen, auf die man zugreifen soll. Innerhalb jeder identifizierten Partition führt der Prozessor dann eine zweite Stufe der Suche in den geclusterten Index an der Spalte b durch, um die Zeilen zu finden, die die Bedingung T.b = 2 und T.a < 10erfüllen.
Die folgende Abbildung ist eine logische Darstellung der Partition-Skip-Scan-Operation. Sie zeigt die Tabelle T mit Daten in den Spalten a und b. Die Partitionen sind mit 1 bis 4 nummeriert, wobei die Partitionsgrenzen durch gestrichelte vertikale Linien angezeigt werden. Eine Suchoperation auf erster Ebene der Partitionen (nicht in der Abbildung gezeigt) bestimmt, dass die Partitionen 1, 2 und 3 die durch die für die Tabelle definierte Partitionierung und das Prädikat auf Spalte a (T.a < 10) implizierte Suchbedingung erfüllen. Der von der zweiten Suchebene durchquerte Pfad wird durch die gekrümmte Linie dargestellt. Im Wesentlichen sucht die Operation in jeder dieser Partitionen nach Zeilen, die die Bedingung b = 2erfüllen. Die Gesamtkosten der Operation entsprechen denen von drei separaten Indexsuchen.
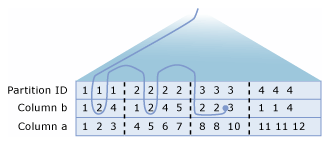
Anzeigen von Partitionierungsinformationen in Abfrageausführungsplänen
Untersuchen Sie die Ausführungspläne von Abfragen auf partitionierten Tabellen und Indizes mithilfe der T-SQL-Anweisungen SETSET SHOWPLAN_XML oder SET STATISTICS XML, oder durch Verwendung der grafischen Ausgabe des Ausführungsplans in SSMS. Zum Beispiel können Sie den Ausführungsplan zur Kompilierzeit anzeigen, indem Sie auf der Symbolleiste des Abfrage-EditorDisplay Estimated Execution Plan auswählen, und den Laufzeitplan, indem Sie Include Actual Execution Plan auswählen.
Mit der Nutzung dieser Werkzeuge finden Sie folgende Informationen:
- Die Operationen wie Scans, Suchen, Einfügen, Aktualisierungen, Zusammenführungen und Löschungen mit Zugriff auf partitionierte Tabellen oder Indizes.
- Die Partitionen, auf die durch die Abfrage zugegriffen wird. Beispielsweise umfassen Ausführungspläne zur Laufzeit die Gesamtzahl der zugegriffenen Partitionen und die Bereiche der zusammenhängenden Partitionen, auf die zugegriffen wird.
- Wenn eine Partitions-Skip-Scan-Operation in einer Such- oder Scan-Operation verwendet wird, um Daten von einer oder mehreren Partitionen abzurufen.
Verbesserungen bei den Partitionierungsinformationen
Die Datenbank-Engine bietet erweiterte Partitionierungsinformationen sowohl für Kompilierungszeit- als auch für Laufzeitausführungspläne. Die Ausführungspläne enthalten jetzt die folgenden Informationen:
- Ein optionales
PartitionedAttribut, das angibt, dass ein Operator wie Suchen, Scannen, Einfügen, Aktualisieren, Zusammenführen oder Löschen auf einer partitionierten Tabelle ausgeführt wird. - Ein neues
SeekPredicateNew-Element mit einemSeekKeys-Unterelement, dasPartitionIDals führende Indexschlüsselspalte sowie Filterbedingungen enthält, mit denen Bereichssuchen fürPartitionIDfestgelegt werden. Das Vorhandensein von zweiSeekKeysUnterelementen weist auf einen Partitions-Skip-Scan aufPartitionIDhin. - Zusammenfassende Informationen mit der Gesamtanzahl der Partitionen, auf die zugegriffen wird. Diese Informationen sind nur in Laufzeitplänen verfügbar.
Nehmen Sie die folgende Abfrage für die partitionierte Tabelle fact_salesals Beispiel zur Veranschaulichung, wie diese Informationen im grafischen Ausführungsplan und in der XML-Showplanausgabe angezeigt werden. Durch diese Abfrage werden Daten in zwei Partitionen aktualisiert.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
Die folgende Abbildung zeigt die Eigenschaften des Clustered Index Seek-Operators im Laufzeitausführungsplan für diese Abfrage. Um die Definition der Tabelle fact_sales und die Partitionsdefinition anzusehen, siehe Beispiel.
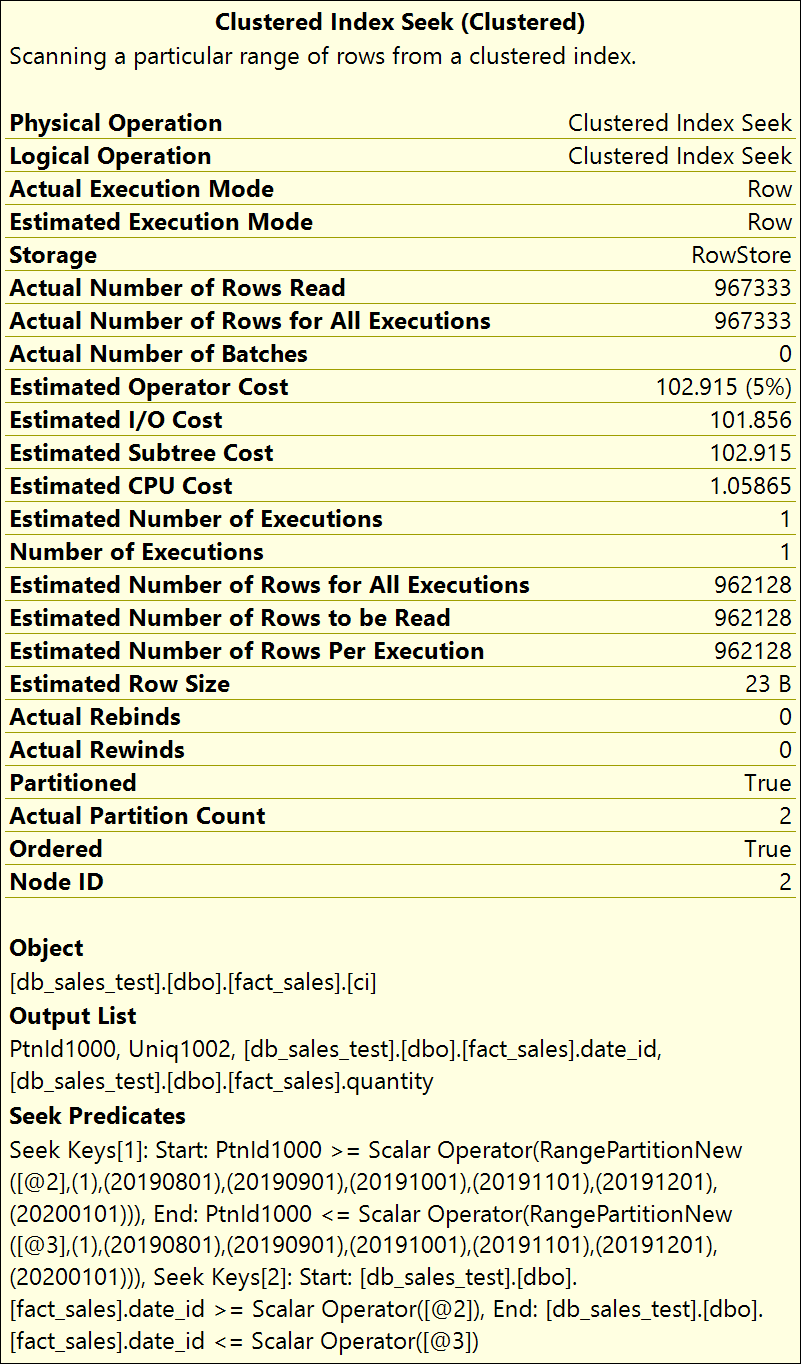
Partitioniertes Attribut
Wenn ein Operator wie „Index Seek“ für eine partitionierte Tabelle oder einen partitionierten Index ausgeführt wird, enthalten der Kompilierzeit- und Laufzeitplan das Attribut Partitioned, das auf True (1) festgelegt wird. Das Attribut wird nicht angezeigt, wenn es auf False (0) gesetzt ist.
Das Partitioned -Attribut kann in den folgenden physischen und logischen Operatoren erscheinen:
- Tabellen-Scan
- Index-Scan
- Indexsuche
- Einfügen
- Aktualisierung
- Löschen
- Zusammenführen
Wie in der vorherigen Abbildung gezeigt, erscheint dieses Attribut in den Eigenschaften des Operators, in dem es definiert ist. In der XML-Showplan-Ausgabe erscheint dieses Attribut wie Partitioned="1" im RelOp Knoten des Operators, in dem es definiert ist.
Neues Suchprädikat
In der XML-Showplan-Ausgabe erscheint das Element SeekPredicateNew in dem Operator, in dem es definiert ist. Das Element kann maximal zwei Instanzen des SeekKeys -Unterelements enthalten. Das erste SeekKeys Element spezifiziert den Suchvorgang der ersten Ebene auf der Partitions-ID-Ebene des logischen Index. Das heißt, diese Suchoperation bestimmt die Partitionen, auf die zugegriffen werden müssen, um die Bedingungen der Abfrage zu erfüllen. Das zweite SeekKeys Element spezifiziert den Seek auf zweiter Ebene, der innerhalb jeder im ersten Niveau identifizierten Partition erfolgt.
Zusammenfassung der Partitionsinformationen
In Laufzeitausführungsplänen geben die zusammenfassenden Partitionsinformationen Auskunft darüber, auf wie viele und auf welche Partitionen zugegriffen wird. Anhand dieser Informationen können Sie überprüfen, ob in der Abfrage auf die richtigen Partitionen zugegriffen wird und ob alle anderen Partitionen vom Zugriff ausgenommen werden.
Die folgenden Informationen werden bereitgestellt: Actual Partition Countund Partitions Accessed.
Actual Partition Count ist die Gesamtzahl der Partitionen, auf die durch die Abfrage zugegriffen wird.
Partitions Accessed, in der XML-Showplan-Ausgabe ist die Partitionszusammenfassungsinformation, die im neuen RuntimePartitionSummary Element im RelOp Knoten des Operators erscheint, in dem es definiert ist. Das folgende Beispiel zeigt den Inhalt des RuntimePartitionSummary -Elements, durch den angegeben wird, dass auf insgesamt zwei Partitionen (Partition 2 und 3) zugegriffen wird.
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Anzeige von Partitionsinformationen mithilfe anderer Showplan-Methoden
Die Showplanmethoden SHOWPLAN_ALL, SHOWPLAN_TEXTund STATISTICS PROFILE stellen keine der in diesem Thema beschriebenen Partitionsinformationen bereit, mit der folgenden Ausnahme. Als Teil des SEEK -Prädikats werden die Partitionen, auf die zugegriffen werden muss, durch ein Bereichsprädikat für die berechnete Spalte, die die Partitions-ID repräsentiert, identifiziert. Das folgende Beispiel zeigt das SEEK -Prädikat für einen Clustered Index Seek -Operator. Es wird auf die Partitionen 2 und 3 zugegriffen, und der SEEK-Operator filtert die Zeilen heraus, die die Bedingung date_id BETWEEN 20190802 AND 20190902erfüllen.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Interpretieren von Ausführungsplänen für partitionierte Heaps
Ein partitionierter Heap wird als logischer Index für die Partitions-ID behandelt. In einem Ausführungsplan wird die Partitionselimination auf einem partitionierten Heap als Operator Table Scan mit einem SEEK Prädikat auf der Partitions-ID dargestellt. Das folgende Beispiel zeigt die bereitgestellten Showplan-Informationen:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Interpretieren von Ausführungsplänen für angeordnete Joins
Eine Anordnung von Joins kann eintreten, wenn zwei Tabellen mit derselben oder einer ähnlichen Partitionsfunktion partitioniert und die Partitionierungsspalten auf beiden Seiten des Joins in der Join-Bedingung der Abfrage angegeben werden. Der Abfrageoptimierer kann einen Plan erzeugen, in dem die Partitionen aller Tabellen mit identischer Partitions-ID separat verknüpft werden. Angeordnete Joins sind jedoch möglicherweise schneller als nicht angeordnete, da sie ggf. weniger Arbeitsspeicher und weniger Verarbeitungszeit benötigen. Der Abfrageoptimierer wählt einen nicht-kollokierten Plan oder einen kollokierten Plan basierend auf den Kostenschätzungen aus.
Bei einem Plan für angeordnete Joins liest der Nested Loops-Join eine oder mehrere zusammengefasste Tabellen- oder Indexpartitionen auf der Innenseite. Die Zahlen in den Constant Scan -Operatoren repräsentieren die Partitionsnummern.
Wenn parallele Pläne für angeordnete Joins für partitionierte Tabellen oder Indizes erzeugt werden, wird ein Parallelism-Operator zwischen dem Constant Scan-Joinoperator und dem Nested Loops-Joinoperator eingefügt. In diesem Fall lesen und bearbeiten mehrere Arbeitsthreads auf der Außenseite des Joins jeweils eine andere Partition.
Die folgende Abbildung zeigt einen parallelen Abfrageplan für einen angeordneten Join.
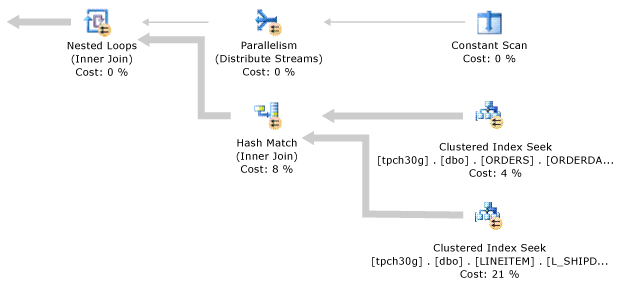
Parallele Ausführungsstrategie für Abfragen bei partitionierten Objekten
Der Abfrageprozessor verwendet eine parallele Ausführungsstrategie für Abfragen bei partitionierten Objekten. Im Rahmen dieser Ausführungsstrategie ermittelt der Abfrageprozessor die für die Abfrage erforderlichen Tabellenpartitionen und die den einzelnen Partitionen zugewiesenen Arbeitsthreadanteile. In den meisten Fällen ordnet der Abfrageprozessor den einzelnen Partitionen eine etwa gleich große Anzahl an Arbeitsthreads zu und führt anschließend die Abfrage partitionsübergreifend parallel aus. In den folgenden Absätzen wird die Arbeitsthreadzuordnung näher erläutert.
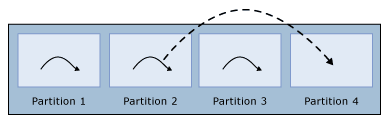
Wenn die Arbeitsthreadanzahl kleiner ist als die Partitionsanzahl, ordnet der Abfrageprozessor jeden Arbeitsthread einer anderen Partition zu, und zunächst verbleiben eine oder mehrere Partitionen ohne Arbeitsthreadzuordnung. Wenn ein Worker-Thread auf einer Partition seine Ausführung beendet, weist der Abfrageprozessor ihn der nächsten Partition zu, bis jeder Partition ein einziger Worker-Thread zugewiesen ist. Diese Zuweisung ist der einzige Fall, in dem der Abfrageprozessor Worker-Threads auf andere Partitionen umverteilt.
Zeigt einen Arbeitsthread, der nach seinem Abschluss erneut zugeordnet wurde. Wenn die Anzahl von Arbeitsthreads gleich der Anzahl von Partitionen ist, weist der Abfrageprozessor jeder Partition einen Arbeitsthread zu. Abgeschlossene Arbeitsthreads werden nicht erneut einer anderen Partition zugeordnet.
Wenn die Anzahl der Arbeitsthreads größer ist als die Anzahl der Partitionen, weist der Abfrageprozessor jeder Partition dieselbe Anzahl an Arbeitsthreads zu. Wenn die Anzahl der Worker-Threads nicht ein exaktes Vielfaches der Anzahl der Partitionen ist, weist der Abfrageprozessor einen zusätzlichen Worker-Thread einigen Partitionen zu, um alle verfügbaren Worker-Threads zu nutzen. Wenn es nur eine Partition gibt, werden alle Worker-Threads dieser Partition zugewiesen. Im folgenden Diagramm gibt es vier Partitionen und 14 Worker-Threads. Jede Partition hat drei Worker-Threads zugewiesen, und zwei Partitionen haben einen zusätzlichen Worker-Thread, also insgesamt 14 Worker-Thread-Zuweisungen. Wenn ein Arbeitsthread abgeschlossen ist, wird er keiner anderen Partition zugeordnet.
Obwohl die vorherigen Beispiele eine einfache Möglichkeit zur Zuweisung von Worker-Threads nahelegen, ist die eigentliche Strategie komplexer und berücksichtigt andere Variablen, die während der Abfrageausführung auftreten. Wenn zum Beispiel die Tabelle partitioniert ist und einen clusterierten Index für die Spalte A hat und eine Abfrage die Prädikatklausel WHERE A IN (13, 17, 25) hat, weist der Abfrageprozessor jedem dieser drei Suchwerte (A = 13, A = 17 und A = 25) einen oder mehrere Worker-Threads zu, anstatt jeder Tabellenpartition. Es ist nur notwendig, die Abfrage in den Partitionen auszuführen, die diese Werte enthalten, und wenn sich alle diese Seek-Prädikate in derselben Tabellenpartition befinden, wird allen Worker-Threads dieselbe Tabellenpartition zugewiesen.
Um ein weiteres Beispiel zu nehmen: Angenommen, die Tabelle hat vier Partitionen in der Spalte A mit Randpunkten (10, 20, 30), einen Index in der Spalte B, und die Abfrage hat eine Prädikatklausel WHERE B IN (50, 100, 150). Da die Tabellenpartitionen auf den Werten von Abasieren, können die Werte von B in jeder der Tabellenpartitionen auftreten. Daher sucht der Abfrageprozessor nach jedem der drei Werte von B (50, 100, 150) in jeder der vier Tabellenpartitionen. Der Abfrageprozessor weist Worker-Threads proportional zu, sodass er jeden dieser 12 Abfragescans parallel ausführen kann.
Tabellenpartitionen basierend auf Spalte A |
Sucht in jeder Tabellenpartition nach Spalte B |
|---|---|
Tabellenpartition 1: A < 10 |
B = 50, B = 100B = 150 |
Tabellenpartition 2: A >= 10 AND A < 20 |
B = 50, B = 100B = 150 |
Tabellenpartition 3: A >= 20 AND A < 30 |
B = 50, B = 100B = 150 |
Tabellenpartition 4: A >= 30 |
B = 50, B = 100B = 150 |
Bewährte Methoden
Um die Leistung von Abfragen zu verbessern, die auf große Datenmengen aus großen partitionierten Tabellen und Indizes zugreifen, folgen Sie diesen Best Practices:
Verteilen Sie alle Partitionen über viele Datenträger (Datenträgerstriping). Dieser Ansatz ist besonders relevant bei der Verwendung rotierender Festplatten.
Verwenden Sie möglichst einen Server mit einem Hauptspeicher, der groß genug ist für Partitionen, auf die häufig zugegriffen wird, bzw. für alle Partitionen, um die E/A-Kosten zu senken.
Wenn die Daten, die du absuchst, nicht in den Speicher passen, komprimiere die Tabellen und Indizes, um die I/O-Kosten zu senken.
Verwenden Sie einen Server mit schnellen und möglichst vielen Prozessoren, um sich die Vorteile der parallelen Abfrageverarbeitung zu Nutze zu machen.
Stellen Sie sicher, dass der Server über eine ausreichend große E/A-Controllerbandbreite verfügt.
Erstellen Sie für jede große partitionierte Tabelle einen gruppierten Index, um den optimierten B-Strukturscan nutzen zu können.
Beim Großladen von Daten in partitionierte Tabellen befolgen Sie die Best-Practice-Empfehlungen im Whitepaper The Data Loading Performance Guide.
Beispiel
Im folgenden Beispiel wird eine Testdatenbank mit einer Tabelle, die sieben Partitionen aufweist, erstellt. Um Partitionierungsinformationen sowohl für Compile-Time- als auch Laufzeitpläne anzuzeigen, verwenden Sie die in Partitionierungsinformationen in Abfrageausführungsplänen anzeigen beschriebenen Werkzeuge beim Ausführen der Abfragen in diesem Beispiel.
Hinweis
In diesem Beispiel werden über eine Millionen Zeilen in die Tabelle eingefügt. Je nach Hardware kann die Ausführung dieses Beispiels einige Minuten dauern. Stellen Sie vor dem Ausführen dieses Beispiels sicher, dass mehr als 1,5 GB Speicherplatz zur Verfügung stehen.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Zugehöriger Inhalt
- Referenz zu logischen und physischen Showplan-Operatoren
- Erweiterte Ereignisübersicht
- Bewährte Methoden für die Überwachung von Workloads mit Abfragespeicher
- Kardinalitätsschätzung (SQL Server)
- Intelligente Abfrageverarbeitung in SQL-Datenbanken
- Operatorrangfolge (Transact-SQL)
- Übersicht über den Ausführungsplan
- Leistungscenter für SQL Server-Datenbank-Engine und Azure SQL-Datenbank