Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Verwenden Sie das Batchverarbeitungskit zum Ergänzen und Aufskalieren von Workloads in Speech-Containern. Dieses als Container verfügbare Open-Source-Hilfsprogramm erleichtert die Batchverabeitung großer Mengen an Audiodateien über eine beliebige Anzahl lokaler und cloudbasierter Speech-Containerendpunkte.
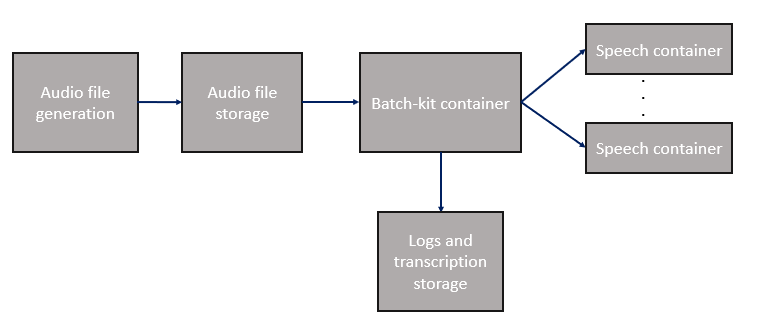
Der Batchkit-Container ist kostenlos auf GitHub und Docker-Hub verfügbar. Sie werden nur für die verwendeten Sprachcontainer in Rechnung gestellt .
| Funktion | BESCHREIBUNG |
|---|---|
| Batchverteilung von Audiodateien | Verteilen Sie automatisch eine große Anzahl von Dateien an lokale oder cloudbasierte Speech-Containerendpunkte. Die Dateien können sich in jedem POSIX-konformen Volume befinden, einschließlich Netzwerkdateisystemen. |
| Speech SDK-Integration | Übergeben Sie allgemeine Flags an das Speech SDK, darunter N-Best-Hypothesen, Diarisierung, Sprache, Maskierung von Obszönitäten. |
| Ausführungsmodi | Führen Sie den Batchclient einmal kontinuierlich im Hintergrund aus, oder erstellen Sie HTTP-Endpunkte für Audiodateien. |
| Fehlertoleranz | Automatisches Wiederholen und Fortsetzen der Transkription ohne Verlust des Fortschritts und Unterscheidung zwischen Fehlern mit und ohne Wiederholungsmöglichkeit. |
| Erkennung der Endpunktverfügbarkeit | Wenn ein Endpunkt nicht mehr verfügbar ist, setzt der Batchclient die Transkription mithilfe anderer Containerendpunkte fort. Wenn der Client verfügbar ist, fängt er automatisch an, den Endpunkt zu verwenden. |
| Endpunkt-Hot-Swapping | Speech-Containerendpunkte können zur Laufzeit hinzugefügt, entfernt oder geändert werden, ohne dass der Batchverlauf unterbrochen wird. Updates erfolgen sofort. |
| Protokollierung in Echtzeit | Echtzeitprotokollierung von versuchten Anforderungen, Zeitstempeln und Fehlerursachen mit Speech SDK-Protokolldateien für jede Audiodatei. |
Sicheres Verarbeiten von langen Audiodaten
Sprachcontainer unterstützen Audio mit einer maximalen Dauer von 24 Stunden. Segmentieren Sie alle Audiodaten länger als 24 Stunden, bevor Sie sie zur Transkription übermitteln. Die Dateigröße ist kein zuverlässiger Ersatz für die Dauer, da die Codierung, Samplerate, Bittiefe und Kanalanzahl die Anzahl der Bytes bestimmen. Beispielsweise ist 1 GB kein universeller Segmentierungsschwellenwert.
Einige Audiopipelines verwenden einen 32-Bit-Zähler, um die Dauer zu berechnen. Nach etwa 37,3 Stunden kann der Zähler überlaufen und eine kürzere, scheinbar gültige Zeitangabe erzeugen. In diesem Fall kann die Transkription Erfolg melden, ohne darauf hinzuweisen, dass das Ergebnis abgeschnitten ist. Die genaue Stelle im Code dieses Overflows ist nicht bekannt.
Vergleichen Sie nach der Transkription die ursprüngliche Audiodauer mit dem endgültigen Transkript-Offset oder dem neuesten erkannten Zeitstempel. Behandeln Sie ein Ergebnis, das deutlich vor dem Ende des Quellaudios endet, als unvollständig, auch wenn die Transkription Erfolg meldet.
Wenn Sie Quellaudio in RIFF/WAV konvertieren, verwenden Sie diese Werte, um zu ermitteln, wo ein Überlauf aufgetreten ist:
- Die Länge des konvertierten WAV-Datenblocks von
274,568,704Bytes weist auf einen Überlauf bei der Konvertierung oder beim Schreiben der Datei hin. - Eine Länge eines Datenblocks von
4,569,536,000Bytes oder eine Datei mit einer Größe von mehr als 4 GB und einem korrekten Header weist darauf hin, dass die Datei ordnungsgemäß geschrieben wurde und der Überlauf erst später in der Verarbeitungspipeline auftrat. Wenden Sie sich an den Microsoft-Support, damit für diesen Fall das Entwicklungsteam hinzugezogen wird.
RF64 und Wave64 (W64) sind keine Drop-In-Korrekturen für dieses Problem. Jeder Reader und jeder Pfad zur Dauerprüfung in der Pipeline muss das ausgewählte Format unterstützen. Zum Beispiel lehnt das integrierte Python-waveModul RF64-Dateien ab.
Abrufen des Containerimages mit docker pull
Verwenden Sie den Docker Pull-Befehl, um den aktuellsten Batchkit-Container herunterzuladen.
Hinweis
Im folgenden Beispiel wird ein öffentliches Container-Image von Docker Hub abgerufen. Es wird empfohlen, dass Sie sich zuerst mit Ihrem Docker Hub Konto (docker login) authentifizieren, anstatt eine anonyme Abrufanforderung zu erstellen. Um die Zuverlässigkeit bei der Verwendung öffentlicher Inhalte zu verbessern, sollten Sie das Image in einer privaten Azure-Containerregistrierung importieren und verwalten. Weitere Informationen zur Verwendung öffentlicher Images finden Sie hier.
docker pull docker.io/batchkit/speech-batch-kit:latest
Endpunktkonfiguration
Der Batchclient verwendet eine YAML-Konfigurationsdatei, die die lokalen Containerendpunkte angibt. Schreiben Sie das folgende Beispiel in /mnt/my_nfs/config.yaml, das in den folgenden Beispielen verwendet wird.
MyContainer1:
  concurrency: 5
  host: 192.168.0.100
  port: 5000
  rtf: 3
MyContainer2:
  concurrency: 5
  host: BatchVM0.corp.redmond.microsoft.com
  port: 5000
  rtf: 2
MyContainer3:
  concurrency: 10
  host: localhost
  port: 6001
  rtf: 4
In diesem YAML-Beispiel werden drei Sprachcontainer auf drei Hosts angegeben. Der erste Host wird durch eine IPv4-Adresse angegeben, der zweite Host wird auf demselben virtuellen Computer wie der Batchclient ausgeführt, und der dritte Container wird vom DNS-Hostnamen eines anderen virtuellen Computers angegeben. Der Wert concurrency gibt die maximale Anzahl der parallel ausgeführten Dateitranskriptionen für einen Container an. Der Wert rtf (Echtzeitfaktor) ist optional und kann zum Optimieren der Leistung verwendet werden.
Der Batchclient kann dynamisch erkennen, wenn ein Endpunkt nicht mehr verfügbar ist (beispielsweise aufgrund eines Containerneustarts oder eines Netzwerkproblems) und wenn seine Verfügbarkeit wieder besteht. Transkriptionsanforderungen werden nicht an Container gesendet, die nicht verfügbar sind, und der Client fährt mit der Verwendung anderer, verfügbarer Container fort. Sie können Endpunkte jederzeit hinzufügen, entfernen oder bearbeiten, ohne den Fortschritt des Batches zu unterbrechen.
Ausführen des Batchverarbeitungs-Containers
Hinweis
- In diesem Beispiel wird das gleiche Verzeichnis (
/my_nfs) für die Konfigurationsdatei und die Eingabe-, Ausgabe- und Protokollverzeichnisse verwendet. Sie können gehostete oder in NFS eingebundene Verzeichnisse für diese Ordner verwenden. - Durch Ausführen des Clients mit dem Flag
–hwerden die verfügbaren Befehlszeilenparameter mit ihren Standardwerten aufgelistet. - Der Batchverarbeitungscontainer wird nur unter Linux unterstützt.
Verwenden Sie den run-Befehl von Docker, um den Container zu starten. Dieser Befehl startet eine interaktive Shell innerhalb des Containers.
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs --entrypoint /bin/bash /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest
So führen Sie den Batchclient aus:
run-batch-client -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs -file_log_level DEBUG -nbest 1 -m ONESHOT -diarization None -language en-US -strict_config
So führen Sie Batchclient und-Container mit einem einzelnen Befehl aus:
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs
Der Client wird ausgeführt. Wenn eine Audiodatei in einem vorherigen Testlauf transkribiert wurde, überspringt der Client die Datei automatisch. Dateien werden für den Fall von Übertragungsfehlern mit automatischer Wiederholung gesendet, und Sie können unterscheiden, bei welchen Fehlern der Client die Wiederholung versuchen soll. Bei einem Transkriptionsfehler setzt der Client die Transkription fort und kann es erneut versuchen, wobei der Fortschritt beibehalten wird.
Ausführungsmodi
Das Batchverarbeitungskit bietet über den Parameter --run-mode drei Modi.
Im ONESHOT-Modus wird ein einzelner Batch von Audiodateien (aus einem Eingabeverzeichnis und einer optionalen Dateiliste) in einen Ausgabeordner transkribiert.
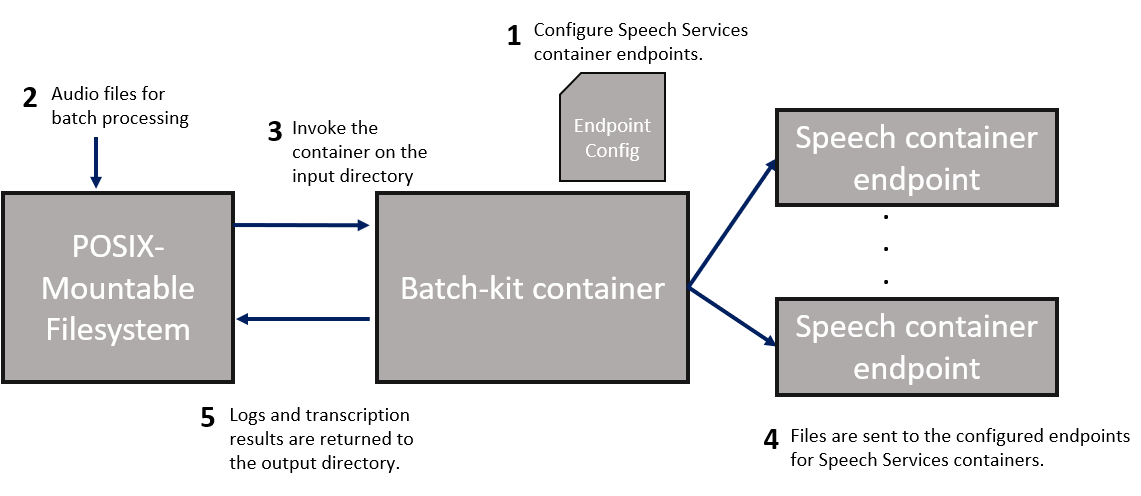
- Definieren Sie die vom Batchclient zu verwendenden Speech-Containerendpunkte in der Datei
config.yaml. - Platzieren Sie Audiodateien für die Transkription in einem Eingabeverzeichnis.
- Rufen Sie den Container für das Verzeichnis auf, um mit der Verarbeitung der Dateien zu beginnen. Wenn die Audiodatei bereits in einem vorherigen Durchgang mit demselben Ausgabeverzeichnis (dem gleichen Dateinamen und der gleichen Prüfsumme) transkribiert wurde, überspringt der Client die Datei.
- Die Dateien werden an die Containerendpunkte aus Schritt 1 verteilt.
- Protokolle und die Speech-Containerausgabe werden an das angegebene Ausgabeverzeichnis zurückgegeben.
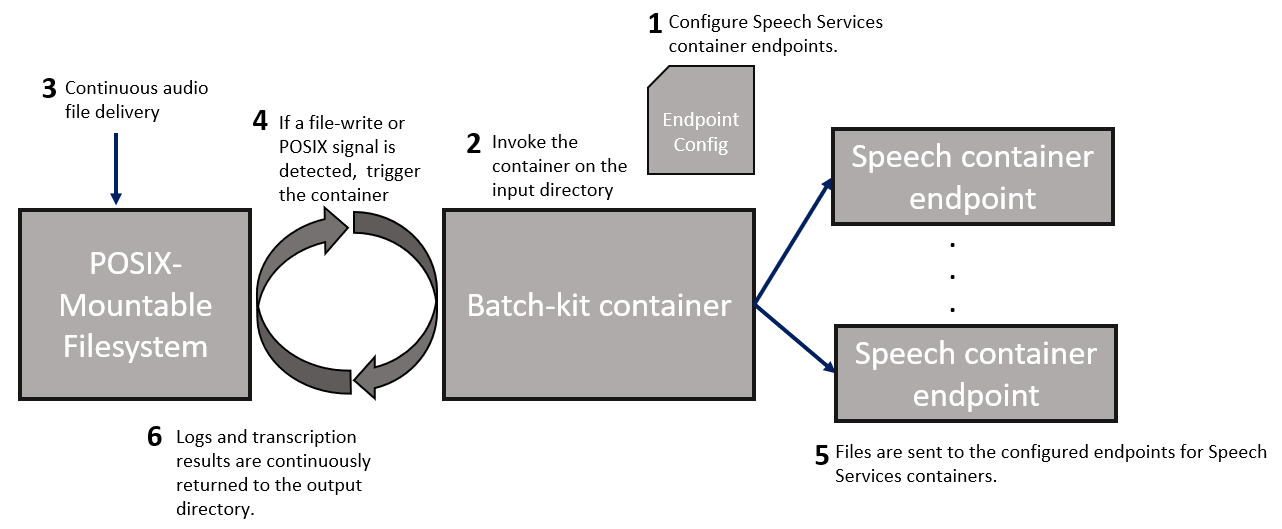

Protokollierung
Hinweis
Der Batchclient überschreibt die Datei run.log regelmäßig, wenn sie zu groß wird.
Der Client erstellt eine run.log-Datei in dem Verzeichnis, das im -log_folder-Argument im Docker-Befehl run angegeben ist. Protokolle werden standardmäßig mit dem Protokolliergrad DEBUG erfasst. Die gleichen Protokolle werden an stdout/stderr gesendet und anhand der Argumente -file_log_level oder console_log_level gefiltert. Dieses Protokoll ist nur zum Debuggen erforderlich oder wenn Sie eine Ablaufverfolgung an den Support senden müssen. Der Protokollierungsordner enthält außerdem die Protokolle des Speech SDK für die einzelnen Audiodateien.
Das durch -output_folder angegebene Ausgabeverzeichnis enthält die Datei run_summary.json, die regelmäßig alle 30 Sekunden oder jeweils beim Abschluss neuer Transkriptionen neu geschrieben wird. Sie können diese Datei verwenden, um bei fortschreitender Verarbeitung des Batches den Status zu überprüfen. Wenn der Batch abgeschlossen ist, enthält diese Datei außerdem die endgültige Ausführungsstatistik und den Abschlussstatus jeder Datei. Der Batch ist abgeschlossen, wenn der Prozess zu einem ordnungsgemäßen Ende gelangt.