Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Important
Dieses Feature befindet sich in der Betaversion.
Das Agentengedächtnis gibt deinen Agenten ein Langzeitgedächtnis, das über Gespräche hinweg erhalten bleibt. Azure Databricks speichert das Gedächtnis in Lakebase und verwaltet Speicher, Indizierung und Suche für Sie, sodass Ihre Agents sich Benutzerpräferenzen, bisherige Entscheidungen und den gesammelten Kontext merken können, ohne dass Sie eine Datenbank betreiben müssen.
Note
Während der Vorschau werden Sie für die zugrundeliegende Lakebase-Instanz abgerechnet, die Ihre Speichereinträge speichert. Für den Agentenspeicher selbst fallen keine zusätzlichen Gebühren an. Die Preise können sich im Verlauf der Vorschau ändern.
Nutzen Sie das Agentengedächtnis, wenn Sie möchten, dass Ihre Agenten Folgendes tun:
- Erinnern Sie sich an Nutzerpräferenzen, Fakten und Entscheidungen über verschiedene Gespräche hinweg.
- Personalisiere die Antworten basierend auf dem, was ein Agent in früheren Sitzungen gelernt hat.
- Teilen Sie gesammeltes Wissen zwischen Agenten und Projekten.
- Verbessern Sie die Genauigkeit und Effizienz im Laufe der Zeit.
Agent memory funktioniert mit Agenten, die auf jedem Framework basieren. Für eine kurzfristige Gesprächshistorie innerhalb einer einzigen Interaktion verwenden Sie Agentensitzungen.
Anforderungen
- Installiere Python 3.10 oder höher, um das AgentKit SDK zu verwenden. Das AgentKit SDK ist der Databricks-Python-Client für Agenten-APIs, den die untenstehenden Beispiele verwenden. Du kannst die REST-API auch direkt aus jeder Sprache aufrufen, ohne dass du Python brauchst.
- Um
memory_store.put()odermemory_store.list(path=...)zu verwenden, installieren Siedatabricks-agentbricks0.6.0 oder höher.
Wie der Agentenspeicher funktioniert
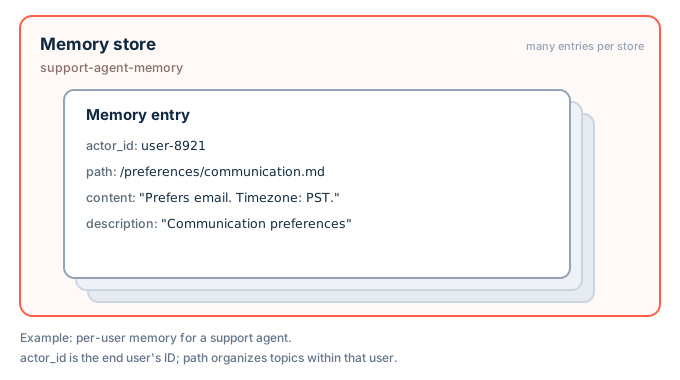
Das Agentengedächtnis hat zwei Stufen:
- Ein Erinnerungsspeicher ist der auf einen Workspace beschränkte Container für die Erinnerungen eines Agenten. Beim Erstellen eines Stores wird der zugrunde liegende Lakebase-Speicher automatisch bereitgestellt. Du adressierst einen Shop mit seiner Store-ID, die du beim Erstellen des Stores auswählst.
- Ein Speichereintrag ist ein einzelnes Inhaltselement in einem Speicher. Jeder Eintrag enthält einen freien Text,
contenteine Kurzformdescriptionfür den Abruf und eine Reihe von Feldern, die ihn organisieren und aufteilen:-
actor_id(erforderlich): Wem der Speicher gehört, zum Beispiel einem Endnutzer oder einem anderen Agenten. -
session_id(optional): die Sitzung, zu der die Erinnerung gehört. Lassen Sie die Einstellung leer, damit der Speicher über alle Sitzungen des Akteurs hinweg gilt. -
path(erforderlich): Ein Dateisystem-ähnlicher Pfad, der Einträge innerhalb eines Aktors organisiert, wie zum Beispiel/preferences/response-style.md.
-
Ein Eintrag wird eindeutig durch die Kombination von actor_id, session_id, und pathidentifiziert. Derselbe Pfad unter zwei verschiedenen Sitzungen oder innerhalb einer Sitzung bzw. ohne Sitzung enthält zwei separate Einträge.
Einträge gelangen auf zwei Arten in einen Store: Ihr Agent oder Ihre Anwendung schreibt sie direkt oder eine Speicherpipeline destilliert sie aus den Gesprächen in einem Sitzungsspeicher.
Abrufen
Speicher werden auf zwei Arten abgerufen:
-
Liste der Einträge für einen Akteur, optional gefiltert nach
session_id, einempathPräfix oder einem exaktenpath. Nutzen Sie dies, um zu durchstöbern oder ein Verzeichnis dessen zu erstellen, was ein Makler weiß. - Durchsuchen Sie Einträge zu einem Akteur mithilfe einer natürlichsprachlichen Abfrage. Die Suche liefert die relevantesten Einträge nach Relevanzbewertung zurück.
Ein Filter bei jeder der beiden Operationen session_id gibt nur die mit der jeweiligen Sitzung gespeicherten Einträge zurück. Es werden keine ohne Sitzung gespeicherten Einträge zurückgegeben.
Get started
Die Beispiele des AgentKit SDK und der REST API richten Agentenspeicher für einen Support-Agenten ein: Sie erstellen einen Speicher, speichern die Präferenz des Benutzers und rufen sie in einem späteren Gespräch ab. Das Agent Bricks CLI-Beispiel verbindet einen Speicher mit einem Agenten, den du mit der CLI baust und deployest. Wählen Sie den Kunden, der zu Ihrem Projekt passt. Eine Speicher-ID muss 3 bis 56 Zeichen umfassen, mit einem kleinen Buchstabe beginnen, mit einem Buchstaben oder einer Zahl enden und nur Kleinbuchstaben, Zahlen und Bindestriche enthalten.
AgentKit SDK
Das AgentKit SDK ist der Databricks-Python-Client für Agenten-APIs, der im Paket databricks-agentbricks verteilt wird. Die Authentifizierung erfolgt über das WorkspaceClient des Databricks SDK.
Installieren Sie das AgentKit SDK:
pip install databricks-agentbricksErstelle einen Speicher für deinen Agenten.
AgentKitClientauthentifiziert sich mit IhrenWorkspaceClientAnmeldedaten:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")Speichere eine Erinnerung, nachdem der Agent etwas Dauerhaftes über einen Nutzer erfahren hat.
actor_idist, wessen Speicher dies ist,pathorganisiert es innerhalb dieses Akteurs unddescriptionverbessert den Abruf:memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )add()schlägt mitALREADY_EXISTSfehl, wenn bereits ein Eintrag auf diesem Pfad existiert. Um den Eintrag zu erstellen oder den bestehenden zu aktualisieren, rufememory_store.put()mit denselben Argumenten auf.Rufen Sie die Erinnerungen des Nutzers in einem späteren Gespräch mit einer Suche in natürlicher Sprache ab:
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)
REST API
Die Clients rufen die REST-API unter /api/2.0/agents/memory-stores. Rufen Sie sie direkt in anderen Sprachen als Python auf.
Generiere ein OAuth-Token mit der Databricks-CLI:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Erstelle einen Speicher für deinen Agenten:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores?managed_memory_store_id=support-agent-memory" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent memory"}'
Speichere einen Speichereintrag für einen Benutzer.
actor_idist, wessen Speicher dies ist,pathorganisiert es unddescriptionverbessert den Abruf:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'Wenn bereits ein Eintrag auf diesem Pfad existiert, schlägt die Anfrage mit
ALREADY_EXISTS(HTTP 409) fehl. Um den bestehenden Eintrag stattdessen zu aktualisieren, suche ihn über den Pfad. Die Suche liefert für jede Sitzung die Einträge des Pfades zurück, also wähle den, dessensession_idübereinstimmt. Das letzte Segment seinernameist die Eintrags-ID:curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \ --data-urlencode "actor_id=user-123" --data-urlencode "path=/preferences/communication.md"Aktualisieren Sie dann den Inhalt des Eintrags anhand seiner ID:
curl -X PATCH "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries/<entry-id>?update_mask=content" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"content": "Prefers email over phone. Timezone: PST."}'
Rufen Sie die Erinnerungen des Nutzers mit einer Suche in natürlicher Sprache ab:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"actor_id": "user-123", "query": "communication preferences"}'
Agent Bricks
Wenn Sie Ihren Agent mit der Agent Bricks CLI bauen, deklariert agentbricks init einen Speicher in agent.toml.
agentbricks deploy erstellt den Store, falls er noch nicht existiert, und gewährt dem eingesetzten Agenten Zugriff darauf.
Pfad auswählen:
Leer starten (die meisten Agenten): Stellen Sie den Agent bereit.
agentbricks deployerzeugt den Speicherbereich, denagentbricks initdeklariert hat. Um einen Agenten namensmy-agenteinzusetzen, führen Sie Folgendes aus:agentbricks deploy my-agentBeginnen Sie mit bereits im Store befindlichen Speichern: Erstellen Sie zuerst den Store, fügen Sie Einträge hinzu, verbinden Sie dann den Store mit dem Agent und vollziehen Sie die Bereitstellung.
Um einen Shop namens
my-agent-memoryzu erstellen, führe Folgendes aus. Die Ausgabe enthält die Store-ID, eine generierte Kennung, die vom Shop-Namen getrennt ist:agentbricks memory stores create --name my-agent-memoryUm einen Eintrag hinzuzufügen, führen Sie Folgendes aus, wobei Sie
<store-id>durch die Store-ID aus dem vorherigen Schritt ersetzen:agentbricks memory entries create --store <store-id> --actor-id you@example.com \ --path /preferences/style.md --content "Prefers Python and concise answers with code examples."Um den Store zu binden und den Agenten einzusetzen, führe Folgendes aus.
agentbricks memory bindersetzt den Shop-Namen inagent.toml, undagentbricks deployfindet den bestehenden Shop anhand des Namens und verwendet ihn, anstatt einen neuen zu erstellen:agentbricks memory bind my-agent-memory agentbricks deploy my-agent
--path ist der Schlüssel des Eintrags im Store, nicht eine Datei auf deinem Rechner.
--actor-id ist der Nutzer, dem der Speicher gehört. Ein bereitgestellter Agent verwendet die E-Mail des angemeldeten Nutzers als Akteur-ID, versehen Sie daher jeden Eintrag mit der E-Mail des Nutzers, der mit dem Agenten chattet.
In der Agent Bricks CLI beziehen sich memory bind und agentbricks deploy auf einen Store mit seinem Namen. Befehle, die auf einen einzelnen Store wirken, wie memory entries create, verwenden die generierte Store-ID.
Gib deinem Agenten Gedächtniswerkzeuge
Damit ein Agent selbst entscheiden kann, wann Speicher gespeichert und abgerufen werden soll, packen Sie die Client-Operationen als Werkzeuge und geben dem Agenten in seiner Systemaufforderung Anweisungen an, wann er sie verwenden soll. Legen Sie den actor_id im vertrauenswürdigen Anwendungscode anhand der verifizierten Endbenutzeridentität fest. Lass das Modell niemals entscheiden, wessen Speicher es liest oder schreibt.
Das folgende Beispiel verpackt das AgentKit-SDK memory_store aus Erste Schritte als Tools für das OpenAI Agents SDK.
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user, replacing any memory at the same path."""
        memory_store.put(actor_id=actor_id, path=path, content=content, description=description or None)
        return f"Saved memory at {path}"

    @function_tool
    def list_memories() -> str:
        """List the paths and descriptions of the user's long-term memories."""
        memories = memory_store.list(actor_id=actor_id)
        return "\n".join(f"{m.path}: {m.description}" if m.description else m.path for m in memories) or "No memory found."

    @function_tool
    def forget_memory(path: str) -> str:
        """Delete the long-term memory at a path, such as when the user asks you to forget it."""
        memories = list(memory_store.list(actor_id=actor_id, path=path))
        for memory in memories:
            memory.delete()
        return f"Forgot memory at {path}" if memories else f"No memory at {path}"

    return [search_memory, save_memory, list_memories, forget_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences, recall them when relevant, and forget them when the user asks.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
put() erstellt den Eintrag oder ersetzt den Inhalt des Eintrags, der bereits auf diesem Pfad liegt. Um den Inhalt stattdessen als neue Zeilen hinzuzufügen, geben Sie append=True an.
put() ist nicht atomar, sodass gleichzeitige Schreibvorgänge auf denselben Pfad sich gegenseitig überschreiben können.
list(path=...) gibt die Einträge auf genau diesem Pfad in jeder Sitzung zurück und somit löscht forget_memory auch jeden Eintrag, der auf dem Pfad innerhalb einer Sitzung gespeichert ist.
Das gleiche Muster funktioniert auch mit dem Claude Agent SDK und anderen Frameworks: Umschließen Sie die Such-, Einfüge-, Auflistungs- und Löschoperationen des Stores als Tool-Typ des Frameworks.
Wenn Sie außerdem eine Speicherpipeline im selben Speicher ausführen, kann die Pipeline die Einträge, die Ihr Agent für jeden von ihm verarbeiteten Akteur speichert, neu schreiben, zusammenführen, aufteilen oder löschen.
Partition und sicherer Speicher
In einem Store trennt actor_id, welche Erinnerungen zu wem gehören. Jede Liste und jede Suche ist auf ein einzelnes actor_id begrenzt. Wählen Sie also die Strategie, die dazu passt, was Ihr Agent sich merken muss:
-
Privater Speicher für jeden Benutzer: Legen Sie
actor_idauf die verifizierte Endbenutzeridentität fest. Jeder Benutzer erhält seine eigene Partition, und der Agent ruft nur die Einträge dieses Benutzers ab.- Beispiel: Ein Support-Mitarbeiter merkt sich an die Kommunikationspräferenzen eines Nutzers und frühere Tickets.
-
Gemeinsamer Speicher für eine Gruppe: Setzen
actor_idSie auf einen festen Schlüssel, den Sie wählen, wie zum Beispiel eine Team-, Projekt- oder Organisations-ID. Jeder liest und schreibt dieselben Erinnerungen.- Beispiel: Ein Teamagent merkt sich ein gemeinsames Glossar mit Unternehmensbegriffen und internen Konventionen.
-
Speicheraufteilung durch ein anderes Kriterium: Erstellen Sie
actor_idaus eigenen Werten, wie z. B. einer Mandanten-ID oder einemuser:projectzusammengesetzten Wert.-
Beispiel: Eine Multi-Tenant-App setzt
{tenant}:{user}aufactor_id, sodass die Benutzer der einzelnen Kunden voneinander isoliert bleiben.
-
Beispiel: Eine Multi-Tenant-App setzt
Legen Sie actor_id in Ihrem Anwendungscode aus einem vertrauenswürdigen Aufruferkontext fest: die verifizierte Endnutzeridentität für benutzerspezifischen Speicher oder einen vertrauenswürdigen Team- oder Projektschlüssel für gemeinsamen Speicher. Lass niemals das Modell es selbst wählen. Wenn Ihre Strategie auf einer Endbenutzeridentität basiert, lehnen Sie Anfragen ab, die keine solche enthalten, anstatt auf eine gemeinsam genutzte Identität actor_idzurückzugreifen.
Warning
actor_id trennt Erinnerungen, aber es ist keine Zugangskontrolle. Memory Stores sind auf den Workspace beschränkt, sodass jeder Principal, der einen Store erreichen kann, jeden Eintrag über alle Akteure hinweg lesen und schreiben kann. Der Laden, nicht der Akteur, ist die Sicherheitsgrenze. Für eine strikte Isolation zwischen Tenants oder Benutzern erstellen Sie pro Grenze einen separaten Speicher.
Um einem anderen Prinzipal, etwa dem Serviceprinzipal Ihres Agenten, die Nutzung eines Stores zu ermöglichen, gewähren Sie ihm mit dem Vorgang „grant-permission“ des Stores (memory_store.grant_permission(principal_id) im AgentKit SDK) Zugriff. Nur der Ersteller des Shops oder ein Workspace-Admin kann Zugriff gewähren.
Einschränkungen
- Das Agentengedächtnis stellt nur Langzeitspeicher bereit. Für den kurzfristigen Konversationsverlauf siehe Agent-Sitzungen.
- Die Suche ordnet Einträge nach Relevanz und kombiniert Volltext (BM25) und semantisches Matching über den Inhalt und die Beschreibung jedes Eintrags. Es gibt bis zu 100 Einträge zurück und unterstützt keine Paginierung.
- Die Zugangskontrolle wird auf Ladenebene durchgesetzt. Zugriffskontrollen pro Eingang und pro Akteur sind nicht verfügbar.
- Die Zugangskontrolle für den Store umfasst die Eingänge eines Store. Jeder Workspace-Nutzer kann Speicherablagen auflisten und abrufen, einschließlich ihrer IDs und Beschreibungen.
- Du kannst die ID eines Shops nicht ändern, nachdem du sie erstellt hast. Nur
descriptionkann aktualisiert werden.